Apa pilihan ion prekursor majeng bener diganti dibandhingake karo TopN DDA conventional?
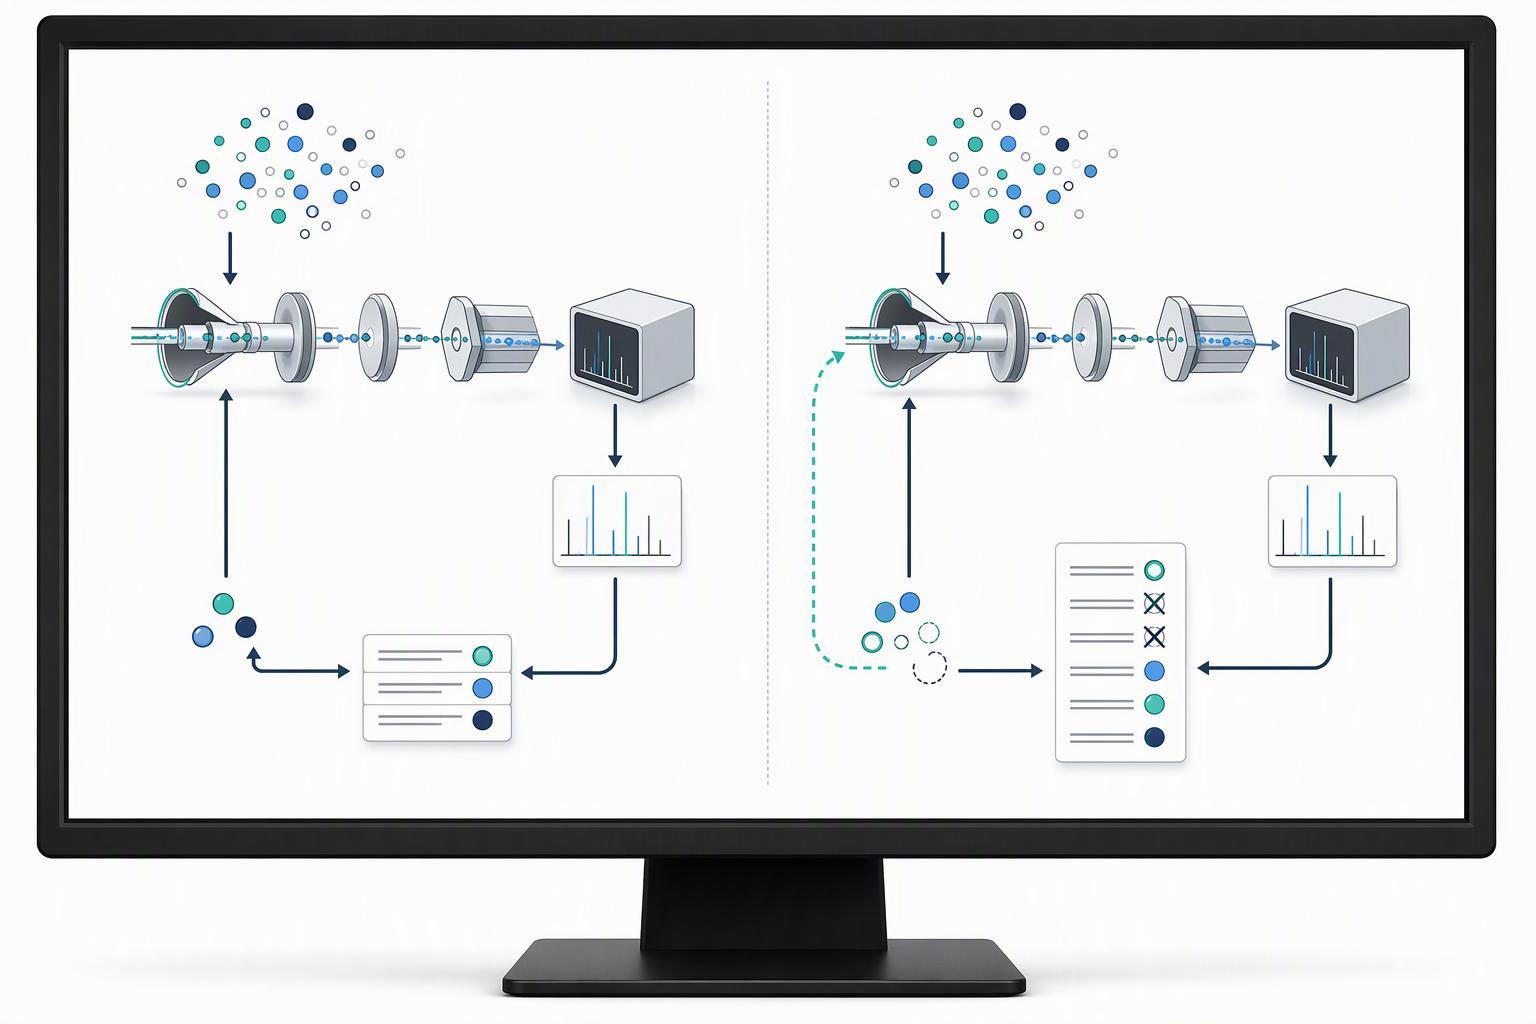
Peptida sintetik Hormon Pertumbuhan Peptida Iku ngganti loop sampling, dudu detektor. TopN DDA konvensional milih N prekursor layak paling kuat ing saben siklus MS1, lan pangecualian dinamis nyegah pilihan maneh langsung, dadi pilihan tetep umumé intensitas-mimpin lan KALUBÈRAN peptida sing sampel maneh lan maneh (Kreimer et al., J Proteome Res, 2016). Instrumen mlaku kanthi bener; strategi mung terus bali menyang tetanggan padha.
Kreimer et al. dibandhingake rong strategi iterative-exclusion: ora kalebu kabeh prekursor sing wis dipecah sadurunge lan ora kalebu mung peptida sing diidentifikasi. Iki minangka desain sing beda-beda kanthi asil sing beda. Njlèntrèhaké dhaptar pengecualian sing digunakake sadurunge ngutip gain, lan nahan ruang lingkup HeLa lan LTQ Orbitrap XL sinau. sinau asli.
Varian katelu nyurung pengecualian luwih lanjut: telusuran basis data wektu nyata sajrone akuisisi ngidini pengecualian kanthi identitas peptida tinimbang kanthi m / z lan acara wektu. karya simulasi awal ing pilihan puncak adaptif ketemu iki ditambahake paling bab a 1% gain liwat pilihan dhaftar pengecualian standar (arXiv pracetak 1207.5848, n.d.). Nambani nomer kasebut minangka asil simulasi, dudu pathokan, lan aja ngutip minangka asil instrumen sing diukur.
Ing dikutip 2016 sinau, jenuh TopN konvensional cedhak 12,500 peptida unik minangka ekstrapolasi. Eksperimen iteratif-eksklusi gabungan ngluwihi 16,000 identifikasi. Perbandingan kasebut nggambarake sampling pelengkap ing desain kasebut, ora universal 29% gain liwat kontrol siji-roto cocog.
Nggoleki spesies sing diisolasi bisa nambah ambane identifikasi ing sing dikutip 2025 sinau. Persentase sing dilapurake nggunakake perbandingan sing beda-beda lan kudu tetep denominator dhewe; ora kudu digabungake dadi rata-rata sing ngluwihi sawetara sing wis ditemtokake utawa digabung karo keuntungan pengecualian-pengecualian..
Pilihan prekursor mengaruhi bukti fragmentasi sing dipikolehi. Fitur unfragmented isih ana ing data MS1; ora bisa diwenehi kapercayan urutan sing padha tanpa bukti pendukung sing nyukupi. Telusuran sing luwih apik bisa mbalekake informasi sing wis ana ing spektrum sing dipikolehi.
Napa teknis-replikasi tumpang tindih bisa sithik tanpa cara sing ora bisa ditindakake?
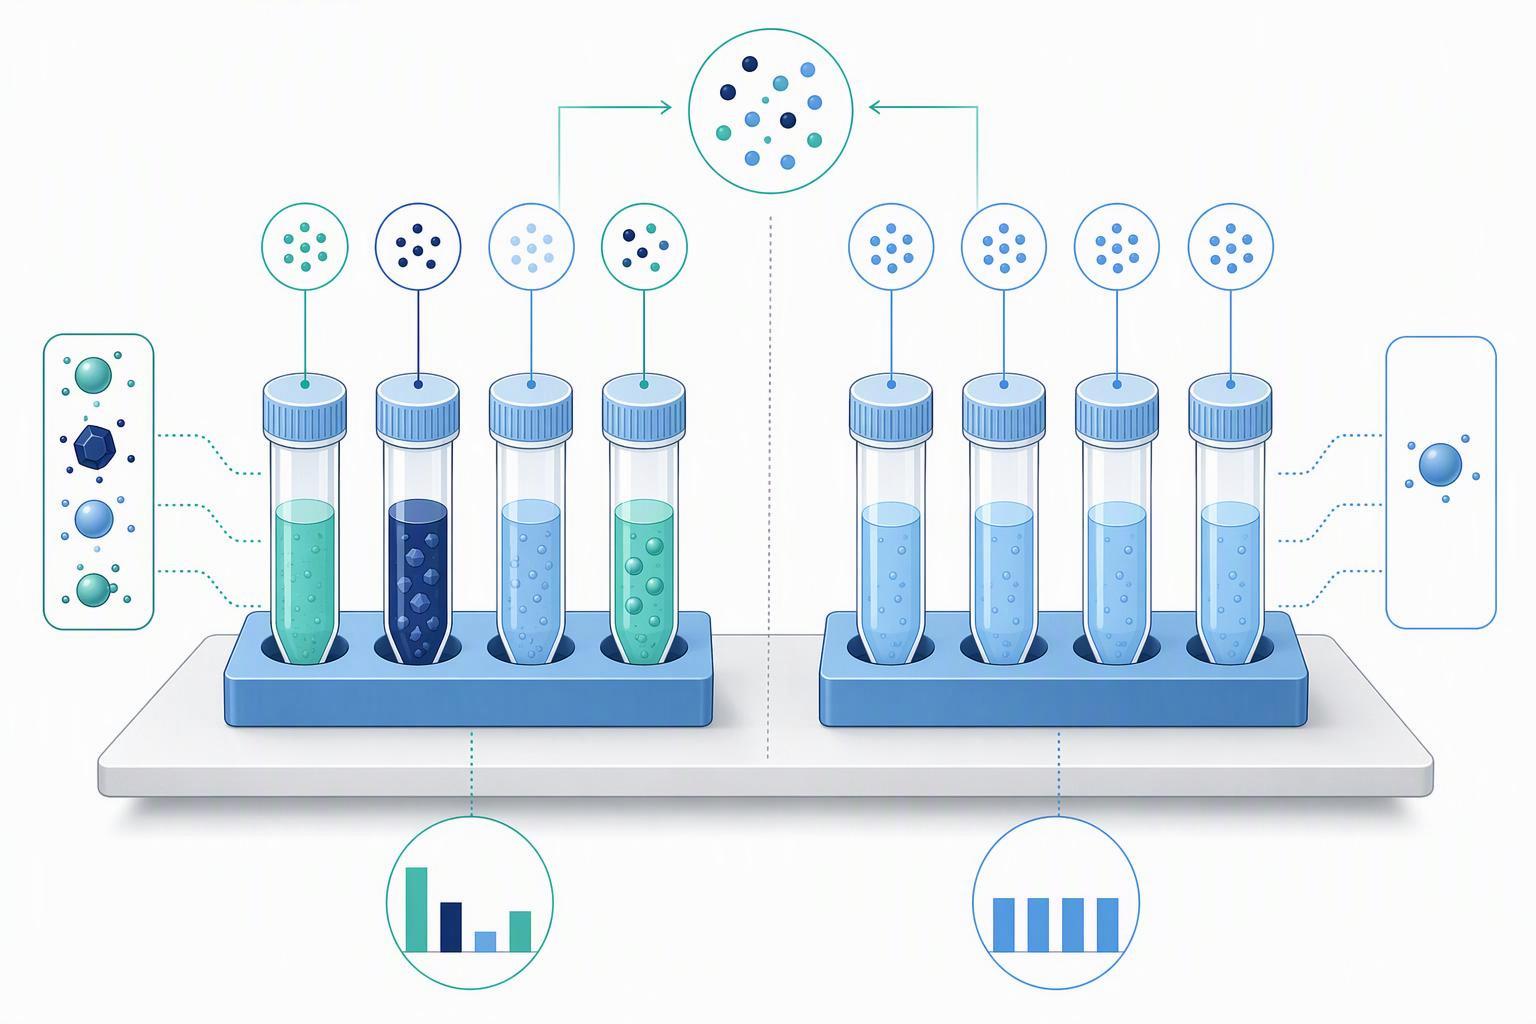
Amarga tumpang tindih sing kurang lan reproduktifitas sing ora apik yaiku pangukuran sing beda, lan desain panemuan-ambane bisa gawé pisanan nalika cara tetep sampurna repeatable. Jangkoan dawa kanggo tumpang tindih peptida replikasi ing DDA konvensional yaiku 35-60% ing antarane pasangan replika teknis., tokoh sing asale saka a 2010 analisis maneh ing LTQ lan instrumen Orbitrap lawas (Tabib et al., J Proteome Res, 2010). Panaliten kasebut uga nemokake tumpang tindih ora gumantung saka kerumitan sampel: campuran 48-protein menehi median 44% tumpang tindih, campuran protein standar 46%, lan pencernaan ragi 45% (Tabib et al., J Proteome Res, 2010). Repeatability hubungane karo intensitas prekursor, dadi peptida kurang turah mbrawah sing gedhe-gedhe sing dropped metu.
Iki minangka prabédan utama. Yen desain tiron sampeyan tetep sampel lan ora beda-beda kajaba injeksi, tumpang tindih kurang tegese cara sampling stokastik, kang samesthine kanggo DDA. Yen desain sampeyan dimaksudake kanggo nuduhake reproducibility, sampeyan kudu nyatakake apa sing tetep lan apa sing maneka warna, lan panuntun dhumateng penulis MCP mbutuhake persis sing: jumlah replika sing dipikolehi kanthi bedane sing jelas antarane biologis, proses lan replika teknis, plus metode lan jinis randomization, kontrol teknis, lan span wektu analisis sampel (Instruksi MCP kanggo Penulis).
Loro eksperimen independen anyar nuduhake sepira masalah tumpang tindih gumantung saka akuisisi. A comparison DDA-versus-DIA langsung ing conto padha ketemu luwih saka 92% saka peptida terus-terusan dikenali liwat replika ing data DIA versus kurang saka 77% ing data DDA, karo konsistensi tingkat protein saka 99.0/98.2/98.2% kanggo DIA marang 95.6/95.4/96.2% kanggo DDA (PMC12801617, 2025). Perbandingan kelengkapan wolung replika ing cairan luh sing ditemokake DIA ing 78.5% kelengkapan peptida lawan 48% kanggo DDA, karo CV belekan saka 10.6% lan 22.3% mungguh (J Mass Spectrom Adv Clin Lab, 2025). Loro metrik sing beda, konsistensi ana / ora ana lan koefisien variasi, nunjukake cara sing padha.
Longkangan jujur: ora sumber ing pesawat iki maneh ngukur ing 2010 angka tumpang tindih ing instrumentasi saiki. Kisaran 35-60% kudu diwenehi tanggal kapan dikutip, lan bukti DIA-versus-DDA mung nyakup garis sel lan cairan luh. Ora ana sumber ing kene sing mbandhingake rong mode ing fosfoproteome utawa conto liyane sing diperkaya PTM, dadi pratelan apa wae babagan DIA lawan DDA kanggo peptida sing diowahi bakal ora didukung.
Sadurunge akuisisi, mbedakake desain panemuan-ambane saka sinau repeatability. Tumpang tindih sing sithik sawise pengecualian sing disengaja bisa nuduhake sampling pelengkap, nanging uga mriksa kapercayan identifikasi, jangkoan total lan kualitas sampel; tumpang tindih kurang piyambak ora mbuktekaken strategi digunakake.
Carane akeh jangkoan urutan cukup, lan ing ngendi jangkoan kudu tiba?
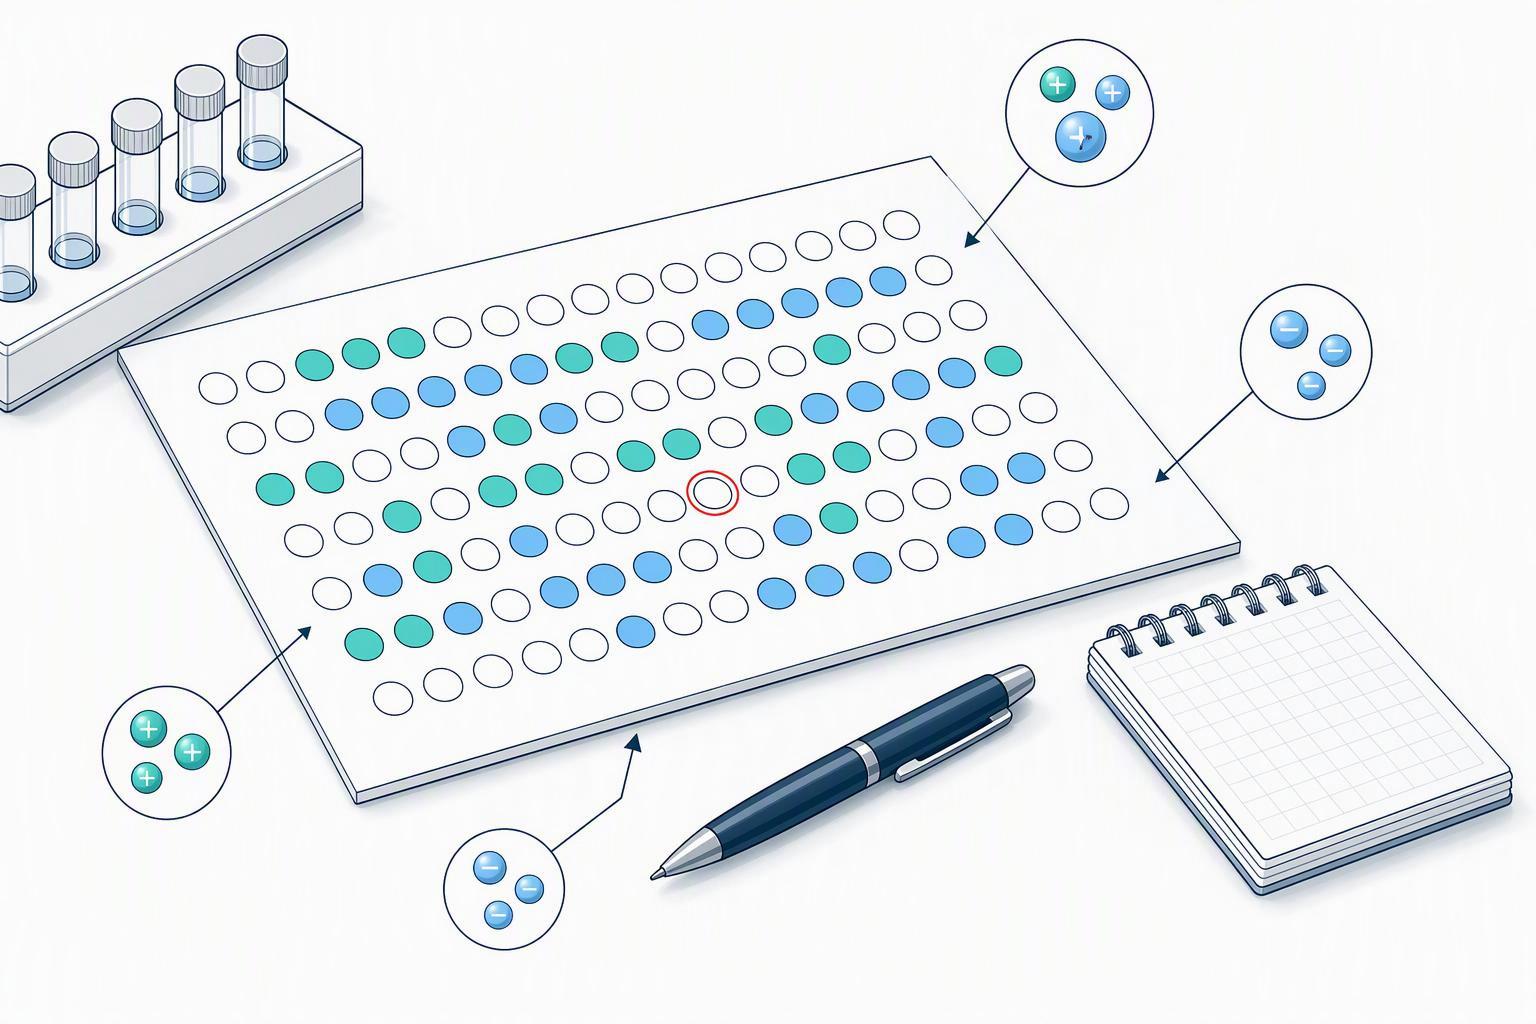
Nemtokake metrik jangkoan sadurunge nyetel kritéria. Jangkoan urutan protein ngitung residu sing diwakili dening peptida sing diidentifikasi; jangkoan fragmen-ion saka peptida sintetik ukuran beda. Sanadyan persentasi piyambak netepake urutan ampas, posisi modifikasi utawa stereokimia. Setel ion diagnostik sing dibutuhake lan tes ortogonal kanggo konstruksi kasebut.
Aturan placement nderek saka definisi kasebut. Kanggo peptida sing diowahi utawa diwenehi label, jangkoan kudu kalebu residu sing nggawa modifikasi utawa label. A 95% map jangkoan sing ninggalake situs dipunéwahi ing ditemokke 5% ora ndhukung pratelan identitas khusus situs, ora ketompo carane dhuwur persentasi katon.
Iku laku vendor, dudu ambang regulasi, lan kudu diwenehi label kaya ing spesifikasi sing sampeyan tulis.
Apa sing bisa ditindakake dening reviewer yaiku set laporan. Panuntun jurnal sing bisa dicekel maca mbutuhake toleransi massa prekursor-ion lan fragmen-ion, mesin telusur lan versi, database kasebut, metode estimasi FDR, lan piranti lunak utawa cara sing digunakake kanggo ngevaluasi tugas situs modifikasi, kanthi spektrum anotasi kanggo saben peptida ing ngendi situs modifikasi dilaporake (MCP Tutorial kanggo Proteomics Data Submission, Pandhuan penulis MCP). Dhaptar priksa informasi minimal nambahake jeneng piranti lunak, versi lan pabrikan, database queried karo versi lan counts entri, lan file parameter (MIAPE-MSI 1.1, 2008-02-05). MIAPE punika 2008 dhaptar mriksa lan tetep ing versi 1.1; iku dudu syarat anyar.
Dadi jawaban praktis kanggo "nomer jangkoan apa sing bakal ditampa dening reviewer" yaiku: nyatakake ambang sing sampeyan gunakake, negara ngendi jangkoan tumiba relatif kanggo Semaglutide Peptida residu sing diowahi, lan laporan paramèter sing ngidini wong ngasilake pitungan. Nomer tanpa telung perkara kasebut ora bisa dipertahanake.
Kepiye cara lokalisasi modifikasi utawa label tinimbang mung ngonfirmasi massa sing utuh?
Lokalisasi minangka pangukuran sing kapisah saka identifikasi, kanthi skor dhewe, ambang dhewe lan tingkat kesalahan dhewe. Basis gabungan kenapa massa mung ora bisa nutup pratelan identitas wis lawas lan mantep: antarane peptida beda-beda ing komposisi siji, loro utawa telu asam amino, 10%, 29% lan 53% mungguh duwe isomer massa-identik, lan ora kalebu isomer leucine / isoleucine tokoh kasebut 14% lan 38% (Dheweke et al., J Proteome Res, 2004). Peptida isomer kasebut ora bisa dibedakake kanthi massa, lan spektrometri massa tandem utawa kendala tambahan liyane dibutuhake.
Skor lokalisasi bisa digunakake kanthi mbandhingake fragmen penentu situs. Implementasi saiki mbandhingake peptidoform kanthi skor paling apik kanthi modifikasi ing situs karo peptidoform kanthi skor paling apik tanpa kasebut., nglirwakake puncak sing dienggo bareng amarga ora menehi diskriminasi, lan drive kapercayan lokalisasi mung saka puncak discriminating (PTMPRophe, 2019). Implementasine sing ditrapake lokalisasi ing ambang kemungkinan iProphet saka 0.9 kanggo loro dataset lan 0.8 kanggo katelu, terakhir cocog kanggo 0.4% kira-kira kesalahan PSM lan 97.9% sensitivitas PSM, lan kacarita asil ing 5% tingkat lokalisasi palsu lan ngisor 1% FLR (PTMPRophe, 2019).
Ambang lokalisasi klasik adhedhasar skor lan ora kudu dianggep minangka kritéria panrima universal. AScore 19 cocog karo p kira-kira 0.01, utawa 99% kepastian, lan mengko laku phosphoproteomics saka laboratorium padha digunakake p luwih liberal < 0.05, AScore > 13; Spectrum Mill mbutuhake prabédan skor luwih saka 1.1 antarane loro lokalisasi ndhuwur kanggo lokalisasi yakin (Skor Lokalisasi Situs Modifikasi, 2012). Tinjauan sing padha ngelingake yen skor adhedhasar kemungkinan gumantung ing asumsi sing ora nyata yen kabeh massa bisa diamati kanthi acak., lan nyaranake dianggep minangka skor sing tundhuk ambang sing disetel pangguna tinimbang minangka ukuran kepastian sing akurat.
Bebaya kasebut dikonfirmasi kanthi cara ambang bener dipilih. PTMProphet nggambarake pilihan ambang kemungkinan lokalisasi minangka pilihan sing sewenang-wenang sing digawe dening pangguna, disetel miturut tingkat kesalahan sing ditampa pangguna (PTMPRophe, 2019). Ora standar mbenakake nomer, dadi pamindhahan sing bisa dipertahanake yaiku nyatakake ambang, nyatakake tingkat kesalahan sing cocog, lan laporake tingkat lokalisasi bebarengan karo tingkat identifikasi.
Kanggo peptida sing diwenehi label, pergeseran massa utuh sing dikarepake ndhukung komposisi sing diusulake nanging ora mbuktekake kimia label utawa situs lampiran. Gunakake fragmen penentu situs lan, ngendi perlu, metode struktural ortogonal kanggo nguji label lan tautan sing diusulake.
Teknik ortogonal kang mangsuli pitakon identitas?
Saben teknik njawab pitakonan sing beda, lan pemetaan prakara luwih saka count. Ing 2025 Pedoman Eropa kanggo peptida sintetik, ing pasukan wiwit Juni 2026, nyaranake nggunakake paling ora rong cara ortogonal kanggo identifikasi minangka bagéan saka specification lan release, lan dhaptar massa, wektu penylametan relatif, LC-MS, pemetaan peptida, bioaktivitas, analisis asam amino utawa NMR minangka cocok, kanthi kombinasi sing dibutuhake kanggo konfirmasi urutan kasebut kanthi jelas (EMA, Pedoman Pengembangan lan Pembuatan Peptida Sintetis, 2025-12-04, efektif 2026-06-01).
Logika pangaturan ing ngisor iki adhedhasar kinerja tinimbang numerik. aku q2(R2) mbutuhake identifikasi kanggo nduduhake kemampuan kanggo mbedakake analit kanthi aspek struktur molekul sing unik, dikonfirmasi dening asil positif marang materi referensi plus asil negatif saka conto kurang analyte, lan ing ngendi prosedur ora cukup mbedakake, prosedur tambahan kudu digunakake (aku q2(R2), diadopsi 2023-11-01, didandani 2023-11-30). Syarat spesifik yaiku tes kemampuan, ora count saka tes.
Praktek standar referensi kanggo identitas peptida converges ing arah sing padha tanpa mbenakake nomer: macem-macem teknik ortogonal biasane digunakake kanggo verifikasi struktur kimia lan identitas kimia, kalebu wektu penylametan HPLC, NMR, MS lan tes kiral, lan pasinaon multi-laboratorium nggunakake NMR, pemetaan peptida, Analisis HPLC lan asam amino (Riset Farmasi, 2023). Identitas HPLC ing praktik kasebut gumantung marang perbandingan wektu retensi karo standar referensi, mulane wektu retensi tanpa standar ora minangka asil identitas.
Metode-kanggo-pitakonan pemetaan sing Supplier Grosir Peptida nderek saka sumber kasebut:
|
Pitakonan identitas |
Teknik sing mangsuli |
Apa ora mangsuli |
|---|---|---|
|
Apa massa utuh bener? |
LC-MS utawa MALDI-TOF massa utuh |
urut-urutan, fitur posisional utawa stereokimia |
|
Apa urutane bener? |
MS / MS kanthi jangkoan urutan, utawa pemetaan peptida |
modifikasi labil, kesenjangan jangkoan parsial |
|
Endi modifikasi utawa label? |
fragmen penentu situs MS/MS kanthi ambang lokalisasi sing wis ditemtokake |
Apa situs kasebut cocog karo fungsine Melittin |
|
Apa stereokimia bener? |
Analisis kiral sing divalidasi; analisis komposisi asam amino biasa mung ora netepake stereokimia |
Posisi modifikasi |
|
Apa bahan sing padha karo standar? Grosir Peptida Custom |
wektu penylametan HPLC marang standar referensi |
Apa wae standar dhewe ora netepake |
Kebiasaan review COA kanggo njaga saben kesimpulan kanthi metode yaiku versi praktis saka tabel iki: kemurnian kromatografi nggambarake homogeneitas kromatografi lan ora nggawe identitas kimia kanthi mandiri, massa utuh piyambak ora bisa netepake saben urutan, fitur posisional utawa stereokimia, lan identitas lan kemurnian kudu dilapurake kanthi kapisah lan digandhengake karo metode sing ndhukung (Vektor E Lab, 2026-09-28).
Apa sing kudu ditulis sadurunge akuisisi supaya klaim identitas bisa dipertahankan?
Rekaman kasebut kudu cukup lengkap supaya wong liya bisa mbukak maneh telusuran sing padha utawa sing padha ing mesin sing padha utawa liyane. Format ijol-ijolan sing nggawa protokol telusuran mbutuhake SpectrumIdentificationProtocol kanggo ngumumake jinis telusuran kayata skor tingkat peptida utawa skor lokalisasi modifikasi., mbutuhake mesin telusur diwakili ing dhaptar piranti lunak, lan dirancang kanggo persis reproducibility sing (mzIdentML 1.3.0, Juni 2024).
Cathetan pra-akuisisi, dikumpulake saka standar laporan ing ndhuwur:
-
Strategi pilihan lan paramèter. Nilai paling dhuwur saham N, jendhela isolasi, durasi pengecualian dinamis, lan apa dhaftar pengecualian kaleksanane nerusake antarane roto.
-
Toleransi. Prekursor lan toleransi massa fragmen, kasebut minangka angka. Ing 2016 sinau digunakake 10 ppm lan 0.5 lan (Kreimer et al., J Proteome Res, 2016); akurasi tingkat instrument cara kudu dicocogake ing ngisor iki 3 ppm RMS liwat 24 h karo kalibrasi njaba lan ngisor 1 ppm RMS kanthi kalibrasi internal ing platform Orbitrap saiki (Spesifikasi Thermo Fisher, sheet vendor saiki diterbitake).
-
Mesin telusur lan versi, database lan versi karo count entri, lan metode estimasi FDR. Panelusuran target-decoy minangka cara sing ditampa kanggo mbedakake identifikasi sing bener saka identifikasi sing salah, lan amarga umume mesin telusur ngasilake asil sanajan spektrum sing ora cocog, tingkat kesalahan kudu kira-kira saka distribusi skor (Elias & Gigi, Metode Alam, 2007). Kapercayan per-peptida asalé saka model probabilistik sing ngitung kemungkinan saben assignment bener, mbisakake nyaring karo tingkat kesalahan katebak (Keller et al., Chem anal, 2002).
-
Metode site-assignment lan ambange, kanthi spektrum anotasi kanggo saben peptida ing ngendi situs modifikasi dilaporake.
-
Replika struktur. Jumlah replika, lan apa iku biologi, proses utawa teknis.
-
Pengenal arsip. Pengenal PXD tetep, unik lan wajib minangka pengenal utama kanggo dataset asli sing dikirim, karo metadata plus file mentah lan diproses setor bebarengan, lan pengenal RPXD kanggo dataset sing dianalisis maneh (Konsorsium ProteomeXchange, Riset Asam Nukleat, 2026-01-06).
Aturan kaputusan, ditrapake sadurunge akuisisi: yen sampeyan ora bisa nulis strategi pilihan, toleransi, paramèter panelusuran, ambang lokalisasi lan struktur replikasi luwih dhisik, pratelan identitas ora bisa dipertahanake sakwise. Saben lapangan kasebut minangka keputusan, lan saben siji luwih murah kanggo nggawe sadurunge roto saka reconstruct sawise iku.
Pitakonan sing Sering Ditakoni
Apa tumpang tindih teknis sing sithik tegese caraku ora apik?
Ora mesthi. DDA konvensional mung milih prekursor sing paling kuat ing saben siklus, supaya kurang tumpang tindih antarane replika samesthine prilaku sampling tinimbang Gagal reproducibility (Tabib et al., J Proteome Res, 2010). Pitakonan sing kudu ditakoni yaiku apa sing dimaksudake desain replika.
Apa aku bisa ngutip 29% tokoh minangka pathokan umum?
Ora. Asalé saka siji 2016 sinau ing LTQ Orbitrap XL karo HeLa digest lan a 120 min gradient (Kreimer et al., J Proteome Res, 2016). Kutip karo sing orane katrangan ditempelake, utawa nyatakake mekanisme kanthi kualitatif.
Jangkoan urutan apa sing kudu daklebokake ing spesifikasi?
Ora ana minimal sing didhukung regulator. Sebutake ambang sing sampeyan gunakake, konfirmasi manawa jangkoan kalebu residu sing nggawa modifikasi utawa label, lan laporake paramèter panelusuran sing ngidini reviewer ngasilake pitungan.
Apa massa utuh cukup kanggo konfirmasi identitas?
Ora. Antarane peptida beda siji, loro utawa telu asam amino, 10%, 29% lan 53% duwe isomer massa-identik (Dheweke et al., J Proteome Res, 2004). Massa minangka salah sawijining metode ortogonal, ora pratelan identitas lengkap.
Apa aku kudu persis loro cara orthogonal?
Ing 2025 Pedoman Eropa nyaranake paling ora loro kanggo identifikasi peptida sintetik (EMA, efektif 2026-06-01), nalika ICH Q2(R2) pigura requirement minangka basis specificity tinimbang count tetep (aku, 2023). Kombinasi kasebut kudu ngonfirmasi urutan kasebut kanthi jelas; nomer nderek saka sing.
Kesimpulan
Klaim identitas dibangun sadurunge akuisisi, ora sawise iku. Strategi pamilihan prekursor nemtokake peptida sing bakal diconto, desain tiron nemtokaken apa tumpang tindih informatif utawa sengaja, laporan jangkoan mutusaké apa ampas dipunéwahi bener nang bukti, lan karakterisasi ortogonal mutusake manawa pratelan kasebut tetep ana ing reviewer sing ngerti yen massa mung ninggalake isomer sing ora bisa dirampungake..
Langkah sabanjure yaiku rekaman pra-akuisisi: strategi pilihan, toleransi, paramèter panelusuran, ambang lokalisasi, struktur replikasi lan pengenal arsip, ditulis mudhun lan versi-kontrol sadurunge injeksi pisanan. Yen ana lapangan sing ilang, ndandani sadurunge roto tinimbang ing nanggepi reviewer.
Kanggo tim mbandingaken orane katrangan layanan kanggo adat, peptida sing diowahi lan diwenehi label, njaluk kutipan sing nyatakake paramèter analitis ing ndhuwur tinimbang mung tokoh kemurnian.
Standar analitis lan perbandingan metode sing dikutip minangka sumber sing diterbitake independen.*