Trả lời nhanh
Think of precursor selection as a sampling strategy rather than a detector setting. A detector reports what reaches it; the sampling strategy decides what gets…
Việc lựa chọn ion tiền chất tiên tiến thực sự thay đổi gì so với TopN DDA thông thường?
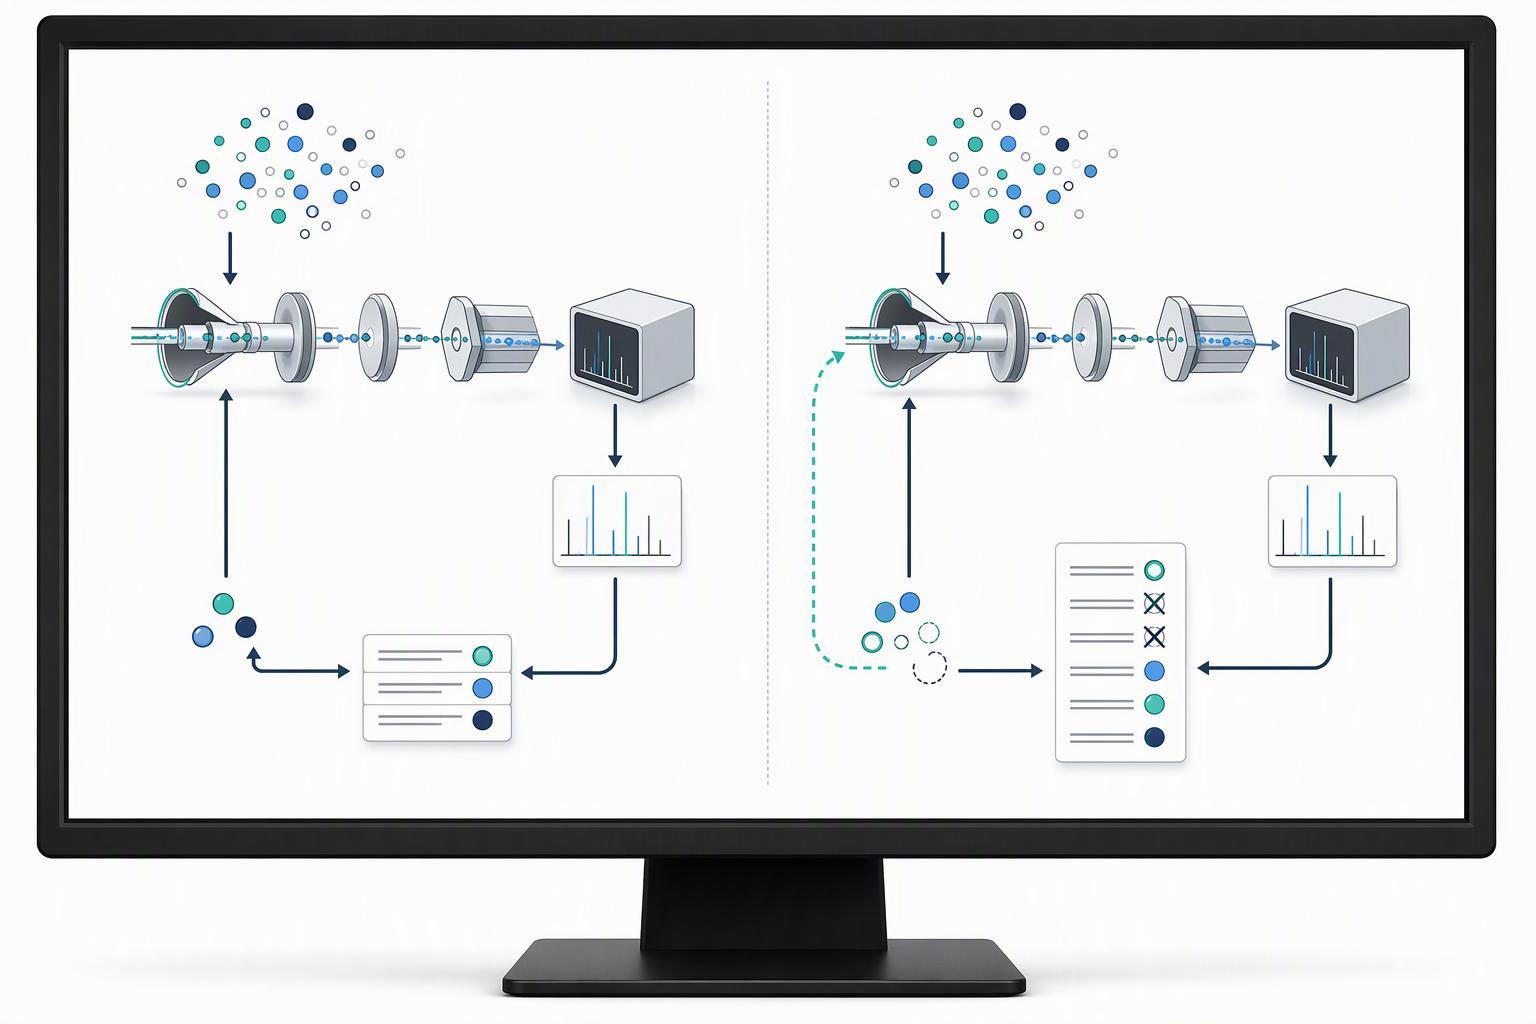
Peptide tổng hợp Hormon tăng trưởng peptide Nó thay đổi vòng lấy mẫu, không phải máy dò. TopN DDA thông thường chọn N tiền chất đủ điều kiện mạnh nhất trong mỗi chu kỳ MS1, và loại trừ động ngăn cản việc lựa chọn lại ngay lập tức, vì vậy quá trình lựa chọn chủ yếu dựa vào cường độ và các peptide dồi dào được lấy mẫu lặp đi lặp lại (Kreimer và cộng sự., J Proteome Res, 2016). Dụng cụ đang hoạt động chính xác; chiến lược chỉ đơn giản là tiếp tục quay trở lại cùng một vùng lân cận.
Kreimer và cộng sự. so sánh hai chiến lược loại trừ lặp đi lặp lại: loại trừ tất cả các tiền chất bị phân mảnh trước đó và chỉ loại trừ các peptide đã xác định. Đây là những thiết kế khác biệt với kết quả khác nhau. Mô tả danh sách loại trừ nào đã được sử dụng trước khi trích dẫn mức tăng, và giữ lại phạm vi phân tích HeLa và LTQ Orbitrap XL của nghiên cứu. Nghiên cứu ban đầu.
Biến thể thứ ba đẩy mạnh việc loại trừ hơn nữa: tìm kiếm cơ sở dữ liệu thời gian thực trong quá trình thu thập cho phép loại trừ theo nhận dạng peptide thay vì theo m/z và sự kiện thời gian. Công việc mô phỏng ban đầu về lựa chọn đỉnh thích ứng cho thấy điều này được bổ sung nhiều nhất là khoảng 1% đạt được lựa chọn danh sách loại trừ tiêu chuẩn (bản in trước arXiv 1207.5848, nd). Hãy coi con số đó là kết quả mô phỏng, không phải là điểm chuẩn, và không trích dẫn nó như một kết quả của công cụ đo lường.
Trong phần trích dẫn 2016 học, độ bão hòa TopN thông thường gần 12,500 peptide độc đáo là một phép ngoại suy. Các thử nghiệm loại trừ lặp đi lặp lại kết hợp đã vượt quá 16,000 nhận dạng. Sự so sánh minh họa việc lấy mẫu bổ sung theo thiết kế đó, không phải là phổ quát 29% đạt được điều khiển chạy một lần phù hợp.
Tìm kiếm các loài cùng phân lập có thể tăng độ sâu nhận dạng trong các loài được trích dẫn 2025 học. Tỷ lệ phần trăm được báo cáo của nó sử dụng các so sánh khác nhau và phải giữ lại mẫu số riêng; chúng không nên được kết hợp thành mức trung bình vượt quá phạm vi đã nêu hoặc được hợp nhất với mức tăng loại trừ lặp lại.
Lựa chọn tiền thân ảnh hưởng đến bằng chứng phân mảnh nào được thu thập. Một tính năng không bị phân mảnh có thể vẫn còn trong dữ liệu MS1; nó không thể được chỉ định độ tin cậy trình tự tương đương nếu không có bằng chứng hỗ trợ đầy đủ. Tìm kiếm được cải thiện có thể khôi phục thông tin đã có trong quang phổ thu được.
Tại sao sự chồng chéo về mặt kỹ thuật có thể thấp mà phương pháp không thể tái tạo được?
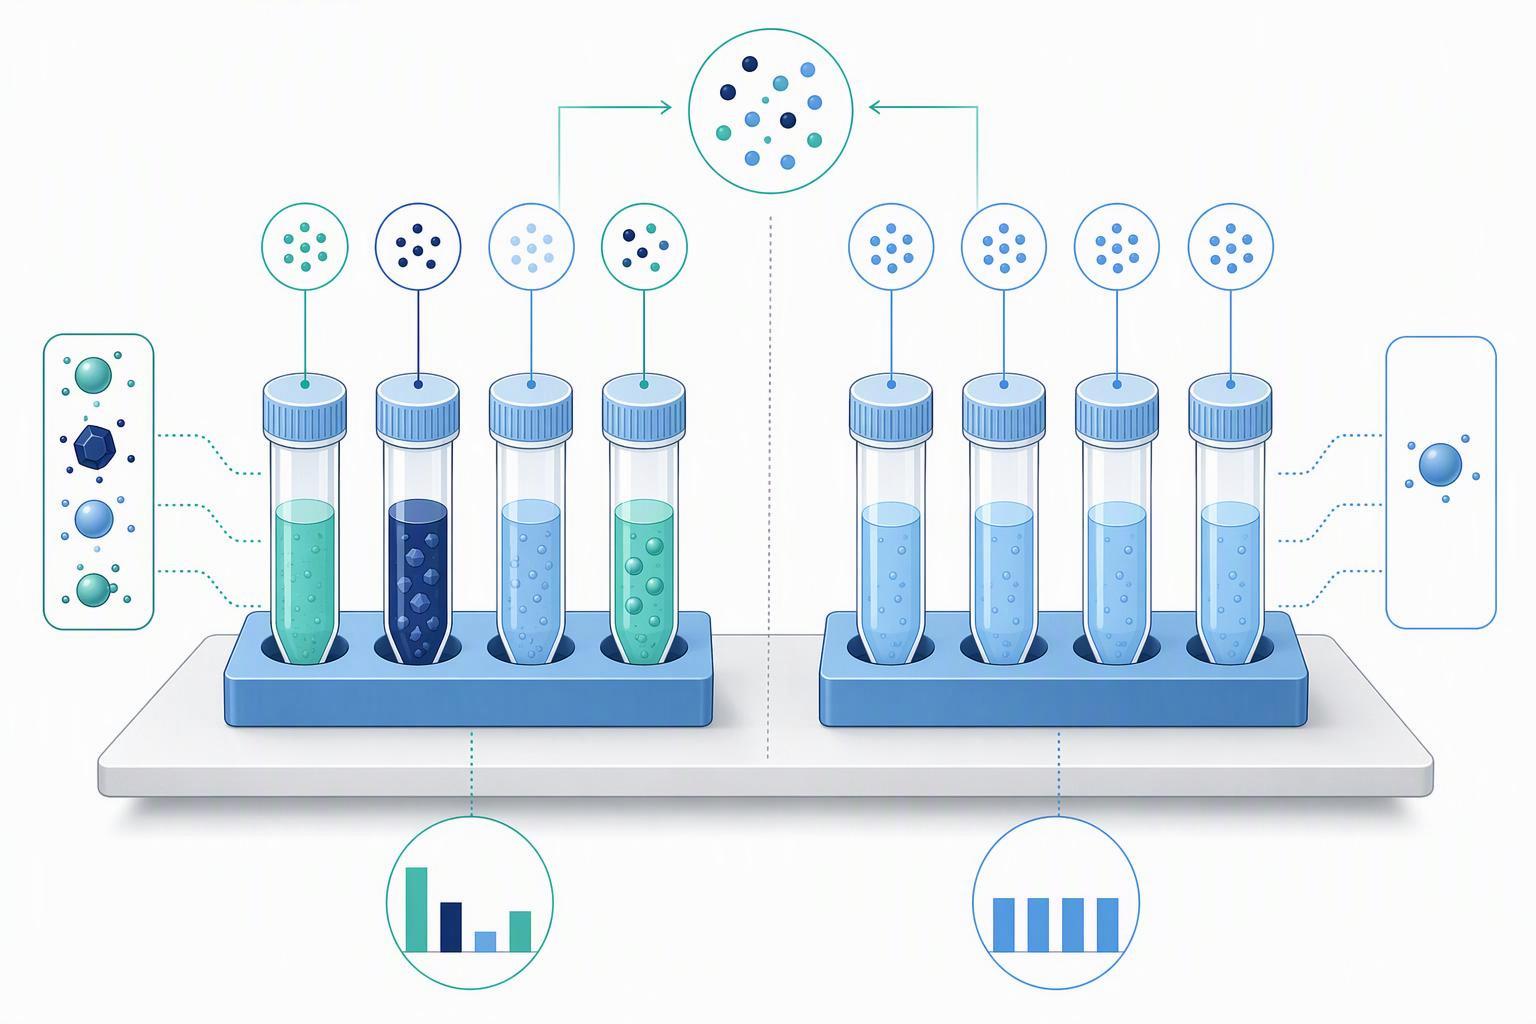
Bởi vì độ chồng chéo thấp và độ tái lập kém là các phép đo khác nhau, và thiết kế theo chiều sâu khám phá có thể tạo ra thiết kế đầu tiên trong khi phương pháp vẫn có thể lặp lại hoàn toàn. Phạm vi lâu dài của sự chồng chéo peptide tái tạo trong DDA thông thường là 35–60% giữa các cặp lặp lại kỹ thuật, một con số đến từ một 2010 phân tích lại trên LTQ và các công cụ Orbitrap cũ hơn (Tabb và cộng sự., J Proteome Res, 2010). Nghiên cứu đó cũng cho thấy sự chồng chéo không phụ thuộc vào độ phức tạp của mẫu: hỗn hợp 48 protein cho kết quả trung bình 44% chồng chéo, hỗn hợp protein chuẩn 46%, và một loại men tiêu hóa 45% (Tabb và cộng sự., J Proteome Res, 2010). Độ lặp lại tương quan với cường độ tiền chất, nên những peptide có hàm lượng thấp là những thứ bị loại bỏ.
Đó là điểm khác biệt then chốt. Nếu thiết kế sao chép của bạn giữ mẫu không đổi và không thay đổi gì ngoài việc tiêm, độ chồng chéo thấp có nghĩa là phương pháp lấy mẫu ngẫu nhiên, điều được mong đợi đối với DDA. Nếu thiết kế của bạn nhằm mục đích chứng minh khả năng tái tạo, bạn cần nêu rõ cái gì được giữ không đổi và cái gì thay đổi, và hướng dẫn của tác giả MCP yêu cầu chính xác điều đó: số lượng bản sao thu được với sự phân biệt rõ ràng giữa sinh học, bản sao quy trình và kỹ thuật, cộng với phương pháp và loại ngẫu nhiên, kiểm soát kỹ thuật, và khoảng thời gian phân tích mẫu (Hướng dẫn MCP cho tác giả).
Hai thử nghiệm độc lập gần đây cho thấy mức độ vấn đề chồng chéo phụ thuộc vào việc thu thập. Một so sánh trực tiếp DDA so với DIA trong cùng một mẫu được tìm thấy nhiều hơn 92% của các peptide được xác định nhất quán qua các lần lặp lại trong dữ liệu DIA so với ít hơn 77% trong dữ liệu DDA, với mức độ nhất quán của protein 99.0/98.2/98.2% ủng hộ DIA chống lại 95.6/95.4/96.2% cho DDA (PMC12801617, 2025). Một so sánh đầy đủ tám lần trong nước mắt được tìm thấy DIA ở 78.5% sự hoàn thiện của peptide so với 48% cho DDA, với CV trung bình của 10.6% Và 22.3% tương ứng (Phòng thí nghiệm lâm sàng J Mass Spectrom Adv, 2025). Hai thước đo khác nhau, sự hiện diện/vắng mặt nhất quán và hệ số biến đổi, chỉ theo cùng một cách.
Khoảng cách trung thực: không có nguồn nào trong bộ này đo lại 2010 hình chồng lên nhau trên thiết bị hiện tại. Phạm vi 35–60% phải được ghi ngày bất cứ khi nào nó được trích dẫn, và bằng chứng DIA so với DDA chỉ bao gồm các dòng tế bào và nước mắt. Không có nguồn nào ở đây so sánh hai chế độ trên mẫu phosphoproteome hoặc mẫu được làm giàu PTM khác, vì vậy mọi khiếu nại về DIA so với DDA đối với các peptide biến đổi sẽ không được chứng minh.
Trước khi mua lại, phân biệt thiết kế theo chiều sâu khám phá với nghiên cứu về khả năng lặp lại. Sự chồng chéo thấp sau khi loại trừ có chủ ý có thể chỉ ra việc lấy mẫu bổ sung, mà còn kiểm tra độ tin cậy nhận dạng, tổng phạm vi bảo hiểm và chất lượng mẫu; chỉ riêng mức độ chồng chéo thấp không chứng tỏ chiến lược đang hoạt động.
Bao nhiêu trình tự bao phủ là đủ, và phạm vi bảo hiểm phải giảm ở đâu?
Xác định số liệu bao phủ trước khi đặt tiêu chí. Phạm vi bao phủ chuỗi protein đếm dư lượng được đại diện bởi các peptide được xác định; Độ bao phủ mảnh ion của peptide tổng hợp là một biện pháp khác. Không phải riêng phần trăm nào cũng thiết lập được trật tự dư lượng, vị trí sửa đổi hoặc hóa học lập thể. Đặt các ion chẩn đoán cần thiết và các xét nghiệm trực giao cho cấu trúc.
Quy tắc vị trí tuân theo định nghĩa đó. Đối với peptide được sửa đổi hoặc dán nhãn, phạm vi bảo hiểm phải bao gồm dư lượng mang theo sự sửa đổi hoặc nhãn. MỘT 95% bản đồ bảo hiểm để lại trang web đã sửa đổi ở trạng thái không được che phủ 5% không hỗ trợ xác nhận danh tính dành riêng cho trang web, cho dù tỷ lệ phần trăm có vẻ cao đến đâu.
Đó là thực tế của nhà cung cấp, không phải là ngưỡng quy định, và nó phải được dán nhãn như vậy trong bất kỳ thông số kỹ thuật nào bạn viết.
Điều mà người đánh giá thực sự có thể thu hút bạn là tập hợp báo cáo. Hướng dẫn của tạp chí mà người đọc có thể nắm được yêu cầu dung sai khối lượng ion tiền chất và mảnh ion, công cụ tìm kiếm và phiên bản, cơ sở dữ liệu, phương pháp ước tính FDR, và phần mềm hoặc phương pháp được sử dụng để đánh giá việc phân công địa điểm sửa đổi, với quang phổ được chú thích cho mọi peptide nơi vị trí sửa đổi được báo cáo (Hướng dẫn MCP để gửi dữ liệu Proteomics, Hướng dẫn tác giả MCP). Danh sách kiểm tra thông tin tối thiểu thêm tên phần mềm, phiên bản và nhà sản xuất, cơ sở dữ liệu được truy vấn với các phiên bản và số lượng mục nhập, và các tập tin tham số (MIAPE-MSI 1.1, 2008-02-05). MIAPE là 2008 danh sách kiểm tra và vẫn còn ở phiên bản 1.1; nó không phải là một yêu cầu mới.
Vì vậy, câu trả lời thực tế cho “người đánh giá sẽ chấp nhận số lượng bảo hiểm nào” là: nêu rõ ngưỡng bạn đã áp dụng, trạng thái nơi phạm vi bảo hiểm giảm so với Semaglutide Peptide dư lượng đã sửa đổi, và báo cáo các tham số cho phép ai đó tái tạo lại phép tính. Một con số không có ba điều đó thì không thể bào chữa được.
Làm cách nào để bản địa hóa một sửa đổi hoặc nhãn thay vì chỉ xác nhận khối lượng còn nguyên vẹn?
Bản địa hóa là một phép đo riêng biệt với nhận dạng, với điểm số riêng của mình, ngưỡng riêng của nó và tỷ lệ lỗi riêng của nó. Cơ sở tổ hợp giải thích tại sao chỉ riêng khối lượng không thể đóng được một yêu cầu nhận dạng đã cũ và chắc chắn: giữa các peptide có thành phần khác nhau một, hai hoặc ba axit amin, 10%, 29% Và 53% tương ứng có các đồng phân giống nhau về khối lượng, và không bao gồm các đồng phân leucine/isoleucine, các số liệu này là 14% Và 38% (Anh ấy và cộng sự., J Proteome Res, 2004). Những peptit đồng phân đó không thể phân biệt được bằng khối lượng, và cần có phép đo phổ khối song song hoặc các hạn chế bổ sung khác.
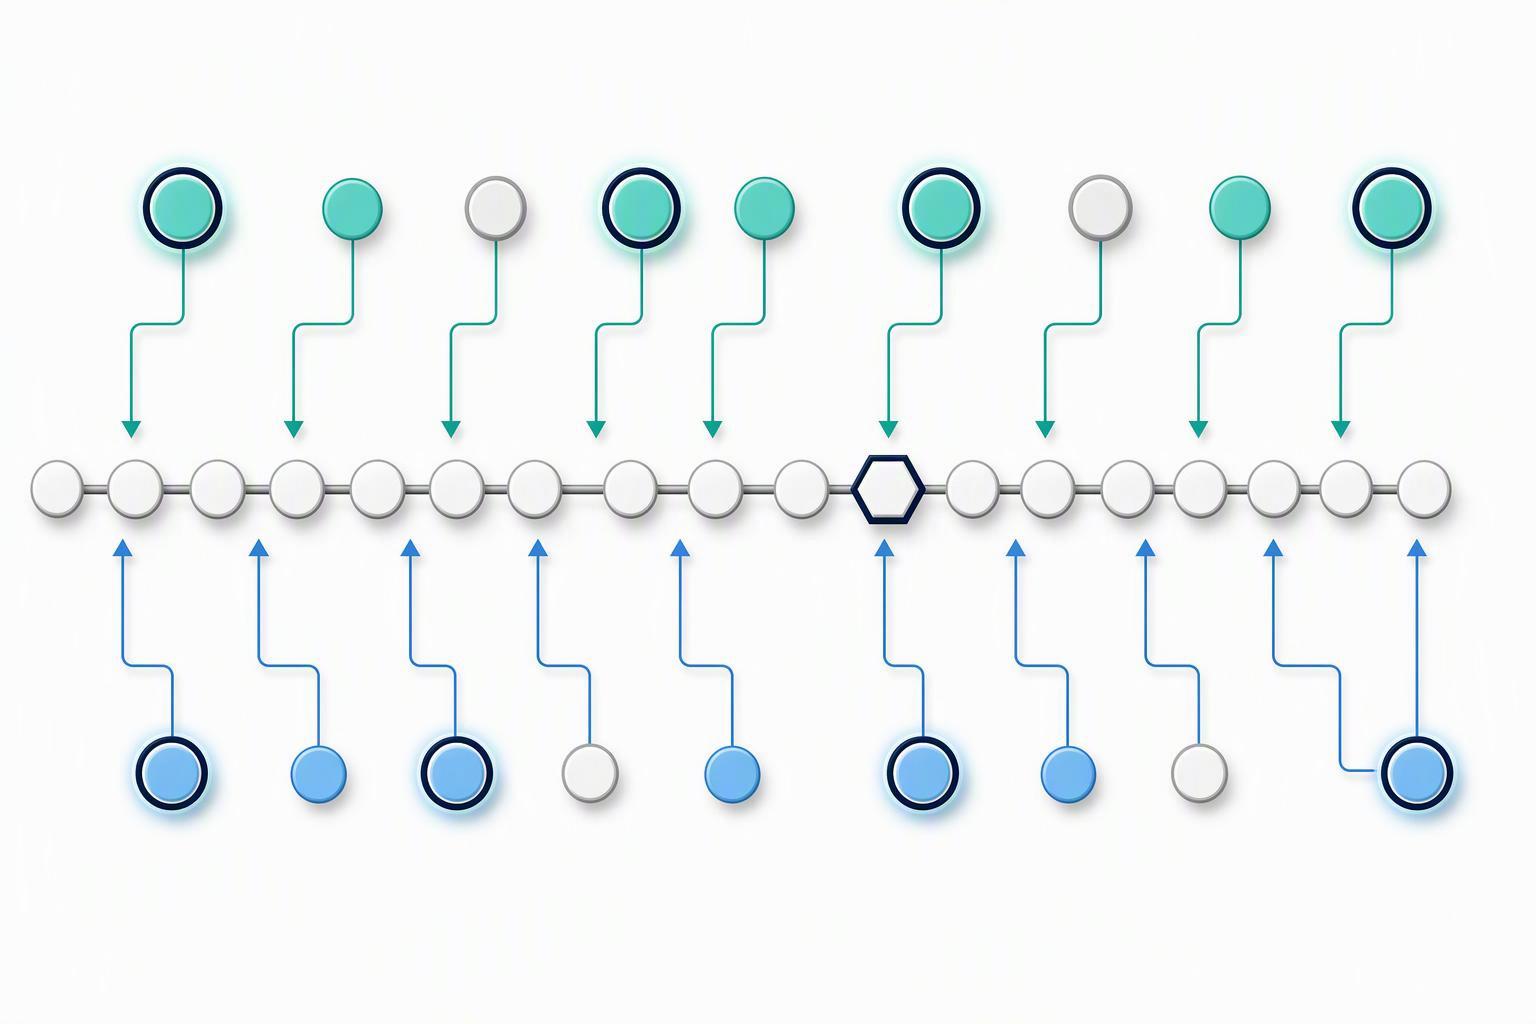
Điểm bản địa hóa hoạt động bằng cách so sánh các đoạn xác định địa điểm. Việc triển khai hiện tại so sánh peptidoform có điểm số cao nhất với dạng biến đổi tại một địa điểm với peptidoform có điểm số cao nhất mà không có nó, bỏ qua các đỉnh được chia sẻ vì chúng không cung cấp sự phân biệt đối xử, và thúc đẩy sự tự tin về nội địa hóa chỉ từ các đỉnh phân biệt đối xử (Nhà tiên tri PTM, 2019). Việc triển khai đó đã áp dụng nội địa hóa ở ngưỡng xác suất của iProphet là 0.9 cho hai tập dữ liệu và 0.8 cho một phần ba, cái sau tương ứng với 0.4% lỗi PSM ước tính và 97.9% Độ nhạy PSM, và báo cáo kết quả tại 5% tỷ lệ nội địa hóa sai trở xuống 1% FLR (Nhà tiên tri PTM, 2019).
Ngưỡng bản địa hóa cổ điển dựa trên điểm số và không được coi là tiêu chí chấp nhận chung. Điểm AS 19 tương ứng với p xấp xỉ 0.01, hoặc 99% sự chắc chắn, và sau đó thực hành phosphoproteomics từ cùng một phòng thí nghiệm đã sử dụng một phương pháp tự do hơn < 0.05, Điểm AS > 13; Spectrum Mill yêu cầu chênh lệch điểm lớn hơn 1.1 giữa hai bản địa hóa hàng đầu để bản địa hóa tự tin (Tính điểm bản địa hóa trang web sửa đổi, 2012). Đánh giá tương tự cảnh báo rằng điểm số dựa trên xác suất dựa trên một giả định phi thực tế rằng tất cả các khối lượng đều có khả năng được quan sát ngẫu nhiên như nhau., và khuyến nghị coi chúng là điểm số tuân theo ngưỡng do người dùng đặt thay vì là thước đo chính xác về độ chắc chắn.
Cảnh báo đó được xác nhận bằng cách chọn ngưỡng thực sự. PTTMrophet mô tả việc lựa chọn ngưỡng xác suất nội địa hóa phần lớn là sự lựa chọn tùy ý của người dùng., được đặt theo tỷ lệ lỗi mà người dùng chấp nhận (Nhà tiên tri PTM, 2019). Không có tiêu chuẩn nào sửa chữa một số, vì vậy động thái có thể phòng thủ là nêu rõ ngưỡng, cho biết tỷ lệ lỗi tương ứng với, và báo cáo tỷ lệ nội địa hóa cùng với tỷ lệ nhận dạng.
Đối với peptide được dán nhãn, sự thay đổi khối lượng nguyên vẹn dự kiến hỗ trợ chế phẩm được đề xuất nhưng không chứng minh được nhãn hóa học hoặc vị trí đính kèm. Sử dụng các đoạn xác định địa điểm và, khi cần thiết, một phương pháp cấu trúc trực giao để kiểm tra nhãn và liên kết được đề xuất.
Kỹ thuật trực giao nào trả lời câu hỏi nhận dạng nào?
Mỗi kỹ thuật trả lời một câu hỏi khác nhau, và việc lập bản đồ quan trọng hơn số lượng. các 2025 Hướng dẫn của Châu Âu về peptide tổng hợp, có hiệu lực từ tháng 6 2026, khuyến nghị sử dụng ít nhất hai phương pháp trực giao để nhận dạng như một phần của thông số kỹ thuật và phát hành, và liệt kê khối lượng, thời gian lưu tương đối, LC-MS, lập bản đồ peptit, hoạt tính sinh học, phân tích axit amin hoặc NMR khi thích hợp, với sự kết hợp cần thiết để xác nhận rõ ràng trình tự (EMA, Hướng dẫn phát triển và sản xuất peptide tổng hợp, 2025-12-04, hiệu quả 2026-06-01).
Logic điều chỉnh bên dưới dựa trên hiệu suất chứ không phải dựa trên số. Tôi quý 2(R2) yêu cầu nhận dạng để chứng minh khả năng phân biệt chất phân tích bằng các khía cạnh cấu trúc phân tử duy nhất, được xác nhận bằng kết quả dương tính với vật liệu tham chiếu cộng với kết quả âm tính từ các mẫu thiếu chất phân tích, và khi thủ tục không đủ khả năng phân biệt đối xử, nên sử dụng một thủ tục bổ sung (Tôi quý 2(R2), được thông qua 2023-11-01, đã sửa 2023-11-30). Yêu cầu về tính đặc hiệu là bài kiểm tra năng lực, không phải là số lượng bài kiểm tra.
Thực hành tiêu chuẩn tham khảo để nhận dạng peptide hội tụ theo cùng một hướng mà không cần sửa số: nhiều kỹ thuật trực giao thường được sử dụng để xác minh cấu trúc hóa học và nhận dạng hóa học, bao gồm cả thời gian lưu HPLC, NMR, Thử nghiệm MS và chirus, và các nghiên cứu đa phòng thí nghiệm sử dụng NMR, lập bản đồ peptit, Phân tích HPLC và axit amin (Nghiên cứu dược phẩm, 2023). Nhận dạng HPLC trong thực tiễn đó dựa vào việc so sánh thời gian lưu với tiêu chuẩn tham chiếu, đó là lý do tại sao thời gian lưu không có tiêu chuẩn không phải là kết quả nhận dạng.
Việc ánh xạ phương pháp đến câu hỏi Nhà cung cấp bán buôn peptide theo dõi từ các nguồn này:
|
Câu hỏi nhận dạng |
Kỹ thuật trả lời nó |
Những gì nó không trả lời |
|---|---|---|
|
Khối lượng nguyên vẹn có đúng không? |
Khối lượng nguyên vẹn LC-MS hoặc MALDI-TOF |
Sự liên tiếp, đặc điểm vị trí hoặc hóa học lập thể |
|
Trình tự có đúng không? |
MS/MS có phạm vi bao phủ chuỗi, hoặc ánh xạ peptit |
Sửa đổi không ổn định, khoảng trống bảo hiểm một phần |
|
Sửa đổi hoặc nhãn ở đâu? |
Các đoạn xác định vị trí MS/MS có ngưỡng nội địa hóa đã nêu |
Liệu trang web có phù hợp về mặt chức năng hay không Melittin |
|
Hóa học lập thể có đúng không? |
Phân tích chirus được xác nhận; chỉ phân tích thành phần axit amin thông thường không thiết lập được cấu trúc lập thể |
Vị trí sửa đổi |
|
Nó có cùng chất liệu với tiêu chuẩn không? Bán buôn peptide tùy chỉnh |
Thời gian lưu HPLC so với tiêu chuẩn tham chiếu |
Bất cứ điều gì bản thân tiêu chuẩn không thiết lập |
Thói quen xem xét COA trong việc giữ từng kết luận theo phương pháp của nó là phiên bản thực tế của bảng này: độ tinh khiết sắc ký mô tả tính đồng nhất của sắc ký và không thiết lập độc lập nhận dạng hóa học, khối lượng nguyên vẹn không thể thiết lập mọi trình tự, tính năng vị trí hoặc hóa học lập thể, và danh tính cũng như độ tinh khiết phải được báo cáo riêng biệt và gắn liền với các phương pháp hỗ trợ chúng (Phòng Thí Nghiệm Vector E, 2026-09-28).
Những gì phải được viết ra trước khi mua lại để có thể bảo vệ được yêu cầu nhận dạng?
Bản ghi phải đủ đầy đủ để người khác có thể chạy lại tìm kiếm tương tự hoặc tương tự trên cùng một công cụ hoặc công cụ khác. Định dạng trao đổi mang giao thức tìm kiếm yêu cầu SpectrumIdentificationProtocol để khai báo một loại tìm kiếm, chẳng hạn như tính điểm cấp độ peptide hoặc tính điểm nội địa hóa sửa đổi, yêu cầu các công cụ tìm kiếm phải được thể hiện trong danh sách phần mềm, và được thiết kế cho khả năng tái tạo chính xác đó (mzIdentML 1.3.0, Tháng sáu 2024).
Hồ sơ trước khi mua lại, được tập hợp từ các tiêu chuẩn báo cáo ở trên:
-
Chiến lược lựa chọn và các thông số của nó. Giá trị TopN, cửa sổ cách ly, thời hạn loại trừ động, và liệu danh sách loại trừ có được chuyển tiếp giữa các lần chạy hay không.
-
Dung sai. Tiền chất và dung sai khối lượng mảnh, được nêu dưới dạng số. các 2016 nghiên cứu sử dụng 10 trang/phút và 0.5 Và (Kreimer và cộng sự., J Proteome Res, 2016); độ chính xác ở cấp độ công cụ mà phương pháp phải phù hợp là dưới đây 3 ppm RMS kết thúc 24 h với hiệu chuẩn bên ngoài trở xuống 1 ppm RMS với hiệu chuẩn nội bộ trên nền tảng Orbitrap hiện tại (Bảng thông số kỹ thuật của Thermo Fisher, bảng nhà cung cấp hiện được xuất bản).
-
Công cụ tìm kiếm và phiên bản, cơ sở dữ liệu và phiên bản có số lượng mục nhập, và phương pháp ước lượng FDR. Tìm kiếm mồi nhử mục tiêu là cách được chấp nhận để phân biệt nhận dạng đúng và sai, và bởi vì hầu hết các công cụ tìm kiếm đều trả về kết quả ngay cả đối với những quang phổ không thể so sánh được, tỷ lệ lỗi phải được ước tính từ phân phối điểm (Elias & Gygi, Phương pháp tự nhiên, 2007). Độ tin cậy của mỗi peptide xuất phát từ mô hình xác suất tính toán xác suất mỗi phép gán là đúng, cho phép lọc với tỷ lệ lỗi có thể dự đoán được (Keller và cộng sự., hóa chất hậu môn, 2002).
-
Phương pháp chỉ định địa điểm và ngưỡng của nó, với quang phổ được chú thích cho mọi peptide nơi vị trí sửa đổi được báo cáo.
-
Sao chép cấu trúc. Số lần lặp lại, và liệu chúng có phải là sinh vật không, quy trình hoặc kỹ thuật.
-
Mã nhận dạng lưu trữ. Số nhận dạng PXD là liên tục, duy nhất và bắt buộc làm mã định danh chính cho các tập dữ liệu được gửi ban đầu, với siêu dữ liệu cộng với các tệp thô và tệp đã xử lý được gửi cùng nhau, và mã định danh RPXD cho các tập dữ liệu được phân tích lại (Hiệp hội ProteomeXchange, Nghiên cứu axit nucleic, 2026-01-06).
Nguyên tắc quyết định, áp dụng trước khi mua lại: nếu bạn không thể viết ra chiến lược lựa chọn, dung sai, các thông số tìm kiếm, ngưỡng nội địa hóa và cấu trúc sao chép trước, yêu cầu về danh tính sẽ không thể được bào chữa sau đó. Mỗi một lĩnh vực đó đều là một quyết định, và mỗi cái được làm trước khi chạy sẽ rẻ hơn so với việc xây dựng lại sau đó.
Câu hỏi thường gặp
Có phải mức độ trùng lặp kỹ thuật thấp có nghĩa là phương pháp của tôi kém?
Không nhất thiết. DDA thông thường chỉ chọn những tiền chất mạnh nhất trong mỗi chu kỳ, do đó, sự chồng chéo thấp giữa các lần lặp lại là hành vi lấy mẫu dự kiến chứ không phải là lỗi tái lập (Tabb và cộng sự., J Proteome Res, 2010). Câu hỏi cần đặt ra là thiết kế tái tạo nhằm mục đích chứng minh điều gì.
Tôi có thể trích dẫn được không 29% lấy con số làm chuẩn mực chung?
KHÔNG. Nó đến từ một 2016 nghiên cứu về LTQ Orbitrap XL với phân tích HeLa và 120 độ dốc tối thiểu (Kreimer và cộng sự., J Proteome Res, 2016). Trích dẫn nó với phạm vi đó kèm theo, hoặc phát biểu cơ chế một cách định tính.
Tôi nên đưa phạm vi trình tự nào vào thông số kỹ thuật?
Không tồn tại mức tối thiểu được cơ quan quản lý hỗ trợ. Nêu rõ ngưỡng bạn đã áp dụng, xác nhận rằng phạm vi bảo hiểm bao gồm dư lượng mang nhãn hiệu sửa đổi hoặc, và báo cáo các tham số tìm kiếm cho phép người đánh giá tái tạo phép tính.
Khối lượng còn nguyên vẹn có đủ để xác nhận danh tính không?
KHÔNG. Trong số các peptit khác nhau một, hai hoặc ba axit amin, 10%, 29% Và 53% có các đồng phân giống nhau về khối lượng (Anh ấy và cộng sự., J Proteome Res, 2004). Khối lượng là một phương pháp trực giao, không phải là một yêu cầu nhận dạng hoàn chỉnh.
Tôi có cần chính xác hai phương pháp trực giao không?
các 2025 Hướng dẫn của Châu Âu khuyến nghị ít nhất hai loại để nhận dạng peptide tổng hợp (EMA, hiệu quả 2026-06-01), trong khi ICH Q2(R2) đóng khung yêu cầu dựa trên tính đặc hiệu thay vì số lượng cố định (TÔI, 2023). Sự kết hợp phải xác nhận rõ ràng trình tự; con số theo sau từ đó.
Phần kết luận
Xác nhận danh tính được xây dựng trước khi mua lại, không theo sau nó. Chiến lược lựa chọn tiền chất quyết định peptide nào được lấy mẫu, thiết kế nhân rộng quyết định xem sự trùng lặp là thông tin hay ngẫu nhiên, báo cáo phạm vi bảo hiểm quyết định liệu dư lượng đã sửa đổi có thực sự nằm trong bằng chứng hay không, và đặc tính trực giao quyết định liệu yêu cầu bồi thường có tồn tại hay không người đánh giá biết rằng chỉ riêng khối lượng thôi đã khiến các đồng phân không được giải quyết.
Bước tiếp theo là hồ sơ trước khi mua lại: chiến lược lựa chọn, dung sai, thông số tìm kiếm, ngưỡng nội địa hóa, sao chép cấu trúc và mã định danh lưu trữ, được viết ra và kiểm soát phiên bản trước lần tiêm đầu tiên. Nếu thiếu bất kỳ trường nào, sửa nó trước khi chạy thay vì phản hồi cho người đánh giá.
Dành cho các nhóm so sánh phạm vi dịch vụ cho tùy chỉnh, peptide được sửa đổi và dán nhãn, yêu cầu một báo giá nêu rõ các thông số phân tích ở trên thay vì chỉ một con số về độ tinh khiết.
Các tiêu chuẩn phân tích và so sánh phương pháp được trích dẫn là các nguồn được xuất bản độc lập.*