Risposta rapida
Think of precursor selection as a sampling strategy rather than a detector setting. A detector reports what reaches it; the sampling strategy decides what gets…
Cosa cambia effettivamente nella selezione avanzata degli ioni precursori rispetto al TopN DDA convenzionale?
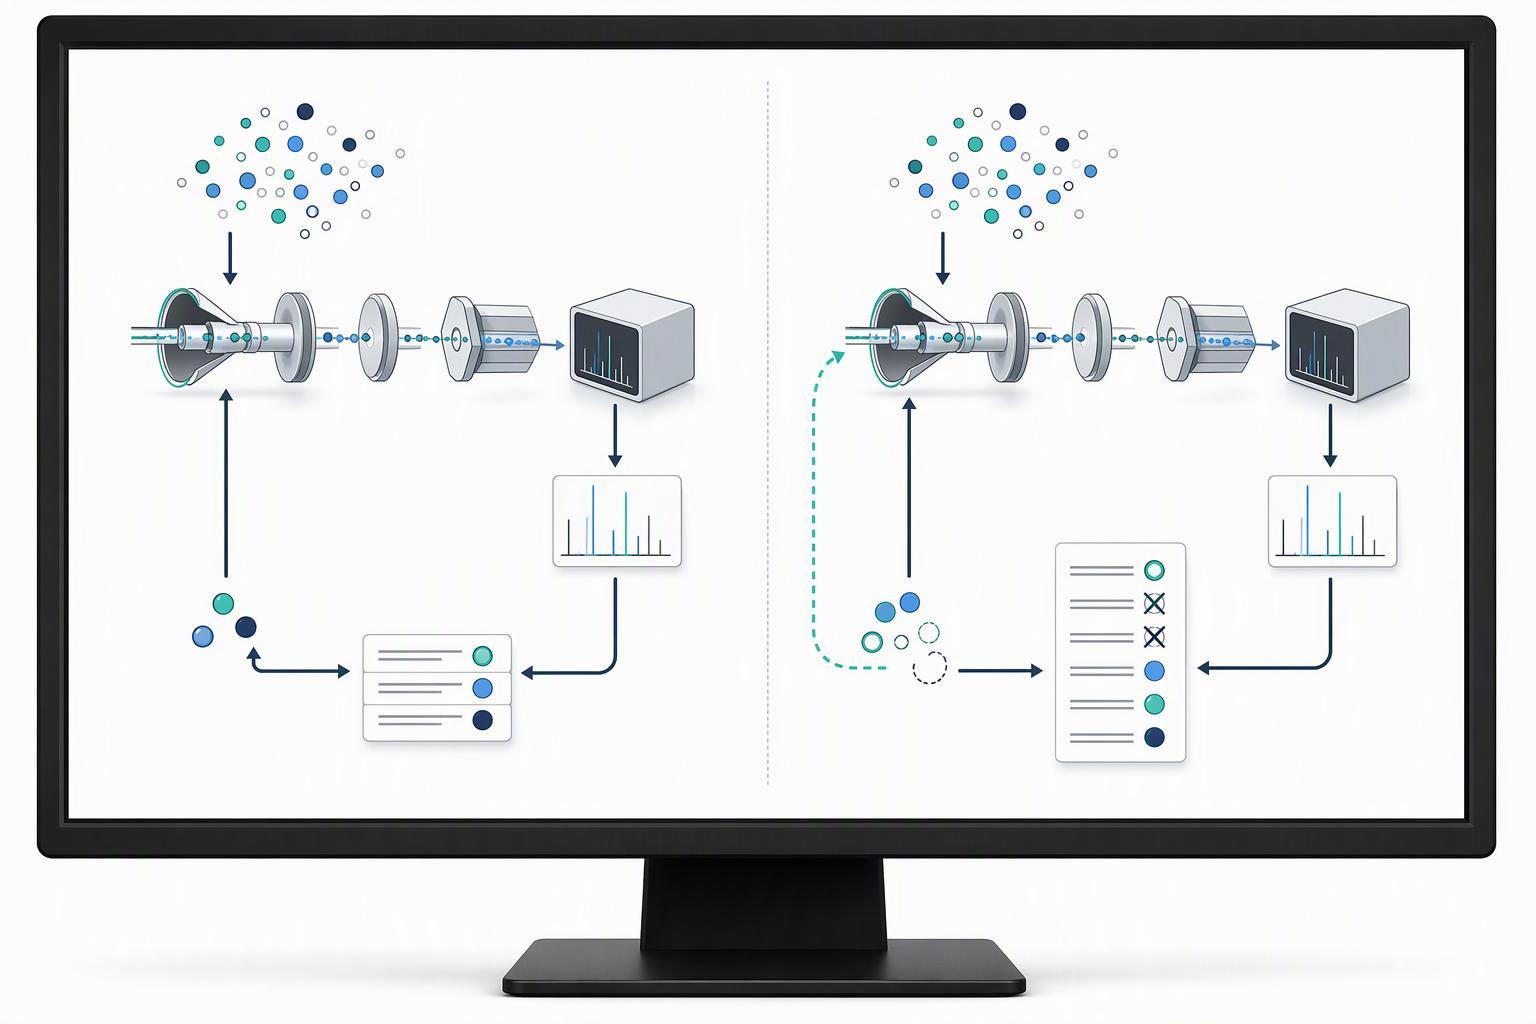
Peptide sintetico Ormoni della crescita dei peptidi Cambia il ciclo di campionamento, non il rilevatore. Il DDA TopN convenzionale seleziona gli N precursori idonei più intensi in ciascun ciclo MS1, e l'esclusione dinamica impedisce la riselezione immediata, quindi la selezione rimane in gran parte guidata dall'intensità e abbondanti peptidi vengono campionati ancora e ancora (Kreimer et al., J proteoma ris, 2016). Lo strumento funziona correttamente; la strategia continua semplicemente a tornare nello stesso quartiere.
Kreimer et al. hanno confrontato due strategie di esclusione iterativa: escludendo tutti i precursori precedentemente frammentati ed escludendo solo i peptidi identificati. Si tratta di progetti distinti con risultati diversi. Descrivi quale elenco di esclusione è stato utilizzato prima di quotare il guadagno, e mantenere l'ambito HeLa digest e LTQ Orbitrap XL dello studio. Studio originale.
Una terza variante spinge ulteriormente l’esclusione: la ricerca nel database in tempo reale durante l'acquisizione consente l'esclusione in base all'identità del peptide anziché in base a un evento m/z e temporale. I primi lavori di simulazione sulla selezione adattiva dei picchi hanno rilevato che questa aggiunta era al massimo di circa a 1% guadagno rispetto alla selezione standard dell'elenco di esclusione (arXiv prestampa 1207.5848, nd). Tratta quel numero come un risultato della simulazione, non un punto di riferimento, e non citarlo come risultato di uno strumento misurato.
Nel citato 2016 studio, la saturazione TopN convenzionale è vicina 12,500 peptidi unici era un'estrapolazione. Gli esperimenti combinati di esclusione iterativa sono stati superati 16,000 identificazioni. Il confronto illustra un campionamento complementare nell'ambito di tale disegno, non universale 29% guadagno rispetto a un controllo a esecuzione singola abbinato.
La ricerca di specie co-isolate può aumentare la profondità di identificazione nelle specie citate 2025 studio. Le percentuali riportate utilizzano confronti diversi e devono mantenere i propri denominatori; non dovrebbero essere combinati in una media che superi un intervallo stabilito o uniti con guadagni di esclusione iterativa.
La selezione del precursore influisce sulla prova della frammentazione acquisita. Una funzionalità non frammentata potrebbe essere ancora presente nei dati MS1; non può essere assegnata la confidenza della sequenza equivalente senza un'adeguata prova di supporto. Una ricerca migliorata può recuperare informazioni già presenti negli spettri acquisiti.
Perché la sovrapposizione della replica tecnica può essere bassa senza che il metodo sia irriproducibile?
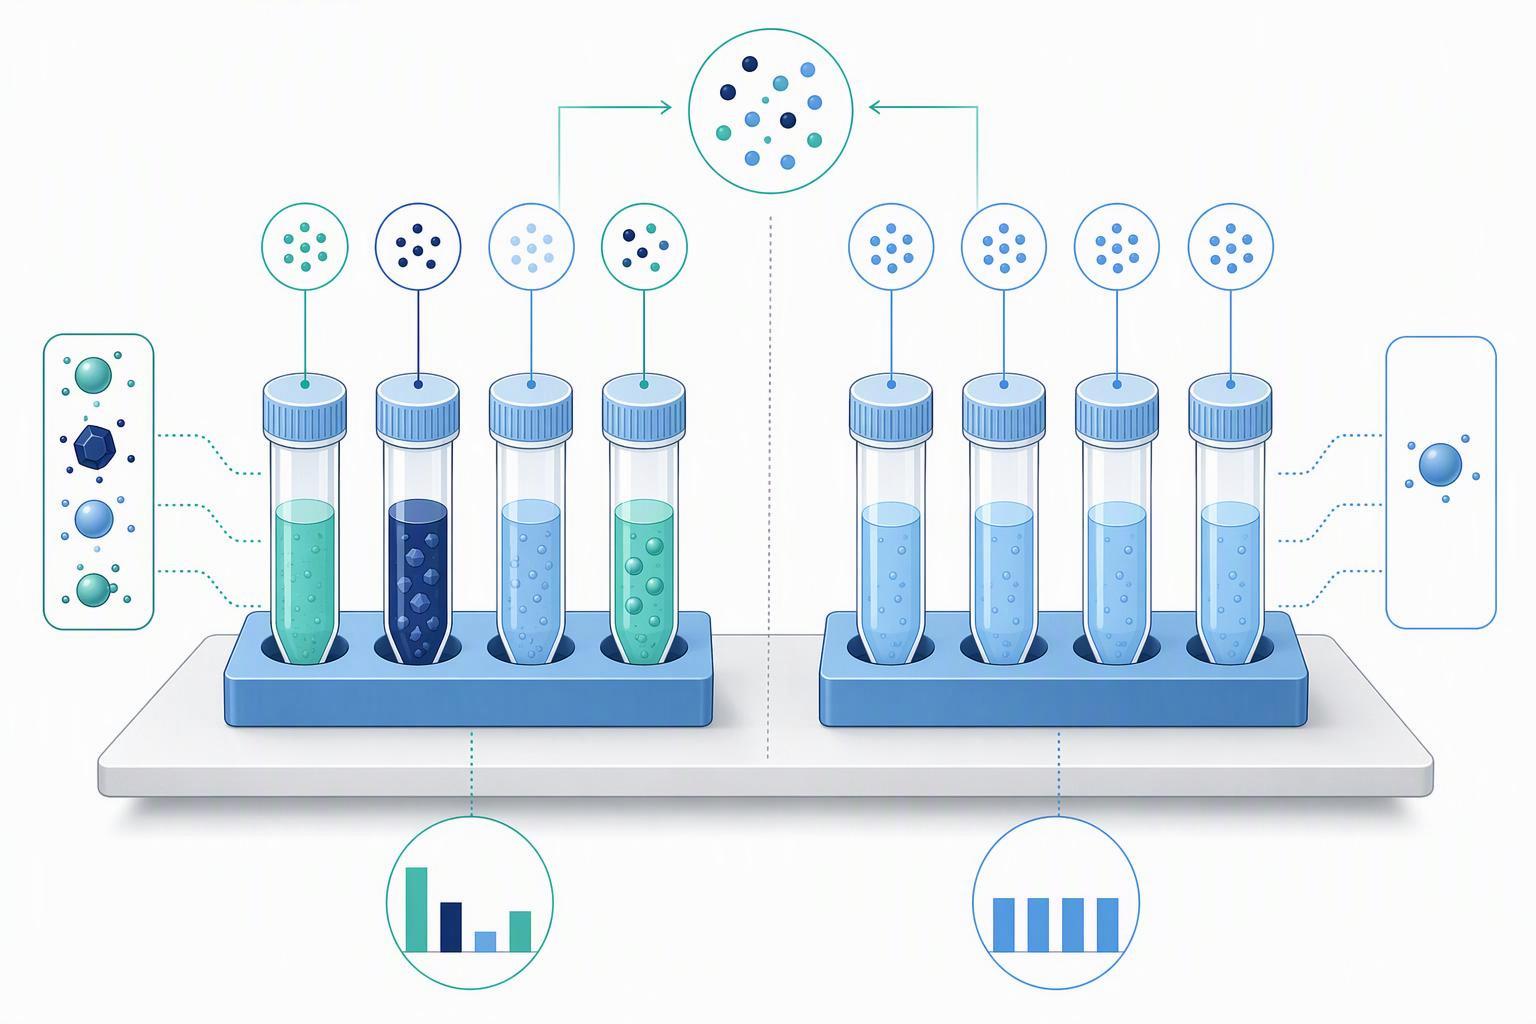
Perché la bassa sovrapposizione e la scarsa riproducibilità sono misurazioni diverse, e una progettazione approfondita può produrre il primo mentre il metodo rimane perfettamente ripetibile. L'intervallo di lunga data per la sovrapposizione dei peptidi replicati nel DDA convenzionale è del 35-60% tra coppie di replicati tecnici, una figura che deriva da a 2010 rianalisi su LTQ e strumenti Orbitrap più vecchi (Tabb et al., J proteoma ris, 2010). Dallo studio è inoltre emerso che la sovrapposizione era indipendente dalla complessità del campione: una miscela di 48 proteine ha fornito una mediana 44% sovrapposizione, una miscela standard di proteine 46%, e un digest di lievito 45% (Tabb et al., J proteoma ris, 2010). La ripetibilità era correlata all'intensità del precursore, quindi i peptidi a bassa abbondanza furono quelli che abbandonarono.
Questa è la distinzione fondamentale. Se il tuo progetto di replica mantiene costante il campione e non varia altro che l'iniezione, una bassa sovrapposizione significa che il metodo sta campionando stocasticamente, che è previsto per DDA. Se il tuo progetto ha lo scopo di dimostrare la riproducibilità, è necessario dichiarare cosa è mantenuto costante e cosa è variato, e la guida dell'autore MCP richiede esattamente questo: il numero di repliche acquisite con una chiara distinzione tra biologiche, processi e repliche tecniche, più il metodo e il tipo di randomizzazione, controlli tecnici, e l'intervallo di tempo dell'analisi del campione (Istruzioni MCP agli autori).
Due recenti esperimenti indipendenti mostrano quanto il problema della sovrapposizione dipenda dall'acquisizione. Un confronto diretto DDA-contro-DIA negli stessi campioni ha rilevato più di 92% di peptidi identificati in modo coerente tra le repliche nei dati DIA rispetto a meno di 77% nei dati DDA, con consistenza a livello proteico di 99.0/98.2/98.2% per DIA contro 95.6/95.4/96.2% per la DDA (PMC12801617, 2025). Un confronto di completezza di otto repliche nel liquido lacrimale ha rilevato che DIA è pari a 78.5% completezza peptidica rispetto a 48% per la DDA, con CV mediano di 10.6% E 22.3% rispettivamente (J Mass Spectrom Adv Clin Lab, 2025). Due metriche diverse, consistenza presenza/assenza e coefficiente di variazione, puntare allo stesso modo.
Il divario onesto: nessuna fonte in questo set rimisura il 2010 figura di sovrapposizione sulla strumentazione attuale. L'intervallo 35–60% dovrebbe essere datato ogni volta che viene citato, e le prove DIA-contro-DDA riguardano solo le linee cellulari e il liquido lacrimale. Nessuna fonte qui confronta le due modalità su un fosfoproteoma o un altro campione arricchito con PTM, quindi qualsiasi affermazione sul DIA rispetto al DDA per i peptidi modificati non sarebbe supportata.
Prima dell'acquisizione, distinguere un progetto approfondito da uno studio di ripetibilità. Una bassa sovrapposizione dopo l'esclusione deliberata può indicare un campionamento complementare, ma controlla anche la confidenza dell'identificazione, copertura totale e qualità del campione; la sola bassa sovrapposizione non dimostra che la strategia funziona.
Quanta copertura della sequenza è sufficiente, e dove deve cadere la copertura?
Definire la metrica di copertura prima di impostare un criterio. La copertura della sequenza proteica conta i residui rappresentati dai peptidi identificati; la copertura di frammenti ionici di un peptide sintetico è una misura diversa. Nessuna delle due percentuali da sola stabilisce l'ordine dei residui, posizione di modifica o stereochimica. Impostare gli ioni diagnostici e i test ortogonali richiesti per il costrutto.
La regola di posizionamento deriva da tale definizione. Per un peptide modificato o marcato, la copertura deve comprendere il residuo che riporta la modifica o l'etichetta. UN 95% mappa di copertura che lascia scoperto il sito modificato 5% non supporta una rivendicazione di identità specifica del sito, non importa quanto alta sia la percentuale.
Questa è la pratica del venditore, non una soglia normativa, e dovrebbe essere etichettato come tale in qualsiasi specifica che scrivi.
Ciò a cui un revisore può effettivamente obbligarti è il set di reporting. La guida del giornale a cui un lettore può essere tenuto richiede tolleranze di massa degli ioni precursori e degli ioni frammento, il motore di ricerca e la versione, la banca dati, il metodo di stima FDR, e il software o il metodo utilizzato per valutare l'assegnazione del sito di modifica, con spettri annotati per ogni peptide in cui è riportato un sito di modifica (Tutorial MCP per l'invio dei dati di proteomica, Guida per l'autore MCP). L'elenco di controllo delle informazioni minime aggiunge il nome del software, versione e produttore, database interrogati con versioni e conteggi di voci, e i file dei parametri (MIAPE-MSI 1.1, 2008-02-05). MIAPE è il 2008 checklist e rimane alla versione 1.1; non è un requisito nuovo.
Quindi la risposta pratica alla domanda “quale numero di copertura accetterà un revisore” è: indica la soglia che hai applicato, stato in cui la copertura cade rispetto a Peptide semaglutide il residuo modificato, e riportare i parametri che permettono a qualcuno di riprodurre il calcolo. Un numero senza queste tre cose non è difendibile.
Come localizzare una modifica o un'etichetta invece di limitarsi a confermare la massa intatta??
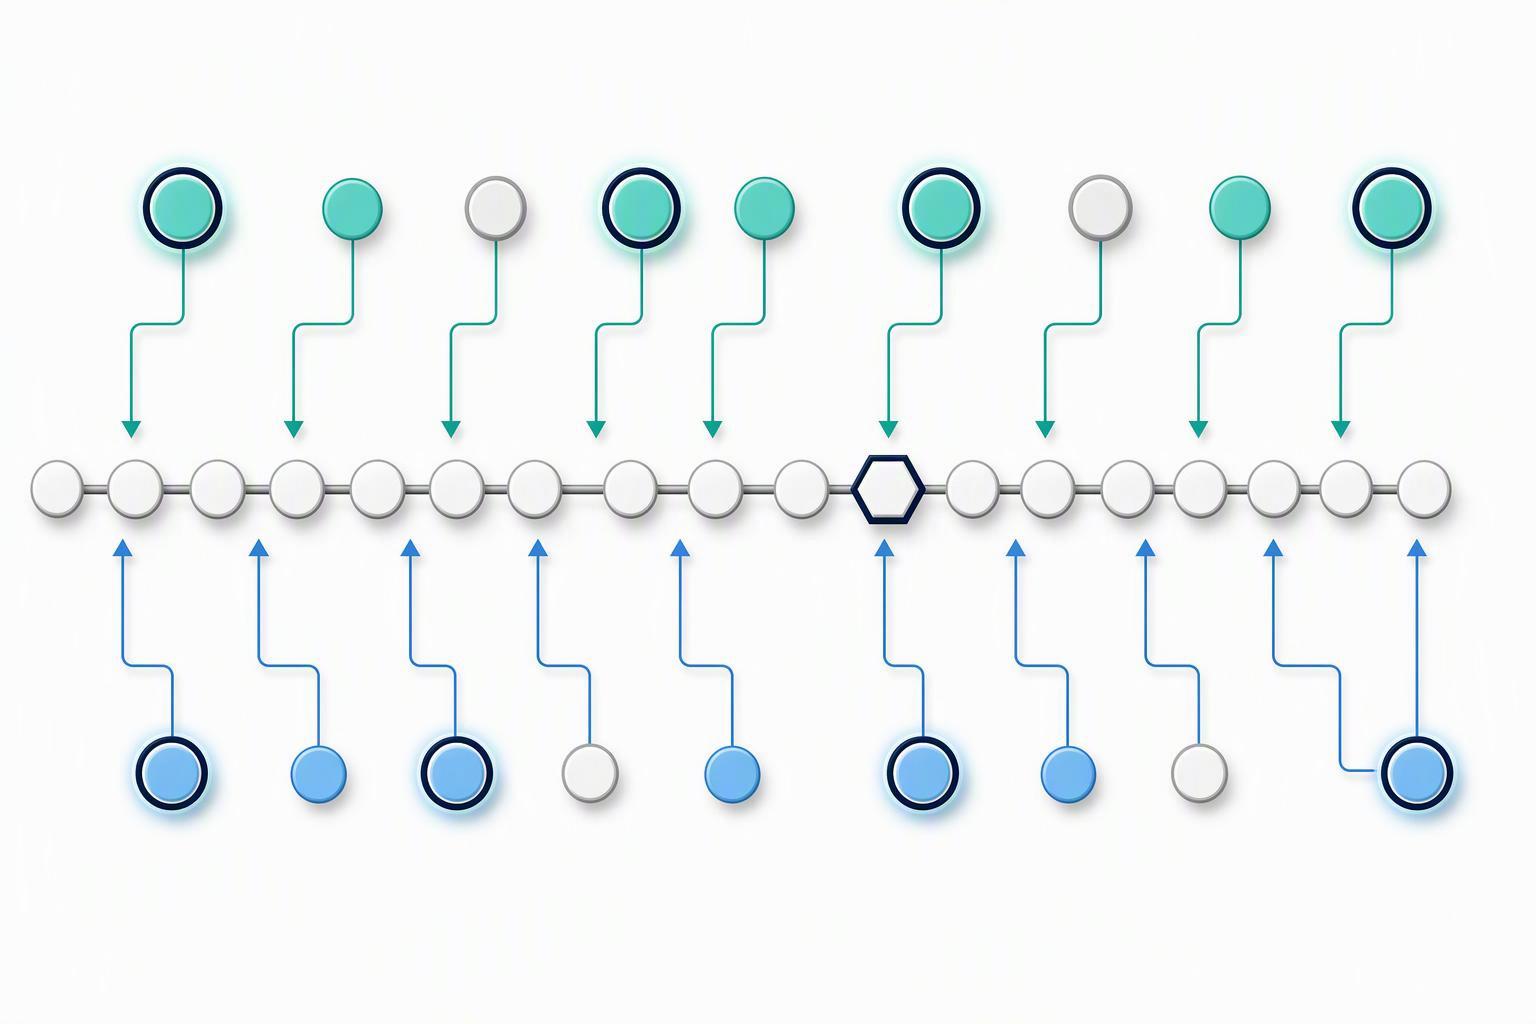
La localizzazione è una misurazione separata dall'identificazione, con il proprio punteggio, la propria soglia e il proprio tasso di errore. La base combinatoria per cui la massa da sola non può chiudere una rivendicazione di identità è vecchia e solida: tra peptidi che differiscono nella composizione di uno, due o tre amminoacidi, 10%, 29% E 53% rispettivamente hanno isomeri identici in massa, ed escludendo gli isomeri di leucina/isoleucina i dati lo sono 14% E 38% (Lui et al., J proteoma ris, 2004). Questi peptidi isomerici non possono essere distinti in base alla massa, e sono necessari la spettrometria di massa tandem o altri vincoli aggiuntivi.
I punteggi di localizzazione funzionano confrontando i frammenti che determinano il sito. Un'implementazione attuale confronta il peptidoforma con il punteggio migliore con la modifica in un sito con il peptidoforma con il punteggio migliore senza di essa, ignora i picchi condivisi perché non forniscono alcuna discriminazione, e guida la fiducia nella localizzazione solo dai picchi discriminanti (PTMProfeta, 2019). Tale implementazione applicava la localizzazione alle soglie di probabilità di iProphet di 0.9 per due set di dati e 0.8 per un terzo, quest'ultimo corrispondente a 0.4% errore PSM stimato e 97.9% Sensibilità PSM, e riportato i risultati a 5% tasso di falsa localizzazione e inferiore 1% FLR (PTMProfeta, 2019).
Le soglie di localizzazione classiche sono basate sul punteggio e non dovrebbero essere trattate come criteri di accettazione universali. Punteggio 19 corrisponde a p circa 0.01, O 99% certezza, e successivamente la pratica della fosfoproteomica dello stesso laboratorio ha utilizzato un p < 0.05, Punteggio > 13; Spectrum Mill richiede una differenza di punteggio maggiore di 1.1 tra le prime due localizzazioni per una localizzazione sicura (Punteggio di localizzazione del sito di modifica, 2012). La stessa revisione avverte che i punteggi basati sulla probabilità si basano sul presupposto non realistico che tutte le masse abbiano la stessa probabilità di essere osservate in modo casuale, e raccomanda di trattarli come punteggi soggetti a una soglia stabilita dall'utente piuttosto che come misure accurate di certezza.
Tale avvertimento è confermato dal modo in cui vengono effettivamente scelte le soglie. PTMProphet descrive la selezione della soglia di probabilità di localizzazione come una scelta in gran parte arbitraria fatta dall'utente, essere impostato in base al tasso di errore accettato dall'utente (PTMProfeta, 2019). Nessuno standard fissa un numero, quindi la mossa difendibile è dichiarare la soglia, indicare il tasso di errore a cui corrisponde, e riportare il tasso di localizzazione insieme al tasso di identificazione.
Per un peptide marcato, uno spostamento di massa intatto previsto supporta una composizione proposta ma non dimostra la chimica dell'etichetta o il sito di attacco. Utilizzare frammenti che determinano il sito e, dove necessario, un metodo strutturale ortogonale per testare l'etichetta e il collegamento proposti.
Quale tecnica ortogonale risponde a quale domanda di identità?
Ogni tecnica risponde a una domanda diversa, e la mappatura conta più del conteggio. IL 2025 Linee guida europee per i peptidi sintetici, in vigore da giugno 2026, raccomanda l'uso di almeno due metodi ortogonali per l'identificazione come parte della specifica e del rilascio, ed elenca la massa, relativo tempo di ritenzione, LC-MS, mappatura peptidica, bioattività, analisi degli amminoacidi o NMR, a seconda dei casi, con la combinazione richiesta per confermare inequivocabilmente la sequenza (EMA, Linee guida sullo sviluppo e la produzione di peptidi sintetici, 2025-12-04, efficace 2026-06-01).
La logica normativa sottostante è basata sulle prestazioni piuttosto che numerica. Io Q2(R2) richiede l'identificazione per dimostrare la capacità di distinguere l'analita in base ad aspetti unici della struttura molecolare, confermato da risultati positivi rispetto a un materiale di riferimento più risultati negativi da campioni privi dell'analita, e quando una procedura non è sufficientemente discriminante, dovrebbe essere utilizzata una procedura aggiuntiva (Io Q2(R2), adottato 2023-11-01, corretto 2023-11-30). Il requisito di specificità è un test di capacità, non un conteggio dei test.
La pratica standard di riferimento per l'identità peptidica converge nella stessa direzione senza fissare un numero: più tecniche ortogonali vengono generalmente utilizzate per verificare la struttura chimica e l'identità chimica, compreso il tempo di ritenzione dell'HPLC, RMN, MS e test chirali, e gli studi multilaboratorio utilizzano la NMR, mappatura peptidica, Analisi HPLC e aminoacidi (Ricerca farmaceutica, 2023). L'identità dell'HPLC in tale pratica si basa sul confronto del tempo di ritenzione rispetto a uno standard di riferimento, ecco perché un tempo di ritenzione senza standard non è un risultato identitario.
Il metodo per fare una domanda lo mappa Fornitore all'ingrosso di peptidi deriva da queste fonti:
|
Domanda sull'identità |
Tecnica che risponde |
A cosa non risponde |
|---|---|---|
|
La massa intatta è corretta?? |
Massa intatta LC-MS o MALDI-TOF |
Sequenza, caratteristiche posizionali o stereochimiche |
|
La sequenza è corretta?? |
MS/MS con copertura di sequenza, o mappatura peptidica |
Modifiche labili, lacune di copertura parziale |
|
Dov'è la modifica o l'etichetta? |
Frammenti che determinano il sito MS/MS con una soglia di localizzazione dichiarata |
Se il sito è funzionalmente rilevante Melittino |
|
La stereochimica è corretta?? |
Analisi chirale validata; l'analisi ordinaria della composizione degli amminoacidi da sola non stabilisce la stereochimica |
Posizione di una modifica |
|
È lo stesso materiale dello standard? Vendita all'ingrosso di peptidi personalizzati |
Tempo di ritenzione HPLC rispetto a uno standard di riferimento |
Tutto ciò che la norma stessa non stabilisce |
L'abitudine della revisione del COA di mantenere ogni conclusione con il proprio metodo è la versione pratica di questa tabella: la purezza cromatografica descrive l'omogeneità cromatografica e non stabilisce in modo indipendente l'identità chimica, la massa intatta da sola potrebbe non stabilire ogni sequenza, caratteristica posizionale o stereochimica, e l'identità e la purezza dovrebbero essere riportate separatamente e allegate ai metodi che le supportano (Laboratorio vettoriale E, 2026-09-28).
Cosa deve essere scritto prima dell'acquisizione affinché la rivendicazione dell'identità sia difendibile?
Il record deve essere sufficientemente completo da consentire a qualcun altro di eseguire nuovamente la stessa ricerca o una simile sullo stesso o su un altro motore. Il formato di scambio che trasporta il protocollo di ricerca richiede che SpectrumIdentificationProtocol dichiari un tipo di ricerca come il punteggio a livello di peptide o il punteggio di localizzazione della modifica, richiede che i motori di ricerca siano rappresentati nell'elenco dei software, ed è progettato esattamente per quella riproducibilità (mzIdentML 1.3.0, Giugno 2024).
Il registro pre-acquisizione, assemblati in base agli standard di rendicontazione di cui sopra:
-
Strategia di selezione e suoi parametri. Valore TopN, finestra di isolamento, durata dell'esclusione dinamica, e se un elenco di esclusione viene portato avanti tra le esecuzioni.
-
Tolleranze. Tolleranza alla massa dei precursori e dei frammenti, indicati come numeri. IL 2016 studio utilizzato 10 ppm e 0.5 E (Kreimer et al., J proteoma ris, 2016); la precisione a livello di strumento a cui deve essere abbinato il metodo è inferiore 3 ppm RMS oltre 24 h con calibrazione esterna e inferiori 1 ppm RMS con calibrazione interna su attuale piattaforma Orbitrap (Scheda tecnica Thermo Fisher, scheda fornitore attualmente pubblicata).
-
Motore di ricerca e versione, database e versione con conteggio delle voci, e il metodo di stima FDR. La ricerca dell'esca del bersaglio è il modo accettato per distinguere le identificazioni corrette da quelle errate, e perché la maggior parte dei motori di ricerca restituisce risultati anche per spettri ineguagliabili, i tassi di errore devono essere stimati dalla distribuzione dei punteggi (Elia & Gygi, Metodi naturali, 2007). La fiducia per peptide deriva da un modello probabilistico che calcola la probabilità che ogni assegnazione sia corretta, consentendo il filtraggio con tassi di errore prevedibili (Keller et al., Chimica anale, 2002).
-
Il metodo di assegnazione del sito e la relativa soglia, con spettri annotati per ogni peptide in cui è riportato un sito di modifica.
-
Replicare la struttura. Numero di repliche, e se sono biologici, processo o tecnico.
-
L'identificatore dell'archivio. Gli identificatori PXD sono persistenti, univoco e obbligatorio come identificatore principale per i set di dati originariamente presentati, con metadati più file grezzi ed elaborati depositati insieme, e identificatori RPXD per set di dati rianalizzati (Consorzio ProteomeXchange, Ricerca sugli acidi nucleici, 2026-01-06).
La regola decisionale, applicata prima dell'acquisizione: se non puoi scrivere la strategia di selezione, le tolleranze, i parametri di ricerca, la soglia di localizzazione e la struttura di replica in anticipo, la rivendicazione dell'identità non sarà più difendibile in seguito. Ognuno di questi campi è una decisione, ed è più economico realizzarli prima della corsa che ricostruirli dopo.
Domande frequenti
La bassa sovrapposizione di replica tecnica significa che il mio metodo non è valido?
Non necessariamente. Il DDA convenzionale seleziona solo i precursori più intensi in ogni ciclo, una sovrapposizione così bassa tra le repliche è un comportamento di campionamento previsto piuttosto che un errore di riproducibilità (Tabb et al., J proteoma ris, 2010). La domanda da porsi è cosa intendeva dimostrare il progetto replicato.
Posso citare il 29% figurare come punto di riferimento generale?
NO. Viene da uno 2016 studio su un LTQ Orbitrap XL con un digest HeLa e a 120 gradiente minimo (Kreimer et al., J proteoma ris, 2016). Citarlo con l'ambito allegato, o dichiarare qualitativamente il meccanismo.
Quale copertura di sequenza dovrei inserire in una specifica?
Non esiste un minimo garantito dal regolatore. Indica la soglia che hai applicato, confermare che la copertura include il residuo recante la modifica o l'etichetta, e riportare i parametri di ricerca che consentono a un revisore di riprodurre il calcolo.
La massa intatta è sufficiente per confermare l'identità?
NO. Tra i peptidi che differiscono per uno, due o tre amminoacidi, 10%, 29% E 53% hanno isomeri identici in massa (Lui et al., J proteoma ris, 2004). La massa è un metodo ortogonale, non una rivendicazione di identità completa.
Ho bisogno esattamente di due metodi ortogonali?
IL 2025 Le linee guida europee ne raccomandano almeno due per l'identificazione dei peptidi sintetici (EMA, efficace 2026-06-01), mentre ICH Q2(R2) inquadra il requisito come basato sulla specificità piuttosto che come conteggio fisso (IO, 2023). La combinazione deve confermare inequivocabilmente la sequenza; il numero segue da quello.
Conclusione
La rivendicazione dell'identità viene costruita prima dell'acquisizione, non dopo. Precursor-selection strategy decides which peptides get sampled, replicate design decides whether overlap is informative or accidental, coverage reporting decides whether the modified residue is actually inside the evidence, and orthogonal characterization decides whether the claim survives a reviewer who knows that mass alone leaves isomers unresolved.
The next step is a pre-acquisition record: selection strategy, tolerances, search parameters, localization threshold, replicate structure and archive identifier, written down and version-controlled before the first injection. If any field is missing, fix it before the run rather than in the response to a reviewer.
For teams comparing service scopes for custom, modified and labeled peptides, request a quotation that states the analytical parameters above rather than a purity figure alone.
Gli standard analitici e i confronti tra metodi citati sono fonti pubblicate indipendenti.*