簡単な回答
Think of precursor selection as a sampling strategy rather than a detector setting. A detector reports what reaches it; the sampling strategy decides what gets…
高度なプリカーサーイオン選択は従来の TopN DDA と比べて実際に何が変わりますか?
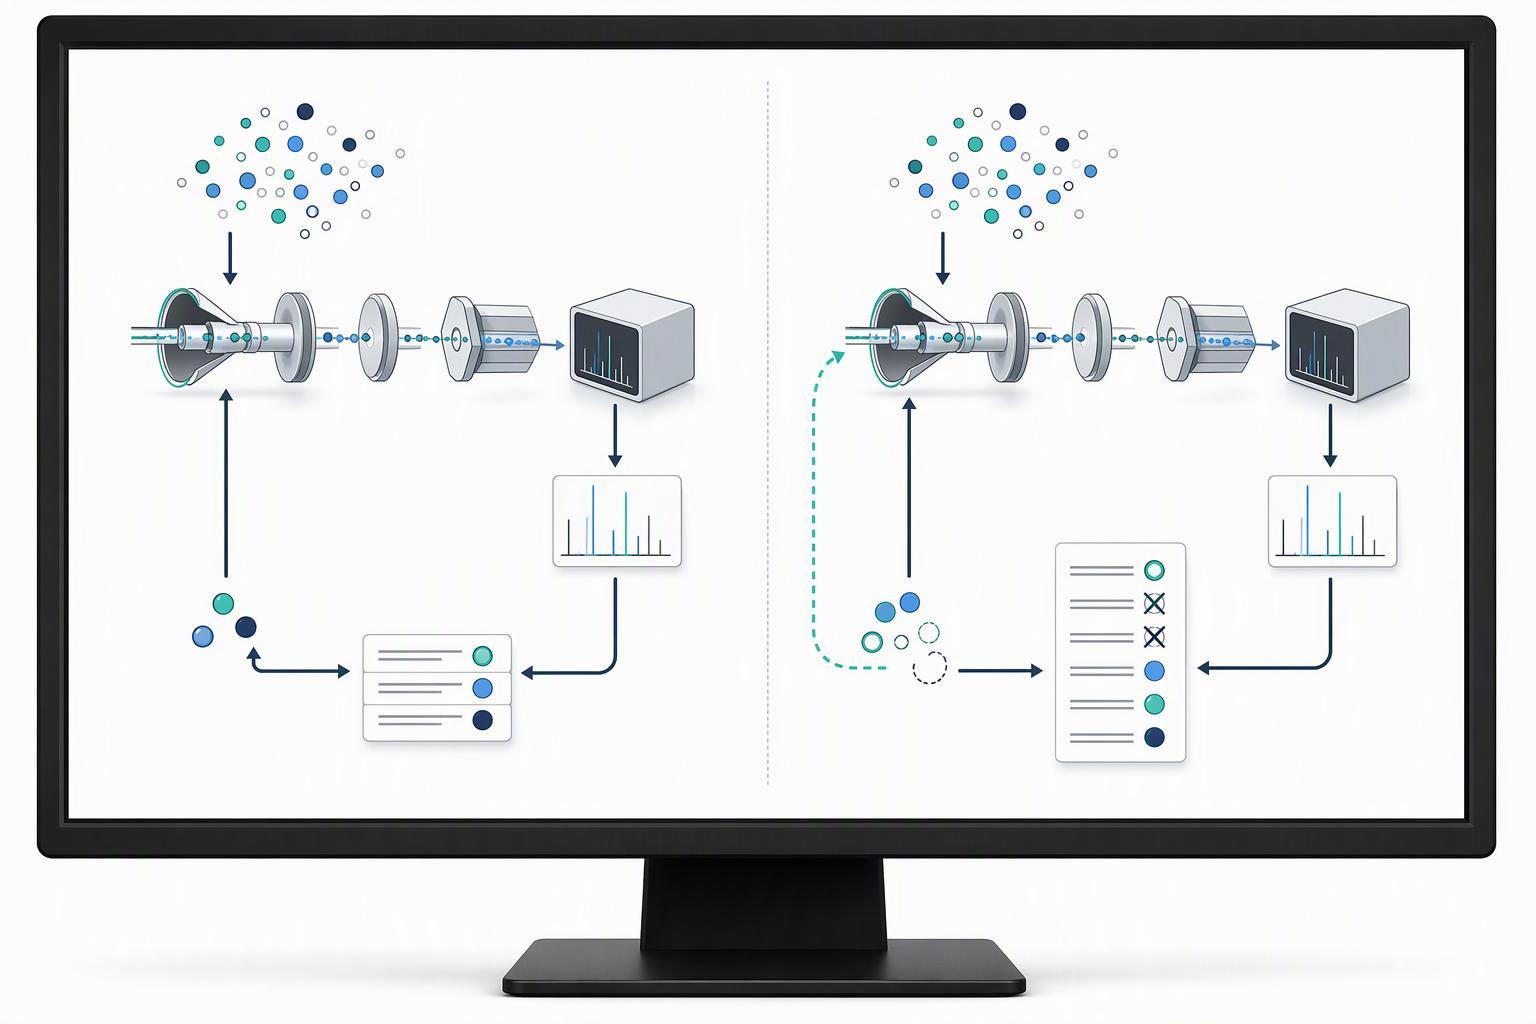
合成ペプチド ペプチド 成長ホルモン サンプリングループを変更します, 検出器ではありません. 従来の TopN DDA は、各 MS1 サイクルで N 個の最も強度の高い適格な前駆体を選択します, 動的除外により、即時の再選択が防止されます。, そのため、選択は主に強度に基づいて行われ、豊富なペプチドが何度もサンプリングされます。 (クライマーら。, J プロテオーム解析, 2016). 機器は正しく動作しています; 戦略は単に同じ地域に戻り続けるだけです.
クライマーら. 2 つの反復排除戦略を比較した: 以前に断片化されたすべての前駆体を除外し、同定されたペプチドのみを除外します。. これらは異なる結果をもたらす異なるデザインです. ゲインを引用する前に、どの除外リストが使用されたかを説明します, 研究の HeLa ダイジェストと LTQ Orbitrap XL スコープを保持します. 独自の研究.
3 番目の亜種は除外をさらに推し進めます: 取得中のリアルタイムデータベース検索により、m/z や時間イベントではなくペプチドのアイデンティティによる除外が可能. 適応ピーク選択に関する初期のシミュレーション作業では、これが追加されるのは最大でも約 1 時間であることがわかりました。 1% 標準の除外リストの選択よりも優れています (arXiv プレプリント 1207.5848, ND). その数値をシミュレーション結果として扱います, ベンチマークではない, 測定された機器の結果として引用しないでください。.
引用された中で 2016 勉強, 従来のTopN飽和度に近い 12,500 ユニークなペプチドは外挿でした. 反復排除実験の組み合わせは次の値を超えました 16,000 身分証明書. この比較は、その設計の下での相補的なサンプリングを示しています。, 普遍的ではない 29% 一致する単一実行コントロールに対するゲイン.
共分離種を検索すると、引用文献の識別の深さが増す可能性があります。 2025 勉強. 報告されるパーセンテージは異なる比較を使用し、独自の分母を保持する必要があります。; 指定された範囲を超える平均値に結合したり、反復除外ゲインと結合したりしないでください。.
前駆体の選択は、どの断片化証拠が取得されるかに影響します. MS1 データには断片化されていない特徴がまだ存在する可能性があります; 適切な裏付け証拠がなければ、同等の配列信頼度を割り当てることはできません. 改良された検索により、取得したスペクトルにすでに存在する情報を回復できます.
手法が再現不可能でなくても、技術的な複製の重複が少ないのはなぜですか?
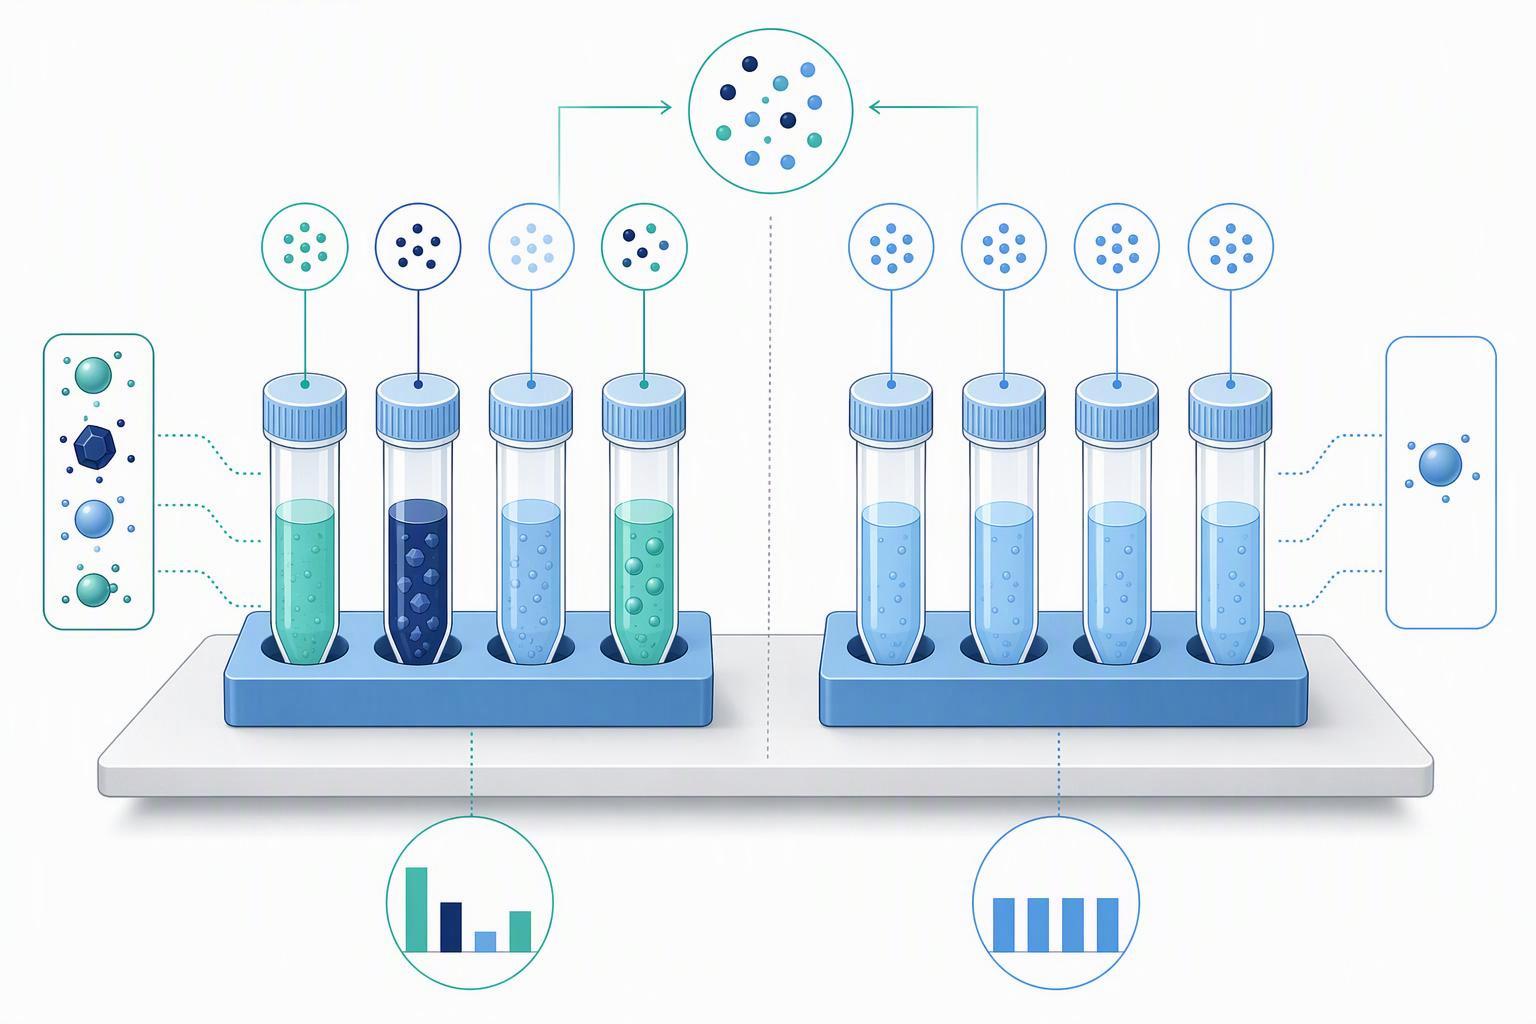
オーバーラップが少ないことと再現性が低いことは異なる測定値であるため, そして、発見の深さの設計により、メソッドが完全に再現可能でありながら、最初の結果を生み出すことができます。. 従来の DDA におけるレプリケートペプチドの重複の長年にわたる範囲は、技術的レプリケートのペア間で 35 ~ 60% でした。, から来る数字 2010 LTQ および古い Orbitrap 機器の再分析 (タブら。, J プロテオーム解析, 2010). この研究では、重複がサンプルの複雑さと無関係であることも判明しました: 48 種類のタンパク質の混合物から中央値が得られる 44% 重なり合う, タンパク質標準混合物 46%, そしてイーストダイジェスト 45% (タブら。, J プロテオーム解析, 2010). 再現性とプリカーサー強度の相関, 存在量の少ないペプチドが脱落した.
それが重要な違いです. 複製デザインがサンプルを一定に保ち、注入のみを変化させる場合, オーバーラップが低いということは、メソッドが確率的にサンプリングされていることを意味します, DDA に期待されること. デザインが再現性を示すことを目的としている場合, 何が一定で何が変化するのかを述べる必要がある, MCP 作成者のガイダンスでは、まさにそれが必要です。: 生物学的データと生物学的データを明確に区別して取得された複製の数, プロセスと技術の複製, 加えて、ランダム化の方法と種類, 技術的制御, およびサンプル分析の期間 (著者に対する MCP の指示).
最近の 2 つの独立した実験は、オーバーラップ問題のどの程度が取得に依存しているかを示しています. 同じサンプルでの DDA と DIA の直接比較では、 92% DIA データの複数の反復にわたって一貫して同定されたペプチドの数とそれ未満のペプチドの数 77% DDA データ内, タンパク質レベルの一貫性を備えた 99.0/98.2/98.2% DIAに対する 95.6/95.4/96.2% DDA用 (PMC12801617, 2025). 涙液における 8 回の反復の完全性比較により、DIA は 78.5% ペプチドの完全性と 48% DDA用, CVの中央値は 10.6% そして 22.3% それぞれ (J マススペクトル Adv Clin Lab, 2025). 2 つの異なる指標, 存在/不在の一貫性と変動係数, 同じ方向を指す.
正直なギャップ: このセットには、再測定を行うソースはありません。 2010 現在の計装上の図と重なる. 35 ~ 60% の範囲を引用する場合は常に日付を記入する必要があります, DIA 対 DDA の証拠は細胞株と涙液のみを対象としています. ここには、リンプロテオームまたは他の PTM が豊富なサンプルで 2 つのモードを比較する情報源はありません。, したがって、修飾ペプチドの DIA と DDA に関するいかなる主張も支持されないことになります。.
取得前, 発見深度設計と再現性調査を区別する. 意図的な除外後の重複が少ない場合は、補完的なサンプリングを示している可能性があります, ただし、識別の信頼性もチェックします, 総合的なカバレッジとサンプルの品質; 重複が少ないだけでは戦略が機能していることを証明できない.
どのくらいの配列カバレッジがあれば十分ですか, そして補償範囲はどこにあるのか?
基準を設定する前にカバレッジ指標を定義する. タンパク質配列カバレージは、同定されたペプチドによって表される残基をカウントします; 合成ペプチドのフラグメントイオンカバレッジは別の尺度です. どちらのパーセンテージだけでは剰余順序を確立することはできません, 修飾位置または立体化学. コンストラクトに必要な診断イオンと直交テストを設定します.
配置ルールはその定義に従います. 修飾または標識されたペプチドの場合, 適用範囲には、修飾またはラベルを保持する残基が含まれている必要があります. あ 95% 変更されたサイトをカバーしないままにするカバレッジ マップ 5% サイト固有の ID 要求はサポートされていません, どんなに割合が高く見えても.
それがベンダーの慣例です, 規制基準ではない, そして、あなたが書くどの仕様にもそのようにラベル付けする必要があります.
レビュー担当者が実際にあなたを拘束できるのはレポート セットです. 読者が従うべきジャーナルの指針には、プリカーサーイオンとフラグメントイオンの質量許容差が必要です, 検索エンジンとバージョン, データベース, FDR推定方法, および修飾部位の割り当てを評価するために使用されるソフトウェアまたは方法, 修飾部位が報告されているすべてのペプチドの注釈付きスペクトル付き (プロテオミクス データ提出のための MCP チュートリアル, MCP 著者のガイダンス). 最低限の情報のチェックリストにソフトウェア名を追加, バージョンとメーカー, バージョンとエントリ数を使用してデータベースをクエリする, およびパラメータファイル (ミアペ-MSI 1.1, 2008-02-05). ミアペは、 2008 チェックリストとバージョンのまま 1.1; それは新しい要件ではありません.
したがって、「レビュー担当者がどのカバレッジ番号を受け入れるか」に対する実際的な答えは次のとおりです。: 適用したしきい値を述べます, 適用範囲が相対的に低くなる状態 セマグルチドペプチド 修飾された残基, 誰かが計算を再現できるようにパラメータを報告します. これら 3 つの要素が欠けている数字は擁護できません.
無傷の質量を確認するだけでなく、修飾またはラベルの位置を特定するにはどうすればよいですか?
位置特定は識別とは別の測定です, 独自のスコア付き, 独自のしきい値と独自のエラー率. 質量だけでアイデンティティの主張を成立させることができない理由の組み合わせの根拠は古く、確固たるものである: 組成が1つ異なるペプチドの間で, 2つまたは3つのアミノ酸, 10%, 29% そして 53% それぞれは同一の質量異性体を持っています, ロイシン/イソロイシン異性体を除いた数値は次のとおりです。 14% そして 38% (彼らは、, J プロテオーム解析, 2004). これらの異性体ペプチドは質量で区別できません, タンデム質量分析またはその他の追加の制約が必要です.
ローカリゼーション スコアは、部位を決定するフラグメントを比較することによって機能します。. 現在の実装では、ある部位に修飾がある最高スコアのペプチドフォームと、修飾のない最高スコアのペプチドフォームを比較します。, 共有ピークは区別できないため無視します。, 識別ピークのみから位置特定の信頼性を高めます (PTM預言者, 2019). その実装では、iProphet の確率しきい値でローカリゼーションが適用されました。 0.9 2 つのデータセットの場合、 0.8 3番目に, 後者は以下に相当します 0.4% 推定PSM誤差と 97.9% PSM感度, で結果を報告しました 5% 誤った定位率以下 1% FLR (PTM預言者, 2019).
従来のローカリゼーションのしきい値はスコアベースであり、普遍的な許容基準として扱うべきではありません。. ASスコア 19 おおよそ p に相当します 0.01, または 99% 確実, その後、同じ研究室でのリンプロテオミクスの実践では、より自由な p が使用されました。 < 0.05, ASスコア > 13; スペクトラム ミルでは、次よりも大きなスコア差が必要です。 1.1 上位 2 つのローカリゼーションの間で確実なローカリゼーションを実現 (変更部位のローカリゼーションスコアリング, 2012). 同じレビューは、確率ベースのスコアは、すべての質量がランダムに観察される可能性が等しいという非現実的な仮定に基づいていると警告しています。, そして、それらを確実性の正確な尺度としてではなく、ユーザーが設定したしきい値に従うスコアとして扱うことを推奨しています。.
この警告は、しきい値が実際にどのように選択されるかによって確認されます。. PTMProphet は、位置特定確率のしきい値の選択は主にユーザーによる恣意的な選択であると説明しています。, ユーザーが許容するエラー率によって設定される (PTM預言者, 2019). 数値を固定する標準はない, したがって、防御可能な措置は、しきい値を明示することです, 対応するエラー率を述べます, 識別率とともに位置特定率を報告します.
標識ペプチドの場合, 予想されるインタクトマスシフトは提案された組成を裏付けるが、ラベルの化学的性質や結合部位を証明するものではない. 部位決定フラグメントを使用し、, 必要に応じて, 提案されたラベルとリンケージをテストするための直交構造法.
どの直交手法がどの恒等性の質問に答えますか?
それぞれのテクニックが異なる質問に答えます, マッピングはカウントよりも重要です. の 2025 合成ペプチドに関するヨーロッパのガイドライン, 6月から施行 2026, 仕様およびリリースの一部として、識別のために少なくとも 2 つの直交する方法を使用することを推奨します。, 質量をリストします, 相対保持時間, LC-MS, ペプチドマッピング, 生物活性, 必要に応じてアミノ酸分析またはNMR, 配列を明確に確認するために必要な組み合わせ (EMA, 合成ペプチドの開発・製造に関するガイドライン, 2025-12-04, 効果的 2026-06-01).
根底にある規制ロジックは数値ではなく実績ベースです. I Q2(R2) 固有の分子構造の側面によって分析物を区別する能力を実証するための識別が必要です, 参照物質に対する陽性結果と分析対象物を欠くサンプルからの陰性結果によって確認される, 手順が十分に識別できない場合, 追加の手順を使用する必要があります (I Q2(R2), 採用された 2023-11-01, 修正されました 2023-11-30). 特異性要件は能力テストです, テストの数ではありません.
ペプチドの同一性に関する参照標準の実践は、番号を固定せずに同じ方向に収束します: 化学構造と化学的同一性を検証するには、通常、複数の直交する手法が使用されます。, HPLC 保持時間を含む, NMR, MS およびキラルテスト, 複数の研究室での研究では NMR が使用されます, ペプチドマッピング, HPLCおよびアミノ酸分析 (製薬研究, 2023). この実践における HPLC の同一性は、参照標準との保持時間の比較に依存します。, これが、標準のない保持時間は同一性の結果ではない理由です。.
メソッドと質問のマッピングは、 ペプチド卸売業者 これらの情報源から導き出されます:
|
アイデンティティに関する質問 |
それに答える技術 |
答えられないもの |
|---|---|---|
|
無傷の質量は正しいですか? |
LC-MS または MALDI-TOF そのままの質量 |
順序, 位置的または立体化学的特徴 |
|
順番は正しいですか? |
配列範囲を含む MS/MS, またはペプチドマッピング |
不安定な変更, 部分的なカバレッジギャップ |
|
変更またはラベルはどこにありますか? |
指定された局在化閾値を持つ MS/MS 部位決定フラグメント |
サイトが機能的に関連しているかどうか メリティン |
|
立体化学は正しいですか? |
検証されたキラル分析; 通常のアミノ酸組成分析だけでは立体化学を確立できません |
変更箇所 |
|
スタンダードと同じ素材ですか?? カスタムペプチドの卸売 |
参照標準に対する HPLC 保持時間 |
規格自体が確立していないもの |
各結論をその方法とともに保持する COA レビューの習慣は、この表の実践版です。: クロマトグラフィー純度はクロマトグラフィーの均一性を表すものであり、化学的同一性を独立して確立するものではありません。, 無傷の塊だけではすべての配列が確立されない可能性があります, 位置的または立体化学的特徴, 同一性と純度は個別に報告され、それらをサポートする方法に添付される必要があります。 (ベクター E ラボ, 2026-09-28).
身元の主張が弁護可能となるためには、取得前に何を書き留めておく必要があるか?
記録は、他の人が同じエンジンまたは別のエンジンで同じまたは類似の検索を再実行できるように完全である必要があります。. 検索プロトコルを伝送する交換フォーマットでは、SpectrumIdentificationProtocol でペプチドレベルのスコアリングや修飾局在化スコアリングなどの検索タイプを宣言する必要があります。, ソフトウェアリストに検索エンジンを表示する必要があります, まさにその再現性を実現するように設計されています (mzIdentML 1.3.0, 6月 2024).
取得前の記録, 上記の報告基準を基にまとめたもの:
-
選択戦略とそのパラメーター. トップNの値, 隔離窓, 動的除外期間, 除外リストが実行間で引き継がれるかどうか.
-
公差. 前駆体およびフラグメントの質量許容差, 数字として記載されている. の 2016 使用された研究 10 ppmと 0.5 そして (クライマーら。, J プロテオーム解析, 2016); メソッドを一致させる必要がある機器レベルの精度は以下のとおりです 3 ppm RMS オーバー 24 h 外部校正あり以下 1 現在の Orbitrap プラットフォームでの内部校正による ppm RMS (サーモフィッシャー仕様書, 現在公開されているベンダーシート).
-
検索エンジンとバージョン, データベースとバージョンとエントリ数, とFDR推定方法. ターゲットおとり検索は、正しい識別と誤った識別を区別するための一般的な方法です, ほとんどの検索エンジンは、一致しないスペクトルであっても結果を返すためです。, エラー率はスコア分布から推定する必要があります (エリアス & ジギ, ネイチャーメソッド, 2007). ペプチドごとの信頼度は、各割り当てが正しい確率を計算する確率モデルから得られます。, 予測可能なエラー率でのフィルタリングを可能にする (ケラーら。, アナルケム, 2002).
-
サイト割り当て方法とそのしきい値, 修飾部位が報告されているすべてのペプチドの注釈付きスペクトル付き.
-
構造の複製. 複製の数, そしてそれらが生物学的であるかどうか, プロセスまたは技術的な.
-
アーカイブ識別子. PXD 識別子は永続的です, 最初に送信されたデータセットの主な識別子として一意かつ必須, メタデータと生のファイルと処理されたファイルが一緒に保存されたもの, 再分析されたデータセットの RPXD 識別子 (ProteomeXchange コンソーシアム, 核酸研究, 2026-01-06).
決定ルール, 取得前に適用される: 選択戦略を書き留めることができない場合, 公差, 検索パラメータ, 局在化閾値と複製構造を事前に設定, 身元に関する主張は後で弁護できなくなります. それらのフィールドのすべてが決定です, そして、それぞれを実行後に再構築するよりも、実行前に作成する方が安価です。.
よくある質問
技術的なレプリケーションの重複が少ないということは、私の手法が悪いということなのでしょうか??
必ずしもではありません. 従来の DDA は、各サイクルで最も強力な前駆体のみを選択します, 反復間の重複が少ないため、再現性の失敗ではなく、サンプリング動作が期待されます。 (タブら。, J プロテオーム解析, 2010). 尋ねるべき質問は、複製されたデザインが何を実証することを意図していたのかということです.
引用してもいいですか 29% 一般的なベンチマークとしての数値?
いいえ. それは一つから来ています 2016 HeLa ダイジェストと 120 最小勾配 (クライマーら。, J プロテオーム解析, 2016). そのスコープを付けて引用します, またはメカニズムを定性的に説明する.
仕様にどのような配列カバレッジを含めるべきか?
規制当局に裏付けられた最小値は存在しない. 適用したしきい値を述べてください, 修飾またはラベルを保持する残基が対象範囲に含まれていることを確認する, レビュー担当者が計算を再現できるように検索パラメータをレポートします。.
身元を確認するのに十分な無傷の質量がある?
いいえ. 1つ異なるペプチド間, 2つまたは3つのアミノ酸, 10%, 29% そして 53% 質量が同一の異性体がある (彼らは、, J プロテオーム解析, 2004). 質量は 1 つの直交メソッドです, 完全な身元の主張ではない.
正確に 2 つの直交メソッドが必要ですか??
の 2025 ヨーロッパのガイドラインでは、合成ペプチドの同定には少なくとも 2 つを推奨しています (EMA, 効果的 2026-06-01), ICH Q2中(R2) 要件を固定数ではなく特異性ベースとしてフレーム化する (私, 2023). 組み合わせは順序を明確に確認する必要があります; そこから数字が導き出されます.
結論
ID クレームは取得前に構築されます, それ以降ではない. 前駆体選択戦略により、どのペプチドがサンプリングされるかが決まります, 重複デザインは、重複が有益であるか偶然であるかを決定します。, カバレッジレポートは、修飾された残留物が実際に証拠の中にあるかどうかを決定します, そして直交特性評価は、質量だけでは異性体が未解決のままであることを知っている査読者にその主張が存続するかどうかを決定する.
次のステップは取得前の記録です: 選択戦略, 公差, 検索パラメータ, ローカリゼーションのしきい値, レプリケート構造とアーカイブ識別子, 最初の注入前に書き留められ、バージョン管理される. いずれかのフィールドが欠落している場合, レビュー担当者への応答ではなく、実行前に修正する.
カスタムのサービス範囲を比較するチーム向け, 修飾および標識されたペプチド, 純度の数値だけではなく、上記の分析パラメーターを記載した見積もりをリクエストしてください.
引用された分析標準と方法の比較は、独立した公開情報源です。*