快速解答
Think of precursor selection as a sampling strategy rather than a detector setting. A detector reports what reaches it; the sampling strategy decides what gets…
与传统的 TopN DDA 相比,先进的前体离子选择实际上改变了什么?
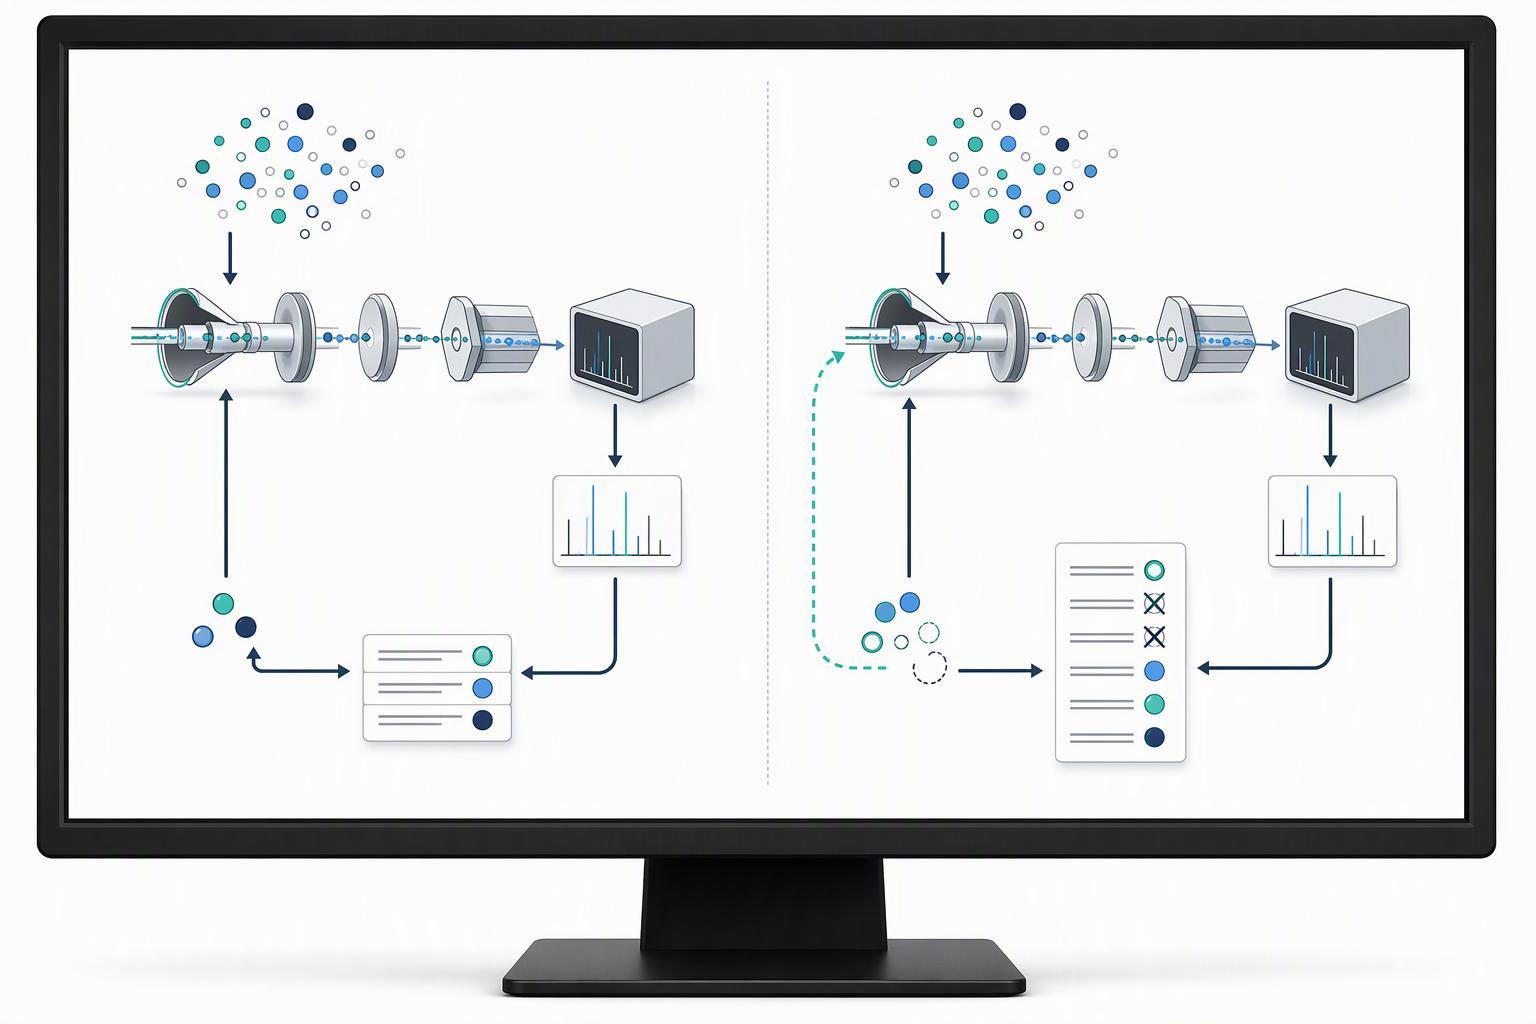
合成肽 肽生长激素 它改变了采样环路, 不是探测器. 传统的TopN DDA在每个MS1循环中选择N个最强烈的合格前体, 动态排除可防止立即重新选择, 因此,选择很大程度上是由强度驱动的,并且一次又一次地对丰富的肽进行采样 (克雷默等人。, 蛋白质组学研究杂志, 2016). 仪器工作正常; 该策略只是不断返回同一个邻域.
克雷默等人. 比较两种迭代排除策略: 排除所有先前片段化的前体并仅排除已识别的肽. 这些是具有不同结果的不同设计. 在引用增益之前描述使用了哪个排除列表, 并保留该研究的 HeLa 摘要和 LTQ Orbitrap XL 范围. 原创研究.
第三种变体进一步推动排除: 采集过程中的实时数据库搜索允许通过肽特性而不是 m/z 和时间事件进行排除. 关于自适应峰值选择的早期模拟工作发现,这最多增加了大约 1% 优于标准排除列表选择 (arXiv 预印本 1207.5848, 日期不详。). 将该数字视为模拟结果, 不是基准, 并且不要将其引用为测量的仪器结果.
在引用的 2016 学习, 传统的 TopN 饱和度接近 12,500 独特的肽是推断. 组合迭代排除实验超过 16,000 身份证明. 该比较说明了该设计下的互补采样, 不是通用的 29% 优于匹配的单次运行控制.
搜索共分离物种可以增加引用中的识别深度 2025 学习. 其报告的百分比使用不同的比较,并且必须保留自己的分母; 它们不应合并为超出规定范围的平均值或与迭代排除增益合并.
前体选择会影响获得哪些碎片证据. MS1 数据中可能仍存在未分段的特征; 如果没有足够的支持证据,则不能为其指定等效的序列置信度. 改进的搜索可以恢复获取的光谱中已存在的信息.
为什么技术重复重叠率可以很低,而方法又不具有不可重复性?
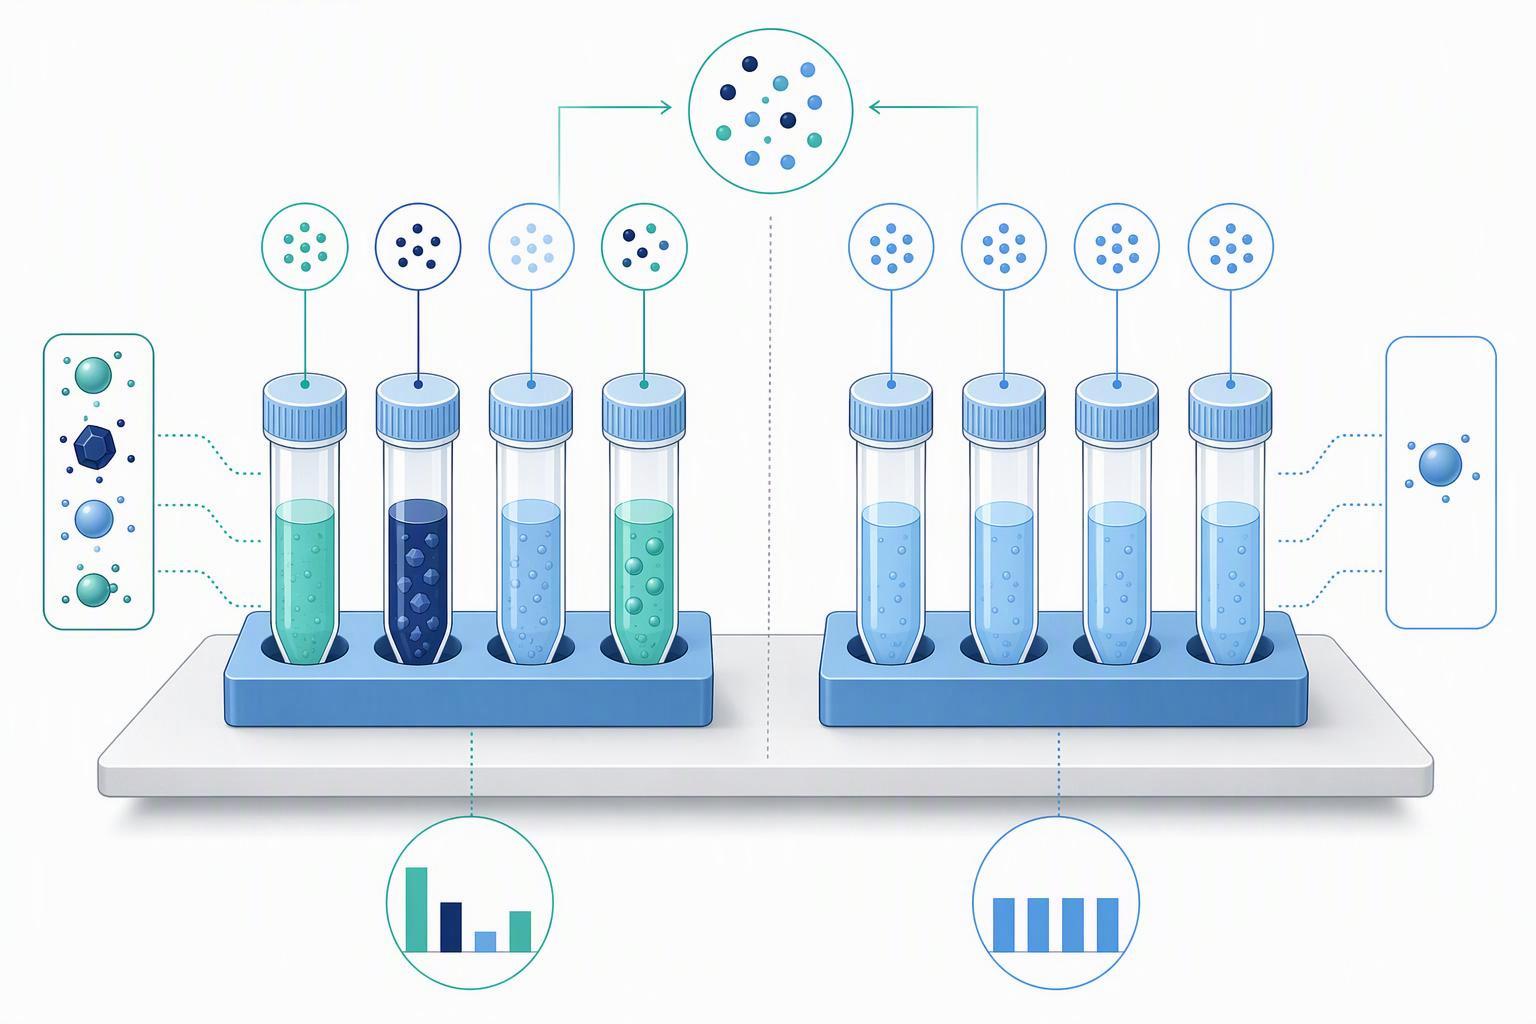
因为重叠度低和再现性差是不同的测量结果, 深度发现设计可以产生第一个,同时该方法仍然完全可重复. 传统 DDA 中重复肽重叠的长期范围是技术重复对之间的 35-60%, 一个数字来自 2010 对 LTQ 和旧 Orbitrap 仪器的重新分析 (塔布等人。, 蛋白质组学研究杂志, 2010). 该研究还发现重叠与样本复杂性无关: 48 种蛋白质的混合物给出了中位数 44% 重叠, 蛋白质标准混合物 46%, 和酵母消化物 45% (塔布等人。, 蛋白质组学研究杂志, 2010). 重复性与前体强度相关, 所以低丰度的肽被淘汰了.
这是关键的区别. 如果您的重复设计保持样品不变并且除了进样之外没有任何变化, 低重叠意味着该方法是随机采样的, DDA 的预期. 如果您的设计旨在展示可重复性, 你需要说明什么是不变的,什么是变化的, MCP 作者指南正是要求这一点: 获得的重复次数与生物之间有明显区别, 工艺和技术复制, 加上随机化的方法和类型, 技术控制, 以及样品分析的时间跨度 (MCP 作者须知).
最近的两个独立实验表明重叠问题有多少是依赖于采集的. 对相同样品进行直接 DDA 与 DIA 比较发现超过 92% 在 DIA 数据中重复鉴定的肽的数量与少于 77% 在 DDA 数据中, 蛋白质水平的一致性 99.0/98.2/98.2% 为 DIA 反对 95.6/95.4/96.2% 对于DDA (PMC12801617, 2025). 泪液的八次重复完整性比较发现 DIA 为 78.5% 肽完整性与 48% 对于DDA, CV 中位数为 10.6% 和 22.3% 分别 (质谱高级临床实验室杂志, 2025). 两个不同的指标, 存在/不存在一致性和变异系数, 指向同一个方向.
诚实的差距: 该组中没有源重新测量 2010 当前仪器的重叠图. 每当引用 35-60% 的范围时,都应注明日期, DIA 与 DDA 的证据仅涵盖细胞系和泪液. 这里没有来源比较磷酸蛋白质组或其他富含 PTM 的样品的两种模式, 因此任何关于修饰肽的 DIA 与 DDA 的说法都不会得到支持.
收购前, 区分发现深度设计和可重复性研究. 故意排除后的低重叠可以表明补充抽样, 还要检查识别可信度, 总覆盖率和样本质量; 仅低重叠并不能证明该策略正在发挥作用.
多少序列覆盖率就足够了, 覆盖范围必须下降到哪里?
在设置标准之前定义覆盖率指标. 蛋白质序列覆盖度对已识别肽代表的残基进行计数; 合成肽的碎片离子覆盖度是一种不同的测量方法. 单独的百分比并不能确定剩余顺序, 修饰位置或立体化学. 为构建体设置所需的诊断离子和正交测试.
放置规则遵循该定义. 对于修饰或标记的肽, 覆盖范围必须包括带有修饰或标签的残留物. 一个 95% 覆盖图将修改后的站点保留在未覆盖的区域中 5% 不支持特定于站点的身份声明, 无论百分比看起来有多高.
这是供应商的做法, 不是监管门槛, 并且在您编写的任何规范中都应该如此标记.
审稿人实际上可以让你遵守的是报告集. 读者可以遵守的期刊指南要求母离子和碎片离子质量容差, 搜索引擎和版本, 数据库, FDR估计法, 以及用于评估修饰位点分配的软件或方法, 带有报告修饰位点的每个肽的注释光谱 (蛋白质组学数据提交 MCP 教程, MCP 作者指导). 最少信息清单添加软件名称, 版本和制造商, 使用版本和条目计数查询数据库, 和参数文件 (MIAPE-MSI 1.1, 2008-02-05). MIAPE 是 2008 清单并保留在版本中 1.1; 这不是一个新要求.
因此,“审稿人会接受多少覆盖范围”的实际答案是: 说明您应用的阈值, 覆盖范围相对于以下情况下降的状态 索马鲁肽肽 修饰残基, 并报告参数,让别人重现计算. 没有这三点的数字是站不住脚的.
如何定位修改或标签,而不仅仅是确认完整的质量?
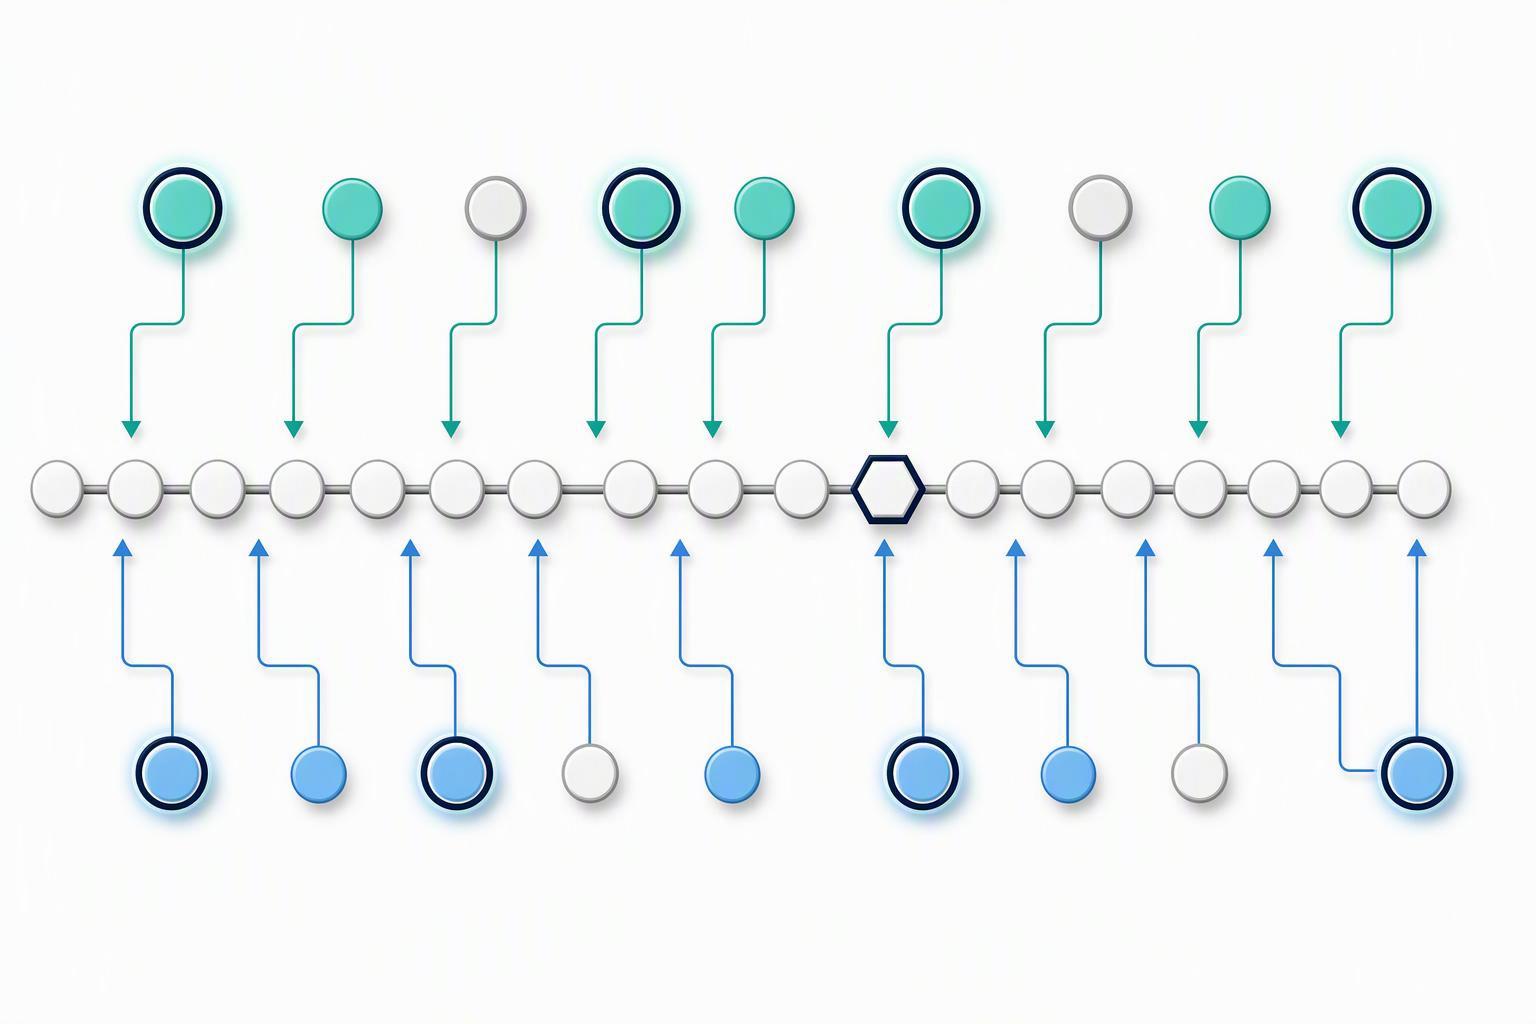
定位是与识别分开的测量, 有自己的分数, 有自己的阈值和错误率. 为什么仅凭质量无法结束身份主张的组合基础是古老而坚定的: 组成不同的肽之间, 两个或三个氨基酸, 10%, 29% 和 53% 分别具有质量相同的异构体, 不包括亮氨酸/异亮氨酸异构体,这些数字是 14% 和 38% (他等人。, 蛋白质组学研究杂志, 2004). 那些异构肽无法通过质量区分, 并且需要串联质谱或其他附加约束.
本地化分数通过比较位点确定片段来发挥作用. 当前的实施将在某个位点进行修饰的最佳评分肽型与没有修饰的最佳评分肽型进行比较, 忽略共享峰值,因为它们不提供区分, 并仅通过区分峰值来提高本地化信心 (PTM先知, 2019). 该实现应用了 iProphet 概率阈值的定位 0.9 对于两个数据集和 0.8 第三个, 后者对应于 0.4% 估计的 PSM 误差和 97.9% PSM灵敏度, 并报告结果 5% 误定位率及以下 1% FLR (PTM先知, 2019).
经典的本地化阈值是基于分数的,不应被视为普遍接受标准. AScore 19 大约对应于 p 0.01, 或者 99% 肯定, 后来同一实验室的磷酸化蛋白质组学实践使用了更自由的 p < 0.05, AScore > 13; Spectrum Mill 要求分数差大于 1.1 位于前两个本地化之间,以实现可靠的本地化 (修改位点定位评分, 2012). 同一篇评论警告说,基于概率的分数基于一个不切实际的假设,即所有质量都同样可能被随机观察到, 并建议将它们视为受用户设置阈值影响的分数,而不是准确的确定性度量.
该警告通过实际选择阈值的方式得到证实. PTMProphet 将定位概率阈值的选择描述为很大程度上是用户做出的任意选择, 由用户接受的错误率来设置 (PTM先知, 2019). 没有标准可以确定数字, 所以合理的做法是规定阈值, 说出它对应的错误率, 并报告定位率和识别率.
对于标记肽, 预期的完整质量变化支持提议的成分,但不能证明标签化学或附着位点. 使用位点确定片段和, 必要时, 用于测试所提出的标签和链接的正交结构方法.
哪种正交技术回答哪个身份问题?
每种技术都回答不同的问题, 映射比计数更重要. 这 2025 欧洲合成肽指南, 自六月起生效 2026, 建议使用至少两种正交方法进行识别,作为规范和发布的一部分, 并列出质量, 相对保留时间, 液质联用, 肽图谱, 生物活性, 氨基酸分析或 NMR(视情况而定), 与明确确认序列所需的组合 (EMA, 合成肽开发与生产指导原则, 2025-12-04, 有效的 2026-06-01).
其背后的监管逻辑是基于绩效而非数字的. 我Q2(R2) 需要鉴定以证明通过独特的分子结构方面区分分析物的能力, 通过参考物质的阳性结果加上缺乏分析物的样品的阴性结果来证实, 当程序没有充分区分时, 应使用额外的程序 (我Q2(R2), 通过 2023-11-01, 已纠正 2023-11-30). 特异性要求是能力测试, 不是测试次数.
肽鉴定的参考标准实践在同一方向上收敛,无需固定数字: 多重正交技术通常用于验证化学结构和化学特性, 包括 HPLC 保留时间, 核磁共振, MS 和手性测试, 和多实验室研究使用 NMR, 肽图谱, HPLC 和氨基酸分析 (药物研究, 2023). 该实践中的 HPLC 特性依赖于与参考标准的保留时间比较, 这就是为什么没有标准的保留时间不是身份结果的原因.
方法到问题的映射 多肽批发供应商 从这些来源得出:
|
身份问题 |
回答这个问题的技术 |
它没有回答什么 |
|---|---|---|
|
完整质量是否正确? |
LC-MS 或 MALDI-TOF 完整质量 |
顺序, 位置或立体化学特征 |
|
顺序是否正确? |
具有序列覆盖率的 MS/MS, 或肽图谱 |
不稳定的修饰, 部分覆盖缺口 |
|
修改或标签在哪里? |
具有指定定位阈值的 MS/MS 定点片段 |
网站功能是否相关 蜂毒肽 |
|
立体化学是否正确? |
经验证的手性分析; 单独分析普通氨基酸组成并不能建立立体化学 |
修改位置 |
|
和标准材质一样吗? 定制多肽批发 |
相对于参考标准的 HPLC 保留时间 |
标准本身没有规定的任何内容 |
将每个结论与其方法保持一致的COA审查习惯是该表的实用版本: 色谱纯度描述了色谱均质性,并不独立地确定化学特性, 单独完整的质量可能无法建立每个序列, 位置或立体化学特征, 身份和纯度应单独报告并附在支持它们的方法中 (矢量电子实验室, 2026-09-28).
为了使身份声明具有辩护性,在获取之前必须写下哪些内容?
记录必须足够完整,以便其他人可以在相同或另一个引擎上重新运行相同或相似的搜索. 携带搜索协议的交换格式需要 SpectrumIdentificationProtocol 来声明搜索类型,例如肽级评分或修饰定位评分, 要求软件列表中包含搜索引擎, 专为实现再现性而设计 (mzIdentML 1.3.0, 六月 2024).
收购前记录, 根据上述报告标准汇总:
-
选择策略及其参数. TopN值, 隔离窗, 动态排除持续时间, 以及排除列表是否在运行之间结转.
-
公差. 前体和碎片质量容差, 以数字表示. 这 2016 研究使用 10 百万分之一和 0.5 和 (克雷默等人。, 蛋白质组学研究杂志, 2016); 该方法应匹配的仪器级精度如下 3 ppm RMS 超过 24 h 带外部校准及以下 1 ppm RMS,在当前 Orbitrap 平台上进行内部校准 (赛默飞世尔规格表, 目前已发布的供应商表).
-
搜索引擎和版本, 数据库和版本以及条目数, 和FDR估计方法. 目标诱饵搜索是区分正确和错误识别的公认方法, 而且因为大多数搜索引擎即使对于无法匹配的光谱也会返回结果, 错误率必须根据分数分布来估计 (埃利亚斯 & 吉吉, 自然方法, 2007). 每个肽的置信度来自概率模型,该模型计算每个分配正确的概率, 启用具有可预测错误率的过滤 (凯勒等人。, 肛门化学, 2002).
-
站点分配方法及其阈值, 带有报告修饰位点的每个肽的注释光谱.
-
复制结构. 重复次数, 以及它们是否是生物的, 工艺或技术.
-
档案标识符. PXD 标识符是持久的, 唯一且强制作为原始提交数据集的主要标识符, 元数据以及原始文件和处理后的文件存放在一起, 和重新分析数据集的 RPXD 标识符 (蛋白质组交换联盟, 核酸研究, 2026-01-06).
决策规则, 收购前应用: 如果你不能写下选择策略, 公差, 搜索参数, 提前定位阈值和复制结构, 此后身份声明将无法辩护. 这些字段中的每一个都是一个决定, 而且每一个在运行前制作都比运行后重建便宜.
常见问题解答
技术重复重叠度低是否意味着我的方法不好?
未必. 传统 DDA 在每个循环中仅选择最强的前体, 因此重复之间的低重叠是预期的采样行为,而不是再现性失败 (塔布等人。, 蛋白质组学研究杂志, 2010). 要问的问题是复制设计旨在证明什么.
我可以引用 29% 作为一般基准的数字?
不. 它来自于一个 2016 对 LTQ Orbitrap XL 进行 HeLa 消解和 120 最小梯度 (克雷默等人。, 蛋白质组学研究杂志, 2016). 引用它并附上该范围, 或定性地陈述机制.
我应该在规范中放入什么序列覆盖率?
不存在监管机构支持的最低限额. 说明您应用的阈值, 确认覆盖范围包括带有修饰或标签的残留物, 并报告搜索参数,以便审阅者重现计算.
完整的质量是否足以确认身份?
不. 肽之间有一个不同, 两个或三个氨基酸, 10%, 29% 和 53% 具有质量相同的异构体 (他等人。, 蛋白质组学研究杂志, 2004). 质量是一种正交方法, 不是完整的身份声明.
我是否需要两种正交方法?
这 2025 欧洲指南推荐至少两种用于合成肽鉴定 (EMA, 有效的 2026-06-01), 而 ICH Q2(R2) 将需求框架为基于特异性而不是固定计数 (我, 2023). 该组合必须明确确认顺序; 由此得出的数字.
结论
身份声明是在获取之前建立的, 不在它之后. 前体选择策略决定对哪些肽进行采样, 重复设计决定重叠是信息性的还是偶然的, 覆盖率报告决定修改后的残留物是否确实在证据内, 正交表征决定了该主张是否能经受住审稿人的考验,因为审稿人知道仅靠质量就无法解决异构体的问题.
下一步是预收购记录: 选择策略, 公差, 搜索参数, 定位阈值, 复制结构和归档标识符, 在第一次注入之前写下并进行版本控制. 如果缺少任何字段, 在运行之前修复它,而不是在对审阅者的响应中修复它.
对于比较定制服务范围的团队, 修饰和标记的肽, 请求报价时注明上述分析参数,而不仅仅是纯度数据.
引用的分析标准和方法比较是独立发表的来源。*