Réponse rapide
Think of precursor selection as a sampling strategy rather than a detector setting. A detector reports what reaches it; the sampling strategy decides what gets…
Qu’est-ce que la sélection avancée d’ions précurseurs change réellement par rapport au TopN DDA conventionnel?
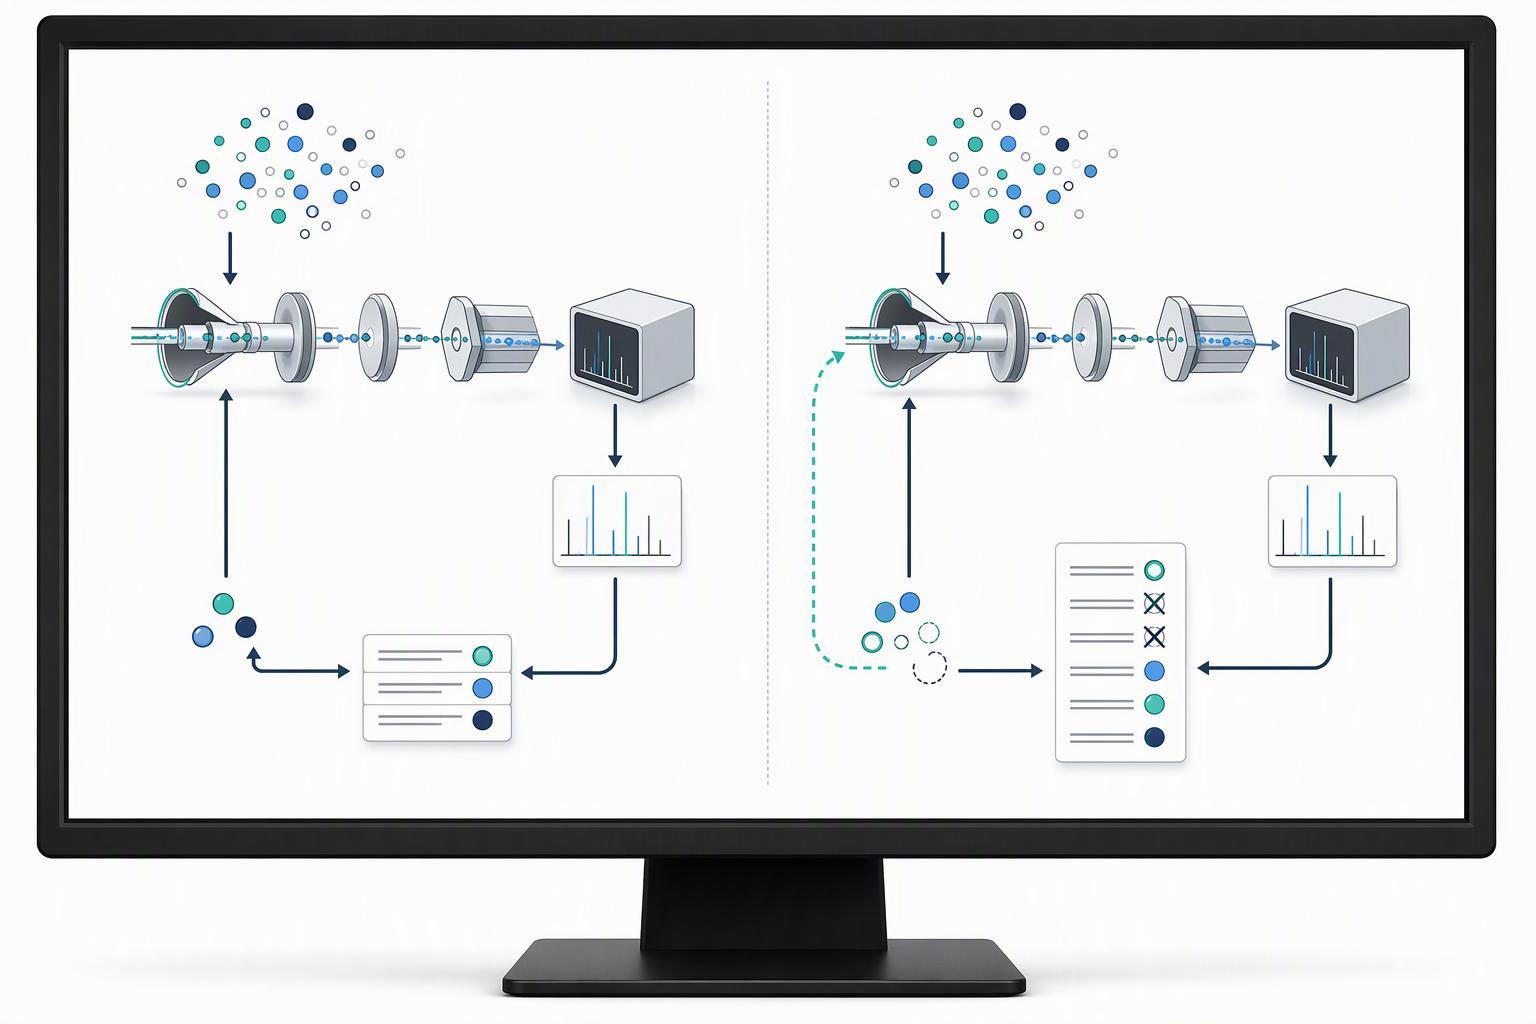
Peptide synthétique Hormones de croissance peptidiques Cela change la boucle d'échantillonnage, pas le détecteur. Le TopN DDA conventionnel sélectionne les N précurseurs éligibles les plus intenses dans chaque cycle MS1, et l'exclusion dynamique empêche une resélection immédiate, la sélection reste donc largement axée sur l'intensité et des peptides abondants sont échantillonnés encore et encore (Kreimer et al., J Protéome Res, 2016). L'instrument fonctionne correctement; la stratégie revient simplement dans le même quartier.
Kreimer et al. comparé deux stratégies d'exclusion itératives: excluant tous les précurseurs précédemment fragmentés et excluant uniquement les peptides identifiés. Ce sont des conceptions distinctes avec des résultats différents. Décrivez quelle liste d'exclusion a été utilisée avant de citer le gain, et conserver le résumé HeLa de l’étude et la portée LTQ Orbitrap XL. Étude originale.
Un troisième variant pousse encore plus l’exclusion: la recherche dans la base de données en temps réel pendant l'acquisition permet l'exclusion par identité peptidique plutôt que par un événement m/z et temporel. Les premiers travaux de simulation sur la sélection adaptative des pics ont révélé que cela ajoutait tout au plus environ un 1% gain par rapport à la sélection standard sur liste d'exclusion (préimpression arXiv 1207.5848, s.d.). Traitez ce nombre comme un résultat de simulation, pas une référence, et ne le citez pas comme un résultat d'instrument mesuré.
Dans le cité 2016 étude, la saturation TopN conventionnelle proche 12,500 les peptides uniques étaient une extrapolation. Les expériences combinées d'exclusion itérative ont dépassé 16,000 identifications. La comparaison illustre un échantillonnage complémentaire sous ce plan, pas un universel 29% gain par rapport à un contrôle à passage unique apparié.
La recherche d'espèces co-isolées peut augmenter la profondeur d'identification dans les zones citées. 2025 étude. Ses pourcentages déclarés utilisent des comparaisons différentes et doivent conserver leurs propres dénominateurs; ils ne doivent pas être combinés en une moyenne dépassant une fourchette indiquée ni fusionnés avec des gains d'exclusion itérative.
La sélection des précurseurs affecte les preuves de fragmentation acquises. Une fonctionnalité non fragmentée peut toujours être présente dans les données MS1; on ne peut pas lui attribuer un degré de confiance de séquence équivalent sans preuves adéquates à l’appui. Une recherche améliorée peut récupérer des informations déjà présentes dans les spectres acquis.
Pourquoi le chevauchement des répétitions techniques peut-il être faible sans que la méthode ne soit irreproductible?
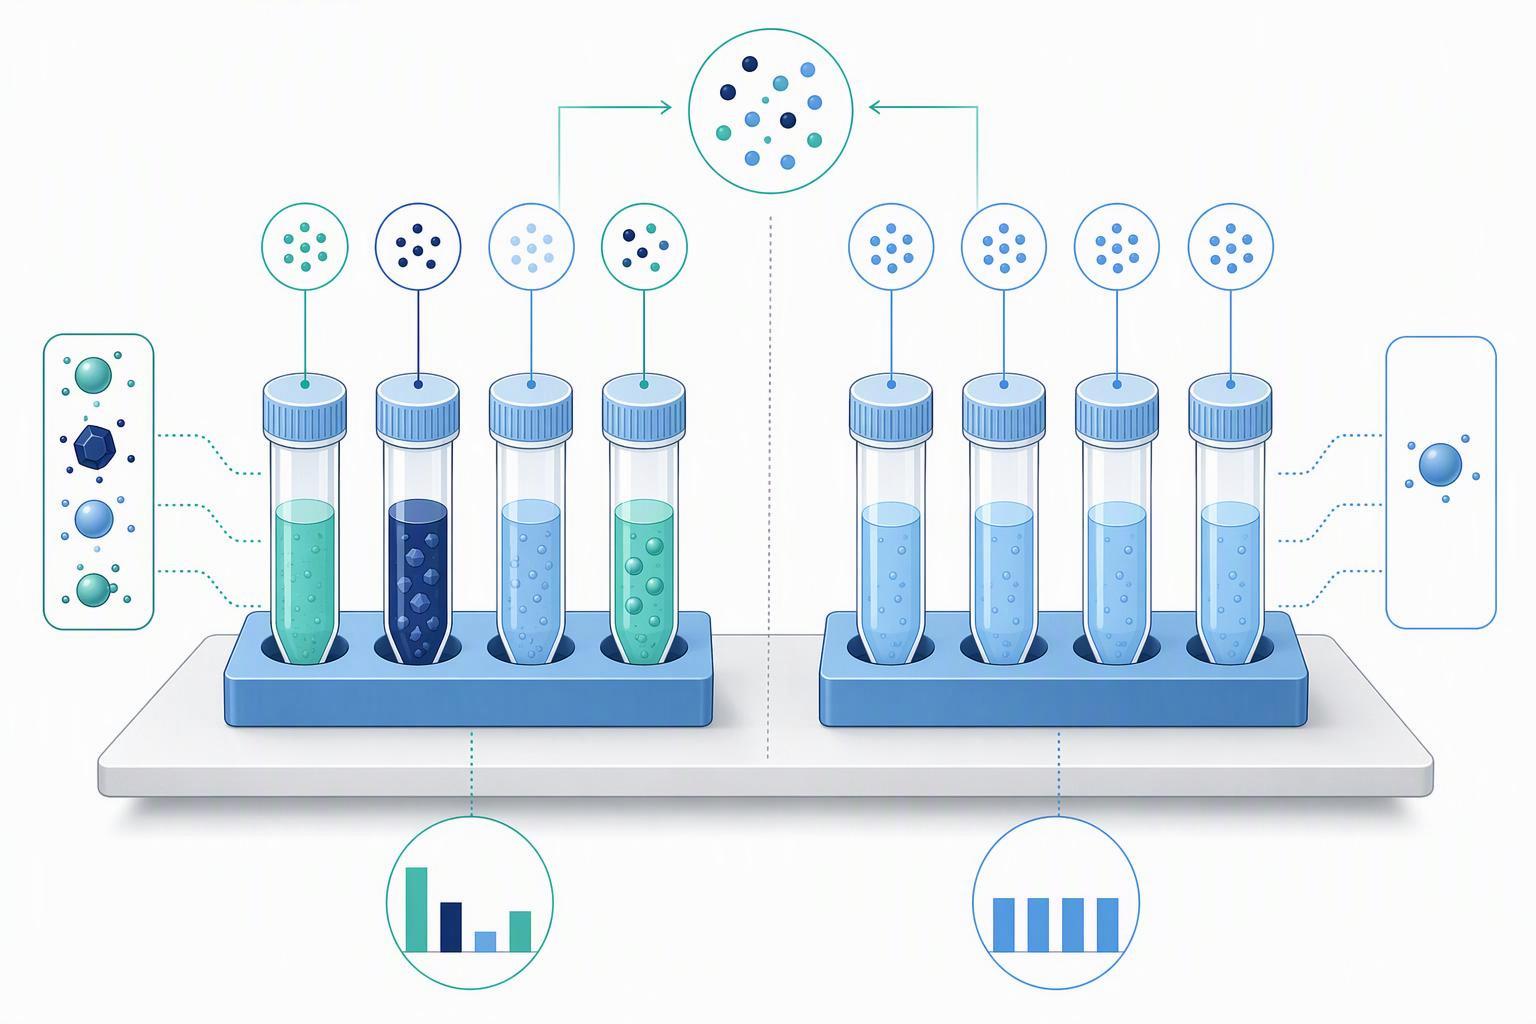
Parce qu'un faible chevauchement et une mauvaise reproductibilité sont des mesures différentes, et une conception en profondeur de découverte peut produire le premier tandis que la méthode reste parfaitement reproductible. La plage de chevauchement de longue date des peptides répliqués dans le DDA conventionnel est de 35 à 60 % entre des paires de réplications techniques., un chiffre qui vient d'un 2010 réanalyse sur les instruments LTQ et Orbitrap plus anciens (Tabb et coll., J Protéome Res, 2010). Cette étude a également révélé que le chevauchement était indépendant de la complexité de l'échantillon.: un mélange de 48 protéines a donné une médiane 44% chevaucher, un mélange standard de protéines 46%, et un digestat de levure 45% (Tabb et coll., J Protéome Res, 2010). Répétabilité corrélée à l'intensité du précurseur, donc les peptides en faible abondance sont ceux qui ont disparu.
C'est la distinction clé. Si votre plan de répétition maintient l'échantillon constant et ne fait varier que l'injection, un faible chevauchement signifie que la méthode échantillonne de manière stochastique, ce qui est attendu pour DDA. Si votre conception est destinée à démontrer la reproductibilité, vous devez indiquer ce qui est constant et ce qui varie, et les conseils des auteurs MCP exigent exactement cela: le nombre de répétitions acquises avec une distinction claire entre les, processus et répliques techniques, plus la méthode et le type de randomisation, contrôles techniques, et la durée de l'analyse des échantillons (Instructions MCP aux auteurs).
Deux expériences indépendantes récentes montrent dans quelle mesure le problème de chevauchement dépend de l'acquisition. Une comparaison directe DDA versus DIA dans les mêmes échantillons a révélé plus de 92% de peptides identifiés de manière cohérente dans les réplicats dans les données DIA contre moins de 77% dans les données DDA, avec une consistance protéique de 99.0/98.2/98.2% pour DIA contre 95.6/95.4/96.2% pour le DDA (PMC12801617, 2025). Une comparaison d'exhaustivité en huit répétitions dans le liquide lacrymal a révélé une DIA à 78.5% exhaustivité du peptide versus 48% pour le DDA, avec des CV médians de 10.6% et 22.3% respectivement (J Mass Spectrom Adv Clin Lab, 2025). Deux métriques différentes, cohérence présence/absence et coefficient de variation, pointer de la même manière.
L'écart honnête: aucune source dans cet ensemble ne mesure à nouveau le 2010 figure de chevauchement sur l'instrumentation actuelle. La fourchette de 35 à 60 % doit être datée chaque fois qu'elle est indiquée., et les preuves DIA versus DDA couvrent uniquement les lignées cellulaires et le liquide lacrymal.. Aucune source ici ne compare les deux modes sur un phosphoprotéome ou autre échantillon enrichi en PTM, donc toute affirmation concernant le DIA par rapport au DDA pour les peptides modifiés ne serait pas étayée.
Avant acquisition, distinguer une conception approfondie de la découverte d'une étude de répétabilité. Un faible chevauchement après une exclusion délibérée peut indiquer un échantillonnage complémentaire, mais aussi vérifier la confiance de l'identification, couverture totale et qualité des échantillons; un faible chevauchement ne prouve pas à lui seul que la stratégie fonctionne.
Quelle couverture de séquence est suffisante, et où doit tomber la couverture?
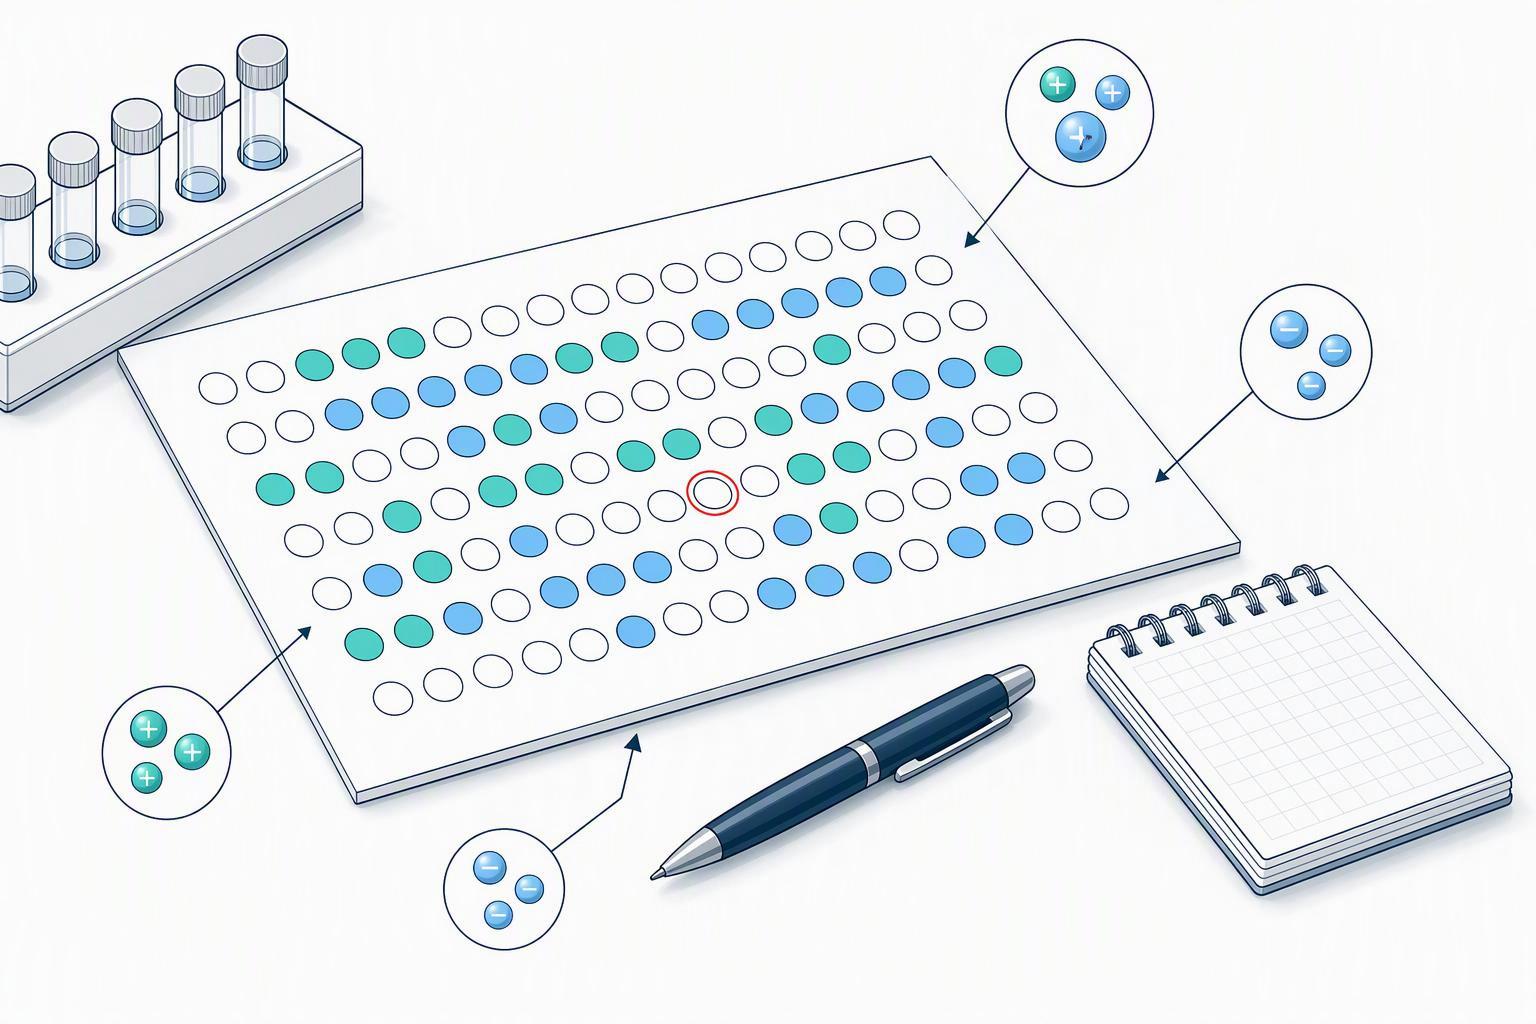
Définir la métrique de couverture avant de définir un critère. La couverture des séquences protéiques compte les résidus représentés par les peptides identifiés; La couverture des fragments d'ions d'un peptide synthétique est une mesure différente. Aucun des deux pourcentages n’établit à lui seul l’ordre des résidus, modification de position ou stéréochimie. Définir les ions de diagnostic et les tests orthogonaux requis pour la construction.
La règle de placement découle de cette définition. Pour un peptide modifié ou marqué, la couverture doit inclure le résidu qui porte la modification ou l'étiquette. UN 95% carte de couverture qui laisse le site modifié à découvert 5% ne prend pas en charge une revendication d'identité spécifique au site, peu importe à quel point le pourcentage semble élevé.
C'est la pratique du fournisseur, pas un seuil réglementaire, et il doit être étiqueté comme tel dans toute spécification que vous écrivez.
Ce à quoi un évaluateur peut réellement vous contraindre, c'est l'ensemble de rapports. Les directives du journal auxquelles un lecteur peut être tenu exigent des tolérances de masse pour les ions précurseurs et les fragments d'ions., le moteur de recherche et la version, la base de données, la méthode d'estimation du FDR, et le logiciel ou la méthode utilisée pour évaluer l'attribution du site de modification, avec des spectres annotés pour chaque peptide pour lequel un site de modification est signalé (Tutoriel MCP pour la soumission de données protéomiques, Conseils aux auteurs MCP). La liste de contrôle des informations minimales ajoute le nom du logiciel, version et fabricant, bases de données interrogées avec les versions et le nombre d'entrées, et les fichiers de paramètres (MIAPE-MSI 1.1, 2008-02-05). MIAPE est le 2008 liste de contrôle et reste à la version 1.1; ce n'est pas une nouvelle exigence.
Ainsi, la réponse pratique à la question « quel numéro de couverture un évaluateur acceptera-t-il » est :: indiquez le seuil que vous avez appliqué, état où la couverture tombe par rapport à Peptide de sémaglutide le résidu modifié, et signaler les paramètres qui permettent à quelqu'un de reproduire le calcul. Un nombre sans ces trois éléments n’est pas défendable.
Comment localiser une modification ou une étiquette plutôt que de simplement confirmer une masse intacte?
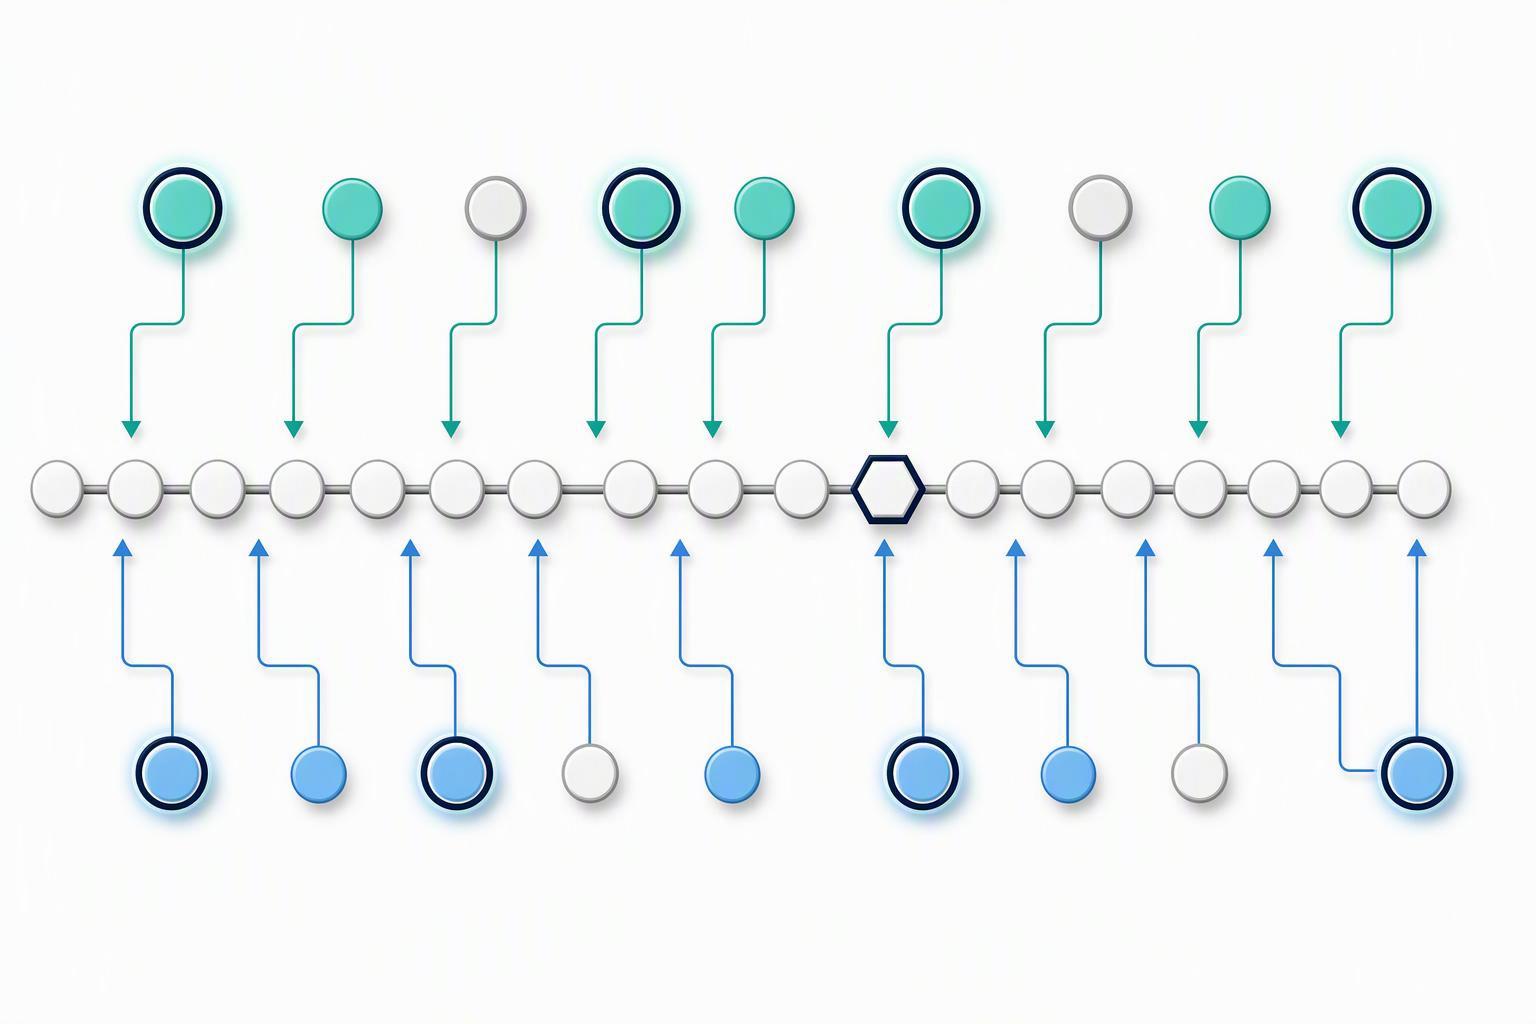
La localisation est une mesure distincte de l'identification, avec sa propre partition, son propre seuil et son propre taux d'erreur. La base combinatoire expliquant pourquoi la masse seule ne peut pas clore une revendication identitaire est ancienne et solide.: parmi les peptides dont la composition diffère d'un, deux ou trois acides aminés, 10%, 29% et 53% ont respectivement des isomères de masse identique, et en excluant les isomères de la leucine/isoleucine, les chiffres sont 14% et 38% (Lui et coll., J Protéome Res, 2004). Ces peptides isomères ne peuvent pas être distingués par leur masse, et une spectrométrie de masse en tandem ou d'autres contraintes supplémentaires sont nécessaires.
Les scores de localisation fonctionnent en comparant des fragments déterminant le site. Une mise en œuvre actuelle compare le peptidoforme ayant le meilleur score avec la modification sur un site avec le peptidoforme le plus performant sans celle-ci., ignore les pics partagés car ils n'offrent aucune discrimination, et stimule la confiance en matière de localisation uniquement à partir de pics discriminants (PTMProphète, 2019). Cette implémentation appliquait la localisation aux seuils de probabilité iProphet de 0.9 pour deux ensembles de données et 0.8 pour un tiers, ce dernier correspondant à 0.4% erreur PSM estimée et 97.9% Sensibilité du PSM, et a rendu compte des résultats à 5% taux de fausse localisation et inférieur 1% FLR (PTMProphète, 2019).
Les seuils de localisation classiques sont basés sur des scores et ne doivent pas être traités comme des critères d'acceptation universels.. Une note 19 correspond à p environ 0.01, ou 99% certitude, et plus tard, la pratique de la phosphoprotéomique du même laboratoire a utilisé une approche plus libérale. < 0.05, Une note > 13; Spectrum Mill nécessite une différence de score supérieure à 1.1 entre les deux principales localisations pour une localisation fiable (Score de localisation du site de modification, 2012). La même revue prévient que les scores basés sur les probabilités reposent sur l’hypothèse irréaliste selon laquelle toutes les masses ont la même probabilité d’être observées au hasard., et recommande de les traiter comme des scores soumis à un seuil défini par l'utilisateur plutôt que comme des mesures précises de certitude..
Cet avertissement est confirmé par la manière dont les seuils sont effectivement choisis. PTMProphet décrit la sélection du seuil de probabilité de localisation comme un choix largement arbitraire fait par l'utilisateur., à définir en fonction du taux d'erreur que l'utilisateur accepte (PTMProphète, 2019). Aucune norme ne fixe un numéro, donc la démarche défendable est d'énoncer le seuil, indiquer le taux d'erreur auquel il correspond, et signaler le taux de localisation ainsi que le taux d'identification.
Pour un peptide marqué, un changement de masse intact attendu soutient une composition proposée mais ne prouve pas la chimie de l'étiquette ou le site de fixation. Utiliser des fragments déterminant le site et, là où c'est nécessaire, une méthode structurelle orthogonale pour tester l'étiquette et la liaison proposées.
Quelle technique orthogonale répond à quelle question d’identité?
Chaque technique répond à une question différente, et la cartographie compte plus que le décompte. Le 2025 Ligne directrice européenne pour les peptides synthétiques, en vigueur depuis juin 2026, recommande l'utilisation d'au moins deux méthodes orthogonales pour l'identification dans le cadre de la spécification et de la version, et répertorie la masse, temps de rétention relatif, LC-MS, cartographie peptidique, bioactivité, analyse des acides aminés ou RMN selon le cas, avec la combinaison requise pour confirmer sans ambiguïté la séquence (EMA, Ligne directrice sur le développement et la fabrication de peptides synthétiques, 2025-12-04, efficace 2026-06-01).
La logique réglementaire sous-jacente est basée sur les performances plutôt que sur les chiffres.. Je Q2(R2) nécessite une identification pour démontrer la capacité de distinguer l'analyte par des aspects uniques de sa structure moléculaire, confirmé par des résultats positifs par rapport à un matériau de référence et par des résultats négatifs provenant d'échantillons dépourvus de l'analyte, et lorsqu'une procédure n'est pas suffisamment discriminante, une procédure supplémentaire doit être utilisée (Je Q2(R2), adopté 2023-11-01, corrigé 2023-11-30). L'exigence de spécificité est un test de capacité, pas un compte de tests.
La pratique standard de référence pour l’identité des peptides converge dans la même direction sans fixer de chiffre: plusieurs techniques orthogonales sont généralement utilisées pour vérifier la structure chimique et l'identité chimique, y compris le temps de rétention HPLC, RMN, Tests MS et chiraux, et les études multilaboratoires utilisent la RMN, cartographie peptidique, HPLC et analyse des acides aminés (Recherche pharmaceutique, 2023). L'identité HPLC dans cette pratique repose sur une comparaison du temps de rétention par rapport à un étalon de référence, c'est pourquoi un temps de rétention sans norme n'est pas un résultat d'identité.
La cartographie méthode-question qui Fournisseur en gros de peptides découle de ces sources:
|
Question d'identité |
Une technique qui y répond |
Ce à quoi il ne répond pas |
|---|---|---|
|
La masse intacte est-elle correcte? |
Masse intacte LC-MS ou MALDI-TOF |
Séquence, caractéristiques positionnelles ou stéréochimiques |
|
La séquence est-elle correcte? |
MS/MS avec couverture de séquence, ou cartographie peptidique |
Modifications labiles, lacunes de couverture partielles |
|
Où se trouve la modification ou l'étiquette? |
Fragments de détermination de site MS/MS avec un seuil de localisation indiqué |
Si le site est fonctionnellement pertinent Mélittine |
|
La stéréochimie est-elle correcte? |
Analyse chirale validée; l'analyse ordinaire de la composition en acides aminés à elle seule n'établit pas de stéréochimie |
Position d'une modification |
|
Est-ce le même matériau que le standard? Vente en gros de peptides personnalisés |
Temps de rétention HPLC par rapport à un étalon de référence |
Tout ce que la norme elle-même n'établit pas |
L'habitude des réviseurs COA de conserver chaque conclusion avec sa méthode est la version pratique de ce tableau.: la pureté chromatographique décrit l'homogénéité chromatographique et n'établit pas indépendamment l'identité chimique, la masse intacte à elle seule ne peut pas établir toutes les séquences, caractéristique positionnelle ou stéréochimique, et l'identité et la pureté doivent être déclarées séparément et attachées aux méthodes qui les soutiennent (Laboratoire vectoriel E, 2026-09-28).
Ce qui doit être écrit avant l'acquisition pour que la revendication d'identité soit défendable?
L'enregistrement doit être suffisamment complet pour que quelqu'un d'autre puisse réexécuter la même recherche ou une recherche similaire sur le même moteur ou sur un autre moteur.. Le format d'échange qui transporte le protocole de recherche nécessite que SpectrumIdentificationProtocol déclare un type de recherche tel qu'un score au niveau du peptide ou un score de localisation de modification., nécessite que les moteurs de recherche soient représentés dans la liste des logiciels, et est conçu exactement pour cette reproductibilité (mzIdentML 1.3.0, Juin 2024).
Le dossier de pré-acquisition, assemblés à partir des normes de reporting ci-dessus:
-
Stratégie de sélection et ses paramètres. Valeur TopN, fenêtre d'isolement, durée d'exclusion dynamique, et si une liste d'exclusion est reportée entre les exécutions.
-
Tolérances. Tolérance de masse des précurseurs et des fragments, indiqué sous forme de chiffres. Le 2016 étude utilisée 10 ppm et 0.5 Et (Kreimer et al., J Protéome Res, 2016); la précision au niveau de l'instrument à laquelle la méthode doit être adaptée est inférieure 3 ppm RMS supérieur 24 h avec calibrage externe et inférieur 1 ppm RMS avec étalonnage interne sur une plateforme Orbitrap actuelle (Fiche technique Thermo Fisher, fiche fournisseur actuellement publiée).
-
Moteur de recherche et version, base de données et version avec nombre d'entrées, et la méthode d'estimation FDR. La recherche de leurres de cible est le moyen accepté pour distinguer les identifications correctes des identifications incorrectes., et parce que la plupart des moteurs de recherche renvoient des résultats même pour des spectres incomparables, les taux d'erreur doivent être estimés à partir de la distribution des scores (Élias & Gygi, Méthodes naturelles, 2007). La confiance par peptide provient d'un modèle probabiliste qui calcule la probabilité que chaque attribution soit correcte, permettant un filtrage avec des taux d'erreur prévisibles (Keller et al., Chimie anale, 2002).
-
La méthode d'attribution de site et son seuil, avec des spectres annotés pour chaque peptide pour lequel un site de modification est signalé.
-
Répliquer la structure. Nombre de répétitions, et s'ils sont biologiques, processus ou technique.
-
L'identifiant de l'archive. Les identifiants PXD sont persistants, unique et obligatoire comme identifiant principal pour les ensembles de données initialement soumis, avec des métadonnées et des fichiers bruts et traités déposés ensemble, et identifiants RPXD pour les ensembles de données réanalysés (Consortium ProtéomeXchange, Recherche sur les acides nucléiques, 2026-01-06).
La règle de décision, appliqué avant l’acquisition: si vous ne pouvez pas écrire la stratégie de sélection, les tolérances, les paramètres de recherche, le seuil de localisation et la structure de réplication à l'avance, la revendication d'identité ne sera plus défendable par la suite. Chacun de ces domaines est une décision, et chacun est moins cher à fabriquer avant la course qu'à reconstruire après.
Foire aux questions
Un faible chevauchement de réplication technique signifie-t-il que ma méthode est mauvaise?
Pas nécessairement. Le DDA conventionnel sélectionne uniquement les précurseurs les plus intenses dans chaque cycle, un faible chevauchement entre les répétitions est donc un comportement d'échantillonnage attendu plutôt qu'un échec de reproductibilité (Tabb et coll., J Protéome Res, 2010). La question à se poser est de savoir ce que le modèle reproduit était censé démontrer..
Puis-je citer le 29% chiffre comme référence générale?
Non. Cela vient d'un 2016 étude sur un LTQ Orbitrap XL avec un digest HeLa et un 120 pente minimale (Kreimer et al., J Protéome Res, 2016). Citez-le avec cette portée ci-jointe, ou énoncer qualitativement le mécanisme.
Quelle couverture de séquence dois-je mettre dans une spécification?
Il n’existe aucun minimum garanti par le régulateur. Indiquez le seuil que vous avez appliqué, confirmer que la couverture inclut les résidus portant la modification ou l'étiquette, et signaler les paramètres de recherche qui permettent à un réviseur de reproduire le calcul.
La masse intacte est-elle suffisante pour confirmer l'identité?
Non. Parmi les peptides différant par un, deux ou trois acides aminés, 10%, 29% et 53% avoir des isomères de masse identique (Lui et coll., J Protéome Res, 2004). La masse est une méthode orthogonale, pas une revendication d'identité complète.
Ai-je besoin d'exactement deux méthodes orthogonales?
Le 2025 La directive européenne en recommande au moins deux pour l’identification des peptides synthétiques (EMA, efficace 2026-06-01), tandis que ICH Q2(R2) définit l'exigence comme étant basée sur la spécificité plutôt que sur un nombre fixe (je, 2023). La combinaison doit confirmer sans ambiguïté la séquence; le numéro en découle.
Conclusion
La revendication identitaire se construit avant l'acquisition, pas après. La stratégie de sélection des précurseurs décide quels peptides sont échantillonnés, le plan de répétition décide si le chevauchement est informatif ou accidentel, le rapport de couverture décide si le résidu modifié se trouve réellement dans la preuve, et la caractérisation orthogonale décide si l'affirmation survit à un critique qui sait que la masse seule laisse les isomères non résolus..
La prochaine étape est un dossier de pré-acquisition: stratégie de sélection, tolérances, paramètres de recherche, seuil de localisation, structure de réplication et identifiant d'archive, rédigé et contrôlé en version avant la première injection. S'il manque un champ, corrigez-le avant l'exécution plutôt que dans la réponse à un évaluateur.
Pour les équipes comparant les étendues de service pour la personnalisation, peptides modifiés et marqués, demander un devis indiquant les paramètres analytiques ci-dessus plutôt qu'un chiffre de pureté seul.
Les normes analytiques et les comparaisons de méthodes citées sont des sources publiées indépendantes.*