Hurtigt svar
Think of precursor selection as a sampling strategy rather than a detector setting. A detector reports what reaches it; the sampling strategy decides what gets…
Hvad ændrer avanceret precursor-ion-valg faktisk sammenlignet med konventionel TopN DDA?
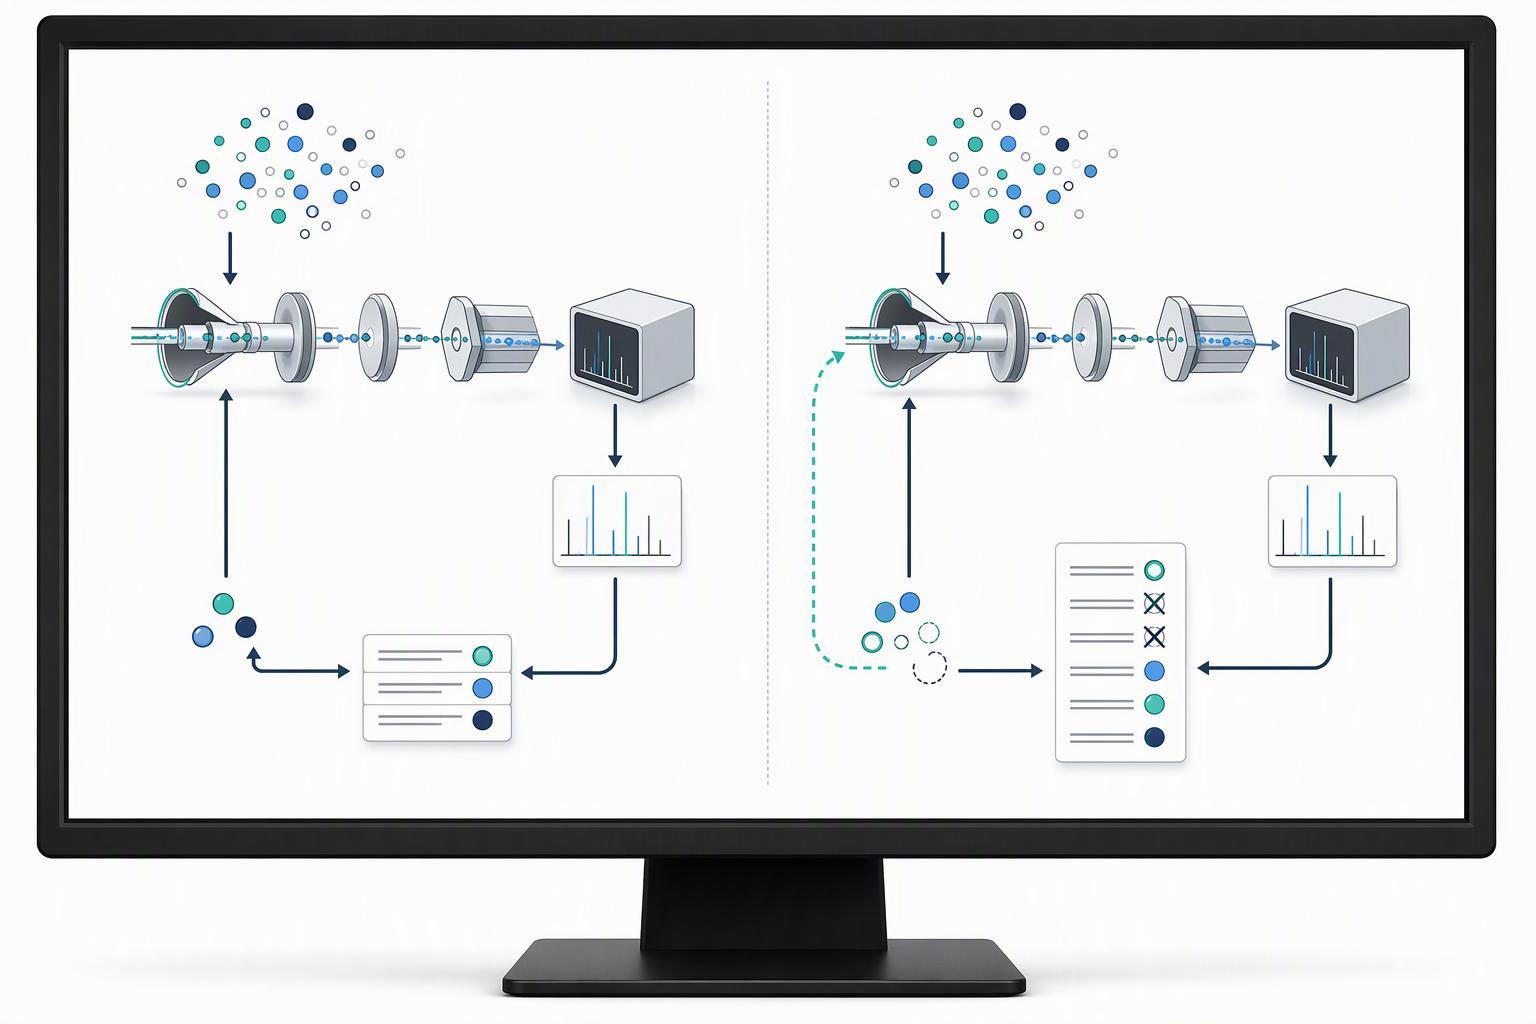
Syntetisk peptid Peptider Væksthormoner Det ændrer samplingsløkken, ikke detektoren. Konventionel TopN DDA udvælger de N mest intense kvalificerede prækursorer i hver MS1-cyklus, og dynamisk udelukkelse forhindrer øjeblikkelig genvalg, så selektion forbliver stort set intensitetsdrevet, og rigelige peptider udtages igen og igen (Kreimer et al., J Proteome Res, 2016). Instrumentet fungerer korrekt; strategien bliver simpelthen ved med at vende tilbage til det samme kvarter.
Kreimer et al. sammenlignede to iterative-udelukkelsesstrategier: udelukker alle tidligere fragmenterede prækursorer og udelukker kun identificerede peptider. Disse er forskellige designs med forskellige resultater. Beskriv hvilken udelukkelsesliste der blev brugt, før gevinsten citeres, og bibehold undersøgelsens HeLa digest og LTQ Orbitrap XL scope. Original undersøgelse.
En tredje variant skubber eksklusion yderligere: Realtidsdatabasesøgning under optagelse tillader udelukkelse af peptididentitet snarere end ved en m/z og tidshændelse. Tidligt simuleringsarbejde med adaptivt peakvalg fandt dette tilføjet højst omkring en 1% gevinst over standard udelukkelseslistevalg (arXiv fortryk 1207.5848, n.d.). Behandl dette tal som et simuleringsresultat, ikke et benchmark, og citer det ikke som et målt instrumentresultat.
I den citerede 2016 studere, den konventionelle TopN-mætning nær 12,500 unikke peptider var en ekstrapolation. De kombinerede iterative-ekskluderingseksperimenter overskred 16,000 identifikationer. Sammenligningen illustrerer komplementær prøveudtagning under dette design, ikke en universel 29% vinde over en matchet single-run kontrol.
Søgning efter co-isolerede arter kan øge identifikationsdybden i de citerede 2025 studere. Dens rapporterede procenter bruger forskellige sammenligninger og skal bevare deres egne nævnere; de bør ikke kombineres til et gennemsnit, der overstiger et angivet interval eller slås sammen med iterative ekskluderingsgevinster.
Precursor-selektion påvirker, hvilket fragmenteringsbevis der erhverves. En ufragmenteret funktion kan stadig være til stede i MS1-data; det kan ikke tildeles tilsvarende sekvenssikkerhed uden tilstrækkeligt underbyggende bevis. Forbedret søgning kan gendanne information, der allerede er til stede i erhvervede spektre.
Hvorfor kan teknisk-replikat overlap være lavt, uden at metoden er irreproducerbar?
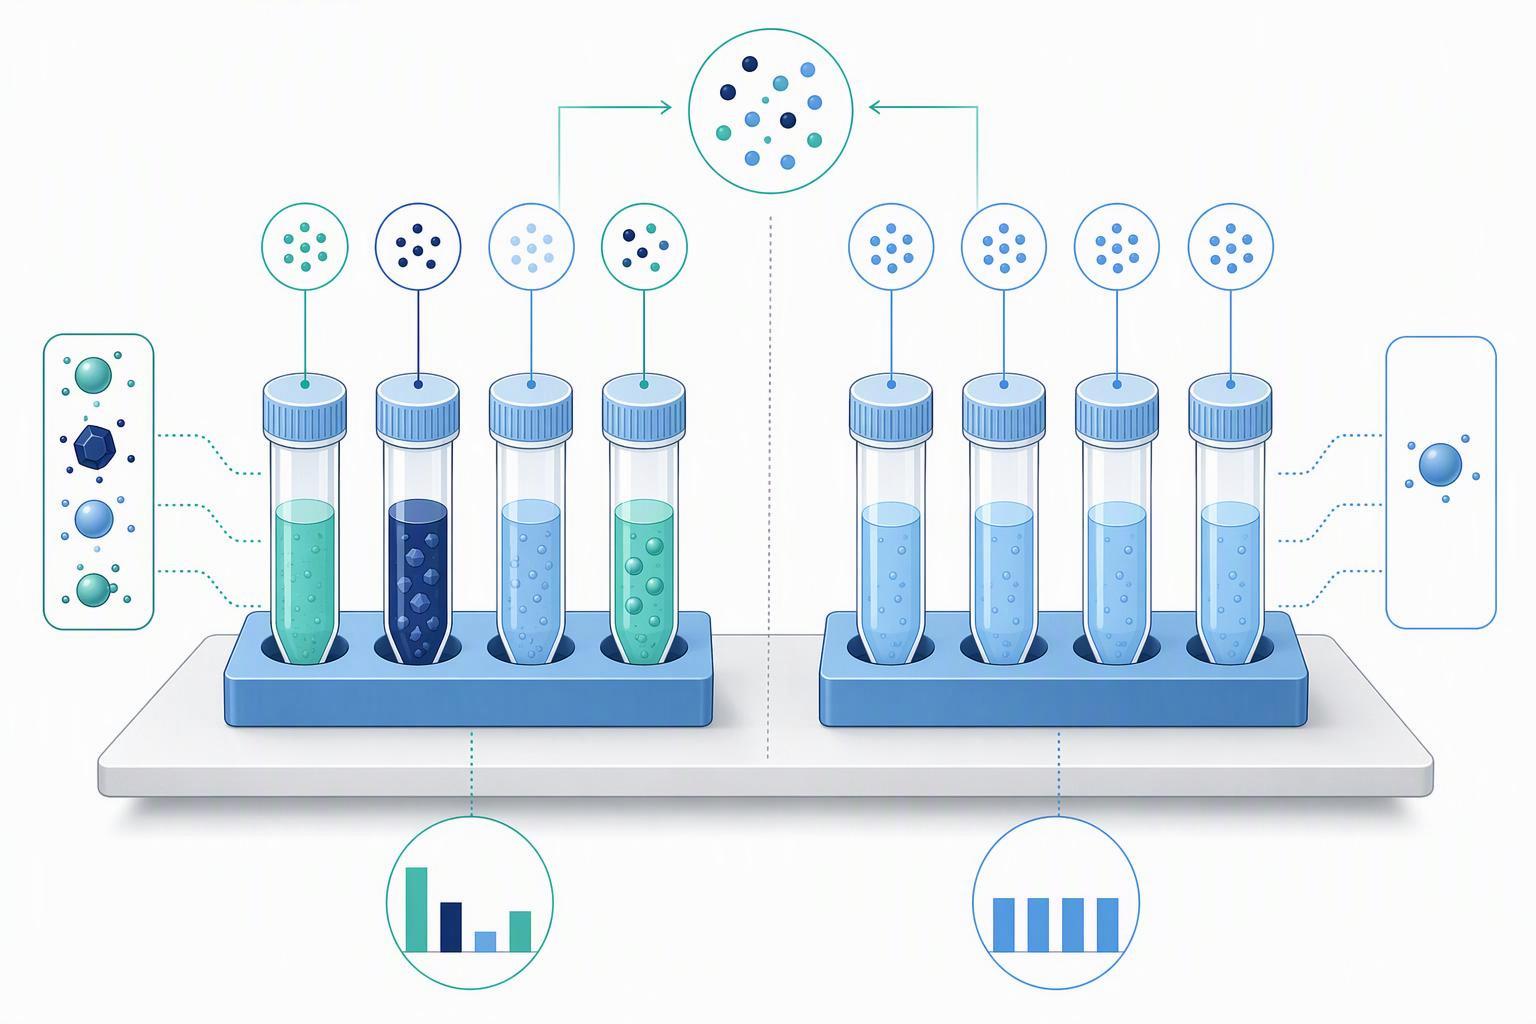
Fordi lavt overlap og dårlig reproducerbarhed er forskellige målinger, og et dybdegående design kan producere det første, mens metoden forbliver perfekt gentagelig. Det langvarige interval for replikatpeptidoverlapning i konventionel DDA er 35-60 % mellem par af tekniske replikater, en figur, der kommer fra en 2010 re-analyse på LTQ og ældre Orbitrap instrumenter (Tabb et al., J Proteome Res, 2010). Denne undersøgelse fandt også, at overlapningen var uafhængig af prøvens kompleksitet: en 48-proteinblanding gav en median 44% overlap, en proteinstandardblanding 46%, og en gærfordøjelse 45% (Tabb et al., J Proteome Res, 2010). Repeterbarhed korreleret med prækursorintensitet, så lav-abundance peptider var dem, der faldt ud.
Det er den vigtigste skelnen. Hvis dit replikatdesign holder prøven konstant og ikke varierer andet end injektionen, lavt overlap betyder, at metoden prøver stokastisk, som forventes til DDA. Hvis dit design er beregnet til at demonstrere reproducerbarhed, du skal angive, hvad der holdes konstant, og hvad der er varieret, og MCP-forfattervejledning kræver netop det: antallet af replikater erhvervet med en klar skelnen mellem biologiske, proces og tekniske replikater, plus metoden og typen af randomisering, tekniske kontroller, og tidsrummet for prøveanalyse (MCP-instruktioner til forfattere).
To nylige uafhængige eksperimenter viser, hvor meget af overlapningsproblemet er erhvervelsesafhængig. En direkte DDA-versus-DIA sammenligning i de samme prøver fandt mere end 92% af peptider konsekvent identificeret på tværs af replikater i DIA-data versus mindre end 77% i DDA-data, med protein-niveau konsistens af 99.0/98.2/98.2% for DIA imod 95.6/95.4/96.2% for DDA (PMC12801617, 2025). En fuldstændighedssammenligning med otte replikater i tårevæske fandt DIA kl 78.5% peptidets fuldstændighed versus 48% for DDA, med median CV'er på 10.6% og 22.3% henholdsvis (J Mass Spectrom Adv Clin Lab, 2025). To forskellige målinger, tilstedeværelse/fravær konsistens og variationskoefficient, peger samme vej.
Den ærlige kløft: ingen kilde i dette sæt genmåler 2010 overlapningstal på nuværende instrumentering. Intervallet på 35–60 % bør dateres, når det er citeret, og DIA-versus-DDA-beviset dækker kun cellelinjer og tårevæske. Ingen kilde her sammenligner de to tilstande på et phosphoproteom eller en anden PTM-beriget prøve, så enhver påstand om DIA versus DDA for modificerede peptider ville ikke være understøttet.
Før erhvervelse, skelne et opdagelsesdybdedesign fra et repeterbarhedsstudie. Lavt overlap efter bevidst udelukkelse kan indikere komplementær prøveudtagning, men kontroller også identifikationssikkerheden, total dækning og prøvekvalitet; lavt overlap alene beviser ikke, at strategien virker.
Hvor meget sekvensdækning er nok, og hvor skal dækningen falde?
Definer dækningsmetrikken, før du sætter et kriterium. Proteinsekvensdækning tæller rester repræsenteret af identificerede peptider; fragment-ion-dækning af et syntetisk peptid er et andet mål. Ingen af procenterne alene etablerer restrækkefølgen, modifikationsposition eller stereokemi. Indstil de nødvendige diagnostiske ioner og ortogonale tests for konstruktionen.
Anbringelsesreglen følger af den definition. For et modificeret eller mærket peptid, dækningen skal omfatte den rest, der bærer modifikationen eller etiketten. EN 95% dækningskort, der efterlader det ændrede sted i det udækkede 5% understøtter ikke et webstedsspecifikt identitetskrav, uanset hvor høj procenten ser ud.
Det er leverandørens praksis, ikke en lovgivningsmæssig tærskel, og det skal være mærket som sådan i enhver specifikation, du skriver.
Hvad en anmelder faktisk kan holde dig til, er rapporteringssættet. Den journalvejledning, som en læser kan holdes til, kræver prækursor-ion- og fragment-ion-massetolerancer, søgemaskinen og versionen, databasen, FDR estimeringsmetoden, og softwaren eller metoden, der bruges til at evaluere tildelingen af ændringsstedet, med annoterede spektre for hvert peptid, hvor et modifikationssted er rapporteret (MCP-vejledning til indsendelse af proteomikdata, MCP forfatter vejledning). Tjeklisten med minimumsoplysninger tilføjer softwarenavn, version og producent, databaser forespørges med versioner og indtastningstal, og parameterfilerne (MIAPE-MSI 1.1, 2008-02-05). MIAPE er 2008 tjekliste og forbliver ved version 1.1; det er ikke et nyt krav.
Så det praktiske svar på "hvilket dækningsnummer vil en anmelder acceptere" er: angiv den tærskel, du har anvendt, stat hvor dækningen falder ift Semaglutid peptid den modificerede rest, og rapporter de parametre, der lader nogen gengive beregningen. Et tal uden disse tre ting er ikke forsvarligt.
Hvordan lokaliserer du en ændring eller en etiket i stedet for blot at bekræfte intakt masse?
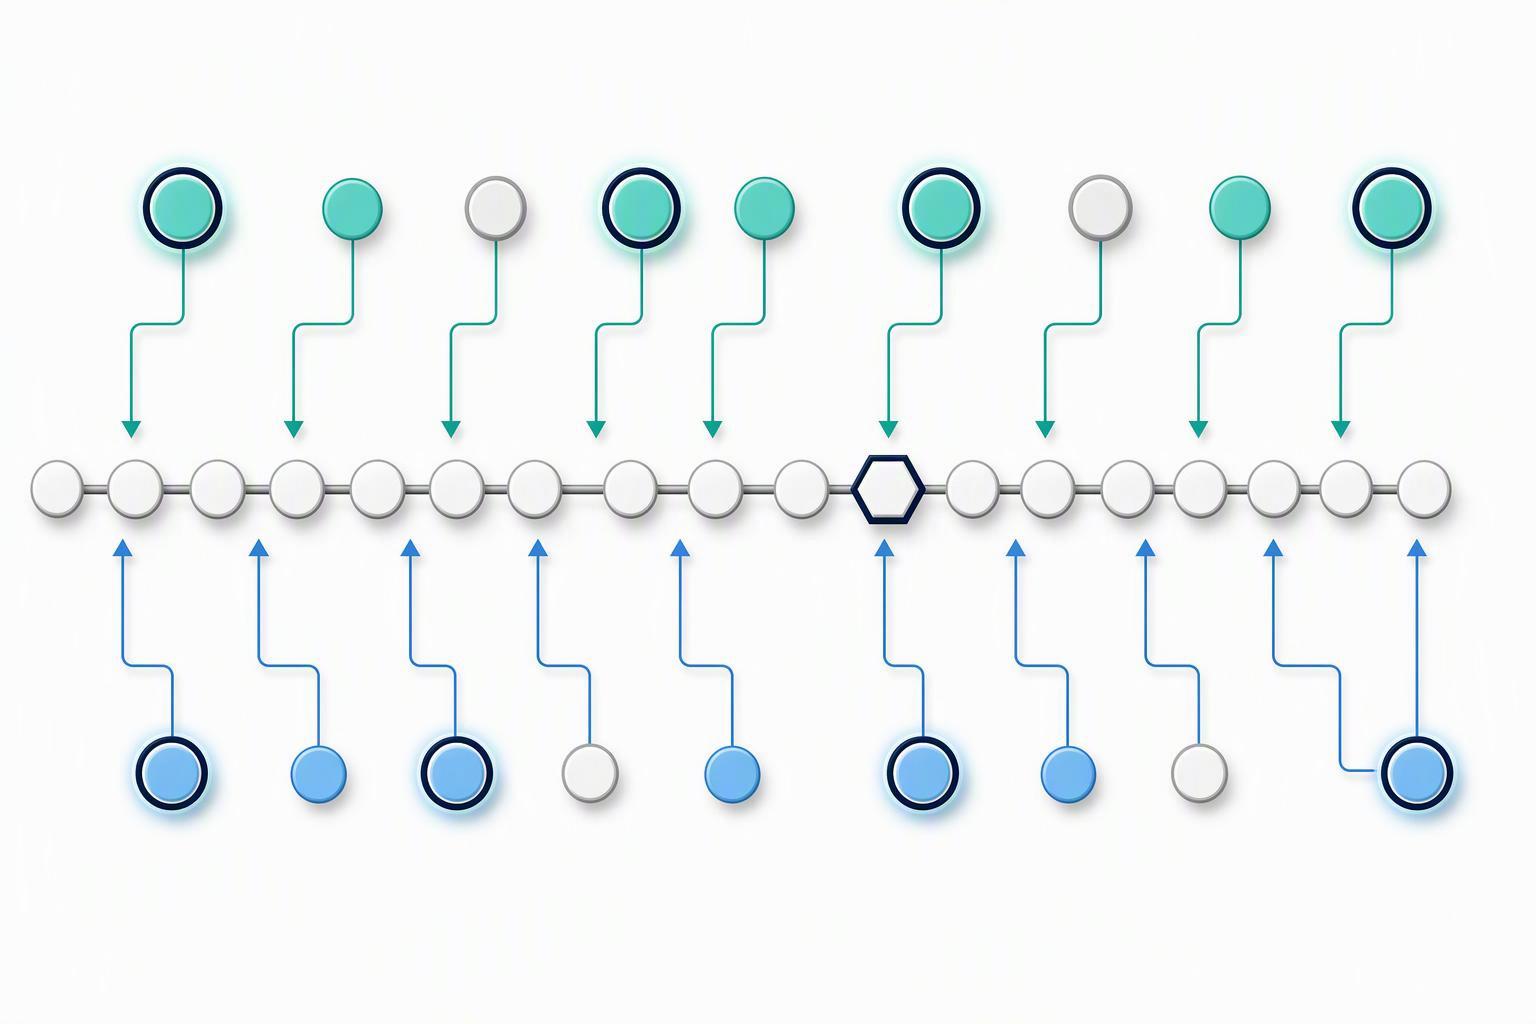
Lokalisering er en separat måling fra identifikation, med sin egen score, sin egen tærskel og sin egen fejlrate. Det kombinatoriske grundlag for, hvorfor masse alene ikke kan lukke et identitetskrav, er gammelt og fast: blandt peptider, der afviger i sammensætning med én, to eller tre aminosyrer, 10%, 29% og 53% har masseidentiske isomerer, og eksklusive leucin/isoleucin-isomerer er tallene 14% og 38% (Han et al., J Proteome Res, 2004). Disse isomere peptider kan ikke skelnes efter masse, og tandem massespektrometri eller andre yderligere begrænsninger er nødvendige.
Lokaliseringsresultater fungerer ved at sammenligne stedbestemmende fragmenter. En nuværende implementering sammenligner den bedst scorende peptidoform med modifikationen på et sted med den bedst scorende peptidoform uden den, ignorerer delte toppe, fordi de ikke giver nogen diskrimination, og driver kun tillid til lokalisering fra diskriminerende toppe (PTMprofet, 2019). Denne implementering anvendte lokalisering ved iProphet-sandsynlighedstærskler på 0.9 for to datasæt og 0.8 for en tredjedel, sidstnævnte svarende til 0.4% estimeret PSM fejl og 97.9% PSM-følsomhed, og rapporterede resultater kl 5% falsk lokaliseringsrate og derunder 1% FLR (PTMprofet, 2019).
De klassiske lokaliseringstærskler er scorebaserede og bør ikke behandles som universelle acceptkriterier. AScore 19 svarer omtrent til p 0.01, eller 99% sikkerhed, og senere phosphoproteomics praksis fra samme laboratorium brugte en mere liberal p < 0.05, AScore > 13; Spectrum Mill kræver en scoreforskel større end 1.1 mellem de to øverste lokaliseringer for sikker lokalisering (Ændring af webstedslokaliseringsscore, 2012). Den samme anmeldelse advarer om, at sandsynlighedsbaserede score hviler på en urealistisk antagelse om, at alle masser er lige sandsynlige, at de bliver observeret tilfældigt, og anbefaler at behandle dem som scorer underlagt en brugerdefineret tærskel snarere end som nøjagtige mål for sikkerhed.
Denne advarsel bekræftes af, hvordan tærskler faktisk er valgt. PTMProphet beskriver valg af lokaliseringssandsynlighedstærsklen som stort set et vilkårligt valg foretaget af brugeren, skal indstilles af den fejlrate, som brugeren accepterer (PTMprofet, 2019). Ingen standard fastsætter et nummer, så det forsvarlige træk er at angive tærsklen, angiv den fejlrate det svarer til, og rapporter lokaliseringshastigheden sammen med identifikationshastigheden.
For et mærket peptid, et forventet intakt masseskift understøtter en foreslået sammensætning, men beviser ikke etikettens kemi eller vedhæftningssted. Brug stedbestemmende fragmenter og, hvor det er nødvendigt, en ortogonal strukturel metode til at teste den foreslåede etiket og kobling.
Hvilken ortogonal teknik besvarer hvilket identitetsspørgsmål?
Hver teknik besvarer et andet spørgsmål, og kortlægningen betyder mere end optællingen. De 2025 Europæisk retningslinje for syntetiske peptider, i kraft siden juni 2026, anbefaler brug af mindst to ortogonale metoder til identifikation som en del af specifikation og frigivelse, og lister masse, relativ opbevaringstid, LC-MS, peptidkortlægning, bioaktivitet, aminosyreanalyse eller NMR efter behov, med den nødvendige kombination for entydigt at bekræfte rækkefølgen (EMA, Vejledning om udvikling og fremstilling af syntetiske peptider, 2025-12-04, effektiv 2026-06-01).
Den regulatoriske logik nedenunder er præstationsbaseret snarere end numerisk. I Q2(R2) kræver identifikation for at demonstrere evnen til at skelne analytten ved unikke molekylære strukturaspekter, bekræftet af positive resultater mod et referencemateriale plus negative resultater fra prøver, der mangler analytten, og hvor en procedure ikke er tilstrækkeligt diskriminerende, en yderligere procedure bør anvendes (I Q2(R2), vedtaget 2023-11-01, rettet 2023-11-30). Specificitetskravet er en kapacitetstest, ikke et antal prøver.
Referencestandardpraksis for peptididentitet konvergerer i samme retning uden at fastsætte et tal: flere ortogonale teknikker bruges typisk til at verificere kemisk struktur og kemisk identitet, inklusive HPLC-retentionstid, NMR, MS og kiral testning, og multilaboratorieundersøgelser anvender NMR, peptidkortlægning, HPLC og aminosyreanalyse (Farmaceutisk forskning, 2023). HPLC-identitet i denne praksis er afhængig af retentionstid sammenligning med en referencestandard, hvorfor en opbevaringstid uden en standard ikke er et identitetsresultat.
Metoden til spørgsmål kortlægger det Peptider Engrosleverandør følger af disse kilder:
|
Identitetsspørgsmål |
Teknik, der besvarer det |
Hvad den ikke svarer |
|---|---|---|
|
Er den intakte masse korrekt? |
LC-MS or MALDI-TOF intact mass |
Sekvens, positional or stereochemical features |
|
Is the sequence correct? |
MS/MS with sequence coverage, or peptide mapping |
Labile modifications, partial coverage gaps |
|
Where is the modification or label? |
MS/MS site-determining fragments with a stated localization threshold |
Whether the site is functionally relevant Melittin |
|
Is the stereochemistry correct? |
Validated chiral analysis; ordinary amino acid composition analysis alone does not establish stereochemistry |
Position of a modification |
|
Is it the same material as the standard? Custom Peptide Engros |
HPLC retention time against a reference standard |
Anything the standard itself does not establish |
The COA review habit of keeping each conclusion with its method is the practical version of this table: kromatografisk renhed beskriver kromatografisk homogenitet og etablerer ikke selvstændigt kemisk identitet, intakt masse alene kan ikke etablere hver sekvens, positionelt eller stereokemisk træk, og identitet og renhed skal rapporteres separat og knyttes til de metoder, der understøtter dem (Vector E Lab, 2026-09-28).
Det, der skal nedskrives før erhvervelsen, for at identitetskravet kan forsvares?
Posten skal være fuldstændig nok til, at en anden kan køre den samme eller en lignende søgning på den samme eller en anden motor. Udvekslingsformatet, der bærer søgeprotokollen, kræver, at SpectrumIdentificationProtocol erklærer en søgetype såsom scoring på peptidniveau eller modifikationslokaliseringsscoring, kræver, at søgemaskiner er repræsenteret i softwarelisten, og er designet til præcis den reproducerbarhed (mzIdentML 1.3.0, juni 2024).
Foranskaffelsesrekorden, samlet ud fra ovenstående rapporteringsstandarder:
-
Udvælgelsesstrategi og dens parametre. TopN-værdi, isolationsvindue, dynamisk udelukkelsesvarighed, og om en eksklusionsliste overføres mellem kørsler.
-
Tolerancer. Precursor- og fragmentmassetolerance, angivet som tal. De 2016 undersøgelse brugt 10 ppm og 0.5 Og (Kreimer et al., J Proteome Res, 2016); den nøjagtighed på instrumentniveau, som metoden skal matches til, er nedenfor 3 ppm RMS overstået 24 h med ekstern kalibrering og derunder 1 ppm RMS med intern kalibrering på en aktuel Orbitrap-platform (Thermo Fisher specifikationsark, leverandørark udgivet i øjeblikket).
-
Søgemaskine og version, database og version med entry count, og FDR-estimeringsmetoden. Target-decoy-søgning er den accepterede måde at skelne korrekt fra forkert identifikation, og fordi de fleste søgemaskiner returnerer resultater selv for uovertrufne spektre, fejlprocenter skal estimeres ud fra scorefordelingen (Elias & Gygi, Naturens metoder, 2007). Per-peptid konfidens kommer fra en probabilistisk model, der beregner sandsynligheden for, at hver tildeling er korrekt, muliggør filtrering med forudsigelige fejlfrekvenser (Keller et al., Anal Chem, 2002).
-
Site-assignment-metoden og dens tærskel, med annoterede spektre for hvert peptid, hvor et modifikationssted er rapporteret.
-
Repliker struktur. Antal replikater, og om de er biologiske, proces eller teknisk.
-
Arkiv-id'en. PXD-identifikatorer er vedvarende, unik og obligatorisk som hovedidentifikation for oprindeligt indsendte datasæt, med metadata plus rå og behandlede filer deponeret sammen, og RPXD identifikatorer for genanalyserede datasæt (ProteomeXchange konsortium, Nukleinsyreforskning, 2026-01-06).
Beslutningsreglen, anvendt før erhvervelsen: hvis du ikke kan skrive udvælgelsesstrategien ned, tolerancerne, søgeparametrene, lokaliseringstærsklen og replikatstrukturen på forhånd, identitetskravet vil ikke kunne forsvares efterfølgende. Every one of those fields is a decision, and each one is cheaper to make before the run than to reconstruct after it.
Ofte stillede spørgsmål
Betyder lav teknisk-replikat overlapning min metode er dårlig?
Ikke nødvendigvis. Conventional DDA selects only the most intense precursors in each cycle, so low overlap between replicates is expected sampling behavior rather than a reproducibility failure (Tabb et al., J Proteome Res, 2010). The question to ask is what the replicate design was meant to demonstrate.
Må jeg citere 29% figur som et generelt benchmark?
Ingen. It comes from one 2016 study on an LTQ Orbitrap XL with a HeLa digest and a 120 min gradient (Kreimer et al., J Proteome Res, 2016). Quote it with that scope attached, or state the mechanism qualitatively.
Hvilken sekvensdækning skal jeg sætte i en specifikation?
No regulator-backed minimum exists. State the threshold you applied, bekræfte, at dækningen omfatter rester, der bærer modifikationen eller etiketten, og rapporter søgeparametrene, der lader en anmelder gengive beregningen.
Er intakt nok til at bekræfte identiteten?
Ingen. Blandt peptider, der adskiller sig med én, to eller tre aminosyrer, 10%, 29% og 53% har masseidentiske isomerer (Han et al., J Proteome Res, 2004). Masse er en ortogonal metode, ikke et fuldstændigt identitetskrav.
Har jeg brug for præcis to ortogonale metoder?
De 2025 Europæisk retningslinje anbefaler mindst to til syntetisk peptididentifikation (EMA, effektiv 2026-06-01), mens ICH Q2(R2) rammer kravet som specificitetsbaseret snarere end et fast antal (jeg, 2023). Kombinationen skal entydigt bekræfte rækkefølgen; tallet følger deraf.
Konklusion
Identitetskravet er bygget før erhvervelse, ikke efter det. Precursor-selektionsstrategi afgør, hvilke peptider der bliver prøvet, replikatdesign afgør, om overlapning er informativt eller tilfældigt, dækningsrapportering afgør, om den modificerede rest faktisk er inde i beviset, og ortogonal karakterisering afgør, om påstanden overlever en anmelder, der ved, at masse alene efterlader isomerer uløste.
Det næste trin er en rekord før erhvervelse: udvælgelsesstrategi, tolerancer, søgeparametre, lokaliseringstærskel, replikere struktur og arkiv identifikator, nedskrevet og versionsstyret før første indsprøjtning. Hvis der mangler et felt, rette det før løbet i stedet for i svaret til en anmelder.
Til teams, der sammenligner serviceomfang for brugerdefinerede, modificerede og mærkede peptider, anmod om et tilbud, der angiver de analytiske parametre ovenfor i stedet for et renhedstal alene.
De anførte analytiske standarder og metodesammenligninger er uafhængige publicerede kilder.*