Respuesta rápida
Think of precursor selection as a sampling strategy rather than a detector setting. A detector reports what reaches it; the sampling strategy decides what gets…
¿Qué cambia realmente la selección avanzada de iones precursores en comparación con el TopN DDA convencional??
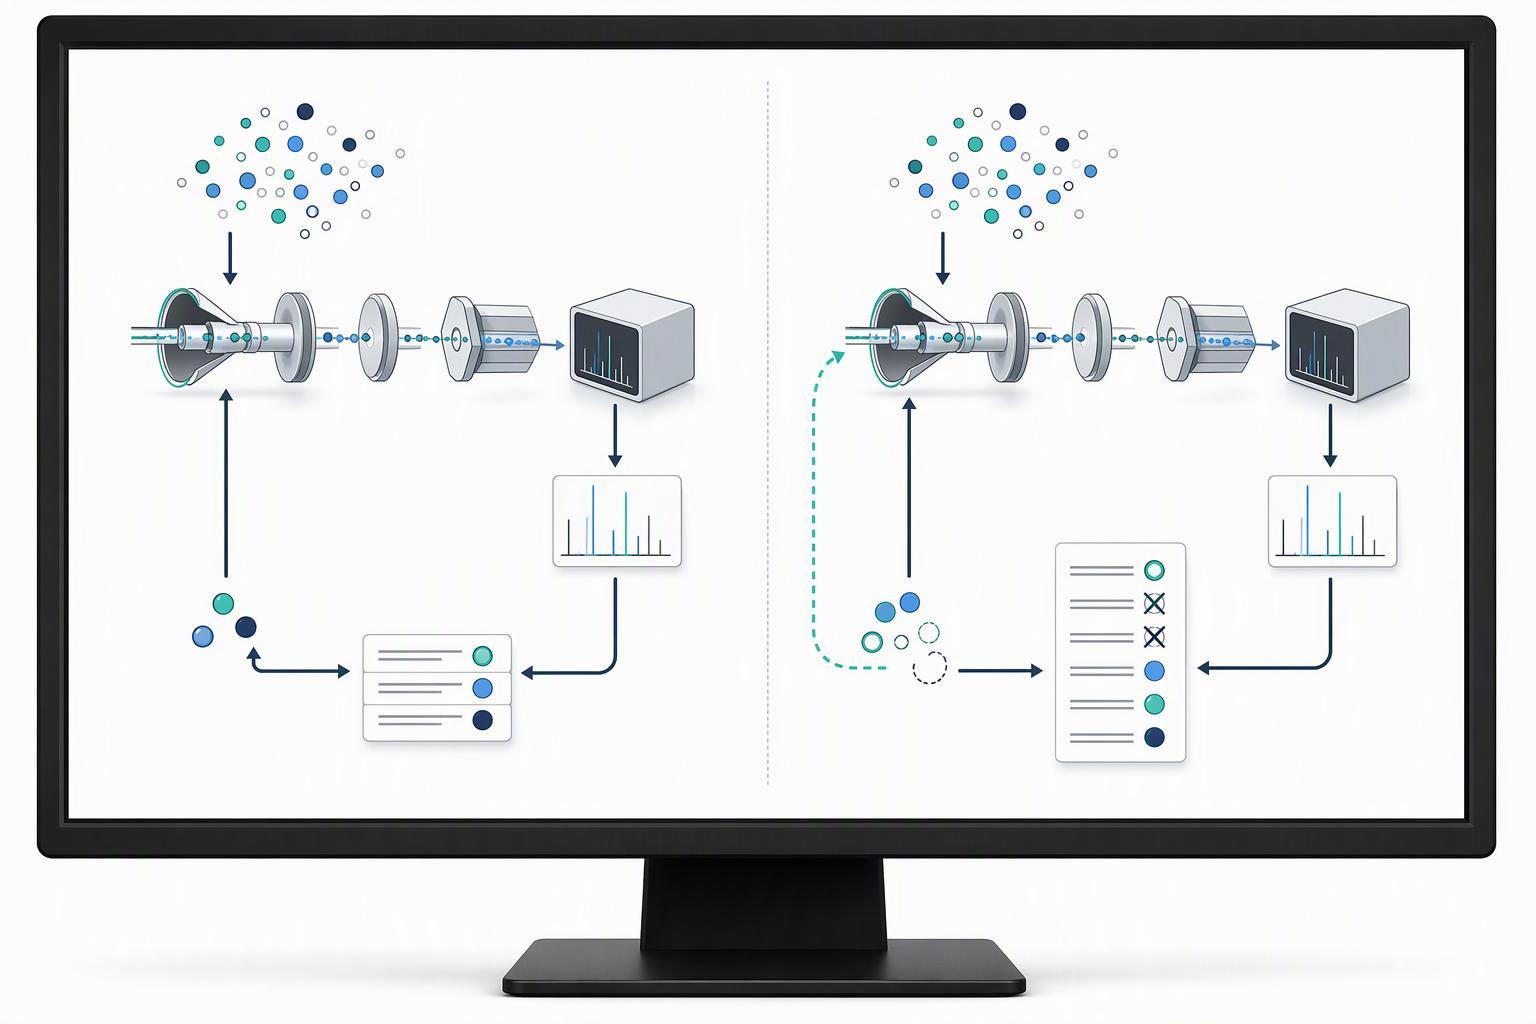
Péptido sintético Hormonas de crecimiento de péptidos Cambia el bucle de muestreo., no el detector. El TopN DDA convencional selecciona los N precursores elegibles más intensos en cada ciclo MS1, y la exclusión dinámica impide la reselección inmediata, por lo que la selección se basa en gran medida en la intensidad y se toman muestras de abundantes péptidos una y otra vez (Kreimer et al., J proteoma res, 2016). El instrumento funciona correctamente.; la estrategia simplemente sigue regresando al mismo vecindario.
Kreimer y otros. comparó dos estrategias de exclusión iterativa: excluyendo todos los precursores previamente fragmentados y excluyendo solo los péptidos identificados. Estos son diseños distintos con diferentes resultados.. Describa qué lista de exclusión se utilizó antes de cotizar la ganancia., y conservar el resumen HeLa del estudio y el alcance LTQ Orbitrap XL. estudio original.
Una tercera variante empuja aún más la exclusión: La búsqueda en la base de datos en tiempo real durante la adquisición permite la exclusión por identidad peptídica en lugar de por un evento m/z y temporal.. Los primeros trabajos de simulación sobre selección adaptativa de picos encontraron que esto agregaba como máximo alrededor de un 1% ganancia sobre la selección de lista de exclusión estándar (preimpresión de arXiv 1207.5848, Dakota del Norte.). Trate ese número como un resultado de simulación., no es un punto de referencia, y no lo cite como un resultado de instrumento medido.
en el citado 2016 estudiar, la saturación TopN convencional cerca 12,500 péptidos únicos fue una extrapolación. Los experimentos combinados de exclusión iterativa excedieron 16,000 identificaciones. La comparación ilustra el muestreo complementario bajo ese diseño., no es universal 29% ganar sobre un control de ejecución única igualado.
La búsqueda de especies coaisladas puede aumentar la profundidad de la identificación en el citado 2025 estudiar. Sus porcentajes informados utilizan comparaciones diferentes y deben conservar sus propios denominadores.; no deben combinarse en un promedio que exceda un rango establecido ni fusionarse con ganancias de exclusión iterativa.
La selección de precursores afecta qué evidencia de fragmentación se adquiere.. Es posible que todavía haya una característica no fragmentada en los datos de MS1; no se le puede asignar una confianza de secuencia equivalente sin evidencia de respaldo adecuada. La búsqueda mejorada puede recuperar información ya presente en los espectros adquiridos.
¿Por qué la superposición técnica-réplica puede ser baja sin que el método sea irreproducible??
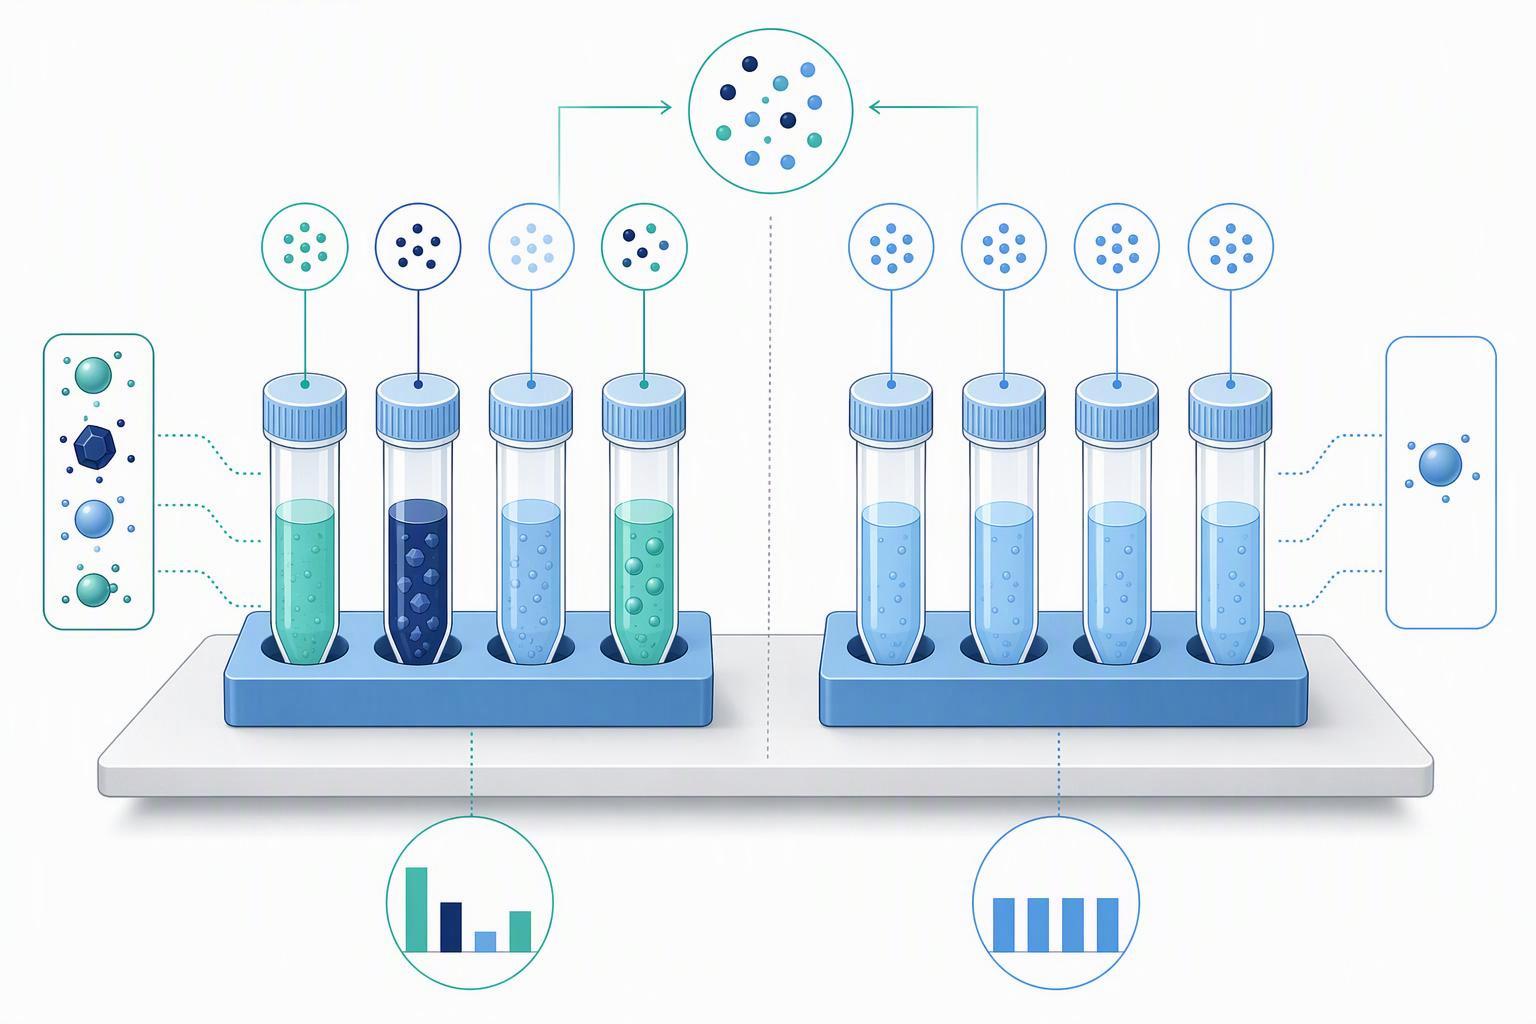
Porque la baja superposición y la mala reproducibilidad son medidas diferentes, y un diseño de descubrimiento en profundidad puede producir el primero mientras el método sigue siendo perfectamente repetible. El rango de larga data para la superposición de péptidos replicados en DDA convencional es del 35% al 60% entre pares de réplicas técnicas, una figura que proviene de un 2010 Nuevo análisis de LTQ y de instrumentos Orbitrap más antiguos. (Tabb et al., J proteoma res, 2010). Ese estudio también encontró que la superposición era independiente de la complejidad de la muestra.: una mezcla de 48 proteínas dio una mediana 44% superposición, una mezcla estándar de proteínas 46%, y un digerido de levadura 45% (Tabb et al., J proteoma res, 2010). Repetibilidad correlacionada con la intensidad del precursor., por lo que los péptidos de baja abundancia fueron los que abandonaron.
Esa es la distinción clave. Si su diseño replicado mantiene la muestra constante y no varía nada más que la inyección, La superposición baja significa que el método está muestreando estocásticamente., que se espera para el PDD. Si su diseño está destinado a demostrar reproducibilidad, es necesario indicar qué se mantiene constante y qué varía, y la guía del autor de MCP requiere exactamente eso: el número de réplicas adquiridas con una clara distinción entre biológicas, proceso y réplicas técnicas, además del método y tipo de aleatorización, controles técnicos, y el lapso de tiempo del análisis de la muestra (Instrucciones de MCP para los autores).
Dos experimentos independientes recientes muestran hasta qué punto el problema de superposición depende de la adquisición.. Una comparación directa entre DDA y DIA en las mismas muestras encontró más de 92% de péptidos identificados consistentemente en réplicas en datos de DIA versus menos de 77% en datos del PDD, con una consistencia a nivel de proteína de 99.0/98.2/98.2% por DIA contra 95.6/95.4/96.2% para el PDD (PMC12801617, 2025). Una comparación de integridad de ocho réplicas en el líquido lagrimal encontró DIA en 78.5% completitud del péptido versus 48% para el PDD, con CV medianos de 10.6% y 22.3% respectivamente (Laboratorio J Mass Spectrom Adv Clin, 2025). Dos métricas diferentes, presencia/ausencia consistencia y coeficiente de variación, apuntar de la misma manera.
La brecha honesta: ninguna fuente en este conjunto vuelve a medir el 2010 figura de superposición en la instrumentación actual. El rango del 35% al 60% debe fecharse siempre que se cite, y la evidencia de DIA versus DDA cubre líneas celulares y líquido lagrimal únicamente. Ninguna fuente aquí compara los dos modos en un fosfoproteoma u otra muestra enriquecida con PTM, por lo que cualquier afirmación sobre DIA versus DDA para péptidos modificados no estaría respaldada.
Antes de la adquisición, distinguir un diseño de profundidad de descubrimiento de un estudio de repetibilidad. Una superposición baja después de una exclusión deliberada puede indicar un muestreo complementario, pero también verifique la confianza de la identificación, cobertura total y calidad de la muestra; La baja superposición por sí sola no prueba que la estrategia esté funcionando..
¿Cuánta cobertura de secuencia es suficiente?, y donde tiene que caer la cobertura?
Definir la métrica de cobertura antes de establecer un criterio. La cobertura de la secuencia de proteínas cuenta los residuos representados por los péptidos identificados.; la cobertura de iones fragmentados de un péptido sintético es una medida diferente. Ningún porcentaje por sí solo establece el orden de los residuos, posición de modificación o estereoquímica. Establezca los iones de diagnóstico necesarios y las pruebas ortogonales para la construcción..
La regla de colocación se deriva de esa definición.. Para un péptido modificado o marcado, la cobertura tiene que incluir el residuo que lleva la modificación o la etiqueta. A 95% mapa de cobertura que deja el sitio modificado en el descubierto 5% no admite un reclamo de identidad específico del sitio, no importa lo alto que parezca el porcentaje.
Esa es la práctica de los proveedores., no es un umbral regulatorio, y debe estar etiquetado como tal en cualquier especificación que escriba.
Lo que un revisor realmente puede exigirle es el conjunto de informes.. La guía de la revista que un lector puede seguir requiere tolerancias de masa de iones precursores y iones fragmentados., el motor de búsqueda y la versión, la base de datos, el método de estimación de FDR, y el software o método utilizado para evaluar la asignación del sitio de modificación, con espectros anotados para cada péptido donde se informa un sitio de modificación (Tutorial de MCP para el envío de datos de proteómica, Guía para autores de MCP). La lista de verificación de información mínima agrega el nombre del software, versión y fabricante, bases de datos consultadas con versiones y recuentos de entradas, y los archivos de parámetros (MIAPE-MSI 1.1, 2008-02-05). MIAPE es el 2008 lista de verificación y permanece en la versión 1.1; no es un requisito nuevo.
Entonces, la respuesta práctica a "¿qué número de cobertura aceptará un revisor?" es: indique el umbral que aplicó, Estado donde cae la cobertura en relación con Péptido de semaglutida el residuo modificado, e informar los parámetros que permiten a alguien reproducir el cálculo. Un número sin esas tres cosas no es defendible.
¿Cómo se localiza una modificación o una etiqueta en lugar de simplemente confirmar la masa intacta??
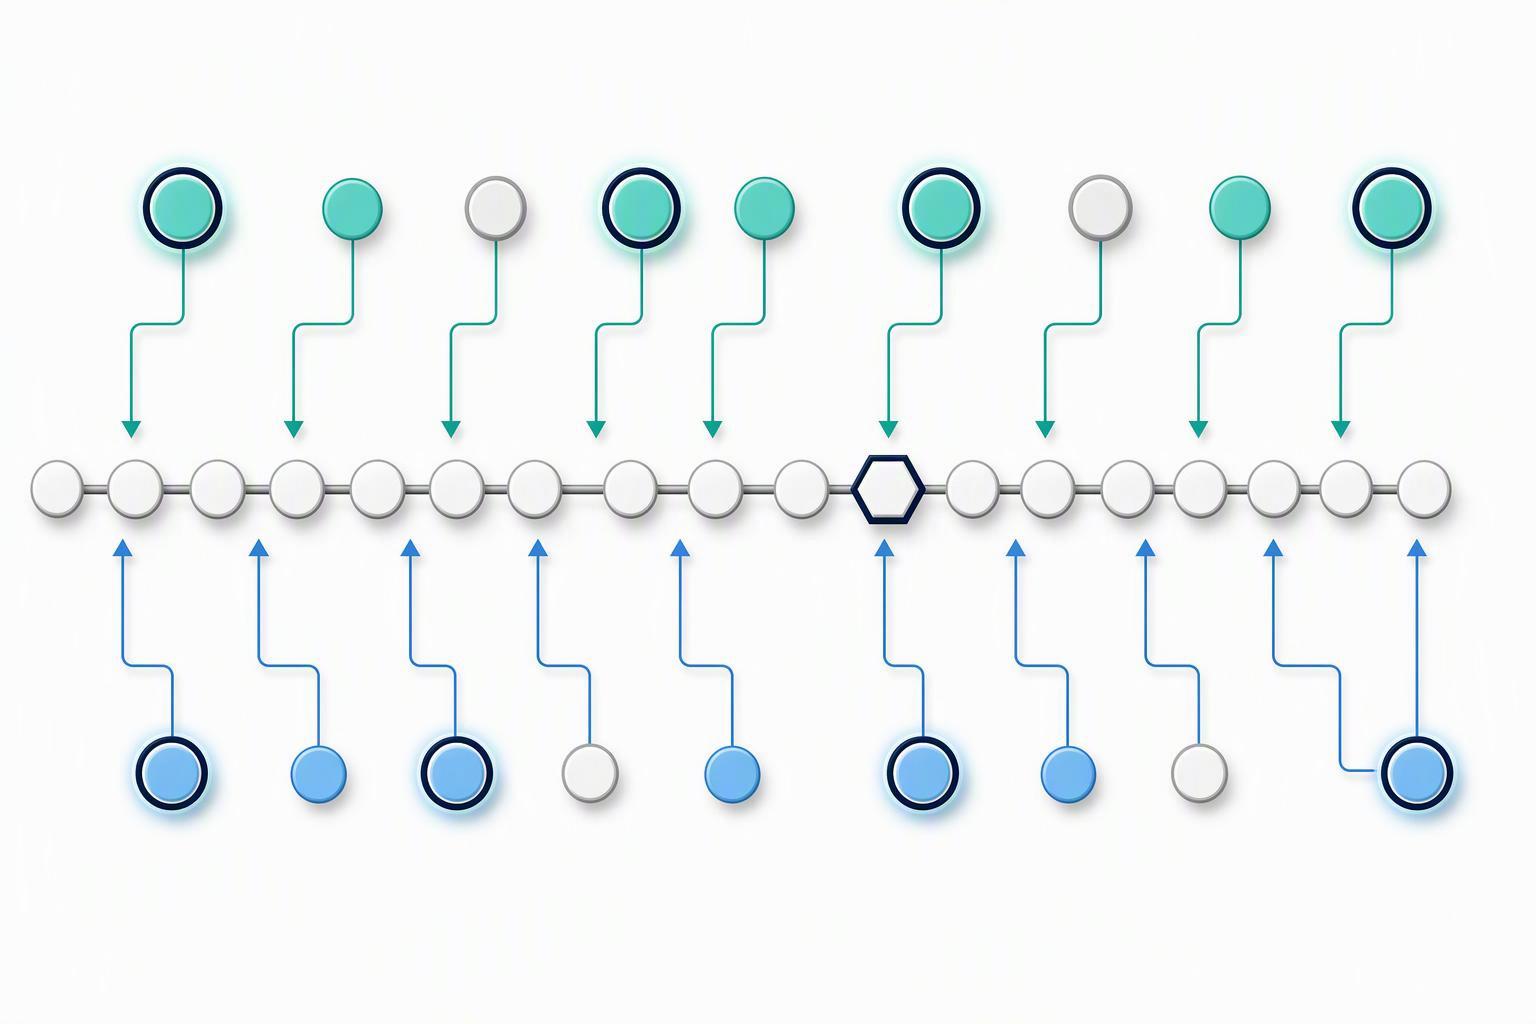
La localización es una medida separada de la identificación., con su propia puntuación, su propio umbral y su propia tasa de error. La base combinatoria de por qué la masa por sí sola no puede cerrar una reivindicación de identidad es vieja y firme: entre péptidos que difieren en composición en uno, dos o tres aminoácidos, 10%, 29% y 53% respectivamente tienen isómeros de masa idéntica, y excluyendo los isómeros de leucina/isoleucina, las cifras son 14% y 38% (He et al., J proteoma res, 2004). Esos péptidos isoméricos no se pueden distinguir por su masa., y se necesitan espectrometría de masas en tándem u otras limitaciones adicionales.
Las puntuaciones de localización funcionan comparando fragmentos que determinan el sitio. Una implementación actual compara la peptidoforma con mejor puntuación con la modificación en un sitio con la peptidoforma con mejor puntuación sin ella., ignora los picos compartidos porque no proporcionan discriminación, e impulsa la confianza en la localización solo desde picos discriminatorios (PTMProfeta, 2019). Esa implementación aplicó la localización en umbrales de probabilidad de iProphet de 0.9 para dos conjuntos de datos y 0.8 por un tercero, este último correspondiente a 0.4% error estimado de PSM y 97.9% Sensibilidad PSM, y reportó resultados en 5% tasa de localización falsa y por debajo 1% FLR (PTMProfeta, 2019).
Los umbrales de localización clásicos se basan en puntuaciones y no deben tratarse como criterios de aceptación universal.. Puntuación AS 19 corresponde a p aproximadamente 0.01, o 99% certeza, y posteriormente la práctica de fosfoproteómica del mismo laboratorio utilizó una p más liberal. < 0.05, Puntuación AS > 13; Spectrum Mill requiere una diferencia de puntaje mayor que 1.1 entre las dos localizaciones principales para una localización segura (Puntuación de localización del sitio de modificación, 2012). La misma revisión advierte que las puntuaciones basadas en la probabilidad se basan en una suposición poco realista de que todas las masas tienen la misma probabilidad de ser observadas al azar., y recomienda tratarlos como puntuaciones sujetas a un umbral establecido por el usuario en lugar de medidas precisas de certeza..
Esa advertencia se ve confirmada por la forma en que se eligen realmente los umbrales.. PTMProphet describe la selección del umbral de probabilidad de localización como una elección en gran medida arbitraria realizada por el usuario., a ser establecido por la tasa de error que el usuario acepta (PTMProfeta, 2019). Ningún estándar fija un número, entonces la medida defendible es establecer el umbral, Indique la tasa de error a la que corresponde., e informar la tasa de localización junto con la tasa de identificación.
Para un péptido marcado, un cambio de masa intacto esperado respalda una composición propuesta pero no prueba la química de la etiqueta o el sitio de unión. Utilice fragmentos que determinen el sitio y, donde sea necesario, un método estructural ortogonal para probar la etiqueta y el enlace propuestos.
¿Qué técnica ortogonal responde a qué pregunta de identidad??
Cada técnica responde a una pregunta diferente, y el mapeo importa más que el conteo. El 2025 Directriz europea para péptidos sintéticos., vigente desde junio 2026, recomienda el uso de al menos dos métodos ortogonales para la identificación como parte de la especificación y publicación, y enumera masa, tiempo de retención relativo, LC-MS, mapeo de péptidos, bioactividad, análisis de aminoácidos o RMN según corresponda, con la combinación necesaria para confirmar inequívocamente la secuencia (EMA, Directrices sobre desarrollo y fabricación de péptidos sintéticos, 2025-12-04, eficaz 2026-06-01).
La lógica regulatoria subyacente se basa en el desempeño en lugar de en números.. Yo Q2(R2) Requiere identificación para demostrar la capacidad de distinguir el analito por aspectos únicos de la estructura molecular., confirmado por resultados positivos frente a un material de referencia más resultados negativos de muestras que carecen del analito, y cuando un procedimiento no sea suficientemente discriminatorio, se debe utilizar un procedimiento adicional (Yo Q2(R2), adoptado 2023-11-01, corregido 2023-11-30). El requisito de especificidad es una prueba de capacidad., no un recuento de pruebas.
La práctica estándar de referencia para la identidad peptídica converge en la misma dirección sin fijar un número: Por lo general, se utilizan múltiples técnicas ortogonales para verificar la estructura química y la identidad química., incluido el tiempo de retención de HPLC, RMN, EM y pruebas quirales, y los estudios de múltiples laboratorios utilizan RMN, mapeo de péptidos, HPLC y análisis de aminoácidos. (Investigación farmacéutica, 2023). La identidad de HPLC en esa práctica se basa en la comparación del tiempo de retención con un estándar de referencia., por eso un tiempo de retención sin estándar no es un resultado de identidad.
El mapeo del método a la pregunta que Proveedor mayorista de péptidos se desprende de estas fuentes:
|
Pregunta de identidad |
Técnica que la responde |
lo que no responde |
|---|---|---|
|
¿Es correcta la masa intacta?? |
Masa intacta LC-MS o MALDI-TOF |
Secuencia, características posicionales o estereoquímicas |
|
¿Es correcta la secuencia?? |
MS/MS con cobertura de secuencia, o mapeo de péptidos |
Modificaciones lábiles, brechas de cobertura parciales |
|
¿Dónde está la modificación o etiqueta?? |
Fragmentos determinantes del sitio MS/MS con un umbral de localización establecido |
Si el sitio es funcionalmente relevante melitina |
|
¿Es correcta la estereoquímica?? |
Análisis quiral validado.; El análisis ordinario de la composición de aminoácidos por sí solo no establece la estereoquímica. |
Posición de una modificación |
|
¿Es el mismo material que el estándar?? Venta al por mayor de péptidos personalizados |
Tiempo de retención de HPLC frente a un estándar de referencia |
Todo lo que la propia norma no establece |
El hábito de revisión del COA de mantener cada conclusión con su método es la versión práctica de esta tabla.: La pureza cromatográfica describe la homogeneidad cromatográfica y no establece de forma independiente la identidad química., la masa intacta por sí sola puede no establecer todas las secuencias, característica posicional o estereoquímica, y la identidad y la pureza deben informarse por separado y adjuntarse a los métodos que las respaldan. (Laboratorio Vector E, 2026-09-28).
Qué debe escribirse antes de la adquisición para que la reivindicación de identidad sea defendible?
El registro debe ser lo suficientemente completo como para que otra persona pueda volver a ejecutar la misma búsqueda o una similar en el mismo motor o en otro.. El formato de intercambio que lleva el protocolo de búsqueda requiere que SpectrumIdentificationProtocol declare un tipo de búsqueda, como puntuación a nivel de péptido o puntuación de localización de modificación., requiere que los motores de búsqueda estén representados en la lista de software, y está diseñado exactamente para esa reproducibilidad (mzIdentML 1.3.0, Junio 2024).
El récord previo a la adquisición, ensamblado a partir de los estándares de informes anteriores:
-
Estrategia de selección y sus parámetros.. Valor N superior, ventana de aislamiento, duración de la exclusión dinámica, y si una lista de exclusión se traslada entre ejecuciones.
-
Tolerancias. Tolerancia de masa de precursores y fragmentos., expresados como números. El 2016 estudio utilizado 10 ppm y 0.5 Y (Kreimer et al., J proteoma res, 2016); la precisión a nivel de instrumento con la que se debe hacer coincidir el método está por debajo 3 ppm RMS por encima 24 h con calibración externa y por debajo 1 ppm RMS con calibración interna en una plataforma Orbitrap actual (Hoja de especificaciones de Thermo Fisher, hoja de proveedor actualmente publicada).
-
Motor de búsqueda y versión., base de datos y versión con recuento de entradas, y el método de estimación de FDR. La búsqueda de señuelos de destino es la forma aceptada de distinguir las identificaciones correctas de las incorrectas., y porque la mayoría de los motores de búsqueda devuelven resultados incluso para espectros incomparables, Las tasas de error deben estimarse a partir de la distribución de puntuaciones. (Elías & gigi, Métodos de la naturaleza, 2007). La confianza por péptido proviene de un modelo probabilístico que calcula la probabilidad de que cada asignación sea correcta., permitiendo el filtrado con tasas de error predecibles (Keller et al., química anal, 2002).
-
El método de asignación de sitios y su umbral., con espectros anotados para cada péptido donde se informa un sitio de modificación.
-
Replicar estructura. Número de réplicas, y si son biológicos, proceso o técnica.
-
El identificador del archivo. Los identificadores PXD son persistentes, Único y obligatorio como identificador principal para los conjuntos de datos enviados originalmente., con metadatos más archivos sin procesar y procesados depositados juntos, e identificadores RPXD para conjuntos de datos reanalizados (Consorcio ProteomeXchange, Investigación de ácidos nucleicos, 2026-01-06).
La regla de decisión, aplicado antes de la adquisición: si no puedes escribir la estrategia de selección, las tolerancias, los parámetros de búsqueda, el umbral de localización y la estructura replicada de antemano, el reclamo de identidad no será defendible después. Cada uno de esos campos es una decisión., y cada uno es más barato de hacer antes de la ejecución que de reconstruir después de ella..
Preguntas frecuentes
¿La baja superposición técnica-replicación significa que mi método es malo??
No necesariamente. La DDA convencional selecciona solo los precursores más intensos en cada ciclo., por lo que se espera una baja superposición entre réplicas, un comportamiento de muestreo en lugar de una falla de reproducibilidad (Tabb et al., J proteoma res, 2010). La pregunta que cabe plantearse es qué pretendía demostrar el diseño replicado..
¿Puedo citar el 29% figura como punto de referencia general?
No. Viene de uno 2016 estudio en un LTQ Orbitrap XL con un digestor HeLa y un 120 gradiente mínimo (Kreimer et al., J proteoma res, 2016). Cítalo con ese alcance adjunto., o indicar el mecanismo cualitativamente.
¿Qué cobertura de secuencia debo poner en una especificación??
No existe un mínimo respaldado por los reguladores. Indique el umbral que aplicó, Confirmar que la cobertura incluye el residuo que lleva la modificación o etiqueta., e informar los parámetros de búsqueda que permiten a un revisor reproducir el cálculo.
¿Tiene masa intacta suficiente para confirmar la identidad??
No. Entre los péptidos que difieren en uno, dos o tres aminoácidos, 10%, 29% y 53% tienen isómeros de masa idéntica (He et al., J proteoma res, 2004). La masa es un método ortogonal., no es un reclamo de identidad completo.
¿Necesito exactamente dos métodos ortogonales??
El 2025 Una directriz europea recomienda al menos dos para la identificación de péptidos sintéticos (EMA, eficaz 2026-06-01), mientras que ICH Q2(R2) Enmarca el requisito como basado en la especificidad en lugar de un recuento fijo. (I, 2023). La combinación debe confirmar inequívocamente la secuencia.; el número se sigue de eso.
Conclusión
La reivindicación de identidad se construye antes de la adquisición., no después de eso. La estrategia de selección de precursores decide qué péptidos se muestrean, El diseño replicado decide si la superposición es informativa o accidental., El informe de cobertura decide si el residuo modificado está realmente dentro de la evidencia., y la caracterización ortogonal decide si la afirmación sobrevive a un revisor que sabe que la masa por sí sola deja los isómeros sin resolver..
El siguiente paso es un registro previo a la adquisición.: estrategia de selección, tolerancias, parámetros de búsqueda, umbral de localización, replicar estructura e identificador de archivo, escrito y controlado por versión antes de la primera inyección. Si falta algún campo, solucionarlo antes de la ejecución en lugar de en la respuesta a un revisor.
Para equipos que comparan alcances de servicios personalizados, péptidos modificados y marcados, Solicite una cotización que indique los parámetros analíticos anteriores en lugar de solo una cifra de pureza..
Los estándares analíticos y las comparaciones de métodos citados son fuentes publicadas independientes.*