Was ist MAOMAO und warum sind FAIR-Daten zur Peptidtoxizität wichtig??
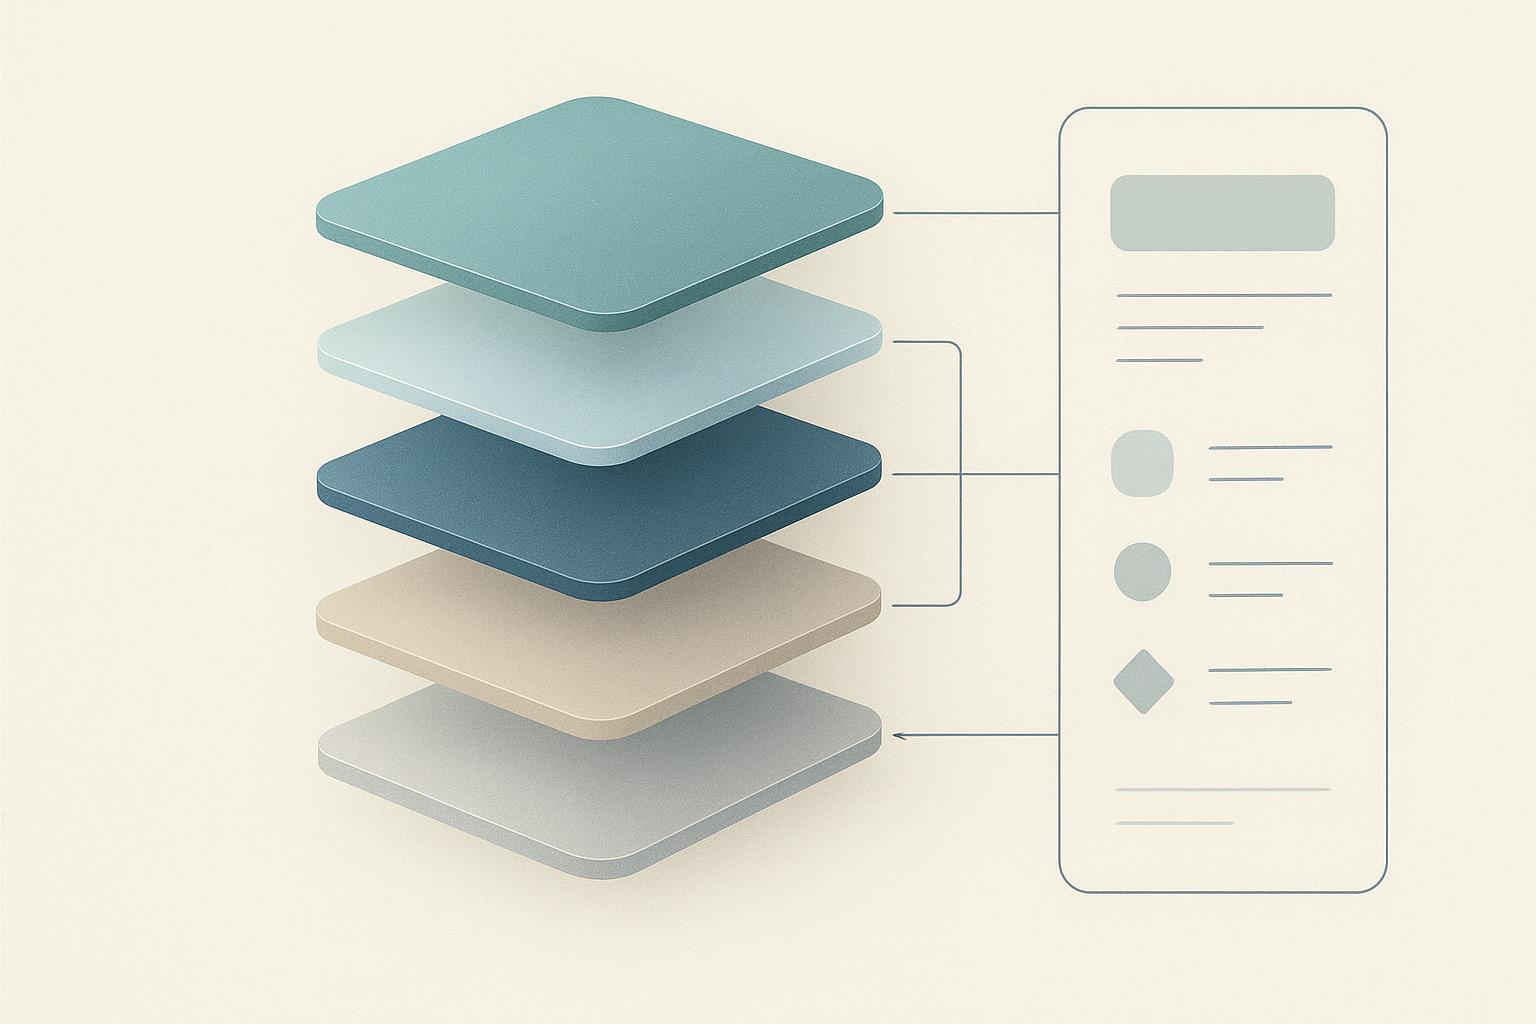
MAOMAO steht für Metadata-Aware Ontology for Multi-source Annotation Organization, eine ontologiegesteuerte Ressource, die Informationen zur Peptidtoxizität aus öffentlichen Datenbanken harmonisiert, Aus der Literatur abgeleitete Ressourcen und kuratierte Datensätze (das MAOMAO-Freigabepapier, 2026). Es handelt sich nicht um eine einzelne Datenbank mit einem einzigen Upstream. Die erste Version ist integriert 56 Quellen, über öffentliche Datenbanken hinweg, Aus der Literatur abgeleitete Ressourcen, ergänzende Datensätze und manuell kuratierte Repositories (gleiches Papier), und konsolidiert sie zu 71,857 einzigartige Peptidsequenzen über acht toxizitätsbezogene Endpunkte hinweg. Die Kernschicht hält 574,856 harmonisierte Peptid-Endpunkt-Kombinationen für diese Sequenzen. Zwischen Juni wurden Suchanfragen auf Google Scholar und PubMed durchgeführt 2025 und September 2026, Daher spiegelt die Veröffentlichung die bis September verfügbaren Ressourcen wider 2026. Zahlen dieser Art variieren je nach Quelle und Kurationsdatum, und ein einzelner Upstream-Datensatz innerhalb der Veröffentlichung trägt nur das Gewicht dieses Upstreams.
FAIRe Peptidtoxizitätsdaten bedeuten etwas enger gefasstes als „gut organisierte Daten“. Dabei handelt es sich um eine Toxizitätsaufzeichnung, die eine dauerhafte Kennung trägt, umfangreiche Provenienz-Metadaten und eine angegebene Lizenz, So kann der Leser nachvollziehen, woher der Anspruch stammt und unter welchen Bedingungen er wiederverwendet werden kann.
Die Analogie: Ein Datensatz ist ein Labornotizbucheintrag, kein Urteil
Behandeln Sie einen Toxizitätsvermerk wie einen Notizbucheintrag mit Herkunftsstempel. Es wird aufgezeichnet, wer den Effekt beobachtet hat, Wann, aus welcher Quelle, auf welchem Organismus, und unter welcher Beweislage. Es bescheinigt nicht, dass eine Sequenz sicher ist. Diese Unterscheidung prägt jede nachgelagerte Entscheidung in diesem Leitfaden, Denn in einer Aufzeichnung erfahren Sie, was behauptet wurde und wie gut es dokumentiert wurde, nicht das, was Sie über Ihren eigenen Kandidaten bewiesen haben.
Was FAIR tatsächlich von einer Toxizitätsaufzeichnung verlangt
Hinter dem Akronym verbergen sich die operativen Anforderungen. Der ursprüngliche FAIR-Prinzipien (Wilkinson et al., Wissenschaftliche Daten, 2016) und die GO FAIR-Übersicht Geben Sie an, dass Daten eine dauerhafte Kennung tragen (F1), dass die Metadaten reichhaltig sind (F2) und enthalten die Kennung der Daten, die sie beschreiben (F3), dass die Herkunft detailliert beschrieben wird (R1.2), dass die Aufzeichnung domänenrelevanten Community-Standards entspricht (R1.3), und das ist klar, Es muss eine barrierefreie Nutzungslizenz angegeben werden (R1.1).
Die harmonisierten Felder von MAOMAO sind die konkrete Umsetzung: Quellenkennungen, Literaturhinweise, Informationen zum Organismus, Herkunft der Anmerkung, Abruftermine, Dateiformate und Versionsinformationen, sofern verfügbar, wobei jede normalisierte Sequenz durch einen deterministischen SHA-256-Bezeichner über dem Großbuchstaben verschlüsselt wird, Leerzeichenfreie Sequenz. Dateien werden als CSV versendet, JSON und YAML.
Schlüssel zum Mitnehmen: Eine kuratierte Toxizitätsaufzeichnung ist eine mit Herkunftsstempel versehene Aussage, kein Sicherheitsurteil.
Warum kuratierte Peptidtoxizitätsmetadaten die Kandidatentriage verändern
Kuratierte Metadaten zur Peptidtoxizität verändern die Triage von Peptidkandidaten, da Sie damit nach der Stärke der zugrunde liegenden Beweise und nicht nach dem Vorhandensein einer Markierung filtern können. Eine Datenbank, die nur „giftig“ oder „ungiftig“ speichert, fasst sehr unterschiedliche Beobachtungen in einem Feld zusammen. MAOMAO trennt sie. Seine Evidenzzustände zeichnen sich positiv aus, Negativ, mehrdeutig, unbeschriftete und keine Informationsaufzeichnungen, und der negative Zustand spaltet sich weiter: Starke Negative wurden ausdrücklich durch experimentelle Beweise gestützt, während schwache Negative aus zufällig ausgewählten Negativsätzen stammten oder keine Bestätigung für das Fehlen von Toxizitätsanmerkungen fehlte (das MAOMAO-Freigabepapier, 2026).
Die Verteilung zeigt, warum diese Unterscheidung Gewicht hat. Über die Veröffentlichung hinweg, MAOMAO berichtet 31,153 positiv, 91,506 Negativ, 15,717 mehrdeutig und 5,044 unbeschriftete Staaten (MAOMAOs eigene Dokumentation seiner Beweise besagt, abgerufen 2026-07-30). Der negative Bereich ist fast dreimal so groß wie der positive Bereich, Eine Triage-Regel, die jedes Negativ als Freigabe behandelt, filtert also nicht nach Beweisen. Es wird nach Lautstärke gefiltert.
|
Beweislage |
Zählen |
Was es bei der Triage unterstützt |
|---|---|---|
|
Peptidsynthese Positiv |
31,153 |
Zur Nachverfolgung markieren; Überprüfen Sie den Endpunkt und den Testkontext |
|
Negativ |
91,506 |
Hängt vom starken vs. schwachen Ursprung ab |
|
Mehrdeutig |
15,717 |
Ein Go/No-Go kann nicht alleine gelöst werden |
|
Unbeschriftet |
5,044 |
Kein nutzbares Signal |
Eine Aufzeichnung lesen und entscheiden, was sie beweist
Nehmen Sie einen Datensatz mit einer abgeleiteten Anmerkung, an den kein Assay-Kontext angehängt ist. Auf dem Etikett steht negativ. Die Herkunft besagt, dass der Anruf eher abgeleitet als gemessen wurde, und kein Endpunkt, Daneben wird die Konzentration oder das Testsystem aufgezeichnet. Zu diesem Zeitpunkt antwortet die Liste nicht: „Ist diese Sequenz sicher weiterzumachen?“ Die Antwort lautet: „Hat jemand eine Toxizitätsbeobachtung auf Sequenzebene für diese Sequenz veröffentlicht?,” und die Antwort ist nein.
Das ist der Entscheidungspunkt. Eine auf dem Vorhandensein eines Labels basierende Triage-Regel leitet den Kandidaten weiter. Eine auf dem Beweisstatus basierende Regel leitet es an den mehrdeutigen oder unbeschrifteten Pfad weiter, wo es entweder einer Literaturprüfung oder einem Assay bedarf, bevor es in die engere Wahl kommt. Die zweite Regel kostet mehr pro Kandidat und führt zu einer Auswahlliste, die Sie verteidigen können.
Die gleiche Logik gilt, wenn zwei Quellen hinsichtlich der Endpunktbezeichnung für eine Sequenz uneinig sind. Das kuratierte Album wählt nicht stillschweigend einen Gewinner aus. Es enthält beide Anmerkungen mit ihrer Provenienz, und die Meinungsverschiedenheit selbst wird zum Signal dafür, dass die Sequenz eher einer orthogonalen analytischen und biologischen Prüfung als einem Datenbankurteil bedarf.
Wo die Beweise ausgehen
Die Endpunktabdeckung ist ungleichmäßig, und die Lücke ist eher struktureller als zufälliger Natur. MAOMAO gibt an, dass die Abdeckung von abrufbaren Beweisen auf Sequenzebene abhängt, was zu einem Klassenungleichgewicht und einer eingeschränkten Darstellung der Zytolyse führt, Embryotoxische und ichthyotoxische Endpunkte (das MAOMAO-Freigabepapier, 2026). Die Zählungen machen die Dünnheit konkret: Embryotoxische Träger 2 positive Zustände und ichthyotoxisch 5, während die Zytolyse gilt 343 Staaten insgesamt. Vergleichen Sie das mit Toxic Root bei 57,080 Staaten und 13,824 Positives, oder hämolytisch bei 35,960 Staaten und 4,714 Positives.
Für eine Triage-Regel, Dies bedeutet, dass das Fehlen einer Anmerkung in einem Thin-Endpunkt kein Beweis für das Fehlen ist. Das bedeutet, dass der Endpunkt selten aufgezeichnet wurde. Eine nach embryotoxischen oder ichthyotoxischen Daten gefilterte Auswahlliste wird nach fast nichts gefiltert, und der ehrliche Schachzug besteht darin, dies zu sagen, bevor der Kandidat eine Programmentscheidung trifft.
Die Lizenzierung ist die zweite Grenze. Anmerkungsinhalte und letzte Aktualisierungsdaten sind verfügbar für 55 von 56 Quellen, aber die explizite Lizenzierung deckt nur ab 15 von 56 (MAOMAOs eigene Dokumentation seiner Beweise besagt, abgerufen 2026-07-30). Die Wiederverwendung von Begriffen für den Rest muss an der Quelle überprüft werden, nicht aus dem Aggregat übernommen.
Schlüssel zum Mitnehmen: Ein Negativ ist nicht eine Sache. Triage nach Beweislage und Herkunft, Geschäft nicht auf Etikettenpräsenz, und behandeln Sie dünne Endpunkte als ungemessen und nicht als sauber.
Evidenzzustände und Herkunftsfelder für Peptidtoxizität, Feld für Feld
Eine Peptidtoxizitätsaufzeichnung ist überprüfbar, wenn zwei Dinge eindeutig sind: wie die Beweislage ist, und woher die Aufzeichnung stammt. MAOMAO strukturiert beides. Die Ontologie hat eine Wurzelklasse, Giftig, mit Primärklassen Zytotoxisch, Neurotoxisch, Embryotoxisch, und ichthyotoxisch, und Zytotoxisch trägt die Unterklassen Hämolytisch, Zytolyse, und Anti-Säugetierzellen (MAOMAO-Trennpapier, 2026). Lesen Sie die Filialsummen sorgfältig durch: Die Wurzel „Toxic“ überschneidet sich mit der Anzahl der Unterklassen, Wenn man also die Zweige summiert, wird die Wurzel überbewertet, eine Einschränkung, die im methodischen Hinweis des Papiers direkt dargelegt wird.
Die Identität wird durch Hashing der normalisierten Großbuchstabensequenz mit SHA-256 gehandhabt, Dadurch erhält dieselbe Sequenz über Ebenen und Quellen hinweg denselben Schlüssel. Datensätze werden als CSV versendet, JSON, oder YAML.
Das Evidence-State-Vokabular in der Praxis
Jeder Staat beantwortet eine andere Frage für ein Programm. Positiv: Gibt es direkte oder hierarchisch unterstützte Toxizitätsnachweise?? Negativ: gibt es direkt, endpunktspezifische ungiftige Beweise? Mehrdeutig: Sind Anmerkungen widersprüchlich oder ungelöst?? Unbeschriftet: Wurde die Sequenz ohne explizite Klassenzuweisung beibehalten?? Keine Informationen: Gibt es einfach keine Beweise für diesen Endpunkt?? (MAOMAO-Trennpapier, 2026). Behandeln Sie diese als Dokumentation dessen, was die Quelle gesagt hat, nicht als Sicherheitsbestimmung.
Provenienzfelder, die einen Datensatz überprüfbar machen
Mithilfe der harmonisierten Felder von MAOMAO kann ein Prüfer einen Anspruch überprüfen, ohne die Originalquelle öffnen zu müssen. Quellenangabe und Literaturhinweis genügen der auffindbaren und nachvollziehbaren Zuordnung. Organismus und Annotationsherkunft erfüllen den wiederverwendbaren Kontext. Das Abrufdatum und die Version entsprechen der verfügbaren Währung. Das Dateiformat unterstützt den interoperablen Austausch. Um
Die Lizenzierung ist die ehrliche Lücke. Das Papier gibt im Haupttext keine einheitliche Datensatzlizenz an, meldet die Lizenzabdeckung auf Quellenebene von 15 von 56 Quellen, und platziert Lizenzinformationen und Versionierungsdatensätze in der Dokumentationsschicht (MAOMAO-Trennpapier, 2026). Überprüfen Sie Begriffe auf Quellebene, bevor Sie sie in einem regulierten Arbeitsablauf wiederverwenden.
Wie sich FAIR-Peptidtoxizitätsdaten in das Assay-Design und die Berichterstattung einfügen
Kuratierte Metadaten zur Peptidtoxizität sagen Ihnen, welche orthogonale Bestätigung als Nächstes ausgeführt werden muss; Es bedeutet nicht, dass ein Kandidat sicher ist. Diese Grenze ist der eigentliche Sinn der Ebene. Ein Datenbankeintrag fasst zusammen, was jemand anderes unter bestimmten Bedingungen beobachtet hat, während die nachgewiesene Sicherheit auf orthogonalen analytischen und biologischen Tests beruht, die an Ihrem Material durchgeführt werden: HPLC-Reinheit, MS-Identität, Gegenionzustand, Endotoxin durch LAL, Sterilität, und die biologischen Tests, die Ihr Programm erfordert. Jeder Test beantwortet eine eng gefasste Frage. LAL misst nur die Endotoxinbelastung, nicht Sterilität oder chemische Reinheit, und die Gegenionenmasse ist nicht trivial, da das TFA-Salz ungefähr darstellen kann 5% Zu 25% von Feststoffmasse und restlichem TFA können die Ergebnisse von Membran- und Rezeptortests beeinträchtigen (Literatur zu Gegenion- und Orthogonaltests, 2020-12-03).
Für Trinkgeld: Ordnen Sie jede verbleibende Unsicherheit dem spezifischen orthogonalen Test zu, der sie löst, bevor Sie Zeit für die Analyse aufwenden.
Von einer Triage-Shortlist bis hin zu einem Assay-Plan
Arbeiten Sie anhand der Auswahlliste, die Ihr Evidence-State-Filter erstellt hat, Wandeln Sie dann jede offene Frage in einen Test und eine Entscheidungsregel um.
-
Identität und Reinheit. Wenn der Datensatz eine abgeleitete Anmerkung ohne Assay-Kontext enthält, Bestätigen Sie die molekulare Identität durch MS und die chromatographische Reinheit durch HPLC nach einer definierten Methode. Lösen Sie den Kandidaten auf, wenn die Identität übereinstimmt und die Reinheit Ihren Spezifikationen entspricht.
-
Gegenstaat. Wo in der Aufzeichnung eine Salzform ohne Quantifizierung vermerkt ist, messen Sie es. Ein Gegenion-Ergebnis, das die effektive Dosis verschiebt oder einen Rezeptor-Assay stört, verändert die Interpretation aller nachgelagerten Prozesse.
-
Endotoxin. Legen Sie den Grenzwert anhand des Endotoxin-Grenzwerts im Kompendium fest, K/M, mit K = 5 USP-EU/kg für andere Wege als intrathekal und K = 0.2 USP-EU/kg für intrathekal, Dabei ist M die maximal empfohlene menschliche Dosis pro kg in einer einzigen Stunde (USP <85> Test auf bakterielle Endotoxine).
-
Sterilität. Nachweis der Abwesenheit lebensfähiger Mikroorganismen unter Testbedingungen, welche unter USP <71> bedeutet Inokulation in spezifizierte Medien und 14-tägige Inkubation (ICH Q2(R2), 2023-11-30).
-
Biologische Bestätigung. Erst nachdem sich die analytische Schicht gesetzt hat, sollten Sie ein Toxizitätssignal als Eigenschaft des Kandidaten und nicht als Eigenschaft der Probe ablesen.
Dokumentation, die der Durchsicht standhält
Jedes oben genannte Ergebnis muss später vertretbar sein, Und die Metadatenebene ist der Ausgangspunkt. Die MHRA 2018 Die GxP-Richtlinie zur Datenintegrität definiert ALCOA als zurechenbar, lesbar, gleichzeitig, Original, und genau, mit ALCOA+ Addition komplett, konsistent, ausdauernd, und verfügbar (MHRA, Leitfaden zur GxP-Datenintegrität, 2018-03-09). Herkunftsfelder werden diesen Attributen direkt zugeordnet: Eine Quellenkennung und ein Kurationsdatum machen eine Aufzeichnung zuordenbar und zeitnah, Ein Assay-Kontextfeld sorgt für die Vollständigkeit, und eine stabile Aufzeichnungsverbindung sorgt dafür, dass es verfügbar bleibt. Validierungserwartungen laufen parallel, since ICH Q2(R2)Der Fit-for-Purpose-Standard erfordert die Dokumentation, dass ein Verfahren für seinen beabsichtigten Zweck geeignet ist, nicht nur, dass es lief (ICH Q2(R2), 2026-02-20).
Eine FAIR-Metadatenschicht unterstützt diesen Workflow in bescheidenem Maße, reproduzierbare Weise. Es kann verwendet werden, um Evidenzstatus und Herkunftsfelder aus Triage-Tools in CoA-Datensätze zu übertragen, ohne dass eine erneute Eingabe erforderlich ist, und es hilft, die Analyseergebnisse beizubehalten, die verwendete Methode, und der Datensatz, mit dem sie abgeglichen wurden, in einer nachverfolgbaren Kette. MOL Changes basiert auf dieser Dokumentations- und Analyse-Verifizierungsebene, einschließlich HPLC/MS und Sterilitätstests und Klasse 100 sterile Herstellung. Die praktische Konsequenz ist, dass die Datenbank niemals für Ihre Tests einspringt; Es entscheidet darüber, welche Tests Sie schulden, und es liefert den Prüfpfad, der zeigt, dass Sie es ausgeführt haben.
Benchmarking- und Vorhersagemodelle basierend auf Metadaten zur Peptidtoxizität
Die Benchmark-Ebene von MAOMAO dient dazu, die Modellleistung auf einer gemeinsamen Basis und nicht auf der privaten Aufteilung jedes Papiers zu vergleichen. Es definiert 300 Endpoint-Seed-Strategy-Konfigurationen, 1,500 Datenpartitionen, 3,300 Darstellungsspezifische Konfigurationen und 16,500 Fold-Instanzen, abgeleitet von 5 geeignete Endpunkte Synthetische Peptide × 30 zufällige Samen × 5-fache Aufteilung × 11 Darstellungen (MAOMAO, Grenzen in der Pharmakologie, 2026). Die Darstellungsseite ist ebenso explizit: 10 Protein-Sprachmodell-Einbettungsmatrizen sowie eine One-Hot-Darstellung, die alles abdeckt 71,857 Sequenzen, neben einer Deskriptorschicht von 41 Merkmale (MAOMAO, 2026).
Die Begrenzung ist ebenso wichtig wie der Umfang. Diese vordefinierten Partitionen verwenden eine zufällige und geschichtete Aufteilung und sind keine Homologie- oder ähnlichkeitskontrolliert, sie sind also nicht leckagekontrolliert. Eine hohe Punktzahl bei diesem Benchmark zeigt an, dass ein Modell die kuratierten Peptidtoxizitätsmetadaten, anhand derer es trainiert wurde, trennt. Es sagt Ihnen noch nicht, dass das Modell auf ein Gerüst übertragen wird, das es noch nie gesehen hat.
Vorhersagemodellaussagen mit den richtigen Vorbehalten lesen
Veröffentlichte Peptidtoxizitätsprädiktoren berichten über starke Zahlen, und jede Zahl hat ihren eigenen Geltungsbereich. ToxiPep trainiert weiter 3,528 giftig und 3,528 ungiftige Peptide, gefiltert bei CD-HIT 0.9, Getestet auf 883 Plus 883, und gemeldete Genauigkeit 0.850, Empfindlichkeit 0.827, Spezifität 0.873, MCC 0.701 Und ToxiPep hat berichtet 0.92 AUC (2025). ToxGINs unabhängiger Test AUROC von 0.9172 kam mit einem F1 von 0.8354 und ein MCC von 0.6866 (Briefings in Bioinformatik, 2024). PeptiVerse zusammengebaut 5,518 giftig und 5,518 ungiftige Peptide, Aber PeptiVerse erbt seine Toxizitätskennzeichnungen von ToxinPred3.0 statt aus dem Assay (2026).
Es folgen zwei Vorbehalte. Erste, Dabei handelt es sich größtenteils um Ergebnisse eigener Methoden, von den Teams bewertet, die die Modelle gebaut haben. Zweite, Der Anwendungsbereich ist durch die Konstruktion begrenzt: Der CD-HIT von ToxiPep 0.9 Filterung bedeutet, dass seine Ansprüche für Sequenzen gelten, die seinen Trainingsdaten ähneln, nicht für willkürliche neuartige Chemie. PeptiVerse verstärkt dies, weil eine von einem Prädiktor geerbte Bezeichnung den Fehler dieses Prädiktors weiterträgt.
Was würde ein durch Lecks kontrollierter Benchmark ändern?
Wenn Sie sich entscheiden, ob Sie einem Model auf einem neuartigen Gerüst vertrauen sollen, die Spaltung ist der Anspruch. Homologie- oder ähnlichkeitskontrollierte Partitionierung hält nahezu doppelte Sequenzen vom Training fern, Ein Testergebnis spiegelt also eher die Extrapolation als das Auswendiglernen naher Verwandter wider. Zufällige und geschichtete Aufteilungen können die beiden nicht unterscheiden, weshalb a 0.92 AUC bei einer zufälligen Aufteilung und a 0.92 AUC bei einer homologiekontrollierten Aufteilung bedeutet für Ihr Programm unterschiedliche Bedeutungen.
Die praktische Lektüre: Bewerten Sie veröffentlichte Metadatenwerte zur Peptidtoxizität als Beweis für interne Diskriminierung, nicht als Transfergarantie. Bevor ein Modell eine Synthese- oder Testentscheidung beeinflusst, Überprüfen Sie, ob die Auswertung die Sequenzähnlichkeit kontrolliert, und bestätigen Sie den Endpunkt und den Assay-Kontext hinter seinen Beschriftungen. Wo diese Kontrolle fehlt, Der Score ist eine Ausgangshypothese für orthogonale analytische und biologische Tests, kein Ersatz dafür.
Häufige Missverständnisse über Peptidtoxizitätsdatenbanken
Der häufigste Fehler besteht darin, eine Datenbankbezeichnung als Sicherheitsbestimmung zu behandeln. Ein Etikett dokumentiert, was beobachtet wurde, in welchem system, unter welchen Bedingungen; Es bescheinigt nicht, dass eine Sequenz sicher fortgeführt werden kann.
Das erste Missverständnis ist, dass ein negatives Etikett ungiftig bedeutet. Negative sind keine Sache. Ein starkes Negativergebnis beruht auf einem dokumentierten Test mit einem angegebenen Endpunkt und Konzentrationsbereich; Ein schwaches Negativ kann eine ungetestete Sequenz widerspiegeln, ein nicht gemeldetes Ergebnis, oder ein Test, der den Effekt nicht erkennen konnte. Eine Triage-Regel, die die beiden zu einem einzigen „sauberen“ Flag zusammenfasst, ist der Fehlermodus.
Zweitens bedeuten mehr Quellen mehr Vertrauen. Quellenzahl und Beweisunabhängigkeit sind unterschiedliche Größen. Ein großes Aggregat kann immer noch auf einen vorgelagerten Mitwirkenden zurückgeführt werden, Daher ist die scheinbare Breite der Unterstützung geringer, als die Zahl vermuten lässt.
Die dritte besteht darin, dass eine Modellbewertung auf eine Romansequenz übertragen wird. Vorhersagemodelle verfügen über einen Anwendbarkeitsbereich, und eine außerhalb davon berechnete Punktzahl ist eine Extrapolation, not a measurement.
Der vierte Punkt besteht darin, dass durch harmonisierte Daten keine orthogonalen Tests mehr erforderlich sind. Durch die Harmonisierung werden Aufzeichnungen vergleichbar; es macht sie nicht ausreichend. Entscheidungen zur Peptidsicherheit erfordern immer noch qualifiziertes professionelles Urteilsvermögen und orthogonale analytische und biologische Tests.
Warnung: Ein negatives Etikett ist keine Sache. Starke und schwache Negative haben unterschiedliche Beweiskraft, und eine Triage-Regel, die sie als eine Sache behandelt, ist der Fehlermodus.
Ein Grund dafür, dass die negative Seite strukturell dünner ist, ist der Publikationsbias der Toxikologie, gemessen als 3,3-facher Publikationsvorteil für positive Befunde, wobei die Prävalenz positiver Ergebnisse von ungefähr ansteigt 50% Zu 90% zwischen 1991 Und 2007 (Bero et al., Überprüfung des Risikos einer Verzerrung, 2016, deckt den Zeitraum 1991–2007 ab). Ein aus der Literatur abgeleiteter Datensatz erbt diese Asymmetrie.
Warum die Fluktuation in der nichtklinischen Toxikologie dies zu einer Entscheidung macht, keine Kuriosität
Es steht auf dem Spiel, warum die Triage von Peptidkandidaten dieses Maß an Sorgfalt und nicht eine schnelle Datenbanksuche verdient. Im Vier-Firmen-Abwanderungsaudit, nichtklinische Toxikologie berücksichtigt 40% von Kündigungen, die größte Einzelursache, quer ungefähr 605 terminierte Verbindungen von AstraZeneca, Eli Lilly, GSK und Pfizer dazwischen 2000 Und 2010 (Waring et al., Nature Reviews Arzneimittelforschung, 2015).
Eine pharmakologische Überprüfung erreicht die gleiche Größenordnung, Schätzungen zufolge macht die Toxizität etwa ein Drittel der Fluktuationen von Arzneimittelkandidaten aus und es werden Fehlerraten bei der Sicherheit klinischer Entwicklungen gemeldet 35% ab Phase 1 zur Unterwerfung und 28% ab Phase 2 zur Unterwerfung (Karnes et al., 2010). Die beiden Quellen kommen durch unterschiedliche Stichproben und Methoden zu derselben Schlussfolgerung, Dadurch wird das Signal verstärkt, ohne dass sie zu völlig unabhängigen Schätzungen werden.
Erste Schritte mit FAIR-Daten zur Peptidtoxizität
Die erste Aktion besteht darin, eine Kandidatensequenz abzurufen und deren Datensatz Ende für Ende zu lesen, bevor Sie etwas ausführen. Dieser einzelne Durchgang sagt Ihnen, was der Datensatz bereits unterstützt und was nicht.
Schritt 1: Lösen Sie die Sequenz auf und lesen Sie den Datensatz. Lösen Sie die Sequenz in ihren deterministischen Bezeichner auf, Lesen Sie dann die dazugehörigen Felder „Beweisstatus“ und „Provenienz“.. Die harmonisierten Felder von MAOMAO sind genau für diesen Pass konzipiert: Eine SHA-256-Kennung verknüpft den Eintrag mit einer Sequenz, und die Herkunftsfelder geben an, woher die zugrunde liegende Messung stammt. Wenn ein Feld leer ist, Behandeln Sie das als Information, nicht als eine Lücke, die durch Annahmen geschlossen werden kann.
Schritt 2: Klassifizieren Sie jede Unsicherheit und weisen Sie einen Test zu. Sortieren Sie Ihre Ergebnisse in analytische Unsicherheit und biologische Unsicherheit, Benennen Sie dann den orthogonalen Test, der jeden Test löst. Orthogonale analytische und biologische Tests bedeuten, dass die zweite Methode nicht den Fehlermodus der ersten Methode aufweist, Daher hat die Übereinstimmung zwischen ihnen Gewicht, was bei einem Wiederholungslauf nicht der Fall ist.
Schritt 3: Notieren Sie das Ergebnis, damit es wiederverwendbar bleibt. Schreiben Sie das Ergebnis gegen die ALCOA+-Attribute, die in der ALCOA-Definition der MHRA festgelegt sind: zurechenbar, lesbar, gleichzeitig, Original, genau, plus komplett, konsistent, langlebig und verfügbar. Ein auf diese Weise aufgezeichnetes Ergebnis kann im nächsten Programm wiederverwendet werden, anstatt erneut abgeleitet zu werden.
Die Metadatenschicht ist ein Ausgangspunkt, kein Ersatz für Tests. Hier erfahren Sie, welches Experiment als nächstes ausgeführt werden soll; Nur das Experiment sagt Ihnen, was das Peptid bewirkt.
Häufig gestellte Fragen
Wofür steht MAOMAO?, und was integriert es?
MAOMAO ist eine kuratierte Ressource zur Peptidtoxizität, die Sequenzaufzeichnungen liefert, Assay-Kontext und Herkunftsmetadaten in einer FAIR-ausgerichteten Ebene, Daher wird ein Toxizitätsetikett mit den Bedingungen geliefert, unter denen es entstanden ist, und nicht als bloße Flagge. Der Integrationspunkt ist wichtiger als das Akronym: Sequenz, Endpunkt, Testsystem und Kurationsdatum reisen zusammen.
Bedeutet eine negative Toxizitätskennzeichnung, dass ein Peptid sicher ist??
NEIN. Eine negative Kennzeichnung bedeutet, dass der kuratierte Datensatz kein Toxizitätssignal für die getesteten Bedingungen enthält, Das ist eine Aussage über die Beweise, nicht um das Molekül. Das Fehlen eines aufgezeichneten Effekts in einem Testsystem stellt keinen Beweis für die Sicherheit dar, Und jede Entwicklungsentscheidung erfordert immer noch eine qualifizierte toxikologische Beurteilung sowie orthogonale analytische und biologische Tests.
Wie schneidet MAOMAO im Vergleich zu DBAASP v3 ab??
DBAASP v3, das Gegenstück zur experimentellen Aufzeichnung, deckt mehr als ab 15,700 Peptideinträge, einschließlich über 14,500 Monomere Peptide und ungefähr 400 Homo- und Heteromultimere, mit Aktivitäts- und Toxizitätsmessungen gegen 8 Zielspezies oder Zelltypgruppen (DBAASP v3, November veröffentlicht 2020). Die beiden Ressourcen beantworten unterschiedliche Fragen: DBAASP v3 aggregiert gemessene Datensätze, während eine FAIR-Schicht die Evidenzstatus- und Herkunftsfelder hinzufügt, die jeden Datensatz überprüfbar machen.
Können Vorhersagemodelle wie ToxiPep oder ToxGIN Assay-Tests ersetzen??
Nicht als Ersatz für eine experimentelle Bestätigung. ToxiPep hat berichtet 0.92 AUC beschreibt Diskriminierung in seinem Bewertungssatz, Dabei handelt es sich um eine Leistungsaussage über ein Modell, keine Sicherheitsfeststellung über eine Sequenz. Die Vorhersageausgabe wird am besten zur Einstufung und Priorisierung von Kandidaten vor orthogonalen analytischen und biologischen Tests verwendet, um eine Toxizitätsfrage nicht abzuschließen.
Welche orthogonalen Tests sind für eine Triage-Shortlist noch erforderlich??
Eine aus kuratierten Peptidtoxizitätsmetadaten erstellte Auswahlliste bedarf noch bestätigender analytischer Arbeit, typischerweise Identitäts- und Reinheitsbewertung durch HPLC und Massenspektrometrie zusammen mit den relevanten biologischen oder zellbasierten Tests für den beabsichtigten Endpunkt. Die Datenbank schränkt ein, was Sie zuerst testen; Der Test wird dadurch nicht entfernt.
Wie unterstützen FAIR-Metadaten die IND-fähige Dokumentation??
FAIR-Metadaten unterstützen die IND-fähige Dokumentation, da jeder Datensatz bis zu seiner Quelle zurückverfolgt werden kann, Methode und Kurationsdatum, Dabei handelt es sich um die gleiche Eigenschaft, die die ALCOA-Definition der MHRA für zurechenbar verlangt, lesbar, gleichzeitig, Originale und genaue Aufzeichnungen. Aufsichtsbehörden überprüfen die Beweiskette, Daher reduziert eine gut dokumentierte Metadatenschicht zur Peptidtoxizität den späteren Rekonstruktionsaufwand.
Abschluss
Kuratierte FAIR-Peptidtoxizitätsdaten verbessern die Kandidatentriage, Assay-Design und Berichterstattung, und es ist kein Beweis für Sicherheit. Diese Unterscheidung ist das ganze Argument: Eine Aufzeichnung mit Herkunftsstempel gibt Aufschluss darüber, was gemessen wurde, in welchem system, unter welchen Bedingungen, und wo die Beweise aufhören. Es bedeutet nicht, dass ein Peptid sicher ist, Und kein Datenbanketikett kann dieses Gewicht alleine tragen.
Der mehrschichtige Fall verläuft vom Datenmodell nach außen. Nachweisstatus und Herkunftsfelder machen einen Datensatz überprüfbar; Überprüfbare Aufzeichnungen machen die Triage vertretbar; Eine vertretbare Triage führt zu einem Testplan, der die Überprüfung übersteht. Jeder Schritt hängt vom vorherigen ab, Aus diesem Grund gerät die teilweise Übernahme tendenziell beim ersten mehrdeutigen Datensatz ins Stocken.
Die Ressource und das sie umgebende Modellökosystem sind immer noch in Bewegung. Es bestehen weiterhin Versorgungslücken, Die Lizenzabdeckung ist unvollständig, und Benchmarks sind noch nicht leckagekontrolliert. Das berichtet das MAOMAO-Freigabepapier 15 von 56 Datensätze enthalten explizite Lizenzinformationen, Überprüfen Sie daher die Begriffe, bevor Sie auf einer Tabelle aufbauen. Behandeln Sie die aktuellen Behauptungen des Vorhersagemodells als richtungsweisend, nicht geklärt.
Wenn Sie über eine Adoption nachdenken, Der nützliche nächste Schritt ist ein ausführliches Gespräch über Ihren eigenen Triage-Workflow. Peptidproduktion
Offenlegung: MOL Changes veröffentlicht Peptiddokumentation und analytische Verifizierung, einschließlich HPLC, MS- und Sterilitätstests unter Klasse 100 sterile Herstellung. Dieser Artikel dient der Aufklärung und empfiehlt oder befürwortet kein bestimmtes Peptid.
Entscheidungen über die Sicherheit von Peptiden erfordern qualifiziertes professionelles Urteilsvermögen und orthogonale analytische und biologische Tests, nicht nur eine Datenbankbezeichnung.