MAOMAO là gì và tại sao dữ liệu về độc tính của FAIR Peptide lại quan trọng?
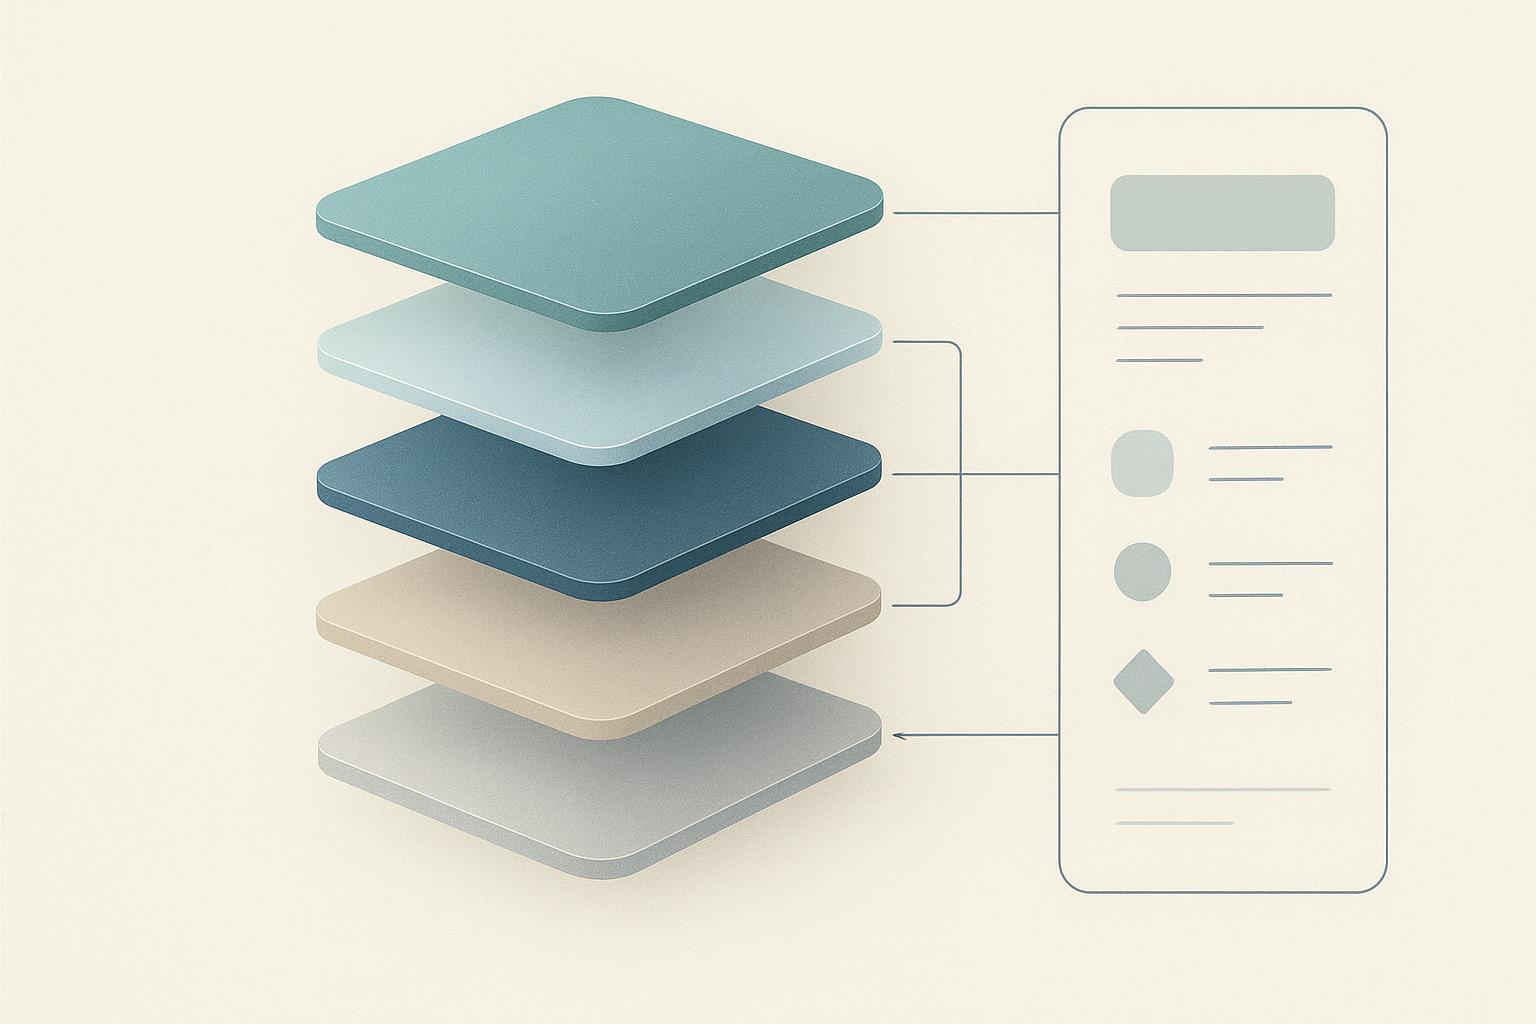
MAOMAO là viết tắt của Bản thể học nhận biết siêu dữ liệu cho tổ chức chú thích đa nguồn, một nguồn tài nguyên hướng dẫn về bản thể học nhằm hài hòa thông tin về độc tính của peptide được lấy từ cơ sở dữ liệu công cộng, tài nguyên có nguồn gốc từ tài liệu và bộ dữ liệu được quản lý (giấy phát hành MAOMAO, 2026). Nó không phải là một cơ sở dữ liệu duy nhất với một cơ sở dữ liệu ngược dòng duy nhất. Bản phát hành đầu tiên của nó tích hợp 56 nguồn, mở rộng cơ sở dữ liệu công cộng, nguồn tài nguyên có nguồn gốc từ văn học, bộ dữ liệu bổ sung và kho lưu trữ được quản lý thủ công (cùng một tờ giấy), và hợp nhất chúng thành 71,857 trình tự peptide duy nhất trên tám điểm cuối liên quan đến độc tính. Lớp lõi giữ 574,856 sự kết hợp điểm cuối peptide hài hòa cho các trình tự đó. Các tìm kiếm được thực hiện trên Google Scholar và PubMed trong khoảng thời gian từ tháng 6 2025 và tháng 9 2026, vì vậy bản phát hành phản ánh các tài nguyên có sẵn cho đến tháng 9 2026. Số liệu thuộc loại này thay đổi tùy theo nguồn và ngày giám tuyển, và một bản ghi ngược dòng duy nhất bên trong bản phát hành chỉ mang trọng số của bản ghi ngược dòng đó.
Dữ liệu về độc tính peptide FAIR có nghĩa là một cái gì đó hẹp hơn “dữ liệu được tổ chức tốt”. Nó có nghĩa là một bản ghi độc tính mang một mã định danh liên tục, siêu dữ liệu xuất xứ phong phú và giấy phép đã nêu, để người đọc có thể theo dõi xác nhận quyền sở hữu đến từ đâu và nó có thể được sử dụng lại trong những điều kiện nào.
Sự tương tự: một bản ghi là một mục ghi chép trong phòng thí nghiệm, không phải là một bản án
Xử lý chú thích về độc tính theo cách bạn xử lý mục ghi chép có đóng dấu xuất xứ. Nó ghi lại những người quan sát thấy hiệu ứng, khi, từ nguồn nào, trên sinh vật nào, và theo bằng chứng nào nêu rõ. Nó không chứng nhận rằng một chuỗi là an toàn. Sự khác biệt đó định hình mọi quyết định tiếp theo trong hướng dẫn này, bởi vì hồ sơ cho bạn biết nội dung đã được yêu cầu và mức độ ghi chép của nó, không phải những gì bạn đã chứng minh về ứng cử viên của chính bạn.
FAIR thực sự yêu cầu gì về hồ sơ độc tính
Từ viết tắt che giấu các yêu cầu hoạt động. các nguyên tắc FAIR ban đầu (Wilkinson và cộng sự., Dữ liệu khoa học, 2016) và Tổng quan về GO FAIR chỉ định rằng dữ liệu mang một mã định danh liên tục (F1), siêu dữ liệu đó sẽ phong phú (F2) và bao gồm mã định danh của dữ liệu họ mô tả (F3), xuất xứ đó phải được chi tiết (R1.2), rằng hồ sơ tuân theo các tiêu chuẩn cộng đồng liên quan đến tên miền (R1.3), và đó là điều rõ ràng, giấy phép sử dụng có thể truy cập được nêu (R1.1).
Các lĩnh vực hài hòa của MAOMAO là việc triển khai cụ thể: mã định danh nguồn, tài liệu tham khảo văn học, thông tin sinh vật, xuất xứ chú thích, ngày thu hồi, định dạng tệp và thông tin phiên bản nếu có, với mỗi chuỗi chuẩn hóa được khóa bằng mã định danh SHA-256 xác định trên chữ hoa, trình tự không có khoảng trắng. Tệp được gửi dưới dạng CSV, JSON và YAML.
Chìa khóa mang đi: Hồ sơ độc tính được quản lý là một tuyên bố có đóng dấu xuất xứ, không phải là một phán quyết an toàn.
Tại sao siêu dữ liệu về độc tính của peptide được quản lý lại thay đổi việc phân loại ứng viên
Siêu dữ liệu về độc tính peptide được quản lý sẽ thay đổi cách phân loại ứng cử viên peptide vì nó cho phép bạn lọc dựa trên độ mạnh của bằng chứng cơ bản thay vì sự hiện diện của nhãn. Cơ sở dữ liệu chỉ lưu trữ “độc hại” hoặc “không độc hại” thu gọn các quan sát rất khác nhau vào một trường. MAOMAO tách họ ra. Bằng chứng của nó nêu rõ sự khác biệt tích cực, tiêu cực, mơ hồ, hồ sơ không có nhãn và không có thông tin, và trạng thái tiêu cực bị chia cắt thêm: những tiêu cực mạnh mẽ đã được hỗ trợ rõ ràng bằng bằng chứng thực nghiệm, trong khi các âm bản yếu có nguồn gốc từ các bộ âm tính được chọn ngẫu nhiên hoặc thiếu xác nhận về việc không có chú thích về độc tính (giấy phát hành MAOMAO, 2026).
Sự phân bổ cho thấy tại sao sự khác biệt đó có trọng lượng. Xuyên suốt bản phát hành, báo cáo MAOMAO 31,153 tích cực, 91,506 tiêu cực, 15,717 mơ hồ và 5,044 trạng thái không được gắn nhãn (Tài liệu riêng của MAOMAO về các bằng chứng của nó nêu rõ, đã lấy lại 2026-07-30). Thùng âm gần gấp ba lần thùng dương, vì vậy, quy tắc phân loại coi mọi tiêu cực là giải pháp rõ ràng sẽ không lọc được bằng chứng. Nó đang lọc theo âm lượng.
|
Trạng thái bằng chứng |
Đếm |
Những gì nó hỗ trợ trong phân loại |
|---|---|---|
|
Tổng hợp peptit Tích cực |
31,153 |
Gắn cờ để theo dõi; kiểm tra bối cảnh điểm cuối và xét nghiệm |
|
Tiêu cực |
91,506 |
Phụ thuộc vào nguồn gốc mạnh và yếu |
|
mơ hồ |
15,717 |
Không thể tự mình giải quyết vấn đề đi/không đi |
|
Chưa được gắn nhãn |
5,044 |
Không có tín hiệu sử dụng được |
Đọc một bản ghi và quyết định xem nó chứng minh điều gì
Lấy một bản ghi mang chú thích được suy luận mà không đính kèm ngữ cảnh xét nghiệm. Trên nhãn ghi tiêu cực. Xuất xứ cho biết cuộc gọi được suy ra chứ không phải được đo lường, và không có điểm cuối, hệ thống nồng độ hoặc xét nghiệm được ghi lại cùng với nó. Tại thời điểm đó, bản ghi không trả lời “trình tự này có an toàn để tiến lên không”. Nó trả lời “có ai công bố quan sát độc tính ở cấp độ trình tự cho trình tự này không,” và câu trả lời là không.
Đó là điểm quyết định. Quy tắc phân loại được xây dựng dựa trên sự hiện diện của nhãn sẽ chuyển ứng viên qua. Một quy tắc được xây dựng trên trạng thái bằng chứng sẽ định tuyến nó đến đường dẫn mơ hồ hoặc không được gắn nhãn, nơi nó cần kiểm tra tài liệu hoặc xét nghiệm trước khi giành được một vị trí trong danh sách rút gọn. Quy tắc thứ hai tốn nhiều chi phí hơn cho mỗi ứng viên và tạo ra danh sách rút gọn mà bạn có thể bảo vệ.
Logic tương tự được áp dụng khi hai nguồn không đồng ý về nhãn điểm cuối cho một chuỗi. Hồ sơ giám tuyển không âm thầm chọn người chiến thắng. Nó chứa cả hai chú thích với nguồn gốc của chúng, and the disagreement itself becomes the signal that the sequence needs orthogonal analytical and biological testing rather than a database verdict.
Nơi bằng chứng hết
Endpoint coverage is uneven, and the gap is structural rather than incidental. MAOMAO states that coverage depends on retrievable sequence-level evidence, which produces class imbalance and limited representation of Cytolysis, Embryotoxic and Ichthyotoxic endpoints (giấy phát hành MAOMAO, 2026). The counts make the thinness concrete: Embryotoxic carries 2 positive states and Ichthyotoxic 5, while Cytolysis holds 343 states in total. Compare that with Toxic root at 57,080 states and 13,824 positives, or Hemolytic at 35,960 states and 4,714 positives.
For a triage rule, this means absence of an annotation in a thin endpoint is not evidence of absence. It means the endpoint was rarely recorded. Một danh sách rút gọn được lọc dựa trên dữ liệu Embryotoxic hoặc Ichthyotoxant hầu như không được lọc gì, và động thái trung thực nhất là nói như vậy trước khi ứng viên đưa ra quyết định về chương trình.
Cấp phép là ranh giới thứ hai. Nội dung chú thích và ngày cập nhật cuối cùng có sẵn cho 55 của 56 nguồn, nhưng việc cấp phép rõ ràng chỉ bao gồm 15 của 56 (Tài liệu riêng của MAOMAO về các bằng chứng của nó nêu rõ, đã lấy lại 2026-07-30). Sử dụng lại các thuật ngữ còn lại cần kiểm tra tại nguồn, không được giả định từ tổng hợp.
Chìa khóa mang đi: Tiêu cực không phải là một chuyện. Phân loại tình trạng bằng chứng và xuất xứ, Cửa hàng không có mặt trên nhãn, và coi các điểm cuối mỏng là không thể đo lường được thay vì sạch sẽ.
Các trạng thái bằng chứng về độc tính của peptide và lĩnh vực xuất xứ, Từng lĩnh vực
Hồ sơ độc tính của peptide có thể được kiểm tra khi có hai điều rõ ràng: trạng thái bằng chứng là gì, và hồ sơ đến từ đâu. Cấu trúc MAOMAO cả. Bản thể luận có một lớp gốc, Độc hại, với các lớp tiểu học gây độc tế bào, Chất độc thần kinh, Độc tố phôi, và độc tố Ichthyotox, và Cytotoxic mang các phân lớp Tan máu, tế bào học, và chống tế bào động vật có vú (Giấy phát hành MAOMAO, 2026). Đọc tổng chi nhánh một cách cẩn thận: số lượng lớp con chồng chéo gốc Độc tố, vì vậy việc tính tổng các nhánh sẽ phóng đại phần gốc, một hạn chế mà ghi chú phương pháp luận của bài báo nêu trực tiếp.
Danh tính được xử lý bằng cách băm chuỗi chữ hoa đã chuẩn hóa bằng SHA-256, cung cấp cùng một chuỗi cùng một khóa trên các lớp và nguồn. Bản ghi được gửi dưới dạng CSV, JSON, hoặc YAML.
Từ vựng trạng thái bằng chứng trong thực tế
Mỗi tiểu bang trả lời một câu hỏi khác nhau cho một chương trình. Tích cực: có bằng chứng độc tính trực tiếp hoặc được hỗ trợ theo thứ bậc không? Tiêu cực: có trực tiếp không, bằng chứng không độc hại cụ thể cho điểm cuối? mơ hồ: các chú thích xung đột hoặc chưa được giải quyết? Chưa được gắn nhãn: trình tự được giữ lại mà không có sự phân công lớp rõ ràng? Không có thông tin: đơn giản là không có bằng chứng nào cho điểm cuối này? (Giấy phát hành MAOMAO, 2026). Hãy coi đây là tài liệu về những gì nguồn đã nói, không phải là một quyết định an toàn.
Các trường xuất xứ giúp bản ghi có thể kiểm tra được
Các trường hài hòa của MAOMAO cho phép người đánh giá kiểm tra xác nhận quyền sở hữu mà không cần mở nguồn gốc. Mã định danh nguồn và tài liệu tham khảo đáp ứng thuộc tính có thể tìm thấy và có thể theo dõi. Sinh vật và xuất xứ chú thích thỏa mãn Bối cảnh có thể tái sử dụng. Ngày truy xuất và phiên bản đáp ứng loại tiền tệ có thể truy cập. Định dạng tệp hỗ trợ trao đổi tương tác. Về
Cấp phép là khoảng cách trung thực. Bài viết nêu rõ không có giấy phép tập dữ liệu thống nhất trong văn bản chính của nó, báo cáo phạm vi cấp phép cấp nguồn của 15 của 56 nguồn, và đặt thông tin cấp phép và bản ghi phiên bản trong Lớp Tài liệu (Giấy phát hành MAOMAO, 2026). Kiểm tra các thuật ngữ cấp nguồn trước khi sử dụng lại trong quy trình làm việc được quy định.
Dữ liệu về độc tính của FAIR Peptide gắn vào thiết kế và báo cáo xét nghiệm như thế nào
Siêu dữ liệu về độc tính peptide được quản lý cho bạn biết xác nhận trực giao nào sẽ chạy tiếp theo; nó không cho bạn biết ứng viên đó an toàn. Ranh giới đó là toàn bộ điểm của lớp. Bản ghi cơ sở dữ liệu tóm tắt những gì người khác quan sát được trong các điều kiện đã nêu, trong khi sự an toàn đã được chứng minh dựa trên thử nghiệm phân tích và sinh học trực giao được thực hiện trên vật liệu của bạn: độ tinh khiết HPLC, Nhận dạng MS, trạng thái phản kháng, nội độc tố của LAL, sự vô sinh, và các thử nghiệm sinh học mà chương trình của bạn yêu cầu. Mỗi bài kiểm tra trả lời một câu hỏi hẹp. LAL chỉ đo gánh nặng nội độc tố, không vô trùng hoặc độ tinh khiết hóa học, và khối lượng phản lực không phải là nhỏ, vì muối TFA có thể đại diện cho khoảng 5% ĐẾN 25% khối lượng rắn và TFA dư có thể làm nhiễu loạn kết quả xét nghiệm màng và thụ thể (tài liệu kiểm tra trực giao và phản biện, 2020-12-03).
Để biết tiền boa: Ánh xạ từng độ không đảm bảo còn lại vào thử nghiệm trực giao cụ thể để giải quyết nó trước khi bạn cam kết thời gian thử nghiệm.
Từ danh sách rút gọn phân loại đến kế hoạch xét nghiệm
Làm việc từ danh sách rút gọn mà bộ lọc trạng thái bằng chứng của bạn tạo ra, sau đó chuyển từng câu hỏi mở thành một bài kiểm tra và một quy tắc quyết định.
-
Bản sắc và sự tinh khiết. Nếu bản ghi mang chú thích được suy luận không có ngữ cảnh xét nghiệm, xác nhận danh tính phân tử bằng MS và độ sạch sắc ký bằng HPLC theo phương pháp xác định. Giải quyết ứng viên nếu danh tính phù hợp và độ tinh khiết đáp ứng đặc điểm kỹ thuật của bạn.
-
Trạng thái phản kháng. Trường hợp hồ sơ ghi một dạng muối mà không định lượng, đo nó. Một kết quả đối kháng làm thay đổi liều hiệu dụng hoặc gây nhiễu loạn xét nghiệm thụ thể sẽ làm thay đổi cách giải thích mọi thứ ở phía dưới.
-
nội độc tố. Đặt giới hạn từ giới hạn nội độc tố bổ sung, K/M, với K = 5 USP-EU/kg đối với các tuyến không phải trong vỏ não và K = 0.2 USP-EU/kg cho nội tủy mạc, trong đó M là liều tối đa được khuyến nghị cho người tính trên kg trong một giờ (USP <85> Xét nghiệm nội độc tố vi khuẩn).
-
vô trùng. Chứng minh sự vắng mặt của vi sinh vật sống trong điều kiện thử nghiệm, theo USP <71> có nghĩa là cấy vào môi trường cụ thể và ủ 14 ngày (Tôi quý 2(R2), 2023-11-30).
-
Xác nhận sinh học. Chỉ sau khi lớp phân tích đã ổn định, bạn mới nên đọc tín hiệu độc tính như một đặc tính của mẫu thử chứ không phải của mẫu..
Tài liệu còn tồn tại sau khi xem xét
Mọi kết quả trên đều phải được bảo vệ sau này, và lớp siêu dữ liệu là nơi bắt đầu. của MHRA 2018 Hướng dẫn về tính toàn vẹn dữ liệu GxP xác định ALCOA là có thể quy cho, dễ đọc, đương thời, nguyên bản, và chính xác, với việc bổ sung ALCOA+ đã hoàn tất, nhất quán, bền bỉ, và có sẵn (MHRA, Hướng dẫn về tính toàn vẹn dữ liệu GxP, 2018-03-09). Các trường xuất xứ ánh xạ trực tiếp vào các thuộc tính đó: mã định danh nguồn và ngày quản lý tạo nên một bản ghi có thể quy kết và đương thời, trường bối cảnh xét nghiệm giúp nó hoàn thiện, và một liên kết bản ghi ổn định giữ cho nó có sẵn. Kỳ vọng xác thực chạy song song, kể từ quý 2(R2)Tiêu chuẩn phù hợp với mục đích của nó yêu cầu ghi lại rằng một quy trình phù hợp với mục đích sử dụng của nó, không chỉ đơn thuần là nó chạy (Tôi quý 2(R2), 2026-02-20).
Lớp siêu dữ liệu FAIR hỗ trợ quy trình công việc này ở mức độ khiêm tốn, cách có thể nhân rộng. Nó có thể được sử dụng để chuyển các trạng thái bằng chứng và trường xuất xứ từ công cụ phân loại vào các bản ghi cấp CoA mà không cần gõ lại, và nó giúp lưu giữ các kết quả phân tích, phương pháp được sử dụng, và bản ghi mà chúng được đối chiếu trong một chuỗi có thể theo dõi. Các thay đổi MOL được xây dựng xung quanh lớp tài liệu và xác minh phân tích đó, bao gồm HPLC/MS và thử nghiệm độ vô trùng và Phân loại 100 sản xuất vô trùng. Hậu quả thực tế là cơ sở dữ liệu không bao giờ phù hợp cho việc thử nghiệm của bạn; nó quyết định bạn nợ bài kiểm tra nào, và nó cung cấp dấu vết kiểm tra cho thấy bạn đã chạy nó.
Các mô hình đo điểm chuẩn và dự đoán được xây dựng trên siêu dữ liệu về độc tính của peptide
Lớp điểm chuẩn của MAOMAO tồn tại để có thể so sánh hiệu suất của mô hình trên nền tảng chung thay vì trên phần tách riêng của mỗi tờ giấy. Nó định nghĩa 300 cấu hình chiến lược điểm cuối-hạt giống, 1,500 phân vùng dữ liệu, 3,300 cấu hình đại diện cụ thể và 16,500 trường hợp gấp, bắt nguồn từ 5 điểm cuối đủ điều kiện Peptide tổng hợp × 30 hạt ngẫu nhiên × chia 5 lần × 11 sự đại diện (MAOMAO, Biên giới trong dược lý, 2026). Mặt đại diện cũng rõ ràng như nhau: 10 ma trận nhúng mô hình ngôn ngữ protein cộng với một biểu diễn nóng bao gồm tất cả 71,857 trình tự, bên cạnh một lớp mô tả của 41 đặc trưng (MAOMAO, 2026).
Giới hạn cũng quan trọng như quy mô. Các phân vùng được xác định trước đó sử dụng phân chia ngẫu nhiên và phân tầng và không tương đồng- hoặc kiểm soát sự tương tự, vì vậy chúng không được kiểm soát rò rỉ. Điểm cao trong tiêu chuẩn này cho bạn biết một mô hình phân tách siêu dữ liệu độc tính peptide được quản lý mà nó đã được đào tạo dựa trên đó. Nó vẫn chưa cho bạn biết mô hình được chuyển đến giàn giáo mà nó chưa từng thấy.
Đọc các xác nhận quyền sở hữu mô hình dự đoán với những cảnh báo phù hợp
Các dự đoán độc tính peptide được công bố báo cáo số lượng lớn, và mỗi số mang phạm vi riêng của nó. ToxiPep được đào tạo về 3,528 độc hại và 3,528 peptide không độc hại được lọc tại CD-HIT 0.9, đã thử nghiệm trên 883 cộng thêm 883, và báo cáo độ chính xác 0.850, sự nhạy cảm 0.827, tính đặc hiệu 0.873, MCC 0.701 Và ToxiPep đã báo cáo 0.92 AUC (2025). AUROC thử nghiệm độc lập của ToxGIN của 0.9172 đi kèm với F1 của 0.8354 và MCC của 0.6866 (Tóm tắt về tin sinh học, 2024). PeptiVerse được lắp ráp 5,518 độc hại và 5,518 peptide không độc hại, Nhưng PeptiVerse kế thừa nhãn độc tính từ ToxinPred3.0 chứ không phải từ xét nghiệm (2026).
Hai lưu ý sau. Đầu tiên, đây phần lớn là kết quả của phương pháp riêng của nhà cung cấp, được đánh giá bởi các nhóm xây dựng mô hình. Thứ hai, miền ứng dụng được giới hạn bởi việc xây dựng: CD-HIT của ToxiPep 0.9 lọc có nghĩa là các yêu cầu của nó được giữ nguyên đối với các chuỗi tương tự với dữ liệu huấn luyện của nó, không dành cho hóa học tiểu thuyết tùy tiện. PeptiVerse kết hợp điều này, bởi vì nhãn được kế thừa từ một yếu tố dự đoán sẽ mang lỗi của yếu tố dự đoán đó về phía trước.
Điểm chuẩn kiểm soát rò rỉ sẽ thay đổi như thế nào
Nếu bạn đang quyết định có nên tin tưởng một mô hình trên một giàn giáo mới hay không, sự chia rẽ là yêu cầu bồi thường. Tương đồng- hoặc phân vùng được kiểm soát tương tự giữ các chuỗi gần như trùng lặp trong quá trình huấn luyện, vì vậy điểm kiểm tra phản ánh khả năng ngoại suy hơn là khả năng ghi nhớ của người thân. Sự phân chia ngẫu nhiên và phân tầng không thể phân biệt được hai, đó là lý do tại sao một 0.92 AUC được chia ngẫu nhiên và 0.92 AUC trên phần phân chia được kiểm soát tương đồng có ý nghĩa khác nhau đối với chương trình của bạn.
Bài đọc thực tế: coi điểm số siêu dữ liệu độc tính peptide được công bố là bằng chứng của sự phân biệt đối xử nội bộ, không phải là một sự đảm bảo chuyển nhượng. Trước khi một mô hình đưa ra quyết định tổng hợp hoặc thử nghiệm, kiểm tra xem đánh giá của nó có được kiểm soát về độ tương tự trình tự hay không, và xác nhận bối cảnh điểm cuối và xét nghiệm đằng sau nhãn của nó. Nơi sự kiểm soát đó vắng mặt, điểm số là giả thuyết khởi đầu cho thử nghiệm phân tích và sinh học trực giao, không phải là sự thay thế cho nó.
Những quan niệm sai lầm phổ biến về cơ sở dữ liệu độc tính của peptide
Lỗi phổ biến nhất là coi nhãn cơ sở dữ liệu là xác định an toàn. Một nhãn ghi lại những gì đã được quan sát, trong hệ thống nào, trong điều kiện nào; nó không chứng nhận rằng một trình tự là an toàn để tiến lên.
Quan niệm sai lầm đầu tiên là nhãn tiêu cực có nghĩa là không độc hại. Tiêu cực không phải là một chuyện. Kết quả âm tính mạnh dựa trên xét nghiệm được ghi lại với điểm cuối và phạm vi nồng độ đã nêu; âm bản yếu có thể phản ánh một trình tự chưa được kiểm chứng, một kết quả không được báo cáo, hoặc một xét nghiệm không thể phát hiện được tác động. Một quy tắc phân loại thu gọn cả hai thành một cờ “sạch” duy nhất là chế độ lỗi.
Thứ hai là nhiều nguồn hơn có nghĩa là tự tin hơn. Số lượng nguồn và tính độc lập bằng chứng là số lượng khác nhau. Một tổng hợp lớn vẫn có thể truy ngược lại một người đóng góp ngược dòng, vì vậy phạm vi hỗ trợ rõ ràng là hẹp hơn con số gợi ý.
Thứ ba là điểm mô hình chuyển sang một chuỗi mới. Các mô hình dự đoán mang một miền ứng dụng, và điểm được tính bên ngoài nó là phép ngoại suy, không phải là thước đo.
Thứ tư là dữ liệu hài hòa loại bỏ nhu cầu kiểm tra trực giao. Sự hài hòa làm cho hồ sơ có thể so sánh được; nó không làm cho họ đủ. Các quyết định về an toàn peptide vẫn cần có sự đánh giá chuyên môn có trình độ và thử nghiệm sinh học và phân tích trực giao.
Cảnh báo: nhãn tiêu cực không phải là một chuyện. Tiêu cực mạnh và yếu có trọng lượng bằng chứng khác nhau, và quy tắc phân loại coi chúng như một thứ là chế độ thất bại.
Một phần lý do tại sao mặt tiêu cực lại mỏng hơn về mặt cấu trúc là do sự thiên vị trong công bố của độc chất học., được đo lường như một lợi thế xuất bản gấp 3,3 lần cho những phát hiện tích cực, với tỷ lệ có kết quả dương tính tăng từ khoảng 50% ĐẾN 90% giữa 1991 Và 2007 (Bero và cộng sự., đánh giá rủi ro thiên vị, 2016, bao trùm cửa sổ 1991–2007). Một tập dữ liệu có nguồn gốc từ tài liệu kế thừa sự bất đối xứng đó.
Tại sao sự tiêu hao chất độc phi lâm sàng lại đưa ra quyết định này, không phải là sự tò mò
Vấn đề là tại sao việc phân loại ứng cử viên peptide xứng đáng được quan tâm ở mức độ này thay vì tra cứu cơ sở dữ liệu nhanh chóng. Trong cuộc kiểm toán tiêu hao lao động của bốn công ty, độc tính phi lâm sàng chiếm 40% chấm dứt, nguyên nhân lớn nhất, đại khái 605 hợp chất đã chấm dứt từ AstraZeneca, Eli Lilly, GSK và Pfizer giữa 2000 Và 2010 (Waring và cộng sự., Thiên nhiên Nhận xét Khám phá Thuốc, 2015).
Một đánh giá dược lý đạt đến mức độ tương tự, đặt độc tính ở mức khoảng 1/3 tỷ lệ tiêu hao của ứng cử viên thuốc và báo cáo tỷ lệ thất bại về an toàn trong phát triển lâm sàng của 35% từ giai đoạn 1 để nộp và 28% từ giai đoạn 2 để nộp (Karnes và cộng sự., 2010). Hai nguồn hội tụ về cùng một kết luận thông qua các mẫu và phương pháp khác nhau, giúp tăng cường tín hiệu mà không đưa ra các ước tính hoàn toàn độc lập.
Bắt đầu với dữ liệu độc tính của FAIR Peptide
The first action is to pull one candidate sequence and read its record end to end before you run anything. That single pass tells you what the record already supports and what it does not.
Bước chân 1: Resolve the sequence and read the record. Resolve the sequence to its deterministic identifier, then read the evidence state and provenance fields attached to it. MAOMAO’s harmonized fields are designed for exactly this pass: a SHA-256 identifier ties the entry to one sequence, and the provenance fields state where the underlying measurement came from. If a field is empty, treat that as information, not as a gap to fill by assumption.
Bước chân 2: Classify each uncertainty and assign a test. Sort what you found into analytical uncertainty and biological uncertainty, then name the orthogonal test that resolves each one. Thử nghiệm phân tích và sinh học trực giao có nghĩa là phương pháp thứ hai không có cùng kiểu lỗi như phương pháp thứ nhất, vì vậy thỏa thuận giữa họ có trọng lượng đến nỗi việc lặp lại không.
Bước chân 3: Ghi lại kết quả để có thể tái sử dụng. Viết kết quả dựa trên các thuộc tính ALCOA+ mà định nghĩa ALCOA của MHRA đặt ra: có thể quy cho, dễ đọc, đương thời, nguyên bản, chính xác, cộng với hoàn thành, nhất quán, bền bỉ và sẵn có. Kết quả được ghi theo cách này có thể được sử dụng lại trong chương trình tiếp theo thay vì lấy lại.
Lớp siêu dữ liệu là điểm bắt đầu, không thể thay thế cho việc kiểm tra. Nó cho bạn biết thử nghiệm nào sẽ chạy tiếp theo; chỉ có thí nghiệm mới cho bạn biết peptit làm gì.
Câu hỏi thường gặp
MAOMAO có nghĩa là gì, và nó tích hợp những gì?
MAOMAO là một nguồn độc tính peptide được quản lý mang lại các bản ghi trình tự, thử nghiệm siêu dữ liệu bối cảnh và xuất xứ thành một lớp được căn chỉnh FAIR, vì vậy nhãn độc tính xuất hiện cùng với các điều kiện tạo ra nó chứ không phải dưới dạng một lá cờ trần. Điểm tích hợp quan trọng hơn từ viết tắt: sự liên tiếp, điểm cuối, hệ thống xét nghiệm và ngày giám tuyển đi cùng nhau.
Nhãn độc tính âm tính có nghĩa là peptide an toàn?
KHÔNG. Nhãn âm có nghĩa là bản ghi được quản lý không chứa tín hiệu độc tính đối với các điều kiện được thử nghiệm, đó là một tuyên bố về bằng chứng, không phải về phân tử. Việc không có tác dụng được ghi lại trong một hệ thống xét nghiệm không đảm bảo tính an toàn, và bất kỳ quyết định phát triển nào vẫn cần có sự đánh giá về độc tính có chất lượng cộng với thử nghiệm sinh học và phân tích trực giao.
MAOMAO so sánh với DBAASP v3 như thế nào?
DBAASP v3, bản sao hồ sơ thí nghiệm, bao gồm nhiều hơn 15,700 mục peptide, bao gồm cả hơn 14,500 peptide đơn phân và đại khái 400 đồng tính- và đa bội, với các phép đo hoạt tính và độc tính chống lại 8 loài mục tiêu hoặc nhóm loại tế bào (DBAASP v3, phát hành tháng 11 2020). Hai nguồn trả lời các câu hỏi khác nhau: DBAASP v3 tổng hợp các bản ghi được đo, trong khi lớp FAIR bổ sung các trường trạng thái bằng chứng và xuất xứ để làm cho mỗi bản ghi có thể kiểm tra được.
Các mô hình dự đoán như ToxiPep hoặc ToxGIN có thể thay thế thử nghiệm xét nghiệm không?
Không thay thế cho xác nhận thử nghiệm. ToxiPep đã báo cáo 0.92 AUC mô tả sự phân biệt đối xử trên tập đánh giá của nó, đó là một tuyên bố hiệu suất về một mô hình, không phải là một phát hiện an toàn về một chuỗi. Kết quả dự đoán được sử dụng tốt nhất để xếp hạng và ưu tiên các ứng viên trước khi thử nghiệm sinh học và phân tích trực giao, không kết thúc một câu hỏi về độc tính.
Danh sách rút gọn phân loại vẫn yêu cầu thử nghiệm trực giao nào?
Một danh sách rút gọn được tạo ra từ siêu dữ liệu độc tính peptide được quản lý vẫn cần công việc phân tích xác nhận, thường là đánh giá danh tính và độ tinh khiết bằng HPLC và phép đo phổ khối cùng với các xét nghiệm sinh học hoặc dựa trên tế bào có liên quan cho điểm cuối dự định. Cơ sở dữ liệu thu hẹp những gì bạn kiểm tra đầu tiên; nó không loại bỏ việc kiểm tra.
Siêu dữ liệu FAIR hỗ trợ tài liệu kích hoạt IND như thế nào?
Siêu dữ liệu FAIR hỗ trợ tài liệu kích hoạt IND vì nó giữ cho mỗi bản ghi có thể theo dõi được nguồn của nó, phương pháp và ngày giám tuyển, đó là đặc tính tương tự mà định nghĩa ALCOA của MHRA yêu cầu về quy, dễ đọc, đương thời, hồ sơ gốc và chính xác. Cơ quan quản lý xem xét chuỗi bằng chứng, vì vậy lớp siêu dữ liệu về độc tính peptide được ghi chép đầy đủ sẽ làm giảm công việc tái thiết sau này.
Phần kết luận
Dữ liệu độc tính peptide FAIR được quản lý giúp cải thiện việc phân loại ứng viên, thiết kế khảo nghiệm và báo cáo, và nó không thể hiện sự an toàn. Sự khác biệt đó là toàn bộ lập luận: hồ sơ có đóng dấu xuất xứ cho bạn biết những gì đã được đo lường, trong hệ thống nào, trong điều kiện nào, và nơi mà bằng chứng dừng lại. Nó không cho bạn biết peptide là an toàn, và không có nhãn cơ sở dữ liệu nào có thể tự mình mang trọng lượng đó.
Trường hợp lớp chạy từ mô hình dữ liệu ra ngoài. Các trạng thái bằng chứng và trường xuất xứ làm cho hồ sơ có thể kiểm toán được; hồ sơ có thể kiểm tra làm cho việc phân loại có thể được bảo vệ; phân loại có thể phòng thủ tạo ra một kế hoạch xét nghiệm tồn tại sau khi xem xét. Mỗi bước phụ thuộc vào bước trước đó, đó là lý do tại sao việc áp dụng một phần có xu hướng bị đình trệ ở bản ghi không rõ ràng đầu tiên.
Tài nguyên và hệ sinh thái mô hình xung quanh nó vẫn đang chuyển động. Khoảng trống bảo hiểm vẫn còn, phạm vi cấp phép chưa đầy đủ, và điểm chuẩn chưa được kiểm soát rò rỉ. Bài báo phát hành MAOMAO báo cáo rằng 15 của 56 bộ dữ liệu mang thông tin cấp phép rõ ràng, vì vậy hãy xác minh các điều khoản trước khi bạn xây dựng trên bất kỳ bảng nào. Coi các tuyên bố về mô hình dự đoán hiện tại là định hướng, chưa giải quyết.
Nếu bạn đang cân nhắc việc nhận con nuôi, bước tiếp theo hữu ích là một cuộc trò chuyện có phạm vi về quy trình làm việc phân loại của riêng bạn. Sản xuất peptit
Tiết lộ: MOL Changes xuất bản tài liệu về peptide và xác minh phân tích, bao gồm cả HPLC, Kiểm tra MS và độ vô trùng theo Lớp 100 sản xuất vô trùng. Bài viết này mang tính giáo dục và không khuyến nghị hoặc xác nhận bất kỳ peptide cụ thể nào.
Các quyết định về an toàn peptide đòi hỏi phải có sự đánh giá chuyên môn có trình độ và thử nghiệm sinh học và phân tích trực giao, không phải là nhãn cơ sở dữ liệu.