什么是 MAOMAO 以及为什么 FAIR 肽毒性数据很重要?
MAOMAO 代表多源注释组织的元数据感知本体, 本体引导的资源,协调从公共数据库中提取的肽毒性信息, 文献衍生资源和精选数据集 (MAOMAO离型纸, 2026). 它不是具有单个上游的单个数据库. 它的第一个版本集成了 56 来源, 跨越公共数据库, 文献来源的资源, 补充数据集和手动管理的存储库 (同一张纸), 并将它们合并为 71,857 跨越八个毒性相关终点的独特肽序列. 核心层持有 574,856 这些序列的协调肽端点组合. 6 月份期间 Google Scholar 和 PubMed 上的搜索量 2025 和九月 2026, 因此该版本反映了截至 9 月份的可用资源 2026. 此类数字因来源和管理日期而异, 并且版本中的单个上游记录仅承载该上游的权重.
FAIR 肽毒性数据的含义比“组织良好的数据”更窄。它意味着带有持久标识符的毒性记录, 丰富的来源元数据和规定的许可证, 这样读者就可以追踪声明的来源以及在什么条件下可以重复使用它.
类比: 记录是实验室笔记本条目, 不是判决
像对待带有出处标记的笔记本条目一样对待毒性注释. 它记录了谁观察到了效果, 什么时候, 来自哪个来源, 在哪个生物体上, 以及根据哪些证据表明. 它并不证明序列是安全的. 这种区别影响了本指南中的每个下游决策, 因为记录会告诉您所主张的内容以及记录的情况, 不是你对自己的候选人所证明的.
FAIR 对毒性记录的实际要求是什么
缩写隐藏了操作要求. 这 原创公平原则 (威尔金森等人。, 科学数据, 2016) 和 GO FAIR 概述 指定数据携带持久标识符 (F1), 元数据丰富 (F2) 并包括它们所描述的数据的标识符 (F3), 详细出处 (R1.2), 该记录遵循领域相关的社区标准 (R1.3), 并且有一个明确的, 注明可访问使用许可证 (R1.1).
MAOMAO统一领域是具体落实: 源标识符, 文献参考, 有机体信息, 注释出处, 检索日期, 文件格式和版本信息(如果有), 每个标准化序列都由大写的确定性 SHA-256 标识符键入, 无空格序列. 文件以 CSV 形式发送, JSON 和 YAML.
要点: 精心策划的毒性记录是带有出处标记的声明, 不是安全判决.
为什么策划的肽毒性元数据会改变候选分类
策划的肽毒性元数据改变了肽候选分类,因为它可以让您根据潜在证据的强度而不是标签的存在进行筛选. 只存储“有毒”或“无毒”的数据库将非常不同的观察结果压缩到一个字段中. 毛毛将他们分开. 其证据表明区分积极, 消极的, 模糊的, 无标签和无信息记录, 消极状态进一步分裂: 实验证据明确支持强烈的负面影响, 而弱阴性源自随机选择的阴性组或缺乏对不存在毒性注释的确认 (MAOMAO离型纸, 2026).
该分布说明了为什么这种区别具有重要意义. 整个发布过程, 毛毛报道 31,153 积极的, 91,506 消极的, 15,717 暧昧和 5,044 未标记状态 (MAOMAO 自己的证据文件指出, 检索到的 2026-07-30). 负桶是正桶的近三倍, 因此,将所有阴性视为清除的分类规则并不是对证据进行过滤. 它正在按音量进行过滤.
|
证据状态 |
数数 |
它在分类中支持什么 |
|---|---|---|
|
多肽合成 积极的 |
31,153 |
后续标记; 检查终点和检测背景 |
|
消极的 |
91,506 |
取决于强弱起源 |
|
模糊的 |
15,717 |
无法自行解决通过/不通过 |
|
未标记 |
5,044 |
无可用信号 |
阅读一条记录并确定它证明了什么
获取带有推断注释的记录,不附加分析上下文. 标签上写的是阴性. 出处称该电话是推断的而不是测量的, 并且没有终点, 浓度或测定系统记录在其旁边. 此时记录并没有回答“这个序列可以安全地推进吗?”它回答“有没有人发表过该序列的序列级毒性观察”,” 答案是否定的.
这就是决策点. 基于标签存在的分类规则使候选者通过. 基于证据状态的规则将其路由到不明确或未标记的路径, 在进入候选名单之前需要进行文献检查或分析. 第二条规则对每个候选人的成本更高,并产生一个你可以捍卫的候选名单.
当两个来源对一个序列的端点标签不一致时,适用相同的逻辑. 精心策划的唱片不会默默地选出获胜者. 它包含两个注释及其出处, 分歧本身就成为序列需要正交分析和生物测试而不是数据库结论的信号.
证据耗尽的地方
端点覆盖不均匀, 这种差距是结构性的而不是偶然的. MAOMAO 指出覆盖范围取决于可检索的序列级证据, 这会产生类别不平衡和细胞溶解的有限代表性, 胚胎毒性和鱼类毒性终点 (MAOMAO离型纸, 2026). 计数使薄度变得具体: 胚胎毒性携带者 2 阳性状态和鱼毒 5, 而细胞溶解作用成立 343 州总数. 与有毒根进行比较 57,080 州和 13,824 积极的一面, 或溶血 35,960 州和 4,714 积极的一面.
对于分类规则, 这意味着薄端点中缺少注释并不表示不存在. 这意味着终点很少被记录. 根据胚胎毒性或鱼类毒性数据过滤的候选名单几乎没有过滤任何内容, 诚实的举动是在候选人做出计划决定之前说出来.
许可是第二个边界. 注释内容和最后更新日期可用于 55 的 56 来源, 但显式许可仅涵盖 15 的 56 (MAOMAO 自己的证据文件指出, 检索到的 2026-07-30). 其余部分的重用条款需要在源头进行检查, 不从总体中假设.
要点: 负面不是一回事. 根据证据状态和来源进行分类, 店铺 标签上不存在, 并将薄端点视为未测量而不是干净的.
肽毒性证据状态和来源字段, 逐个领域
当有两件事明确时,肽毒性记录是可审核的: 证据状态是什么, 以及记录来自哪里. MAOMAO 结构. 本体有一个根类, 有毒的, 主要类别 细胞毒性, 神经毒性, 胚胎毒性, 和鱼毒, 和细胞毒性携带溶血亚类, 细胞溶解作用, 和抗哺乳动物细胞 (毛毛离型纸, 2026). 仔细阅读分支总计: 根有毒重叠子类计数, 所以对分支求和会夸大根, 该论文的方法说明直接指出了一个限制.
通过使用 SHA-256 对标准化大写序列进行哈希处理来处理身份, 这为相同的序列提供了跨层和源的相同密钥. 将发货记录为 CSV, JSON, 或 YAML.
实践中的证据状态词汇
每个州针对某个计划回答不同的问题. 积极的: 是否有直接或层次支持的毒性证据? 消极的: 有直接的吗, 终点特定的无毒性证据? 模糊的: 注释是否冲突或未解决? 未标记: 是否在没有显式类别分配的情况下保留了序列? 暂无信息: 是否根本没有证据表明该终点? (毛毛离型纸, 2026). 将这些视为消息来源所说内容的文档, 不作为安全决定.
使记录可审计的出处字段
MAOMAO 的统一字段让审阅者无需打开原始来源即可检查声明. 来源标识符和文献参考满足可查找和可追溯的归属. 有机体和注释来源满足可重用上下文. 检索日期和版本满足可访问货币. 文件格式支持互操作交换. 关于
许可是诚实的差距. 该论文在正文中指出没有统一的数据集许可, 报告源级许可覆盖范围 15 的 56 来源, 并将许可信息和版本控制记录放置在文档层中 (毛毛离型纸, 2026). 在受监管的工作流程中重用之前检查源级别术语.
FAIR 肽毒性数据如何融入检测设计和报告
精心策划的肽毒性元数据告诉您下一步要运行哪个正交确认; 它不会告诉您候选人是安全的. 该边界是该层的整个点. 数据库记录总结了其他人在规定条件下观察到的情况, 而证明的安全性取决于对您的材料进行的正交分析和生物测试: 高效液相色谱纯度, 女士身份, 反离子状态, LAL 内毒素, 不育, 以及您的程序所需的生物检测. 每个测试都回答一个狭窄的问题. LAL 仅测量内毒素负荷, 不是无菌或化学纯度, 反离子质量并非微不足道, 因为 TFA 盐可以大致代表 5% 到 25% 固体质量和残留 TFA 会干扰膜和受体测定读数 (反离子和正交测试文献, 2020-12-03).
对于小费: 在提交检测时间之前,将每个剩余的不确定性映射到解决该问题的特定正交测试.
从分类候选名单到检测计划
从您的证据状态过滤器生成的候选名单中进行工作, 然后将每个开放问题转换为测试和决策规则.
-
身份和纯度. 如果记录带有没有分析上下文的推断注释, 在规定的方法下通过 MS 确认分子身份并通过 HPLC 确认色谱清洁度. 如果身份匹配并且纯度符合您的规格,则解决候选人.
-
抗衡离子状态. 记录中未量化的盐形式, 测量它. 改变有效剂量或扰乱受体测定的反离子结果会改变对下游一切的解释.
-
内毒素. 根据药典内毒素限量设定限量, 公里/米, 与 K = 5 USP-EU/kg(鞘内注射以外的途径),K = 0.2 USP-EU/kg 鞘内注射, 其中 M 是单小时内每公斤人体的最大推荐剂量 (美国药典 <85> 细菌内毒素检查).
-
不育. 证明在测试条件下不存在活微生物, 根据USP <71> 指接种到指定的培养基中并培养 14 天 (我Q2(R2), 2023-11-30).
-
生物学证实. 只有在分析层稳定后,您才能将毒性信号视为候选物而不是样品的属性.
通过审查的文档
上述每一个结果都必须在以后得到辩护, 元数据层是开始的地方. MHRA 的 2018 GxP 数据完整性指南将 ALCOA 定义为可归因的, 清晰易读, 同时期的, 原来的, 和准确的, 与 ALCOA+ 添加完成, 持续的, 持久, 并可用 (MHRA, GxP 数据完整性指南, 2018-03-09). 出处字段直接映射到这些属性: 来源标识符和管理日期使记录可归属且同时发生, 分析上下文字段使其保持完整, 稳定的记录链接使其可用. 验证期望并行运行, 自从我 Q2(R2)的适合用途标准要求记录程序适合其预期用途, 不仅仅是它运行了 (我Q2(R2), 2026-02-20).
FAIR 元数据层以适度的方式支持此工作流程, 可复制的方式. 它可用于将证据状态和出处字段从分类工具传输到 CoA 级记录,而无需重新输入, 它有助于保存分析结果, 使用的方法, 以及它们在一条可追溯链中进行匹配的记录. MOL Changes 是围绕文档和分析验证层构建的, 包括 HPLC/MS 和无菌测试和 Class 100 无菌生产. 实际的结果是数据库永远不会代替你的测试; 它决定您需要进行哪些测试, 它提供了审计跟踪来显示您运行了它.
基于肽毒性元数据构建的基准测试和预测模型
MAOMAO 的基准层的存在是为了可以在共享基础上比较模型性能,而不是在每篇论文的私有分裂上进行比较. 它定义了 300 端点种子策略配置, 1,500 数据分区, 3,300 特定于表示的配置和 16,500 折叠实例, 源自 5 符合条件的端点 合成肽 × 30 随机种子 × 5 倍分裂 × 11 陈述 (MAOMAO, 药理学前沿, 2026). 代表方同样明确: 10 蛋白质语言模型嵌入矩阵加上覆盖所有内容的单热表示 71,857 序列, 旁边的描述符层 41 特征 (MAOMAO, 2026).
限制与规模一样重要. 这些预定义的分区使用随机和分层分割,并且不是同源的- 或相似性控制, 因此它们不受泄漏控制. 该基准的高分告诉您模型将其训练所依据的策划肽毒性元数据分开. 它还没有告诉你模型转移到它从未见过的脚手架上.
阅读具有正确警告的预测模型声明
已发表的肽毒性预测因子报告了强劲的数据, 每个数字都有自己的范围. ToxiPep 接受过培训 3,528 有毒和 3,528 CD-HIT 过滤的无毒肽 0.9, 测试于 883 加 883, 并报告准确性 0.850, 灵敏度 0.827, 特异性 0.873, 中冶集团 0.701 和 ToxiPep 报告 0.92 曲线下面积 (2025). ToxGIN 的独立测试 AUROC 的 0.9172 附带 F1 的 0.8354 和一个MCC 0.6866 (生物信息学简报, 2024). PeptiVerse 组装完毕 5,518 有毒和 5,518 无毒肽, 但 PeptiVerse 继承了 ToxinPred3.0 的毒性标签 而不是来自测定 (2026).
以下是两个注意事项. 第一的, 这些主要是供应商自己的方法的结果, 由构建模型的团队评估. 第二, 适用范围受结构限制: ToxiPep 的 CD-HIT 0.9 过滤意味着它的声明适用于与其训练数据相似的序列, 不适用于任意新颖的化学. PeptiVerse 复合了这一点, 因为从预测器继承的标签将预测器的误差向前传递.
泄漏控制基准会改变什么
如果您正在决定是否信任新颖支架上的模型, 分裂就是索赔. 同源性- 或相似性控制的分区将接近重复的序列排除在训练之外, 因此,测试分数反映的是外推法,而不是记忆的近亲. 随机和分层分割无法区分两者, 这就是为什么 0.92 随机分割的 AUC 和 0.92 同源控制分割上的 AUC 对于您的程序来说意味着不同的事情.
实际阅读: 将已发布的肽毒性元数据分数视为内部歧视的证据, 不作为转让担保. 在模型通知综合或测试决策之前, 检查其评估是否控制序列相似性, 并确认其标签背后的终点和检测背景. 如果没有这种控制, 该分数是正交分析和生物测试的起始假设, 不能替代它.
关于肽毒性数据库的常见误解
最常见的错误是将数据库标签视为安全决定. 标签记录了观察到的情况, 在什么系统中, 在什么条件下; 它并不证明序列可以安全地推进.
第一个误解是负面标签意味着无毒. 负面因素不是一回事. 强阴性取决于具有规定终点和浓度范围的记录化验; 弱负值可能反映了未经测试的序列, 未报告的结果, 或无法检测效果的测定. 将两者合并为一个“干净”标志的分类规则是故障模式.
二是来源越多,信心就越大. 来源计数和证据独立性是不同的数量. 一个大的聚合仍然可以追溯到一个上游贡献者, 因此表面上的支持范围比数字显示的要窄.
第三个是模型分数转移到新的序列. 预测模型具有适用范围, 在它之外计算的分数是外推法, 不是测量.
第四,统一的数据消除了正交测试的需要. 统一使记录具有可比性; 这并不足以使他们足够. 关于肽安全性的决定仍然需要合格的专业判断以及正交分析和生物测试.
警告: 负面标签不是一回事. 强否定和弱否定具有不同的证据分量, 将它们视为一件事的分类规则就是故障模式.
负面结构较薄的部分原因是毒理学的发表偏差, 积极发现的发表优势为 3.3 倍, 阳性结果患病率大约从 50% 到 90% 之间 1991 和 2007 (贝罗等人。, 偏倚风险审查, 2016, 涵盖 1991-2007 年窗口期). 文献衍生的数据集继承了这种不对称性.
为什么非临床毒理学消耗会做出这样的决定, 不是好奇心
关键在于为什么候选肽分类值得如此重视,而不是快速数据库查找. 在四家公司的减员审计中, 非临床毒理学占 40% 终止次数, 最大的单一原因, 大致穿过 605 阿斯利康终止化合物, 礼来公司, 葛兰素史克和辉瑞之间 2000 和 2010 (韦林等人。, 自然评论药物发现, 2015).
药理学审查达到相同数量级, 将毒性定为候选药物损耗的大约三分之一,并报告临床开发安全失败率 35% 从相 1 提交和 28% 从相 2 提交 (卡恩斯等人., 2010). 两个来源通过不同的样本和方法得出了相同的结论, 这增强了信号而不使它们完全独立的估计.
FAIR 肽毒性数据入门
第一个操作是在运行任何操作之前拉出一个候选序列并从头到尾读取其记录. 该单遍告诉您记录已经支持什么以及不支持什么.
步 1: 解析序列并读取记录. 将序列解析为其确定性标识符, 然后阅读附加的证据状态和出处字段. MAOMAO 的协调字段正是针对此关卡而设计的: SHA-256 标识符将条目与一个序列联系起来, 来源字段说明了基础测量的来源. 如果字段为空, 将其视为信息, 不是通过假设来填补空白.
步 2: 对每个不确定性进行分类并分配测试. 将您的发现分为分析不确定性和生物不确定性, 然后命名解决每个问题的正交测试. 正交分析和生物测试意味着第二种方法不具有第一种方法的失效模式, 因此,他们之间的协议具有重要意义,而重复运行却没有意义.
步 3: 记录结果,以便可重复使用. 根据 MHRA 的 ALCOA 定义规定的 ALCOA+ 属性写入结果: 可归因的, 清晰易读, 同时期的, 原来的, 准确的, 加完整, 持续的, 持久且可用. 以这种方式记录的结果可以在下一个程序中重用,而不是重新导出.
元数据层是一个起点, 不能替代测试. 它告诉您接下来要运行哪个实验; 只有实验才能告诉您肽的作用.
常见问题解答
MAOMAO 代表什么, 它集成了什么?
MAOMAO 是一个精心策划的肽毒性资源,可带来序列记录, 将上下文和来源元数据分析到一个 FAIR 对齐层中, 因此,毒性标签与产生它的条件一起到达,而不是作为一个裸露的标志. 集成点比缩写词更重要: 顺序, 终点, 分析系统和策展日期一起旅行.
毒性标签阴性是否意味着肽是安全的?
不. 负面标签意味着策划的记录不包含测试条件下的毒性信号, 这是关于证据的陈述, 与分子无关. 一个测定系统中没有记录的效果并不能证明安全性, 任何开发决策仍然需要合格的毒理学判断加上正交分析和生物测试.
MAOMAO 与 DBAASP v3 相比如何?
DBAASP v3, 实验记录对应物, 涵盖超过 15,700 肽条目, 包括超过 14,500 单体肽和大致 400 同性恋者- 和异源多聚体, 并进行活性和毒性测量 8 目标物种或细胞类型组 (DBAASP v3, 十一月发布 2020). 这两个资源回答不同的问题: DBAASP v3 聚合测量记录, 而 FAIR 层添加了证据状态和来源字段,使每条记录都可审计.
ToxiPep 或 ToxGIN 等预测模型能否取代分析测试?
不能代替实验确认. ToxiPep 报告 0.92 AUC 描述了其评估集上的歧视, 这是关于模型的性能陈述, 不是关于序列的安全发现. 预测输出最适合在正交分析和生物测试之前对候选者进行排名和优先排序, 不要结束毒性问题.
分类候选名单还需要哪些正交测试?
根据精心策划的肽毒性元数据生成的候选名单仍需要验证性分析工作, 通常通过 HPLC 和质谱法以及相关的生物或细胞分析来评估预期终点的身份和纯度. 数据库缩小了您首先测试的范围; 它不会删除测试.
FAIR 元数据如何支持 IND 文档?
FAIR 元数据支持支持 IND 的文档,因为它使每条记录都可追溯到其来源, 方法和策展日期, 这与 MHRA 的 ALCOA 定义要求的属性相同, 清晰易读, 同时期的, 原始且准确的记录. 监管机构审查证据链, 因此,详细记录的肽毒性元数据层减少了以后的重建工作.
结论
精心策划的 FAIR 肽毒性数据可改善候选者分类, 分析设计和报告, 并且它没有表现出安全性. 这种区别就是整个论点: 带有出处标记的记录会告诉您测量的内容, 在什么系统中, 在什么条件下, 以及证据停止的地方. 它并没有告诉您肽是安全的, 没有任何数据库标签可以单独承担这样的重量.
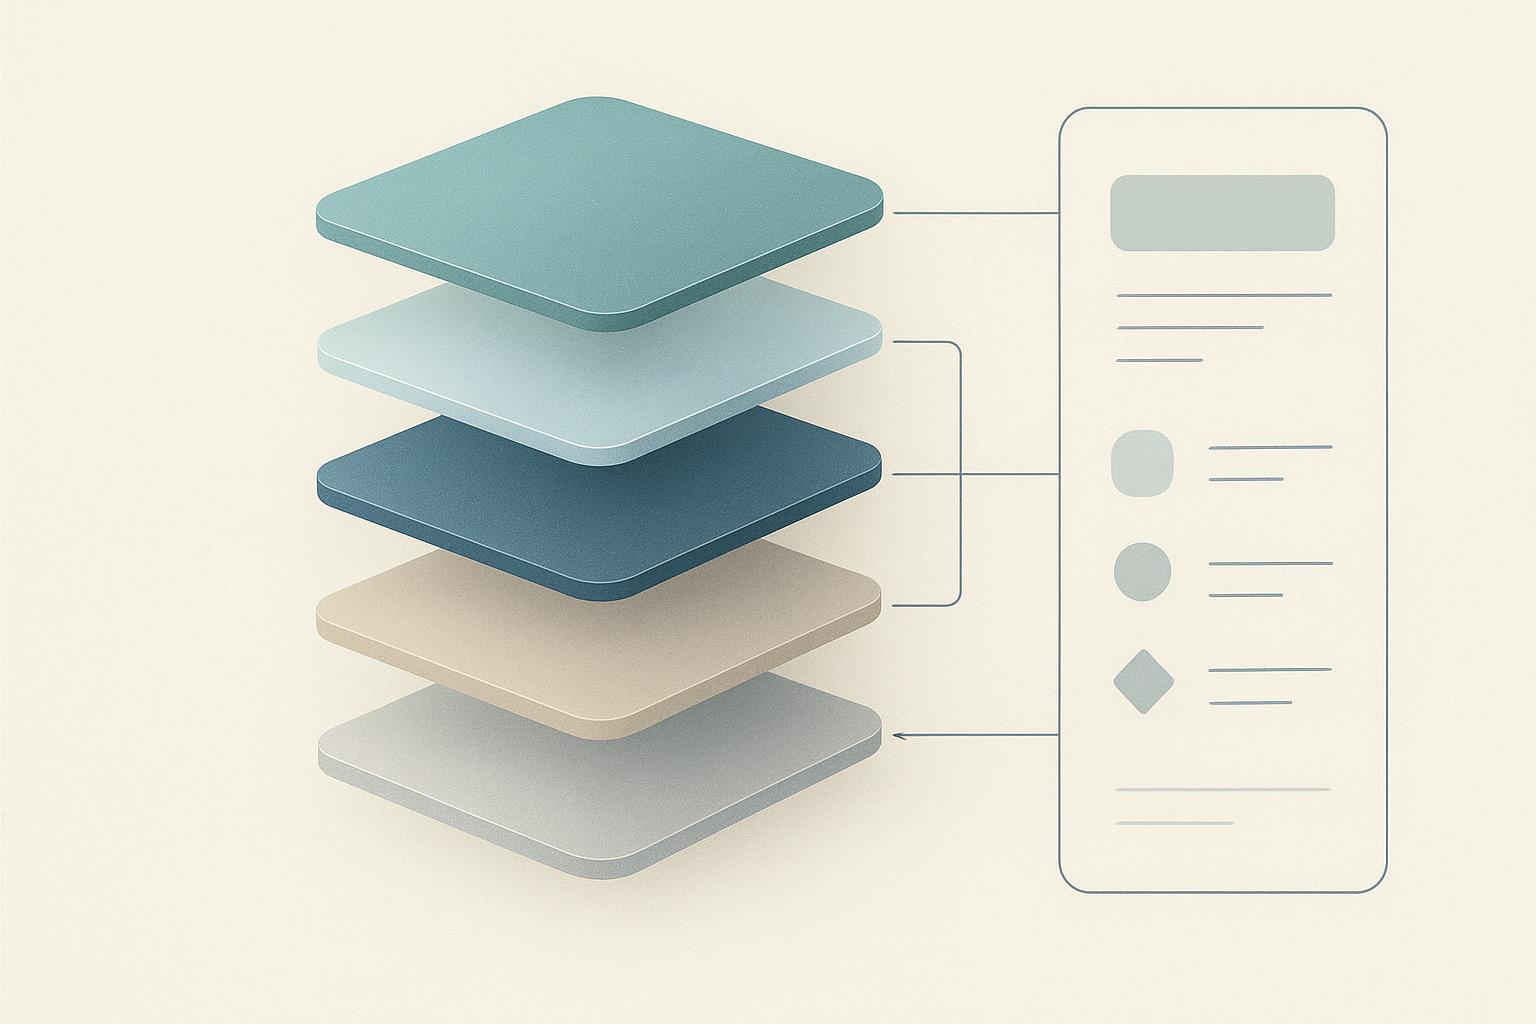
分层情况从数据模型向外延伸. 证据状态和出处字段使记录可审计; 可审计的记录使分类变得站得住脚; 合理的分类产生了一个能够通过审查的检测计划. 每一步都取决于之前的一步, 这就是为什么部分采用往往会在第一个模糊记录时停滞不前.
资源及其周围的模型生态系统仍在移动. 覆盖范围仍然存在差距, 许可范围不完整, 并且基准尚未受到泄漏控制. MAOMAO 发布文件报道称 15 的 56 数据集携带明确的许可信息, 因此,在任何表格上构建之前请先验证条款. 将当前的预测模型主张视为方向性的, 未解决.
如果您正在考虑收养, 有用的下一步是关于您自己的分类工作流程的范围对话. 多肽生产
披露: MOL Changes 发布肽文档和分析验证, 包括高效液相色谱法, MS 和 Class 下的无菌测试 100 无菌生产. 本文具有教育意义,不推荐或认可任何特定肽.
有关肽安全性的决策需要合格的专业判断以及正交分析和生物测试, 不仅仅是数据库标签.