Pourquoi le goulot d'étranglement est passé du modèle au banc
Un co-scientifique en IA est un système multi-agents qui génère et classe des hypothèses de recherche; l'interface côté banc est tout entre un candidat classé et un flacon de matériel caractérisé. La capacité du modèle a dépassé cette interface, et l'écart est là où les gains sont perdus.
Les propres validations rapportées par Google en sont l’illustration la plus claire. Son co-scientifique multi-agent Gemini a proposé des candidats pour la réutilisation de la leucémie myéloïde aiguë qui inhibaient la viabilité du KG-1 à des concentrations cliniquement pertinentes., cibles épigénétiques qui ont montré une activité dans les organoïdes hépatiques humains (p < 0.01), et un mécanisme cf-PICI/phage-tail pour la résistance aux antimicrobiens (Recherche Google, 2025-02-19). Lire les petits caractères: le système a produit des hypothèses, pas de matériaux. Chacune de ces réclamations n'est devenue une réclamation qu'après un travail en laboratoire humide., et au moment où les premiers résultats de co-scientifiques évalués par des pairs sont apparus dans Nature, la couverture était explicite que les validations en laboratoire, pas le modèle, avoir le poids de la preuve (Spectre IEEE, 2026).
Le motif se répète sur tout le terrain. Une évaluation de six cadres de découverte d'agents a révélé qu'aucun ne prenait pleinement en charge l'un des 15 classes de tâches du monde réel, et les tâches spécifiques aux peptides n'avaient aucune couverture, avec des systèmes orientés vers les représentations de petites molécules (examiner la couverture, 2026-02-13).
La couche physique n'est pas une erreur d'arrondi. Le même 16-mer, six résines, une quintuple propagation en pureté brute: étoile du bar[75–90] variait de 20% à 52% sans étiquette solubilisante et 41% à 72% avec un ArgTag (Etude de résine SPPS, 2025-11-21). L'efficacité par étape se compose de la même manière: 99% sur 30 les résidus donnent à peu près 74% rendement global, 98% donne environ 55%, et 95% donne environ 21% (explicateur de fabrication, 2026-07-24). Ce dernier ensemble est une illustration arithmétique, données de campagne non mesurées, et les chiffres de ce type varient selon la source.
Clé à retenir: Un modèle qui classe bien les candidats remet encore au banc une molécule dont la faisabilité de synthèse, la compatibilité des modifications et la confirmation analytique sont indécises. La faisabilité de la synthèse peptidique conçue par l’IA est la contrainte qui définit ce que la boucle peut réellement fournir.
Synthèse peptidique sur six résines de synthèse plus un PS-2CTC à l'échelle pilote, deux séries par résine (sans ArgTag / avec ArgTag). Valeurs sans/avec: 20/41, trace/24, 45/72, 52/58, 51/64, 34/64, 27/50. Source: PMC12645436, 2025.]
La faisabilité de la synthèse est un filtre de conception, Pas un contrôle post-hoc
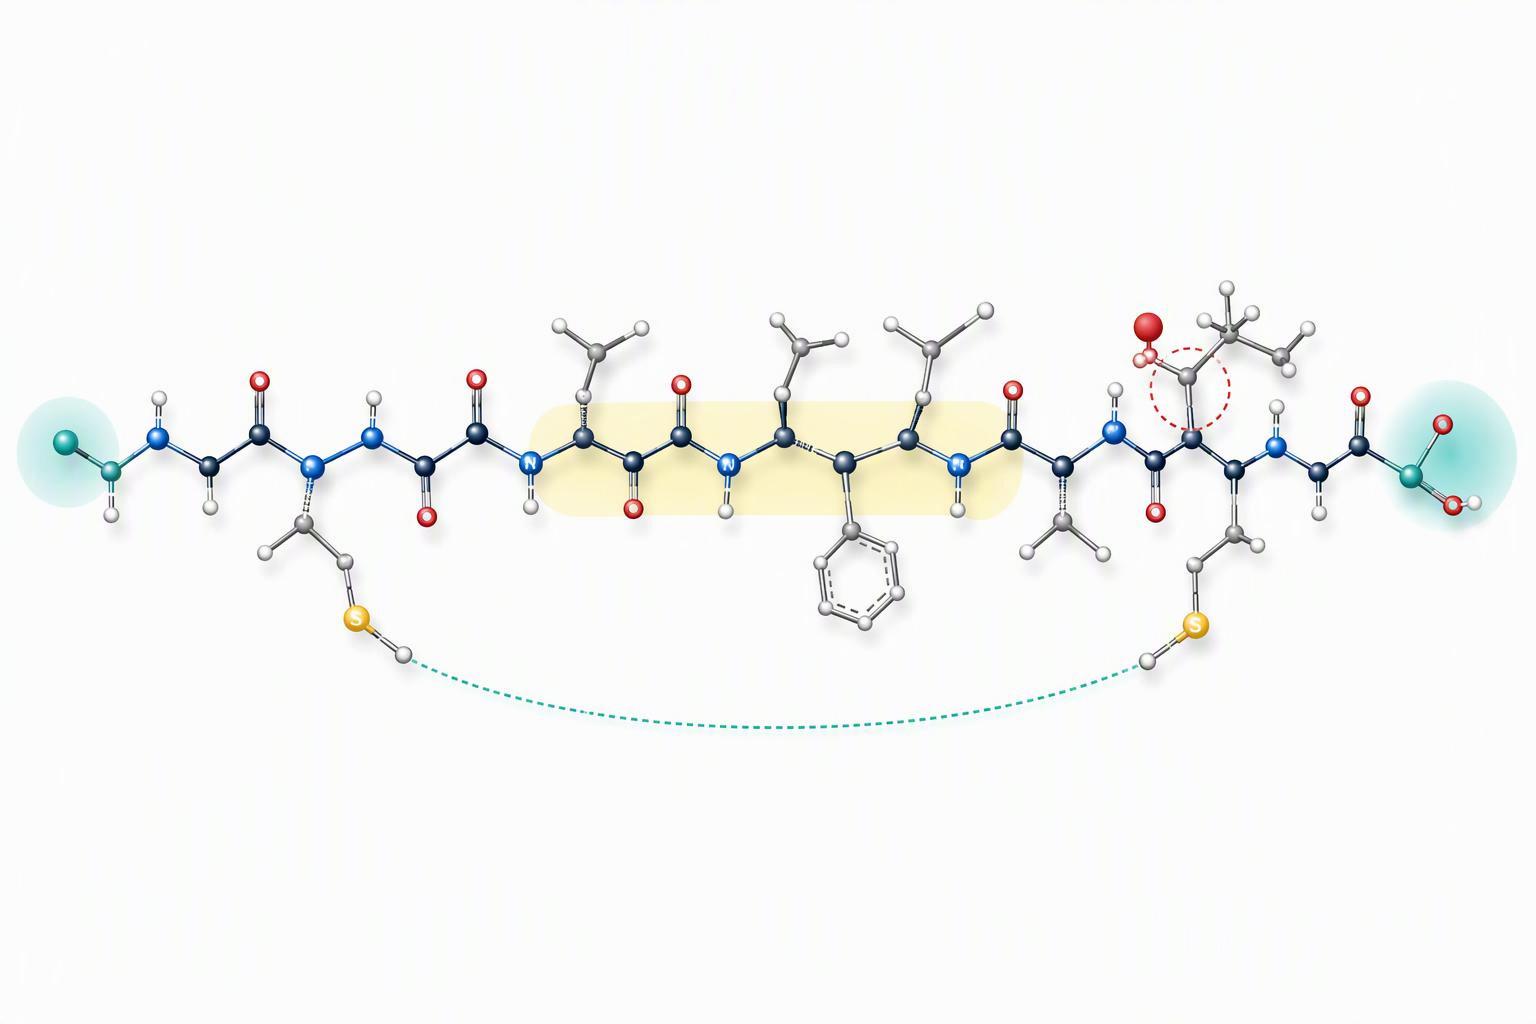
La faisabilité de la synthèse peptidique conçue par l'IA doit trouver un candidat avant que quiconque ne passe une commande, je n'explique pas l'échec par la suite. Traitez-le comme un filtre de conception: un écran au niveau de la séquence qui s'exécute sur la sortie du modèle, dans la même boucle que la fonction de scoring.
Le plafond pratique auquel travaillent la plupart des chimistes de synthèse est court. Ci-dessus à peu près 15 acides aminés, le produit brut en phase solide contient un grand nombre de sous-produits de faible concentration, et ces sous-produits dépassent souvent le peptide cible dans le brut (Revue pratique SPPS, 2025). Au-dessus de 35 à 40 résidus, Le SPPS par étapes cesse d'être la bonne voie et la condensation convergente ou la ligature chimique native prend le relais (même avis, 2025).
L'arithmétique explique pourquoi. À 95% par étape, une chaîne de 30 résidus renvoie environ un cinquième de la théorie; sur 100 résidus, un 1% la perte par étape laisse environ un huitième de la théorie (Explication de la synthèse peptidique, 2026). Les deux chiffres sont une illustration arithmétique, données de campagne non mesurées.
Les scores de synthétisabilité aident ici, avec des limites. SAscore a été validé par rapport aux jugements des chimistes à r² = 0.89 sur quarante molécules, un petit ensemble (Sciences Chimiques RSC, 2025), et la littérature définit ces scores comme des proxys d'alerte précoce, pas de preuve de fabricabilité (Etude de filtrage de synthétisabilité, 2026).
Clé à retenir: Problèmes de faisabilité intrinsèques à une séquence séparée (propension à l'agrégation, étirement hydrophobe, topologie multi-disulfure, couplage à empêchement stérique) de ceux dépendants de l'itinéraire (stratégie de protection, choix de résine, conditions de clivage et de purification). La première est une contrainte de conception; la seconde est un choix de processus.
Les contraintes de modification appartiennent à l'étape de génération
Les contraintes de modification des peptides sont une entrée au moment de la génération, pas une surprise au moment de la purification. La chimie prévue et la voie de synthèse réelle doivent être vérifiées l'une par rapport à l'autre avant qu'un modèle ne s'engage sur un candidat., car un score de structure uniquement ne peut pas voir l'itinéraire. Les modèles correspondent toujours aux modèles, pas de physique: des revues évaluées par des pairs sur les cadres de conception de peptides multi-agents indiquent que ces systèmes sont limités par le manque de données expérimentales de haute qualité, faible manipulation des peptides flexibles et désordonnés, et le recours à des modèles statistiques plutôt qu'à la chimie physique (Briefings en bioinformatique, 2024; Communications chimiques, 2026).
C'est dans cette lacune qu'une vérification de compatibilité gagne sa place. Un candidat porteur de lipidation, la cyclisation ou une étiquette fluorescente doit être exécutée sur un menu de modification qui couvre la chimie prévue avant qu'une commande ne soit passée, pas après un échec Peptides synthétiques parcelle. En pratique, il s'agit d'un échange court: séquence dans, modification prévue nommée, itinéraire et faisabilité relire. Où le menu s'arrête, un CDMO compétent ou un fournisseur spécialisé est la réponse honnête, et l'arbitre est toujours l'expérience.
Une lecture n'est pas une confirmation
La confirmation analytique orthogonale des peptides implique l'utilisation de méthodes dont la base physique pour séparer ou identifier une molécule est véritablement indépendante., pas deux exécutions du même principe. Une seule trace HPLC en phase inverse vous indique que le lot est élué en un seul pic.; cela ne vous dit pas quel est ce pic. La propre liste des lacunes de la FDA dans les dépôts comparatifs de peptides s'attend à ce que des méthodes chromatographiques orthogonales avec différents principes de séparation aux côtés de l'UHPLC-HRMS/MS confirment l'identité des pics. (Directives de la FDA pour l'analyse comparative des peptides, 2022-09-20). Je Q2(R2) fixe les caractéristiques de validation par type de procédure et permet de démontrer la spécificité par rapport à une seconde, procédure bien caractérisée, dont un orthogonal (Je Q2(R2), 2023-11-30). Q6B définit les spécifications des lots de cohérence de fabrication, c'est pourquoi les critères d'acceptation font partie du lot, pas au test (Je Q6B).
|
Niveau d'impureté |
Services Action requise |
|---|---|
|
≥0,10 % |
Rapport |
|
≥0,5% |
Identifier |
|
≥1,0% |
Qualifier |
|
>0.5% nouvelle impureté vs. produit de référence |
Pas acc Boutique acceptable |
Seuils selon les directives de la FDA (2022-09-20) et le Directive EMA sur les peptides synthétiques (2025-12-04).
Le modèle de banc récurrent: un candidat se classe bien in silico, synthétise comme un brut à faible récupération, purifie mal, et donne beaucoup dont la lecture par méthode unique semble acceptable alors que la méthode orthogonale n'est pas d'accord.
La documentation sur l'identité et la pureté doit être traçable jusqu'aux fichiers de données brutes par lot, et un CoA sans le chromatogramme et le spectre de masse sous-jacents n'est pas vérifiable. Production de peptides
La comparabilité des lots est une entrée de conception
La comparabilité des peptides d'un lot à l'autre est la capacité de montrer que deux lots de la même séquence répondent aux mêmes spécifications., et c'est décidé bien avant que QC ouvre un flacon. Une spécification n'est pas un numéro de pureté; ce sont des tests, procédures et critères, et les mêmes seuils s'appliquent lot à lot (Directives de la FDA sur les limites d'endotoxines). Les choix de tracé et de résine sont des variables de comparabilité: dans un 2025 Etude SPPS, une séquence a donné 27% pureté brute sur résine PS-2CTC à haute charge à 0.75 mmol/g, s'élevant à 50% à 0.69 mmol/g avec l'étiquette, tandis que le PSAM-RAM apolaire donnait à peu près 20% et MBHA-RAM uniquement trace de produit (même étude sur la résine SPPS). Les sous-produits tombent dans les suppressions, terminaisons et modifications chimiques, et leur profil change avec l'itinéraire.
Aucun ensemble de données publié pour 2025-2026 ne donne une distribution numérique de la pureté d'un lot à l'autre pour les peptides modifiés complexes par rapport aux peptides linéaires simples.. Ce que l'enregistrement corrige, c'est la couche de version: la stérilité prend 14 jours dans deux milieux à deux températures avant qu'un résultat de stérilité n'existe, sans croissance dans aucun des deux supports requis (Manuel de microbiologie pharmaceutique de la FDA), et l'endotoxine est jugée par rapport au 5 Limite parentérale UE/kg, calculé en K/M (Directives de la FDA sur les limites d'endotoxines). Un ensemble de documentation par lot enregistre le numéro de lot, apparence, pureté par HPLC avec chromatogramme, identité par MS avec spectre, et résultats d'endotoxines et de stérilité, chacun traçable à son fichier de données brutes.
Le taux de boucle est défini par le redressement analytique, Pas de vitesse d'inférence
Le cycle de conception-test-apprentissage pour la découverte de peptides, la boucle où un candidat est conçu, synthétisé, testé et réinjecté dans le tour suivant, est limité par l'heure du calendrier sur le banc, pas par vitesse d'inférence. Dans la découverte de petites molécules basée sur l'IA, une itération de conception-réalisation-test-analyse s'exécute généralement 4 à 8 semaines, tandis que les cotations des services peptidiques placent la synthèse standard à 1 à 3 semaines et des peptides modifiés ou plus longs à 2 à 6 semaines, avec un redressement des analyses primaires de 3 à 5 jours, 5 jours avec ADME, et sous 10 jours avec PK in vivo (Association de la BioIndustrie, récupéré 2026-09-12). Ce sont des déclarations de fournisseur et de niveau de service, pas une référence contrôlée. L'objectif d'AstraZeneca entre la conception et les données de test en moins de 5 jours et le cycle de prototype de moins de 2 heures montrent à quoi ressemble la même boucle lorsque les étapes du laboratoire humide sont conçues pour la vitesse. (IRBM, récupéré 2026-09-11).
Le temps calendaire réellement consommé par une requête de synthèse suit la même forme: peptides standards de 2 à 30 acides aminés ci-dessus 80% la pureté arrive généralement dans 10 à 15 jours ouvrables, exprimer les commandes en 5 à 7 jours, et des séquences complexes ou multi-modifiées dans 3 à 4 semaines. Raccourcir la boucle, c’est racheter ces semaines, ne pas gagner des millisecondes sur une exécution de modèle.
Mais les modèles seront conçus autour de la chimie – n’est-ce pas déjà le cas?
En partie, et la concession compte. Les filtres de synthétisabilité de classe SAscore sont une pratique courante, et la littérature 2025-2026 considère les scores d’accessibilité comme des indicateurs d’alerte précoce utiles. Mais la même littérature précise clairement qu’il s’agit de proxys, pas de preuve de fabricabilité, l'expérience physique restant l'arbitre. Le proxy est aussi plus mince que sa réputation: SAscore a été validé sur quarante molécules, et il s'agit uniquement d'une structure plutôt que d'un itinéraire. Côté modèle, un examen de six cadres agents n'a révélé aucune couverture des tâches peptidiques dans six cadres, avec un biais vers les représentations de petites molécules, et la notation sous-jacente correspond largement aux modèles, pas de physique. De meilleurs filtres augmentent le taux de réussite. Ils ne suppriment pas la faisabilité, compatibilité des modifications, confirmation orthogonale et comparabilité comme entrées de conception.
Prochaines étapes: Traitez l'interface comme la surface de conception
Faisabilité de la synthèse peptidique conçue par l'IA, compatibilité des modifications, la confirmation orthogonale et la comparabilité des lots sont des éléments de conception, pas de contrôles en aval, et le taux de boucle est défini par le délai d'exécution analytique plutôt que par la vitesse d'inférence. La séquence de départ est courte. Filtrez les candidats par rapport aux règles de faisabilité intrinsèques à la séquence avant de commander quoi que ce soit.. Vérifiez la modification prévue par rapport à l'itinéraire qui l'exécutera réellement. Exiger une confirmation orthogonale avec traçabilité des données brutes par lot. Spécifier les critères de comparabilité dans la commande elle-même, pas dans un e-mail de suivi après l'arrivée du premier lot.
MOL Changes est un peptide R spécialisé&D organisme intégrant la chimie organique et la biologie, offrant une synthèse personnalisée depuis la conception de séquences jusqu'à la production à grande échelle, avec production en classe 100 environnements de salle blanche ultra-stériles et QC par MS, HPLC, AAA, endotoxine, contre-ion, rotation optique et contenu UV. MOL Changes a un intérêt commercial dans les normes de qualité des peptides. La caractérisation des matériaux en phase de développement ne constitue pas une allégation clinique, et les décisions de formulation ou de dosage appartiennent à des professionnels qualifiés.
Envoyer une séquence pour une lecture de faisabilité. Vous obtenez une évaluation de l'itinéraire et un calendrier réaliste avant de vous engager sur une commande, quel est le moyen le moins cher de savoir si un candidat peut exister dans un flacon. À propos
Foire aux questions
Les filtres de synthétisabilité ne résolvent pas déjà ce problème?
En partie, et c'est la réponse honnête. Les filtres sont des proxys utiles, pas de certificats. Un ensemble de validation de 40 molécules a montré que la synthétisabilité prévue et les résultats des tests divergent suffisamment souvent pour qu'un filtre puisse classer les candidats mais ne puisse en éliminer un.. Considérez une note de passage comme une autorisation d'essayer, jamais comme preuve que la molécule existe.
Notre programme s'engage déjà auprès des candidats qui échouent à la faisabilité. Maintenant quoi?
Re-séquencer l'itinéraire avant de reconcevoir la molécule. L’accumulation de sous-produits devient la contrainte dominante au-dessus d’environ 15 résidus, et l'itinéraire lui-même change ci-dessus 35 à 40 résidus, où la ligature convergente commence à payer. De nombreuses séquences « infaisables » sont réalisables avec une stratégie d'assemblage différente.
Les modèles ne s’amélioreront-ils pas simplement et seront-ils conçus autour de la chimie ??
La capacité s’améliore; la couverture n'est pas. Six cadres d'évaluation majeurs ne contenaient aucune couverture peptidique, donc les frameworks n'ont pas été évalués sur les peptides. De meilleurs modèles aident, mais les contraintes de modification des peptides sont physiques, pas informatif, et aucun benchmark ne les mesure actuellement.
La comparabilité des lots est-elle importante à l'échelle de la recherche, ou seulement à la fabrication?
Cela compte dès que deux lots alimentent une expérience. La comparabilité est une question de spécification: définir les seuils d'impuretés et les méthodes analytiques qui les mesurent avant de comparer les résultats entre les lots, pas après une réplique en désaccord.