Réponse rapide
Un modèle vous remet désormais une liste de candidats pour le prix d'un calcul. La partie coûteuse commence après ça: décider quelles séquences méritent une synthèse, lequel …
Ce que la campagne antibiotique du MIT et la recherche sur les enzymes ont réellement démontré
Usine de fournisseur de peptides Technologie peptidique Les deux campagnes ont démontré la recherche et la priorisation à grande échelle, candidats médicaments non validés. Le Cellule le travail combinait des modèles génératifs basés sur des fragments et de novo et poussait 36 millions de composés prédits à travers des filtres pour 24 molécules synthétisées, sept d'entre eux sont antibactériens (Krishnan et coll., Cellule, 2025). L’entonnoir du suivi de la gonorrhée montre le coût: 6,937,677 molécules générées, 678 laissé après le filtrage, 80 priorisé pour la synthèse, 27 tenté, et seulement 2 de 27 les composés tentés étaient synthétisables.
La piste SARM s'est déroulée 29,014,974 généré des molécules pour 90 présélectionné, 22 acquis, et 6 actif à 64 µg/mL, que les auteurs rapportent comme étant la piste du SARM 27.3% taux de découverte réel. Le composé principal est important sur le plan biologique: NG1 lie LptA, une protéine de construction de la membrane externe que les antibiotiques existants ne ciblent pas, et son 0.5 μg/mL CMI contre N. gonorrhée est venu avec une réduction d'environ 3 log d'UFC dans un modèle vaginal de souris. Les deux agents pathogènes se trouvent sur le 2024 Liste des priorités de l'OMS comme haute priorité.
L’histoire des enzymes est un autre type de preuve. Les agents du rapport récupérés 198,290 clusters de transcriptase inverse, marqué 3,564 familles de protéines partenaires candidates, et promu 17 à des rapports lisibles par l'homme. Le rapport lui-même porte la mention « ART (hypothèse)" étiquette et déclare que les résultats attendent une caractérisation expérimentale. Un rapport indépendant indique que le rapport n'a pas été examiné par des pairs et que la même transcriptase inverse est apparue dans un 2021 papier à phages géants (Filaire, 2026).
Pourquoi des dizaines de millions de candidats se réduisent à quelques dizaines de composés synthétisés
Les campagnes citées montrent que la synthèse et les tests expérimentaux peuvent limiter les efforts de découverte spécifiques.. Ils n’établissent pas que la prédiction est adéquate ou que la synthèse est le goulot d’étranglement dominant dans chaque programme peptidique.. Évaluez les deux.
Les programmes peptidiques rencontrent le même mur dans l’autre sens. Une campagne générative de peptides rapportée 86 de 100 les peptides conçus étaient actifs, mais sa génération était limitée à des séquences sous 50 résidus, et 1 de 20 les peptides de référence n'ont pas pu être synthétisés du tout (ApexGO, Intelligence des machines naturelles, 2026). UN 100% le taux de réussite de la synthèse sur une référence de 20 peptides n'est pas la même affirmation que 86% activité sur 100 peptides, et aucun des deux nombres n'est transféré à un 40-mer hydrophobe.
Comment la faisabilité de la synthèse devient un élément du classement des candidats
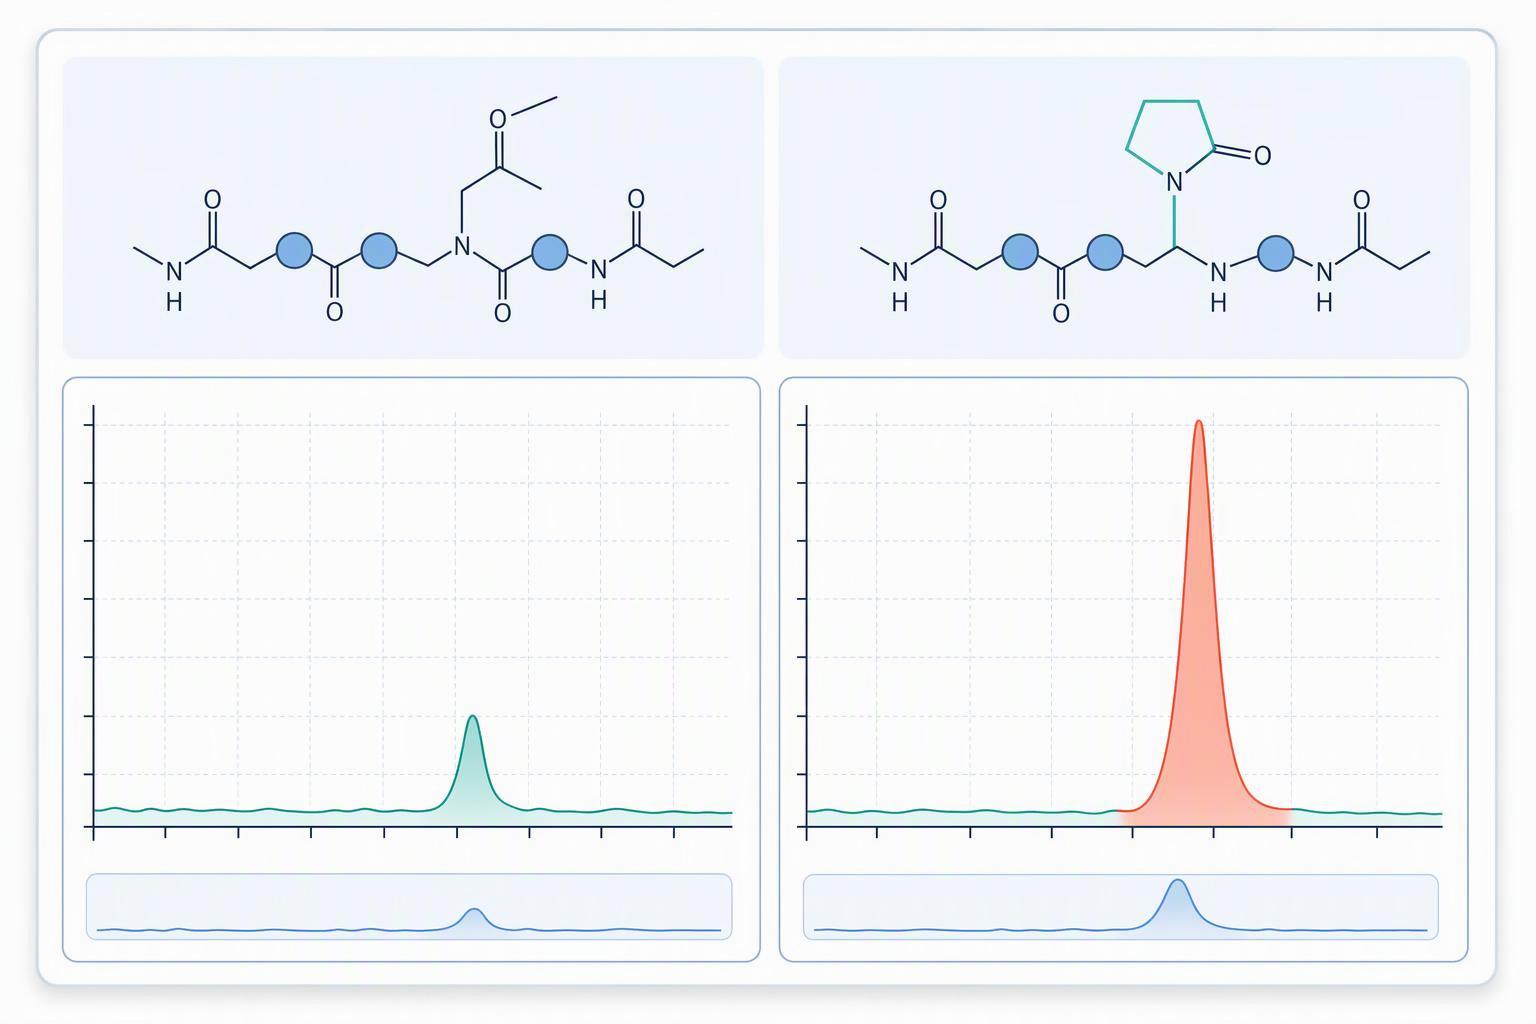
La faisabilité appartient à la fonction de notation, pas dans la file d'attente après. Un modèle classé uniquement en fonction de l'activité prévue continuera à traiter les séquences de laboratoire que le laboratoire ne peut pas réaliser., et chaque couplage échoué coûte un cycle que la campagne ne peut pas récupérer. Le coût est mesurable. UN 2026 Chimie naturelle étude de 539 Les séquences ont montré que la substitution par la pseudoproline améliorait la pureté brute de 23% à 69% pour un fragment de hGH et de 17% à 75% pour un fragment GB1, avec des séquences d'agrégation signalées par l'élargissement du pic de déprotection au-dessus 20% par rapport au premier accouplement (Tamas et al., Chimie naturelle, 2026).
Le même travail montre quoi marquer. Composition de résidus favorisant l'agrégation, pas la séquence exacte, transportait la majeure partie du signal prédictif: Être(t-Ceci), Avec, Val et Thr(t-Ceci) a augmenté la probabilité la plus, Gln(Trt) et Leu a largement contribué, les motifs Gly – Ser et Leu – Leu étaient importants, et l'agrégation est généralement définie dans 5 à 15 résidus de l'ancre en résine.
Pour un pourboire: Cinq entrées de faisabilité à ajouter à la fonction de classement: composition sujette à l'agrégation, drapeaux à motifs, longueur par rapport à la plage validée du synthétiseur, complexité des modifications, et risque d’épuration. Une séquence qui obtient de bons résultats en termes d'activité et de mauvais résultats sur les cinq est un élément de file d'attente., pas un candidat.
Une question d’intégration reste ouverte. L'optimiseur ApexGO décrit dans les travaux du MIT ne semble pas modéliser la propension à l'agrégation, donc un flux de travail de la conception à la synthèse nécessite toujours l'ajout de cette couche entre la sortie du modèle et la file d'attente de synthèse.
Ce que signifie « validé » pour un peptide nommé par l’IA
Valider chaque méthode pour son attribut prévu. La pureté HPLC et un résultat d’identité MS répondent à des questions complémentaires, mais le simple fait de les associer ne prouve pas la confirmation orthogonale de chaque caractéristique structurelle ni ne valide la puissance et le contenu quantitatifs..
|
Attribut |
Question à laquelle il répond |
Méthode principale |
Partenaire orthogonal |
Standard |
Omission commune du CoA |
|---|---|---|---|---|---|
|
Identité |
Est-ce la séquence Fournisseur de peptides synthétiques ordonné? |
LC-MS |
Analyse des acides aminés ou séquençage MS/MS |
Je Q6B |
Messe rapportée sans interprétation |
|
Pureté |
Quelle quantité de peptide cible est présente? |
PR- Peptides purs HPLC |
HPLC sur une chimie différente |
Je Q2(R2) |
Pourcentage de superficie uniquement, aucun détail sur la méthode |
|
Puissance |
Est-ce qu'il fonctionne dans le test? |
Test fonctionnel |
Essai biologique orthogonal |
Je Q6B Source de peptides |
Non signalé pour les lots de recherche |
|
Contenu |
Quelle quantité de peptide contient le flacon? |
Test quantitatif |
Bilan de masse |
Je Q6B |
Teneur nette en peptides absente |
|
Endotoxine |
Le matériau est-il sans danger pour le système d'analyse? |
Test LAL |
Contrôles d’adéquation des méthodes |
USP <85> |
Limite non indiquée |
Pour les analyses cellulaires, justifier le contrôle des endotoxines à partir de la sensibilité du test, concentration et interférence. Les limites parentérales K/M ne sont pas des critères de test cellulaire par défaut. Endotoxine, les micro-organismes et les particules viables ont des attributs différents et nécessitent des contrôles appropriés, le cas échéant.
Qu'est-ce qui rend le matériel peptidique prêt pour l'analyse, et comment exclure les artefacts
Un matériau peptidique prêt pour le test est un matériau dont le comportement dans le test a été séparé de la propre interférence du test.. Le contre-écran d'agrégation standard existe parce que les peptides s'agrègent à des concentrations micromolaires faibles à moyennes., former des particules 100 à 500 nm à travers cette protéine de liaison dans la gamme picomolaire et sont invisibles à l'œil (Auld, Anglais & Dahlin, Manuel d'orientation des tests, 2017).
Sélectionnez l'agrégation, dommages à la membrane, Contrôles d'adsorption et de véhicule pour le test proprement dit. Les concentrations publiées dans la littérature ou les plages de réponse LDH ne constituent pas des limites d'acceptation universelles., et le détergent peut lui-même modifier le mécanisme d’un peptide membranaire actif.
Quelle gouvernance sépare la promesse informatique des performances validées
La gouvernance sépare les deux en gardant séparément les résultats du modèle et les résultats mesurés., enregistrements versionnés, et en refusant de laisser l'un remplacer l'autre. La partie 11 Le langage de piste d'audit définit un enregistrement électronique comme toute combinaison de texte, graphique, données, audio, représentation picturale ou autre information créée, modifié, entretenu, archivé, récupéré ou distribué par un système informatique, et soumet les systèmes informatiques et leur documentation à l'inspection de la FDA (21 Partie CFR 11, eCFR).
Cela régit les dossiers, pas de validité du modèle. Rien dans le règlement ne dit qu'un modèle génératif est qualifié parce que ses sorties sont enregistrées. La campagne sur les enzymes montre pourquoi la distinction est importante: la propre déclaration du rapport selon laquelle la fonction est inconnue se trouve à côté de dix réexécutions qui n'ont jamais refait surface le tableau lors de la découverte.
|
Réclamer |
Statut |
Qu'est-ce qui le ferait avancer |
|---|---|---|
|
36 millions de composés générés |
Démontré, évalué par les pairs |
Rien de plus |
|
6 de 22 Composés de SARM actifs in vitro Fabricant de tests peptidiques |
Démontré, évalué par les pairs |
Réplication indépendante |
|
Efficacité du NG1 dans un modèle murin |
Démontré chez les animaux uniquement |
Aucune allégation clinique autorisée |
|
Fonction du système ART |
Hypothèse, non évalué par les pairs |
Caractérisation expérimentale |
|
Le classement des modèles prédit le succès de la synthèse |
Non établi |
Données de synthèse prospectives |
Ce qu'un programme peptidique devrait changer maintenant
Changez d'abord la fonction de classement, puis le package analytique, puis les enregistrements. Concrètement: ajouter une notation de faisabilité avant la liste restreinte, nécessiter une méthode d'identité orthogonale sur chaque lot, exécuter des contre-écrans d'agrégation avant de croire les actifs principaux, et conserver les sorties du modèle et les résultats mesurés dans des enregistrements versionnés séparés avec une piste d'audit.
Où la synthèse est la contrainte, la conversation avec le fournisseur compte plus que le modèle. Notre équipe chez MOL Changes effectue la synthèse Fmoc en phase solide avec des données HPLC en phase inverse et de spectrométrie de masse fournies avec chaque commande de peptides personnalisés., couvre le terminal N, Modifications du C-terminal et de la chaîne latérale, y compris la cyclisation, ponts disulfure, acides aminés non naturels et incorporation d'isotopes stables, et échelles de milligrammes à kilogrammes par lyophilisation. Les installations utilisent une double isolation, Filtration HEPA et espace à pression positive, avec contrôle de pureté en cours de processus, contenu, endotoxine, pH et stérilité sous régime d’auto-inspection.
|
Fenêtre |
Action |
|---|---|
|
30 jours |
Ajoutez les cinq entrées de faisabilité à la fonction de classement; auditer les trois derniers CoA pour détecter les données d'identité ou de contenu manquantes |
|
60 jours |
Associez chaque méthode de pureté à une méthode d’identité orthogonale; ajouter un contre-écran d'agrégation au protocole d'analyse standard |
|
90 jours |
Séparez les enregistrements de sortie du modèle des enregistrements de résultats mesurés avec gestion des versions et piste d'audit; rédiger le registre de l'état des réclamations pour chaque programme actif |
Foire aux questions
Est-ce que le 86% Le taux de réussite des peptides prouve que la conception de peptides d’IA surpasse les campagnes de petites molécules?
Non. Le 86 de 100 les peptides conçus étaient actifs contre au moins un des 11 agents pathogènes, tandis que le Cellule papiers 27.3% est une activité parmi 22 petites molécules synthétisées. Différents dénominateurs, espace chimique différent, différents points de départ.
Pourquoi tant de candidats générés par l'IA échouent-ils en synthèse?
Parce que la génération n'est pas contrainte par les voies de synthèse. Le Cellule les auteurs rapportent que seulement 2 de 27 les composés tentés dans une piste étaient synthétisables, et ce fragment a dû être tronqué car aucun de ses cinq principaux composés n'était accessible dans les délais et les coûts habituels..
La découverte de l'enzyme est-elle évaluée par des pairs?
Non. Le rapport technique n'a pas été examiné par des pairs, qualifie le système d’hypothèse, et déclare que les résultats attendent une caractérisation expérimentale.
Les normes ICH et USP s'appliquent-elles aux peptides de qualité recherche?
Je Q2(R2) et Q6B régissent la validation analytique et l’établissement des spécifications pour les médicaments. Pour le matériel de qualité recherche, utilisez-les comme référence en matière de qualité de méthode: identité orthogonale, spécificité démontrée, et les limites d'endotoxines indiquées vous indiquent toujours si le CoA signifie quelque chose.
Comment la priorisation de la faisabilité de la synthèse peptidique devrait-elle modifier une fonction de classement?
Composition sujette à l'agrégation des scores, drapeaux à motifs, longueur par rapport à la plage de synthèse validée, complexité de la modification et risque de purification parallèlement à l'activité prévue, et traiter une activité élevée, séquence à haut risque en tant qu'élément de file d'attente plutôt que candidat.
Conclusion
La campagne antibiotique du MIT et la recherche enzymatique montrent qu'une boucle de conception vers les données peut parcourir d'énormes espaces et renvoyer des hypothèses prioritaires; ils ne montrent pas qu'un composé ou un peptide est un médicament. Le Cellule le travail s'arrête sur les modèles d'infection de souris, la campagne peptidique s’arrête aux CMI in vitro, et le système enzymatique reste une hypothèse en attente d'expériences. Pour les flux de travail de recherche sur les antibiotiques et les peptides conçus par l’IA, les maillons faibles sont la faisabilité de la synthèse, validation orthogonale et gouvernance des enregistrements, et chacun d'eux est un problème d'ingénierie qu'un programme peut résoudre ce trimestre.
Le changement que nous nous attendons à voir dans ce domaine est triple: conception tenant compte de la faisabilité qui classe les candidats selon s'ils peuvent être retenus, des analyses orthogonales par défaut qui supposent qu'une seule méthode peut induire en erreur, et revendiquer des étiquettes qui voyagent avec les données afin qu'un résultat de modèle de souris ne soit jamais lu comme un résultat clinique. Les programmes qui adoptent les trois convertiront les listes de candidats IA en matériel peptidique prêt à être analysé plus rapidement que les programmes qui traitent la validation comme une formalité en aval..
Une première étape pratique consiste à amener une séquence difficile et son analyse prévue dans une conversation technique.. Demandez ce que le dossier analytique devrait contenir avant de signer le CoA., et demandez un exemple de CoA et un package analytique afin que la réponse soit un document plutôt qu'une promesse. Rien ici n'est un conseil clinique ou réglementaire; les décisions concernant la progression des candidats appartiennent à vos propres évaluateurs scientifiques et médicaux.
Divulgation de l'éditeur: MOL Changes fournit des services peptidiques et a un intérêt commercial dans ce sujet. Les gammes de services et les déclarations de capacités sont des réclamations des fournisseurs; la disponibilité et les performances pour une construction spécifique nécessitent des preuves spécifiques au projet.