快速解答
现在,模型会为您提供计算运行价格的候选列表. 昂贵的部分在那之后开始: 决定哪些序列值得合成, 哪个 …
麻省理工学院的抗生素运动和酶搜索实际证明了什么
多肽供应商工厂 肽科技 这两个活动展示了大规模的搜索和优先级, 未经验证的候选药物. 这 细胞 工作结合了基于片段和从头生成模型并推动 36 百万个预测化合物通过过滤器 24 合成分子, 其中七种具有抗菌作用 (克里希南等人。, 细胞, 2025). 淋病追踪漏斗显示了成本: 6,937,677 生成的分子, 678 过滤后剩下的, 80 优先合成, 27 尝试过, 并且只有 2 的 27 尝试的化合物是可合成的.
MRSA 赛道运行 29,014,974 生成的分子 90 入围, 22 采购的, 和 6 活跃于 64 微克/毫升, 作者将其报告为 MRSA 轨迹 27.3% 真实发现率. 先导化合物具有生物学意义: NG1 结合 LptA, 现有抗生素不针对的外膜构建蛋白, 和它的 0.5 μg/mL MIC 针对 氮. 淋病 在小鼠阴道模型中,CFU 减少了大约 3 个对数. 两种病原体都位于 2024 世界卫生组织列为高度优先事项的优先事项清单.
酶的故事是另一种证据. 该报告的特工已康复 198,290 逆转录酶簇, 得分 3,564 候选伙伴蛋白家族, 并晋升 17 人类可读的报告. 该报告本身带有“ART (假设)” 标签并指出研究结果有待实验表征. 独立报告指出,该报告尚未经过同行评审,并且相同的逆转录酶出现在 2021 巨型噬菌体纸 (有线, 2026).
为什么数以千万计的候选化合物会崩溃到几十种合成化合物
所引用的活动表明合成和实验测试可能会限制特定的发现工作. 他们没有证明预测是充分的,也没有证明合成是每个肽计划的主要瓶颈. 评估两者.
肽程序从另一个方向遇到同一堵墙. 据报道,一项生成肽活动 86 的 100 设计的肽具有活性, 但它的生成被限制在以下序列 50 残留物, 和 1 的 20 基准肽根本无法合成 (顶点GO, 自然机器智能, 2026). 一个 100% 20 肽基准的合成成功率与以下说法不同: 86% 活动于 100 肽, 并且两个数字都不会转移到疏水性 40 聚体.
综合可行性如何成为候选排名的输入
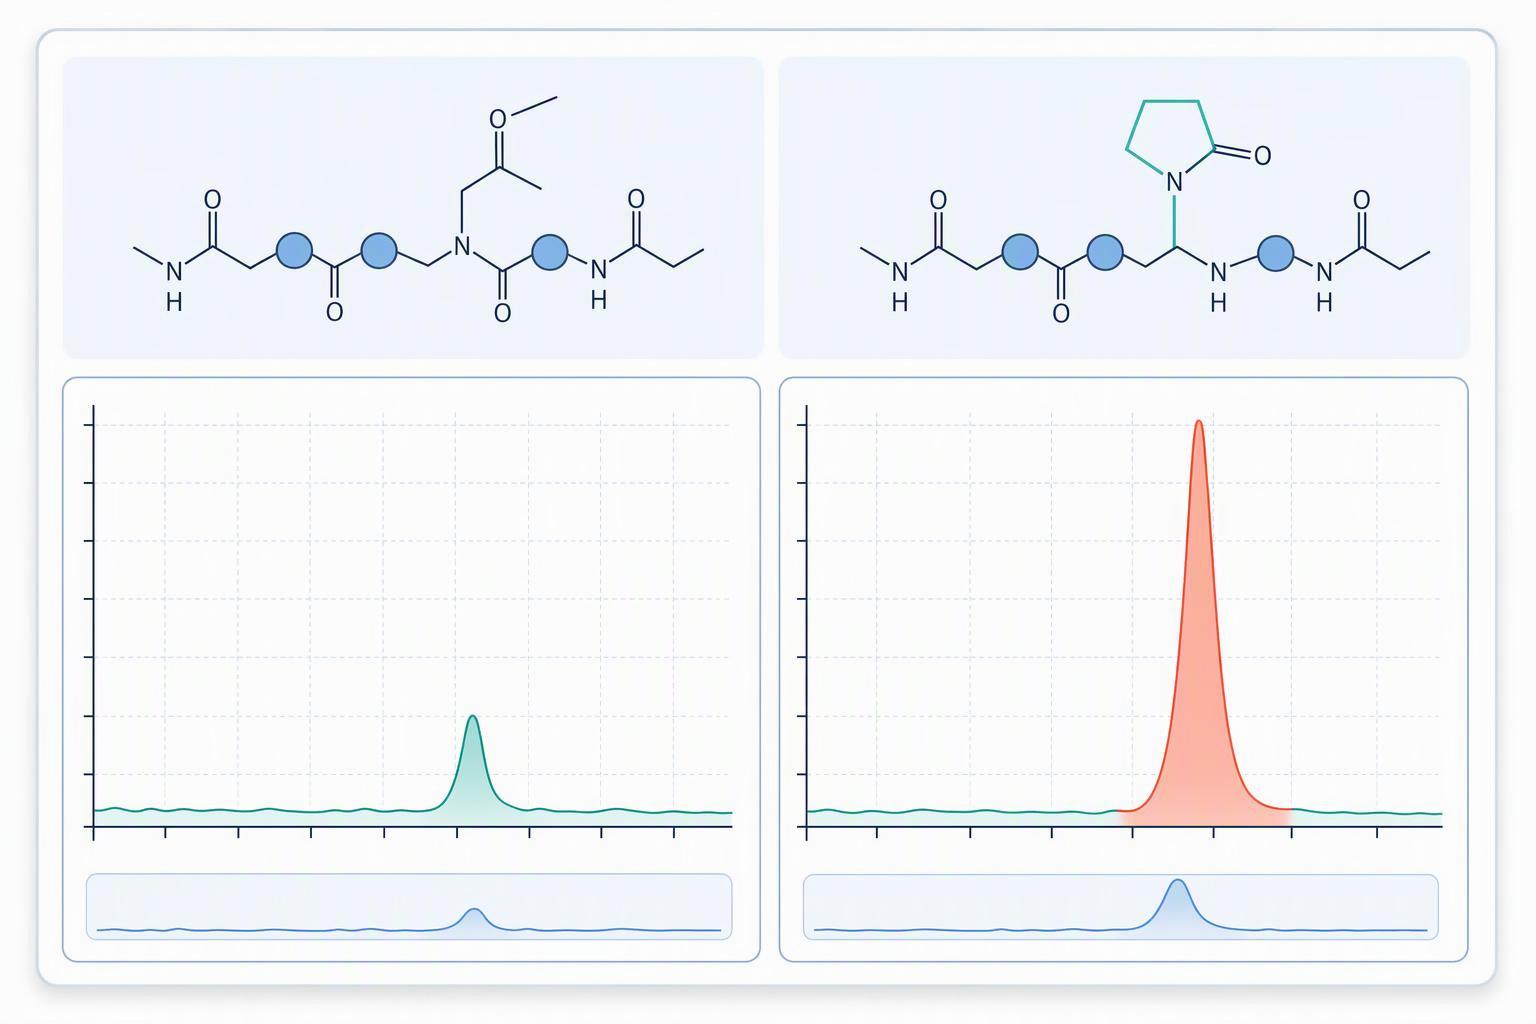
可行性属于评分函数, 不在队列中. 仅按预测活动排名的模型将继续处理实验室无法制作的实验室序列, 每一次失败的耦合都会花费一个周期,该活动无法收回. 成本是可衡量的. 一个 2026 自然化学 研究 539 序列发现,伪脯氨酸取代提高了粗纯度 23% 到 69% 对于 hGH 片段和来自 17% 到 75% 对于 GB1 片段, 具有通过上面的脱保护峰加宽标记的聚集序列 20% 相对于第一个耦合 (塔马斯等人。, 自然化学, 2026).
同样的工作显示了得分. 促进聚集的残留物组合物, 不是确切的顺序, 携带大部分预测信号: 成为(t-这个), 和, 缬氨酸和苏氨酸(t-这个) 可能性最大, 谷氨酰胺(特鲁特) 和 Leu 做出了巨大贡献, Gly-Ser 和 Leu-Leu 基序很重要, 和聚合通常设置在 5 到 15 树脂锚栓的残留物.
对于小费: 添加到排名功能的五个可行性输入: 易于聚集的成分, 主题旗帜, 长度与合成器的验证范围, 修改复杂度, 和净化风险. 在活动上得分良好但在所有五项上得分都很差的序列是队列项目, 不是候选人.
一个整合问题仍然悬而未决. MIT 工作中描述的 ApexGO 优化器似乎并未对聚合倾向进行建模, 因此,设计到综合工作流程仍然需要在模型输出和综合队列之间添加该层.
对于 AI 提名的肽而言,“经过验证”意味着什么
验证每个方法的预期属性. HPLC 纯度和 MS 鉴定结果回答了互补的问题, 但仅仅将它们配对并不能证明每个结构特征的正交确认或验证定量效力和内容.
|
属性 |
提问它回答 |
主要方法 |
正交伙伴 |
标准 |
常见 CoA 省略 |
|---|---|---|---|---|---|
|
身份 |
这是顺序吗 合成肽供应商 已订购? |
液质联用 |
氨基酸分析或 MS/MS 测序 |
我Q6B |
未经解释的大规模报告 |
|
纯度 |
存在多少目标肽? |
RP- 纯肽 高效液相色谱法 |
不同化学物质的 HPLC |
我Q2(R2) |
仅面积百分比, 没有方法细节 |
|
效力 |
它在测定中表现吗? |
功能测定 |
正交生物测定法 |
我Q6B 肽源 |
未报告研究批次 |
|
内容 |
小瓶中有多少肽? |
定量分析 |
质量平衡 |
我Q6B |
不存在净肽含量 |
|
内毒素 |
该材料对于检测系统是否安全? |
鲎试剂测试 |
方法适用性控制 |
美国药典 <85> |
未注明限制 |
用于基于细胞的检测, 从检测灵敏度证明内毒素控制的合理性, 浓度和干扰. 肠外 K/M 限值不是默认的细胞测定标准. 内毒素, 活微生物和颗粒具有不同的属性,需要适当的控制(如果相关).
是什么让肽材料分析做好准备, 以及如何排除伪影
待测肽材料是指其在测定中的行为已与测定本身的干扰分开的材料. 标准聚集反筛选的存在是因为肽在低至中微摩尔浓度下聚集, 形成颗粒 100 到 500 纳米跨度,结合皮摩尔范围内的蛋白质,肉眼看不见 (奥尔德, 英语 & 达林, 检测指导手册, 2017).
选择聚合, 膜损伤, 实际测定的吸附和载体控制. 文献浓度或 LDH 响应范围并非普遍接受的限度, 去污剂本身可能会改变膜活性肽的机制.
什么治理将计算承诺与经过验证的性能分开
治理通过将模型的输出和测量结果分开来将两者分开, 版本记录, 并拒绝让一个人代替另一个人. 部分 11 审计跟踪语言将电子记录定义为文本的任意组合, 图形, 数据, 声音的, 创建的图形或其他信息表示, 修改的, 维持, 已归档, 由计算机系统检索或分发, 并使计算机系统及其文档接受 FDA 检查 (21 CFR部分 11, 病死率).
管理记录, 不是模型有效性. 法规中没有任何内容表明生成模型是合格的,因为它的输出被记录. 酶运动展示了为什么这种区别很重要: 该报告自己的声明(该函数未知)位于十次重新运行的旁边,这些重新运行从未将数组作为发现重新出现.
|
宣称 |
地位 |
什么会推动它前进 |
|---|---|---|
|
36 生成百万种化合物 |
展示了, 同行评审 |
没有更多了 |
|
6 的 22 MRSA 化合物具有体外活性 多肽测试生产商 |
展示了, 同行评审 |
独立复制 |
|
NG1 在小鼠模型中的功效 |
仅在动物身上得到证实 |
不允许临床索赔 |
|
ART系统功能 |
假设, 未经同行评审 |
实验表征 |
|
模型排名预测合成成功 |
未成立 |
预期综合数据 |
肽计划现在应该改变什么
先改变排名功能, 然后是分析包, 然后记录. 具体来说: 在入围名单之前添加可行性评分, 要求每个批次都采用正交恒等法, 在相信主要活动之前运行聚合计数器, 并将模型输出和测量结果保存在单独的版本记录中,并进行审计跟踪.
综合是制约因素, 供应商对话比模型更重要. 我们 MOL Changes 的团队使用每个定制肽订单提供的反相 HPLC 和质谱数据进行 Fmoc 固相合成, 覆盖N端, C 末端和侧链修饰,包括环化, 二硫桥, 非天然氨基酸和稳定同位素掺入, 通过冻干从毫克到公斤. 设施采用双重隔离, HEPA过滤和正压空间, 进行过程中的纯度测试, 内容, 内毒素, 自检制度下的 pH 值和无菌度.
|
窗户 |
行动 |
|---|---|
|
30 天 |
将五个可行性输入添加到排名函数中; 审核最后三个 CoA 是否缺少身份或内容数据 |
|
60 天 |
将每种纯度方法与正交恒等法配对; 将聚合计数器添加到标准检测方案中 |
|
90 天 |
通过版本控制和审计跟踪将模型输出记录与测量结果记录分开; 为每个活动程序写入声明状态寄存器 |
常见问题解答
是否 86% 肽命中率证明人工智能肽设计胜过小分子活动?
不. 这 86 的 100 设计的肽对至少一种具有活性 11 病原体, 而 细胞 文件 27.3% 是其中的活动 22 合成小分子. 不同的分母, 不同的化学空间, 不同的起点.
为什么这么多人工智能生成的候选者在合成时失败?
因为生成不受合成路线的限制. 这 细胞 作者报告说,只有 2 的 27 一条轨道中尝试的化合物是可合成的, 并且该片段必须被截断,因为其前五种化合物均无法在典型的时间范围和成本内获得.
酶发现是否经过同行评审?
不. 技术报告未经同行评审, 将系统标记为假设, 并指出研究结果有待实验表征.
ICH 和 USP 标准是否适用于研究级肽?
我Q2(R2) 和 Q6B 管理医药产品的分析验证和规格设定. 用于研究级材料, 使用它们作为方法质量基准: 正交恒等式, 表现出的特异性, 并且规定的内毒素限值仍然可以告诉您 CoA 是否意味着什么.
肽合成可行性优先级应如何改变排序函数?
分数容易聚集的成分, 主题旗帜, 长度与验证的合成范围, 修饰复杂性和纯化风险以及预测的活性, 并治疗高活动量, 高风险序列作为队列项而不是候选序列.
结论
麻省理工学院的抗生素运动和酶搜索表明,从设计到数据的循环可以搜索巨大的空间并返回优先假设; 他们没有表明任何化合物或肽是药物. 这 细胞 工作停留在小鼠感染模型上, 肽活动在体外 MIC 停止, 酶系统仍然是一个等待实验的假设. 适用于人工智能设计的抗生素和肽研究工作流程, 薄弱环节是综合可行性, 正交验证和记录治理, 这些都是一个工程问题,一个程序可以在本季度解决.
我们期望在整个领域看到三重转变: 可行性感知设计,根据候选人是否可以进行排名, 默认正交分析假设任何单一方法都可能产生误导, 并声称标签随数据一起移动,因此小鼠模型结果永远不会被解读为临床结果. 采用这三种方法的程序将比将验证视为下游手续的程序更快地将人工智能候选列表转换为可用于分析的肽材料.
实际的第一步是将一个困难的序列及其预期的分析带入技术对话中. 在签署 CoA 之前询问分析包需要包含哪些内容, 并索取 CoA 样本和分析包,这样答案就是一份文件而不是承诺. 这里没有任何临床或监管建议; 关于候选人进展的决定属于您自己的科学和医学评审员.
出版商披露: MOL Changes 提供肽服务并对此主题具有商业利益. 服务范围和能力声明是供应商的声明; 特定构造的可用性和性能需要项目特定的证据.