Šta tokovi rada podataka o peptidima za otkrivanje AI lijekova zapravo zahtijevaju
Tokovi rada podataka o peptidima za otkrivanje AI lijekova su evidencija, analitički, i prakse upravljanja koje peptidni skup podataka čine mašinom upotrebljivim pomoću prediktivnog modela. Pokrivaju pet oblasti: zapisi o sekvenci i modifikacijama, kontekst analize, podaci o nečistoći, istorija serije, i standardizovane analitičke rezultate. Ono što ih razlikuje od generičkog savjeta o spremnosti podataka je da svaki zahtjev leži na nivou pojedinačnog polja zapisa, i svaki od njih mora preživjeti i pregled povjerljivosti i dokumentovani protokol validacije.
Traka na nivou rekorda je dio koji većina timova potcjenjuje. Referentni tretman notacije strukture peptida smatra da cjevovodi za strojno učenje najbolje funkcioniraju iz kemijske reprezentacije bez gubitaka kao primarnog zapisa, sa kodiranjima specifičnim za model koji su izvedeni iz njega, a ne pohranjeni kao izvor istine (Obilježavanje peptidnih struktura korištenjem SMILES-a i drugih kemijskih kodova, 2017). U tom pristupu, InChIKey djeluje kao ključ identiteta i deduplikacije, dok ciklizacija i umrežavanje moraju biti napisani kao eksplicitni objekti veze umjesto lijevo implicitno.
Regulatori se kreću u istom smjeru. Januar FDA 2025 nacrt smjernica o AI u regulatornom odlučivanju uvodi procjenu kredibiliteta zasnovanu na riziku vezanu za definirani kontekst upotrebe (FDA nacrt smjernica, sadržaj aktuelan 2025-01-06). To je nacrt, nije za implementaciju, ali signalizira da će se skupovi peptidnih podataka spremnih za umjetnu inteligenciju procjenjivati na osnovu sljedivosti, a ne volumena.
Key Takeaway: Tri stvari razlikuju ove tokove rada od običnog čišćenja podataka: zahtjevi za evidenciju na nivou terena, mehanika povjerljivosti koja omogućava partnerima da dijele bez otkrivanja potencijalnog klijenta, i protokol operativne validacije, a ne navedeni princip.
Dvije zablude izazivaju većinu konfuzije. "Čisti podaci" ne znači "kurirani podaci", uredna tabela i dalje može biti neupotrebljiva za model. A jedan broj čistoće ne opisuje peptid; Podaci o nečistoći i istoriji serije nose informacije iz kojih model zapravo može naučiti. Ovaj dio se oslanja na recenziranu literaturu o strukturnim notacijama i trenutne regulatorne smjernice, bez izvora dobavljača.
Zašto su tokovi podataka o peptidima za otkrivanje AI lijekova sada važni
Radni tok podataka o peptidima za otkrivanje AI lijekova je važan jer se novac sada kreće prije podataka. U 2026 AI alat za praćenje dogovora koji je objavio VLS Research, objelodanjene unaprijed skupne vrijednosti od 30 do 50 miliona dolara u odnosu na vrijednost naslova iznad 1 milijarde dolara, otprilike 2–3% vrijednosti naslova plaćeno u gotovini (VLS Research, AI Tracker za otkrivanje droga 2026, preuzeto 2026-07-03). Isomorphic Labs – Eli Lilly pokazuje oko 45 miliona dolara unaprijed u odnosu na preko 1,7 milijardi dolara u prekretnicama; Noetik–GSK pokazuje 50 miliona dolara unaprijed na petogodišnju strukturu licenciranja. Obratite pažnju na izvor: jedan analiticki tragac, sa interesom dobavljača za narativ dogovora sa umjetnom inteligencijom.
Klinički zapis je protivteža. Okolo 90% molekula koji ulaze u kliniku nikada ne dobiju odobrenje, i 50–60% neuspjeha faze II vodi do nedostatka efikasnosti, brojke koje su se jedva pomjerile u dvije decenije (Mao Z & Yan L, Granice u farmakologiji, preuzeto 2026-07-03). Isto 2024 sistematski pregled 20 Programi vođeni umjetnom inteligencijom iz 2018 to 2023 utvrđeno je da je optimizacija potencijalnih potencijalnih klijenata uz pomoć umjetne inteligencije smanjila vrijeme provjere kandidata u prosjeku za 30–50%., dok je gubitak u fazi I/II ostao uporediv s referentnim vrijednostima u industriji.
Taj jaz je poenta. Partneri sada mogu potpisati model, ali model ne može učiti iz zapisa koji nikada nisu uhvatili peptid.
Ovo utiče na R&D vodi, analitička hemija, podaci i IT, i menadžeri saveza koji nasljeđuju pitanja marljivosti nakon potpisivanja.
Pet stubova podataka skupova peptidnih podataka spremnih za umjetnu inteligenciju
Skupovi peptidnih podataka spremnih za umjetnu inteligenciju izgrađeni su od pet stubova rekordnog nivoa, i zajedno čine kontrolnu listu spremnosti koju tim može postići prije potpisivanja ugovora o partnerstvu. Svaki stub ispod je napisan na isti način: zašto je to važno, kako to implementirati, i kako izgleda neuspjeh kada nedostaje. Naredba je namjerna. Identitet je na prvom mjestu jer svako polje nizvodno, od konteksta analize do profila nečistoća, nasljeđuje greške dvosmislenog zapisa strukture. Model obučen na pogrešno specificiranom nizu ne pokvari glasno; uči pogrešnu molekulu i daje pouzdana predviđanja o tome.
Pošteno ocenite svaki stub. Tim koji može da rekonstruiše svaki peptid iz sopstvenih zapisa, priložiti uslove analize svakom rezultatu, i pratiti svaku partiju do sertifikata analize je spreman da preda podatke partneru. Tim koji ne može nije blokiran u partnerstvu, ali treba očekivati da će se prvi mjeseci saradnje potrošiti na popravku podataka, a ne na obuku modela.
Pilule 1: Zapisi o nedvosmislenom redoslijedu i modifikacijama
Slijed peptida i zapisi o modifikacijama su važni jer model ne može naučiti od peptida koji ne može rekonstruirati, a greške identiteta se tiho šire kroz svako nizvodno predviđanje. Popravak je hemijski prikaz bez gubitaka kao primarni zapis, sa kodiranjima specifičnim za model koji su izvedeni iz njega, a ne pohranjeni kao izvor istine.
Implementacija slijedi mali skup konvencija. HELM rukuje strukturama svjesnim polimera, uključujući grane i neprirodne monomere, dok SMILES služi modelima grafova na nivou atoma. InChI i InChIKey djeluju kao ključevi za deduplikaciju i identitet u svim sistemima. Ciklizacija i umrežavanje pripadaju eksplicitnim objektima povezivanja, nikada kao implicitna pretpostavka da "ciklizirano" svuda znači isto. Referentni tretman notacije strukture peptida pokriva ostalo: višeslovne šifre za ne-proteinske ili neprirodne ostatke, napomena malim slovima za D-amino kiseline, i napomena modifikacije na nivou ostataka u MAP formatu (Journal of Cheminformatics / PMC).
Režim kvara je tih i skup. Program bilježi laktamski most i disulfid kao "ciklizirane" u istom polju, tako da model tretira dvije hemijski različite skele kao jednu. Svako predviđanje izgrađeno na toj koloni je kontaminirano, i ništa u cevovodu to ne označava.
Zapis koji se može koristiti modelom za modifikovani makrociklički peptid nosi polje postavljeno ispod. MOL Changes podržava ovaj pristup strukturi prvi u svom radu sa podacima o peptidima, a primjer se može replicirati sa bilo kojim kompatibilnim sistemom zapisa.
|
Polje |
Model-upotrebljiv zapis |
Tipičan zapis slobodnog teksta |
|---|---|---|
|
Primarno zastupanje |
HELM niz s eksplicitnim objektima povezivanja |
Slijed zalijepljen u polje za bilješke |
|
Kodiranje na nivou atoma |
SMILES izvedeni iz HELM zapisa |
Odsutan |
|
Peptide Synthesis Ključ identiteta |
InChIKey za deduplikaciju |
Odsutan |
|
Neprirodno Synthetic Peptides ostaci |
Višeslovni kodovi, definisano u tabeli monomera |
Jednoslovne aproksimacije |
|
Stereohemija |
Oznaka D-amino kiselina malim slovima |
Nije snimljeno |
|
Modifikacije |
MAP napomena na nivou ostatka |
Napomena u slobodnom tekstu, npr. "ciklizirano" |
|
Tip ciklizacije |
Eksplicitni objekt mosta sa pozicijama |
Dvosmisleno |
|
Usluge Unakrsne veze |
Eksplicitni objekt veze |
Odsutan ili impliciran |
Pilule 2: Kontekst analize koji putuje s rezultatom
Afinitet vezivanja bez njegovih uslova analize nije oznaka za obuku, to je broj. Kontekst analize mora da putuje sa rezultatom: tip testa, ciljni konstrukt i vrste, format čitanja, i da li je vrijednost izmjerena ili predviđena.
Razlika između izmjerenog i predviđenog je mjesto gdje se većina skupova podataka tiho prekida. A 2025 sistematski pregled prediktora epitopa otkrio je da samo 174 of 777 (22%) kompjuterski predviđeni peptidi koji se vezuju za HLA u jednoj studiji SARS-CoV-2 potvrđeno je da se stabilno vezuju in vitro (npj Vaccines, 2025-08-30). Ta brojka je obuhvaćena jednom studijom, nije opšta stopa tačnosti za AI u imunologiji, ali pokazuje zašto predviđena vrijednost i izmjerena vrijednost ne mogu dijeliti kolonu bez zastavice koja ih razdvaja.
⚠️ Upozorenje: Pooling SPR, polarizacija fluorescencije i vrijednosti bazirane na ćelijama u jednu kolonu afiniteta obučava model na testu, a ne na hemiji. Model uči koja je laboratorija generirala broj, ne za koji se peptid vezuje.
Pilule 3: Profili nečistoća, Nijedan broj čistoće
Podaci o nečistoći peptida i historiji serije pripadaju zapisu kao profil, nije postotak naslova. Dvije parcele prijavljene na 98% pure može drugačije da se ponaša u testu, a modelu je potreban omotač nečistoće i stanje protiv jona da vidi zašto.
Efekti kontraiona su dobro dokumentovani. U a 2025 recenzija, peptid M33 kao TFA so pokazao je 5-30% veću citotoksičnost prema normalnim epitelnim ćelijama bronhija nego acetatni pandan, i MOG peptid formulisan sa TFA je bio povezan sa početkom encefalomijelitisa 5 dana ranije sa uporedivom učestalošću i težinom (Biomolekule, 2025-11-07). Odvojeni pregled je otkrio da je hlorid najmanje efikasan od testiranih aniona u indukciji spiralne strukture u LL-37 (Pharmaceuticals / Molekule, 2020-12-03). Ovo su zapažanja zavisna od formulacije, nije potpuna izjava da bilo koji kontrajon nije bezbedan.
Implementacija znači pohranjivanje vremena zadržavanja nečistoća, relativne površine i stanje protujonske izmjene uz brojku čistoće. Za nivoe validacije, I Q2(R2) postavlja opseg validacije, a ne granice čistoće peptida: ispitivanje nečistoće mora pokriti prag izvještavanja do 120% ograničenja specifikacije, a čistoća po procentu površine je potvrđena iz 80% od nižeg do 100% gornje granice specifikacije (I Q2(R2), konačna smjernica 2023-11-30).
Pilule 4: Istorija serije i sertifikati analize vezani za lotove
Povjerenje modela je svojstvo sljedivosti, zbog čega brojevi partija, Veza sertifikata analize i istorija ponovnog testiranja pripadaju skupu podataka, a ne samo sistemu upravljanja kvalitetom. Očekivanja ALCOA+ koja AI/ML cjevovodi sada moraju zadovoljiti su već postojeći GMP standard proširen na novi slučaj upotrebe, nije novo pravilo izmišljeno za modele. Linija podataka označena je kao kritična briga jer se AI/ML integriše sa MES i LIMS, a digitalna nit je definirana kao neprekinuti lanac odnosa podataka od testiranja sirovog materijala preko proizvodnje do izdavanja konačnog proizvoda (Regulatorne perspektive za implementaciju AI/ML, PMC, 2025-06-16).
Za savjet: Sačuvajte historiju ponovnog testiranja i ponovnog testiranja umjesto da prepisujete Shop to. Zamijenjena vrijednost sa vremenskom oznakom je dokaz; zamijenjena vrijednost je jaz.
Način neuspjeha je kampanja koja se dvostruko računa. Tri testa koja se izvode na istoj seriji unose se kao tri nezavisna opažanja, a model tretira jednu seriju kao tri, naduvavanje poverenja u rezultat koji se nikada nije ponovio.
Pilule 5: Standardizovani analitički rezultati i mašinski čitljivi formati
Standardizirani analitički rezultati za peptidnu AI zavise od formata koje cevovod može analizirati bez ručnog čišćenja. Mašinski čitljivi standardi već postoje za analitički sloj: mzML za sirove podatke masene spektrometrije, mzIdentML i mzTab za identifikaciju i kvantifikaciju, PX-XML za podnošenje metapodataka, SDRF-Proteomika za odnose uzorka i izloženosti, i USI za stabilne identifikatore spektra (Proteomska podatkovna infrastruktura).
Reproducibilnost također zahtijeva cijeli blok metoda. Parametri HPLC metode uključuju hemiju kolone (tipično C18), veličina čestica i pora, dimenzije stuba, mobilne faze i modifikatori, program gradijenta, protok (okolo 1.0 mL/min analitičko), temperatura kolone, talasna dužina detekcije (tipično 214-220 nm za peptide) i količinu injekcije. Identitet se mora potvrditi LC-MS ili MALDI-TOF netaknute mase sa uočenom masom u odnosu na teorijsku masu i navedenim ppm ili Da prihvatljivim prozorom, ne samo HPLC (Phenomenex HPLC centar znanja, 2026-07-29).
Način kvara je zapis koji kaže "standardni RP-HPLC gradijent". Bez bloka metoda, rezultat ne može poslužiti kao sidro za validaciju, a partner ga ne može reprodukovati.
Povjerljivost: Dijeljenje podataka o peptidima bez curenja elektroda
Rizik povjerljivosti u AI peptidnim partnerstvima je mjerljiv, nije teorijski. A 2025 Studija neuronskih mreža za otkrivanje lijekova otkrila je da je u scenariju crne kutije gdje su izloženi samo izlazni logiti, kao što je model koji se nudi kao web usluga, Napadi zaključivanja o članstvu su identifikovali koje su hemijske strukture bile u setu za obuku, a kombinovanje nekoliko napada povećalo je rizik (Objavljivanje neuronskih mreža u otkrivanju lijekova može ugroziti povjerljivost, 2025-03-26). Autori napominju da su molekuli iz manjinskih klasa, često najvredniji u otkrivanju lijekova, su posebno ranjivi, i da jedinstvene strukture koje se razlikuju od uspostavljenih bibliotečkih spojeva mogu odgovarati vlasničkim vodovima ili novim skelama u razvoju.
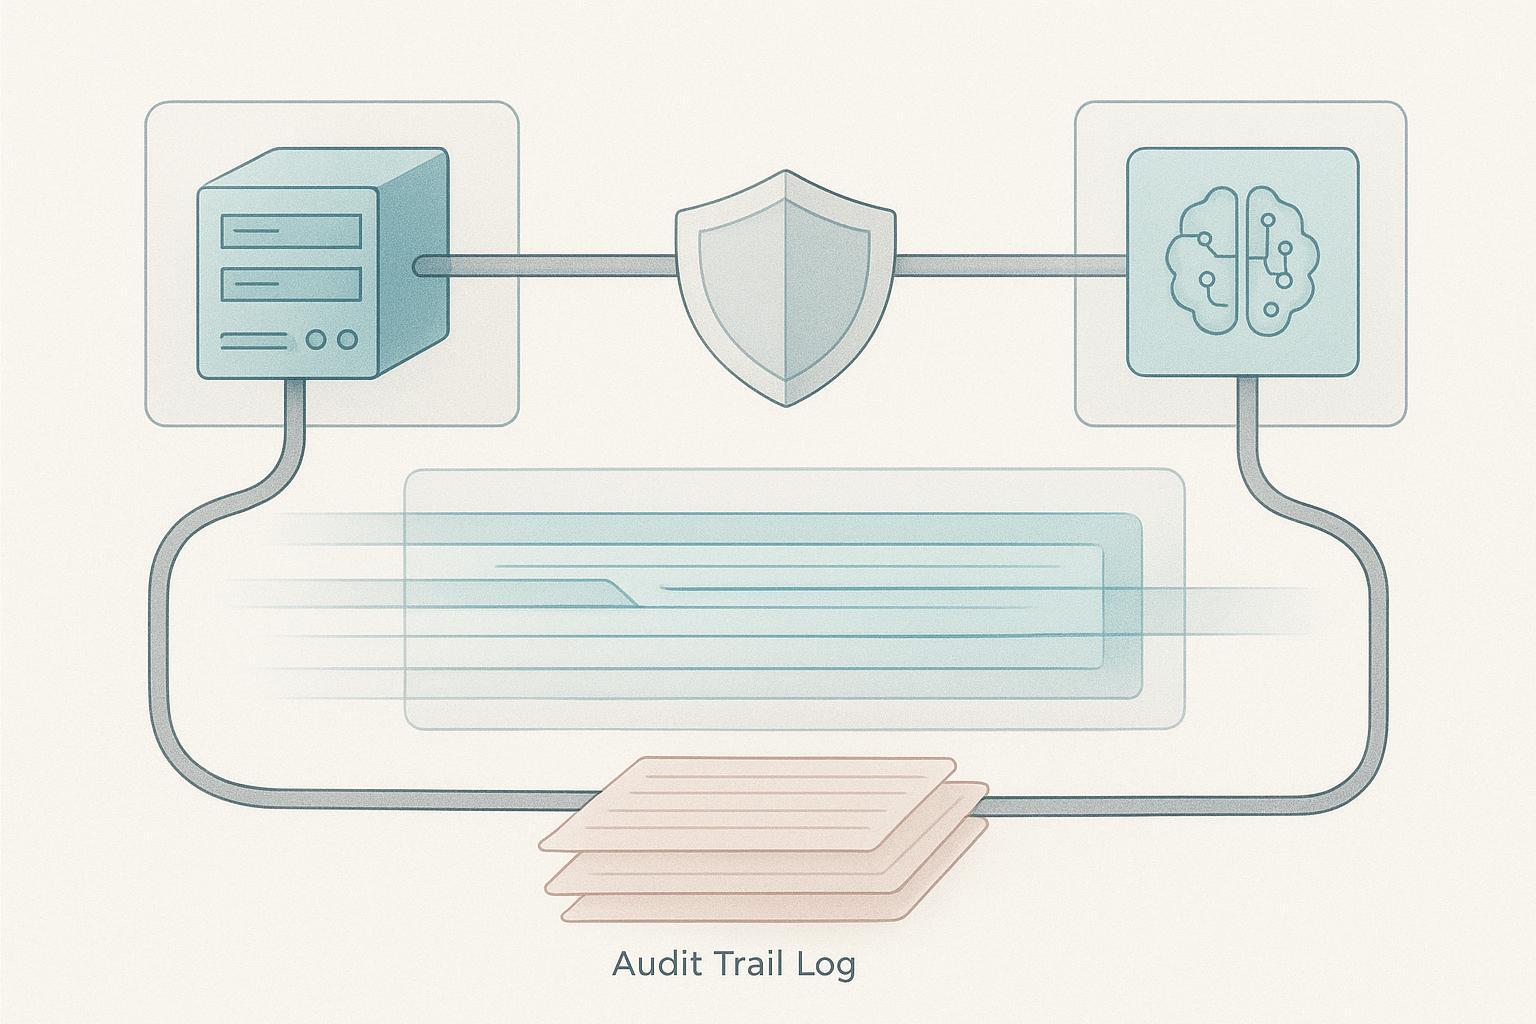
Operativni odgovor je višeslojni model pristupa nego jedna odluka o dijeljenju podataka. Sponzori čuvaju sirovu evidenciju u kući; partner prima deidentifikovane ili heširane reprezentacije kada to dozvoljava zadatak modeliranja; samo agregatni rezultati napuštaju saradnju. Ugovorna ograničenja onoga što partner može zadržati, plus revizijski trag za svaki upit u odnosu na zajednički skup, zatvorite petlju.
Key Takeaway: De-identifikacija smanjuje rizik od curenja, ali ga ne eliminiše za strukturno prepoznatljive peptide, pa revizija slojeva i upita imaju težinu koju samo maskiranje ne može.
Scientific Validation: Operativni protokol, Nije princip
Validacija nije princip sa kojim se slažete. To je sekvenca koju pokrećete: prvo ortogonalna potvrda, zatim nezavisna replikacija, zatim usaglašavanje svake vrednosti okrenute prema modelu nazad sa sirovim analitičkim podacima iz kojih dolazi. Preskakanje trećeg koraka je najčešći neuspjeh, jer usaglašeni broj i neusaglašeni broj izgledaju identično u tabeli za obuku.
Definirajte ortogonalni par po vrsti zahtjeva prije nego što bilo šta generišete. Za identitet, upariti netaknutu masu sa sekundom, mehanički različita metoda, a ne ponovljena injekcija na istom instrumentu. Za aktivnost, upariti očitavanje biofizičkog vezivanja sa funkcionalnim očitanjem baziranim na ćelijama, jer njih dvoje odgovaraju na različita pitanja.
Replikacija mora koristiti neovisno sintetizirani lot, ne ponavljanje istog materijala. Izvođenje istog testa dvaput na istoj seriji mjeri preciznost instrumenta, ne generalizacija. A 2025 sistematski pregled metoda predviđanja epitopa otkrio je da mnogi trenutni pristupi pate od preopterećenja njihovim skupovima podataka za obuku, što drastično ograničava koliko dobro se prenose na nove ciljeve (npj Vaccines, 2025-08-30). Isti pregled primjećuje da nisu sva veziva imunogena: prvorangirani epitop može vezati antitijela in vitro, ali ne može izazvati željeni odgovor in vivo, a tačnost na benčmarku se ne prenosi prilikom očitavanja, ćelijska linija, ili se ciljni kontekst razlikuje.
To je način kvara protiv kojeg treba dizajnirati. Set za validaciju koji je izvučen iz iste kampanje kao i set za obuku mjeri pamćenje, ne generalizacija.
Benchmark Gap: Ono što standardizacija još uvijek ne može popraviti
Standardizacija je neophodna, ali nije dovoljna. Merila na polju su nova i uska, i nijedna kartica rezultata još ne može mjeriti ono što tvrdi da mjeri.
PepBenchmark, standardizovani peptid-ML benchmark objavljen u aprilu 2026 i predstavljen na ICLR-u 2026, pokriva 29 canonical-peptide plus 6 nekanonski peptidni skupovi podataka preko 7 grupe, sa objedinjenim cevovodom za prethodnu obradu i tablom lidera koja obuhvata četiri porodice metoda: Otisak prsta, GNN, PLM, i OSMESI. Njegovi autori jasno navode da je prethodni rad bio „sprečen nepostojanjem standardizovanih merila“ i da je pretrpeo „probleme kvaliteta uobičajene u ad hoc kanalima“. To je pravi napredak, a takođe je i uska: 35 skupovi podataka, jedan reper, jedno izdanje.
Iskrene granice su važnije za planiranje nego naslov. Nijedna anketa ne daje jedan odbranjiv postotak FAIR usvajanja za biofarmu R&D, i nijedna studija ne broji udio dokumenata o otkrivanju lijekova s umjetnom inteligencijom s defektima curenja ili reproduktivnosti. Stoga je svaka tablica spremnosti pomoćno prosuđivanje, nije mjerenje.
⚠️ Upozorenje: Tretirajte rezultat spremnosti kao strukturirani pokretač razgovora, nije validirana metrika. Ako partner pita u čemu se mjeri vaš rezultat, tačan odgovor danas je „naši sopstveni kriterijumi,” nije objavljeni standard.
Stiže vanjski okvir, ipak. Januar FDA 2025 nacrt smjernica o AI u regulatornom odlučivanju predlaže procjenu kredibiliteta zasnovanu na riziku vezanu za navedeni kontekst upotrebe. To je nacrt, nije za implementaciju, i upravlja podnošenjem, a ne otkrivanjem. Čak i tako, ukazuje na pitanje na koje bi trebalo izraditi program spremnosti da odgovori: čemu služi ovaj model, i koji dokazi čine njegove rezultate vjerodostojnim za tu upotrebu?
Getting Started: 30-dnevna propusnica za spremnost podataka o peptidima
Radni tokovi podataka o peptidima za otkrivanje AI lijekova najbrže se testiraju povlačenjem dvadeset zapisa o peptidima nasumično i bodovanjem svakog prema pet stubova. To je odluka od pet minuta, i obično rješava pitanje da li je program spreman za partnerstvo. Većina timova smatra da je nekoliko zapisa čistih, veća grupa je djelimično kompletna, a neke se uopšte ne mogu rekonstruisati.
Za svako polje koje ne uspije, odlučiti da li je jaz problem hvatanja ili problem povezivanja. Problem hvatanja znači da podaci nikada nisu snimljeni, tako da je popravka promjena onoga što tim prikuplja na klupi. Problem povezivanja znači da podaci postoje negdje, ali nisu spojeni s puno, metoda, ili očitavanje testa, tako da je popravka identifikator i spoj, nije novi eksperiment. Njih dvoje imaju različite vlasnike i različite vremenske rokove, a tretiranje problema veze kao problema hvatanja gubi mjesece.
Zatim prođite jedan peptid kroz cijeli lanac od kraja do kraja: ličnu kartu, lot-linked sertifikat analize, mašinski čitljiva analitička datoteka. Dokumentirajte svaku tačku gdje je čovjek morao intervenirati ručno. Ta interventna lista je pravi obim projekta pripravnosti.
Uobičajeno oklijevanje je da to zahtijeva zamjenu platforme. U većini slučajeva nije. To zahtijeva disciplinu na nivou terena u zapisima koje tim već proizvodi.
Sledeći korak: Pokrenite prolaz za bodovanje od dvadeset rekorda i donesite listu intervencija na pregled tehničkih podataka o spremnosti, gdje se praznine mapiraju na betonske popravke.
Često postavljana pitanja
Ono što peptidnu sekvencu i zapis o modifikacijama čini nedvosmislenim?
Nedvosmislen zapis navodi tačnu hemijsku strukturu, nije stenografija koju čitalac mora da tumači. Referentni tretman notacije strukture peptida tretira hemijsku reprezentaciju bez gubitaka kao primarni zapis, sa HELM-om koji se koristi za strukture svjesne polimera i SMILES za modele grafova na nivou atoma, InChI ili InChIKey kao ključevi za deduplikaciju i identitet, ciklizacija i unakrsne veze napisane kao eksplicitni objekti povezivanja, i ne-prirodni ostaci napisani u višeslovnim kodovima s malim slovima za D-amino kiseline. Bilješka modifikacije na nivou ostatka, kako ga koristi MAP, održava laktamski most koji se razlikuje od disulfida. Zapis koji kaže "modificirani peptid" bez tog detalja izgleda čisto, ali nije spreman za umjetnu inteligenciju.
Da li je HELM ili SMILES bolji primarni rekord?
Ni jedno ni drugo nije univerzalno bolje; izbor slijedi model koji će konzumirati ploču. HELM čuva topologiju na nivou polimera i čisto rukuje neprirodnim monomerima i objektima povezivanja, koji odgovara radu sa svjestan niza i makrociklusima. SMILES daje graf na nivou atoma koji većina grafova neuronskih mreža i heminformatičkih alata čita direktno. Programi koji trebaju i pohraniti jedan kao primarni zapis i generirati drugi, sa InChIKey kao spojnim ključem, tako da se isti molekul nikada ne broji dvaput.
Koliko je kontekst analize dovoljan?
Dovoljno da druga laboratorija može ponoviti mjerenje i protumačiti broj. U najmanju ruku: tip testa i očitavanje, cilj i konstrukcija, ćelijska linija ili matriks, raspon koncentracije, uslovi inkubacije, metoda detekcije, i jedinice. A 2025 Sistematski pregled prediktora epitopa otkrio je da epitop s najvišim rangom može vezati antitijela in vitro, ali biti slabo imunogen in vivo, i ta tačnost se ne prenosi prilikom očitavanja, ćelijska linija ili ciljni kontekst se razlikuju. Obvezujuća vrijednost bez konteksta ne može se udružiti ni sa čim.
Da li je jedan broj čistoće ikada prihvatljiv?
Samo kao naslov, nikad kao rekord. I Q2(R2)Zahtjevi za raspon validacije postavljaju izvješćivanje o nečistoći od praga do 120% ograničenja specifikacije, i postotak površine čistoće od 80% to 100% ograničenja specifikacije, sa ograničenjima detekcije i kvantifikacije oko odnosa signal-šum od otprilike 3:1 i 10:1. Podaci o nečistoćama peptida i historiji serije koji sadrže samo "98% čistoće" skrivaju koje nečistoće, na kom nivou, kojom metodom. Zadrži broj, zatim pričvrstite profil iza njega. Proizvodnja peptida O
Kako dijelimo strukture s partnerom bez izlaganja glavne serije?
Podijelite model ili izvedene karakteristike umjesto sirovog skupa za obuku, i testirajte šta izlaz otkriva. Napadi zaključivanja o članstvu koji oporavljaju molekule za obuku iz serviranog modela identificiraju trening molekule samo iz izlaznih logita, a molekuli manjinske klase i nove skele su najranjiviji, sa kombinovanim napadima koji dodatno povećavaju rizik. Ako partneru trebaju sami podaci, koristite kontrolisano okruženje sa dogovorenim skupom funkcija i revizorskim tragom, a ne prenosom fajla.
Može li se model validirati bez nezavisnog lota?
br. Model koji je validiran samo na partijama već je vidio izvještaje o memorisanju, ne generalizacija. Zaustavite najmanje jedan lot po programu, idealno iz druge kampanje sinteze, i čuvajte je netaknutu do konačne procjene. Ako ne postoji nezavisna partija, Iskrena izjava je da je model interno konzistentan, nije potvrđeno.
Da li se nacrt smjernica FDA primjenjuje na rad u fazi otkrića?
Ne direktno, ali to je najjasnija dostupna izjava standarda kojeg ćete se na kraju držati. Januar FDA 2025 nacrt smjernica o AI u regulatornom odlučivanju predlaže procjenu kredibiliteta zasnovanu na riziku vezanu za navedeni kontekst upotrebe. To je nacrt datiran 6 januara 2025 i nije za implementaciju. Discovery timovi koji sada dokumentiraju kontekst upotrebe neće morati kasnije da ga rekonstruišu.
Key Takeaway: Tvrdnja o spremnosti se može braniti samo kada imenuje polja zapisa, arhitektura dijeljenja i protokol validacije, ne kada prijavljuje broj čistoće.
Zaključak
Spremnost je svojstvo zapisa, ne od modela, a to je radni tok podataka o testnim peptidima za otkrivanje AI lijekova koji se sada suočavaju u svakom partnerskom razgovoru. Pet stubova, nedvosmislen niz i modifikacija notacije, kontekst analize koji putuje s rezultatom, profili nečistoća, a ne jedan broj čistoće, lot-linked certifikati analize, i mašinski čitljiv standardizovani analitički izlaz, su kontrolna lista. Arhitektura povjerljivosti i pisani protokol validacije su ono što vam omogućava da podijelite taj zapis bez predaje glavnog.
Referentni i regulatorni okviri se još uvijek formiraju: PepBenchmark 2026 je rano, i FDA nacrt smjernica još nije napisan za implementaciju. Sada izgrađeni program spremnosti odgovara na pitanje koje će partneri formalnije postaviti kasnije, tako da ga napravite da bude ponovo bodovan, a ne jednom sertifikovan. Ovaj vodič je pomoć pri prosuđivanju, nije mjerenje. Ne postoji odbrambeni postotak FAIR usvajanja na cijelom polju ili broj nedostataka curenja, tako da kartica rezultata ovdje podržava odluku, a ne rješavanje.
MOL Changes objavljuje kao dobavljač peptida.
Saznajte gdje bi vaši peptidni zapisi pokvarili partnerov model. Tehnički pregled spremnosti podataka mapira vaše peptidne zapise u odnosu na pet stubova i klasifikuje svaki jaz kao problem hvatanja ili problem povezivanja. Zatražite pregled spremnosti podataka sa našim analitičkim timom.