एआई ड्रग डिस्कवरी के लिए वास्तव में पेप्टाइड डेटा वर्कफ़्लो की क्या आवश्यकता है
एआई दवा खोज के लिए पेप्टाइड डेटा वर्कफ़्लो रिकॉर्ड-कीपिंग हैं, विश्लेषणात्मक, और शासन प्रथाएं जो एक पूर्वानुमानित मॉडल द्वारा पेप्टाइड डेटासेट मशीन को प्रयोग करने योग्य बनाती हैं. वे पाँच क्षेत्रों को कवर करते हैं: अनुक्रम और संशोधन रिकॉर्ड, परख संदर्भ, अशुद्धता डेटा, बैच इतिहास, और मानकीकृत विश्लेषणात्मक परिणाम. जो चीज़ उन्हें सामान्य डेटा-तत्परता सलाह से अलग करती है वह यह है कि प्रत्येक आवश्यकता एक व्यक्तिगत रिकॉर्ड फ़ील्ड के स्तर पर होती है, और प्रत्येक को गोपनीयता समीक्षा और दस्तावेज़ सत्यापन प्रोटोकॉल दोनों से बचना होगा.
रिकॉर्ड-स्तरीय बार वह हिस्सा है जिसे अधिकांश टीमें कम आंकती हैं. पेप्टाइड संरचना संकेतन का संदर्भ उपचार यह मानता है कि मशीन लर्निंग पाइपलाइन प्राथमिक रिकॉर्ड के रूप में दोषरहित रासायनिक प्रतिनिधित्व से सबसे अच्छा काम करती है, सत्य के स्रोत के रूप में संग्रहित करने के बजाय इससे प्राप्त मॉडल-विशिष्ट एन्कोडिंग के साथ (स्माइल्स और अन्य रासायनिक कोड का उपयोग करके पेप्टाइड संरचनाओं का एनोटेशन, 2017). उस दृष्टिकोण में, InChIKey एक पहचान और डिडुप्लीकेशन कुंजी के रूप में कार्य करता है, जबकि चक्रीकरण और क्रॉसलिंक्स को अंतर्निहित बाएं के बजाय स्पष्ट कनेक्शन ऑब्जेक्ट के रूप में लिखा जाना चाहिए.
नियामक उसी दिशा में आगे बढ़ रहे हैं. एफडीए का जनवरी 2025 विनियामक निर्णय लेने में एआई पर मसौदा मार्गदर्शन उपयोग के एक परिभाषित संदर्भ से जुड़ा जोखिम-आधारित विश्वसनीयता मूल्यांकन पेश करता है (एफडीए मसौदा मार्गदर्शन, सामग्री वर्तमान 2025-01-06). यह एक मसौदा है, कार्यान्वयन के लिए नहीं, लेकिन यह संकेत देता है कि एआई-तैयार पेप्टाइड डेटासेट को वॉल्यूम के बजाय ट्रैसेबिलिटी पर आंका जाएगा.
कुंजी ले जाएं: तीन चीज़ें इन वर्कफ़्लोज़ को सामान्य डेटा क्लीनअप से अलग करती हैं: फ़ील्ड-स्तरीय रिकॉर्ड आवश्यकताएँ, गोपनीयता तंत्र जो साझेदारों को बिना किसी सुराग को उजागर किए साझा करने देता है, और एक बताए गए सिद्धांत के बजाय एक परिचालन सत्यापन प्रोटोकॉल.
दो ग़लतफ़हमियाँ सबसे अधिक भ्रम का कारण बनती हैं. "स्वच्छ डेटा" का अर्थ "क्यूरेटेड डेटा" नहीं है, एक सुव्यवस्थित स्प्रेडशीट अभी भी एक मॉडल के लिए अनुपयोगी हो सकती है. और एक भी शुद्धता संख्या पेप्टाइड का वर्णन नहीं करती है; अशुद्धता और बैच इतिहास डेटा में वह जानकारी होती है जिससे एक मॉडल वास्तव में सीख सकता है. यह अनुभाग सहकर्मी-समीक्षित संरचना-नोटेशन साहित्य और वर्तमान नियामक मार्गदर्शन पर आधारित है, बिना किसी विक्रेता स्रोत के.
एआई ड्रग डिस्कवरी के लिए पेप्टाइड डेटा वर्कफ़्लो अब क्यों मायने रखता है
एआई दवा खोज के लिए पेप्टाइड डेटा वर्कफ़्लो मायने रखता है क्योंकि पैसा अब डेटा से पहले चलता है. में 2026 वीएलएस रिसर्च द्वारा प्रकाशित एआई डील ट्रैकर, $1B से ऊपर के हेडलाइन मूल्यों के मुकाबले $30-50M पर अपफ्रंट क्लस्टर का खुलासा किया गया, हेडलाइन मूल्य का लगभग 2-3% नकद के रूप में भुगतान किया जाता है (वीएलएस रिसर्च, एआई ड्रग डिस्कवरी डील ट्रैकर 2026, पुनर्प्राप्त 2026-07-03). आइसोमोर्फिक लैब्स-एली लिली ने मील के पत्थर में $1.7B से अधिक के मुकाबले लगभग $45M का अग्रिम प्रदर्शन किया है; नोएटिक-जीएसके पांच साल की लाइसेंसिंग संरचना पर $50 मिलियन अग्रिम दिखाता है. स्रोत नोट करें: एक विश्लेषक ट्रैकर, एआई डील कथा में विक्रेता की रुचि के साथ.
क्लिनिकल रिकॉर्ड इसका प्रतिकार है. आस-पास 90% क्लिनिक में प्रवेश करने वाले अणु कभी भी अनुमोदन तक नहीं पहुँच पाते, और चरण II की 50-60% विफलताएँ प्रभावकारिता की कमी का पता लगाती हैं, आंकड़े जो दो दशकों में बमुश्किल बढ़े हैं (माओ ज़ेड & यान एल, फार्माकोलॉजी में फ्रंटियर्स, पुनर्प्राप्त 2026-07-03). जो उसी 2024 की व्यवस्थित समीक्षा 20 एआई-संचालित कार्यक्रम 2018 को 2023 पाया गया कि एआई-असिस्टेड लीड ऑप्टिमाइज़ेशन ने उम्मीदवारों की स्क्रीनिंग के समय में औसतन 30-50% की कटौती की है, जबकि चरण I/II का क्षरण उद्योग के बेंचमार्क के बराबर रहा.
वह अंतर ही मुख्य बात है. भागीदार अब एक मॉडल पर हस्ताक्षर कर सकते हैं, लेकिन एक मॉडल उन रिकॉर्ड्स से नहीं सीख सकता, जिन्होंने कभी पेप्टाइड पर कब्जा नहीं किया.
इसका असर आर पर पड़ता है&डी नेतृत्व करता है, विश्लेषणात्मक रसायनशास्त्र, डेटा और आईटी, और गठबंधन प्रबंधक जिन्हें परिश्रम विरासत में मिलता है, हस्ताक्षर के बाद प्रश्न पूछते हैं.
एआई-रेडी पेप्टाइड डेटासेट के पांच डेटा स्तंभ
एआई-तैयार पेप्टाइड डेटासेट पांच रिकॉर्ड-स्तरीय स्तंभों से बनाए गए हैं, और साथ में वे तत्परता चेकलिस्ट बनाते हैं, एक टीम साझेदारी समझौते पर हस्ताक्षर करने से पहले खुद को स्कोर कर सकती है. नीचे प्रत्येक स्तंभ पर इसी प्रकार लिखा हुआ है: यह क्यों मायने रखती है, इसे कैसे क्रियान्वित किया जाए, और जब यह गायब हो तो विफलता कैसी दिखती है. आदेश जानबूझकर दिया गया है. पहचान सबसे पहले आती है क्योंकि हर डाउनस्ट्रीम क्षेत्र, परख संदर्भ से लेकर अशुद्धता प्रोफ़ाइल तक, एक अस्पष्ट संरचना रिकॉर्ड की त्रुटियाँ विरासत में मिलती हैं. गलत-निर्दिष्ट अनुक्रम पर प्रशिक्षित एक मॉडल ज़ोर से विफल नहीं होता है; यह गलत अणु को सीखता है और उसके बारे में विश्वसनीय भविष्यवाणियां करता है.
प्रत्येक स्तंभ को ईमानदारी से स्कोर करें. एक टीम जो अपने स्वयं के रिकॉर्ड से प्रत्येक पेप्टाइड का पुनर्निर्माण कर सकती है, प्रत्येक परिणाम के साथ परख की शर्तें संलग्न करें, और विश्लेषण के प्रमाण पत्र के लिए हर लॉट का पता लगाएं, एक भागीदार को डेटा सौंपने के लिए तैयार है. जो टीम ऐसा नहीं कर सकती उसे साझेदारी करने से नहीं रोका गया है, लेकिन यह उम्मीद की जानी चाहिए कि सहयोग के पहले महीनों को मॉडल प्रशिक्षण के बजाय डेटा सुधार पर खर्च किया जाएगा.
गोलियाँ 1: सुस्पष्ट अनुक्रम और संशोधन रिकॉर्ड
पेप्टाइड अनुक्रम और संशोधन रिकॉर्ड मायने रखते हैं क्योंकि एक मॉडल उस पेप्टाइड से नहीं सीख सकता है जिसका वह पुनर्निर्माण नहीं कर सकता है, और पहचान संबंधी त्रुटियां प्रत्येक डाउनस्ट्रीम भविष्यवाणी के माध्यम से चुपचाप फैलती हैं. फिक्स प्राथमिक रिकॉर्ड के रूप में एक दोषरहित रासायनिक प्रतिनिधित्व है, सत्य के स्रोत के रूप में संग्रहित करने के बजाय इससे प्राप्त मॉडल-विशिष्ट एन्कोडिंग के साथ.
कार्यान्वयन सम्मेलनों के एक छोटे समूह का पालन करता है. HELM पॉलिमर-जागरूक संरचनाओं को संभालता है, शाखाओं और गैर-प्राकृतिक मोनोमर्स सहित, जबकि SMILES परमाणु-स्तरीय ग्राफ़ मॉडल पेश करता है. InChI और InChIKey पूरे सिस्टम में डिडुप्लीकेशन और पहचान कुंजी के रूप में कार्य करते हैं. साइक्लाइज़ेशन और क्रॉसलिंक स्पष्ट कनेक्शन ऑब्जेक्ट से संबंधित हैं, कभी भी एक अंतर्निहित धारणा के रूप में नहीं कि "चक्रीय" का अर्थ हर जगह एक ही है. पेप्टाइड संरचना संकेतन का संदर्भ उपचार बाकी को कवर करता है: गैर-प्रोटीन या गैर-प्राकृतिक अवशेषों के लिए बहु-अक्षर कोड, डी-अमीनो एसिड के लिए लोअर-केस एनोटेशन, और एमएपी प्रारूप में अवशेष-स्तरीय संशोधन एनोटेशन (जर्नल ऑफ केमिनफॉर्मेटिक्स / पीएमसी).
विफलता मोड शांत और महंगा है. एक प्रोग्राम एक ही क्षेत्र में लैक्टम ब्रिज और डाइसल्फ़ाइड को "साइक्लाइज्ड" के रूप में रिकॉर्ड करता है, इसलिए मॉडल दो रासायनिक रूप से भिन्न मचानों को एक मानता है. उस कॉलम पर बनी प्रत्येक भविष्यवाणी दूषित है, और पाइपलाइन में कुछ भी इसे चिह्नित नहीं करता है.
संशोधित मैक्रोसाइक्लिक पेप्टाइड के लिए एक मॉडल-प्रयोग योग्य रिकॉर्ड नीचे दिए गए फ़ील्ड सेट को वहन करता है. एमओएल चेंजेस अपने पेप्टाइड डेटा कार्य में इस संरचना-प्रथम दृष्टिकोण का समर्थन करता है, और यह उदाहरण किसी भी अनुरूप रिकॉर्ड प्रणाली के साथ दोहराया जा सकता है.
|
मैदान |
मॉडल-प्रयोग योग्य रिकॉर्ड |
विशिष्ट मुक्त-पाठ रिकॉर्ड |
|---|---|---|
|
प्राथमिक प्रतिनिधित्व |
स्पष्ट कनेक्शन ऑब्जेक्ट के साथ हेल्म स्ट्रिंग |
अनुक्रम को नोट्स फ़ील्ड में चिपकाया गया |
|
परमाणु-स्तरीय एन्कोडिंग |
HELM रिकॉर्ड से प्राप्त मुस्कान |
अनुपस्थित |
|
पेप्टाइड संश्लेषण पहचान कुंजी |
डिडुप्लीकेशन के लिए InChIKey |
अनुपस्थित |
|
गैर प्राकृतिक सिंथेटिक पेप्टाइड्स अवशेष |
बहु-अक्षर कोड, एक मोनोमर तालिका में परिभाषित |
एकल-अक्षर सन्निकटन |
|
त्रिविम |
लोअर-केस डी-अमीनो एसिड एनोटेशन |
रिकार्ड नहीं किया गया |
|
संशोधनों |
अवशेष-स्तरीय एमएपी एनोटेशन |
मुफ़्त-पाठ नोट, उदाहरण के लिए:. "चक्रीय" |
|
चक्रीकरण प्रकार |
पदों के साथ स्पष्ट पुल वस्तु |
अस्पष्ट |
|
सेवाएं क्रॉसलिंक्स |
स्पष्ट कनेक्शन वस्तु |
अनुपस्थित या निहित |
गोलियाँ 2: परख संदर्भ जो परिणाम के साथ यात्रा करता है
इसकी परख शर्तों के बिना एक बाध्यकारी संबंध एक प्रशिक्षण लेबल नहीं है, यह एक संख्या है. परख संदर्भ को परिणाम के साथ यात्रा करनी होगी: परख प्रकार, लक्ष्य निर्माण और प्रजाति, रीडआउट प्रारूप, और क्या मूल्य मापा गया था या भविष्यवाणी की गई थी.
मापा-बनाम-पूर्वानुमानित अंतर वह है जहां अधिकांश डेटासेट चुपचाप टूट जाते हैं. ए 2025 एपिटोप भविष्यवक्ताओं की व्यवस्थित समीक्षा में केवल यही पाया गया 174 का 777 (22%) एक SARS-CoV-2 अध्ययन में कम्प्यूटेशनल रूप से अनुमानित HLA-बाइंडिंग पेप्टाइड्स की इन विट्रो में स्थिर रूप से बंधने की पुष्टि की गई थी (एनपीजे टीके, 2025-08-30). यह आंकड़ा एकल अध्ययन तक सीमित है, इम्यूनोलॉजी में एआई के लिए सामान्य सटीकता दर नहीं, लेकिन यह दिखाता है कि क्यों एक अनुमानित मूल्य और एक मापा मूल्य एक कॉलम को ध्वज से अलग किए बिना साझा नहीं कर सकता है.
⚠️ चेतावनी: पूलिंग एसपीआर, प्रतिदीप्ति ध्रुवीकरण और कोशिका-आधारित मान एक आत्मीयता स्तंभ में रसायन शास्त्र के बजाय परख पर मॉडल को प्रशिक्षित करते हैं. मॉडल सीखता है कि किस प्रयोगशाला ने संख्या उत्पन्न की है, वह नहीं जो पेप्टाइड बांधता है.
गोलियाँ 3: अशुद्धता प्रोफाइल, एक भी शुद्धता संख्या नहीं
पेप्टाइड अशुद्धता और बैच इतिहास डेटा एक प्रोफ़ाइल के रूप में रिकॉर्ड में मौजूद है, शीर्षक प्रतिशत नहीं. दो लॉट की सूचना दी गई 98% शुद्ध एक परख में अलग तरह से व्यवहार कर सकता है, और मॉडल को यह देखने के लिए अशुद्धता आवरण और काउंटरियन स्थिति की आवश्यकता है कि क्यों.
प्रतिवाद प्रभाव अच्छी तरह से प्रलेखित हैं. में एक 2025 समीक्षा, टीएफए नमक के रूप में एम33 पेप्टाइड ने एसीटेट समकक्ष की तुलना में सामान्य ब्रोन्कियल उपकला कोशिकाओं के प्रति 5-30% अधिक साइटोटॉक्सिसिटी दिखाई।, और टीएफए के साथ तैयार किया गया एमओजी पेप्टाइड मोटे तौर पर एन्सेफेलोमाइलाइटिस की शुरुआत से जुड़ा था 5 तुलनीय घटना और गंभीरता पर दिन पहले (जैविक अणुओं, 2025-11-07). एक अलग समीक्षा में पाया गया कि क्लोराइड एलएल-37 में पेचदार संरचना को प्रेरित करने में परीक्षण किए गए आयनों में सबसे कम कुशल था (दवाइयों / अणुओं, 2020-12-03). ये सूत्रीकरण-निर्भर अवलोकन हैं, यह एक सामान्य बयान नहीं है कि कोई भी प्रतिवाद असुरक्षित है.
कार्यान्वयन का अर्थ है अशुद्धता अवधारण समय का भंडारण करना, शुद्धता के आंकड़े के साथ सापेक्ष क्षेत्र और काउंटरियन विनिमय स्थिति. सत्यापन स्तरों के लिए, मैं Q2(आर2) पेप्टाइड शुद्धता सीमा के बजाय सत्यापन सीमा निर्धारित करता है: अशुद्धता परीक्षण को रिपोर्टिंग सीमा तक कवर करना चाहिए 120% विशिष्टता सीमा का, और क्षेत्र प्रतिशत के अनुसार शुद्धता को मान्य किया जाता है 80% निचले से 100% ऊपरी विशिष्टता सीमा का (मैं Q2(आर2), अंतिम दिशानिर्देश 2023-11-30).
गोलियाँ 4: बैच इतिहास और विश्लेषण के लॉट-लिंक्ड प्रमाणपत्र
मॉडल ट्रस्ट एक ट्रैसेबिलिटी प्रॉपर्टी है, यही कारण है कि लॉट नंबर, विश्लेषण प्रमाणपत्र लिंकेज और पुन: परीक्षण इतिहास केवल गुणवत्ता प्रबंधन प्रणाली के बजाय डेटासेट में शामिल हैं. ALCOA+ की अपेक्षाएं जिन्हें AI/ML पाइपलाइनों को अब पूरा करना है, एक पूर्व-मौजूदा GMP मानक है जिसे नए उपयोग के मामले में विस्तारित किया गया है, मॉडलों के लिए आविष्कार किया गया कोई नया नियम नहीं. डेटा वंशावली को एक महत्वपूर्ण चिंता के रूप में चिह्नित किया गया है क्योंकि एआई/एमएल एमईएस और एलआईएमएस के साथ एकीकृत है, और डिजिटल थ्रेड को कच्चे माल के परीक्षण से लेकर विनिर्माण के माध्यम से अंतिम उत्पाद रिलीज तक डेटा संबंधों की अटूट श्रृंखला के रूप में परिभाषित किया गया है (एआई/एमएल कार्यान्वयन के लिए नियामक परिप्रेक्ष्य, पीएमसी, 2025-06-16).
टिप के लिए: ओवरराइटिंग के बजाय दोबारा परीक्षण और दोबारा परख इतिहास को बनाए रखें दुकान यह. टाइमस्टैम्प के साथ प्रतिस्थापित मान साक्ष्य है; प्रतिस्थापित मान एक अंतराल है.
विफलता मोड एक डबल-गिनती वाला अभियान है. एक ही लॉट पर चलाए गए तीन परीक्षण तीन स्वतंत्र अवलोकनों के रूप में दर्ज किए जाते हैं, और मॉडल एक बैच को तीन मानता है, ऐसे परिणाम में आत्मविश्वास बढ़ाना जिसे कभी दोहराया नहीं गया.
गोलियाँ 5: मानकीकृत विश्लेषणात्मक परिणाम और मशीन-पठनीय प्रारूप
पेप्टाइड एआई के लिए मानकीकृत विश्लेषणात्मक परिणाम उन प्रारूपों पर निर्भर करते हैं जिन्हें पाइपलाइन मैन्युअल सफाई के बिना पार्स कर सकती है. विश्लेषणात्मक परत के लिए मशीन-पठनीय मानक पहले से ही मौजूद हैं: कच्चे मास स्पेक्ट्रोमेट्री डेटा के लिए mzML, पहचान और परिमाणीकरण के लिए mzIdentML और mzTab, सबमिशन मेटाडेटा के लिए पीएक्स-एक्सएमएल, नमूना और एक्सपोज़र संबंधों के लिए एसडीआरएफ-प्रोटिओमिक्स, और स्थिर स्पेक्ट्रम पहचानकर्ताओं के लिए यूएसआई (प्रोटिओमिक्स डेटा अवसंरचना).
पुनरुत्पादन के लिए पूर्ण विधि ब्लॉक की भी आवश्यकता होती है. एचपीएलसी विधि मापदंडों में स्तंभ रसायन विज्ञान शामिल है (सामान्यतः C18), कण और छिद्र का आकार, स्तंभ आयाम, मोबाइल चरण और संशोधक, ग्रेडिएंट प्रोग्राम, प्रवाह दर (आस-पास 1.0 एमएल/मिनट विश्लेषणात्मक), स्तंभ तापमान, पता लगाने की तरंग दैर्ध्य (पेप्टाइड्स के लिए आमतौर पर 214-220 एनएम) और इंजेक्शन की मात्रा. पहचान की पुष्टि अक्षुण्ण-द्रव्यमान LC-MS या MALDI-TOF द्वारा प्रेक्षित बनाम सैद्धांतिक द्रव्यमान और एक निर्दिष्ट पीपीएम या दा स्वीकृति विंडो के साथ की जानी चाहिए।, अकेले एचपीएलसी द्वारा नहीं (फेनोमेनेक्स एचपीएलसी ज्ञान केंद्र, 2026-07-29).
विफलता मोड एक रिकॉर्ड है जो कहता है "मानक आरपी-एचपीएलसी ग्रेडिएंट।" विधि ब्लॉक के बिना, परिणाम सत्यापन एंकर के रूप में काम नहीं कर सकता, और कोई भागीदार इसे पुन: उत्पन्न नहीं कर सकता.
गोपनीयता: लीड लीक किए बिना पेप्टाइड डेटा साझा करना
एआई पेप्टाइड साझेदारी में गोपनीयता जोखिम मापने योग्य है, सैद्धांतिक नहीं. ए 2025 दवा-खोज तंत्रिका नेटवर्क के अध्ययन में पाया गया कि ब्लैक-बॉक्स परिदृश्य में जहां केवल आउटपुट लॉग उजागर होते हैं, जैसे वेब सेवा के रूप में पेश किया जाने वाला मॉडल, सदस्यता अनुमान हमलों ने पहचान की कि प्रशिक्षण सेट में कौन सी रासायनिक संरचनाएँ थीं, और कई हमलों के संयोजन से जोखिम बढ़ गया (दवा खोज में तंत्रिका नेटवर्क का प्रकाशन गोपनीयता से समझौता कर सकता है, 2025-03-26). लेखक ध्यान दें कि अणु अल्पसंख्यक वर्गों से हैं, दवा खोज में अक्सर सबसे मूल्यवान, विशेष रूप से असुरक्षित हैं, और स्थापित पुस्तकालय परिसरों से भिन्न अद्वितीय संरचनाएं विकास के तहत मालिकाना लीड या उपन्यास मचानों के अनुरूप हो सकती हैं.
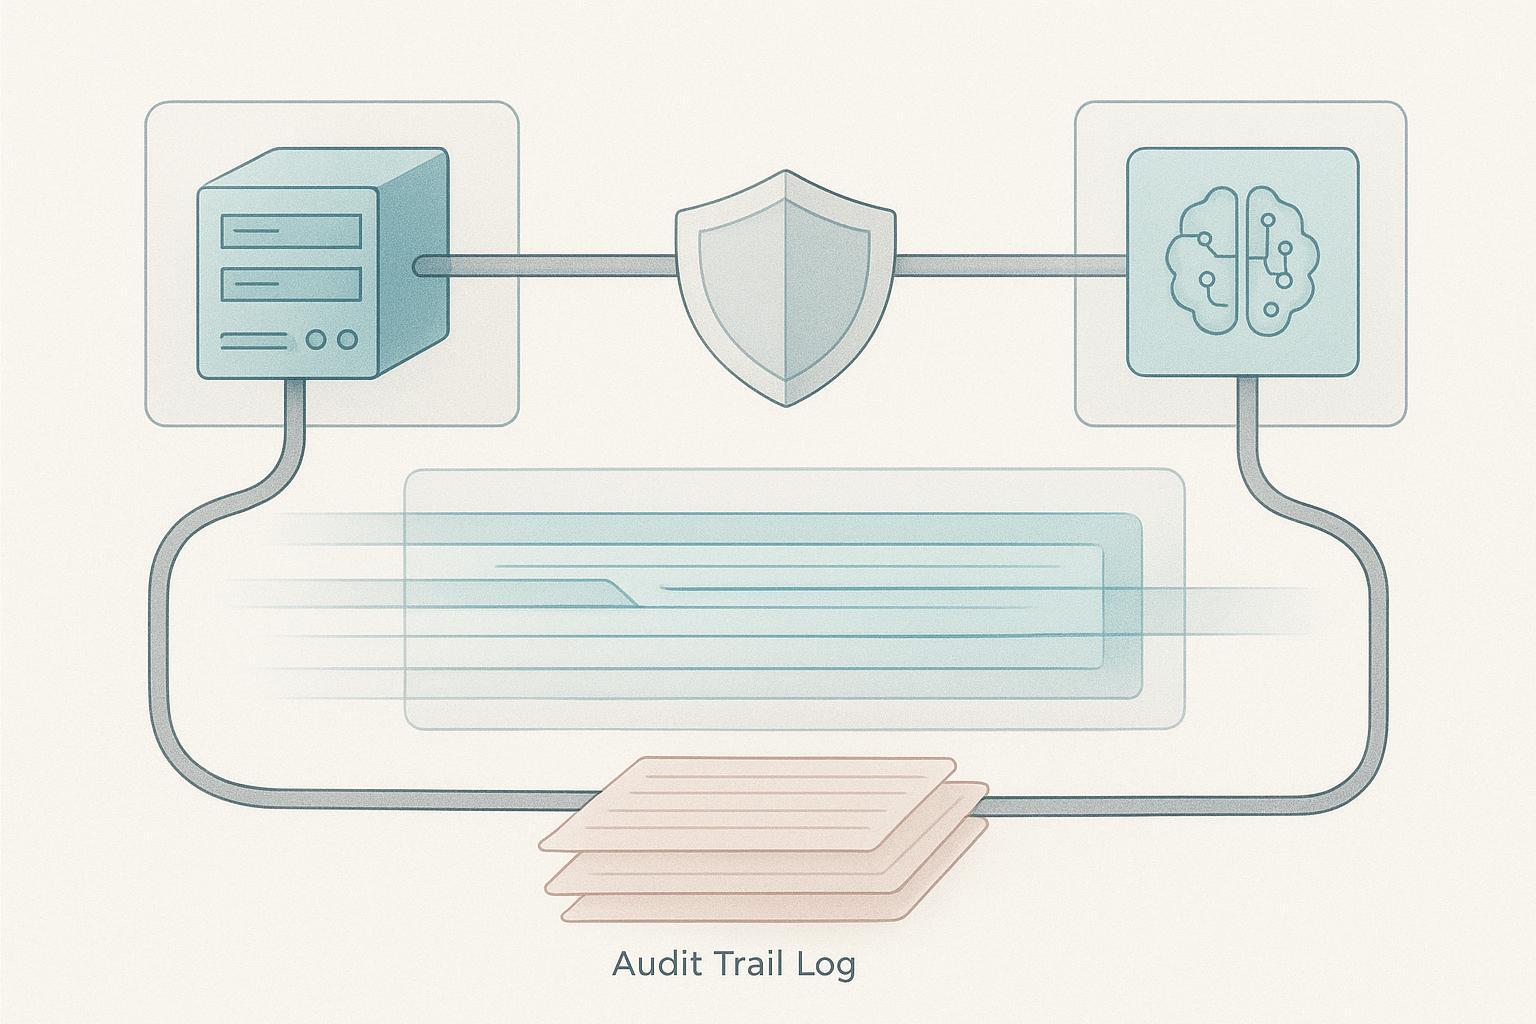
परिचालन प्रतिक्रिया एकल डेटा-साझाकरण निर्णय के बजाय एक स्तरीय एक्सेस मॉडल है. प्रायोजक कच्चे रिकॉर्ड घर में रखते हैं; जहां मॉडलिंग कार्य अनुमति देता है, वहां पार्टनर को डी-आइडेंटिफाइड या हैशेड अभ्यावेदन प्राप्त होता है; केवल समग्र आउटपुट ही सहयोग छोड़ते हैं. साझेदार क्या रख सकता है, इस पर संविदात्मक सीमाएँ, साथ ही साझा सेट के विरुद्ध प्रत्येक क्वेरी पर एक ऑडिट ट्रेल, लूप को बंद करो.
कुंजी ले जाएं: डी-आइडेंटिफिकेशन रिसाव के जोखिम को कम करता है लेकिन संरचनात्मक रूप से विशिष्ट पेप्टाइड्स के लिए इसे समाप्त नहीं करता है, इसलिए टियरिंग और क्वेरी ऑडिटिंग उस भार को उठाती है जो अकेले छिपाने से नहीं हो सकता.
वैज्ञानिक मान्यता: एक ऑपरेशनल प्रोटोकॉल, कोई सिद्धांत नहीं
सत्यापन कोई ऐसा सिद्धांत नहीं है जिससे आप सहमत हों. यह एक क्रम है जिसे आप चलाते हैं: पहले ओर्थोगोनल पुष्टि, फिर स्वतंत्र प्रतिकृति, फिर प्रत्येक मॉडल-सामना वाले मूल्य का उस कच्चे विश्लेषणात्मक डेटा से मिलान किया गया जिससे वह आया था. तीसरा चरण छोड़ना सबसे आम विफलता है, क्योंकि एक प्रशिक्षण तालिका में एक मिलान संख्या और एक असम्बद्ध संख्या समान दिखती है.
कुछ भी उत्पन्न करने से पहले प्रति दावा प्रकार ऑर्थोगोनल जोड़ी को परिभाषित करें. पहचान के लिए, अक्षुण्ण द्रव्यमान को एक सेकंड के साथ जोड़ें, एक ही उपकरण पर बार-बार इंजेक्शन लगाने के बजाय यांत्रिक रूप से भिन्न विधि. गतिविधि के लिए, बायोफिजिकल बाइंडिंग रीडआउट को सेल-आधारित कार्यात्मक रीडआउट के साथ जोड़ें, क्योंकि दोनों अलग-अलग सवालों के जवाब देते हैं.
प्रतिकृति को स्वतंत्र रूप से संश्लेषित लॉट का उपयोग करना चाहिए, उसी सामग्री का पुनः संचालन नहीं. एक ही परख को एक ही लॉट पर दो बार चलाने से उपकरण की सटीकता मापी जाती है, सामान्यीकरण नहीं. ए 2025 एपिटोप भविष्यवाणी विधियों की व्यवस्थित समीक्षा में पाया गया कि कई मौजूदा दृष्टिकोण अपने प्रशिक्षण डेटासेट में ओवरफिटिंग से ग्रस्त हैं, जो काफी हद तक सीमित कर देता है कि वे नए लक्ष्यों पर कितनी अच्छी तरह स्थानांतरित होते हैं (एनपीजे टीके, 2025-08-30). वही समीक्षा नोट करती है कि सभी बाइंडर्स इम्युनोजेनिक नहीं हैं: एक शीर्ष क्रम का एपिटोप इन विट्रो में एंटीबॉडी को बांध सकता है, फिर भी विवो में अपेक्षित प्रतिक्रिया प्राप्त करने में विफल रहता है, और बेंचमार्क पर सटीकता रीडआउट के समय कायम नहीं रहती, कोशिका रेखा, या लक्ष्य संदर्भ भिन्न है.
इसके विरुद्ध डिज़ाइन करने में यह विफलता मोड है. प्रशिक्षण सेट याद रखने को मापने के लिए उसी अभियान से लिया गया एक सत्यापन सेट है, सामान्यीकरण नहीं.
बेंचमार्क गैप: क्या मानकीकरण अभी भी ठीक नहीं हो सका है
मानकीकरण आवश्यक है लेकिन पर्याप्त नहीं है. क्षेत्र के मानक नए और संकीर्ण हैं, और कोई भी स्कोरकार्ड अभी तक यह नहीं माप सका है कि वह क्या मापने का दावा करता है.
पेपबेंचमार्क, मानकीकृत पेप्टाइड-एमएल बेंचमार्क अप्रैल में जारी किया गया 2026 और आईसीएलआर में प्रस्तुत किया गया 2026, कवर 29 कैनोनिकल-पेप्टाइड प्लस 6 गैर-विहित-पेप्टाइड डेटासेट 7 समूह, एक एकीकृत प्रीप्रोसेसिंग पाइपलाइन और चार विधि परिवारों तक फैले लीडरबोर्ड के साथ: अंगुली की छाप, जीएनएन, पीएलएम, और मुस्कुराओ. इसके लेखकों ने स्पष्ट रूप से कहा है कि पिछला काम "मानकीकृत बेंचमार्क की अनुपस्थिति के कारण बाधित हुआ था" और "तदर्थ पाइपलाइनों में सामान्य गुणवत्ता के मुद्दों" का सामना करना पड़ा। यह एक वास्तविक प्रगति है, और यह एक संकीर्ण भी है: 35 डेटासेट, एक बेंचमार्क, एक रिलीज.
योजना बनाने के लिए शीर्षक की तुलना में ईमानदार सीमाएँ अधिक मायने रखती हैं. कोई भी सर्वेक्षण बायोफार्मा आर के लिए एक भी रक्षात्मक एफएआईआर-गोद लेने का प्रतिशत नहीं देता है&डी, और कोई भी अध्ययन लीक या पुनरुत्पादन दोष वाले एआई दवा-खोज पत्रों के अनुपात की गणना नहीं करता है. इसलिए कोई भी तैयारी स्कोरकार्ड एक निर्णय सहायता है, माप नहीं.
⚠️ चेतावनी: तत्परता स्कोर को एक संरचित वार्तालाप स्टार्टर के रूप में मानें, कोई मान्य मीट्रिक नहीं. यदि कोई साथी पूछता है कि आपका स्कोर किसके विरुद्ध बेंचमार्क किया गया है, आज सही उत्तर है "हमारे अपने मानदंड।","एक प्रकाशित मानक नहीं है.
बाहरी फ्रेम आ रहा है, यद्यपि. एफडीए का जनवरी 2025 विनियामक निर्णय लेने में एआई पर मसौदा मार्गदर्शन उपयोग के एक निर्दिष्ट संदर्भ से जुड़े जोखिम-आधारित विश्वसनीयता मूल्यांकन का प्रस्ताव करता है. यह एक मसौदा है, कार्यान्वयन के लिए नहीं, और यह खोज के बजाय प्रस्तुतीकरण को नियंत्रित करता है. फिर भी, यह उस प्रश्न की ओर इशारा करता है जिसका उत्तर देने के लिए एक तत्परता कार्यक्रम बनाया जाना चाहिए: यह मॉडल किस लिए है, और कौन सा साक्ष्य इसके आउटपुट को उस उपयोग के लिए विश्वसनीय बनाता है?
शुरू करना: 30-दिवसीय पेप्टाइड डेटा रेडीनेस पास
एआई दवा खोज के लिए पेप्टाइड डेटा वर्कफ़्लो का परीक्षण यादृच्छिक रूप से बीस पेप्टाइड रिकॉर्ड खींचकर और प्रत्येक को पांच स्तंभों के विरुद्ध स्कोर करके सबसे तेज़ किया जाता है।. वह पांच मिनट का निर्णय है, और यह आम तौर पर इस सवाल का समाधान करता है कि क्या कोई कार्यक्रम साझेदारी के लिए तैयार है. अधिकांश टीमों का मानना है कि कुछ रिकॉर्ड साफ-सुथरे हैं, एक बड़ा समूह आंशिक रूप से पूर्ण है, और कुछ का बिल्कुल भी पुनर्निर्माण नहीं किया जा सकता है.
हर उस क्षेत्र के लिए जो विफल रहता है, तय करें कि गैप कैप्चर समस्या है या लिंकेज समस्या है. कैप्चर समस्या का मतलब है कि डेटा कभी रिकॉर्ड नहीं किया गया था, इसलिए टीम बेंच पर जो एकत्र करती है, उसमें बदलाव एक समस्या है. लिंकेज समस्या का मतलब है कि डेटा कहीं मौजूद है लेकिन बहुत से लोगों से जुड़ा नहीं है, एक विधि, या एक परख रीडआउट, तो फिक्स एक पहचानकर्ता और एक जुड़ाव है, कोई नया प्रयोग नहीं. दोनों के मालिक अलग-अलग हैं और समयसीमा भी अलग-अलग है, और एक लिंकेज समस्या को कैप्चर समस्या के रूप में मानने में कई महीने बर्बाद हो जाते हैं.
फिर एक पेप्टाइड को पूरी श्रृंखला में एक सिरे से दूसरे सिरे तक चलाएँ: पहचान रिकार्ड, विश्लेषण का लॉट-लिंक्ड प्रमाणपत्र, मशीन-पठनीय विश्लेषणात्मक फ़ाइल. हर उस बिंदु का दस्तावेजीकरण करें जहां किसी इंसान को हाथ से हस्तक्षेप करना पड़ा हो. वह हस्तक्षेप सूची तत्परता परियोजना का वास्तविक दायरा है.
आम हिचकिचाहट यह है कि इसके लिए प्लेटफ़ॉर्म को बदलने की आवश्यकता है. अधिकतर मामलों में ऐसा नहीं होता. इसके लिए टीम द्वारा पहले से तैयार किए गए रिकॉर्ड पर फ़ील्ड-स्तरीय अनुशासन की आवश्यकता होती है.
अगला कदम: बीस-रिकॉर्ड स्कोरिंग पास चलाएँ और हस्तक्षेप सूची को तकनीकी डेटा-तत्परता समीक्षा में लाएँ, जहां अंतरालों को ठोस सुधारों के लिए मैप किया जाता है.
अक्सर पूछे जाने वाले प्रश्नों
पेप्टाइड अनुक्रम और संशोधन रिकॉर्ड को क्या स्पष्ट बनाता है?
एक स्पष्ट रिकॉर्ड सटीक रासायनिक संरचना का नाम देता है, कोई आशुलिपि नहीं जिसकी पाठक को व्याख्या करनी पड़े. पेप्टाइड संरचना संकेतन का संदर्भ उपचार दोषरहित रासायनिक प्रतिनिधित्व को प्राथमिक रिकॉर्ड के रूप में मानता है, पॉलिमर-जागरूक संरचनाओं के लिए HELM और परमाणु-स्तरीय ग्राफ मॉडल के लिए SMILES का उपयोग किया जाता है, डुप्लीकेशन और पहचान कुंजी के रूप में InChI या InChIKey, चक्रीकरण और क्रॉसलिंक को स्पष्ट कनेक्शन ऑब्जेक्ट के रूप में लिखा गया है, और गैर-प्राकृतिक अवशेष डी-अमीनो एसिड के लिए छोटे अक्षरों वाले बहु-अक्षर कोड में लिखे गए हैं. अवशेष-स्तरीय संशोधन एनोटेशन, जैसा कि एमएपी द्वारा उपयोग किया जाता है, लैक्टम ब्रिज को डाइसल्फ़ाइड से अलग रखता है. एक रिकॉर्ड जो उस विवरण के बिना "संशोधित पेप्टाइड" कहता है वह साफ-सुथरा दिखता है लेकिन एआई-तैयार नहीं है.
क्या HELM या SMILES बेहतर प्राथमिक रिकॉर्ड है??
कोई भी सार्वभौमिक रूप से बेहतर नहीं है; चुनाव उस मॉडल का अनुसरण करता है जो रिकॉर्ड का उपभोग करेगा. एचईएलएम पॉलिमर-स्तरीय टोपोलॉजी को संरक्षित करता है और गैर-प्राकृतिक मोनोमर्स और कनेक्शन ऑब्जेक्ट्स को सफाई से संभालता है, जो अनुक्रम-जागरूक और मैक्रोसायकल कार्य के लिए उपयुक्त है. SMILES एक परमाणु-स्तरीय ग्राफ़ देता है जिसे अधिकांश ग्राफ़ न्यूरल नेटवर्क और केमिनफॉर्मेटिक्स टूलकिट सीधे पढ़ते हैं. ऐसे प्रोग्राम जिन्हें प्राथमिक रिकॉर्ड के रूप में एक को संग्रहीत करने और दूसरे को उत्पन्न करने की आवश्यकता होती है, InChIKey के साथ जुड़ने की कुंजी के रूप में इसलिए एक ही अणु को कभी भी दो बार नहीं गिना जाता है.
कितना परख संदर्भ पर्याप्त है?
इतना पर्याप्त है कि एक अलग प्रयोगशाला माप को दोहरा सकती है और संख्या की व्याख्या कर सकती है. न्यूनतम पर: परख प्रकार और रीडआउट, लक्ष्य और निर्माण, सेल लाइन या मैट्रिक्स, एकाग्रता सीमा, ऊष्मायन की स्थिति, पता लगाने की विधि, और इकाइयाँ. ए 2025 एपिटोप भविष्यवक्ताओं की व्यवस्थित समीक्षा में पाया गया कि एक शीर्ष क्रम वाला एपिटोप इन विट्रो में एंटीबॉडी को बांध सकता है, फिर भी विवो में खराब इम्युनोजेनिक हो सकता है, और पढ़ते समय वह सटीकता स्थानांतरित नहीं होती है, सेल लाइन या लक्ष्य संदर्भ भिन्न होता है. बिना किसी संदर्भ वाले बाध्यकारी मूल्य को किसी भी चीज़ के साथ एकत्रित नहीं किया जा सकता है.
क्या एकल शुद्धता संख्या कभी स्वीकार्य है??
सिर्फ हेडलाइन के तौर पर, रिकार्ड के रूप में कभी नहीं. मैं Q2(आर2)की सत्यापन-श्रेणी आवश्यकताएँ सीमा से अशुद्धता रिपोर्टिंग निर्धारित करती हैं 120% विशिष्टता सीमा का, और शुद्धता क्षेत्र प्रतिशत से 80% को 100% विशिष्टता सीमाओं की, मोटे तौर पर सिग्नल-टू-शोर अनुपात के आसपास पता लगाने और मात्रा की सीमा के साथ 3:1 और 10:1. पेप्टाइड अशुद्धता और बैच इतिहास डेटा जो केवल "98% शुद्ध" रखते हैं, कौन सी अशुद्धियाँ छिपाते हैं, किस स्तर पर, किस विधि से. नंबर रखो, फिर इसके पीछे प्रोफ़ाइल संलग्न करें. पेप्टाइड उत्पादन के बारे में
हम मुख्य श्रृंखला को उजागर किए बिना किसी भागीदार के साथ संरचनाएं कैसे साझा करते हैं?
कच्चे प्रशिक्षण सेट के बजाय मॉडल या व्युत्पन्न सुविधाओं को साझा करें, और परीक्षण करें कि आउटपुट से क्या पता चलता है. सदस्यता-अनुमान हमले जो एक सेवा मॉडल से प्रशिक्षण अणुओं को पुनर्प्राप्त करते हैं, अकेले आउटपुट लॉग से प्रशिक्षण अणुओं की पहचान करते हैं, और अल्पसंख्यक-वर्ग और उपन्यास-मचान अणु सबसे कमजोर हैं, संयुक्त हमलों से खतरा और बढ़ गया है. अगर किसी पार्टनर को डेटा की ही जरूरत है, फ़ाइल स्थानांतरण के बजाय एक सहमत सुविधा सेट और ऑडिट ट्रेल के साथ नियंत्रित वातावरण का उपयोग करें.
क्या किसी मॉडल को स्वतंत्र लॉट के बिना मान्य किया जा सकता है??
नहीं. एक मॉडल को केवल लॉट पर मान्य किया गया है, इसमें पहले से ही रिपोर्ट को याद रखना देखा गया है, सामान्यीकरण नहीं. प्रति प्रोग्राम कम से कम एक लॉट रोक कर रखें, आदर्श रूप से एक अलग संश्लेषण अभियान से, और अंतिम मूल्यांकन तक इसे अछूता रखें. यदि कोई स्वतंत्र लॉट मौजूद नहीं है, ईमानदार कथन यह है कि मॉडल आंतरिक रूप से सुसंगत है, मान्य नहीं.
क्या एफडीए मसौदा मार्गदर्शन खोज-चरण कार्य पर लागू होता है?
प्रत्यक्ष नहीं, लेकिन यह उस मानक का सबसे स्पष्ट उपलब्ध कथन है जिसका आपको अंततः पालन करना होगा. एफडीए का जनवरी 2025 विनियामक निर्णय लेने में एआई पर मसौदा मार्गदर्शन उपयोग के एक निर्दिष्ट संदर्भ से जुड़े जोखिम-आधारित विश्वसनीयता मूल्यांकन का प्रस्ताव करता है. यह दिनांकित प्रारूप है 6 जनवरी 2025 और कार्यान्वयन के लिए नहीं है. डिस्कवरी टीमें जो अभी उपयोग के संदर्भ का दस्तावेजीकरण करती हैं, उन्हें बाद में इसका पुनर्निर्माण नहीं करना पड़ेगा.
कुंजी ले जाएं: तत्परता का दावा केवल तभी बचाव योग्य होता है जब वह रिकॉर्ड फ़ील्ड का नाम देता है, साझाकरण वास्तुकला और सत्यापन प्रोटोकॉल, तब नहीं जब यह शुद्धता संख्या की रिपोर्ट करता है.
निष्कर्ष
तत्परता रिकॉर्ड की संपत्ति है, मॉडल का नहीं, और वह एआई दवा खोज के लिए परीक्षण पेप्टाइड डेटा वर्कफ़्लो है जिसका अब हर साझेदारी वार्तालाप में सामना होता है. पांच स्तंभ, स्पष्ट अनुक्रम और संशोधन संकेतन, परख संदर्भ जो परिणाम के साथ यात्रा करता है, एकल शुद्धता के आंकड़े के बजाय अशुद्धता प्रोफाइल, विश्लेषण के लॉट-लिंक्ड प्रमाणपत्र, और मशीन-पठनीय मानकीकृत विश्लेषणात्मक आउटपुट, चेकलिस्ट हैं. गोपनीयता वास्तुकला और एक लिखित सत्यापन प्रोटोकॉल वह है जो आपको लीड सौंपे बिना उस रिकॉर्ड को साझा करने देता है.
बेंचमार्क और नियामक ढाँचे अभी भी बन रहे हैं: पेपबेंचमार्क 2026 जल्दी है, और कार्यान्वयन के लिए FDA मसौदा मार्गदर्शन अभी तक नहीं लिखा गया है. अब बनाया गया तत्परता कार्यक्रम उस प्रश्न का उत्तर देता है जो भागीदार बाद में अधिक औपचारिक रूप से पूछेंगे, इसलिए इसे एक बार प्रमाणित करने के बजाय दोबारा स्कोर करने के लिए बनाएं. यह मार्गदर्शिका एक निर्णय सहायता है, माप नहीं. कोई रक्षात्मक क्षेत्र-व्यापी FAIR-गोद लेने का प्रतिशत या रिसाव-दोष गणना मौजूद नहीं है, इसलिए यहां स्कोरकार्ड किसी निर्णय का समर्थन करने के बजाय किसी निर्णय का समर्थन करता है.
एमओएल चेंजेस एक पेप्टाइड विक्रेता के रूप में प्रकाशित होता है.
पता लगाएँ कि आपके पेप्टाइड रिकॉर्ड किसी भागीदार के मॉडल को कहाँ विफल करेंगे. एक तकनीकी डेटा-तत्परता समीक्षा आपके पेप्टाइड रिकॉर्ड को पांच स्तंभों के विरुद्ध मैप करती है और प्रत्येक अंतर को कैप्चर समस्या या लिंकेज समस्या के रूप में वर्गीकृत करती है।. डेटा-तत्परता समीक्षा का अनुरोध करें हमारी विश्लेषणात्मक टीम के साथ.