Ce dont ont réellement besoin les flux de travail de données peptidiques pour la découverte de médicaments par l’IA
Les flux de travail de données peptidiques pour la découverte de médicaments liés à l'IA constituent la tenue des registres, analytique, et des pratiques de gouvernance qui rendent un ensemble de données peptidiques utilisable par machine par un modèle prédictif. Ils couvrent cinq domaines: enregistrements de séquence et de modification, contexte du test, données sur les impuretés, historique des lots, et des résultats analytiques standardisés. Ce qui les distingue des conseils génériques sur la préparation des données, c'est que chaque exigence se situe au niveau d'un champ d'enregistrement individuel., et chacun doit survivre à la fois à un examen de confidentialité et à un protocole de validation documenté.
La barre du niveau record est la partie que la plupart des équipes sous-estiment. Le traitement de référence de la notation de la structure peptidique soutient que les pipelines d'apprentissage automatique fonctionnent mieux à partir d'une représentation chimique sans perte comme enregistrement principal., avec des codages spécifiques au modèle qui en dérivent plutôt que stockés comme source de vérité (Annotation des structures peptidiques à l'aide de SMILES et d'autres codes chimiques, 2017). Dans cette approche, InChIKey agit comme une clé d'identité et de déduplication, tandis que la cyclisation et les liens croisés doivent être écrits sous forme d'objets de connexion explicites au lieu d'être laissés implicites.
Les régulateurs vont dans la même direction. Le mois de janvier de la FDA 2025 le projet d'orientations sur l'IA dans la prise de décision réglementaire introduit une évaluation de la crédibilité basée sur les risques et liée à un contexte d'utilisation défini (Projet de lignes directrices de la FDA, contenu actuel 2025-01-06). C'est un brouillon, pas pour la mise en œuvre, mais cela indique que les ensembles de données peptidiques prêts pour l'IA seront jugés sur la traçabilité plutôt que sur le volume.
Clé à retenir: Trois éléments distinguent ces flux de travail du nettoyage de données ordinaire: exigences en matière d'enregistrement au niveau du terrain, des mécanismes de confidentialité qui permettent aux partenaires de partager sans exposer de prospect, et un protocole de validation opérationnelle plutôt qu'un principe énoncé.
Deux idées fausses sont à l'origine de la plus grande confusion. « Données propres » ne signifie pas « données organisées », une feuille de calcul bien rangée peut toujours être inutilisable par un modèle. Et un seul indice de pureté ne décrit pas un peptide; les données d'impuretés et d'historique de lots contiennent les informations dont un modèle peut réellement tirer des leçons. Cette section s'appuie sur la littérature sur la notation de structure évaluée par des pairs et sur les orientations réglementaires actuelles., sans sources de fournisseurs.
Pourquoi les flux de travail de données peptidiques pour la découverte de médicaments par l'IA sont désormais importants
Les flux de travail de données peptidiques pour la découverte de médicaments basés sur l’IA sont importants, car l’argent circule désormais avant les données.. Dans le 2026 Suivi des transactions IA publié par VLS Research, les montants initiaux divulgués se situent entre 30 et 50 millions de dollars, contre des valeurs globales supérieures à 1 milliard de dollars, environ 2 à 3 % de la valeur globale payée en espèces (Recherche VLS, Suivi des accords de découverte de médicaments par l'IA 2026, récupéré 2026-07-03). Isomorphic Labs – Eli Lilly affiche environ 45 millions de dollars d'avance contre plus de 1,7 milliard de dollars d'étapes; Noetik-GSK affiche 50 millions de dollars d'avance sur une structure de licence de cinq ans. Notez la source: un tracker d'analyste, avec un intérêt du fournisseur pour le récit de l'accord sur l'IA.
Le dossier clinique est le contrepoids. Autour 90% des molécules entrant en clinique n’obtiennent jamais d’approbation, et 50 à 60 % des échecs de phase II sont dus à un manque d’efficacité, des chiffres qui ont à peine bougé en deux décennies (Mao-Z & Yan L., Frontières de la pharmacologie, récupéré 2026-07-03). Le même 2024 examen systématique de 20 Programmes basés sur l'IA de 2018 à 2023 a découvert que l'optimisation des leads assistée par l'IA réduisait le temps de sélection des candidats de 30 à 50 % en moyenne, tandis que l'attrition des phases I/II est restée comparable aux références de l'industrie..
Cet écart est le point. Les partenaires peuvent désormais signer sur un modèle, mais un modèle ne peut pas apprendre des enregistrements qui n'ont jamais capturé le peptide.
Cela affecte R&D mène, chimie analytique, données et informatique, et les dirigeants de l'alliance qui héritent des questions de diligence après signature.
Les cinq piliers de données des ensembles de données peptidiques prêts pour l'IA
Les ensembles de données peptidiques prêts pour l’IA sont construits à partir de cinq piliers de niveau record, et ensemble, ils forment la liste de contrôle de préparation sur laquelle une équipe peut se comparer avant de signer un accord de partenariat.. Chaque pilier ci-dessous est écrit de la même manière: pourquoi c'est important, comment le mettre en œuvre, et à quoi ressemble l'échec quand il manque. L'ordre est délibéré. L'identité passe avant tout car chaque domaine en aval, du contexte d'analyse au profil d'impuretés, hérite des erreurs d'un enregistrement de structure ambigu. Un modèle entraîné sur une séquence mal spécifiée n'échoue pas bruyamment; il apprend la mauvaise molécule et rapporte des prédictions sûres à son sujet.
Notez honnêtement chaque pilier. Une équipe capable de reconstruire chaque peptide à partir de ses propres enregistrements, joindre des conditions de test à chaque résultat, et tracer chaque lot jusqu'à un certificat d'analyse est prêt à transmettre les données à un partenaire. Une équipe qui ne le peut pas n’est pas empêchée de s’associer, but it should expect the first months of the collaboration to be spent on data remediation rather than model training.
Pilules 1: Enregistrements de séquence et de modification sans ambiguïté
Peptide sequence and modification records matter because a model cannot learn from a peptide it cannot reconstruct, and identity errors propagate silently through every downstream prediction. The fix is a lossless chemical representation as the primary record, avec des codages spécifiques au modèle qui en dérivent plutôt que stockés comme source de vérité.
Implementation follows a small set of conventions. HELM handles polymer-aware structures, including branches and non-natural monomers, while SMILES serves atom-level graph models. InChI and InChIKey act as deduplication and identity keys across systems. Cyclization and crosslinks belong in explicit connection objects, never as an implicit assumption that “cyclized” means the same thing everywhere. Le traitement de référence de la notation de la structure peptidique couvre le reste: codes à plusieurs lettres pour les résidus non protéiques ou non naturels, annotation en minuscules pour les acides aminés D, et annotation de modification du niveau de résidus au format MAP (Journal de Chemininformatique / PMC).
Le mode panne est silencieux et coûteux. Un programme enregistre un pont lactame et un disulfure comme « cyclisés » dans le même champ, le modèle traite donc deux échafaudages chimiquement distincts comme un seul. Chaque prédiction construite sur cette colonne est contaminée, et rien dans le pipeline ne le signale.
Un enregistrement utilisable par un modèle pour un peptide macrocyclique modifié porte le champ défini ci-dessous. MOL Changes soutient cette approche axée sur la structure dans son travail sur les données peptidiques, et l'exemple est reproductible avec n'importe quel système d'enregistrement conforme.
|
Champ |
Enregistrement utilisable par le modèle |
Enregistrement en texte libre typique |
|---|---|---|
|
Représentation primaire |
Chaîne HELM avec objets de connexion explicites |
Séquence collée dans un champ de notes |
|
Encodage au niveau de l'atome |
SMILES dérivés de l'enregistrement HELM |
Absent |
|
Synthèse peptidique Clé d'identité |
InChIKey pour la déduplication |
Absent |
|
Non naturel Peptides synthétiques résidus |
Codes à plusieurs lettres, défini dans un tableau des monomères |
approximations d'une seule lettre |
|
Stéréochimie |
Annotation minuscule des acides aminés D |
Non enregistré |
|
Modifications |
Annotation MAP au niveau des résidus |
Note en texte libre, par exemple. "cyclisé" |
|
Type de cyclisation |
Objet pont explicite avec positions |
Ambiguë |
|
Services Liens croisés |
Objet de connexion explicite |
Absent ou implicite |
Pilules 2: Contexte de test qui accompagne le résultat
Une affinité de liaison sans ses conditions de test n'est pas une étiquette de formation, c'est un numéro. Le contexte du test doit suivre le résultat: type de test, construction et espèces cibles, format de lecture, et si la valeur a été mesurée ou prédite.
La distinction entre mesures et prévisions est le point où la plupart des ensembles de données se brisent discrètement.. UN 2025 une revue systématique des prédicteurs d'épitopes a révélé que seuls 174 de 777 (22%) Il a été confirmé que les peptides de liaison HLA prédits par ordinateur dans une étude sur le SRAS-CoV-2 se lient de manière stable in vitro (Vaccins npj, 2025-08-30). Ce chiffre est limité à une seule étude, pas un taux de précision général pour l'IA en immunologie, mais cela montre pourquoi une valeur prédite et une valeur mesurée ne peuvent pas partager une colonne sans un indicateur les séparant.
⚠️ Attention: Mutualisation SPR, la polarisation de fluorescence et les valeurs cellulaires dans une seule colonne d'affinité entraînent le modèle sur le test plutôt que sur la chimie. Le modèle apprend quel laboratoire a généré le numéro, pas quel peptide se lie.
Pilules 3: Profils d'impuretés, Pas un seul numéro de pureté
Les données sur les impuretés peptidiques et l'historique des lots appartiennent à l'enregistrement en tant que profil., pas un pourcentage global. Deux lots signalés à 98% pur peut se comporter différemment dans un test, et le modèle a besoin de l'enveloppe d'impureté et de l'état du contre-ion pour voir pourquoi.
Les effets des contre-ions sont bien documentés. Dans un 2025 revoir, le peptide M33 sous forme de sel de TFA a montré une cytotoxicité 5 à 30 % plus élevée envers les cellules épithéliales bronchiques normales que son homologue acétate, et le peptide MOG formulé avec du TFA était associé à l'apparition d'une encéphalomyélite à peu près 5 jours plus tôt à une incidence et une gravité comparables (Biomolécules, 2025-11-07). Une étude distincte a révélé que le chlorure était le moins efficace des anions testés pour induire une structure hélicoïdale dans le LL-37. (Médicaments / Molécules, 2020-12-03). Ce sont des observations dépendantes de la formulation, il ne s'agit pas d'une déclaration générale selon laquelle tout contre-ion est dangereux.
La mise en œuvre consiste à mémoriser les temps de rétention des impuretés, zones relatives et état d'échange de contre-ions ainsi que le chiffre de pureté. Pour les niveaux de validation, Je Q2(R2) définit la plage de validation plutôt que les limites de pureté des peptides: les tests d'impuretés doivent couvrir le seuil de déclaration jusqu'à 120% de la limite de spécification, et la pureté par pourcentage de surface est validée à partir de 80% du bas à 100% de la limite supérieure de spécification (Je Q2(R2), ligne directrice finale 2023-11-30).
Pilules 4: Historique des lots et certificats d'analyse liés aux lots
La confiance modèle est une propriété de traçabilité, c'est pourquoi les numéros de lot, le lien entre le certificat d'analyse et l'historique des nouveaux tests appartient à l'ensemble de données plutôt qu'au système de gestion de la qualité. Les attentes ALCOA+ auxquelles les pipelines IA/ML doivent désormais satisfaire sont une norme GMP préexistante étendue à un nouveau cas d'utilisation., pas une nouvelle règle inventée pour les modèles. La traçabilité des données est signalée comme une préoccupation critique à mesure que l'IA/ML s'intègre au MES et au LIMS., et le fil numérique est défini comme la chaîne ininterrompue de relations entre les données, depuis les tests des matières premières jusqu'à la sortie du produit final en passant par la fabrication. (Perspectives réglementaires pour la mise en œuvre de l'IA/ML, PMC, 2025-06-16).
Pour un pourboire: Conserver l'historique des re-tests et des ré-analyses plutôt que de l'écraser Boutique il. Une valeur remplacée avec un horodatage est une preuve; une valeur remplacée est un écart.
Le mode échec est une campagne doublement comptée. Trois analyses effectuées sur le même lot sont enregistrées comme trois observations indépendantes, et le modèle traite un lot comme trois, gonfler la confiance dans un résultat qui n’a jamais été reproduit.
Pilules 5: Résultats analytiques standardisés et formats lisibles par machine
Les résultats analytiques standardisés pour l’IA peptidique dépendent des formats qu’un pipeline peut analyser sans nettoyage manuel. Des normes lisibles par machine existent déjà pour la couche analytique: mzML pour les données brutes de spectrométrie de masse, mzIdentML et mzTab pour les identifications et la quantification, PX-XML pour les métadonnées de soumission, SDRF-Protéomique pour les relations entre échantillons et expositions, et USI pour les identifiants de spectre stables (Infrastructure de données protéomiques).
Reproducibility also requires the full method block. HPLC method parameters include column chemistry (typically C18), taille des particules et des pores, column dimensions, mobile phases and modifiers, programme de dégradé, débit (around 1.0 mL/min analytical), température de la colonne, longueur d'onde de détection (typically 214–220 nm for peptides) and injection amount. Identity must be confirmed by intact-mass LC-MS or MALDI-TOF with observed versus theoretical mass and a stated ppm or Da acceptance window, not by HPLC alone (Phenomenex HPLC knowledge center, 2026-07-29).
The failure mode is a record that says “standard RP-HPLC gradient.” Without the method block, the result cannot serve as a validation anchor, and a partner cannot reproduce it.
Confidentialité: Partager des données peptidiques sans fuite de plomb
Le risque de confidentialité dans les partenariats sur les peptides d’IA est mesurable, pas théorique. UN 2025 Une étude des réseaux neuronaux de découverte de médicaments a révélé que dans un scénario de boîte noire où seuls les logits de sortie sont exposés, comme un modèle proposé en service web, les attaques d'inférence d'adhésion ont identifié les structures chimiques qui se trouvaient dans l'ensemble d'entraînement, et la combinaison de plusieurs attaques augmentait le risque (La publication de réseaux neuronaux dans le cadre de la découverte de médicaments pourrait compromettre la confidentialité, 2025-03-26). Les auteurs notent que les molécules issues de classes minoritaires, souvent le plus précieux dans la découverte de médicaments, sont particulièrement vulnérables, et que des structures uniques différentes des composés de bibliothèques établis peuvent correspondre à des pistes exclusives ou à de nouveaux échafaudages en cours de développement..
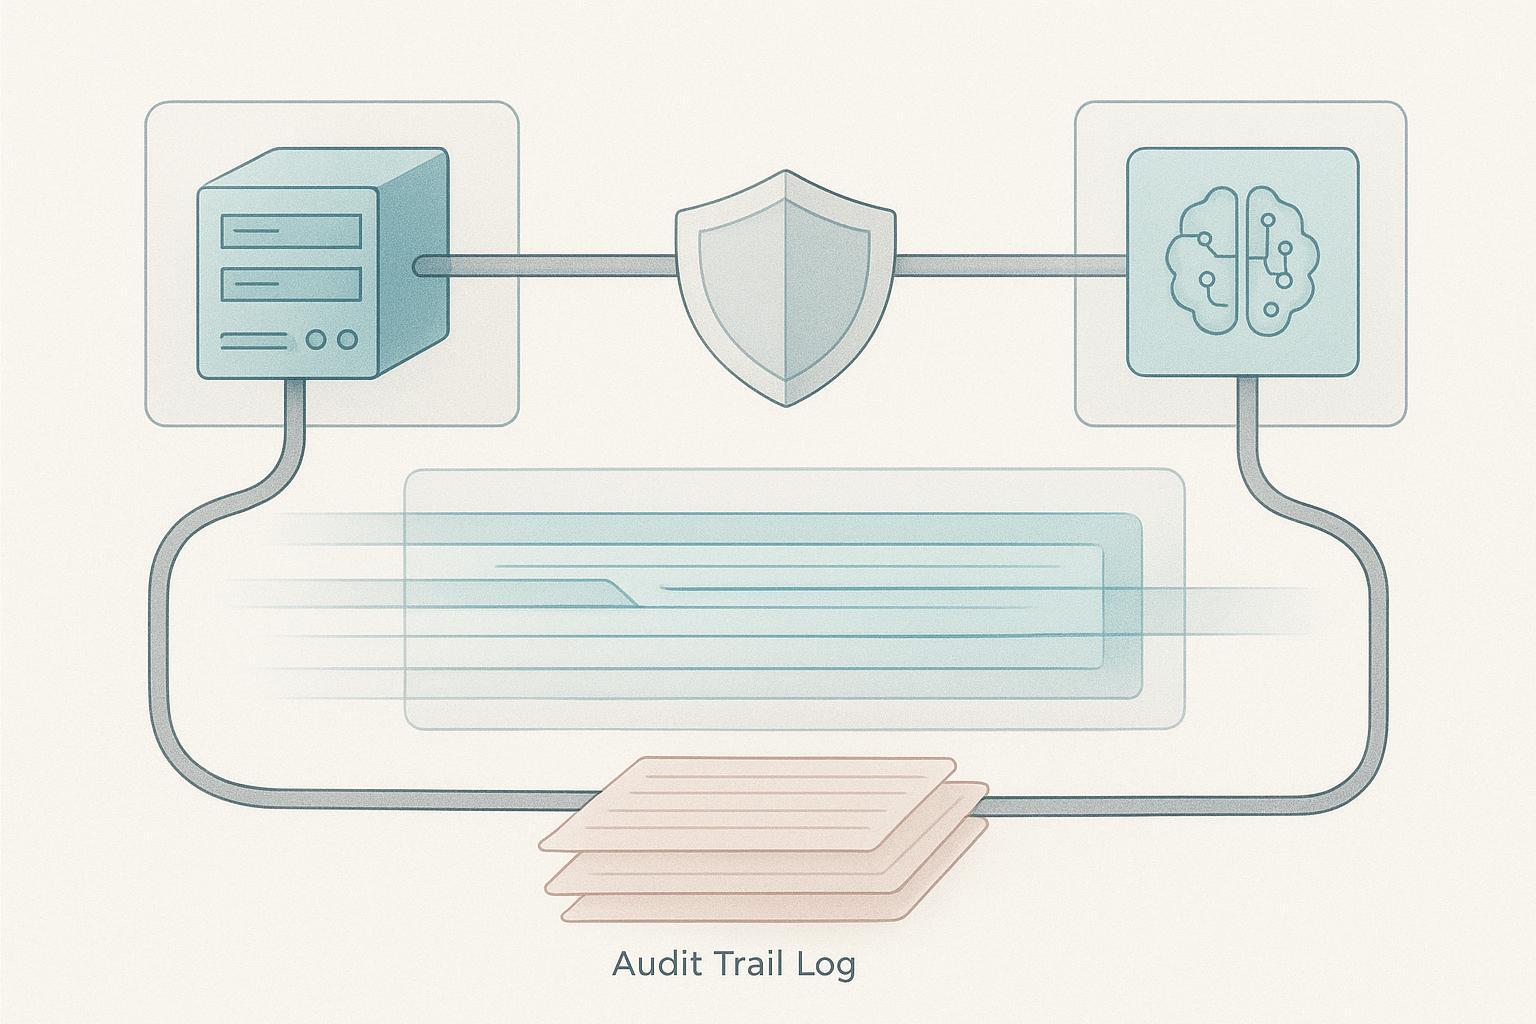
La réponse opérationnelle est un modèle d'accès à plusieurs niveaux plutôt qu'une décision unique de partage de données.. Les sponsors conservent des enregistrements bruts en interne; le partenaire reçoit des représentations anonymisées ou hachées lorsque la tâche de modélisation le permet; seuls les résultats agrégés quittent la collaboration. Limites contractuelles sur ce que le partenaire peut conserver, plus une piste d'audit sur chaque requête sur l'ensemble partagé, boucler la boucle.
Clé à retenir: La désidentification réduit le risque de fuite mais ne l’élimine pas pour les peptides structurellement distinctifs, la hiérarchisation et l'audit des requêtes ont donc un poids que le masquage seul ne peut pas.
Validation scientifique: Un protocole opérationnel, Pas un principe
La validation n'est pas un principe avec lequel vous êtes d'accord. C'est une séquence que tu exécutes: confirmation orthogonale en premier, puis réplication indépendante, puis rapprochement de chaque valeur orientée vers le modèle avec les données analytiques brutes dont elle provient. Sauter la troisième étape est l'échec le plus courant, because a reconciled number and an unreconciled number look identical in a training table.
Define the orthogonal pair per claim type before you generate anything. Pour l'identité, pair intact mass with a second, mechanistically different method rather than a repeat injection on the same instrument. For activity, pair a biophysical binding readout with a cell-based functional readout, parce que les deux répondent à des questions différentes.
Replication must use an independently synthesized lot, not a re-run of the same material. Running the same assay twice on the same lot measures instrument precision, not generalization. UN 2025 systematic review of epitope prediction methods found that many current approaches suffer from overfitting to their training datasets, which drastically limits how well they transfer to new targets (Vaccins npj, 2025-08-30). The same review notes that not all binders are immunogenic: un épitope de premier ordre peut se lier aux anticorps in vitro mais ne parvient pas à provoquer la réponse souhaitée in vivo, et la précision sur un point de référence ne se conserve pas lorsque la lecture, lignée cellulaire, ou le contexte cible diffère.
C'est le mode d'échec contre lequel concevoir. Un ensemble de validation tiré de la même campagne que l'ensemble de formation mesure la mémorisation, not generalization.
L’écart de référence: Ce que la normalisation ne peut toujours pas résoudre
La normalisation est nécessaire mais pas suffisante. Les références du domaine sont nouvelles et étroites, et aucun tableau de bord ne peut encore mesurer ce qu'il prétend mesurer.
PepBenchmark, le benchmark standardisé peptide-ML publié en avril 2026 et présenté à l'ICLR 2026, couvre 29 canonique-peptide plus 6 ensembles de données peptidiques non canoniques à travers 7 groupes, avec un pipeline de prétraitement unifié et un classement couvrant quatre familles de méthodes: Empreinte digitale, GNN, PLM, et des sourires. Ses auteurs affirment clairement que les travaux antérieurs étaient « entravés par l’absence de références standardisées » et souffraient de « problèmes de qualité courants dans les pipelines ad hoc ». C'est une vraie avancée, et c'est aussi un étroit: 35 ensembles de données, un point de référence, une version.
Les limites honnêtes comptent plus pour la planification que le titre. Aucune enquête ne donne un seul pourcentage défendable d’adoption FAIR pour la biopharmaceutique R&D, et aucune étude ne compte la proportion d'articles de découverte de médicaments sur l'IA présentant des fuites ou des défauts de reproductibilité. Toute fiche de score de préparation est donc une aide au jugement, pas une mesure.
⚠️ Attention: Traitez un score de préparation comme un démarreur de conversation structuré, pas une métrique validée. Si un partenaire vous demande à quoi votre score est comparé, la bonne réponse aujourd’hui est « nos propres critères," pas une norme publiée.
Le cadre extérieur arrive, cependant. Le mois de janvier de la FDA 2025 un projet d'orientations sur l'IA dans la prise de décision réglementaire propose une évaluation de la crédibilité basée sur les risques et liée à un contexte d'utilisation déclaré. C'est un brouillon, pas pour la mise en œuvre, et il régit les soumissions plutôt que la découverte. Quand même, cela souligne la question à laquelle un programme de préparation devrait être construit pour répondre: à quoi sert ce modèle, et quelles preuves rendent sa production crédible pour cette utilisation?
Commencer: Un pass de préparation aux données peptidiques de 30 jours
Les flux de travail de données peptidiques pour la découverte de médicaments liés à l'IA sont testés plus rapidement en extrayant vingt enregistrements de peptides au hasard et en notant chacun d'entre eux par rapport aux cinq piliers.. C'est une décision de cinq minutes, et cela règle généralement la question de savoir si un programme est prêt pour un partenariat. La plupart des équipes trouvent qu'une poignée de dossiers sont vierges, un groupe plus important est partiellement complet, et quelques-uns ne peuvent pas du tout être reconstruits.
Pour chaque champ qui échoue, décider si l'écart est un problème de capture ou un problème de liaison. Un problème de capture signifie que les données n'ont jamais été enregistrées, donc la solution est un changement par rapport à ce que l'équipe collecte sur le banc. Un problème de liaison signifie que les données existent quelque part mais ne sont pas jointes à un grand nombre, une méthode, ou une lecture de test, donc le correctif est un identifiant et une jointure, pas une nouvelle expérience. Les deux ont des propriétaires différents et des délais différents, et traiter un problème de liaison comme un problème de capture fait perdre des mois.
Ensuite, exécutez un peptide à travers toute la chaîne de bout en bout.: fiche d'identité, certificat d'analyse lié à un lot, fichier analytique lisible par machine. Documentez chaque point où un humain a dû intervenir manuellement. Cette liste d'intervention est la véritable portée du projet de préparation.
L'hésitation courante est que cela nécessite de remplacer la plateforme. Dans la plupart des cas, ce n'est pas le cas. Cela nécessite une discipline de terrain sur les enregistrements que l'équipe produit déjà..
Étape suivante: Exécutez la passe de notation de vingt enregistrements et apportez la liste d'intervention à un examen de l'état de préparation des données techniques, où les lacunes sont mappées à des solutions concrètes.
Foire aux questions
Qu'est-ce qui rend un enregistrement de séquence peptidique et de modification sans ambiguïté?
Un enregistrement sans ambiguïté nomme la structure chimique exacte, ce n'est pas un raccourci qu'un lecteur doit interpréter. Le traitement de référence de la notation de la structure peptidique traite une représentation chimique sans perte comme enregistrement principal, avec HELM utilisé pour les structures sensibles aux polymères et SMILES pour les modèles graphiques au niveau atomique, InChI ou InChIKey comme clés de déduplication et d'identité, cyclisation et liens croisés écrits sous forme d'objets de connexion explicites, et résidus non naturels écrits dans des codes à plusieurs lettres avec des lettres minuscules pour les acides aminés D. Annotation de modification au niveau des résidus, tel qu'utilisé par MAP, maintient un pont lactame distinct d'un disulfure. Un enregistrement qui dit « peptide modifié » sans ce détail est propre mais n'est pas prêt pour l'IA..
HELM ou SMILES sont-ils le meilleur enregistrement principal?
Ni l’un ni l’autre n’est universellement meilleur; le choix suit le modèle qui consommera le disque. HELM préserve la topologie au niveau des polymères et gère proprement les monomères non naturels et les objets de connexion., qui convient au travail sensible aux séquences et aux macrocycles. SMILES donne un graphique au niveau de l'atome que la plupart des réseaux de neurones graphiques et des boîtes à outils cheminformatiques lisent directement. Programmes qui doivent à la fois stocker l'un comme enregistrement principal et générer l'autre, avec InChIKey comme clé de jointure pour que la même molécule ne soit jamais comptée deux fois.
Dans quelle mesure le contexte du test est suffisant?
Assez pour qu'un autre laboratoire puisse répéter la mesure et interpréter le nombre. Au minimum: type de test et lecture, cibler et construire, lignée ou matrice cellulaire, plage de concentration, conditions d'incubation, méthode de détection, et les unités. UN 2025 une revue systématique des prédicteurs d'épitopes a révélé qu'un épitope de premier rang peut se lier aux anticorps in vitro tout en étant faiblement immunogène in vivo, et cette précision ne se transfère pas lors de la lecture, la lignée cellulaire ou le contexte cible diffère. Une valeur de liaison sans contexte ne peut pas être regroupée avec quoi que ce soit.
Un indice de pureté unique est-il toujours acceptable?
Seulement comme titre, jamais comme le record. Je Q2(R2)Les exigences en matière de plage de validation définissent la déclaration des impuretés à partir du seuil jusqu'à 120% de la limite de spécification, et pourcentage de zone de pureté de 80% à 100% des limites de spécification, avec des limites de détection et de quantification autour de rapports signal sur bruit d'environ 3:1 et 10:1. Les données sur les impuretés peptidiques et l'historique des lots qui ne contiennent que « 98 % de pureté » cachent quelles impuretés, à quel niveau, par quelle méthode. Gardez le numéro, puis attachez le profil derrière. Production de peptides À propos
Comment partager des structures avec un partenaire sans exposer la série principale?
Partagez le modèle ou les fonctionnalités dérivées plutôt que l'ensemble d'entraînement brut, et testez ce que la sortie révèle. Les attaques par inférence d'adhésion qui récupèrent les molécules d'entraînement à partir d'un modèle servi identifient les molécules d'entraînement à partir des seuls logits de sortie., et les molécules de classe minoritaire et les nouvelles molécules d'échafaudage sont les plus vulnérables, avec des attaques combinées augmentant encore le risque. Si un partenaire a lui-même besoin des données, utiliser un environnement contrôlé avec un ensemble de fonctionnalités convenues et une piste d'audit plutôt qu'un transfert de fichiers.
Un modèle peut-il être validé sans lot indépendant?
Non. Un modèle validé uniquement sur des lots il a déjà vu des rapports de mémorisation, not generalization. Retenez au moins un lot par programme, idéalement issu d'une autre campagne de synthèse, et gardez-le intact jusqu'à l'évaluation finale. S'il n'existe aucun lot indépendant, la déclaration honnête est que le modèle est cohérent en interne, non validé.
Le projet de lignes directrices de la FDA s'applique-t-il aux travaux en phase de découverte?
Pas directement, mais c'est l'énoncé le plus clair disponible de la norme à laquelle vous serez éventuellement tenu de respecter. Le mois de janvier de la FDA 2025 un projet d'orientations sur l'IA dans la prise de décision réglementaire propose une évaluation de la crédibilité basée sur les risques et liée à un contexte d'utilisation déclaré. Il s'agit d'un projet daté 6 Janvier 2025 et n'est pas destiné à la mise en œuvre. Les équipes de découverte qui documentent le contexte d'utilisation maintenant n'auront pas à le reconstruire plus tard.
Clé à retenir: Une affirmation de préparation n'est défendable que lorsqu'elle nomme les champs d'enregistrement, l'architecture de partage et le protocole de validation, pas quand il rapporte un numéro de pureté.
Conclusion
La préparation est une propriété du dossier, pas du modèle, et c'est là que les flux de travail de données sur les peptides de test pour la découverte de médicaments liés à l'IA sont désormais confrontés dans chaque conversation de partenariat.. Les cinq piliers, notation de séquence et de modification sans ambiguïté, contexte de test qui accompagne le résultat, profils d'impuretés plutôt qu'un seul chiffre de pureté, certificats d'analyse liés à des lots, et sortie analytique standardisée lisible par machine, sont la liste de contrôle. Une architecture de confidentialité et un protocole de validation écrit vous permettent de partager cet enregistrement sans céder la responsabilité..
Les cadres de référence et réglementaires sont encore en formation: PepBenchmark 2026 il est tôt, et le projet de lignes directrices de la FDA n'est pas encore rédigé pour être mis en œuvre. Un programme de préparation construit maintenant répond à une question que les partenaires poseront plus formellement plus tard, alors construisez-le pour qu'il soit réévalué plutôt que certifié une fois. Ce guide est une aide au jugement, pas une mesure. Il n’existe aucun pourcentage d’adoption FAIR défendable à l’échelle du domaine ni aucun décompte de défauts de fuite., donc un tableau de bord ici soutient une décision plutôt que d'en régler une.
MOL Changes publie en tant que fournisseur de peptides.
Découvrez où vos enregistrements peptidiques échoueraient par rapport au modèle d'un partenaire. Un examen de l'état de préparation des données techniques mappe vos enregistrements peptidiques par rapport aux cinq piliers et classe chaque lacune comme un problème de capture ou un problème de liaison.. Demander un examen de l'état de préparation des données avec notre équipe d'analyse.