Qué requieren realmente los flujos de trabajo de datos de péptidos para el descubrimiento de fármacos mediante IA
Los flujos de trabajo de datos de péptidos para el descubrimiento de fármacos con IA son el mantenimiento de registros, analítico, y prácticas de gobernanza que hacen que un conjunto de datos de péptidos sea utilizable por máquina mediante un modelo predictivo. Cubren cinco áreas: registros de secuencia y modificación, contexto del ensayo, datos de impurezas, historial de lotes, y resultados analíticos estandarizados. Lo que los diferencia de los consejos genéricos de preparación de datos es que cada requisito llega al nivel de un campo de registro individual., y cada uno tiene que sobrevivir tanto a una revisión de confidencialidad como a un protocolo de validación documentado..
La barra de nivel récord es la parte que la mayoría de los equipos subestiman. El tratamiento de referencia de la notación de la estructura peptídica sostiene que los canales de aprendizaje automático funcionan mejor a partir de una representación química sin pérdidas como registro principal., con codificaciones específicas del modelo derivadas de él en lugar de almacenarse como fuente de verdad (Anotación de estructuras peptídicas utilizando SMILES y otros códigos químicos, 2017). En ese enfoque, InChIKey actúa como clave de identidad y deduplicación, mientras que la ciclación y los enlaces cruzados deben escribirse como objetos de conexión explícitos en lugar de dejarlos implícitos..
Los reguladores se mueven en la misma dirección. El informe de enero de la FDA 2025 El proyecto de guía sobre IA en la toma de decisiones regulatorias introduce una evaluación de credibilidad basada en riesgos vinculada a un contexto de uso definido. (Borrador de guía de la FDA, contenido actual 2025-01-06). es un borrador, no para implementación, pero indica que los conjuntos de datos de péptidos listos para la IA se juzgarán por su trazabilidad y no por su volumen..
Conclusión clave: Tres cosas distinguen estos flujos de trabajo de la limpieza de datos ordinaria: requisitos de registro a nivel de campo, Mecanismos de confidencialidad que permiten a los socios compartir sin exponer un cliente potencial., y un protocolo de validación operativa en lugar de un principio declarado.
Dos conceptos erróneos causan la mayor parte de la confusión.. "Datos limpios" no significa "datos seleccionados", Una hoja de cálculo ordenada aún puede resultar inutilizable para un modelo.. Y un único número de pureza no describe un péptido.; Los datos del historial de lotes y de impurezas contienen la información de la que un modelo realmente puede aprender.. Esta sección se basa en literatura sobre notación de estructuras revisada por pares y en la guía regulatoria actual., sin fuentes de proveedores.
Por qué son importantes ahora los flujos de trabajo de datos de péptidos para el descubrimiento de fármacos mediante IA
Los flujos de trabajo de datos de péptidos para el descubrimiento de fármacos con IA son importantes porque ahora el dinero se mueve antes que los datos.. En el 2026 Rastreador de acuerdos de IA publicado por VLS Research, Los anticipos revelados se agrupan entre 30 y 50 millones de dólares frente a valores principales superiores a 1.000 millones de dólares., Aproximadamente entre el 2% y el 3% del valor principal se paga en efectivo. (Investigación VLS, Rastreador de acuerdos de descubrimiento de fármacos con IA 2026, recuperado 2026-07-03). Isomorphic Labs: Eli Lilly muestra unos 45 millones de dólares por adelantado frente a más de 1.700 millones de dólares en hitos; Noetik-GSK muestra 50 millones de dólares por adelantado en una estructura de licencia de cinco años. Tenga en cuenta la fuente: un rastreador de analistas, con un proveedor interesado en la narrativa del acuerdo de IA.
La historia clínica es el contrapeso. Alrededor 90% de las moléculas que entran en la clínica nunca llegan a ser aprobadas, y entre el 50% y el 60% de los fracasos de la Fase II se deben a la falta de eficacia, cifras que apenas se han movido en dos décadas (mao z & Yan L, Fronteras en farmacología, recuperado 2026-07-03). Lo mismo 2024 revisión sistemática de 20 Programas impulsados por IA de 2018 a 2023 Se descubrió que la optimización de clientes potenciales asistida por IA reducía el tiempo de selección de candidatos entre un 30% y un 50% en promedio., mientras que el desgaste de las Fases I/II se mantuvo comparable a los puntos de referencia de la industria.
Esa brecha es el punto. Los socios ahora pueden registrarse en un modelo, pero un modelo no puede aprender de registros que nunca capturaron el péptido.
Esto afecta a R&D lleva, química analítica, datos y TI, y los gestores de alianzas que heredan las cuestiones de diligencia tras la firma.
Los cinco pilares de datos de los conjuntos de datos de péptidos preparados para la IA
Los conjuntos de datos de péptidos listos para la IA se construyen a partir de cinco pilares de nivel récord, y juntos forman la lista de verificación de preparación con la que un equipo puede calificarse antes de firmar un acuerdo de asociación.. Cada pilar a continuación está escrito de la misma manera.: por qué es importante, cómo implementarlo, y cómo se ve el fracaso cuando falta. El orden es deliberado.. La identidad es lo primero porque cada campo posterior, Del contexto del ensayo al perfil de impurezas., hereda los errores de un registro de estructura ambigua. Un modelo entrenado con una secuencia mal especificada no falla estrepitosamente; aprende la molécula equivocada e informa predicciones confiables sobre ella.
Califique cada pilar honestamente. Un equipo que puede reconstruir cada péptido a partir de sus propios registros, adjuntar condiciones de ensayo a cada resultado, y rastrear cada lote hasta un certificado de análisis está listo para entregar los datos a un socio. Un equipo que no puede no puede asociarse, pero debería esperar que los primeros meses de colaboración se dediquen a la corrección de datos en lugar de a la capacitación de modelos..
Pastillas 1: Registros de secuencia y modificación inequívocos
La secuencia de péptidos y los registros de modificación son importantes porque un modelo no puede aprender de un péptido que no puede reconstruir, y los errores de identidad se propagan silenciosamente a través de cada predicción posterior. La solución es una representación química sin pérdidas como registro principal., con codificaciones específicas del modelo derivadas de él en lugar de almacenarse como fuente de verdad.
La implementación sigue un pequeño conjunto de convenciones.. HELM maneja estructuras sensibles a los polímeros, incluyendo ramas y monómeros no naturales, mientras que SMILES sirve modelos gráficos a nivel atómico. InChI e InChIKey actúan como claves de identidad y deduplicación en todos los sistemas. La ciclación y los enlaces cruzados pertenecen a objetos de conexión explícitos., nunca como una suposición implícita de que “ciclado” significa lo mismo en todas partes. El tratamiento de referencia de la notación de la estructura peptídica cubre el resto.: códigos de varias letras para residuos no proteicos o no naturales, anotación en minúsculas para D-aminoácidos, y anotación de modificación del nivel de residuos en formato MAP (Revista de quimioinformática / PMC).
El modo de fallo es silencioso y caro.. Un programa registra un puente lactámico y un disulfuro como “ciclados” en el mismo campo, entonces el modelo trata dos andamios químicamente distintos como uno solo. Cada predicción construida sobre esa columna está contaminada., y nada en el proceso lo señala.
Un registro utilizable por modelo para un péptido macrocíclico modificado lleva el campo establecido a continuación. MOL Changes apoya este enfoque de estructura primero en su trabajo de datos de péptidos, y el ejemplo es replicable con cualquier sistema de registro conforme.
|
Campo |
Registro utilizable por modelo |
Registro típico de texto libre |
|---|---|---|
|
Representación primaria |
Cadena HELM con objetos de conexión explícitos |
Secuencia pegada en un campo de notas |
|
Codificación a nivel de átomo |
SONRISAS derivadas del registro HELM |
Ausente |
|
Síntesis de péptidos Clave de identidad |
InChIKey para deduplicación |
Ausente |
|
No natural Péptidos sintéticos residuos |
Códigos de varias letras, definido en una tabla de monómeros |
Aproximaciones de una sola letra |
|
Estereoquímica |
Anotación de D-aminoácidos en minúsculas |
No registrado |
|
Modificaciones |
Anotación MAP a nivel de residuos |
Nota de texto libre, p.ej. “ciclado” |
|
Tipo de ciclación |
Objeto puente explícito con posiciones. |
Ambiguo |
|
Servicios Enlaces cruzados |
Objeto de conexión explícita |
Ausente o implícito |
Pastillas 2: Contexto del ensayo que viaja con el resultado
Una afinidad de unión sin sus condiciones de ensayo no es una etiqueta de entrenamiento, es un numero. El contexto del ensayo tiene que viajar con el resultado.: tipo de ensayo, constructo y especie objetivo, formato de lectura, y si el valor fue medido o predicho.
La distinción entre medición y predicción es donde la mayoría de los conjuntos de datos se rompen silenciosamente.. A 2025 revisión sistemática de predictores de epítopos encontró que solo 174 de 777 (22%) Se confirmó que los péptidos de unión a HLA predichos computacionalmente en un estudio de SARS-CoV-2 se unen de manera estable in vitro (npj vacunas, 2025-08-30). Esa cifra se limita a un solo estudio., no es una tasa de precisión general para la IA en inmunología, pero muestra por qué un valor predicho y un valor medido no pueden compartir una columna sin una bandera que los separe.
⚠️ Advertencia: SPR de agrupación, La polarización de fluorescencia y los valores basados en células en una columna de afinidad entrenan el modelo en el ensayo en lugar de en la química.. El modelo aprende qué laboratorio generó el número., no qué péptido se une.
Pastillas 3: Perfiles de impurezas, Ni un solo número de pureza
Los datos de impurezas de péptidos y del historial de lotes pertenecen al registro como un perfil., no es un porcentaje titular. Dos lotes reportados en 98% puro puede comportarse de manera diferente en un ensayo, y el modelo necesita la envoltura de impurezas y el estado del contraión para ver por qué.
Los efectos contraiónicos están bien documentados.. en un 2025 revisar, El péptido M33 como sal de TFA mostró una citotoxicidad entre un 5% y un 30% mayor hacia las células epiteliales bronquiales normales que su homólogo de acetato., y el péptido MOG formulado con TFA se asoció con la aparición de encefalomielitis aproximadamente 5 días antes con incidencia y gravedad comparables (Biomoléculas, 2025-11-07). Una revisión separada encontró que el cloruro era el menos eficiente de los aniones probados para inducir la estructura helicoidal en LL-37. (Productos farmacéuticos / Moléculas, 2020-12-03). Estas son observaciones que dependen de la formulación., no es una declaración general de que cualquier contraión no sea seguro.
La implementación significa almacenar los tiempos de retención de impurezas., áreas relativas y el estado de intercambio de contraiones junto con la cifra de pureza. Para niveles de validación, Yo Q2(R2) establece el rango de validación en lugar de los límites de pureza de los péptidos: Las pruebas de impurezas deben cubrir el umbral de informe hasta 120% del límite de especificación, y la pureza por porcentaje de área se valida a partir de 80% de la parte inferior a 100% del límite superior de especificación (Yo Q2(R2), directriz final 2023-11-30).
Pastillas 4: Historial de lotes y certificados de análisis vinculados a lotes
La confianza modelo es una propiedad de trazabilidad, por eso los números de lote, La vinculación del certificado de análisis y el historial de reevaluaciones pertenecen al conjunto de datos y no solo al sistema de gestión de calidad.. Las expectativas de ALCOA+ que ahora deben satisfacer los canales de IA/ML son un estándar GMP preexistente extendido a un nuevo caso de uso., no es una nueva regla inventada para los modelos. El linaje de datos se señala como una preocupación crítica a medida que AI/ML se integra con MES y LIMS, y el hilo digital se define como la cadena ininterrumpida de relaciones de datos desde las pruebas de la materia prima hasta la fabricación y el lanzamiento del producto final. (Perspectivas regulatorias para la implementación de IA/ML, PMC, 2025-06-16).
Para propina: Conservar el historial de nuevas pruebas y ensayos en lugar de sobrescribirlo. Comercio él. Un valor reemplazado con una marca de tiempo es evidencia; un valor reemplazado es una brecha.
El modo de fracaso es una campaña de doble conteo.. Tres ensayos realizados en el mismo lote se ingresan como tres observaciones independientes, y el modelo trata un lote como tres, Inflar la confianza en un resultado que nunca se replicó..
Pastillas 5: Resultados analíticos estandarizados y formatos legibles por máquina
Los resultados analíticos estandarizados para la IA de péptidos dependen de los formatos que una canalización puede analizar sin limpieza manual. Ya existen estándares legibles por máquina para la capa analítica: mzML para datos de espectrometría de masas sin procesar, mzIdentML y mzTab para identificaciones y cuantificación, PX-XML para metadatos de envío, SDRF-Proteómica para relaciones de muestra y exposición., y USI para identificadores de espectro estables (Infraestructura de datos proteómica).
La reproducibilidad también requiere el bloque de método completo.. Los parámetros del método HPLC incluyen la química de la columna. (típicamente C18), tamaño de partículas y poros, dimensiones de la columna, fases móviles y modificadores, programa de gradiente, tasa de flujo (alrededor 1.0 mL/min analítico), temperatura de la columna, longitud de onda de detección (típicamente 214-220 nm para péptidos) y cantidad de inyección. La identidad debe confirmarse mediante LC-MS de masa intacta o MALDI-TOF con masa observada versus masa teórica y una ventana de aceptación de ppm o Da indicada., no solo por HPLC (Centro de conocimiento de HPLC Phenomenex, 2026-07-29).
El modo de falla es un registro que dice "gradiente RP-HPLC estándar". Sin el bloque de método, el resultado no puede servir como ancla de validación, y un compañero no puede reproducirlo.
Confidencialidad: Compartir datos de péptidos sin filtrar el plomo
El riesgo de confidencialidad en las asociaciones de péptidos de IA es mensurable, no teórico. A 2025 Un estudio de redes neuronales de descubrimiento de fármacos encontró que en un escenario de caja negra donde solo se exponen los logits de salida, como un modelo ofrecido como servicio web, Los ataques de inferencia de membresía identificaron qué estructuras químicas habían estado en el conjunto de entrenamiento., y combinar varios ataques aumentaba el riesgo (La publicación de redes neuronales en el descubrimiento de fármacos podría comprometer la confidencialidad, 2025-03-26). Los autores señalan que las moléculas de clases minoritarias, A menudo es el más valioso en el descubrimiento de fármacos., son particularmente vulnerables, y que las estructuras únicas que difieren de los compuestos de la biblioteca establecida pueden corresponder a pistas patentadas o nuevos andamios en desarrollo..
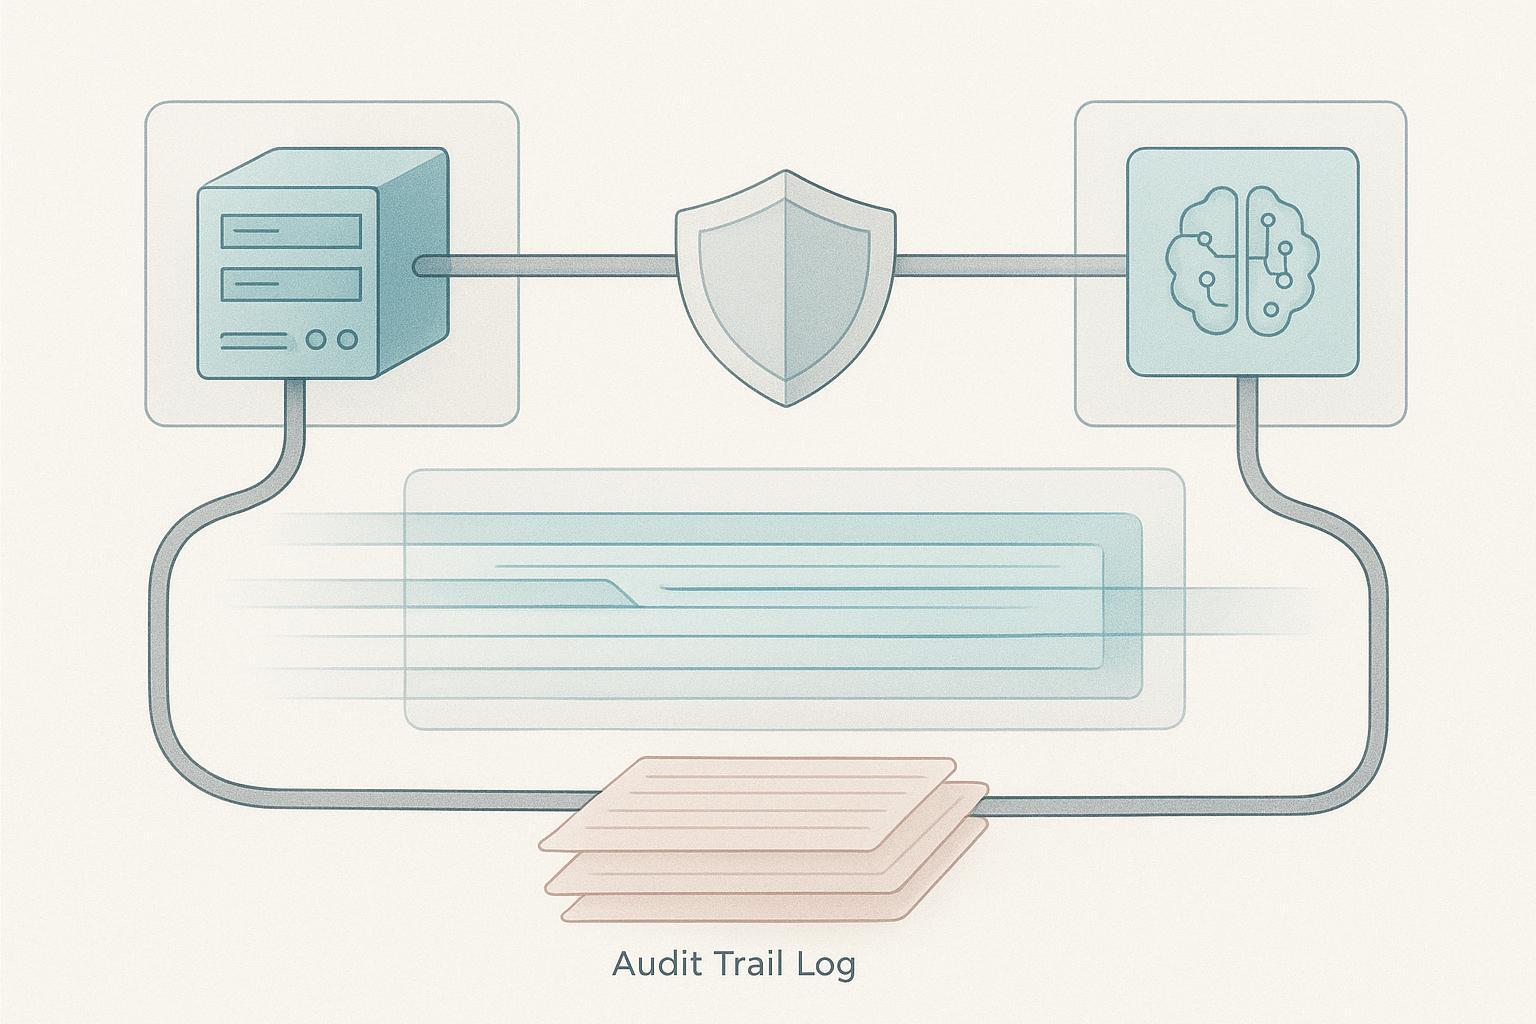
La respuesta operativa es un modelo de acceso escalonado en lugar de una única decisión de intercambio de datos.. Los patrocinadores mantienen registros sin procesar internamente; el socio recibe representaciones no identificadas o hash cuando la tarea de modelado lo permite; sólo los resultados agregados abandonan la colaboración. Límites contractuales a lo que el socio puede retener, además de un seguimiento de auditoría en cada consulta del conjunto compartido, cerrar el ciclo.
Conclusión clave: La desidentificación reduce el riesgo de fuga pero no lo elimina para péptidos estructuralmente distintivos, por lo que la auditoría de consultas y niveles tiene el peso que el enmascaramiento por sí solo no puede.
Validación científica: Un protocolo operativo, No es un principio
La validación no es un principio con el que estás de acuerdo. Es una secuencia que ejecutas.: confirmación ortogonal primero, luego replicación independiente, luego, la conciliación de cada valor orientado al modelo con los datos analíticos sin procesar de los que provino. Saltarse el tercer paso es el fallo más común, porque un número conciliado y un número no conciliado parecen idénticos en una tabla de entrenamiento.
Defina el par ortogonal por tipo de reclamo antes de generar algo. Por identidad, emparejar masa intacta con una segunda, método mecánicamente diferente en lugar de una inyección repetida en el mismo instrumento. Para actividad, emparejar una lectura de unión biofísica con una lectura funcional basada en células, porque los dos responden preguntas diferentes.
La replicación debe utilizar un lote sintetizado de forma independiente., no es una repetición del mismo material. Realizar el mismo ensayo dos veces en el mismo lote mide la precisión del instrumento, no generalización. A 2025 Una revisión sistemática de los métodos de predicción de epítopos encontró que muchos enfoques actuales sufren de sobreajuste en sus conjuntos de datos de entrenamiento., lo que limita drásticamente su transferencia a nuevos objetivos (npj vacunas, 2025-08-30). La misma revisión señala que no todos los aglutinantes son inmunogénicos.: un epítopo de primer nivel puede unirse a anticuerpos in vitro pero no lograr provocar la respuesta deseada in vivo, y la precisión en un punto de referencia no se transfiere cuando la lectura, linea celular, o el contexto objetivo difiere.
Ese es el modo de falla contra el cual diseñar. Un conjunto de validación extraído de la misma campaña que el conjunto de entrenamiento mide la memorización., no generalización.
La brecha de referencia: Lo que la estandarización aún no puede solucionar
La estandarización es necesaria pero no suficiente. Los puntos de referencia del campo son nuevos y estrechos, y ningún cuadro de mando puede todavía medir lo que dice medir.
PepBenchmark, el punto de referencia estandarizado de péptido-ML publicado en abril 2026 y presentado en ICLR 2026, cubre 29 péptido canónico plus 6 conjuntos de datos de péptidos no canónicos en 7 grupos, con un canal de preprocesamiento unificado y una tabla de clasificación que abarca cuatro familias de métodos: Huella dactilar, GNN, PLM, y SONRISAS. Sus autores afirman claramente que el trabajo anterior se vio "obstaculizado por la ausencia de puntos de referencia estandarizados" y sufrió "problemas de calidad comunes en los proyectos ad hoc". Eso es un verdadero avance., y también es angosto: 35 conjuntos de datos, un punto de referencia, un lanzamiento.
Los límites honestos importan más para la planificación que el titular. Ninguna encuesta proporciona un porcentaje único defendible de adopción FAIR para la biofarmacéutica R&D, y ningún estudio cuenta la proporción de artículos sobre descubrimiento de fármacos de IA con fugas o defectos de reproducibilidad.. Por lo tanto, cualquier cuadro de mando de preparación es una ayuda para el juicio., no es una medida.
⚠️ Advertencia: Trate una puntuación de preparación como un punto de partida de una conversación estructurada., no es una métrica validada. Si un socio le pregunta con qué se compara su puntuación, la respuesta correcta hoy es “nuestro propio criterio,"no es un estándar publicado.
El marco externo está llegando., aunque. El informe de enero de la FDA 2025 El proyecto de guía sobre IA en la toma de decisiones regulatorias propone una evaluación de credibilidad basada en riesgos vinculada a un contexto de uso declarado.. es un borrador, no para implementación, y gobierna las presentaciones en lugar del descubrimiento.. Aún así, apunta a la pregunta para la cual se debe crear un programa de preparación: para que sirve este modelo, y qué evidencia hace que su producción sea creíble para ese uso?
Empezando: Un pase de preparación de datos de péptidos de 30 días
Los flujos de trabajo de datos de péptidos para el descubrimiento de fármacos mediante IA se prueban más rápido al extraer veinte registros de péptidos al azar y calificar cada uno según los cinco pilares.. Esa es una decisión de cinco minutos., y generalmente resuelve la cuestión de si un programa está listo para asociarse. La mayoría de los equipos encuentran que un puñado de registros están limpios., un grupo más grande está parcialmente completo, y algunos no pueden reconstruirse en absoluto.
Por cada campo que falla, decidir si la brecha es un problema de captura o un problema de vinculación. Un problema de captura significa que los datos nunca se registraron, entonces la solución es un cambio en lo que el equipo recolecta en el banquillo. Un problema de vinculación significa que los datos existen en algún lugar pero no están unidos a muchos, un método, o una lectura de ensayo, entonces la solución es un identificador y una unión, no es un nuevo experimento. Los dos tienen diferentes propietarios y diferentes cronogramas., y tratar un problema de vinculación como un problema de captura desperdicia meses.
Luego pase un péptido a través de la cadena completa de extremo a extremo.: registro de identidad, certificado de análisis vinculado al lote, archivo analítico legible por máquina. Documente a mano cada punto donde un humano tuvo que intervenir. Esa lista de intervención es el alcance real del proyecto de preparación..
La duda común es que esto requiere reemplazar la plataforma.. En la mayoría de los casos no. Requiere disciplina a nivel de campo en los registros que el equipo ya produce..
Siguiente paso: Ejecute el pase de puntuación de veinte registros y lleve la lista de intervenciones a una revisión de preparación de datos técnicos, donde las brechas se asignan a soluciones concretas.
Preguntas frecuentes
¿Qué hace que una secuencia peptídica y un registro de modificación sean inequívocos??
Un registro inequívoco nombra la estructura química exacta., no es una taquigrafía que el lector tenga que interpretar. El tratamiento de referencia de la notación de la estructura peptídica trata una representación química sin pérdidas como registro principal., con HELM utilizado para estructuras con reconocimiento de polímeros y SMILES para modelos de gráficos a nivel atómico, InChI o InChIKey como claves de identidad y deduplicación, ciclación y enlaces cruzados escritos como objetos de conexión explícitos, y residuos no naturales escritos en códigos de varias letras con letras minúsculas para D-aminoácidos. Anotación de modificación del nivel de residuo, como lo utiliza MAP, Mantiene un puente lactama distinguible de un disulfuro.. Un registro que dice "péptido modificado" sin ese detalle tiene un aspecto limpio pero no está preparado para la IA.
¿HELM o SMILES son el mejor registro primario??
Ninguno de los dos es universalmente mejor; la elección sigue el modelo que consumirá el registro. HELM conserva la topología a nivel de polímero y maneja monómeros no naturales y objetos de conexión de forma limpia, que se adapta al trabajo consciente de secuencias y macrociclos. SMILES ofrece un gráfico a nivel atómico que la mayoría de las redes neuronales gráficas y los kits de herramientas de quimioinformática leen directamente.. Programas que necesitan almacenar uno como registro principal y generar el otro., con InChIKey como clave de unión para que la misma molécula nunca se cuente dos veces.
¿Cuánto contexto de ensayo es suficiente??
Suficiente para que un laboratorio diferente pudiera repetir la medición e interpretar el número.. Como mínimo: tipo de ensayo y lectura, apuntar y construir, línea celular o matriz, rango de concentración, condiciones de incubación, método de detección, y las unidades. A 2025 Una revisión sistemática de los predictores de epítopos encontró que un epítopo mejor clasificado puede unirse a anticuerpos in vitro pero ser poco inmunogénico in vivo., y esa precisión no se transfiere cuando se lee, la línea celular o el contexto objetivo difieren. Un valor vinculante sin contexto no se puede combinar con nada.
¿Es alguna vez aceptable un único número de pureza??
Sólo como titular, nunca como el récord. Yo Q2(R2)Los requisitos del rango de validación establecen informes de impurezas desde el umbral hasta 120% del límite de especificación, y porcentaje de área de pureza de 80% a 100% de los límites de especificación, con límites de detección y cuantificación en torno a relaciones señal-ruido de aproximadamente 3:1 y 10:1. Los datos de impurezas de péptidos y del historial de lotes que contienen solo "98 % de pureza" ocultan qué impurezas, a que nivel, por qué método. Mantenga el número, luego coloque el perfil detrás de él. Producción de péptidos Acerca de
¿Cómo compartimos estructuras con un socio sin exponer la serie principal??
Comparta el modelo o las características derivadas en lugar del conjunto de entrenamiento sin procesar., y probar lo que revela el resultado. Los ataques de inferencia de membresía que recuperan moléculas de entrenamiento de un modelo servido identifican moléculas de entrenamiento solo a partir de logits de salida, y las moléculas de clase minoritaria y de estructura novedosa son las más vulnerables, con ataques combinados que aumentan aún más el riesgo. Si un socio necesita los datos por sí mismo, Utilice un entorno controlado con un conjunto de funciones acordado y un registro de auditoría en lugar de una transferencia de archivos..
¿Se puede validar un modelo sin un lote independiente??
No. Un modelo validado sólo en lotes que ya ha visto informes de memorización, no generalización. Retener al menos un lote por programa, idealmente de una campaña de síntesis diferente, y mantenerlo intacto hasta la evaluación final. Si no existe ningún lote independiente, La afirmación honesta es que el modelo es internamente consistente., no validado.
¿Se aplica el borrador de la guía de la FDA al trabajo en etapa de descubrimiento??
No directamente, pero es la declaración más clara disponible del estándar al que eventualmente se le exigirá. El informe de enero de la FDA 2025 El proyecto de guía sobre IA en la toma de decisiones regulatorias propone una evaluación de credibilidad basada en riesgos vinculada a un contexto de uso declarado.. Es un borrador fechado 6 Enero 2025 y no es para implementación. Los equipos de descubrimiento que documenten el contexto de uso ahora no tendrán que reconstruirlo más adelante..
Conclusión clave: Una afirmación de preparación sólo es defendible cuando nombra los campos del registro, la arquitectura de intercambio y el protocolo de validación, no cuando informa un número de pureza.
Conclusión
La preparación es una propiedad del registro., no del modelo, y ese es el flujo de trabajo de datos de péptidos de prueba para el descubrimiento de fármacos con IA que ahora enfrentan en cada conversación de asociación.. Los cinco pilares, notación de secuencia y modificación inequívoca, contexto del ensayo que viaja con el resultado, Perfiles de impurezas en lugar de una única cifra de pureza., certificados de análisis vinculados a lotes, y salida analítica estandarizada legible por máquina, son la lista de verificación. La arquitectura de confidencialidad y un protocolo de validación escrito son los que le permiten compartir ese registro sin entregar el liderazgo..
Los marcos de referencia y regulatorios aún se están formando: PepBenchmark 2026 es temprano, y el borrador de la guía de la FDA aún no está escrito para su implementación. Un programa de preparación creado ahora responde a una pregunta que los socios harán más formalmente más adelante, así que constrúyalo para volver a calificarlo en lugar de certificarlo una vez. Esta guía es una ayuda para el juicio., no es una medida. No existe un porcentaje defendible de adopción FAIR en todo el campo ni un recuento de defectos de fuga, por lo que aquí un cuadro de mando respalda una decisión en lugar de resolverla.
MOL Changes se publica como proveedor de péptidos.
Descubra dónde sus registros de péptidos fallarían en el modelo de un socio. Una revisión técnica de la preparación de los datos relaciona sus registros de péptidos con los cinco pilares y clasifica cada brecha como un problema de captura o un problema de vinculación.. Solicite una revisión de preparación de datos con nuestro equipo analítico.