Hvad peptiddataarbejdsgange til AI Drug Discovery faktisk kræver
Peptiddataarbejdsgange til opdagelse af AI-lægemidler er journalføringen, analytisk, og forvaltningspraksis, der gør et peptiddatasæt maskinanvendeligt ved hjælp af en forudsigelig model. De dækker fem områder: sekvens- og ændringsoptegnelser, assay kontekst, urenhedsdata, batch historie, og standardiserede analyseresultater. Det, der adskiller dem fra generiske råd om databeredskab, er, at hvert krav lander på niveau med et individuelt registreringsfelt, og hver enkelt skal overleve både en fortrolighedsgennemgang og en dokumenteret valideringsprotokol.
Baren på rekordniveau er den del, de fleste hold undervurderer. Referencebehandlingen af peptidstrukturnotation hævder, at maskinlæringspipelines fungerer bedst fra en tabsfri kemisk repræsentation som den primære registrering, med modelspecifikke kodninger afledt af den i stedet for lagret som kilden til sandheden (Annotering af peptidstrukturer ved hjælp af SMILES og andre kemiske koder, 2017). I den tilgang, InChIKey fungerer som en identitets- og deduplikeringsnøgle, mens cyklisering og tværbindinger skal skrives som eksplicitte forbindelsesobjekter i stedet for venstre implicitte.
Regulatorerne bevæger sig i samme retning. FDA's januar 2025 udkast til vejledning om kunstig intelligens i lovgivningsmæssig beslutningstagning introducerer en risikobaseret troværdighedsvurdering knyttet til en defineret brugskontekst (FDA udkast til vejledning, aktuelle indhold 2025-01-06). Det er et udkast, ikke til implementering, men det signalerer, at AI-klare peptiddatasæt vil blive bedømt på sporbarhed frem for volumen.
Nøgle takeaway: Tre ting adskiller disse arbejdsgange fra almindelig dataoprydning: registreringskrav på feltniveau, fortrolighedsmekanik, der lader partnere dele uden at afsløre et kundeemne, og en operationel valideringsprotokol snarere end et erklæret princip.
To misforståelser forårsager det meste af forvirringen. "Rene data" betyder ikke "kurerede data", et ryddeligt regneark kan stadig være ubrugeligt af en model. Og et enkelt renhedsnummer beskriver ikke et peptid; urenheds- og batchhistorikdata indeholder de oplysninger, som en model faktisk kan lære af. Dette afsnit trækker på peer-reviewed struktur-notation litteratur og aktuelle lovgivningsmæssige vejledning, uden leverandørkilder.
Hvorfor Peptide Data Workflows for AI Drug Discovery betyder noget nu
Peptiddataarbejdsgange til opdagelse af AI-lægemidler betyder noget, fordi pengene nu flytter sig, før dataene gør. I den 2026 AI deal tracker udgivet af VLS Research, afsløret upfronts-klynge på $30-50 mio. mod overskriftsværdier over $1 mia, ca. 2-3 % af overordnet værdi betalt som kontanter (VLS forskning, AI Drug Discovery Deal Tracker 2026, hentet 2026-07-03). Isomorphic Labs-Eli Lilly viser omkring $45M på forhånd mod over $1,7B i milepæle; Noetik–GSK viser $50 millioner på forhånd på en fem-årig licensstruktur. Bemærk kilden: en analytiker tracker, med en leverandørinteresse i AI-aftalens fortælling.
Den kliniske journal er modvægten. Omkring 90% af molekyler, der kommer ind i klinikken, bliver aldrig godkendt, og 50-60 % af fase II-fejl skyldes manglende effekt, figurer, der knap har bevæget sig i to årtier (Mao Z & Yan L, Grænser i farmakologi, hentet 2026-07-03). Det samme 2024 systematisk gennemgang af 20 AI-drevne programmer fra 2018 til 2023 fandt AI-assisteret leadoptimering reducerede kandidatscreeningstiden med 30-50 % i gennemsnit, mens fase I/II-nedslidning forblev sammenlignelig med industriens benchmarks.
Det hul er pointen. Partnere kan nu logge på en model, men en model kan ikke lære af optegnelser, der aldrig fangede peptidet.
Dette påvirker R&D fører, analytisk kemi, data og IT, og alliancecheferne, der arver flid-spørgsmål efter underskrift.
De fem datasøjler i AI-klare peptiddatasæt
AI-klare peptiddatasæt er bygget af fem søjler på rekordniveau, og sammen danner de den parathedstjekliste, som et hold kan score sig mod, inden de underskriver en partnerskabsaftale. Hver søjle nedenfor er skrevet på samme måde: hvorfor det betyder noget, hvordan man implementerer det, og hvordan fejlen ser ud, når den mangler. Ordren er bevidst. Identitet kommer først, fordi hvert downstream felt, fra analysekontekst til urenhedsprofil, arver fejlene i en flertydig strukturpost. En model trænet i en forkert specificeret sekvens fejler ikke højlydt; det lærer det forkerte molekyle og rapporterer sikre forudsigelser om det.
Score hver søjle ærligt. Et hold, der kan rekonstruere hvert peptid fra dets egne optegnelser, vedhæft analysebetingelser til hvert resultat, og spore hvert parti til et analysecertifikat er klar til at aflevere data til en partner. Et hold, der ikke kan, er ikke blokeret fra partnerskab, men det skal forventes, at de første måneder af samarbejdet bliver brugt på datasanering frem for modeltræning.
Piller 1: Entydige sekvens- og ændringsposter
Peptidsekvens- og modifikationsregistre betyder noget, fordi en model ikke kan lære af et peptid, den ikke kan rekonstruere, og identitetsfejl forplanter sig lydløst gennem hver nedstrøms forudsigelse. Rettelsen er en tabsfri kemisk repræsentation som den primære registrering, med modelspecifikke kodninger afledt af den i stedet for lagret som kilden til sandheden.
Implementeringen følger et lille sæt konventioner. HELM håndterer polymer-bevidste strukturer, herunder grene og ikke-naturlige monomerer, mens SMILES serverer grafmodeller på atomniveau. InChI og InChIKey fungerer som deduplikering og identitetsnøgler på tværs af systemer. Cyclisering og tværbindinger hører hjemme i eksplicitte forbindelsesobjekter, aldrig som en implicit antagelse om, at "cykliseret" betyder det samme overalt. Referencebehandlingen af peptidstrukturnotation dækker resten: flerbogstavskoder for ikke-protein- eller ikke-naturlige rester, annotation med små bogstaver for D-aminosyrer, og restniveau-modifikationsannotering i MAP-format (Journal of Cheminformatics / PMC).
Fejltilstanden er stille og dyr. Et program registrerer en lactambro og et disulfid som "cykliseret" i samme felt, så modellen behandler to kemisk adskilte stilladser som ét. Hver forudsigelse bygget på den kolonne er forurenet, og intet i pipelinen markerer det.
En modelanvendelig registrering for et modificeret makrocyklisk peptid bærer feltsættet nedenfor. MOL Changes understøtter denne struktur-første tilgang i sit peptiddataarbejde, og eksemplet kan kopieres med ethvert konformt registreringssystem.
|
Felt |
Modelbrugbar rekord |
Typisk fritekstpost |
|---|---|---|
|
Primær repræsentation |
HELM-streng med eksplicitte forbindelsesobjekter |
Sekvens indsat i et notefelt |
|
Kodning på atomniveau |
SMILES afledt af HELM-posten |
Fraværende |
|
Peptidsyntese Identitetsnøgle |
InChIKkey til deduplikering |
Fraværende |
|
Ikke-naturlig Syntetiske peptider rester |
Koder med flere bogstaver, defineret i en monomertabel |
Enkeltbogstavs tilnærmelser |
|
Stereokemi |
D-aminosyreannotation med små bogstaver |
Ikke optaget |
|
Ændringer |
MAP-annotering på restniveau |
Fritekstnotat, f.eks. "cykliseret" |
|
Cykling type |
Eksplicit broobjekt med positioner |
Tvetydigt |
|
Tjenester Tværbindinger |
Eksplicit forbindelsesobjekt |
Fraværende eller underforstået |
Piller 2: Assaykontekst, der følger med resultatet
En bindingsaffinitet uden dens assaybetingelser er ikke et træningsmærke, det er et tal. Assay kontekst skal rejse med resultatet: analysetype, målkonstruktion og art, udlæsningsformat, og om værdien blev målt eller forudsagt.
Den målte-versus-forudsagte skelnen er, hvor de fleste datasæt stille og roligt går i stykker. EN 2025 systematisk gennemgang af epitop-prædiktorer fandt kun, at 174 af 777 (22%) beregningsmæssigt forudsagte HLA-bindende peptider i et SARS-CoV-2-studie blev bekræftet at binde stabilt in vitro (npj Vacciner, 2025-08-30). Det tal er beregnet til en enkelt undersøgelse, ikke en generel nøjagtighedsrate for AI i immunologi, men det viser, hvorfor en forudsagt værdi og en målt værdi ikke kan dele en kolonne uden et flag, der adskiller dem.
⚠️ Advarsel: Pooling SPR, fluorescenspolarisering og cellebaserede værdier i en affinitetskolonne træner modellen på analysen i stedet for kemien. Modellen lærer, hvilket laboratorium der har genereret tallet, ikke hvilket peptid der binder.
Piller 3: Urenhedsprofiler, Ikke et enkelt renhedsnummer
Peptidurenhed og batchhistorikdata hører hjemme i posten som en profil, ikke en overskriftsprocent. To lodder anmeldt kl 98% pure kan opføre sig anderledes i et assay, og modellen har brug for urenhedsindhylningen og modiontilstanden for at se hvorfor.
Modvirkninger er veldokumenterede. I en 2025 anmeldelse, M33-peptidet som et TFA-salt viste 5-30 % større cytotoksicitet over for normale bronkiale epitelceller end acetatmodstykket, og MOG-peptid formuleret med TFA var groft forbundet med encephalomyelitis-debut 5 dage tidligere ved sammenlignelig forekomst og sværhedsgrad (Biomolekyler, 2025-11-07). En separat gennemgang fandt, at chlorid var den mindst effektive af de testede anioner til at inducere spiralstruktur i LL-37 (Lægemidler / Molekyler, 2020-12-03). Disse er formuleringsafhængige observationer, ikke en generel erklæring om, at enhver modion er usikker.
Implementering betyder lagring af urenhedsretentionstider, relative områder og modionbyttertilstanden ved siden af renhedstallet. Til valideringsniveauer, I Q2(R2) indstiller valideringsintervallet i stedet for peptidrenhedsgrænser: urenhedstest skal dække indberetningstærsklen op til 120% af specifikationsgrænsen, og renhed efter arealprocent er valideret fra 80% af den nederste til 100% af den øvre specifikationsgrænse (I Q2(R2), endelige retningslinje 2023-11-30).
Piller 4: Batchhistorik og lot-linkede analysecertifikater
Modeltillid er en sporbarhedsegenskab, derfor lot numre, kobling af analysecertifikat og re-testhistorik hører hjemme i datasættet snarere end kun i kvalitetsstyringssystemet. ALCOA+-forventningerne, som AI/ML-pipelines nu skal opfylde, er en allerede eksisterende GMP-standard udvidet til en ny use case, ikke en ny regel opfundet for modeller. Dataafstamning er markeret som en kritisk bekymring, da AI/ML integreres med MES og LIMS, og den digitale tråd er defineret som den ubrudte kæde af datarelationer fra råmaterialetestning gennem fremstilling til endelig produktudgivelse (Regulatoriske perspektiver for AI/ML-implementering, PMC, 2025-06-16).
Til tip: Behold re-test og re-assay historie i stedet for at overskrive Butik det. En erstattet værdi med et tidsstempel er bevis; en udskiftet værdi er et hul.
Fejltilstanden er en dobbelttællet kampagne. Tre analyser, der køres på det samme parti, indtastes som tre uafhængige observationer, og modellen behandler en batch som tre, øge tilliden til et resultat, der aldrig blev gentaget.
Piller 5: Standardiserede analytiske resultater og maskinlæsbare formater
Standardiserede analytiske resultater for peptid AI afhænger af formater, som en pipeline kan parse uden manuel oprydning. Der findes allerede maskinlæsbare standarder for det analytiske lag: mzML til rå massespektrometridata, mzIdentML og mzTab til identifikation og kvantificering, PX-XML til indsendelsesmetadata, SDRF-Proteomics til prøve- og eksponeringsforhold, og USI for stabile spektrumidentifikatorer (Proteomics datainfrastruktur).
Reproducerbarhed kræver også den fulde metodeblok. HPLC-metodeparametre omfatter søjlekemi (typisk C18), partikel- og porestørrelse, søjle dimensioner, mobile faser og modifikatorer, gradient program, flowhastighed (omkring 1.0 ml/min analytisk), kolonnetemperatur, detektionsbølgelængde (typisk 214-220 nm for peptider) og injektionsmængde. Identitet skal bekræftes af intakt masse LC-MS eller MALDI-TOF med observeret versus teoretisk masse og et angivet ppm eller Da acceptvindue, ikke ved HPLC alene (Phenomenex HPLC videncenter, 2026-07-29).
Fejltilstanden er en post, der siger "standard RP-HPLC-gradient." Uden metodeblokken, resultatet kan ikke tjene som et valideringsanker, og en partner kan ikke gengive det.
Fortrolighed: Deling af peptiddata uden at lække blyet
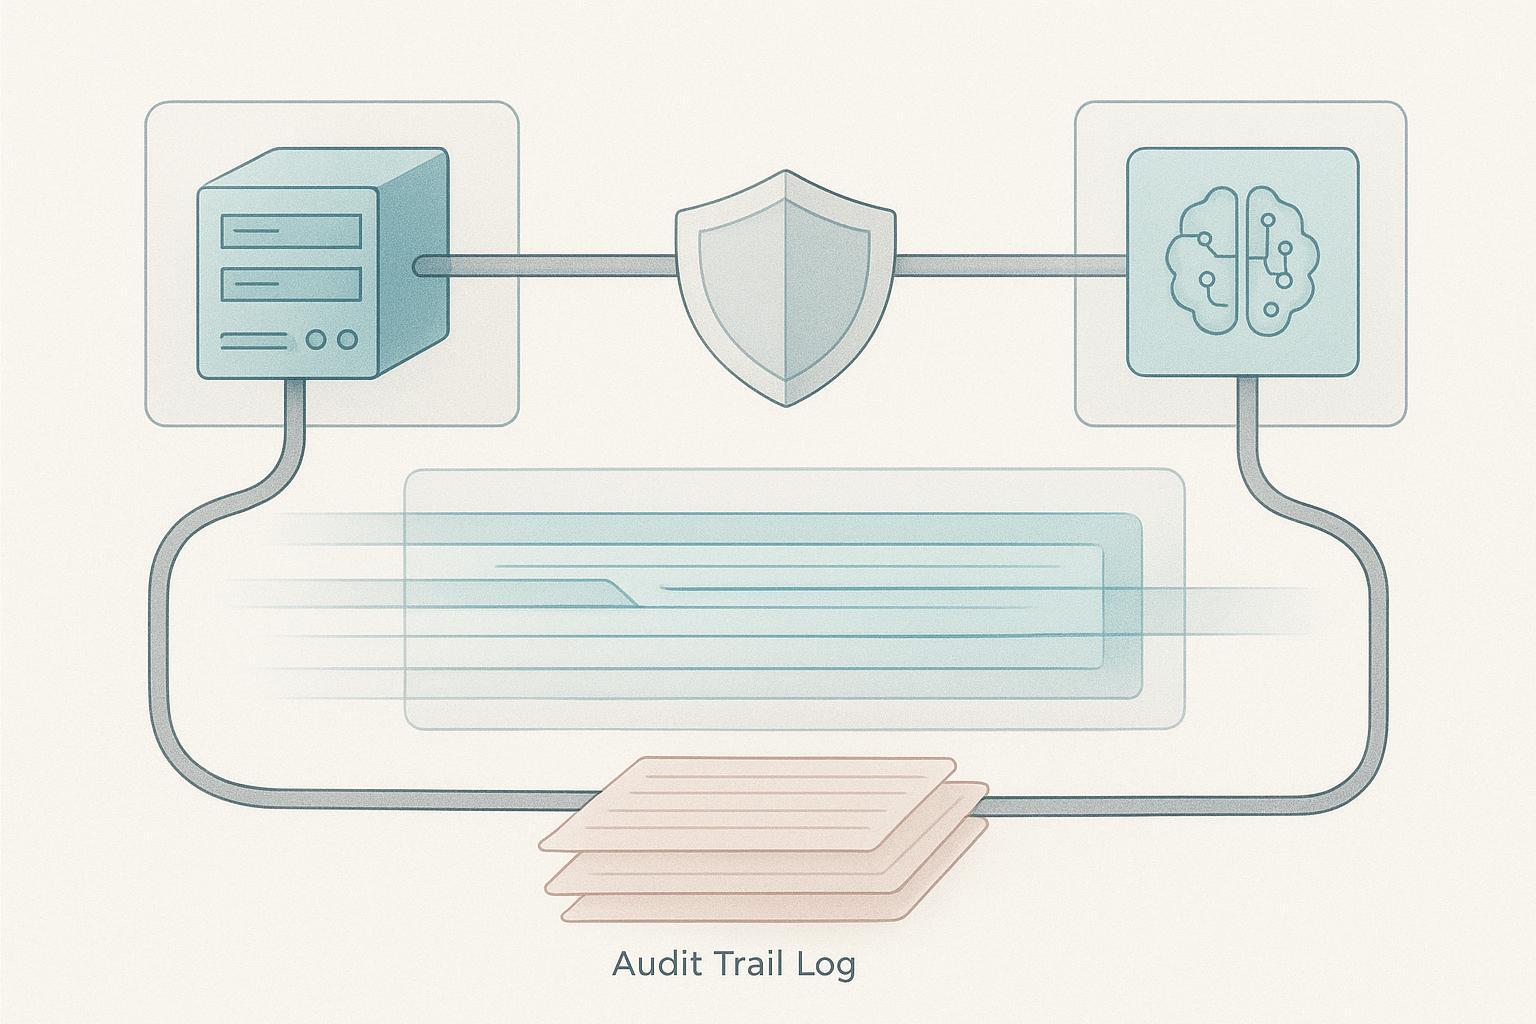
Fortrolighedsrisikoen i AI-peptidpartnerskaber er målbar, ikke teoretisk. EN 2025 undersøgelse af neurale netværk til opdagelse af lægemidler fandt, at i et black-box-scenarie, hvor kun output-logits er afsløret, såsom en model, der tilbydes som en webservice, medlemskabsslutningsangreb identificerede, hvilke kemiske strukturer der havde været i træningssættet, og at kombinere flere angreb øgede risikoen (Udgivelse af neurale netværk i lægemiddelopdagelse kan kompromittere fortroligheden, 2025-03-26). Forfatterne bemærker, at molekyler fra minoritetsklasser, ofte den mest værdifulde i lægemiddelopdagelse, er særligt udsatte, og at unikke strukturer, der adskiller sig fra etablerede biblioteksforbindelser, kan svare til proprietære kundeemner eller nye stilladser under udvikling.
Det operationelle svar er en trindelt adgangsmodel snarere end en enkelt beslutning om datadeling. Sponsorer fører rå optegnelser internt; partneren modtager de-identificerede eller hash-repræsentationer, hvor modelleringsopgaven tillader det; kun samlede output forlader samarbejdet. Aftalemæssige grænser for, hvad partneren må beholde, plus et revisionsspor på hver forespørgsel mod det delte sæt, luk løkken.
Nøgle takeaway: Afidentifikation reducerer risikoen for lækage, men eliminerer den ikke for strukturelt karakteristiske peptider, så niveaudeling og forespørgselsrevision bærer den vægt, som maskering alene ikke kan.
Videnskabelig validering: En operationel protokol, Ikke et princip
Validering er ikke et princip, du er enig i. Det er en sekvens, du kører: ortogonal bekræftelse først, derefter uafhængig replikation, derefter afstemning af hver model-vendte værdi tilbage til de rå analytiske data, den kom fra. At springe det tredje trin over er den mest almindelige fejl, fordi et afstemt tal og et uafstemt tal ser identiske ud i en træningstabel.
Definer det ortogonale par pr. kravtype, før du genererer noget. For identitet, parre intakt masse med en anden, mekanistisk anderledes metode frem for en gentagen injektion på det samme instrument. Til aktivitet, parre en biofysisk bindingsudlæsning med en cellebaseret funktionel udlæsning, fordi de to besvarer forskellige spørgsmål.
Replikering skal bruge et uafhængigt syntetiseret parti, ikke en genudsendelse af det samme materiale. Kørsel af det samme assay to gange på det samme parti måler instrumentets præcision, ikke generalisering. EN 2025 systematisk gennemgang af epitopforudsigelsesmetoder viste, at mange nuværende tilgange lider af overtilpasning til deres træningsdatasæt, hvilket drastisk begrænser, hvor godt de overfører til nye mål (npj Vacciner, 2025-08-30). Den samme anmeldelse bemærker, at ikke alle bindemidler er immunogene: en toprangeret epitop kan binde antistoffer in vitro og alligevel ikke fremkalde det tilsigtede respons in vivo, og nøjagtighed på et benchmark overføres ikke, når udlæsningen, cellelinje, eller målkonteksten er forskellig.
Det er fejltilstanden at designe imod. Et valideringssæt hentet fra den samme kampagne som træningssættet måler huske, ikke generalisering.
Benchmark Gap: Hvad standardisering stadig ikke kan rette
Standardisering er nødvendig, men ikke tilstrækkelig. Feltets pejlemærker er nye og smalle, og intet scorekort kan endnu måle, hvad det hævder at måle.
PepBenchmark, det standardiserede peptid-ML benchmark udgivet i april 2026 og præsenteret på ICLR 2026, dækker 29 kanonisk-peptid plus 6 ikke-kanoniske peptiddatasæt på tværs 7 grupper, med en samlet forbehandlingspipeline og et leaderboard, der spænder over fire metodefamilier: Fingeraftryk, GNN, PLM, og SMIL. Dets forfattere siger klart, at tidligere arbejde var "hæmmet af fraværet af standardiserede benchmarks" og led "kvalitetsproblemer, der var almindelige i ad hoc-pipelines." Det er et reelt fremskridt, og den er også en smal: 35 datasæt, ét benchmark, en udgivelse.
De ærlige grænser betyder mere for planlægningen, end overskriften gør. Ingen undersøgelse giver en enkelt forsvarlig FAIR-adoptionsprocent for biopharma R&D, og ingen undersøgelse tæller andelen af AI-lægemiddelopdagelsespapirer med lækage eller reproducerbarhedsfejl. Ethvert parathedsscorekort er derfor en bedømmelseshjælp, ikke en måling.
⚠️ Advarsel: Behandl en parathedsscore som en struktureret samtalestarter, ikke en valideret metrik. Hvis en partner spørger, hvad din score er benchmarked imod, det rigtige svar i dag er "vores egne kriterier,” ikke en offentliggjort standard.
Den eksterne ramme ankommer, selvom. FDA's januar 2025 udkast til vejledning om kunstig intelligens i lovgivningsmæssig beslutningstagning foreslår en risikobaseret troværdighedsvurdering knyttet til en angivet brugskontekst. Det er et udkast, ikke til implementering, og det styrer indsendelser snarere end opdagelse. Alligevel, det peger på spørgsmålet, et beredskabsprogram bør bygges til at besvare: hvad er denne model til, og hvilke beviser gør dets output troværdigt til den brug?
Kom godt i gang: Et 30-dages Peptid Data Readiness Pass
Peptiddataarbejdsgange til AI-lægemiddelopdagelse testes hurtigst ved at trække tyve peptidposter tilfældigt og score hver enkelt mod de fem søjler. Det er en beslutning på fem minutter, og det afgør normalt spørgsmålet om, hvorvidt et program er partnerskabsparat. De fleste hold oplever, at en håndfuld rekorder er rene, en større gruppe er delvist komplet, og nogle få kan slet ikke rekonstrueres.
For hvert felt der fejler, beslutte, om kløften er et fangstproblem eller et koblingsproblem. Et optagelsesproblem betyder, at dataene aldrig blev registreret, så rettelsen er en ændring af, hvad holdet samler på bænken. Et koblingsproblem betyder, at data eksisterer et eller andet sted, men ikke er forbundet med en masse, en metode, eller en analyseaflæsning, så rettelsen er en identifikator og en join, ikke et nyt eksperiment. De to har forskellige ejere og forskellige tidslinjer, og behandling af et koblingsproblem som et fangstproblem spilder måneder.
Kør derefter et peptid gennem hele kæden ende til ende: identitetsjournal, lot-linked analysecertifikat, maskinlæsbar analytisk fil. Dokumenter hvert punkt, hvor et menneske skulle gribe ind med håndkraft. Den interventionsliste er det reelle omfang af beredskabsprojektet.
Den almindelige tøven er, at dette kræver udskiftning af platformen. I de fleste tilfælde gør det ikke. Det kræver disciplin på feltniveau på optegnelser, som holdet allerede producerer.
Næste skridt: Kør tyve-records-scoringspas, og bring interventionslisten til en teknisk databeredskabsgennemgang, hvor hullerne bliver kortlagt til konkrete rettelser.
Ofte stillede spørgsmål
Hvad gør en peptidsekvens og modifikationsregistrering utvetydig?
En utvetydig optegnelse navngiver den nøjagtige kemiske struktur, ikke en stenografi, som en læser skal fortolke. Referencebehandlingen af peptidstrukturnotation behandler en tabsfri kemisk repræsentation som den primære registrering, med HELM brugt til polymerbevidste strukturer og SMILES til grafmodeller på atomniveau, InChI eller InChIKey som deduplikering og identitetsnøgler, cyklisering og tværbindinger skrevet som eksplicitte forbindelsesobjekter, og ikke-naturlige rester skrevet i flerbogstavskoder med små bogstaver for D-aminosyrer. Modifikationsannotation på restniveau, som brugt af MAP, holder en lactambro, der kan skelnes fra et disulfid. En post, der siger "modificeret peptid" uden den detalje, ser rent ud, men ikke AI-klar.
Er HELM eller SMILES den bedste primære rekord?
Hverken er universelt bedre; valget følger den model, der vil forbruge rekorden. HELM bevarer topologi på polymerniveau og håndterer ikke-naturlige monomerer og forbindelsesobjekter rent, som passer til sekvensbevidst og makrocyklusarbejde. SMILES giver en graf på atomniveau, som de fleste grafer af neurale netværk og keminformatikværktøjer læser direkte. Programmer, der både skal gemme den ene som den primære post og generere den anden, med InChIKey som joinnøgle, så det samme molekyle aldrig tælles to gange.
Hvor meget analysekontekst er nok?
Nok til at et andet laboratorium kunne gentage målingen og fortolke tallet. Som minimum: analysetype og udlæsning, mål og konstruere, cellelinje eller matrix, koncentrationsområde, inkubationsbetingelser, detektionsmetode, og enhederne. EN 2025 systematisk gennemgang af epitop-prædiktorer fandt, at en toprangeret epitop kan binde antistoffer in vitro og alligevel være dårligt immunogen in vivo, og at nøjagtigheden ikke overføres ved aflæsning, cellelinje eller målkontekst er forskellig. En bindende værdi uden kontekst kan ikke samles med noget som helst.
Er et enkelt renhedstal nogensinde acceptabelt?
Kun som overskrift, aldrig som rekord. I Q2(R2)'s krav til valideringsområde sætter urenhedsrapportering fra tærsklen op til 120% af specifikationsgrænsen, og renhedsarealprocent fra 80% til 100% af specifikationsgrænser, med detektions- og kvantificeringsgrænser omkring signal-til-støj-forhold på ca 3:1 og 10:1. Peptid urenheder og batch historie data, der kun bærer "98% ren" skjuler hvilke urenheder, på hvilket niveau, med hvilken metode. Behold nummeret, fastgør derefter profilen bagved. Peptid produktion Om
Hvordan deler vi strukturer med en partner uden at afsløre lead-serien?
Del modellen eller de afledte funktioner i stedet for det rå træningssæt, og test, hvad output afslører. Medlemskabs-inferensangreb, der genvinder træningsmolekyler fra en serveret model, identificerer træningsmolekyler fra outputlogits alene, og minoritetsklassen og nye stilladsmolekyler er de mest sårbare, med kombinerede angreb øger risikoen yderligere. Hvis en partner selv har brug for dataene, bruge et kontrolleret miljø med et aftalt funktionssæt og et revisionsspor frem for en filoverførsel.
Kan en model valideres uden et selvstændigt parti?
Ingen. En model, der kun er valideret på partier, den har allerede set rapporterer memorering, ikke generalisering. Hold mindst et parti tilbage pr. program, ideelt set fra en anden syntesekampagne, og hold det urørt indtil den endelige evaluering. Hvis der ikke findes et selvstændigt parti, det ærlige udsagn er, at modellen er internt konsistent, ikke valideret.
Gælder FDA-udkastet til vejledning for arbejde på opdagelsesstadiet?
Ikke direkte, men det er den klarest tilgængelige erklæring om den standard, du i sidste ende vil blive holdt til. FDA's januar 2025 udkast til vejledning om kunstig intelligens i lovgivningsmæssig beslutningstagning foreslår en risikobaseret troværdighedsvurdering knyttet til en angivet brugskontekst. Det er et udkast dateret 6 januar 2025 og er ikke til implementering. Discovery-teams, der dokumenterer brugskonteksten nu, behøver ikke at rekonstruere den senere.
Nøgle takeaway: Et beredskabskrav er kun forsvarligt, når det navngiver postfelterne, delingsarkitekturen og valideringsprotokollen, ikke når den rapporterer et renhedsnummer.
Konklusion
Parathed er en egenskab, ikke af modellen, og det er de testpeptiddata-workflows for opdagelse af AI-lægemidler nu står over for i hver partnerskabssamtale. De fem søjler, utvetydig rækkefølge og modifikationsnotation, assay kontekst, der rejser med resultatet, urenhedsprofiler i stedet for et enkelt renhedstal, lot-linked analysecertifikater, og maskinlæsbart standardiseret analytisk output, er tjeklisten. Fortrolighedsarkitektur og en skriftlig valideringsprotokol er det, der lader dig dele denne registrering uden at overdrage leadet.
Benchmark og regulatoriske rammer er stadig ved at danne sig: PepBenchmark 2026 er tidligt, og FDA-udkastet til vejledning er endnu ikke skrevet til implementering. Et beredskabsprogram, der er bygget nu, besvarer et spørgsmål, som partnere vil stille mere formelt senere, så byg den til at blive genbedømt i stedet for at blive certificeret én gang. Denne vejledning er en bedømmelseshjælp, ikke en måling. Der eksisterer ingen forsvarlig FAIR-vedtagelsesprocent eller lækagedefektantal i hele felten, så et scorecard her understøtter en beslutning frem for at afgøre en.
MOL Changes udgiver som peptidleverandør.
Find ud af, hvor dine peptidregistreringer ville svigte en partners model. En teknisk databeredskabsgennemgang kortlægger dine peptidregistreringer mod de fem søjler og klassificerer hvert hul som et indfangningsproblem eller et koblingsproblem. Anmod om en gennemgang af databeredskab med vores analytiske team.