Quy trình làm việc dữ liệu peptide để khám phá thuốc AI thực sự yêu cầu
Quy trình xử lý dữ liệu peptide để khám phá thuốc AI là công cụ lưu giữ hồ sơ, phân tích, và các phương pháp quản trị giúp bộ dữ liệu peptide có thể sử dụng được bằng mô hình dự đoán. Chúng bao gồm năm lĩnh vực: hồ sơ trình tự và sửa đổi, bối cảnh khảo nghiệm, dữ liệu tạp chất, lịch sử lô, và kết quả phân tích được chuẩn hóa. Điều khác biệt giữa chúng với lời khuyên chung về tính sẵn sàng của dữ liệu là mọi yêu cầu đều nằm ở cấp độ trường bản ghi riêng lẻ., và mỗi người phải vượt qua cả quá trình đánh giá tính bảo mật và giao thức xác thực được ghi lại.
Thanh kỷ lục là phần mà hầu hết các đội đều đánh giá thấp. Cách xử lý tham chiếu của ký hiệu cấu trúc peptide cho thấy rằng các đường dẫn máy học hoạt động tốt nhất từ biểu diễn hóa học không mất dữ liệu làm bản ghi chính, với các mã hóa dành riêng cho từng mô hình bắt nguồn từ nó thay vì được lưu trữ dưới dạng nguồn sự thật (Chú thích cấu trúc peptide sử dụng SMILES và các mã hóa học khác, 2017). Trong cách tiếp cận đó, InChIKey hoạt động như một khóa nhận dạng và chống trùng lặp, trong khi chu kỳ và liên kết chéo phải được viết dưới dạng đối tượng kết nối rõ ràng thay vì để ngầm.
Cơ quan quản lý đang di chuyển theo cùng một hướng. Tháng 1 của FDA 2025 dự thảo hướng dẫn về AI trong việc ra quyết định theo quy định đưa ra đánh giá độ tin cậy dựa trên rủi ro gắn liền với bối cảnh sử dụng xác định (Dự thảo hướng dẫn của FDA, nội dung hiện tại 2025-01-06). Đó là một bản dự thảo, không phải để thực hiện, nhưng nó báo hiệu rằng các bộ dữ liệu peptide sẵn sàng cho AI sẽ được đánh giá dựa trên khả năng truy xuất nguồn gốc thay vì khối lượng.
Chìa khóa mang đi: Ba điều phân biệt các quy trình công việc này với việc dọn dẹp dữ liệu thông thường: yêu cầu về bản ghi cấp trường, cơ chế bảo mật cho phép các đối tác chia sẻ mà không để lộ thông tin khách hàng tiềm năng, và một giao thức xác nhận hoạt động chứ không phải là một nguyên tắc đã nêu.
Hai quan niệm sai lầm gây ra hầu hết sự nhầm lẫn. “Dữ liệu sạch” không có nghĩa là “dữ liệu được tuyển chọn”, một bảng tính ngăn nắp vẫn có thể không được người mẫu sử dụng. Và một con số độ tinh khiết duy nhất không mô tả được một peptit; dữ liệu lịch sử lô và tạp chất mang thông tin mà một mô hình thực sự có thể học được từ đó. Phần này dựa trên tài liệu ký hiệu cấu trúc được bình duyệt và hướng dẫn quy định hiện hành, không có nguồn nhà cung cấp.
Tại sao quy trình làm việc dữ liệu peptide cho việc khám phá thuốc AI lại quan trọng hiện nay
Quy trình làm việc của dữ liệu peptide để phát hiện thuốc AI rất quan trọng vì tiền hiện đang di chuyển trước khi dữ liệu diễn ra. trong 2026 Trình theo dõi giao dịch AI được xuất bản bởi VLS Research, cụm chi phí trả trước được tiết lộ ở mức 30–50 triệu đô la so với các giá trị tiêu đề trên 1 tỷ đô la, khoảng 2–3% giá trị tiêu đề được thanh toán bằng tiền mặt (Nghiên cứu VLS, Trình theo dõi giao dịch khám phá thuốc AI 2026, đã lấy lại 2026-07-03). Phòng thí nghiệm đẳng hình–Eli Lilly cho thấy khoảng 45 triệu đô la trả trước so với hơn 1,7 tỷ đô la ở các mốc quan trọng; Noetik–GSK cho thấy mức trả trước 50 triệu USD cho cơ cấu cấp phép 5 năm. Ghi chú nguồn: một người theo dõi nhà phân tích, với sự quan tâm của nhà cung cấp đối với câu chuyện về thỏa thuận AI.
Hồ sơ bệnh án là đối trọng. Xung quanh 90% của các phân tử vào phòng khám không bao giờ đạt được sự chấp thuận, và 50–60% thất bại ở Giai đoạn II là do thiếu hiệu quả, những con số hầu như không di chuyển trong hai thập kỷ (Mao Z & Yến L, Biên giới trong dược lý, đã lấy lại 2026-07-03). Giống nhau 2024 xem xét có hệ thống 20 Các chương trình điều khiển bằng AI từ 2018 ĐẾN 2023 nhận thấy tính năng tối ưu hóa khách hàng tiềm năng được hỗ trợ bởi AI giúp giảm thời gian sàng lọc ứng viên trung bình 30–50%, trong khi mức tiêu hao Giai đoạn I/II vẫn tương đương với mức chuẩn của ngành.
Khoảng cách đó chính là điểm. Giờ đây, các đối tác có thể đăng nhập vào một mô hình, nhưng một mô hình không thể học từ những bản ghi không bao giờ thu được peptit.
Điều này ảnh hưởng đến R&D dẫn, hóa học phân tích, dữ liệu và CNTT, và các nhà quản lý liên minh kế thừa các câu hỏi thẩm định sau khi ký kết.
Năm trụ cột dữ liệu của bộ dữ liệu peptide sẵn sàng cho AI
Bộ dữ liệu peptide sẵn sàng cho AI được xây dựng từ năm trụ cột ở mức kỷ lục, và họ cùng nhau tạo thành danh sách kiểm tra mức độ sẵn sàng mà một nhóm có thể tự chấm điểm trước khi ký thỏa thuận hợp tác. Mỗi cột bên dưới được viết giống nhau: tại sao nó lại quan trọng, làm thế nào để thực hiện nó, và thất bại trông như thế nào khi thiếu nó. Lệnh này có chủ ý. Bản sắc được đặt lên hàng đầu vì mọi lĩnh vực hạ nguồn, từ bối cảnh xét nghiệm đến hồ sơ tạp chất, kế thừa các lỗi của một bản ghi cấu trúc không rõ ràng. Một mô hình được đào tạo theo trình tự xác định sai sẽ không thất bại nặng nề; nó học sai phân tử và báo cáo những dự đoán chắc chắn về nó.
Chấm điểm từng trụ cột một cách trung thực. Một nhóm có thể tái tạo lại mọi peptide từ hồ sơ của chính mình, đính kèm các điều kiện xét nghiệm vào mọi kết quả, và theo dõi từng lô để có chứng chỉ phân tích sẵn sàng trao dữ liệu cho đối tác. Một nhóm không thể không bị chặn hợp tác, nhưng dự kiến những tháng hợp tác đầu tiên sẽ được dành cho việc khắc phục dữ liệu thay vì đào tạo mô hình.
thuốc 1: Trình tự rõ ràng và các bản ghi sửa đổi
Trình tự peptide và các bản ghi sửa đổi rất quan trọng vì một mô hình không thể học hỏi từ một peptide mà nó không thể tái tạo lại, và lỗi nhận dạng lan truyền âm thầm qua mọi dự đoán xuôi dòng. Bản sửa lỗi là biểu diễn hóa học không mất dữ liệu làm bản ghi chính, với các mã hóa dành riêng cho từng mô hình bắt nguồn từ nó thay vì được lưu trữ dưới dạng nguồn sự thật.
Việc thực hiện tuân theo một tập hợp nhỏ các quy ước. HELM xử lý các cấu trúc nhận biết polymer, bao gồm các nhánh và các monome phi tự nhiên, trong khi SMILES phục vụ các mô hình đồ thị cấp nguyên tử. InChI và InChIKey đóng vai trò là khóa chống trùng lặp và nhận dạng trên các hệ thống. Chu kỳ và liên kết chéo thuộc về các đối tượng kết nối rõ ràng, không bao giờ là một giả định ngầm rằng “theo chu kỳ” có nghĩa giống nhau ở mọi nơi. Việc xử lý tham chiếu ký hiệu cấu trúc peptide bao gồm phần còn lại: mã nhiều chữ cái cho dư lượng phi protein hoặc phi tự nhiên, chú thích chữ thường cho axit D-amino, và chú thích sửa đổi mức dư lượng ở định dạng MAP (Tạp chí hóa học / PMC).
Chế độ thất bại yên tĩnh và tốn kém. Một chương trình ghi lại cầu nối lactam và disulfide là “được luân chuyển hóa” trong cùng một lĩnh vực, vì vậy mô hình coi hai giàn giáo khác biệt về mặt hóa học là một. Mọi dự đoán được xây dựng trên cột đó đều bị ô nhiễm, và không có gì trong quy trình đánh dấu nó.
Bản ghi có thể sử dụng được theo mô hình cho peptit vòng lớn đã biến đổi mang trường được đặt bên dưới. MOL Changes hỗ trợ phương pháp tiếp cận cấu trúc đầu tiên này trong công việc dữ liệu peptide của nó, và ví dụ này có thể được nhân rộng với bất kỳ hệ thống hồ sơ phù hợp nào.
|
Cánh đồng |
Bản ghi có thể sử dụng được cho mô hình |
Bản ghi văn bản tự do điển hình |
|---|---|---|
|
Đại diện chính |
Chuỗi HELM với các đối tượng kết nối rõ ràng |
Trình tự được dán vào trường ghi chú |
|
Mã hóa cấp độ nguyên tử |
SMILES bắt nguồn từ bản ghi HELM |
Vắng mặt |
|
Tổng hợp peptit Khóa nhận dạng |
InChIKey để chống trùng lặp |
Vắng mặt |
|
Không tự nhiên Peptide tổng hợp dư lượng |
Mã nhiều chữ cái, được xác định trong bảng monome |
Xấp xỉ một chữ cái |
|
Hóa học lập thể |
Chú thích axit D-amino chữ thường |
Không được ghi lại |
|
Sửa đổi |
Chú thích MAP cấp dư lượng |
Ghi chú văn bản tự do, ví dụ. “đi xe đạp” |
|
Kiểu chu kỳ |
Đối tượng cầu rõ ràng với các vị trí |
mơ hồ |
|
Dịch vụ Liên kết chéo |
Đối tượng kết nối rõ ràng |
Vắng mặt hoặc ngụ ý |
thuốc 2: Bối cảnh khảo nghiệm đi kèm với kết quả
Mối quan hệ ràng buộc không có điều kiện xét nghiệm không phải là nhãn huấn luyện, nó là một con số. Bối cảnh khảo nghiệm phải đi kèm với kết quả: loại xét nghiệm, cấu trúc mục tiêu và loài, định dạng đọc, và liệu giá trị đó có được đo lường hay dự đoán hay không.
Sự khác biệt giữa đo lường và dự đoán là điểm mà hầu hết các tập dữ liệu đều lặng lẽ phá vỡ. MỘT 2025 đánh giá có hệ thống về các yếu tố dự đoán epitope cho thấy chỉ 174 của 777 (22%) Các peptide liên kết với HLA được dự đoán bằng máy tính trong một nghiên cứu SARS-CoV-2 đã được xác nhận là liên kết ổn định trong ống nghiệm (Vắc xin npj, 2025-08-30). Con số đó nằm trong phạm vi một nghiên cứu duy nhất, không phải là tỷ lệ chính xác chung cho AI trong miễn dịch học, nhưng nó cho thấy tại sao giá trị dự đoán và giá trị đo được không thể chia sẻ một cột nếu không có cờ ngăn cách chúng.
⚠️ Cảnh báo: SPR gộp chung, phân cực huỳnh quang và các giá trị dựa trên tế bào vào một cột ái lực huấn luyện mô hình về xét nghiệm thay vì hóa học. Mô hình tìm hiểu phòng thí nghiệm nào đã tạo ra số, không phải peptide nào liên kết.
thuốc 3: Hồ sơ tạp chất, Không phải một con số tinh khiết duy nhất
Dữ liệu lịch sử lô và tạp chất peptide được lưu trong hồ sơ dưới dạng hồ sơ, không phải là tỷ lệ phần trăm tiêu đề. Hai lô được báo cáo tại 98% tinh khiết có thể hoạt động khác nhau trong một xét nghiệm, và mô hình cần có đường bao tạp chất và trạng thái phản ứng để hiểu tại sao.
Hiệu ứng phản tác dụng đã được ghi nhận rõ ràng. trong một 2025 ôn tập, peptide M33 dưới dạng muối TFA cho thấy độc tính tế bào cao hơn 5–30% đối với các tế bào biểu mô phế quản bình thường so với đối tác axetat, và MOG peptide được điều chế bằng TFA có liên quan đến việc khởi phát bệnh viêm não tủy 5 ngày trước đó với tỷ lệ mắc và mức độ nghiêm trọng tương đương (Phân tử sinh học, 2025-11-07). Một đánh giá riêng biệt cho thấy clorua có hiệu quả kém nhất trong số các anion được thử nghiệm trong việc tạo ra cấu trúc xoắn ốc trong LL-37 (Dược phẩm / Phân tử, 2020-12-03). Đây là những quan sát phụ thuộc vào công thức, không phải là một tuyên bố chung chung rằng bất kỳ sự phản đối nào đều không an toàn.
Thực hiện nghĩa là lưu trữ thời gian lưu giữ tạp chất, diện tích tương đối và trạng thái trao đổi ion cùng với con số độ tinh khiết. Đối với các bậc xác thực, Tôi quý 2(R2) đặt phạm vi xác nhận thay vì giới hạn độ tinh khiết peptide: kiểm tra tạp chất phải bao gồm ngưỡng báo cáo lên đến 120% giới hạn đặc điểm kỹ thuật, và độ tinh khiết theo phần trăm diện tích được xác nhận từ 80% của mức thấp hơn đến 100% của giới hạn đặc điểm kỹ thuật trên (Tôi quý 2(R2), hướng dẫn cuối cùng 2023-11-30).
thuốc 4: Lịch sử lô và chứng chỉ phân tích liên kết lô
Sự tin cậy của mô hình là một đặc tính truy xuất nguồn gốc, đó là lý do tại sao số lô, liên kết chứng nhận phân tích và lịch sử kiểm tra lại thuộc về tập dữ liệu chứ không chỉ thuộc hệ thống quản lý chất lượng. Những kỳ vọng của ALCOA+ mà quy trình AI/ML hiện phải đáp ứng là tiêu chuẩn GMP đã có từ trước và được mở rộng sang trường hợp sử dụng mới, không phải là một quy tắc mới được phát minh cho các mô hình. Dòng dữ liệu được gắn cờ là mối quan tâm quan trọng khi AI/ML tích hợp với MES và LIMS, và luồng kỹ thuật số được định nghĩa là chuỗi mối quan hệ dữ liệu không bị gián đoạn từ thử nghiệm nguyên liệu thô cho đến sản xuất đến phát hành sản phẩm cuối cùng (Quan điểm pháp lý đối với việc triển khai AI/ML, PMC, 2025-06-16).
Để biết tiền boa: Giữ lại lịch sử kiểm tra lại và xét nghiệm lại thay vì ghi đè Cửa hàng Nó. Giá trị thay thế có dấu thời gian là bằng chứng; một giá trị thay thế là một khoảng cách.
Chế độ thất bại là một chiến dịch được tính hai lần. Ba xét nghiệm chạy trên cùng một lô được nhập dưới dạng ba quan sát độc lập, và mô hình coi một lô là ba, thổi phồng niềm tin vào một kết quả không bao giờ được lặp lại.
thuốc 5: Kết quả phân tích được tiêu chuẩn hóa và định dạng có thể đọc được bằng máy
Các kết quả phân tích được tiêu chuẩn hóa cho peptide AI phụ thuộc vào các định dạng mà đường ống có thể phân tích cú pháp mà không cần dọn dẹp thủ công. Các tiêu chuẩn có thể đọc được bằng máy đã tồn tại cho lớp phân tích: mzML cho dữ liệu khối phổ thô, mzIdentML và mzTab để nhận dạng và định lượng, PX-XML cho siêu dữ liệu gửi, SDRF-Proteomics cho mối quan hệ mẫu và phơi nhiễm, và USI để nhận dạng phổ ổn định (Cơ sở hạ tầng dữ liệu proteomics).
Khả năng tái tạo cũng yêu cầu khối phương thức đầy đủ. Các thông số của phương pháp HPLC bao gồm cột hóa học (điển hình là C18), kích thước hạt và lỗ chân lông, kích thước cột, Pha động và chất biến tính, chương trình gradient, tốc độ dòng chảy (xung quanh 1.0 phân tích mL/phút), nhiệt độ cột, bước sóng phát hiện (thông thường là 214–220 nm đối với peptide) và lượng tiêm. Việc nhận dạng phải được xác nhận bằng LC-MS hoặc MALDI-TOF khối lượng nguyên vẹn với khối lượng quan sát được so với khối lượng lý thuyết và khoảng chấp nhận ppm hoặc Da đã nêu, không chỉ bằng HPLC (Trung tâm kiến thức Phenomenex HPLC, 2026-07-29).
Chế độ lỗi là bản ghi có nội dung “gradient RP-HPLC tiêu chuẩn”. Không có khối phương thức, kết quả không thể đóng vai trò là điểm neo xác thực, và đối tác không thể tái tạo nó.
Bảo mật: Chia sẻ dữ liệu peptide mà không làm rò rỉ chì
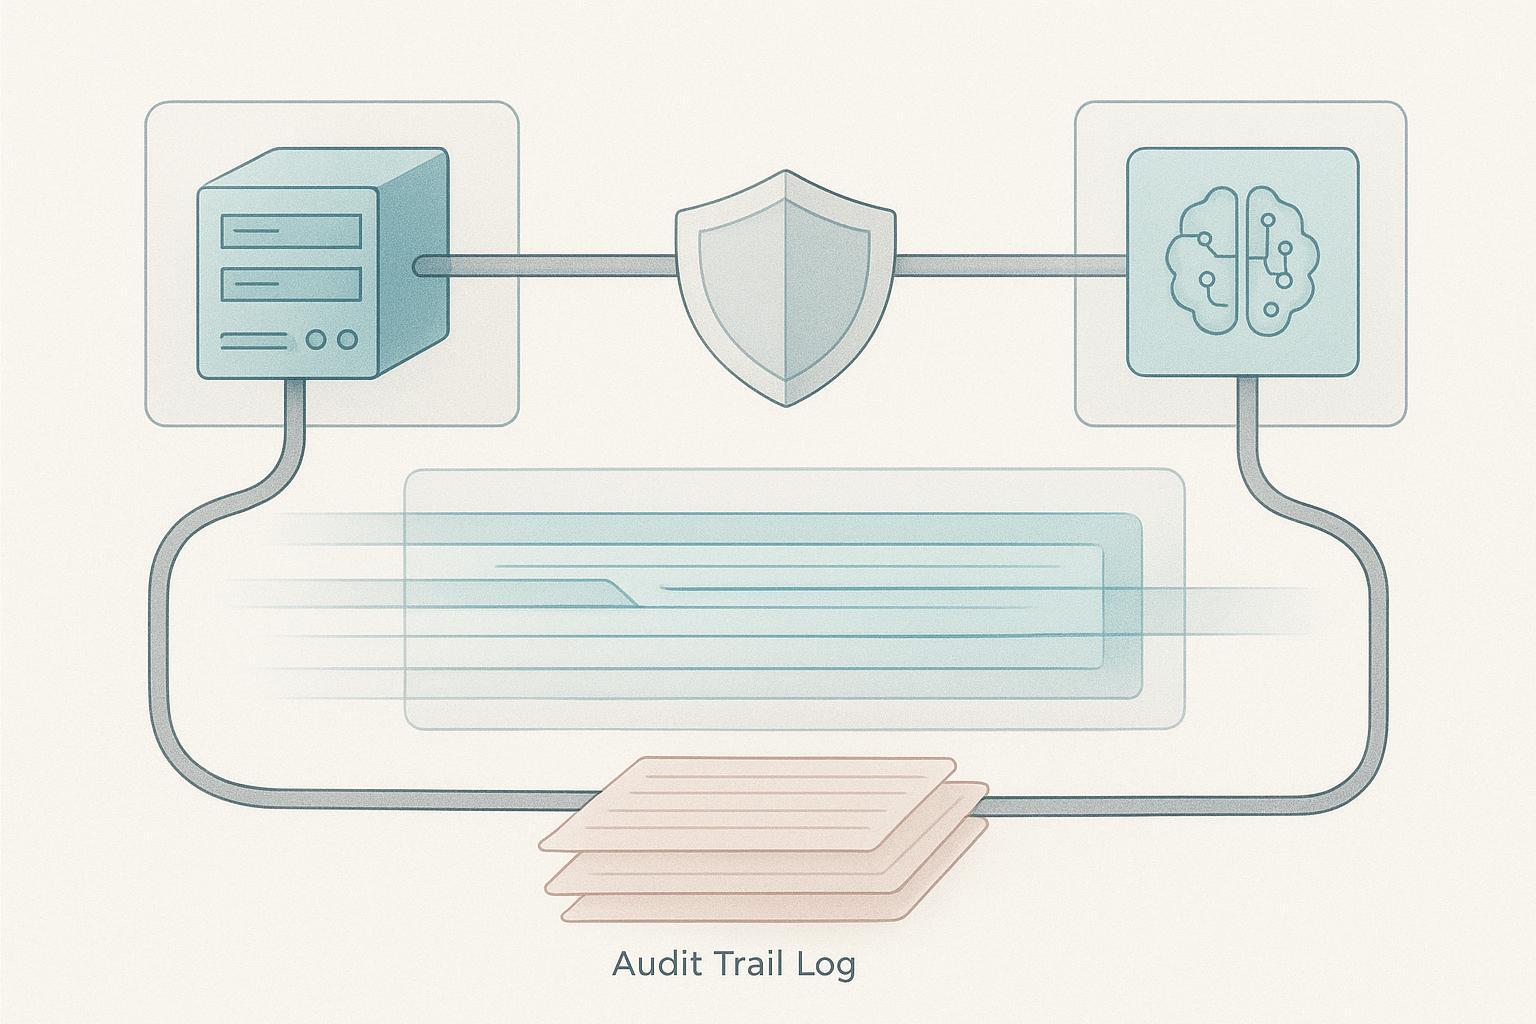
Rủi ro về tính bảo mật trong quan hệ đối tác peptide AI có thể đo lường được, không mang tính lý thuyết. MỘT 2025 nghiên cứu về mạng lưới thần kinh khám phá ma túy cho thấy rằng trong kịch bản hộp đen nơi chỉ có nhật ký đầu ra được hiển thị, chẳng hạn như một mô hình được cung cấp dưới dạng dịch vụ web, Các cuộc tấn công suy luận thành viên đã xác định cấu trúc hóa học nào đã có trong tập huấn luyện, và kết hợp nhiều cuộc tấn công làm tăng nguy cơ (Xuất bản mạng lưới thần kinh trong khám phá thuốc có thể ảnh hưởng đến tính bảo mật, 2025-03-26). Các tác giả lưu ý rằng các phân tử từ các lớp thiểu số, thường có giá trị nhất trong việc khám phá thuốc, đặc biệt dễ bị tổn thương, và các cấu trúc độc đáo khác với các hợp chất thư viện đã được thiết lập có thể tương ứng với các khách hàng tiềm năng độc quyền hoặc các giàn giáo mới đang được phát triển.
Phản hồi vận hành là mô hình truy cập theo cấp bậc thay vì quyết định chia sẻ dữ liệu duy nhất. Các nhà tài trợ giữ hồ sơ thô trong nhà; đối tác nhận được các biểu diễn được băm hoặc không xác định khi nhiệm vụ lập mô hình cho phép; chỉ kết quả đầu ra tổng hợp rời khỏi sự hợp tác. Giới hạn hợp đồng về những gì đối tác có thể giữ lại, cộng với một bản kiểm tra trên mỗi truy vấn đối với nhóm chia sẻ, đóng vòng lặp.
Chìa khóa mang đi: Việc khử nhận dạng làm giảm nguy cơ rò rỉ nhưng không loại bỏ nó đối với các peptide có cấu trúc đặc biệt, vì vậy việc kiểm tra phân tầng và truy vấn mang lại sức nặng mà chỉ riêng việc che giấu không thể.
Xác nhận khoa học: Một giao thức hoạt động, Không phải là một nguyên tắc
Xác thực không phải là một nguyên tắc mà bạn đồng ý. Đó là một trình tự bạn chạy: xác nhận trực giao đầu tiên, sau đó sao chép độc lập, sau đó đối chiếu mọi giá trị đối với mô hình trở lại dữ liệu phân tích thô mà nó lấy được. Bỏ qua bước thứ ba là lỗi phổ biến nhất, bởi vì số được đối chiếu và số không được đối chiếu trông giống hệt nhau trong bảng huấn luyện.
Xác định cặp trực giao cho mỗi loại xác nhận quyền sở hữu trước khi bạn tạo bất kỳ thứ gì. Để nhận dạng, ghép khối nguyên vẹn với một giây, phương pháp khác về mặt cơ học thay vì tiêm lặp lại trên cùng một dụng cụ. Đối với hoạt động, ghép nối kết quả đọc liên kết sinh lý với kết quả đọc chức năng dựa trên tế bào, bởi vì cả hai trả lời những câu hỏi khác nhau.
Việc sao chép phải sử dụng lô tổng hợp độc lập, không phải là một bản chạy lại của cùng một tài liệu. Chạy cùng một xét nghiệm hai lần trên cùng một lô sẽ đo độ chính xác của thiết bị, không khái quát hóa. MỘT 2025 đánh giá có hệ thống về các phương pháp dự đoán văn bia cho thấy nhiều phương pháp tiếp cận hiện tại gặp phải tình trạng trang bị quá mức cho tập dữ liệu huấn luyện của họ, điều này hạn chế đáng kể mức độ họ chuyển sang các mục tiêu mới (Vắc xin npj, 2025-08-30). Đánh giá tương tự lưu ý rằng không phải tất cả các chất kết dính đều có khả năng miễn dịch: một epitope được xếp hạng cao nhất có thể liên kết với các kháng thể trong ống nghiệm nhưng không tạo được phản ứng mong muốn trong cơ thể, và độ chính xác trên điểm chuẩn không được chuyển sang khi kết quả đọc, dòng tế bào, hoặc bối cảnh mục tiêu khác nhau.
Đó là chế độ thất bại để thiết kế chống lại. Tập xác thực được rút ra từ cùng một chiến dịch với tập huấn luyện đo lường khả năng ghi nhớ, không khái quát hóa.
Khoảng cách điểm chuẩn: Tiêu chuẩn hóa nào vẫn không thể khắc phục được
Tiêu chuẩn hóa là cần thiết nhưng chưa đủ. Điểm chuẩn của lĩnh vực này mới và hẹp, và chưa có thẻ điểm nào có thể đo lường được những gì nó tuyên bố đo lường.
PepBenchmark, điểm chuẩn peptide-ML được tiêu chuẩn hóa được phát hành vào tháng 4 2026 và trình bày tại ICLR 2026, bao gồm 29 kinh điển-peptide cộng 6 bộ dữ liệu peptide không chính tắc trên 7 nhóm, với quy trình tiền xử lý thống nhất và bảng xếp hạng bao gồm bốn nhóm phương pháp: Dấu vân tay, GNN, PLM, và CƯỜI. Các tác giả của nó tuyên bố rõ ràng rằng công việc trước đây “bị cản trở do thiếu các tiêu chuẩn chuẩn hóa” và gặp phải “các vấn đề về chất lượng thường gặp trong các đường ống đặc biệt”. Đó là một bước tiến thực sự, và nó cũng là một cái hẹp: 35 bộ dữ liệu, một điểm chuẩn, một bản phát hành.
Các giới hạn trung thực quan trọng hơn cho việc lập kế hoạch so với tiêu đề. Không có khảo sát nào đưa ra tỷ lệ phần trăm áp dụng FAIR có thể bảo vệ được cho dược phẩm sinh học R&D, và không có nghiên cứu nào tính tỷ lệ các tài liệu phát hiện thuốc AI có khiếm khuyết về rò rỉ hoặc khả năng tái sản xuất. Do đó, bất kỳ thẻ điểm sẵn sàng nào cũng là công cụ hỗ trợ phán đoán, không phải là thước đo.
⚠️ Cảnh báo: Coi điểm sẵn sàng như một cách bắt đầu cuộc trò chuyện có cấu trúc, không phải là số liệu được xác thực. Nếu một đối tác hỏi điểm của bạn được so sánh với điểm nào, câu trả lời đúng hôm nay là “tiêu chí riêng của chúng tôi,” không phải là tiêu chuẩn được công bố.
Khung bên ngoài đang đến, mặc dù. Tháng 1 của FDA 2025 dự thảo hướng dẫn về AI trong việc ra quyết định theo quy định đề xuất đánh giá độ tin cậy dựa trên rủi ro gắn liền với bối cảnh sử dụng đã nêu. Đó là một bản dự thảo, không phải để thực hiện, và nó chi phối việc gửi hơn là khám phá. Dù vậy, nó chỉ ra câu hỏi cần xây dựng một chương trình sẵn sàng để trả lời: mô hình này dùng để làm gì, và bằng chứng nào làm cho kết quả của nó đáng tin cậy cho việc sử dụng đó?
Bắt đầu: Thẻ sẵn sàng dữ liệu peptide trong 30 ngày
Quy trình làm việc về dữ liệu peptide để khám phá thuốc AI được kiểm tra nhanh nhất bằng cách lấy ngẫu nhiên 20 bản ghi peptide và cho điểm từng bản ghi theo năm trụ cột. Đó là một quyết định năm phút, và nó thường giải quyết câu hỏi liệu một chương trình có sẵn sàng hợp tác hay không. Hầu hết các đội nhận thấy rằng một số ít hồ sơ là sạch, một nhóm lớn hơn đã hoàn thành một phần, và một số ít không thể được xây dựng lại.
Đối với mọi trường không thành công, quyết định xem khoảng trống là vấn đề nắm bắt hay vấn đề liên kết. Sự cố chụp có nghĩa là dữ liệu chưa bao giờ được ghi lại, vì vậy cách khắc phục là thay đổi những gì đội thu thập ở băng ghế dự bị. Sự cố liên kết có nghĩa là dữ liệu tồn tại ở đâu đó nhưng không được kết nối nhiều, một phương pháp, hoặc kết quả xét nghiệm, vì vậy bản sửa lỗi là một mã định danh và một phép nối, không phải là một thử nghiệm mới. Hai người có chủ sở hữu khác nhau và thời gian khác nhau, và coi vấn đề liên kết như một vấn đề nắm bắt sẽ lãng phí hàng tháng trời.
Sau đó chạy một peptide từ đầu đến cuối chuỗi đầy đủ: hồ sơ nhận dạng, chứng chỉ phân tích liên kết lô, tập tin phân tích có thể đọc được bằng máy. Ghi lại mọi điểm mà con người phải can thiệp bằng tay. Danh sách can thiệp đó là phạm vi thực sự của dự án sẵn sàng.
Sự do dự phổ biến là điều này đòi hỏi phải thay thế nền tảng. Trong hầu hết các trường hợp nó không. Nó đòi hỏi kỷ luật ở cấp độ hiện trường đối với các hồ sơ mà nhóm đã tạo ra.
Bước tiếp theo: Chạy quy trình ghi điểm gồm 20 bản ghi và đưa danh sách can thiệp vào quá trình đánh giá mức độ sẵn sàng của dữ liệu kỹ thuật, nơi các khoảng trống được ánh xạ tới các bản sửa lỗi cụ thể.
Câu hỏi thường gặp
Điều gì làm cho trình tự peptide và bản ghi sửa đổi trở nên rõ ràng?
Một bản ghi rõ ràng nêu tên cấu trúc hóa học chính xác, không phải là một tốc ký mà người đọc phải giải thích. Việc xử lý tham chiếu ký hiệu cấu trúc peptide coi biểu diễn hóa học không mất dữ liệu là bản ghi chính, với HELM được sử dụng cho các cấu trúc nhận biết polymer và SMILES cho các mô hình đồ thị cấp nguyên tử, InChI hoặc InChIKey làm khóa chống trùng lặp và nhận dạng, chu kỳ và liên kết chéo được viết dưới dạng đối tượng kết nối rõ ràng, và dư lượng phi tự nhiên được viết bằng mã nhiều chữ cái viết thường cho axit D-amino. Chú thích sửa đổi cấp độ dư lượng, được MAP sử dụng, giữ cho cầu lactam có thể phân biệt được với disulfide. Bản ghi có nội dung "peptide đã sửa đổi" không có chi tiết đó trông rõ ràng nhưng chưa sẵn sàng cho AI.
HELM hay SMILES là bản ghi chính tốt hơn?
Cả hai đều không tốt hơn; sự lựa chọn tuân theo mô hình sẽ sử dụng bản ghi. HELM bảo tồn cấu trúc liên kết cấp polyme và xử lý các monome phi tự nhiên cũng như các đối tượng kết nối một cách sạch sẽ, phù hợp với công việc nhận biết trình tự và macrocycle. SMILES cung cấp một biểu đồ cấp độ nguyên tử mà hầu hết các mạng thần kinh đồ thị và bộ công cụ tin học hóa học đều đọc trực tiếp. Các chương trình cần vừa lưu trữ một bản ghi làm bản ghi chính vừa tạo bản ghi còn lại, với InChIKey làm khóa nối nên cùng một phân tử không bao giờ được tính hai lần.
Bối cảnh khảo nghiệm bao nhiêu là đủ?
Đủ để một phòng thí nghiệm khác có thể lặp lại phép đo và giải thích con số. Tối thiểu: loại xét nghiệm và chỉ số đọc, mục tiêu và xây dựng, dòng tế bào hoặc ma trận, khoảng nồng độ, điều kiện ủ bệnh, phương pháp phát hiện, và các đơn vị. MỘT 2025 đánh giá có hệ thống về các yếu tố dự đoán epitop cho thấy một epitop được xếp hạng cao nhất có thể liên kết với các kháng thể trong ống nghiệm nhưng khả năng miễn dịch kém trong cơ thể, và độ chính xác đó không thay đổi khi đọc, dòng tế bào hoặc bối cảnh mục tiêu khác nhau. Giá trị ràng buộc không có ngữ cảnh không thể được gộp với bất kỳ thứ gì.
Một số độ tinh khiết duy nhất có thể chấp nhận được không?
Chỉ như một tiêu đề, không bao giờ như kỷ lục. Tôi quý 2(R2)Các yêu cầu về phạm vi xác thực của thiết lập báo cáo tạp chất từ ngưỡng lên đến 120% giới hạn đặc điểm kỹ thuật, và phần trăm diện tích tinh khiết từ 80% ĐẾN 100% giới hạn đặc điểm kỹ thuật, với các giới hạn phát hiện và định lượng xung quanh tỷ lệ tín hiệu trên tạp âm khoảng 3:1 Và 10:1. Dữ liệu lịch sử lô và tạp chất peptide chỉ mang “98% nguyên chất” che giấu tạp chất nào, ở mức độ nào, bằng phương pháp nào. Giữ số, sau đó đính kèm hồ sơ đằng sau nó. Sản xuất peptit Về
Làm cách nào để chúng tôi chia sẻ cấu trúc với đối tác mà không để lộ chuỗi khách hàng tiềm năng?
Chia sẻ mô hình hoặc các tính năng dẫn xuất thay vì tập huấn luyện thô, và kiểm tra những gì đầu ra tiết lộ. Các cuộc tấn công suy luận thành viên nhằm khôi phục các phân tử huấn luyện từ một mô hình được cung cấp sẽ xác định các phân tử huấn luyện chỉ từ nhật ký đầu ra, và các phân tử thuộc tầng lớp thiểu số và giàn giáo mới là dễ bị tổn thương nhất, với các cuộc tấn công kết hợp làm tăng thêm rủi ro. Nếu đối tác cần chính dữ liệu đó, sử dụng môi trường được kiểm soát với bộ tính năng đã được thống nhất và quy trình kiểm tra thay vì truyền tệp.
Một mô hình có thể được xác nhận mà không cần lô độc lập?
KHÔNG. Một mô hình chỉ được xác nhận trên nhiều lô và đã thấy ghi nhớ báo cáo, không khái quát hóa. Giữ lại ít nhất một lô cho mỗi chương trình, lý tưởng nhất là từ một chiến dịch tổng hợp khác, và giữ nguyên nó cho đến lần đánh giá cuối cùng. Nếu không có lô độc lập tồn tại, tuyên bố trung thực là mô hình này nhất quán trong nội bộ, không được xác nhận.
Hướng dẫn dự thảo của FDA có áp dụng cho công việc ở giai đoạn khám phá không?
Không trực tiếp, nhưng đó là tuyên bố rõ ràng nhất về tiêu chuẩn mà cuối cùng bạn sẽ phải tuân theo. Tháng 1 của FDA 2025 dự thảo hướng dẫn về AI trong việc ra quyết định theo quy định đề xuất đánh giá độ tin cậy dựa trên rủi ro gắn liền với bối cảnh sử dụng đã nêu. Đó là một bản dự thảo ngày 6 Tháng Một 2025 và không phải để thực hiện. Các nhóm khám phá ghi lại bối cảnh sử dụng bây giờ sẽ không phải xây dựng lại nó sau này.
Chìa khóa mang đi: Yêu cầu về tính sẵn sàng chỉ có thể được bảo vệ khi đặt tên cho các trường bản ghi, kiến trúc chia sẻ và giao thức xác thực, không phải khi nó báo cáo số lượng tinh khiết.
Phần kết luận
Sự sẵn sàng là một thuộc tính của hồ sơ, không phải của người mẫu, và đó là quy trình xử lý dữ liệu peptide thử nghiệm để khám phá thuốc AI hiện phải đối mặt trong mọi cuộc trò chuyện hợp tác. Năm trụ cột, trình tự rõ ràng và ký hiệu sửa đổi, bối cảnh khảo nghiệm đi kèm với kết quả, hồ sơ tạp chất chứ không phải là một con số độ tinh khiết duy nhất, giấy chứng nhận phân tích liên kết lô, và đầu ra phân tích được tiêu chuẩn hóa có thể đọc được bằng máy, là danh sách kiểm tra. Kiến trúc bảo mật và giao thức xác thực bằng văn bản là những gì cho phép bạn chia sẻ bản ghi đó mà không cần chuyển giao khách hàng tiềm năng.
Các khung chuẩn và quy định vẫn đang hình thành: PepBenchmark 2026 đến sớm, và dự thảo hướng dẫn của FDA vẫn chưa được viết để thực hiện. Một chương trình sẵn sàng được xây dựng hiện nay sẽ trả lời một câu hỏi mà các đối tác sẽ hỏi chính thức hơn sau này, vì vậy hãy xây dựng nó để được chấm điểm lại thay vì được chứng nhận một lần. Hướng dẫn này là một công cụ hỗ trợ phán đoán, không phải là thước đo. Không tồn tại tỷ lệ phần trăm áp dụng FAIR hoặc số lượng lỗi rò rỉ trên toàn trường có thể bảo vệ được, vì vậy thẻ điểm ở đây hỗ trợ một quyết định thay vì giải quyết một quyết định.
MOL Changes xuất bản với tư cách là nhà cung cấp peptide.
Tìm hiểu xem bản ghi peptide của bạn sẽ thất bại ở đâu trong mô hình của đối tác. Quá trình đánh giá mức độ sẵn sàng của dữ liệu kỹ thuật sẽ ánh xạ các bản ghi peptit của bạn theo năm trụ cột và phân loại từng khoảng trống dưới dạng vấn đề thu thập hoặc vấn đề liên kết. Yêu cầu đánh giá mức độ sẵn sàng của dữ liệu với nhóm phân tích của chúng tôi.