Cosa richiedono effettivamente i flussi di lavoro dei dati sui peptidi per la scoperta di farmaci basati sull'intelligenza artificiale
I flussi di lavoro dei dati sui peptidi per la scoperta di farmaci basati sull'intelligenza artificiale sono la tenuta dei registri, analitico, e pratiche di governance che rendono un set di dati peptidico utilizzabile dalle macchine mediante un modello predittivo. Coprono cinque aree: registrazioni di sequenze e modifiche, contesto del test, dati sulle impurità, cronologia del lotto, e risultati analitici standardizzati. Ciò che li distingue dai consigli generici sulla disponibilità dei dati è che ogni requisito arriva a livello di un singolo campo record, e ognuno deve sopravvivere sia a una revisione della riservatezza che a un protocollo di convalida documentato.
La barra del livello record è la parte che la maggior parte delle squadre sottovaluta. Il trattamento di riferimento della notazione della struttura peptidica sostiene che le pipeline di machine learning funzionano meglio da una rappresentazione chimica senza perdite come record primario, con codifiche specifiche del modello derivate da esso anziché archiviate come fonte di verità (Annotazione delle strutture peptidiche utilizzando SMILES e altri codici chimici, 2017). In questo approccio, InChIKey funge da chiave di identità e deduplicazione, mentre la ciclizzazione e i collegamenti incrociati devono essere scritti come oggetti di connessione espliciti anziché lasciati impliciti.
I regolatori si stanno muovendo nella stessa direzione. Gennaio della FDA 2025 il progetto di linee guida sull’IA nel processo decisionale normativo introduce una valutazione della credibilità basata sul rischio legata a un contesto d’uso definito (Progetto di guida della FDA, contenuto attuale 2025-01-06). È una bozza, non per l'implementazione, ma segnala che i set di dati sui peptidi pronti per l’intelligenza artificiale saranno giudicati in base alla tracciabilità piuttosto che al volume.
Chiave da asporto: Tre cose distinguono questi flussi di lavoro dalla normale pulizia dei dati: requisiti di registrazione a livello di campo, meccanismi di riservatezza che consentono ai partner di condividere senza esporre un vantaggio, e un protocollo di validazione operativa piuttosto che un principio dichiarato.
Due idee sbagliate causano la maggior parte della confusione. “Dati puliti” non significa “dati curati”, un foglio di calcolo ordinato può comunque essere inutilizzabile da un modello. E un singolo numero di purezza non descrive un peptide; i dati relativi alle impurità e alla cronologia dei lotti contengono le informazioni da cui un modello può effettivamente imparare. Questa sezione si basa sulla letteratura peer-reviewed sulla notazione della struttura e sulle attuali linee guida normative, senza fonti di fornitori.
Perché i flussi di lavoro dei dati sui peptidi per la scoperta di farmaci basati sull'intelligenza artificiale sono importanti adesso
I flussi di lavoro dei dati sui peptidi per la scoperta di farmaci basati sull’intelligenza artificiale sono importanti perché ora il denaro si sposta prima dei dati. Nel 2026 Tracker delle trattative AI pubblicato da VLS Research, gli anticipi dichiarati si collocano tra i 30 e i 50 milioni di dollari rispetto a valori principali superiori a 1 miliardo di dollari, circa il 2-3% del valore nominale pagato in contanti (Ricerca VLS, Tracker delle trattative per la scoperta di farmaci con intelligenza artificiale 2026, recuperato 2026-07-03). Isomorphic Labs–Eli Lilly mostra circa 45 milioni di dollari in anticipo contro oltre 1,7 miliardi di dollari in traguardi; Noetik-GSK prevede un anticipo di 50 milioni di dollari su una struttura di licenza quinquennale. Nota la fonte: un tracker dell'analista, con l'interesse di un fornitore per la narrativa dell'accordo sull'intelligenza artificiale.
La cartella clinica fa da contrappeso. In giro 90% delle molecole che entrano nella clinica non raggiungono mai l’approvazione, e il 50-60% dei fallimenti della Fase II è dovuto alla mancanza di efficacia, cifre che non si sono mosse quasi in due decenni (Mao Z & Yan L, Frontiere in farmacologia, recuperato 2026-07-03). Lo stesso 2024 revisione sistematica di 20 Programmi basati sull'intelligenza artificiale da 2018 A 2023 ha scoperto che l’ottimizzazione dei lead assistita dall’intelligenza artificiale riduce in media il tempo di screening dei candidati del 30-50%., mentre il logoramento della Fase I/II è rimasto paragonabile ai parametri di riferimento del settore.
Questo divario è il punto. I partner ora possono firmare un modello, ma un modello non può imparare da registrazioni che non hanno mai catturato il peptide.
Ciò colpisce R&D conduce, chimica analitica, dati e informatica, e i manager dell'alleanza che ereditano le domande di diligenza dopo la firma.
I cinque pilastri dei dati sui peptidi pronti per l’intelligenza artificiale
I set di dati sui peptidi pronti per l’intelligenza artificiale sono costruiti partendo da cinque pilastri a livello di record, e insieme formano la checklist di preparazione contro cui una squadra può segnarsi prima di firmare un accordo di partnership. Ogni pilastro sottostante è scritto allo stesso modo: perché è importante, come implementarlo, e che aspetto ha il fallimento quando manca. L'ordine è deliberato. L'identità viene prima perché ogni campo a valle, dal contesto del test al profilo delle impurità, eredita gli errori di un record di struttura ambigua. Un modello addestrato su una sequenza specificata erroneamente non fallisce rumorosamente; apprende la molecola sbagliata e riporta previsioni attendibili al riguardo.
Assegna un punteggio onesto a ciascun pilastro. Una squadra in grado di ricostruire ogni peptide dai propri archivi, allegare le condizioni del test a ogni risultato, e tracciare ogni lotto in un certificato di analisi è pronto per consegnare i dati a un partner. A una squadra che non può farlo non viene impedito di collaborare, ma dovrebbe aspettarsi che i primi mesi della collaborazione siano dedicati alla bonifica dei dati piuttosto che alla formazione dei modelli.
Pillole 1: Registrazioni inequivocabili di sequenze e modifiche
La sequenza peptidica e le registrazioni delle modifiche sono importanti perché un modello non può apprendere da un peptide che non può ricostruire, e gli errori di identità si propagano silenziosamente attraverso ogni previsione a valle. La correzione è una rappresentazione chimica senza perdite come record principale, con codifiche specifiche del modello derivate da esso anziché archiviate come fonte di verità.
L'implementazione segue un piccolo insieme di convenzioni. HELM gestisce strutture sensibili ai polimeri, compresi rami e monomeri non naturali, mentre SMILES serve modelli grafici a livello di atomo. InChI e InChIKey fungono da chiavi di deduplicazione e identità nei sistemi. La ciclizzazione e i collegamenti incrociati appartengono agli oggetti di connessione espliciti, mai come presupposto implicito che “ciclizzato” significhi la stessa cosa ovunque. La trattazione di riferimento della notazione della struttura peptidica copre il resto: codici multilettera per residui non proteici o non naturali, annotazione in minuscolo per gli amminoacidi D, e annotazione di modifica a livello di residuo in formato MAP (Giornale di chemioinformatica / PMC).
La modalità di guasto è silenziosa e costosa. Un programma registra un ponte lattamico e un disolfuro come “ciclizzati” nello stesso campo, quindi il modello tratta due impalcature chimicamente distinte come una sola. Ogni previsione costruita su quella colonna è contaminata, e nulla in cantiere lo segnala.
Una registrazione utilizzabile come modello per un peptide macrociclico modificato riporta il campo indicato di seguito. MOL Changes supporta questo approccio basato innanzitutto sulla struttura nel suo lavoro sui dati sui peptidi, e l'esempio è replicabile con qualsiasi sistema di registrazione conforme.
|
Campo |
Record utilizzabile come modello |
Tipico record di testo libero |
|---|---|---|
|
Rappresentanza primaria |
Stringa HELM con oggetti di connessione espliciti |
Sequenza incollata in un campo note |
|
Codifica a livello di atomo |
SORRISI derivati dal record HELM |
Assente |
|
Sintesi peptidica Chiave d'identità |
InChIKey per la deduplicazione |
Assente |
|
Non naturale Peptidi sintetici residui |
Codici multilettera, definito in una tabella dei monomeri |
Approssimazioni di una sola lettera |
|
Stereochimica |
Annotazione dell'amminoacido D in minuscolo |
Non registrato |
|
Modifiche |
Annotazione MAP a livello di residuo |
Nota a testo libero, per esempio. “ciclizzato” |
|
Tipo di ciclizzazione |
Oggetto bridge esplicito con posizioni |
Ambiguo |
|
Servizi Reticoli |
Oggetto di connessione esplicita |
Assente o implicito |
Pillole 2: Contesto del test che viaggia con il risultato
Un'affinità di legame senza le relative condizioni di analisi non è un'etichetta di addestramento, è un numero. Il contesto del test deve viaggiare con il risultato: tipo di analisi, costrutto e specie bersaglio, formato di lettura, e se il valore è stato misurato o previsto.
La distinzione tra misurato e previsto è il punto in cui la maggior parte dei set di dati si interrompe silenziosamente. UN 2025 la revisione sistematica dei predittori degli epitopi ha rilevato solo questo 174 Di 777 (22%) È stato confermato che i peptidi leganti HLA previsti computazionalmente in uno studio SARS-CoV-2 si legano stabilmente in vitro (npj Vaccini, 2025-08-30). Tale cifra è limitata a un singolo studio, non un tasso di accuratezza generale per l’IA in immunologia, ma mostra perché un valore previsto e un valore misurato non possono condividere una colonna senza un flag che li separa.
⚠️ Attenzione: Raggruppamento SPR, la polarizzazione della fluorescenza e i valori basati sulle cellule in una colonna di affinità addestrano il modello sul test piuttosto che sulla chimica. Il modello apprende quale laboratorio ha generato il numero, non quale peptide si lega.
Pillole 3: Profili di impurità, Non un singolo numero di purezza
I dati relativi alle impurità peptidiche e alla cronologia dei lotti appartengono al record come profilo, non una percentuale principale. Due lotti riportati a 98% puro può comportarsi diversamente in un dosaggio, e il modello ha bisogno dell'involucro delle impurità e dello stato di controione per capirne il motivo.
Gli effetti di contrasto sono ben documentati. Nell'a 2025 revisione, il peptide M33 come sale TFA ha mostrato una citotossicità maggiore del 5-30% verso le cellule epiteliali bronchiali normali rispetto alla controparte in acetato, e il peptide MOG formulato con TFA è stato associato approssimativamente all'insorgenza di encefalomielite 5 giorni prima con incidenza e gravità comparabili (Biomolecole, 2025-11-07). Una revisione separata ha rilevato che il cloruro era il meno efficiente degli anioni testati nell'indurre la struttura elicoidale in LL-37 (Prodotti farmaceutici / Molecole, 2020-12-03). Queste sono osservazioni dipendenti dalla formulazione, non una dichiarazione generale che qualsiasi contro-affermazione non sia sicura.
L'implementazione significa memorizzare i tempi di ritenzione delle impurità, aree relative e lo stato di scambio dei controioni insieme alla cifra di purezza. Per i livelli di convalida, Io Q2(R2) imposta l'intervallo di validazione anziché i limiti di purezza del peptide: i test di impurità devono coprire la soglia di segnalazione fino a 120% del limite di specifica, e la purezza per percentuale dell'area viene convalidata 80% del inferiore a 100% del limite superiore delle specifiche (Io Q2(R2), linea guida finale 2023-11-30).
Pillole 4: Storico dei lotti e certificati di analisi legati ai lotti
L'attendibilità del modello è una proprietà di tracciabilità, ecco perché i numeri di lotto, il collegamento del certificato di analisi e la cronologia dei nuovi test appartengono al set di dati piuttosto che solo al sistema di gestione della qualità. Le aspettative ALCOA+ che le pipeline AI/ML devono ora soddisfare sono uno standard GMP preesistente esteso a un nuovo caso d'uso, non una nuova regola inventata per i modelli. La derivazione dei dati è segnalata come una preoccupazione critica poiché AI/ML si integra con MES e LIMS, e il thread digitale è definito come la catena ininterrotta di relazioni tra dati, dai test sulle materie prime alla produzione fino al rilascio del prodotto finale (Prospettive normative per l'implementazione di AI/ML, PMC, 2025-06-16).
Per Suggerimento: Conservare la cronologia dei nuovi test e dei nuovi test anziché sovrascriverli Negozio Esso. Un valore sostituito con un timestamp è una prova; un valore sostituito è uno spazio vuoto.
La modalità di fallimento è una campagna conteggiata due volte. Tre analisi eseguite sullo stesso lotto vengono inserite come tre osservazioni indipendenti, e il modello tratta un lotto come tre, gonfiando la fiducia in un risultato mai replicato.
Pillole 5: Risultati analitici standardizzati e formati leggibili dalla macchina
I risultati analitici standardizzati per l'intelligenza artificiale dei peptidi dipendono dai formati che una pipeline può analizzare senza pulizia manuale. Esistono già standard leggibili dalla macchina per il livello analitico: mzML per i dati grezzi della spettrometria di massa, mzIdentML e mzTab per identificazioni e quantificazioni, PX-XML per i metadati di invio, SDRF-Proteomica per le relazioni tra campione ed esposizione, e USI per identificatori di spettro stabili (Infrastruttura dati proteomica).
La riproducibilità richiede anche il blocco completo del metodo. I parametri del metodo HPLC includono la chimica della colonna (tipicamente C18), dimensione delle particelle e dei pori, dimensioni della colonna, fasi mobili e modificatori, programma gradiente, portata (in giro 1.0 ml/min analitico), temperatura della colonna, lunghezza d'onda di rilevamento (tipicamente 214–220 nm per i peptidi) e la quantità di iniezione. L'identità deve essere confermata mediante LC-MS o MALDI-TOF su massa intatta con massa osservata rispetto a massa teorica e una finestra di accettazione ppm o Da dichiarata, non solo tramite HPLC (Centro di conoscenza Phenomenex HPLC, 2026-07-29).
La modalità di errore è un record che dice "gradiente RP-HPLC standard". Senza il blocco del metodo, il risultato non può servire come ancora di validazione, e un partner non può riprodurlo.
Riservatezza: Condivisione dei dati sui peptidi senza perdita di piombo
Il rischio di riservatezza nelle partnership con i peptidi AI è misurabile, non teorico. UN 2025 uno studio sulle reti neurali per la scoperta di farmaci ha rilevato che in uno scenario a scatola nera in cui sono esposti solo i log di output, come un modello offerto come servizio web, gli attacchi di inferenza sull'appartenenza hanno identificato quali strutture chimiche erano presenti nel set di addestramento, e la combinazione di diversi attacchi aumentava il rischio (La pubblicazione di reti neurali nella scoperta di farmaci potrebbe compromettere la riservatezza, 2025-03-26). Gli autori notano che le molecole appartengono a classi minoritarie, spesso il più prezioso nella scoperta di farmaci, sono particolarmente vulnerabili, e che strutture uniche che differiscono dai composti della libreria consolidata possono corrispondere a lead proprietari o a nuovi scaffold in fase di sviluppo.
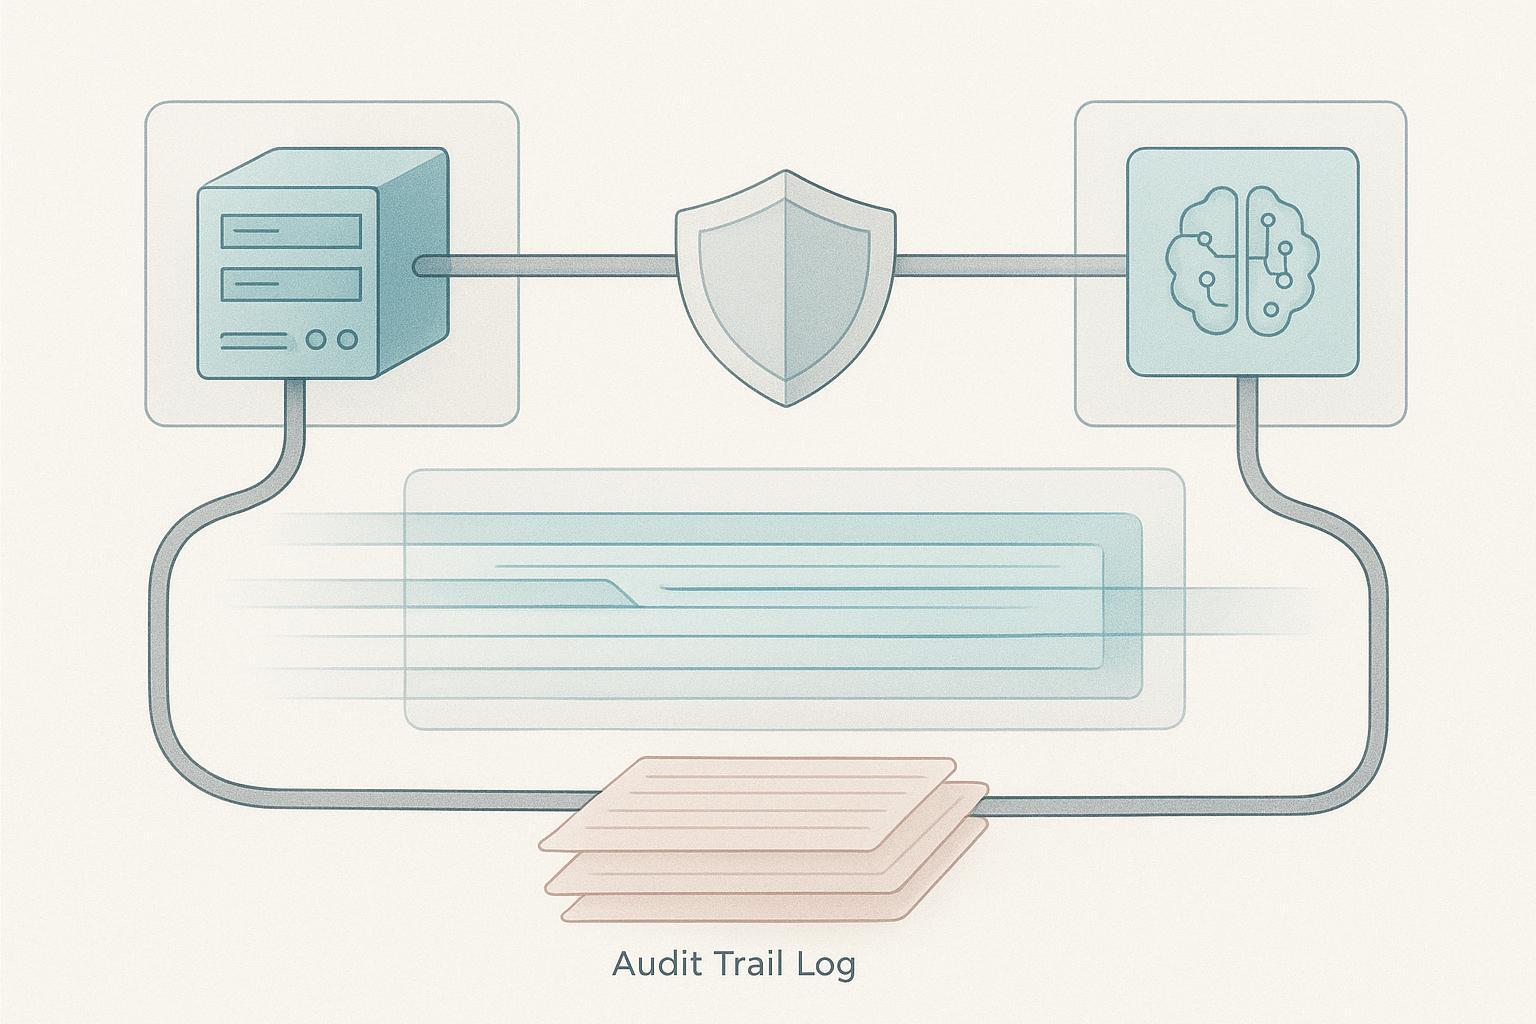
La risposta operativa è un modello di accesso a più livelli piuttosto che una singola decisione di condivisione dei dati. Gli sponsor mantengono i dati grezzi internamente; il partner riceve rappresentazioni non identificate o con hash laddove l'attività di modellazione lo consente; solo gli output aggregati lasciano la collaborazione. Limiti contrattuali su quanto il partner può trattenere, oltre a una traccia di controllo su ogni query rispetto al set condiviso, chiudere il ciclo.
Chiave da asporto: La deidentificazione riduce il rischio di perdita ma non lo elimina per peptidi strutturalmente distintivi, quindi il tiering e il controllo delle query hanno il peso che il mascheramento da solo non può fare.
Validazione scientifica: Un protocollo operativo, Non un principio
La convalida non è un principio con cui sei d'accordo. È una sequenza che esegui: prima la conferma ortogonale, quindi replicazione indipendente, quindi la riconciliazione di ogni valore rivolto al modello con i dati analitici grezzi da cui proviene. Saltare il terzo passaggio è il fallimento più comune, perché un numero riconciliato e un numero non riconciliato sembrano identici in una tabella di addestramento.
Definire la coppia ortogonale per tipo di attestazione prima di generare qualsiasi cosa. Per identità, accoppiare la massa intatta con un secondo, metodo meccanicamente diverso piuttosto che un’iniezione ripetuta sullo stesso strumento. Per attività, associare una lettura del legame biofisico con una lettura funzionale basata sulle cellule, perché i due rispondono a domande diverse.
La replica deve utilizzare un lotto sintetizzato in modo indipendente, non una replica dello stesso materiale. L'esecuzione dello stesso test due volte sullo stesso lotto misura la precisione dello strumento, non generalizzazione. UN 2025 una revisione sistematica dei metodi di previsione degli epitopi ha rilevato che molti approcci attuali soffrono di un adattamento eccessivo ai set di dati di addestramento, il che limita drasticamente la capacità di trasferimento verso nuovi obiettivi (npj Vaccini, 2025-08-30). La stessa revisione rileva che non tutti i leganti sono immunogenici: un epitopo di alto livello può legarsi agli anticorpi in vitro ma non riuscire a suscitare la risposta prevista in vivo, e la precisione su un benchmark non viene mantenuta durante la lettura, linea cellulare, o il contesto di destinazione è diverso.
Questa è la modalità di fallimento contro cui progettare. Un set di validazione tratto dalla stessa campagna del set di training misura la memorizzazione, non generalizzazione.
Il divario di riferimento: Ciò che la standardizzazione non può ancora risolvere
La standardizzazione è necessaria ma non sufficiente. I parametri di riferimento del settore sono nuovi e ristretti, e nessuna scorecard può ancora misurare ciò che pretende di misurare.
PepBenchmark, il benchmark standardizzato peptide-ML pubblicato ad aprile 2026 e presentato all'ICLR 2026, coperture 29 peptide canonico plus 6 set di dati di peptidi non canonici attraverso 7 gruppi, con una pipeline di preelaborazione unificata e una classifica che abbraccia quattro famiglie di metodi: Impronta digitale, GNN, PLM, e SORRISI. I suoi autori affermano chiaramente che il lavoro precedente era “ostacolato dall’assenza di parametri di riferimento standardizzati” e soffriva di “problemi di qualità comuni nelle pipeline ad hoc”. Questo è un vero progresso, ed è anche stretto: 35 set di dati, un punto di riferimento, una versione.
I limiti onesti contano più del titolo per la pianificazione. Nessun sondaggio fornisce un’unica percentuale difendibile di adozione FAIR per il settore biofarmaceutico R&D, e nessuno studio conta la percentuale di documenti sulla scoperta di farmaci sull’intelligenza artificiale con perdite o difetti di riproducibilità. Qualsiasi scorecard di preparazione è quindi un aiuto al giudizio, non una misurazione.
⚠️ Attenzione: Considera il punteggio di preparazione come un inizio di conversazione strutturata, non una metrica convalidata. Se un partner ti chiede con cosa viene confrontato il tuo punteggio, la risposta corretta oggi è “i nostri criteri”.,"Non è uno standard pubblicato.
In arrivo la cornice esterna, Anche se. Gennaio della FDA 2025 Il progetto di linee guida sull’intelligenza artificiale nel processo decisionale normativo propone una valutazione della credibilità basata sul rischio e legata a un contesto d’uso dichiarato. È una bozza, non per l'implementazione, e governa le sottomissioni piuttosto che la scoperta. Comunque, indica la domanda a cui dovrebbe essere costruito un programma di preparazione: a cosa serve questo modello?, e quali prove rendono credibile la sua produzione per quell’uso?
Iniziare: Un pass di preparazione ai dati sui peptidi di 30 giorni
I flussi di lavoro dei dati sui peptidi per la scoperta di farmaci basati sull'intelligenza artificiale vengono testati più velocemente estraendo venti record di peptidi in modo casuale e assegnando a ciascuno un punteggio rispetto ai cinque pilastri. Si tratta di una decisione di cinque minuti, e di solito risolve la questione se un programma sia pronto per la partnership. La maggior parte dei team ritiene che una manciata di record siano puliti, un gruppo più ampio è parzialmente completo, e alcuni non possono essere ricostruiti affatto.
Per ogni campo che fallisce, decidere se il divario è un problema di cattura o di collegamento. Un problema di acquisizione significa che i dati non sono mai stati registrati, quindi la soluzione è una modifica a ciò che la squadra raccoglie in panchina. Un problema di collegamento significa che i dati esistono da qualche parte ma non sono uniti a molto, un metodo, o una lettura del test, quindi la correzione è un identificatore e un join, non un nuovo esperimento. I due hanno proprietari diversi e tempistiche diverse, e trattare un problema di collegamento come un problema di cattura fa sprecare mesi.
Quindi esegui un peptide attraverso l'intera catena da un'estremità all'altra: registro d'identità, certificato di analisi legato al lotto, file analitico leggibile dalla macchina. Documentare manualmente ogni punto in cui un essere umano è dovuto intervenire. Tale elenco di interventi è il vero scopo del progetto di preparazione.
L’esitazione comune è che ciò richieda la sostituzione della piattaforma. Nella maggior parte dei casi non è così. Richiede disciplina a livello di campo sui record che il team già produce.
Prossimo passo: Eseguire il passaggio del punteggio di venti record e sottoporre l'elenco degli interventi a una revisione della preparazione dei dati tecnici, dove le lacune vengono mappate in soluzioni concrete.
Domande frequenti
Ciò che rende inequivocabile la registrazione di una sequenza peptidica e di una modifica?
Un documento inequivocabile nomina l'esatta struttura chimica, non una scorciatoia che un lettore deve interpretare. Il trattamento di riferimento della notazione della struttura peptidica considera una rappresentazione chimica senza perdite come registrazione primaria, con HELM utilizzato per strutture consapevoli dei polimeri e SMILES per modelli grafici a livello di atomo, InChI o InChIKey come chiavi di deduplicazione e identità, ciclizzazione e collegamenti incrociati scritti come oggetti di connessione espliciti, e residui non naturali scritti in codici multilettera con lettere minuscole per gli amminoacidi D. Annotazione di modifica a livello di residuo, come utilizzato da MAP, mantiene un ponte lattamico distinguibile da un disolfuro. Un record che dice “peptide modificato” senza quel dettaglio ha un aspetto pulito ma non è pronto per l’intelligenza artificiale.
HELM o SMILES è il record primario migliore?
Nessuno dei due è universalmente migliore; la scelta segue il modello che consumerà il disco. HELM preserva la topologia a livello di polimero e gestisce monomeri non naturali e oggetti di connessione in modo pulito, che si adatta al lavoro consapevole delle sequenze e dei macrocicli. SMILES fornisce un grafico a livello di atomo che la maggior parte delle reti neurali grafiche e dei toolkit chemioinformatici leggono direttamente. I programmi che necessitano di memorizzarne uno come record primario e generare l'altro, con InChIKey come chiave di unione in modo che la stessa molecola non venga mai contata due volte.
Quanto contesto del test è sufficiente?
Abbastanza perché un laboratorio diverso possa ripetere la misurazione e interpretare il numero. Al minimo: tipo di analisi e lettura, mirare e costruire, linea cellulare o matrice, intervallo di concentrazione, condizioni di incubazione, metodo di rilevamento, e le unità. UN 2025 una revisione sistematica dei predittori degli epitopi ha rilevato che un epitopo di alto livello può legarsi agli anticorpi in vitro ma essere scarsamente immunogenico in vivo, e tale precisione non viene trasferita durante la lettura, la linea cellulare o il contesto di destinazione differiscono. Un valore vincolante senza contesto non può essere raggruppato con nulla.
È sempre accettabile un unico numero di purezza??
Solo come titolo, mai come da record. Io Q2(R2)I requisiti dell'intervallo di convalida stabiliscono la segnalazione delle impurità dalla soglia fino a 120% del limite di specifica, e percentuale dell'area di purezza da 80% A 100% dei limiti di specifica, con limiti di rilevamento e quantificazione attorno ai rapporti segnale-rumore di circa 3:1 E 10:1. I dati relativi alle impurità peptidiche e alla cronologia dei lotti che riportano solo "puro al 98%" nascondono tali impurità, a che livello, con quale metodo. Mantieni il numero, quindi allegare il profilo dietro di esso. Produzione di peptidi Di
Come condividiamo le strutture con un partner senza esporre le serie principali?
Condividi il modello o le funzionalità derivate anziché il set di addestramento grezzo, e testare ciò che rivela l'output. Gli attacchi di inferenza dell'appartenenza che recuperano le molecole di addestramento da un modello servito identificano le molecole di addestramento solo dai log di output, e le molecole di classe minoritaria e di nuova impalcatura sono le più vulnerabili, con attacchi combinati che aumentano ulteriormente il rischio. Se un partner ha bisogno dei dati stessi, utilizzare un ambiente controllato con un set di funzionalità concordate e una traccia di controllo anziché un trasferimento di file.
Un modello può essere convalidato senza un lotto indipendente?
NO. Un modello validato solo su lotti che ha già visto la memorizzazione dei report, non generalizzazione. Trattenere almeno un lotto per programma, idealmente da una diversa campagna di sintesi, e mantenerlo intatto fino alla valutazione finale. Se non esiste un lotto indipendente, la dichiarazione onesta è che il modello è internamente coerente, non convalidato.
La bozza delle linee guida della FDA si applica al lavoro in fase di scoperta??
Non direttamente, ma è la dichiarazione più chiara disponibile dello standard a cui alla fine sarai tenuto. Gennaio della FDA 2025 Il progetto di linee guida sull’intelligenza artificiale nel processo decisionale normativo propone una valutazione della credibilità basata sul rischio e legata a un contesto d’uso dichiarato. È una bozza datata 6 Gennaio 2025 e non è per l'implementazione. I team di scoperta che documentano il contesto d’uso ora non dovranno ricostruirlo in seguito.
Chiave da asporto: Un'attestazione di disponibilità è difendibile solo quando denomina i campi del record, l'architettura di condivisione e il protocollo di validazione, non quando riporta un numero di purezza.
Conclusione
La disponibilità è una proprietà del record, non del modello, e questo è il flusso di lavoro dei dati sui peptidi di prova per la scoperta di farmaci basati sull'intelligenza artificiale che ora devono affrontare in ogni conversazione di partnership. I cinque pilastri, sequenza univoca e notazione di modifica, contesto del test che viaggia con il risultato, profili di impurità piuttosto che un singolo valore di purezza, certificati di analisi legati al lotto, e output analitico standardizzato leggibile dalla macchina, sono la lista di controllo. L'architettura di riservatezza e un protocollo di convalida scritto sono ciò che ti consente di condividere quel record senza cedere il comando.
Il benchmark e il quadro normativo sono ancora in fase di formazione: PepBenchmark 2026 è presto, e la bozza della guida della FDA non è ancora stata scritta per l'implementazione. Un programma di preparazione creato ora risponde a una domanda che i partner porranno in modo più formale in seguito, quindi costruiscilo per essere rivalutato anziché certificato una volta. Questa guida è un aiuto al giudizio, non una misurazione. Non esiste una percentuale difendibile di adozione del FAIR su tutto il campo o un conteggio di difetti di fuga, quindi una scorecard qui supporta una decisione piuttosto che stabilirla.
MOL Changes pubblica come fornitore di peptidi.
Scopri dove i tuoi record peptidici fallirebbero il modello di un partner. Una revisione tecnica della preparazione dei dati mappa i tuoi record peptidici rispetto ai cinque pilastri e classifica ogni lacuna come un problema di cattura o un problema di collegamento. Richiedi una revisione della disponibilità dei dati con il nostro team analitico.