Schnelle Antwort
Assess the actual system’s traceability, metadata and audit controls. This blueprint identifies potential gaps but provides no measured prevalence across pepti…
Ein Peptiddatenteich auf einer Seite
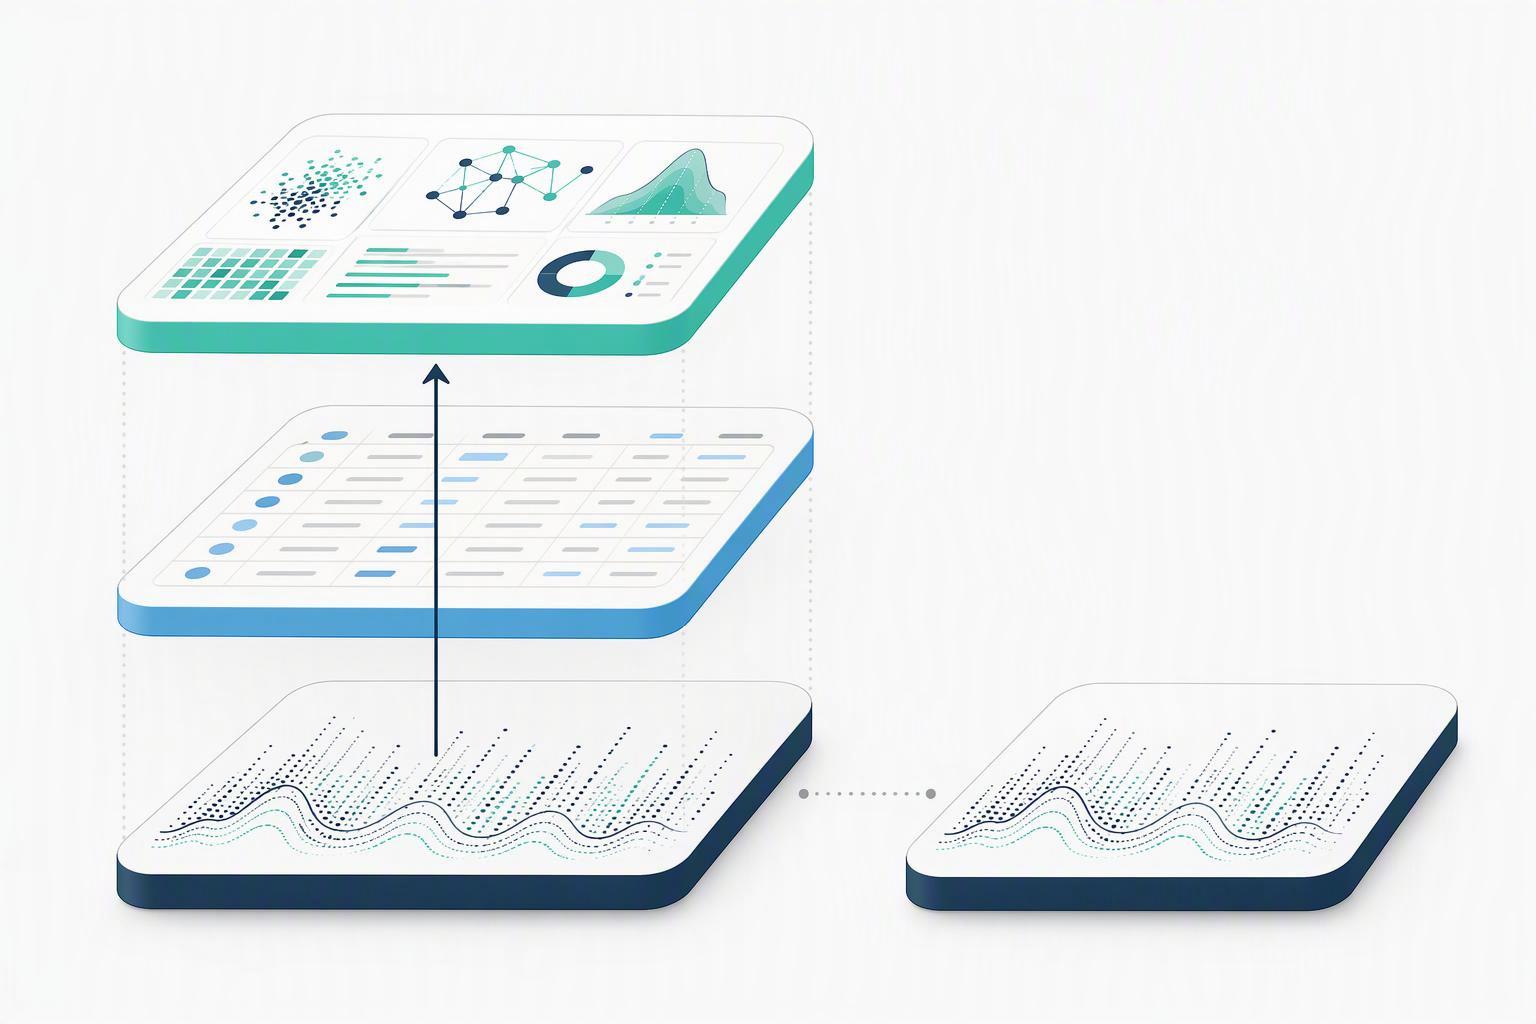
Peptidtests im Großhandel Peptide Ein Peptiddatenteich besteht aus drei Schichten über einer unveränderlichen Rohkopie: die ursprüngliche Instrumentenaufnahme, eine strukturierte Datensatzebene für Chargen und ihre analytischen untergeordneten Elemente, und eine abgeleitete Ebene für Peaktabellen, Funktionen und Modellausgaben. Die Rohkopie ändert sich nie; alles andere lässt sich daraus nachbauen.
Die Argumente für diese Struktur sind messbar. A 2022 Die Auswertung öffentlicher chromatographischer Metadaten ergab dies 70% Die Beschreibungen der chromatographischen Setups in öffentlichen Repositories waren unvollständig, und nur 20.8% (312 von 1,501) vollständig und korrekt genug waren, um wiederverwendet zu werden (Harrieder et al., Metabolomik, 2022). Die Repository-für-Repository-Aufteilung derselben Studie zeigt MetaboLights bei 174 von 468 Beschreibungen vollständig (37.2%) und Metabolomics Workbench bei 276 von 1,033 (26.7%). Dabei handelt es sich um öffentliche Repositories, deren Einreicher Wert auf die gemeinsame Nutzung von Daten legt, und die Autoren weisen darauf hin, dass die Zahlen die Richtigkeit an anderer Stelle möglicherweise überbewerten.
Der regulatorische Grund, die Roherfassung intakt zu halten, ist unabhängig vom Wiederverwendungsargument. MHRA definiert Rohdaten als die erste Erfassung von Informationen, ob auf Papier oder elektronisch, und Metadaten als Daten, die Attribute beschreiben und Kontext und Bedeutung angeben, einen integralen Bestandteil der Originalaufzeichnung bilden (MHRA GxP-Datenintegritätsleitfaden, Revision 1, Marsch 2018). Die Position der MHRA, dass dynamische Rohdaten dynamisch bleiben müssen, folgt aus derselben Definition: Ein gedrucktes Chromatogramm ist eine statische Aufzeichnung und kann nicht als Rohdaten dienen.
Schlüssel zum Mitnehmen: Ein Peptiddatenteich ist eine Roherfassung, strukturierte Datensätze und abgeleitete Features in drei Ebenen, wobei die Rohkopie unveränderlich ist und jedes abgeleitete Artefakt daraus neu erstellt werden kann.
Strukturierte Identifikatoren können die Abfrage und Herkunft verbessern. Ein freigegebenes Laufwerk kann auch gesteuerte Laufwerke enthalten, nachvollziehbare Aufzeichnungen; Vorschriften bedürfen ihrer Bewahrung und Bedeutung, kein bestimmtes Datenbankschema oder eine Fremdschlüsselimplementierung.
Der Mindestdatensatz für eine Synthesecharge und ihre analytischen untergeordneten Elemente
Diese Schichtentrennung lohnt sich nur, wenn die Datensätze selbst spezifiziert werden, Daher trennt die Minimalarchitektur einen Batch-Datensatz von seinen analytischen untergeordneten Elementen, und jedes Kind trägt seine eigenen Identifikatoren, Methodenreferenz- und Ergebnisfelder. Eine einzelne flache Tabelle mit einer Zeile pro Los kann die im nächsten Abschnitt beschriebenen Verknüpfungen nicht aufnehmen, und es erzwingt unabhängige Messungen in gemeinsam genutzten Spalten.
Das branchenübliche QC-Feldmuster ist ein nützlicher Ausgangspunkt, keine Spezifikation. Anbieter kundenspezifischer Synthesen dokumentieren in der Regel analytische HPLC zur Reinheit, Massenspektrometrie zur Identitätsfeststellung, Peptidgehalt oder Nettopeptidgewicht, und ein Analysezertifikat mit einem HPLC-Chromatogramm und einem MS-Spektrum; Zu den optionalen Zusatzleistungen gehören Endotoxintests, Gegenionenanalyse, Wassergehalt durch Karl Fischer und optische Drehung. Behandeln Sie dies als den Feldsatz, den das Schema berücksichtigen muss, und vergleichen Sie die tatsächliche Feldliste jedes Lieferanten mit seinen eigenen Dokumenten.
|
Feld |
Schicht |
Erforderlich oder nützlich |
Notizen |
|---|---|---|---|
|
Chargenkennung |
Charge |
Erforderlich |
Hartnäckig, nie projektübergreifend wiederverwendet |
|
Reihenfolge und Modifikationen |
Charge |
Erforderlich |
Strukturiert, kein Freitext (siehe Abschnitt „Modifikation“.) |
|
Synthesemethode und Harz |
Charge |
Erforderlich |
Versionierter Verweis auf einen Methodendatensatz |
|
Skalierung und Ertrag |
Charge |
Erforderlich |
Einheiten explizit |
|
Gegenionenform |
Charge |
Erforderlich |
TFA und Acetat sind unterschiedliche Materialien |
|
Analysezertifikat |
Charge |
Erforderlich |
Anhang plus strukturierte Ergebnisfelder |
|
Aliquot-Identifikator |
Analytisches Kind |
Erforderlich |
Fremdschlüssel des übergeordneten Batches |
|
Injektions- und Laufkennung |
Analytisches Kind |
Erforderlich |
Fremdschlüssel des übergeordneten Aliquots |
|
Methodenversion |
Analytisches Kind |
Anf Fabrik für synthetische Peptide wütend |
Links zur änderungsgesteuerten Methodentabelle |
|
HPLC-Reinheitsergebnis |
Analytisches Kind |
Erforderlich |
Wert, Einheit, Integrationsparameter |
|
MS-Identitätsergebnis |
Analytisches Kind |
Erforderlich |
Beobachtete versus theoretische Masse |
|
Peptidgehalt |
Analytisches Kind |
Erforderlich |
Methode benannt (Stickstoff, UV, gravimetrisch) |
|
Karl-Fischer-Wassergehalt |
Analytisches Kind |
Nützlich |
Erforderlich, wenn der Inhalt um Wasser korrigiert wird |
|
Endotoxin-Ergebnis |
Analytisch USA-Peptide Kind |
Nützlich |
Methode und Grenzwert angegeben |
|
Optische Drehung |
Analytisches Kind |
Nützlich |
Lösungsmittel und Temperatur angegeben |
Warnung: Das in dieser Blaupause beschriebene Material ist nur für Forschungszwecke im Zusammenhang mit der Peptidversorgung bestimmt. Hier unterstützt nichts die Dosierung, therapeutisch, diagnostische oder persönliche Gebrauchsansprüche, und ein Datenmodell sollte nichts anderes implizieren.
So verknüpfen Sie Synthesedatensätze mit Chromatogrammen und Massenspektren ohne Dateinamenkleber
Sobald diese Datensätze vorhanden sind, Der Teich beantwortet die Verbindung vom Syntheseansatz zum Chromatogramm und zum Massenspektrum durch gespeicherte Identifikatoren, nicht durch Parsen eines Dateinamens. Die Kette läuft im Batch-Betrieb, Aliquot, Injektion, laufen, Datei, verarbeitetes Ergebnis, und jeder Link ist ein Fremdschlüssel mit einem Zeitstempel und einem Operator.
Diese Kette hat eine formale Form. Provenienz modelliert als Entitäten und Aktivitäten (PROV-O) beschreibt ein Ergebnis, das durch eine Aktivität generiert wird, von einer Eingabeentität abgeleitet und einem Agenten zugeordnet, Dies ist genau die Struktur einer erneut verarbeiteten Peak-Tabelle, die aus einer Rohdatei abgeleitet wurde (W3C PROV-O-Empfehlung, 2013). Sie benötigen die Ontologie nicht, um den Join zu erstellen, aber man braucht seine Disziplin: Jedes abgeleitete Artefakt weist darauf hin, woher es stammt.
Containerformate reservieren bereits Platz für diese Disziplin. Das Datenformat von Allotrope reserviert einen Prüfspeicher und Prüfsummen neben den Daten, in einer sechskomponentigen Struktur, die auf HDF5 basiert und für die Langzeitarchivierung analytischer Daten vorgesehen ist (Allotropes Datenformat v1.5.3 RF, freigegeben 30 November 2020). Für Spektren, mzML 1.1.x ist die aktuell offene Spezifikationslinie, und in der eigenen Dokumentation heißt es, dass Peak-List-Formate keine Informationen über Vorläufersignale und zugehörige Erfassungsmetadaten enthalten (HUPO-PSI mzML-Repository).
Die Workflow-Reihenfolge ist ein aufzeichnungsfähiges Objekt, keine Konvention. Die Reihenfolgesteuerung in §11.10(F) von 21 CFR Teil 11 erfordert Betriebssystemprüfungen, die eine zulässige Abfolge von Schritten und Ereignissen erzwingen, Das ist es, was die Synthese ausmacht, Aliquot, Führen und überprüfen Sie eine überprüfbare Reihenfolge und nicht eine Gewohnheit (21 CFR 11.10). Die Rückverfolgbarkeit der Chargen für Peptide hängt davon ab, dass die Reihenfolge die Wiederaufbereitung übersteht.
Warnung: Eine erneut verarbeitete Peak-Tabelle, die über das Original zurückgeschrieben wird, zerstört den Join und den Audit-Trail gleichzeitig. Abgeleitete Ergebnisse gehören in einen neuen Datensatz, der auf die Rohdatei verweist, niemals an dessen Stelle.
Wie Peptidmodifikationen gespeichert werden sollten, damit ein Modell sie verwenden kann
Die Join-Kette trägt den Batch, Aber auch die Chemie der Charge selbst muss strukturiert sein: Eine Änderung ist ein Datensatz mit einer Site, eine Chemie, ein Massendelta und ein kontrollierter Vokabularzugang, keine Zeichenfolge, die an einen Probennamen angehängt wird. Freitext-Änderungsnamen unterbrechen sowohl den Join als auch jedes Modell, das stapelübergreifend argumentieren muss.
Das Wortschatzproblem ist so groß, dass ein Akzessionssystem erforderlich ist. Unimod dokumentiert 1,559 Änderungseinträge ab Januar 2025, ein in a zitierter Graf 2025 Artikel zur kombinatorischen Modifikationsidentifikation (Lai et al., 2025). Ein Schema, das Änderungsnamen als Text speichert, kann einem Vokabular dieser Größe nicht zuverlässig zugeordnet werden, und im selben Artikel wird darauf hingewiesen, dass herkömmliche Suchmethoden nur eine begrenzte Anzahl von Modifikationen vorgeben, normalerweise neun.
Suchmaschinen behandeln Änderungen als Suchparameter, was das Gegenteil einer gespeicherten Tatsache ist. Maskottchen unterscheidet fest, variable und exklusive Modifikationen, testet alle möglichen Anordnungen von Variablenmodifikationen und warnt davor, mit Variablenmodifikationen sparsam umzugehen (Matrix Science Maskottchen Hilfe, undatiert). Wenn die Änderung nur in einer Suchkonfiguration vorhanden ist, Es ist nicht in der Aufzeichnung enthalten und ein Modell kann nicht daraus lernen.
Der chemische Bereich, den das Schema enthalten muss, ist breit. Die maßgeschneiderte Peptidarbeit umfasst N-terminale Modifikationen wie Acetylierung, Biotinylierung, Fluoreszenzmarkierungen und PEGylierung; Seitenkettenmodifikationen einschließlich Phosphorylierung an Serin, Threonin und Tyrosin, Methylierung, Sulfatierung und Glykosylierung; C-terminale Modifikationen wie Amidierung und Esterformen; und spezielle Strukturen einschließlich Kopf-Schwanz- und Seitenkettencyclisierung, Disulfide, geheftete und verzweigte Peptide, D-Aminosäuren und Isotopenmarkierung. Mehrere gleichzeitige Änderungen sind Routine, Daher muss der Datensatz von Anfang an eins-zu-viele sein.
Die Interoperabilitätsklausel I3 von FAIR verlangt, dass Metadaten qualifizierte Verweise auf andere Metadaten enthalten, Dies ist das Prinzip, das ein Beitritt plus ein strukturierter Fremdschlüssel erfüllt (GO FAIR-Prinzipien, Wilkinson et al., 2016). Eine auf diese Weise erstellte Modifikationstabelle ist ohne weitere Arbeit KI-bereit; Ein Textfeld ist es nicht.
|
Feld |
Beispiel: Phosphoserin |
Beispiel: N-terminales Acetyl |
|---|---|---|
|
Website |
Zu sein, Restposition 12 |
N-Terminus |
|
Chemieunterricht |
Phosphorylierung |
Acetylierung |
|
Massendelta |
+79.966 Und |
+42.011 Und |
|
Vokabelzugang |
Unimod-Beitritt |
Unimod-Beitritt |
|
Beweis |
MS/MS-Standortlokalisierung Gh-Peptide |
MS/MS-Terminalfragment |
|
Methodenreferenz Lieferant von Peptidfabriken |
Konfigurationsversion suchen |
Konfigurationsversion suchen |
Reinheit, Identität, Inhalt, Stabilität und Assay-Eignung sind fünf verschiedene Bereiche
Strukturierte Modifikationen sind ein Teil des Vokabeltrainings; Die andere Hälfte besteht darin, die Qualitätsmerkmale auseinanderzuhalten, weil Reinheit, Identität, Inhalt, Stabilität und Assay-Eignung sind fünf separate Ergebnisfelder, die fünf verschiedene Fragen beantworten und durch verschiedene Tests validiert werden. Sie in einer Spalte „Qualität“ zusammenzufassen, ist der häufigste Schemafehler in Peptiddatensätzen.
ICH Q2(R2) beschreibt Leistungsmerkmale für analytische Verfahren entsprechend ihrem Verwendungszweck. Es wird nicht das Fünf-Felder-Datenschema dieses Artikels vorgeschrieben oder jeder Methode die gleichen Validierungsmerkmale zugewiesen.
Die Richtlinie benannte auch ihr eigenes Vokabular um. Im Glossar wird „Validierungsmerkmal“ bewusst durch „Leistungsmerkmal“ ersetzt,„beschrieben als technologieunabhängige Beschreibung einer Eigenschaft, die die Qualität des Messergebnisses sichert (ICH Q2(R2) Glossar). Ein Schema, das Spalten weiterhin mit dem ersetzten Q2 beschriftet(R1) Die Liste stimmt nicht mit den aktuellen Methodenvalidierungsberichten überein.
Stabilität und Assay-Eignung liegen außerhalb dieses Tisches und benötigen ihre eigenen Bereiche. Stabilität ist ein Zeit- und Zustandsergebnis mit einer Studienkennung; Die Assay-Eignung ist eine Beurteilung auf Methodenebene, die anhand eines bestimmten Verfahrens aufgezeichnet wird. Beides lässt sich nicht aus einem Reinheitsprozentsatz ableiten, und ein Reinheitsprozentsatz allein stellt keine Verbindungsidentität her, deshalb Reinheit, Identität, Verfahren, Chargennummer und Dokumentation müssen gemeinsam überprüft werden.
Die praktische Konsequenz ist ein Feld pro Attribut, jedes mit seiner eigenen Methodenreferenz, Einheit und Akzeptanzkriterium. Ein Modell, das auf einem zusammengeführten „Qualitätsfaktor“ trainiert wurde, lernt die Zusammenführung, nicht die Chemie.
Was muss nachverfolgbar sein, bevor eine KI-Schicht an der Spitze sitzt?
Bestimmen Sie, ob Teil 11 wendet alle relevanten Kontrollen an und bewertet sie, Systemvalidierung, Verfahren, Schulung und Bindung. Zugriffsberechtigungen und eine Audit-Table-Implementierung allein stellen keine Compliance her. Skalieren Sie das System entsprechend seinen Risiken und dem Verwendungszweck.
-
Validierung von Systemen, einschließlich der Fähigkeit, ungültige oder geänderte Datensätze zu erkennen.
-
Genaue und vollständige Kopien in lesbarer und elektronischer Form.
-
Schutz der Aufzeichnungen für einen genauen und schnellen Abruf während der Aufbewahrungsfrist.
-
Der Zugang ist auf autorisierte Personen beschränkt.
-
Sicher, computergeneriert, Prüfprotokolle mit Zeitstempel, die frühere Informationen nicht verdecken.
-
Betriebskontrollen zur Durchsetzung der zulässigen Abfolge von Schritten und Ereignissen.
-
Die Behörde prüft, wer unterschreiben darf, eine Operation ändern oder durchführen.
-
Gerät prüft die Gültigkeit der Datenquelle.
-
Dokumentierte Ausbildung, Schulung und Erfahrung für Systembenutzer.
-
Schriftliche Richtlinien, die Einzelpersonen für Handlungen unter ihren elektronischen Signaturen zur Rechenschaft ziehen.
-
Kontrolle über die Systemdokumentation, einschließlich Revisions- und Änderungskontrolle mit Audit-Trail.
Die Änderungskontrollklausel deckt Methodenversionen ab. §11.10(k) erfordert Revisions- und Änderungskontrollverfahren, die einen Prüfpfad der zeitlich aufeinander folgenden Entwicklung und Änderung der Systemdokumentation aufrechterhalten, Das ist es, was eine Methodenversionstabelle erfüllen muss (21 CFR 11.10(k)). ALCOA-Attribute der MHRA, zurechenbar, lesbar, gleichzeitig, originell und genau, plus komplett, konsistent, langlebig und verfügbar, beschreiben die gleiche Anforderung in Bezug auf die Datenqualität (MHRA GxP-Datenintegritätsleitfaden, 2018). Die US-Verordnung liefert die Kontrollliste; Die britischen Leitlinien liefern die Attribute.
FAIR fügt eine Klausel hinzu, die die Steuerelemente nicht direkt angeben: R1.2 verlangt, dass Daten mit einer detaillierten Herkunft verknüpft werden, Dabei handelt es sich um die Forschungsdatenversion des Prüfpfads (GO FAIR-Prinzipien, 2016). Weder FAIR noch die Formatspezifikationen werden von einer Regulierungsbehörde unterstützt, Behandeln Sie sie daher als Gestaltungshilfen, kein Compliance-Nachweis.
Warnung: Ein Entwurf, der diese Kontrollen erfüllt, ist kein validiertes System. Bei der Validierung handelt es sich um eine dokumentierte Aktivität anhand der beabsichtigten Verwendung, und die Übernahme eines Formats oder einer Ontologie ersetzt diese nicht.
Wo die KI-Ebene tatsächlich passt, und wo nicht
KI kann Rohsignale analysieren, verarbeitete Merkmale oder strukturierte Ergebnisse, wenn der Ansatz für seinen beabsichtigten Zweck validiert wird. Erhalten Sie Quelldaten und Verarbeitungsherkunft, Zugriff kontrollieren, und die Glaubwürdigkeit des Modells entsprechend der Entscheidung und dem geltenden Rahmen bewerten.
Der regulatorische Rahmen für KI im GxP-Kontext ist noch im Entwurfsstadium. Die FDA hat Leitlinienentwürfe zu KI herausgegeben, um die regulatorische Entscheidungsfindung für Arzneimittel und biologische Produkte zu unterstützen 7 Januar 2025, Aktenzeichen FDA-2024-D-4689, mit geschlossenen Kommentaren 7 April 2025 (Bundesregister, 90 FR 1157, 2025). Es schlägt einen risikobasierten Glaubwürdigkeitsbewertungsrahmen vor, der auf einem definierten Nutzungskontext basiert, mit Glaubwürdigkeitsnachweisen, die auf diesen Kontext zugeschnitten sind und vom Modellrisiko abhängen. Es handelt sich um einen Entwurf, und in der Bekanntmachung heißt es, dass kein spezifischer KI-Ansatz befürwortet wird.
Die Form des Rahmens ist bereits im Entwurf aufschlussreich. Es handelt sich um eine siebenstufige Glaubwürdigkeitsbewertung: Definieren Sie die Frage, die Sie interessiert, Definieren Sie den Nutzungskontext, Beurteilung des Modellrisikos, Glaubwürdigkeitsaktivitäten planen, den Plan ausführen, Ergebnisse und Abweichungen dokumentieren, und die Eignung für den Nutzungskontext bestimmen (Goodwin-Analyse des FDA-Entwurfs, Januar 2025). Der Schritt, der für einen Datenteich von Bedeutung ist, ist der zweite: ohne definierten Nutzungskontext, Kein Datenvolumen macht ein Modell glaubwürdig.
Der Anwendungsbereich des Entwurfs ist enger als der der Labordatenverarbeitung. Es umfasst KI, die zur Erstellung von Informationen verwendet wird, die regulatorische Entscheidungen zur Sicherheit unterstützen, Wirksamkeit oder Qualität, und es schließt ausdrücklich Anwendungen in der Arzneimittelforschung und betrieblichen Effizienz aus, die keinen Einfluss auf die Patientensicherheit haben, Arzneimittelqualität oder die Verlässlichkeit von Studienergebnissen (Bundesregister, 90 FR 1157). Ein Modell, das wahrscheinliche Reinheitsausreißer für die Aufmerksamkeit eines Prüfers kennzeichnet, ist eine Betriebshilfe; Ein Modell, dessen Ausgabe in eine Spezifikationsentscheidung einfließt, liegt im Geltungsbereich.
Eine Entscheidungsregel für die Freigabe einer KI-fähigen Datenschicht
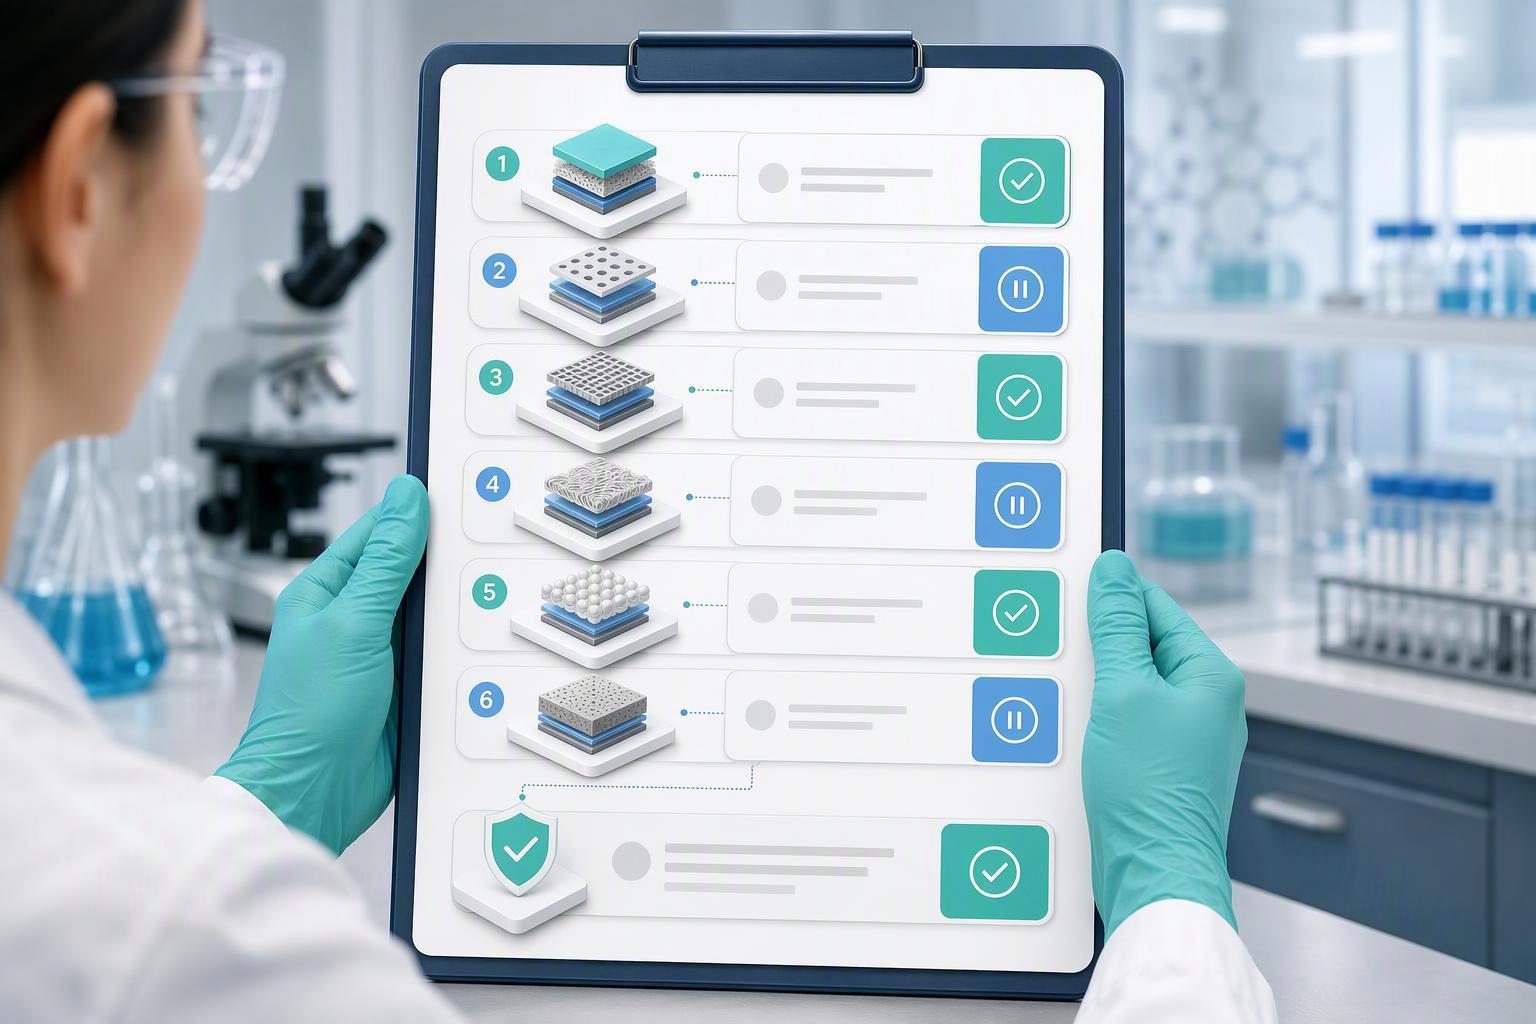
Diese Grenze wird durch die Freigaberegel geprüft, weil eine Datenschicht bereit ist, ein Modell zu tragen, wenn sechs Prüfungen der Reihe nach bestanden werden, und der erste Fehler stoppt die Veröffentlichung. Wenden Sie sie auf Ihr eigenes System an, bevor ein Modell daraus liest.
- Bewahren Sie Originaldatensätze und wesentliche Metadaten in einer Form auf, die ihre Bedeutung und erforderliche Funktionalität bewahrt. Für elektronische dynamische Aufzeichnungen sind möglicherweise native Daten erforderlich; Originalunterlagen in Papierform sind nicht grundsätzlich ungültig. Dokumentieren und überprüfen Sie jede Konvertierung oder echte Kopie.
-
Jedes analytische untergeordnete Element wird ohne Analyse des Dateinamens in seinen Stapel aufgelöst. Die Join-Kette wird als Bezeichner gespeichert, und eine Abfrage gibt die Charge von jedem Chromatogramm oder Spektrum zurück.
-
Die elf Kontrollen gemäß §11.10 werden erfüllt oder dokumentiert, risikobewertete Lücke. Zuerst müssen die Audit-Trail- und Change-Control-Klauseln getestet werden (21 CFR 11.10).
-
Änderungen sind hinzugefügte Datensätze, kein Text. Jede Änderung trägt eine Site, Chemie, Massendelta und Wortschatzakzession, und mehrere gleichzeitige Änderungen sind darstellbar.
-
Reinheit, Identität, Inhalt, Stabilität und Assay-Eignung sind separate Bereiche mit eigenen Methodenreferenzen, Übereinstimmung mit der attributspezifischen Testmatrix in ICH Q2(R2) (ICH Q2(R2), 2023).
-
Der Nutzungskontext des Modells wird vor der Erstellung des Modells niedergeschrieben, mit der im FDA-Entwurf beschriebenen Risikobewertung und Glaubwürdigkeitsbeweis (Bundesregister, 90 FR 1157, 2025).
Ein ausgearbeitetes Beispiel verdeutlicht die Regel. Ein Chargenprotokoll trägt seine Kennung, Sequenz mit zusätzlichen Modifikationen, Gegenionenform und Methodenversionen. Zwei analytische Kinder zeigen darauf: ein HPLC-Reinheitsergebnis mit seinen Integrationsparametern und ein Massenspektrum mit beobachteter und theoretischer Masse. Beide Kinder zeigen auf ihre Methodenversionen, und die Methodenversionstabelle enthält einen Änderungsverlauf. Eine abgeleitete Peaktabelle befindet sich in einem eigenen Datensatz, zeigt auf die Rohdateien und wird nie über diese zurückgeschrieben. Das Modell, das diese Schicht liest, kann beantworten, zu welcher Charge ein Spektrum gehört, welche Methode einen Reinheitswert ergab und was sich zwischen zwei Methodenversionen geändert hat.
Wenn Sie die Regel anhand realer Datensätze testen möchten, Sprechen Sie mit einem technischen Experten oder fordern Sie eine Komplettlösung für das Batch-Datenpaket an und vergleichen Sie den Feldsatz mit der obigen Tabelle.
Die beschriebene Architektur ist ein allgemeiner Entwurf, der aus öffentlichen Regulierungs- und Standarddokumenten stammt, keine Beschreibung des Systems eines Anbieters.*
Häufig gestellte Fragen
Was ist ein Peptiddatenteich??
Ein Peptiddatenteich ist ein dreischichtiger Speicher: eine unveränderliche Roherfassung von Instrumentendateien, eine strukturierte Datensatzschicht für Synthesebatches und ihre analytischen untergeordneten Elemente, und eine abgeleitete Ebene für Peaktabellen, Funktionen und Modellausgaben. Die Rohebene ändert sich nie, und jedes abgeleitete Artefakt kann daraus nachgebaut werden.
Können wir die Rohformate des Anbieters beibehalten, anstatt sie in mzML zu konvertieren??
Behalten Sie die Rohdateien des Anbieters als Rohdatensatz bei und konvertieren Sie sie zur gemeinsamen Nutzung und zum langfristigen Zugriff in mzML 1.1.x. In der mzML-Dokumentation heißt es, dass Peak-List-Formate Vorläufersignale und Erfassungsmetadaten verlieren, Daher ist eine Peak-Liste kein Ersatz für die Rohdatei (HUPO-PSI mzML-Repository). Die Konvertierung ist ein zusätzlich abgeleitetes Artefakt, kein Ersatz.
Macht die Einführung von Allotrope oder FAIR das System konform??
NEIN. Das Format von Allotrope reserviert einen Prüfspeicher und Prüfsummen, und FAIRs R1.2 verlangt eine detaillierte Herkunft, aber keines von beiden wird von einer Regulierungsbehörde als Compliance-Nachweis gebilligt (Allotropes Datenformat; GO FAIR-Prinzipien). Compliance ergibt sich aus den Kontrollen und der Validierung, nicht der Behälter.
Ist die FDA-KI-Leitlinie endgültig??
NEIN. Es handelt sich um einen Leitlinienentwurf 7 Januar 2025, mit geschlossenen Kommentaren 7 April 2025, und es heißt, dass es keinen spezifischen KI-Ansatz befürworte (Bundesregister, 90 FR 1157). Behandeln Sie den Rahmen für den Nutzungskontext und die Glaubwürdigkeitsbewertung als Designreferenz, keine Voraussetzung.
Abschluss
Der Bauplan reduziert sich auf eine Regel: Halten Sie die Roherfassung unveränderlich, Speichern Sie die Verknüpfungen als Bezeichner, und trennen Sie die fünf Qualitätsmerkmale in eigene Felder. Alles Weitere in einem KI-fähigen Analyseworkflow ergibt sich aus diesen drei Entscheidungen, und die Quellen dahinter sind öffentliche Regulierungs- und Normtexte und nicht Angaben von Anbietern.
Der Beweis dafür, jetzt zu handeln, ist die Lücke in der Vollständigkeit. Nur eine öffentliche Repository-Studie gefunden 20.8% von chromatographischen Beschreibungen, die vollständig genug sind, um wiederverwendet zu werden, und diese Einsender waren motiviert, etwas zu teilen (Harrieder et al., Metabolomik, 2022). Interne Datensätze, die ohne Schema erstellt wurden, sehen in der Regel gleich aus, und die Kosten tauchen auf, wenn ein Model oder ein Prüfer um den Beitritt bittet.
Der nächste Schritt ist die Anwendung der Sechs-Prüfungs-Entscheidungsregel auf eine echte Charge: Ziehen Sie das Analysezertifikat heraus, sein Chromatogramm und sein Massenspektrum, und prüfen Sie, ob das System beantworten kann, zu welcher Charge das Spektrum gehört und welche Methodenversion den Reinheitswert ermittelt hat. Wenn es nicht geht, Die Lücke liegt im Rekordsatz, nicht im Modell.