快速解答
Assess the actual system’s traceability, metadata and audit controls. This blueprint identifies potential gaps but provides no measured prevalence across pepti…
一页中的肽数据池
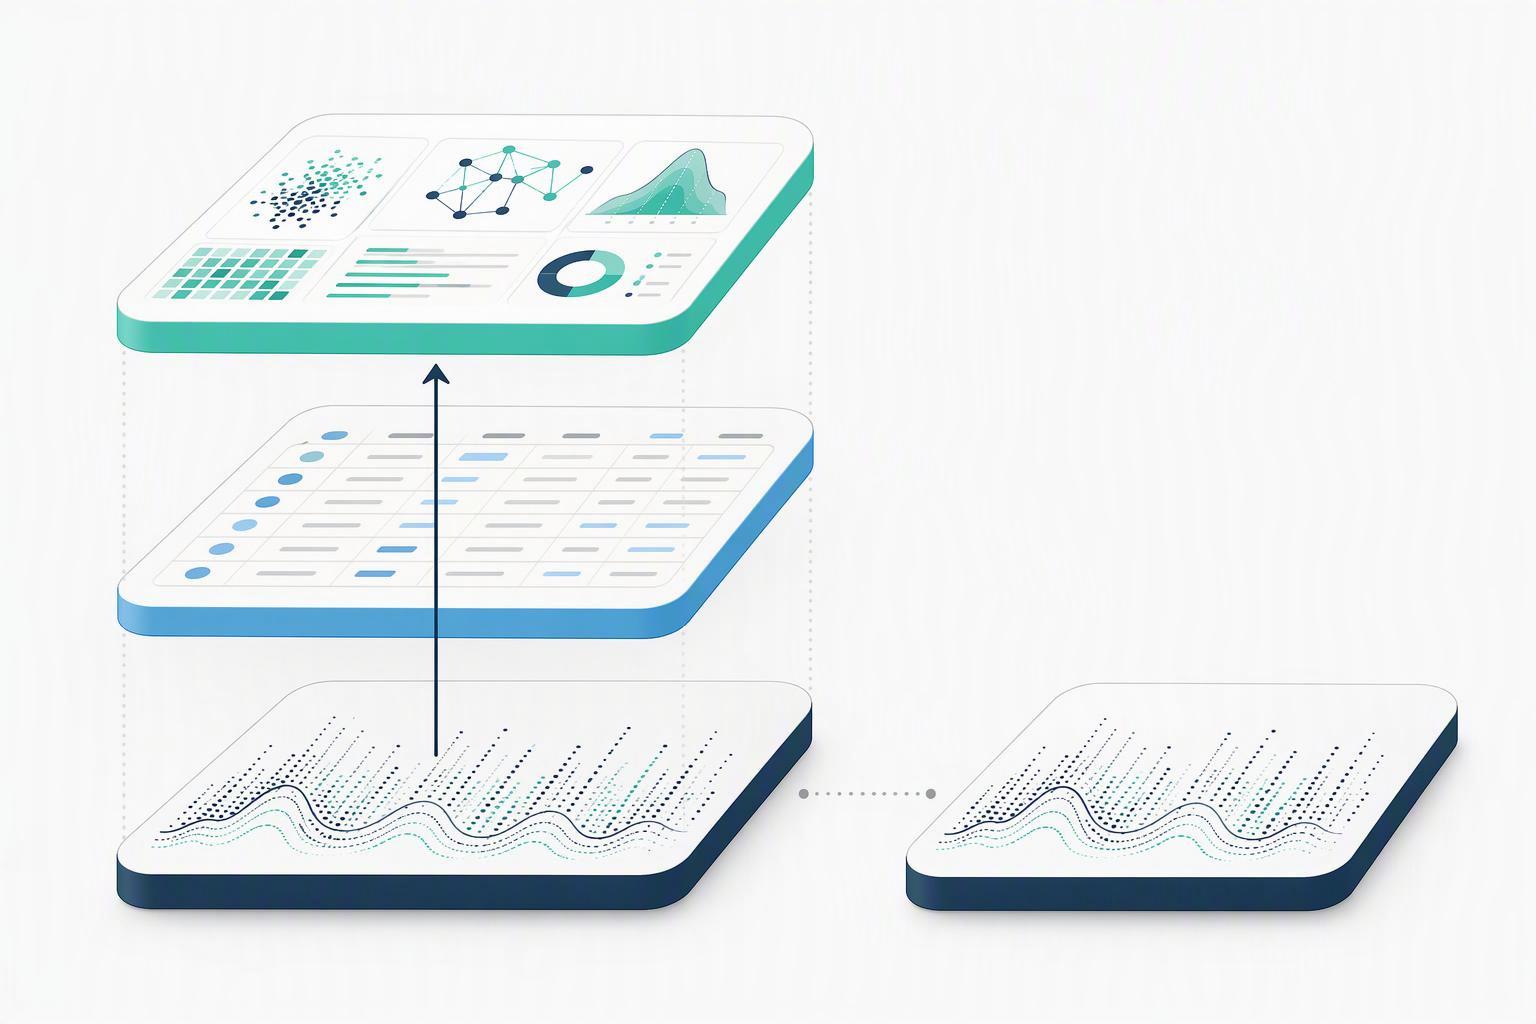
肽测试批发 肽 肽数据池是一个不可变的原始副本上的三层: 原始仪器捕获, 批次及其分析子项的结构化记录层, 以及峰值表的派生层, 特征和模型输出. 原始副本永远不会改变; 其他一切都可以从中重建.
该结构的情况是可测量的. 一个 2022 对公共色谱元数据的评估发现 70% 公共存储库中的色谱设置描述不完整, 并且只有 20.8% (312 的 1,501) 足够完整和正确,可以重复使用 (哈里德等人。, 代谢组学, 2022). 同一项研究的存储库拆分显示 MetaboLights 位于 174 的 468 描述完成 (37.2%) 和代谢组学工作台 276 的 1,033 (26.7%). 这些是公共存储库,其提交者重视数据共享, 作者指出这些数字可能高估了其他地方的正确性.
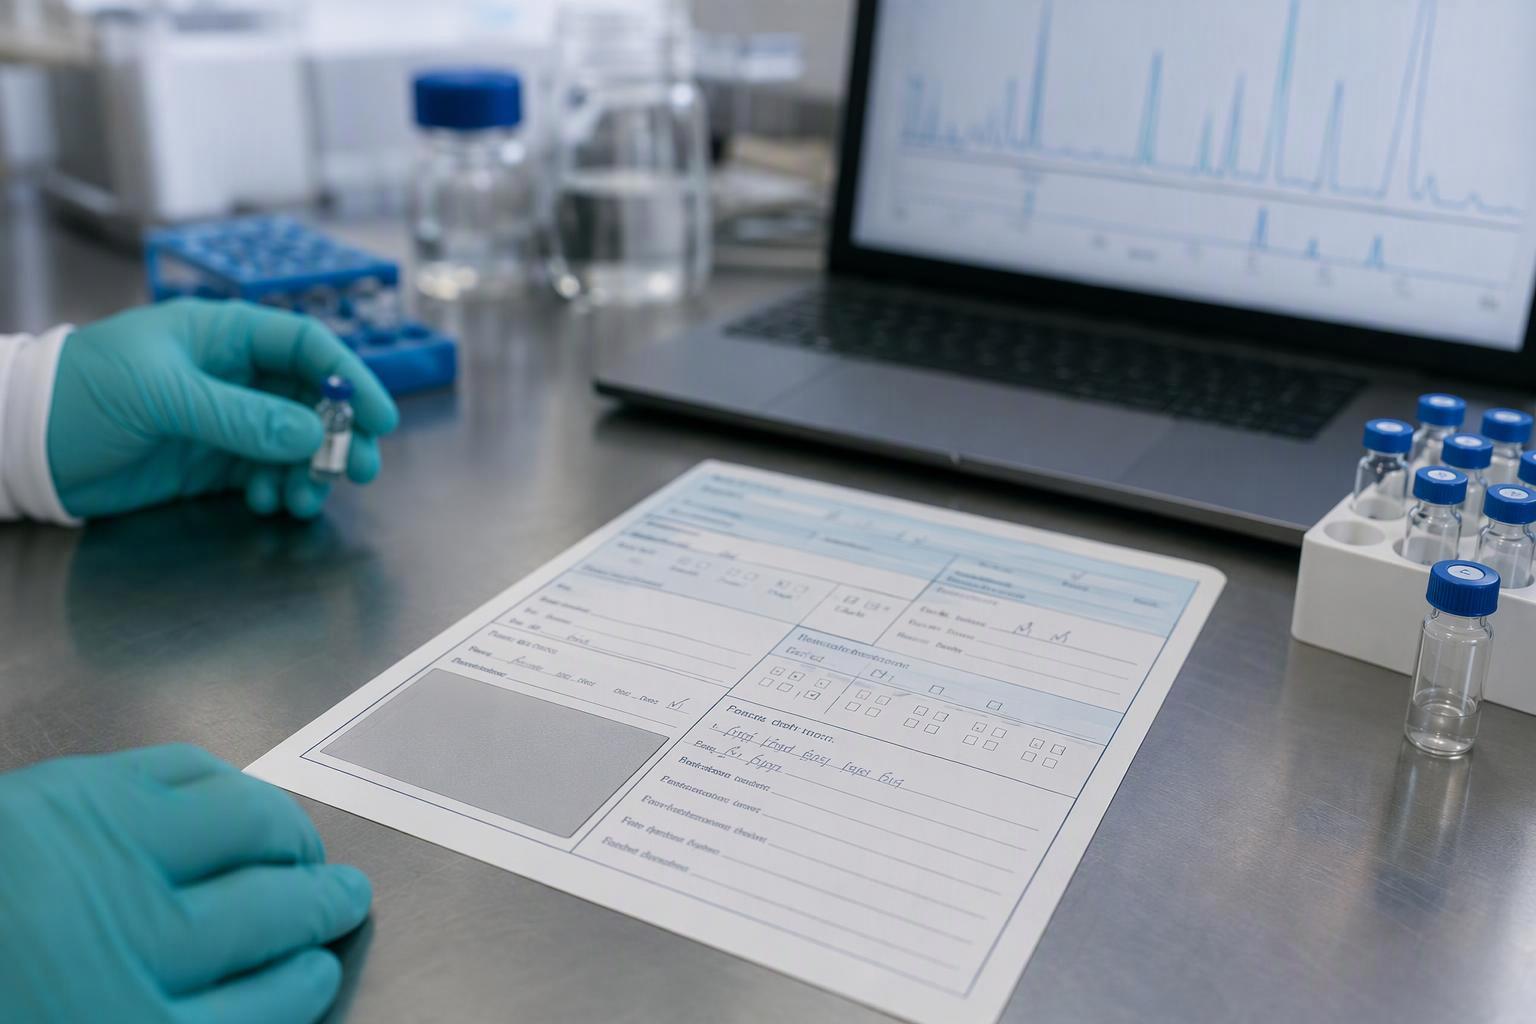
保持原始捕获完整的监管原因与重用论点是分开的. MHRA 将原始数据定义为首次捕获的信息, 无论是纸质还是电子形式, 元数据作为描述属性并给出上下文和含义的数据, 形成原始记录的组成部分 (MHRA GxP 数据完整性指南, 修订 1, 行进 2018). MHRA 的动态原始数据必须保持动态的立场遵循相同的定义: 打印的色谱图是静态记录,不能作为原始数据.
要点: 肽数据池是原始捕获, 三层结构化记录和派生特征, 原始副本不可变,并且每个派生工件都可以从中重建.
结构化标识符可以改进查询和来源. 共享驱动器还可以包含受控, 可追溯的记录; 法规需要保存和意义, 不是特定的数据库模式或外键实现.
合成批次及其分析子项的最小记录集
只有在指定记录本身的情况下,层的分离才有意义, 因此,最小架构将批记录与其分析子记录分开, 每个孩子都有自己的标识符, 方法参考和结果字段. 每批次一行的单个平面表无法容纳下一节中描述的连接, 并且它迫使不相关的测量进入共享列.
业界常见的 QC 现场模式是一个有用的起点, 不是规格. 定制合成供应商通常会记录分析 HPLC 的纯度, 质谱鉴定, 肽含量或肽净重, 以及包含 HPLC 色谱图和 MS 谱图的分析证书; 可选附加项目包括内毒素检测, 反离子分析, 通过卡尔费休和旋光测定水含量. 将其视为架构必须容纳的字段集, 并根据供应商自己的文件检查其实际现场列表.
|
场地 |
层 |
必需或有用 |
笔记 |
|---|---|---|---|
|
批次标识符 |
批 |
必需的 |
执着的, 从未在项目中重用 |
|
顺序和修改 |
批 |
必需的 |
结构化, 不是自由文本 (参见修改部分) |
|
合成方法及树脂 |
批 |
必需的 |
对方法记录的版本化引用 |
|
规模与产量 |
批 |
必需的 |
单位明确 |
|
反离子形式 |
批 |
必需的 |
TFA和醋酸酯是不同的材料 |
|
分析证书 |
批 |
必需的 |
附件加结构化结果字段 |
|
等分标识符 |
善于分析的孩子 |
必需的 |
父批次外键 |
|
注射和运行标识符 |
善于分析的孩子 |
必需的 |
父等分外键 |
|
方法版本 |
善于分析的孩子 |
要求 合成肽工厂 恼怒 |
变更控制方法表的链接 |
|
HPLC纯度结果 |
善于分析的孩子 |
必需的 |
价值, 单元, 积分参数 |
|
MS 鉴定结果 |
善于分析的孩子 |
必需的 |
观测质量与理论质量 |
|
肽含量 |
善于分析的孩子 |
必需的 |
方法命名为 (氮, 紫外线, 重量分析法) |
|
卡尔费休水分含量 |
善于分析的孩子 |
有用 |
如果针对水校正了含量,则为必填项 |
|
内毒素结果 |
分析型 美国肽 孩子 |
有用 |
规定的方法和限度 |
|
旋光度 |
善于分析的孩子 |
有用 |
规定的溶剂和温度 |
警告: 本蓝图中描述的材料仅供肽供应领域的研究使用. 这里没有任何内容支持剂量, 治疗性的, 诊断或个人使用声明, 并且数据模型不应暗示其他情况.
如何在不使用文件名粘合剂的情况下将合成记录连接到色谱图和质谱图
一旦这些记录存在, 池通过存储的标识符回答从合成批次到色谱图和质谱图的连接, 不是通过解析文件名. 链批量运行, 等分试样, 注射, 跑步, 文件, 处理结果, 每个链接都是一个带有时间戳和运算符的外键.
那条链子有正式的形状. 起源建模为实体和活动 (普罗沃-O) 描述由活动生成的结果, 源自输入实体并归因于代理, 这正是从原始文件中导出的经过重新处理的峰值表的结构 (W3C PROV-O 推荐, 2013). 您不需要本体来构建连接, 但你确实需要它的纪律: 每个派生的工件都指向它的来源.
容器格式已经为该学科预留了空间. Allotrope 的数据格式保留了审计存储和校验和以及数据, 采用基于 HDF5 的六组件结构,旨在用于分析数据的长期归档 (同素异形体数据格式 v1.5.3 RF, 释放 30 十一月 2020). 对于光谱, mzML 1.1.x 是当前开放的规范线, 及其自己的文档指出,峰值列表格式缺乏有关前体信号和相关采集元数据的信息 (HUPO-PSI mzML 存储库).
工作流程顺序是一个可记录的对象, 不是一个约定. §11.10 中的排序控制(f) 的 21 CFR部分 11 需要操作系统检查来强制执行允许的步骤和事件顺序, 这就是合成的原因, 等分试样, 运行和审查可审核的订单而不是习惯 (21 病死率 11.10). 肽的批次可追溯性取决于后处理的顺序.
警告: 重新处理的峰值表写回原始表会立即破坏连接和审计跟踪. 派生结果属于指向原始文件的新记录, 永远无法取代它.
应如何存储肽修饰以便模型可以使用它们
连接链携带批次, 但批次本身的化学成分也必须结构化: 修改是一个站点的记录, 化学, 大量增量和受控词汇加入, 不是附加到样本名称的字符串. 自由文本修改名称会破坏连接和任何必须跨批次推理的模型.
词汇量问题足够大,需要一个加入系统. Unimod 已记录 1,559 截至一月份的修改条目 2025, a 中引用的计数 2025 组合修饰识别论文 (赖等人., 2025). 将修改名称存储为文本的模式无法可靠地映射到该大小的词汇表, 同一篇论文指出,传统的搜索方法仅预先指定有限数量的修改, 通常是九个.
搜索引擎将修改视为搜索参数, 这与存储的事实相反. 吉祥物区分固定, 可变和独占修改, 测试变量修改的所有可能排列,并警告应谨慎使用变量修改 (矩阵科学吉祥物帮助, 未注明日期). 如果修改仅存在于搜索配置中, 它不在记录中,模型无法从中学习.
该模式必须包含的化学范围很广. 定制肽工作涵盖 N 端修饰,例如乙酰化, 生物素化, 荧光标记和聚乙二醇化; 侧链修饰,包括丝氨酸磷酸化, 苏氨酸和酪氨酸, 甲基化, 硫酸化和糖基化; C 末端修饰,例如酰胺化和酯形式; 以及特殊结构,包括头尾和侧链环化, 二硫化物, 钉合肽和支链肽, D-氨基酸和同位素标记. 多个同时修改是常规的, 所以记录从一开始就必须是一对多的.
FAIR 的互操作性条款 I3 要求元数据包含对其他元数据的限定引用, 这是加入加上结构化外键满足的原则 (公平原则, 威尔金森等人。, 2016). 以这种方式构建的修改表无需进一步工作即可用于 AI; 文本字段不是.
|
场地 |
例子: 磷酸丝氨酸 |
例子: N-末端乙酰基 |
|---|---|---|
|
地点 |
成为, 残基位置 12 |
N-末端 |
|
化学课 |
磷酸化 |
乙酰化 |
|
质量增量 |
+79.966 和 |
+42.011 和 |
|
词汇加入 |
Unimod 加入 |
Unimod 加入 |
|
证据 |
MS/MS 站点本地化 Gh肽 |
MS/MS 末端片段 |
|
方法参考 多肽工厂供应商 |
搜索配置版本 |
搜索配置版本 |
纯度, 身份, 内容, 稳定性和检测适用性是五个不同的领域
结构化修改是词汇学科的一半; 另一半是保持质量属性分开, 因为纯洁, 身份, 内容, 稳定性和测定适用性是五个独立的结果字段,回答五个不同的问题并通过不同的测试进行验证. 将它们折叠成一个“质量”列是肽记录中最常见的模式错误.
我Q2(R2) 根据分析程序的预期用途描述其性能特征. 它不强制要求本文的五字段数据模式或为每个方法分配相同的验证特征.
该指南还重新命名了自己的词汇. 其术语表故意将“验证特性”替换为“性能特性”,” 被描述为一种独立于技术的特征描述,可确保测量结果的质量 (我Q2(R2) 词汇表). 仍然使用被取代的 Q2 标记列的架构(R1) 列表与当前方法验证报告不匹配.
稳定性和测定适用性位于该表之外,需要自己的字段. 稳定性是带有研究标识符的时间和条件结果; 测定适用性是针对特定程序记录的方法级判断. 两者都不能从纯度百分比推导出来, 仅凭纯度百分比并不能确定化合物的身份, 这就是为什么纯度, 身份, 方法, 批号和文件必须一起审查.
实际结果是每个属性一个字段, 每个都有自己的方法参考, 单位及验收标准. 在合并的“质量分数”上训练的模型学习合并, 不是化学.
在人工智能层登上顶层之前,什么必须是可追踪的
判断是否为零件 11 应用并评估所有相关控制措施, 系统验证, 程序, 培训和保留. 仅访问权限和审核表实施并不能建立合规性. 根据风险和预期用途调整系统规模.
-
系统验证, 包括辨别无效或更改记录的能力.
-
以人类可读的电子形式提供准确完整的副本.
-
保护记录,以便在保留期内准确、方便地检索.
-
仅限授权个人访问.
-
安全的, 计算机生成的, 带时间戳的审计跟踪不会掩盖以前的信息.
-
执行允许的步骤和事件顺序的操作检查.
-
当局检查谁可以签名, 改变或执行操作.
-
设备检查数据源的有效性.
-
记录的教育, 系统用户的培训和经验.
-
书面政策要求个人对其电子签名下的行为负责.
-
对系统文档的控制, 包括带有审计跟踪的修订和变更控制.
变更控制子句涵盖方法版本. §11.10(k) 需要修订和变更控制程序,维护按时间顺序开发和修改系统文档的审计跟踪, 这是方法版本表必须满足的 (21 病死率 11.10(k)). MHRA 的 ALCOA 属性, 可归因的, 清晰易读, 同时期的, 原创且准确, 加完整, 持续的, 持久且可用, 用数据质量术语描述相同的要求 (MHRA GxP 数据完整性指南, 2018). 美国法规提供管制清单; 英国指南提供了属性.
FAIR 添加了一项控件未直接说明的条款: R1.2 要求数据与详细来源相关联, 这是审计追踪的研究数据版本 (公平原则, 2016). FAIR 和格式规范均未得到监管机构的认可, 所以将它们视为设计辅助工具, 不是合规证据.
警告: 满足这些控制的蓝图并不是经过验证的系统. 验证是针对预期用途的记录活动, 采用格式或本体并不能取代它.
AI 层实际适合的位置, 以及没有的地方
人工智能可以分析原始信号, 当该方法经过验证其预期目的时,已处理的特征或结构化结果. 保留源数据和处理沿袭, 控制访问, 并根据决策和适用框架评估模型可信度.
GxP 背景下的人工智能监管框架仍处于草案阶段. FDA 发布人工智能指南草案,以支持药品和生物制品的监管决策 7 一月 2025, 案卷 FDA-2024-D-4689, 评论已关闭 7 四月 2025 (联邦公报, 90 FR 1157, 2025). 它提出了一个基于风险的可信度评估框架,该框架建立在定义的使用环境之上, 具有针对该背景并取决于模型风险的可信度证据. 这是一个草案, 该通知指出,它不认可任何特定的人工智能方法.
即使在草稿中,框架的形状也具有指导意义. 它以七步可信度评估的形式运行: 定义感兴趣的问题, 定义使用上下文, 评估模型风险, 策划诚信活动, 执行计划, 记录结果和偏差, 并确定适用于使用环境的充分性 (古德温对 FDA 草案的分析, 一月 2025). 对于数据池来说最重要的一步是第二步: 没有明确的使用环境, 无论数据量有多少,模型都不会可信.
该草案的范围比实验室数据处理窄. 它涵盖用于生成支持安全监管决策的信息的人工智能, 有效性或质量, 它明确排除了不影响患者安全的药物发现和运营效率用途, 药品质量或研究结果的可靠性 (联邦公报, 90 FR 1157). 标记可能的纯度异常值以引起审阅者注意的模型是一种操作辅助工具; 其输出提供规范决策的模型在范围内.
发布人工智能就绪数据层的决策规则
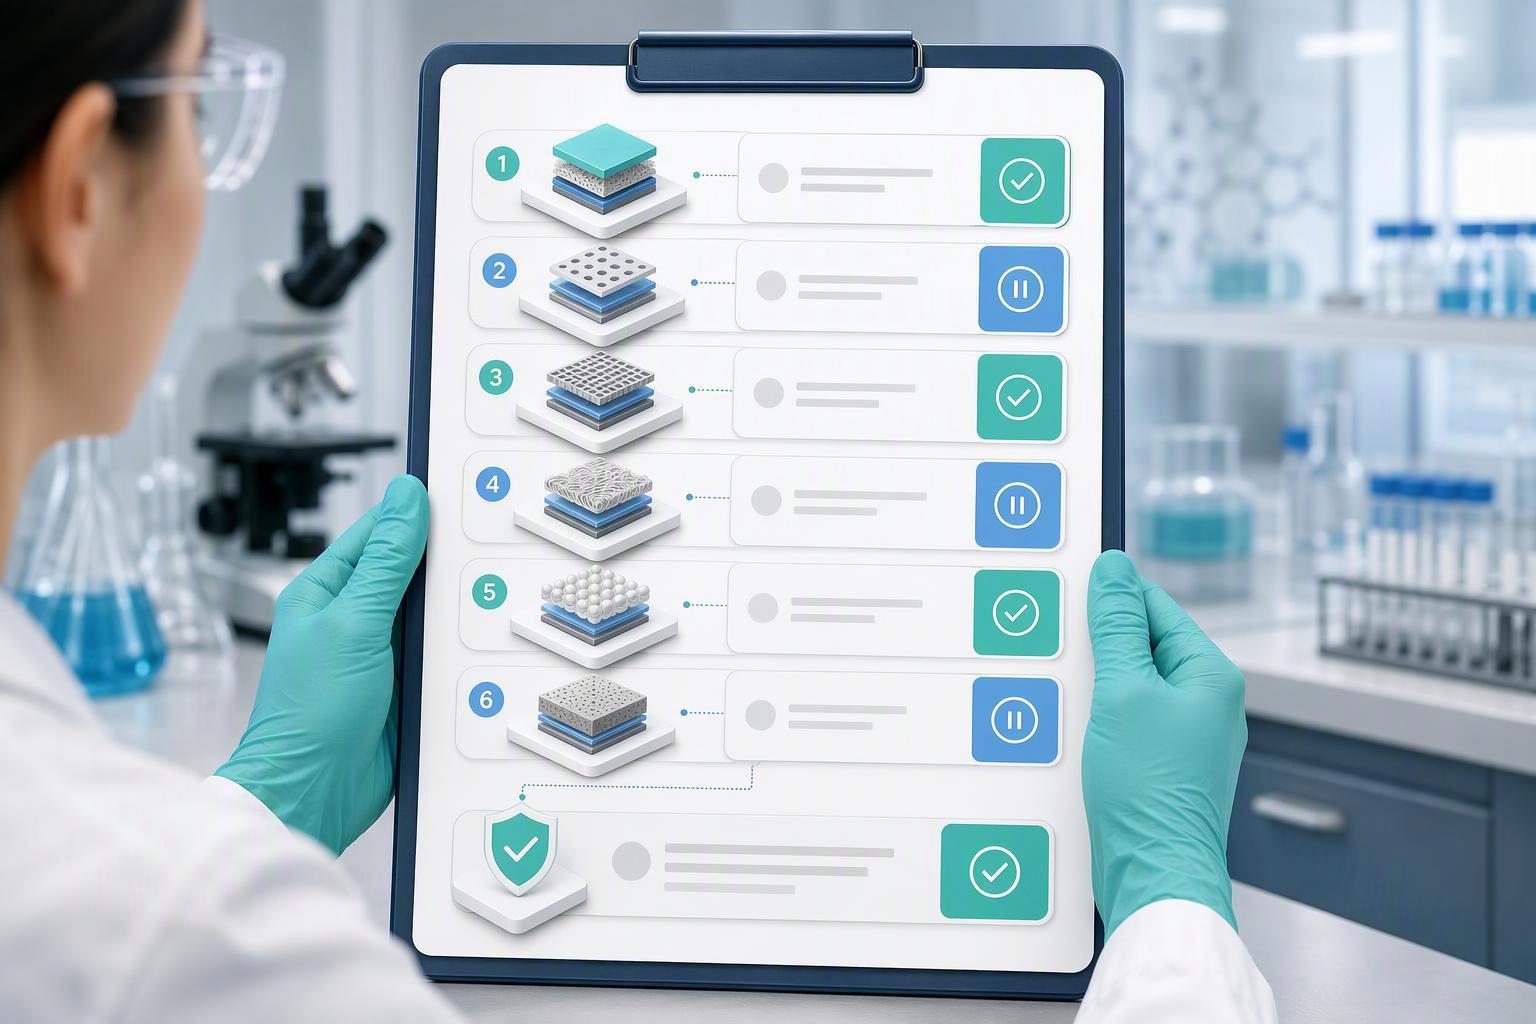
该边界是发布规则测试的内容, 因为当六个检查按顺序通过时,数据层就准备好承载模型, 第一次失败会停止发布. 在任何模型读取数据之前将它们应用到您自己的系统中.
- 以保留其含义和所需功能的形式保留原始记录和基本元数据. 电子动态记录可能需要本机数据; 原始纸质记录并非固有无效. 记录并验证任何转换或真实副本.
-
每个分析子进程都会解析其批处理,而不进行文件名解析. 连接链作为标识符存储, 并且查询会从任何色谱图或光谱中返回批次.
-
十一项 §11.10 控制措施得到满足或有记录, 风险评估差距. 审计跟踪和变更控制条款是首先要测试的条款 (21 病死率 11.10).
-
修改已加入记录, 不是文字. 每个修改都带有一个位点, 化学, 质量增量和词汇添加, 并且可以表示多个同时修改.
-
纯度, 身份, 内容, 稳定性和测定适用性是不同的领域,有自己的方法参考, 匹配 ICH Q2 中的属性特定测试矩阵(R2) (我Q2(R2), 2023).
-
在模型构建之前就写下了模型的使用上下文, FDA 草案描述的风险评估和可信度证据 (联邦公报, 90 FR 1157, 2025).
一个有效的例子使规则变得具体. 批次记录带有其标识符, 带有附加修饰的序列, 反离子形式和方法版本. 两个善于分析的孩子指着它: HPLC 纯度结果及其积分参数以及具有观测质量和理论质量的质谱. 两个孩子都指向他们的方法版本, 方法版本表携带变更历史. 导出的峰值表位于其自己的记录中, 指向原始文件并且永远不会写回它们. 读取该层的模型可以回答光谱属于哪个批次, 哪种方法产生了纯度值以及两个方法版本之间发生了什么变化.
如果您想根据真实记录测试规则, 与技术专家交谈或请求批量数据包演练,并将字段集与上表进行比较.
所描述的架构是从公共监管和标准文件中绘制的总体蓝图, 不是对任何供应商系统的描述。*
常见问题解答
什么是肽数据池?
肽数据池是一个三层存储: 仪器文件的不可变原始捕获, 用于合成批次及其分析子项的结构化记录层, 以及峰值表的派生层, 特征和模型输出. 原始层永远不会改变, 每个派生的工件都可以从中重建.
我们可以保留供应商原始格式而不是转换为 mzML?
将供应商原始文件保留为原始记录并转换为 mzML 1.1.x 以供共享和长期访问. mzML 文档指出峰值列表格式会丢失前兆信号和采集元数据, 因此峰值列表不能替代原始文件 (HUPO-PSI mzML 存储库). 转换是一个额外的派生工件, 不是替代品.
采用同素异形体或 FAIR 是否使系统合规?
不. Allotrope 的格式保留审计存储和校验和, FAIR 的 R1.2 要求提供详细出处, 但监管机构均未认可作为合规证据 (同素异形体数据格式; 公平原则). 合规性来自控制和验证, 不是容器.
FDA 人工智能指南是最终版吗?
不. 这是发布的指导草案 7 一月 2025, 评论已关闭 7 四月 2025, 并且声明不认可任何特定的人工智能方法 (联邦公报, 90 FR 1157). 将其使用环境和可信度评估框架作为设计参考, 不是一个要求.
结论
蓝图简化为一条规则: 保持原始捕获不可变, 将连接存储为标识符, 并将五个质量属性分成各自的字段. 人工智能就绪分析工作流程中的其他一切都遵循这三个决策, 它们背后的来源是公共监管和标准文本,而不是供应商的声明.
现在采取行动的证据是完整性差距. 公共存储库研究仅发现 20.8% 色谱描述的完整性足以重复使用, 这些提交者有动力分享 (哈里德等人。, 代谢组学, 2022). 没有模式构建的内部记录往往看起来相同, 当模型或审核员要求加入时,成本就会浮现出来.
下一步是将六检查决策规则应用于一个真实批次: 提取其分析证书, 其色谱图和质谱图, 并查看系统是否可以回答光谱属于哪个批次以及哪个方法版本产生了纯度值. 如果不能的话, 差距已创纪录, 不在模型中.