Risposta rapida
Valutare la tracciabilità effettiva del sistema, metadati e controlli di audit. Questo progetto identifica potenziali lacune ma non fornisce alcuna prevalenza misurata tra i pepti...
Uno stagno di dati sui peptidi in una pagina
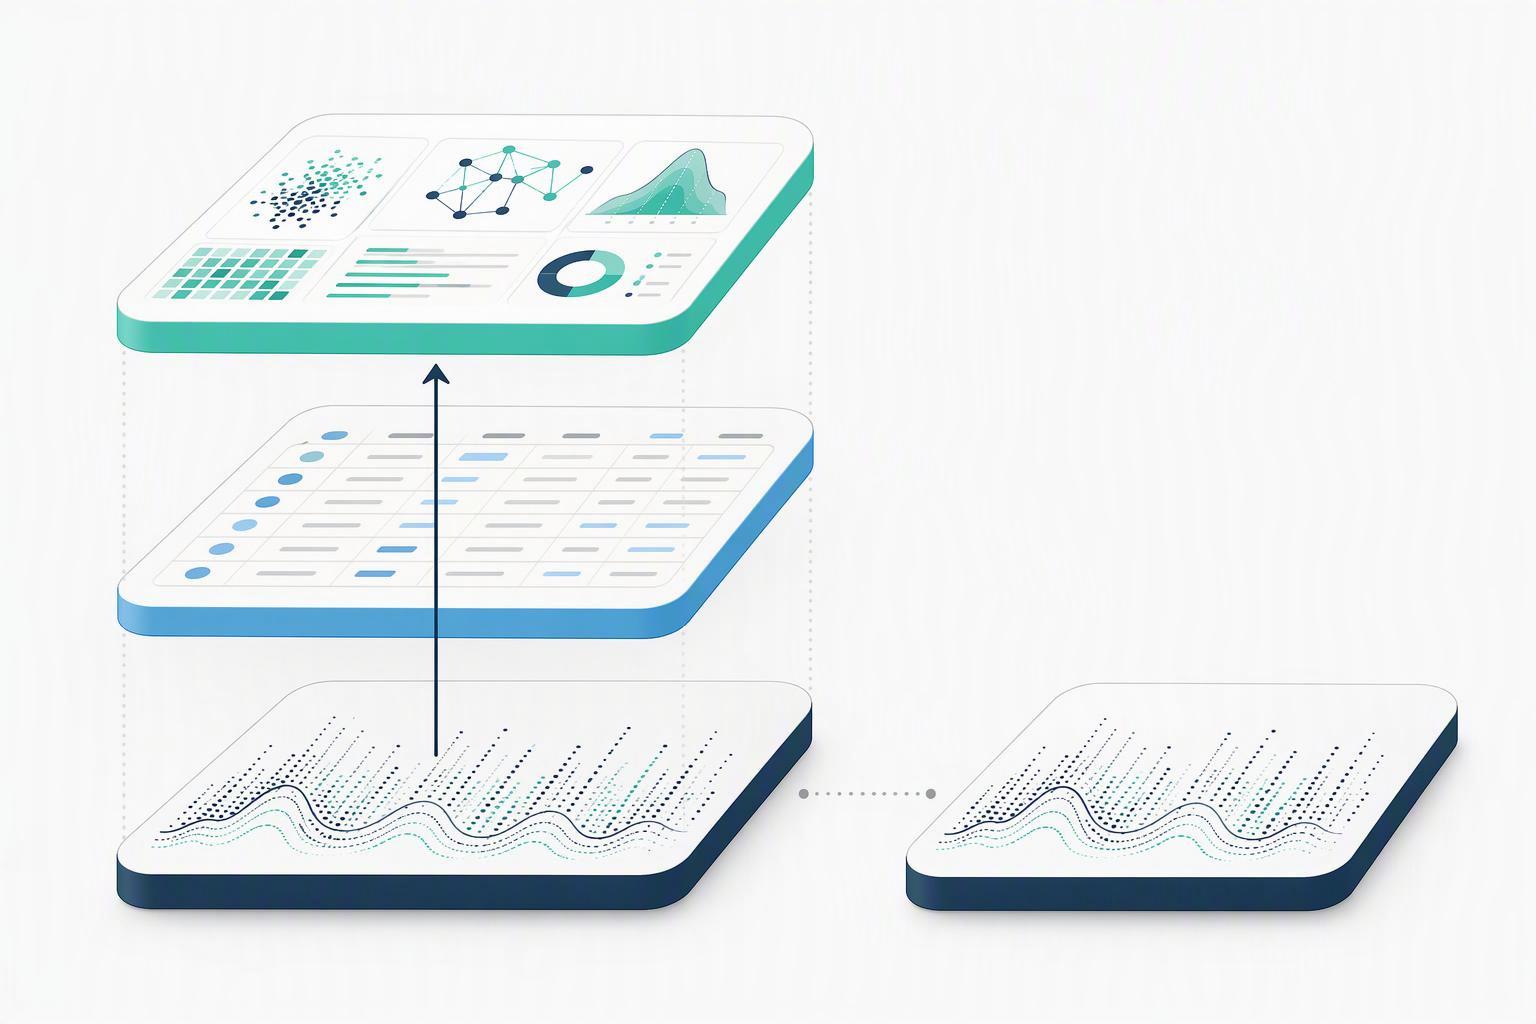
Test dei peptidi all'ingrosso Peptidi Uno stagno di dati peptidici è costituito da tre strati su una copia grezza immutabile: la cattura dello strumento originale, un livello di record strutturato per i batch e i relativi figli analitici, e uno strato derivato per le tabelle dei picchi, caratteristiche e risultati del modello. La copia grezza non cambia mai; tutto il resto può essere ricostruito da esso.
Il caso di quella struttura è misurabile. UN 2022 la valutazione dei metadati cromatografici pubblici ha rilevato che 70% delle descrizioni delle impostazioni cromatografiche negli archivi pubblici erano incomplete, e solo 20.8% (312 Di 1,501) erano sufficientemente completi e corretti da poter essere riutilizzati (Harrieder et al., Metabolomica, 2022). La suddivisione repository per repository dello stesso studio mostra MetaboLights a 174 Di 468 descrizioni complete (37.2%) e Banco di lavoro per la metabolomica presso 276 Di 1,033 (26.7%). Quelli sono archivi pubblici i cui presentatori apprezzano la condivisione dei dati, e gli autori notano che le cifre potrebbero sovrastimare la correttezza altrove.
La ragione normativa per mantenere intatta la cattura grezza è separata dall’argomento del riutilizzo. MHRA definisce i dati grezzi come la prima acquisizione di informazioni, sia su supporto cartaceo che elettronico, e metadati come dati che descrivono attributi e forniscono contesto e significato, costituenti parte integrante del documento originale (Guida all'integrità dei dati MHRA GxP, Revisione 1, Marzo 2018). La posizione dell’MHRA secondo cui i dati grezzi dinamici devono rimanere dinamici deriva dalla stessa definizione: un cromatogramma stampato è una registrazione statica e non può fungere da dati grezzi.
Chiave da asporto: Uno stagno di dati peptidici è una cattura grezza, record strutturati e caratteristiche derivate in tre livelli, con la copia grezza immutabile e ogni artefatto derivato ricostruibile da essa.
Gli identificatori strutturati possono migliorare le interrogazioni e la provenienza. Un'unità condivisa può contenere anche elementi controllati, registrazioni tracciabili; le normative richiedono preservazione e significato, non un particolare schema di database o un'implementazione di chiave esterna.
Il record minimo impostato per un batch di sintesi e i suoi figli analitici
Questa separazione dei livelli ripaga solo se i record stessi vengono specificati, quindi l'architettura minima separa un record batch dai suoi figli analitici, e ogni bambino porta i propri identificatori, riferimento al metodo e campi dei risultati. Una singola tabella piatta con una riga per lotto non può contenere i join descritti nella sezione successiva, e forza le misurazioni non correlate in colonne condivise.
Il modello di campo CQ comune del settore è un utile punto di partenza, non una specifica. I fornitori di sintesi personalizzata in genere documentano la purezza dell'HPLC analitico, spettrometria di massa per l'identità, contenuto di peptidi o peso netto dei peptidi, e un certificato di analisi rilasciato con un cromatogramma HPLC e uno spettro MS; i componenti aggiuntivi opzionali includono il test delle endotossine, analisi dei controioni, contenuto d'acqua di Karl Fischer e rotazione ottica. Consideralo come l'insieme di campi che lo schema deve ospitare, e controllare l'effettivo elenco dei campi di qualsiasi fornitore rispetto ai suoi stessi documenti.
|
Campo |
Strato |
Necessario o utile |
Note |
|---|---|---|---|
|
Identificatore del lotto |
Lotto |
Necessario |
Persistente, mai riutilizzato in tutti i progetti |
|
Sequenza e modifiche |
Lotto |
Necessario |
Strutturato, non testo libero (vedere la sezione modifica) |
|
Metodo di sintesi e resina |
Lotto |
Necessario |
Riferimento con versione a un record di metodo |
|
Scala e rendimento |
Lotto |
Necessario |
Unità esplicite |
|
Forma del controione |
Lotto |
Necessario |
TFA e acetato sono materiali diversi |
|
Certificato di analisi |
Lotto |
Necessario |
Allegato più campi dei risultati strutturati |
|
Identificatore dell'aliquota |
Bambino analitico |
Necessario |
Chiave esterna del batch padre |
|
Identificatore dell'iniezione e della corsa |
Bambino analitico |
Necessario |
Chiave esterna dell'aliquota principale |
|
Versione del metodo |
Bambino analitico |
Richiesto Fabbrica di peptidi sintetici infiammato |
Collegamenti alla tabella dei metodi controllati dalle modifiche |
|
Risultato della purezza HPLC |
Bambino analitico |
Necessario |
Valore, unità, parametri di integrazione |
|
Risultato dell'identità della SM |
Bambino analitico |
Necessario |
Massa osservata e massa teorica |
|
Contenuto peptidico |
Bambino analitico |
Necessario |
Metodo nominato (azoto, UV, gravimetrico) |
|
Contenuto d'acqua Karl Fischer |
Bambino analitico |
Utile |
Obbligatorio se il contenuto è corretto per l'acqua |
|
Risultato endotossina |
Analitico Peptidi Usa bambino |
Utile |
Metodo e limite indicati |
|
Rotazione ottica |
Bambino analitico |
Utile |
Solvente e temperatura dichiarati |
Avvertimento: Il materiale descritto in questo progetto è destinato esclusivamente alla ricerca nel contesto della fornitura di peptidi. Niente qui supporta il dosaggio, terapeutico, affermazioni diagnostiche o per uso personale, e un modello di dati non dovrebbe implicare il contrario.
Come unire i record di sintesi ai cromatogrammi e agli spettri di massa senza colla dei nomi dei file
Una volta che questi record esistono, lo stagno risponde all'unione dal lotto di sintesi al cromatogramma e allo spettro di massa attraverso identificatori memorizzati, non analizzando un nome file. La catena funziona in batch, aliquota, iniezione, correre, file, risultato elaborato, e ogni collegamento è una chiave esterna con un timestamp e un operatore.
Quella catena ha una forma formale. Provenienza modellata come entità e attività (PROV-O) descrive un risultato generato da un'attività, derivato da un'entità di input e attribuito a un agente, che è esattamente la struttura di una tabella dei picchi rielaborata derivata da un file grezzo (Raccomandazione PROV-O del W3C, 2013). Non è necessaria l'ontologia per creare il join, ma hai bisogno della sua disciplina: ogni artefatto derivato indica da dove proviene.
I formati contenitore già riservano spazio a questa disciplina. Il formato dei dati di Allotrope riserva un archivio di controllo e checksum insieme ai dati, in una struttura a sei componenti costruita su HDF5 e destinata all'archiviazione a lungo termine di dati analitici (Formato dati allotropi v1.5.3 RF, rilasciato 30 novembre 2020). Per gli spettri, mzML 1.1.x è l'attuale linea di specifiche aperte, e la sua stessa documentazione afferma che i formati degli elenchi di picchi mancano di informazioni sui segnali precursori e sui metadati di acquisizione associati (Repository HUPO-PSI mzML).
L'ordine del flusso di lavoro è un oggetto registrabile, non una convenzione. Il controllo sequenziale in §11.10(F) Di 21 CFR parte 11 richiede controlli del sistema operativo che impongano la sequenza consentita di passaggi ed eventi, che è ciò che fa la sintesi, aliquota, eseguire e rivedere un ordine verificabile piuttosto che un'abitudine (21 CFR 11.10). La tracciabilità dei lotti per i peptidi dipende dall'ordine che sopravvive al ritrattamento.
Avvertimento: Una tabella dei picchi rielaborata e riscritta sopra l'originale distrugge contemporaneamente il join e la traccia di controllo. I risultati derivati appartengono a un nuovo record che punta al file non elaborato, mai al suo posto.
Come dovrebbero essere conservate le modifiche dei peptidi in modo che un modello possa utilizzarle
La catena di join trasporta il batch, ma anche la chimica del lotto deve essere strutturata: una modifica è un record con un sito, una chimica, un delta di massa e un'accesso al vocabolario controllato, non una stringa aggiunta al nome di un campione. I nomi di modifica con testo libero interrompono sia il join che qualsiasi modello che deve ragionare tra batch.
Il problema del vocabolario è abbastanza grande da richiedere un sistema di adesione. Unimod documentato 1,559 voci di modifica a partire da gennaio 2025, un conteggio citato in a 2025 articolo sull'identificazione delle modifiche combinatorie (Lai et al., 2025). Uno schema che memorizza i nomi delle modifiche come testo non può essere mappato in modo affidabile su un vocabolario di quelle dimensioni, e lo stesso articolo rileva che i metodi di ricerca convenzionali specificano in anticipo solo un numero limitato di modifiche, tipicamente nove.
I motori di ricerca trattano le modifiche come parametri di ricerca, che è l'opposto di un fatto memorizzato. La mascotte distingue fissa, modifiche variabili ed esclusive, verifica tutte le possibili disposizioni delle modifiche variabili e avverte che le modifiche variabili dovrebbero essere utilizzate con parsimonia (Aiuto della mascotte di Matrix Science, senza data). Se la modifica esiste solo in una configurazione di ricerca, non è registrato e un modello non può imparare da esso.
La gamma chimica che lo schema deve contenere è ampia. Il lavoro peptidico personalizzato comprende modifiche N-terminali come l'acetilazione, biotinilazione, etichette fluorescenti e PEGilazione; modifiche della catena laterale inclusa la fosforilazione sulla serina, treonina e tirosina, metilazione, solfatazione e glicosilazione; Modifiche C-terminali come amidazione e forme estere; e strutture speciali tra cui la ciclizzazione testa-coda e catena laterale, disolfuri, peptidi pinzati e ramificati, D-amminoacidi e marcatura isotopica. Molteplici modifiche simultanee sono di routine, quindi il record deve essere uno-a-molti fin dall'inizio.
La clausola I3 di interoperabilità di FAIR richiede che i metadati includano riferimenti qualificati ad altri metadati, che è il principio che un'adesione più una chiave esterna strutturata soddisfa (Principi GO FAIR, Wilkinson et al., 2016). Una tabella di modifica creata in questo modo è pronta per l'intelligenza artificiale senza ulteriore lavoro; un campo di testo non lo è.
|
Campo |
Esempio: fosfoserina |
Esempio: Acetile N-terminale |
|---|---|---|
|
Sito |
Essere, posizione dei residui 12 |
N-terminale |
|
Lezione di chimica |
Fosforilazione |
Acetilazione |
|
Delta di massa |
+79.966 E |
+42.011 E |
|
Accesso al vocabolario |
Adesione all'Unimod |
Adesione all'Unimod |
|
Prova |
Localizzazione di siti MS/MS Peptidi Gh |
Frammento terminale MS/MS |
|
Riferimento al metodo Fornitore della fabbrica di peptidi |
Cerca la versione della configurazione |
Cerca la versione della configurazione |
Purezza, Identità, Contenuto, Stabilità e idoneità al test sono cinque campi diversi
Le modifiche strutturate rappresentano la metà della disciplina del vocabolario; l'altra metà tiene separati gli attributi di qualità, perché la purezza, identità, contenuto, la stabilità e l'idoneità del test sono cinque campi di risultati separati che rispondono a cinque domande diverse e sono convalidati da test diversi. Comprimerli in un'unica colonna "qualità" è l'errore di schema più comune nei record dei peptidi.
Io Q2(R2) descrive le caratteristiche prestazionali delle procedure analitiche in base all'uso previsto. Non impone lo schema di dati a cinque campi di questo articolo né assegna le stesse caratteristiche di convalida a ogni metodo.
La linea guida ha anche rinominato il proprio vocabolario. Il suo glossario sostituisce deliberatamente “caratteristica di validazione” con “caratteristica di prestazione”.," Descritto come una descrizione indipendente dalla tecnologia di una caratteristica che garantisce la qualità del risultato misurato (Io Q2(R2) glossario). Uno schema che etichetta ancora le colonne con il Q2 sostituito(R1) l'elenco non corrisponderà ai report di convalida del metodo correnti.
La stabilità e l'idoneità al test si trovano fuori da quella tabella e necessitano dei propri campi. La stabilità è un risultato tempo e condizione con un identificatore di studio; l'idoneità del test è un giudizio a livello di metodo registrato rispetto a una procedura specifica. Nessuno dei due è derivabile da una percentuale di purezza, e una percentuale di purezza da sola non stabilisce l'identità del composto, ecco perché la purezza, identità, metodo, il numero di lotto e la documentazione devono essere esaminati insieme.
La conseguenza pratica è un campo per attributo, ciascuno con il proprio riferimento al metodo, unità e criterio di accettazione. Un modello addestrato su un "punteggio di qualità" unito apprende l'unione, non la chimica.
Cosa deve essere tracciabile prima che uno strato AI sia in cima
Determinare se la Parte 11 applica e valuta tutti i controlli rilevanti, validazione del sistema, procedure, formazione e mantenimento. Le autorizzazioni di accesso e l'implementazione di una tabella di controllo da sole non garantiscono la conformità. Adattare il sistema ai rischi e all'uso previsto.
-
Validazione dei sistemi, inclusa la capacità di discernere record non validi o alterati.
-
Copie accurate e complete in formato leggibile dall'uomo ed elettronico.
-
Protezione dei documenti per un recupero accurato e pronto durante il periodo di conservazione.
-
Accesso limitato alle persone autorizzate.
-
Sicuro, generato dal computer, tracce di controllo con timestamp che non oscurano le informazioni precedenti.
-
Controlli operativi che impongono la sequenza consentita di passaggi ed eventi.
-
L'autorità controlla chi può firmare, alterare o eseguire un'operazione.
-
Il dispositivo controlla la validità dell'origine dati.
-
Educazione documentata, formazione ed esperienza per gli utenti del sistema.
-
Politiche scritte che ritengono gli individui responsabili delle azioni effettuate sotto le loro firme elettroniche.
-
Controlli sulla documentazione dei sistemi, inclusa la revisione e il controllo delle modifiche con una traccia di controllo.
La clausola di controllo delle modifiche copre le versioni del metodo. §11.10(k) richiede procedure di revisione e controllo delle modifiche che mantengano una traccia di controllo dello sviluppo sequenziato nel tempo e della modifica della documentazione dei sistemi, che è ciò che una tabella delle versioni del metodo deve soddisfare (21 CFR 11.10(k)). Attributi ALCOA di MHRA, attribuibile, leggibile, contemporaneo, originale e accurato, più completo, coerente, duraturo e disponibile, descrivere lo stesso requisito in termini di qualità dei dati (Guida all'integrità dei dati MHRA GxP, 2018). La normativa statunitense fornisce la lista di controllo; la guida del Regno Unito fornisce gli attributi.
FAIR aggiunge una clausola che i controlli non dichiarano direttamente: R1.2 richiede che i dati siano associati alla provenienza dettagliata, che è la versione dei dati di ricerca della pista di controllo (Principi GO FAIR, 2016). Né FAIR né le specifiche del formato sono approvati da un regolatore, quindi trattali come aiuti alla progettazione, non prove di conformità.
Avvertimento: Un progetto che soddisfa questi controlli non è un sistema convalidato. La convalida è un'attività documentata rispetto all'uso previsto, e l'adozione di un formato o di un'ontologia non la sostituisce.
Dove si adatta effettivamente il livello AI, e dove no
L’intelligenza artificiale può analizzare i segnali grezzi, caratteristiche elaborate o risultati strutturati quando l'approccio è convalidato per lo scopo previsto. Preservare i dati di origine e la derivazione dell'elaborazione, controllare l'accesso, e valutare la credibilità del modello in base alla decisione e al quadro applicabile.
Il quadro normativo per l’IA in un contesto GxP è ancora in bozza. La FDA ha pubblicato una bozza di linee guida sull'intelligenza artificiale per supportare il processo decisionale normativo per i farmaci e i prodotti biologici 7 Gennaio 2025, scheda FDA-2024-D-4689, con commenti chiusi 7 aprile 2025 (Registro federale, 90 FR 1157, 2025). Propone un quadro di valutazione della credibilità basato sul rischio costruito su un contesto d’uso definito, con prove di credibilità adattate al contesto e dipendenti dal rischio del modello. È una bozza, e l’avviso afferma di non sostenere alcun approccio specifico all’IA.
La forma della struttura è istruttiva anche in bozza. Funziona come una valutazione della credibilità in sette fasi: definire la questione di interesse, definire il contesto d’uso, valutare il rischio del modello, pianificare attività di credibilità, eseguire il piano, documentare i risultati e le deviazioni, e determinare l’adeguatezza al contesto d’uso (Analisi Goodwin della bozza della FDA, Gennaio 2025). Il passaggio che conta per un data pool è il secondo: senza un contesto d’uso definito, nessuna quantità di volume di dati rende credibile un modello.
L’ambito della bozza è più ristretto rispetto all’elaborazione dei dati di laboratorio. Riguarda l'intelligenza artificiale utilizzata per produrre informazioni a supporto delle decisioni normative sulla sicurezza, efficacia o qualità, ed esclude esplicitamente la scoperta di farmaci e gli usi di efficienza operativa che non influiscono sulla sicurezza del paziente, qualità del farmaco o affidabilità dei risultati dello studio (Registro federale, 90 FR 1157). Un modello che segnala probabili valori anomali di purezza all’attenzione di un revisore è un aiuto operativo; rientra nell'ambito un modello il cui output alimenta una decisione relativa alle specifiche.
Una regola decisionale per il rilascio di un livello dati pronto per l'intelligenza artificiale
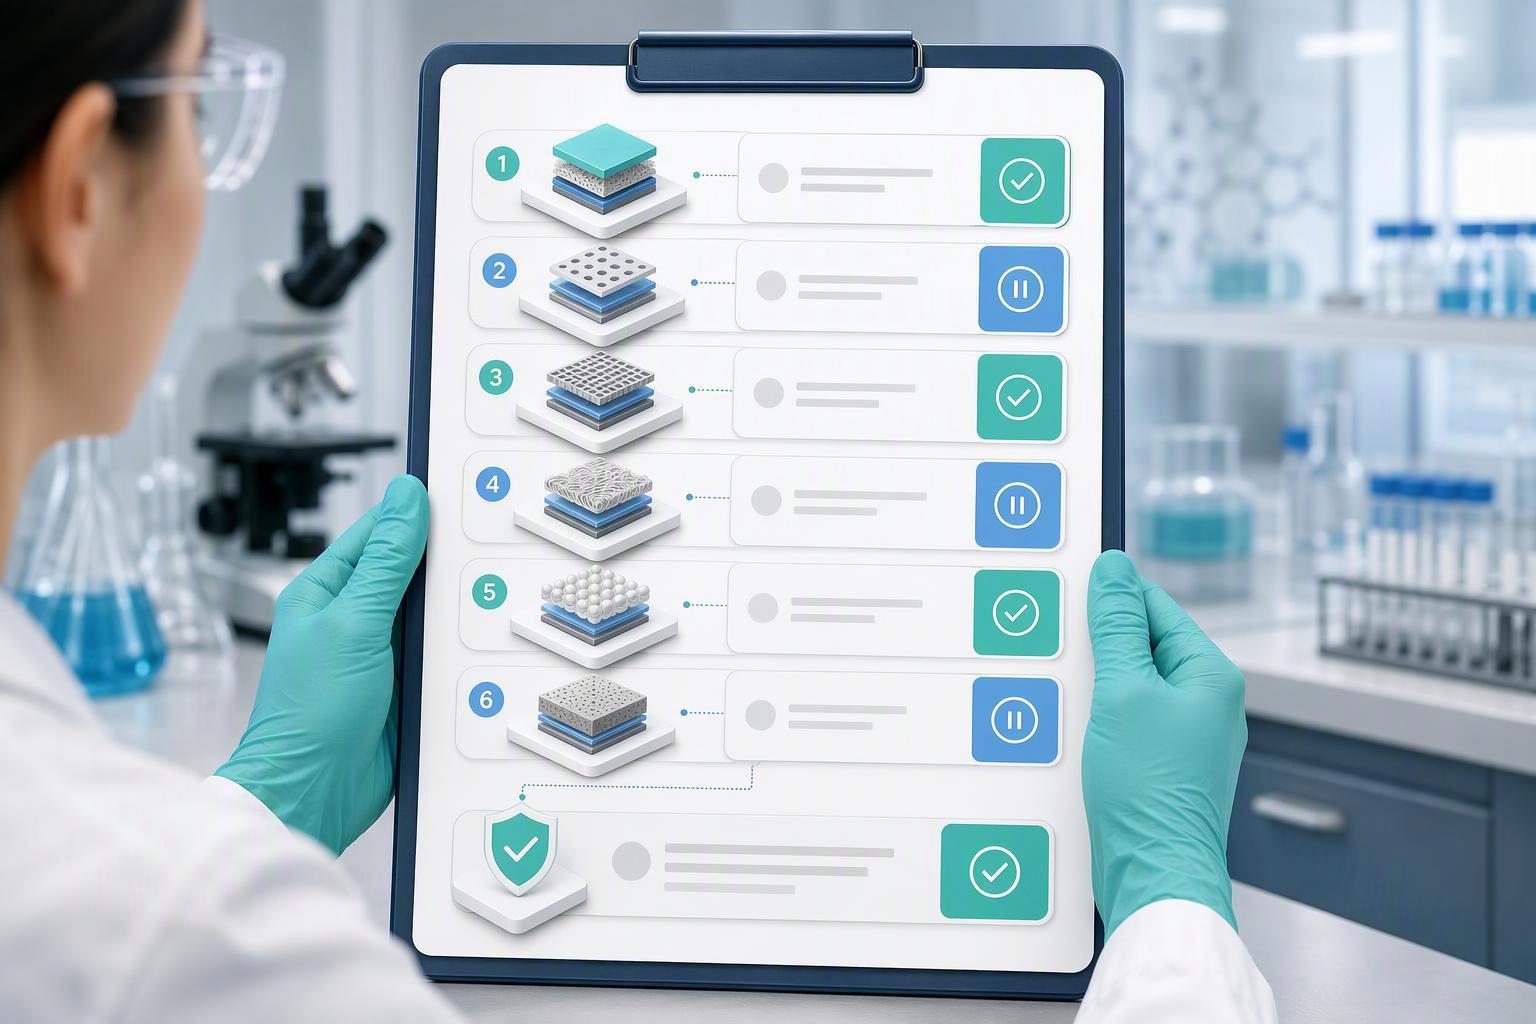
Questo limite è ciò che verifica la regola di rilascio, perché un livello dati è pronto a trasportare un modello quando vengono superati sei controlli in ordine, e il primo fallimento interrompe il rilascio. Applicali al tuo sistema prima che qualsiasi modello legga da esso.
- Conservare i record originali e i metadati essenziali in una forma che ne preservi il significato e la funzionalità richiesta. I record dinamici elettronici potrebbero richiedere dati nativi; i documenti cartacei originali non sono intrinsecamente invalidi. Documentare e verificare qualsiasi conversione o copia fedele.
-
Ogni figlio analitico si risolve nel proprio batch senza l'analisi del nome file. La catena di join viene archiviata come identificatori, e una query restituisce il batch da qualsiasi cromatogramma o spettro.
-
Gli undici controlli §11.10 sono soddisfatti o sono documentati, divario valutato in termini di rischio. Le clausole di audit trail e di controllo delle modifiche sono quelle da testare per prime (21 CFR 11.10).
-
Le modifiche sono record con accesso, non testo. Ogni modifica porta un sito, chimica, delta di massa e accesso al vocabolario, e sono rappresentabili più modifiche simultanee.
-
Purezza, identità, contenuto, la stabilità e l'idoneità al test sono campi separati con i propri riferimenti al metodo, corrispondente alla matrice di test specifica per l'attributo in ICH Q2(R2) (Io Q2(R2), 2023).
-
Il contesto d’uso del modello viene scritto prima che il modello venga costruito, con la valutazione del rischio e le prove di credibilità descritte nella bozza della FDA (Registro federale, 90 FR 1157, 2025).
Un esempio pratico rende concreta la regola. Un batch record porta il suo identificatore, sequenza con modifiche aggiunte, Forma del controione e versioni del metodo. Due bambini analitici lo indicano: un risultato di purezza HPLC con i suoi parametri di integrazione e uno spettro di massa con massa osservata e teorica. Entrambi i bambini indicano le loro versioni del metodo, e la tabella delle versioni del metodo contiene una cronologia delle modifiche. Una tabella dei picchi derivata si trova nel proprio record, punta ai file grezzi e non viene mai riscritto su di essi. Il modello che legge questo livello può rispondere a quale lotto appartiene uno spettro, quale metodo ha prodotto un valore di purezza e cosa è cambiato tra le due versioni del metodo.
Se vuoi testare la regola rispetto a record reali, parlare con un esperto tecnico o richiedere una procedura dettagliata sul pacchetto dati batch e confrontare il campo impostato con la tabella sopra.
L'architettura descritta è un modello generale tratto da documenti normativi e normativi pubblici, non una descrizione del sistema di alcun fornitore.*
Domande frequenti
Cos'è uno stagno di dati sui peptidi?
Un data pool di peptidi è un archivio a tre strati: un'acquisizione grezza immutabile dei file dello strumento, uno strato di record strutturato per i lotti di sintesi e i relativi figli analitici, e uno strato derivato per le tabelle dei picchi, caratteristiche e risultati del modello. Lo strato grezzo non cambia mai, e ogni artefatto derivato può essere ricostruito da esso.
Possiamo mantenere i formati raw del fornitore invece di convertirli in mzML?
Conserva i file raw del fornitore come record raw e convertili in mzML 1.1.x per la condivisione e l'accesso a lungo termine. La documentazione mzML afferma che i formati peak-list perdono segnali precursori e metadati di acquisizione, quindi un elenco dei picchi non sostituisce il file raw (Repository HUPO-PSI mzML). La conversione è un ulteriore artefatto derivato, non una sostituzione.
L'adozione di Allotrope o FAIR rende il sistema conforme?
NO. Il formato di Allotrope riserva un archivio di controllo e checksum, e R1.2 di FAIR richiede una provenienza dettagliata, ma nessuno dei due è approvato da un regolatore come prova di conformità (Formato dati allotropi; Principi GO FAIR). La conformità deriva dai controlli e dalla convalida, non il contenitore.
La guida AI della FDA è definitiva?
NO. Si tratta di una bozza di linee guida pubblicata 7 Gennaio 2025, con commenti chiusi 7 aprile 2025, e afferma di non sostenere alcun approccio specifico all’IA (Registro federale, 90 FR 1157). Trattare il contesto d'uso e il quadro di valutazione della credibilità come un riferimento di progettazione, non è un requisito.
Conclusione
Il progetto si riduce a una regola: mantenere immutabile l'acquisizione grezza, memorizzare i join come identificatori, e separare i cinque attributi di qualità nei rispettivi campi. Tutto il resto in un flusso di lavoro analitico pronto per l'intelligenza artificiale deriva da queste tre decisioni, e le fonti dietro di essi sono testi normativi e standard pubblici piuttosto che affermazioni dei fornitori.
La prova per agire ora è il divario di completezza. È stato trovato solo uno studio sull'archivio pubblico 20.8% di descrizioni cromatografiche sufficientemente complete da poter essere riutilizzate, e i presentatori erano motivati a condividere (Harrieder et al., Metabolomica, 2022). I record interni creati senza uno schema tendono ad avere lo stesso aspetto, e il costo emerge quando un modello o un revisore richiede l'adesione.
Il passo successivo è la regola decisionale dei sei controlli applicata a un lotto reale: ritirare il suo certificato di analisi, il suo cromatogramma e il suo spettro di massa, e vedere se il sistema è in grado di rispondere a quale lotto appartiene lo spettro e quale versione del metodo ha prodotto il valore di purezza. Se non può, il divario è nel record, non nel modello.