Réponse rapide
Évaluer la traçabilité du système réel, métadonnées et contrôles d’audit. Ce plan identifie les lacunes potentielles mais ne fournit aucune prévalence mesurée parmi les peptides…
Un bassin de données sur les peptides en une seule page
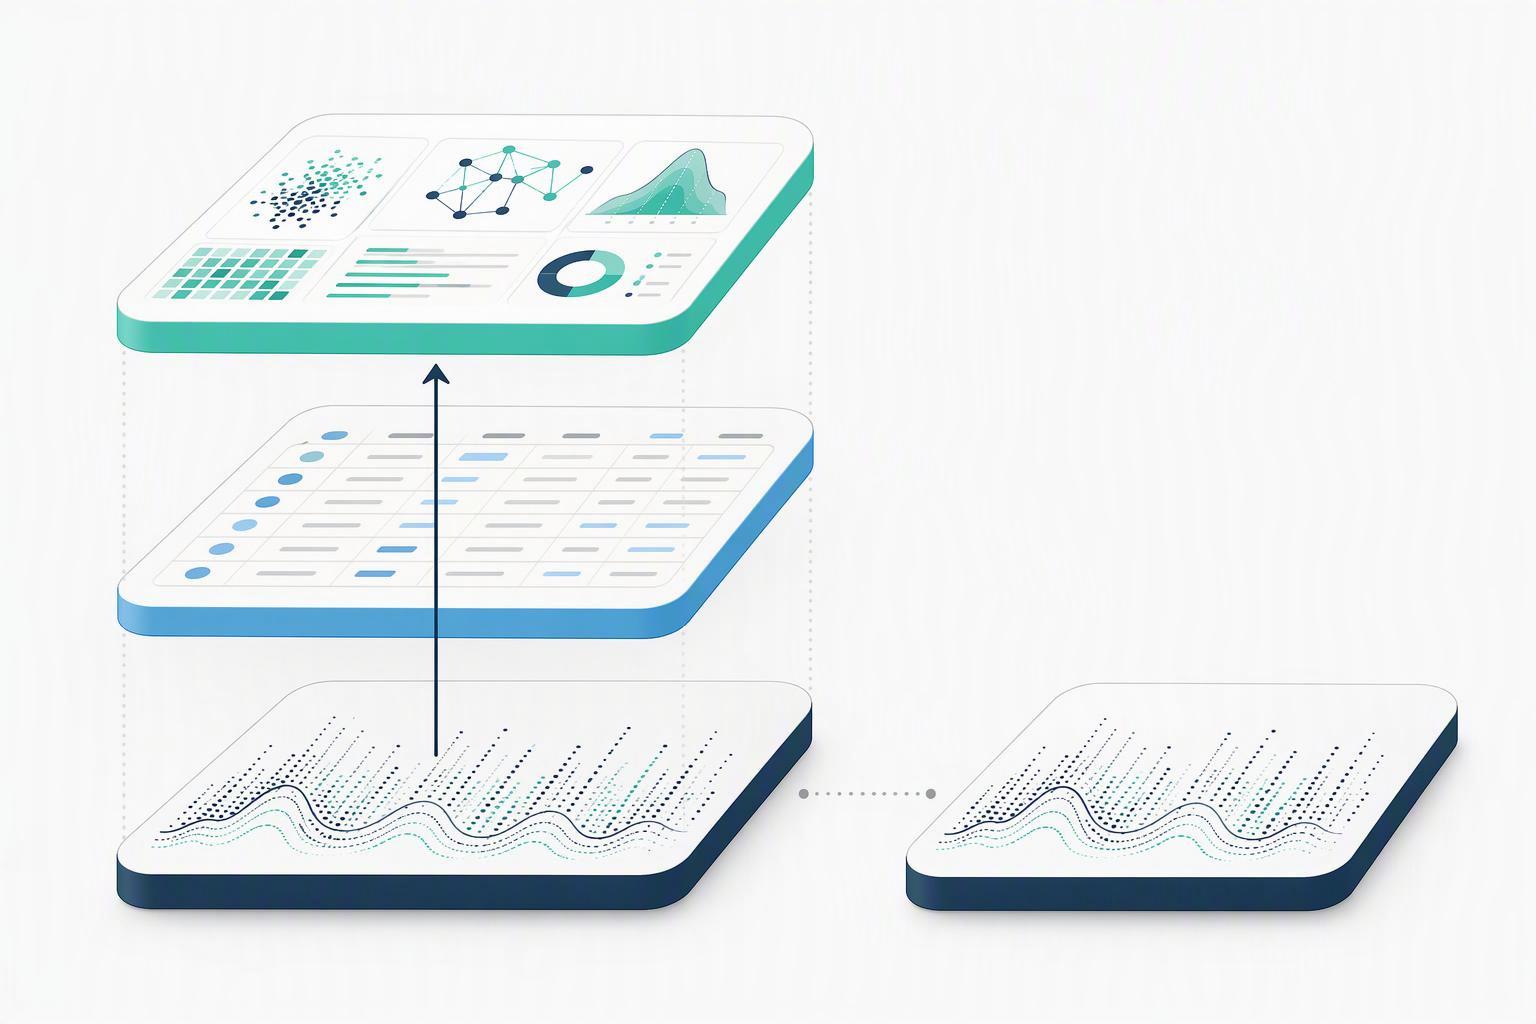
Test peptidique en gros Peptides Un bassin de données peptidiques est constitué de trois couches sur une copie brute immuable: la capture originale de l'instrument, une couche d'enregistrement structurée pour les lots et leurs enfants analytiques, et une couche dérivée pour les tableaux de pics, fonctionnalités et sorties du modèle. La copie brute ne change jamais; tout le reste peut être reconstruit à partir de là.
Les arguments en faveur de cette structure sont mesurables. UN 2022 L'évaluation des métadonnées chromatographiques publiques a révélé que 70% des descriptions de configurations chromatographiques dans les référentiels publics étaient incomplètes, et seulement 20.8% (312 de 1,501) étaient suffisamment complets et corrects pour être réutilisés (Harrieder et coll., Métabolomique, 2022). La répartition référentiel par référentiel de la même étude montre MetaboLights à 174 de 468 descriptions complètes (37.2%) et atelier de métabolomique à 276 de 1,033 (26.7%). Ce sont des référentiels publics dont les auteurs apprécient le partage de données., et les auteurs notent que les chiffres peuvent surestimer l'exactitude ailleurs.
La raison réglementaire de conserver intacte la capture brute est distincte de l’argument de la réutilisation.. La MHRA définit les données brutes comme la première capture d'informations, que ce soit sur papier ou par voie électronique, et les métadonnées en tant que données qui décrivent les attributs et donnent un contexte et une signification, faisant partie intégrante du dossier original (Conseils sur l’intégrité des données MHRA GxP, Révision 1, Mars 2018). La position de la MHRA selon laquelle les données brutes dynamiques doivent rester dynamiques découle de la même définition.: un chromatogramme imprimé est un enregistrement statique et ne peut pas servir de données brutes.
Clé à retenir: Un bassin de données peptidiques est une capture brute, enregistrements structurés et fonctionnalités dérivées en trois couches, avec la copie brute immuable et chaque artefact dérivé pouvant être reconstitué à partir de celle-ci.
Les identifiants structurés peuvent améliorer les requêtes et la provenance. Un Drive partagé peut également contenir des, enregistrements traçables; les réglementations nécessitent une préservation et un sens, pas un schéma de base de données particulier ni une implémentation de clé étrangère.
L'ensemble d'enregistrements minimum pour un lot de synthèse et ses enfants analytiques
Cette séparation des couches n'est payante que si les enregistrements eux-mêmes sont spécifiés, donc l'architecture minimale sépare un enregistrement de lot de ses enfants analytiques, et chaque enfant porte ses propres identifiants, champs de référence de méthode et de résultat. Une seule table plate avec une ligne par lot ne peut pas contenir les jointures décrites dans la section suivante, et il force les mesures non liées dans des colonnes partagées.
Le modèle de champ CQ courant dans l’industrie constitue un point de départ utile, pas une spécification. Les fournisseurs de synthèses personnalisées documentent généralement la HPLC analytique pour la pureté, spectrométrie de masse pour l'identité, teneur en peptide ou poids net du peptide, et un certificat d'analyse délivré avec un chromatogramme HPLC et un spectre MS; les modules complémentaires facultatifs incluent le test des endotoxines, analyse des contre-ions, teneur en eau par Karl Fischer et rotation optique. Considérez que comme le champ est défini, le schéma doit s'adapter, et vérifiez la liste de champs réelle de tout fournisseur par rapport à ses propres documents.
|
Champ |
Couche |
Obligatoire ou utile |
Remarques |
|---|---|---|---|
|
Identifiant du lot |
Lot |
Requis |
Persistant, jamais réutilisé dans tous les projets |
|
Séquence et modifications |
Lot |
Requis |
Structuré, pas de texte libre (voir la rubrique modifications) |
|
Méthode de synthèse et résine |
Lot |
Requis |
Référence versionnée à un enregistrement de méthode |
|
Échelle et rendement |
Lot |
Requis |
Unités explicites |
|
Forme contre-ion |
Lot |
Requis |
Le TFA et l'acétate sont des matériaux différents |
|
Certificat d'analyse |
Lot |
Requis |
Pièces jointes et champs de résultats structurés |
|
Identificateur d'aliquote |
Enfant analytique |
Requis |
Clé étrangère du lot parent |
|
Identifiant d'injection et d'exécution |
Enfant analytique |
Requis |
Clé étrangère de l'aliquote parent |
|
Version de la méthode |
Enfant analytique |
Requ Usine de peptides synthétiques irrité |
Liens vers le tableau des méthodes contrôlées par les modifications |
|
Résultat de pureté HPLC |
Enfant analytique |
Requis |
Valeur, unité, paramètres d'intégration |
|
Résultat de l'identité MS |
Enfant analytique |
Requis |
Masse observée versus masse théorique |
|
Teneur en peptides |
Enfant analytique |
Requis |
Méthode nommée (azote, UV, gravimétrique) |
|
Teneur en eau Karl Fischer |
Enfant analytique |
Utile |
Obligatoire si le contenu est corrigé pour l'eau |
|
Résultat endotoxine |
Analytique Peptides des États-Unis enfant |
Utile |
Méthode et limite indiquées |
|
Rotation optique |
Enfant analytique |
Utile |
Solvant et température indiqués |
Avertissement: Le matériel décrit dans ce plan est destiné uniquement à la recherche dans le contexte de l'approvisionnement en peptides.. Rien ici ne soutient le dosage, thérapeutique, allégations de diagnostic ou d’usage personnel, et un modèle de données ne doit pas impliquer le contraire.
Comment joindre des enregistrements de synthèse à des chromatogrammes et des spectres de masse sans colle de nom de fichier
Une fois que ces enregistrements existent, l'étang répond à la jointure du lot de synthèse au chromatogramme et au spectre de masse grâce aux identifiants stockés, pas en analysant un nom de fichier. La chaîne fonctionne par lots, aliquote, injection, courir, déposer, résultat traité, et chaque lien est une clé étrangère avec un horodatage et un opérateur.
Cette chaîne a une forme formelle. Provenance modélisée en tant qu'entités et activités (PROV-O) décrit un résultat tel que généré par une activité, dérivé d’une entité d’entrée et attribué à un agent, qui est exactement la structure d'une table de pics retraitée dérivée d'un fichier brut (Recommandation PROV-O du W3C, 2013). Vous n'avez pas besoin de l'ontologie pour construire la jointure, mais tu as besoin de sa discipline: chaque artefact dérivé indique d'où il vient.
Les formats de conteneurs réservent déjà de l'espace à cette discipline. Le format de données d'Allotrope réserve un magasin d'audit et des sommes de contrôle à côté des données, dans une structure à six composants construite sur HDF5 et destinée à l'archivage à long terme des données analytiques (Format de données allotropes v1.5.3 RF, libéré 30 Novembre 2020). Pour les spectres, mzML 1.1.x est la ligne de spécification ouverte actuelle, et sa propre documentation indique que les formats de liste de pics manquent d'informations sur les signaux précurseurs et les métadonnées d'acquisition associées (Dépôt HUPO-PSI mzML).
L'ordre de workflow est un objet enregistrable, pas une convention. Le contrôle de séquençage au §11.10(f) de 21 Partie CFR 11 nécessite des vérifications du système opérationnel qui appliquent la séquence autorisée des étapes et des événements, c'est ce qui fait la synthèse, aliquote, exécuter et réviser une commande vérifiable plutôt qu’une habitude (21 CFR 11.10). La traçabilité des lots de peptides dépend de la survie de cet ordre au retraitement.
Avertissement: Une table de pic retraitée, réécrite sur l'original, détruit immédiatement la jointure et la piste d'audit.. Les résultats dérivés appartiennent à un nouvel enregistrement qui pointe vers le fichier brut, jamais à la place.
Comment les modifications peptidiques doivent être stockées pour qu'un modèle puisse les utiliser
La chaîne de jointure transporte le lot, mais la chimie du lot doit aussi être structurée: une modification est un enregistrement avec un site, une chimie, un delta de masse et une accession à vocabulaire contrôlé, pas une chaîne ajoutée à un nom d'échantillon. Les noms de modification en texte libre interrompent à la fois la jointure et tout modèle qui doit raisonner sur plusieurs lots.
Le problème du vocabulaire est suffisamment important pour nécessiter un système d'adhésion. Unimod documenté 1,559 entrées de modifications à partir de janvier 2025, un chef d'accusation cité dans un 2025 article sur l'identification des modifications combinatoires (Lai et al., 2025). Un schéma qui stocke les noms de modifications sous forme de texte ne peut pas être mappé de manière fiable sur un vocabulaire de cette taille., et le même article note que les méthodes de recherche conventionnelles ne pré-spécifient qu'un nombre limité de modifications, généralement neuf.
Les moteurs de recherche traitent les modifications comme des paramètres de recherche, ce qui est le contraire d'un fait stocké. La mascotte distingue le fixe, modifications variables et exclusives, teste tous les arrangements possibles de modifications de variables et avertit que les modifications de variables doivent être utilisées avec parcimonie (Aide de la mascotte Matrix Science, sans date). Si la modification n'existe que dans une configuration de recherche, ce n'est pas dans le dossier et un modèle ne peut pas en tirer des leçons.
La gamme chimique que le schéma doit contenir est large. Le travail personnalisé sur les peptides couvre les modifications N-terminales telles que l’acétylation, biotinylation, marqueurs fluorescents et PEGylation; modifications des chaînes latérales, y compris la phosphorylation sur la sérine, thréonine et tyrosine, méthylation, sulfatation et glycosylation; Modifications C-terminales telles que les formes amidation et ester; et des structures spéciales, y compris la cyclisation tête-bêche et side-chain, disulfures, peptides agrafés et ramifiés, Acides D-aminés et marquage isotopique. Plusieurs modifications simultanées sont courantes, donc l'enregistrement doit être un à plusieurs dès le début.
La clause d'interopérabilité I3 de FAIR demande que les métadonnées incluent des références qualifiées à d'autres métadonnées, quel est le principe qu'une accession plus une clé étrangère structurée satisfait (Principes GO FAIR, Wilkinson et coll., 2016). Une table de modification construite de cette façon est prête pour l'IA sans autre travail; un champ de texte n'est pas.
|
Champ |
Exemple: phosphosérine |
Exemple: Acétyle N-terminal |
|---|---|---|
|
Site |
Être, position des résidus 12 |
N-terminus |
|
Cours de chimie |
Phosphorylation |
Acétylation |
|
Delta de masse |
+79.966 Et |
+42.011 Et |
|
Adhésion de vocabulaire |
Adhésion Unimod |
Adhésion Unimod |
|
Preuve |
Localisation de sites MS/MS Peptides de Gh |
Fragment de terminal MS/MS |
|
Référence de la méthode Fournisseur d'usine de peptides |
Rechercher la version de configuration |
Rechercher la version de configuration |
Pureté, Identité, Contenu, La stabilité et l'adéquation des tests sont cinq domaines différents
Les modifications structurées représentent la moitié de la discipline du vocabulaire; l'autre moitié consiste à séparer les attributs de qualité, parce que la pureté, identité, contenu, la stabilité et l'adéquation du test sont cinq champs de résultats distincts qui répondent à cinq questions différentes et sont validés par différents tests. Les regrouper en une seule colonne « qualité » est l'erreur de schéma la plus courante dans les enregistrements de peptides..
Je Q2(R2) décrit les caractéristiques de performance des procédures analytiques en fonction de leur utilisation prévue. Il n'exige pas le schéma de données à cinq champs de cet article ni n'attribue les mêmes caractéristiques de validation à chaque méthode..
La ligne directrice a également renommé son propre vocabulaire. Son glossaire remplace délibérément « caractéristique de validation » par « caractéristique de performance," décrit comme une description indépendante de la technologie d'une caractéristique qui garantit la qualité du résultat mesuré (Je Q2(R2) glossaire). Un schéma qui étiquette toujours les colonnes avec le Q2 remplacé(R1) la liste ne correspondra pas aux rapports de validation de méthode actuels.
La stabilité et l'adéquation du test se situent en dehors de cette table et nécessitent leurs propres champs. La stabilité est un résultat temporel et conditionnel avec un identifiant d'étude; la pertinence du test est un jugement au niveau de la méthode enregistré par rapport à une procédure spécifique. Ni l'un ni l'autre ne peut être dérivé d'un pourcentage de pureté, et un pourcentage de pureté à lui seul n'établit pas l'identité du composé, c'est pourquoi la pureté, identité, méthode, le numéro de lot et la documentation doivent être examinés ensemble.
La conséquence pratique est un champ par attribut, chacun avec sa propre référence de méthode, unité et critère d'acceptation. Un modèle formé sur un « score de qualité » fusionné apprend la fusion, pas la chimie.
Ce qui doit être traçable avant qu'une couche d'IA ne soit placée au-dessus
Déterminez si la partie 11 applique et évalue tous les contrôles pertinents, validation du système, procédures, formation et rétention. Les autorisations d'accès et l'implémentation d'une table d'audit à elles seules n'établissent pas la conformité. Adaptez le système à ses risques et à son utilisation prévue.
-
Validation des systèmes, y compris la capacité de discerner les enregistrements invalides ou modifiés.
-
Copies exactes et complètes sous forme lisible par l’homme et électronique.
-
Protection des enregistrements pour une récupération précise et rapide tout au long de la période de conservation.
-
Accès limité aux personnes autorisées.
-
Sécurisé, généré par ordinateur, des pistes d'audit horodatées qui ne masquent pas les informations précédentes.
-
Contrôles opérationnels appliquant la séquence autorisée des étapes et des événements.
-
L'autorité vérifie qui peut signer, modifier ou effectuer une opération.
-
L'appareil vérifie la validité de la source de données.
-
Éducation documentée, formation et expérience pour les utilisateurs du système.
-
Politiques écrites tenant les individus responsables de leurs actions sous leur signature électronique.
-
Contrôles sur la documentation des systèmes, y compris le contrôle des révisions et des modifications avec une piste d'audit.
La clause de contrôle des modifications couvre les versions de méthode. §11.10(k) nécessite des procédures de révision et de contrôle des modifications, le maintien d'une piste d'audit du développement et de la modification chronologiques de la documentation des systèmes., c'est ce à quoi une table de versions de méthodes doit satisfaire (21 CFR 11.10(k)). Les attributs ALCOA de la MHRA, attribuable, lisible, contemporain, original et précis, plus complet, cohérent, endurant et disponible, décrire la même exigence en termes de qualité des données (Conseils sur l’intégrité des données MHRA GxP, 2018). La réglementation américaine fournit la liste de contrôle; les directives britanniques fournissent les attributs.
FAIR ajoute une clause que les contrôles n'indiquent pas directement: R1.2 demande que les données soient associées à une provenance détaillée, qui est la version des données de recherche de la piste d'audit (Principes GO FAIR, 2016). Ni FAIR ni les spécifications de format ne sont approuvés par un régulateur, alors traitez-les comme des aides à la conception, pas de preuve de conformité.
Avertissement: Un modèle qui répond à ces contrôles n'est pas un système validé. La validation est une activité documentée par rapport à l'utilisation prévue, et adopter un format ou une ontologie ne s'y substitue pas.
Où se situe réellement la couche IA, et là où ce n'est pas le cas
L'IA peut analyser les signaux bruts, fonctionnalités traitées ou résultats structurés lorsque l’approche est validée pour l’objectif prévu. Préserver les données sources et la traçabilité des traitements, contrôler l'accès, et évaluer la crédibilité du modèle en fonction de la décision et du cadre applicable.
Le cadre réglementaire de l’IA dans un contexte GxP est encore à l’état de projet. La FDA a publié un projet de lignes directrices sur l'IA pour soutenir la prise de décision réglementaire concernant les médicaments et les produits biologiques sur 7 Janvier 2025, dossier FDA-2024-D-4689, avec commentaires fermés 7 Avril 2025 (Registre fédéral, 90 FR 1157, 2025). Il propose un cadre d'évaluation de la crédibilité basé sur les risques et construit sur un contexte d'utilisation défini., avec des preuves de crédibilité adaptées à ce contexte et dépendant du risque du modèle. C'est un brouillon, et l'avis indique qu'il n'approuve aucune approche spécifique de l'IA.
La forme du cadre est instructive même à l’état de brouillon. Il s'agit d'une évaluation de la crédibilité en sept étapes: définir la question d'intérêt, définir le contexte d'utilisation, évaluer le risque du modèle, planifier des activités de crédibilité, exécuter le plan, documenter les résultats et les écarts, et déterminer l’adéquation au contexte d’utilisation (Analyse Goodwin du projet de la FDA, Janvier 2025). L'étape qui compte pour un bassin de données est la deuxième: sans contexte d'utilisation défini, aucun volume de données ne rend un modèle crédible.
Le champ d’application du projet est plus restreint que le traitement des données de laboratoire. Il couvre l'IA utilisée pour produire des informations à l'appui des décisions réglementaires en matière de sécurité., efficacité ou qualité, et il exclut explicitement la découverte de médicaments et les utilisations d'efficacité opérationnelle qui n'affectent pas la sécurité des patients., la qualité des médicaments ou la fiabilité des résultats des études (Registre fédéral, 90 FR 1157). Un modèle qui signale les valeurs aberrantes probables de pureté à l’attention d’un évaluateur est une aide opérationnelle; un modèle dont la sortie alimente une décision de spécification est dans le champ d'application.
Une règle de décision pour publier une couche de données prête pour l'IA
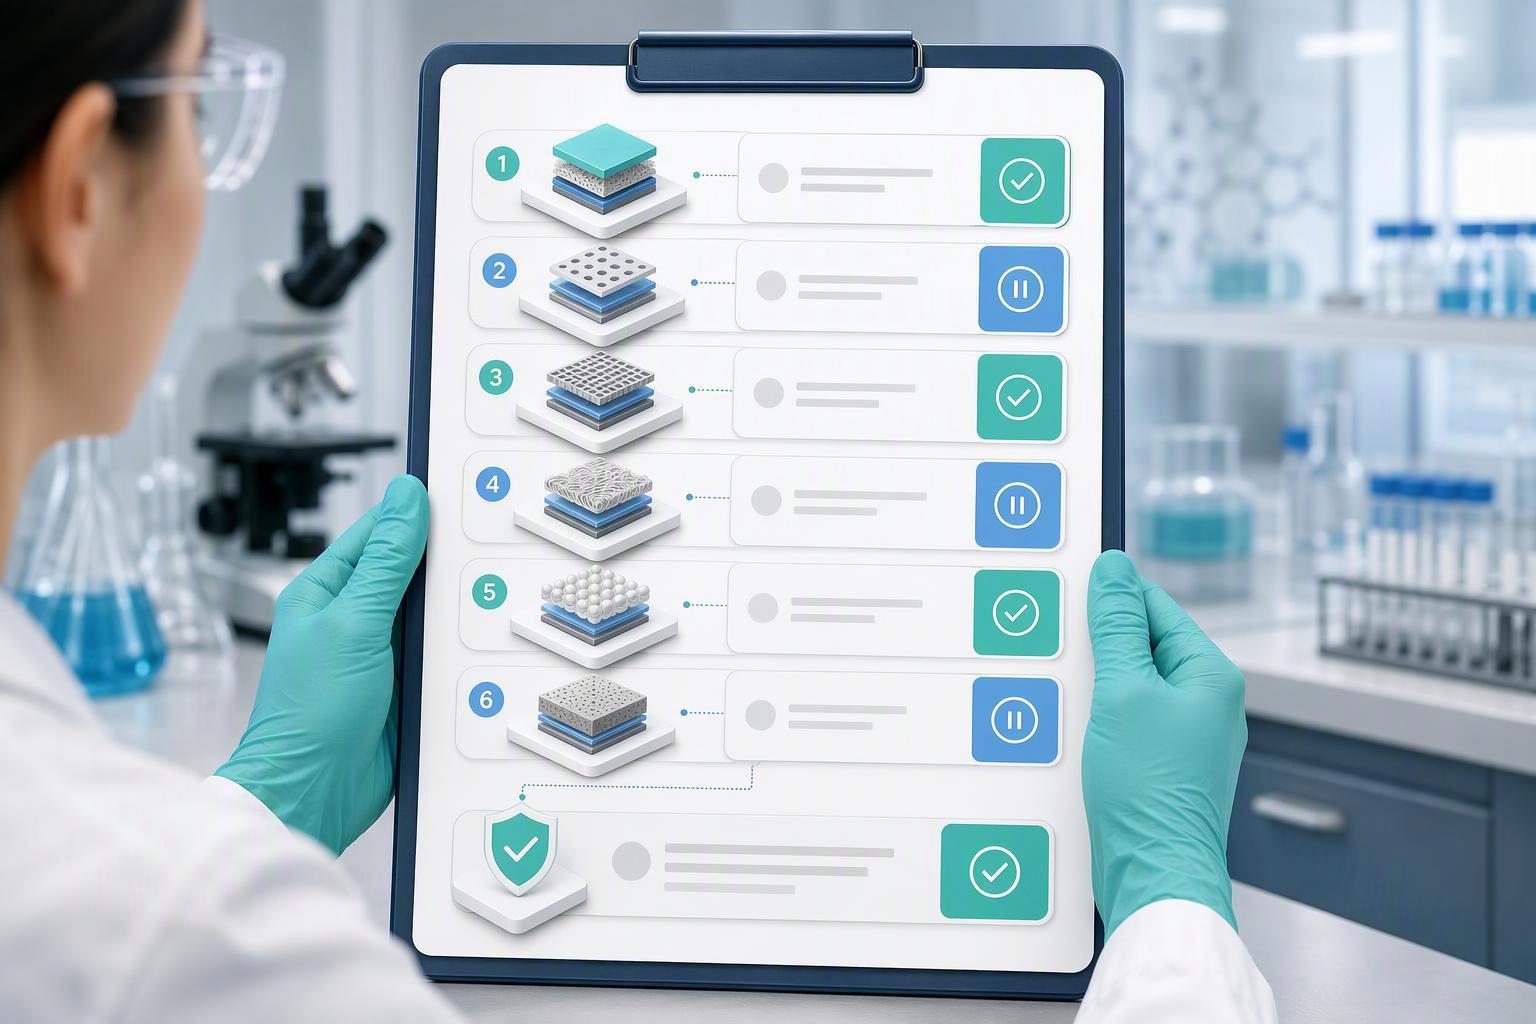
Cette limite est ce que teste la règle de publication, car une couche de données est prête à transporter un modèle lorsque six vérifications réussissent dans l'ordre, et le premier échec arrête la version. Appliquez-les à votre propre système avant qu'un modèle n'en lise.
- Conserver les enregistrements originaux et les métadonnées essentielles sous une forme qui préserve leur signification et leur fonctionnalité requise. Les enregistrements dynamiques électroniques peuvent nécessiter des données natives; les documents papier originaux ne sont pas intrinsèquement invalides. Documenter et vérifier toute conversion ou copie conforme.
-
Chaque enfant analytique résout son lot sans analyse du nom de fichier. La chaîne de jointure est stockée sous forme d'identifiants, et une requête renvoie le lot de n'importe quel chromatogramme ou spectre.
-
Les onze contrôles §11.10 sont satisfaits ou ont un document, écart évalué en fonction des risques. Les clauses de piste d'audit et de contrôle des modifications sont celles à tester en premier (21 CFR 11.10).
-
Les modifications sont des enregistrements adhérés, pas de texte. Chaque modification porte un site, chimie, delta de masse et adhésion au vocabulaire, et plusieurs modifications simultanées sont représentables.
-
Pureté, identité, contenu, la stabilité et l'adéquation du test sont des domaines distincts avec leurs propres références de méthode, correspondant à la matrice de test spécifique aux attributs dans ICH Q2(R2) (Je Q2(R2), 2023).
-
Le contexte d’utilisation du modèle est écrit avant la construction du modèle, avec l'évaluation des risques et les preuves de crédibilité décrites dans le projet de la FDA (Registre fédéral, 90 FR 1157, 2025).
Un exemple concret rend la règle concrète. Un enregistrement de lot porte son identifiant, séquence avec modifications accessées, Forme de contre-ion et versions de méthode. Deux enfants analytiques le montrent du doigt: un résultat de pureté HPLC avec ses paramètres d'intégration et un spectre de masse avec masse observée et théorique. Les deux enfants montrent leurs versions de méthode, et la table méthode-version contient un historique des modifications. Une table de pic dérivée se trouve dans son propre enregistrement, pointe vers les fichiers bruts et n'est jamais réécrit dessus. Le modèle qui lit cette couche peut répondre à quel lot appartient un spectre., quelle méthode a produit une valeur de pureté et ce qui a changé entre deux versions de méthode.
Si vous souhaitez tester la règle par rapport à de vrais enregistrements, parlez à un expert technique ou demandez une présentation pas à pas du paquet de données par lots et comparez le champ défini avec le tableau ci-dessus.
L'architecture décrite est un schéma général tiré de documents publics réglementaires et normatifs., il ne s’agit pas d’une description du système d’un fournisseur.*
Foire aux questions
Qu'est-ce qu'un bassin de données peptidiques?
Un bassin de données peptidiques est un stockage à trois niveaux: une capture brute immuable des fichiers d'instruments, une couche d'enregistrement structurée pour les lots de synthèse et leurs enfants analytiques, et une couche dérivée pour les tableaux de pics, fonctionnalités et sorties du modèle. La couche brute ne change jamais, et chaque artefact dérivé peut être reconstruit à partir de celui-ci.
Pouvons-nous conserver les formats bruts du fournisseur au lieu de les convertir en mzML?
Conservez les fichiers bruts du fournisseur comme enregistrement brut et convertissez-les en mzML 1.1.x pour le partage et l'accès à long terme.. La documentation mzML indique que les formats de liste de pics perdent les signaux précurseurs et les métadonnées d'acquisition., donc une liste de pics ne remplace pas le fichier brut (Dépôt HUPO-PSI mzML). La conversion est un artefact dérivé supplémentaire, pas un remplacement.
L'adoption d'Allotrope ou de FAIR rend-elle le système conforme?
Non. Le format d'Allotrope réserve un magasin d'audit et des sommes de contrôle, et le R1.2 de FAIR demande une provenance détaillée, mais ni l'un ni l'autre n'est approuvé par un régulateur comme preuve de conformité (Format de données allotropiques; Principes GO FAIR). La conformité passe par les contrôles et la validation, pas le conteneur.
Les directives de la FDA sur l'IA sont-elles définitives?
Non. Il s'agit d'un projet de lignes directrices publié 7 Janvier 2025, avec commentaires fermés 7 Avril 2025, et il déclare qu'il n'approuve aucune approche spécifique de l'IA (Registre fédéral, 90 FR 1157). Traiter son contexte d'utilisation et son cadre d'évaluation de la crédibilité comme une référence de conception, pas une exigence.
Conclusion
Le plan se réduit à une seule règle: garder la capture brute immuable, stocker les jointures sous forme d'identifiants, et séparez les cinq attributs de qualité dans leurs propres champs. Tout le reste dans un flux de travail analytique prêt pour l'IA découle de ces trois décisions, et les sources qui les sous-tendent sont des textes de réglementation et de normes publics plutôt que des réclamations des fournisseurs..
La preuve pour agir maintenant est le manque d’exhaustivité. Une étude du référentiel public n'a trouvé que 20.8% de descriptions chromatographiques suffisamment complètes pour être réutilisées, et ces contributeurs étaient motivés à partager (Harrieder et coll., Métabolomique, 2022). Les enregistrements internes créés sans schéma ont tendance à se ressembler, et le coût apparaît lorsqu'un modèle ou un auditeur demande la jointure.
L'étape suivante est la règle de décision en six contrôles appliquée à un lot réel: retirer son certificat d'analyse, son chromatogramme et son spectre de masse, et voyez si le système peut répondre à quel lot appartient le spectre et quelle version de la méthode a produit la valeur de pureté. S'il ne peut pas, l'écart est dans le record, pas dans le modèle.