Schnelle Antwort
A model now hands you a candidate list for the price of a compute run. The expensive part starts after that: deciding which sequences deserve synthesis, which …
Was die Antibiotika-Kampagne des MIT und die Enzymsuche tatsächlich gezeigt haben
Fabrik für Peptidlieferanten Peptidtechnologie Die beiden Kampagnen demonstrierten die Suche und Priorisierung im großen Maßstab, nicht validierte Medikamentenkandidaten. Der Zelle Die Arbeit kombinierte fragmentbasierte und de novo generative Modelle und pushte 36 Millionen vorhergesagte Verbindungen durch Filter zu 24 synthetisierte Moleküle, sieben davon antibakteriell (Krishnan et al., Zelle, 2025). Der Trichter der Gonorrhoe-Spur zeigt die Kosten: 6,937,677 erzeugte Moleküle, 678 nach dem Filtern übrig bleibt, 80 für die Synthese priorisiert, 27 versucht, und nur 2 von 27 Die versuchten Verbindungen waren synthetisierbar.
Die MRSA-Spur verlief 29,014,974 erzeugte Moleküle zu 90 in die engere Wahl gezogen, 22 beschafft, Und 6 aktiv bei 64 μg/ml, die die Autoren als MRSA-Spur bezeichnen 27.3% wahre Entdeckungsrate. Die Leitverbindung ist biologisch von Bedeutung: NG1 bindet LptA, ein Aufbauprotein der Außenmembran, auf das herkömmliche Antibiotika nicht abzielen, und es ist 0.5 μg/ml MIC gegen N. Gonorrhoe kam in einem Mausvaginalmodell zu einer KBE-Reduktion um etwa 3 log. Beide Erreger sitzen auf der 2024 WHO-Prioritätenliste mit hoher Priorität.
Die Enzymgeschichte ist eine andere Art von Beweis. Die Agenten des Berichts erholten sich 198,290 Reverse-Transkriptase-Cluster, gepunktet 3,564 mögliche Partnerproteinfamilien, und gefördert 17 zu menschenlesbaren Berichten. Der Bericht selbst trägt das „ART (Hypothese)“-Label und gibt an, dass die Ergebnisse auf eine experimentelle Charakterisierung warten. Unabhängige Berichte weisen darauf hin, dass der Bericht keinem Peer-Review unterzogen wurde und dass dieselbe Reverse Transkriptase in einem vorkam 2021 Jumbo-Phagen-Papier (Verdrahtet, 2026).
Warum zig Millionen Kandidaten zu ein paar Dutzend synthetisierten Verbindungen zusammenfallen
Die zitierten Kampagnen zeigen, dass Synthese und experimentelle Tests spezifische Entdeckungsbemühungen einschränken können. Sie belegen nicht, dass die Vorhersage angemessen ist oder dass die Synthese der größte Engpass in jedem Peptidprogramm ist. Bewerten Sie beide.
Peptidprogramme treffen aus der anderen Richtung auf dieselbe Wand. Eine generative Peptidkampagne wurde gemeldet 86 von 100 Die entwickelten Peptide waren aktiv, aber seine Generierung war auf folgende Sequenzen begrenzt 50 Rückstände, Und 1 von 20 Benchmark-Peptide konnten überhaupt nicht synthetisiert werden (ApexGO, Naturmaschinenintelligenz, 2026). A 100% Die Erfolgsrate der Synthese bei einem 20-Peptid-Benchmark ist nicht die gleiche Behauptung wie 86% Aktivität auf 100 Peptide, und keine der beiden Zahlen wird auf ein hydrophobes 40-mer übertragen.
Wie die Durchführbarkeit einer Synthese zum Einflussfaktor für das Kandidatenranking wird
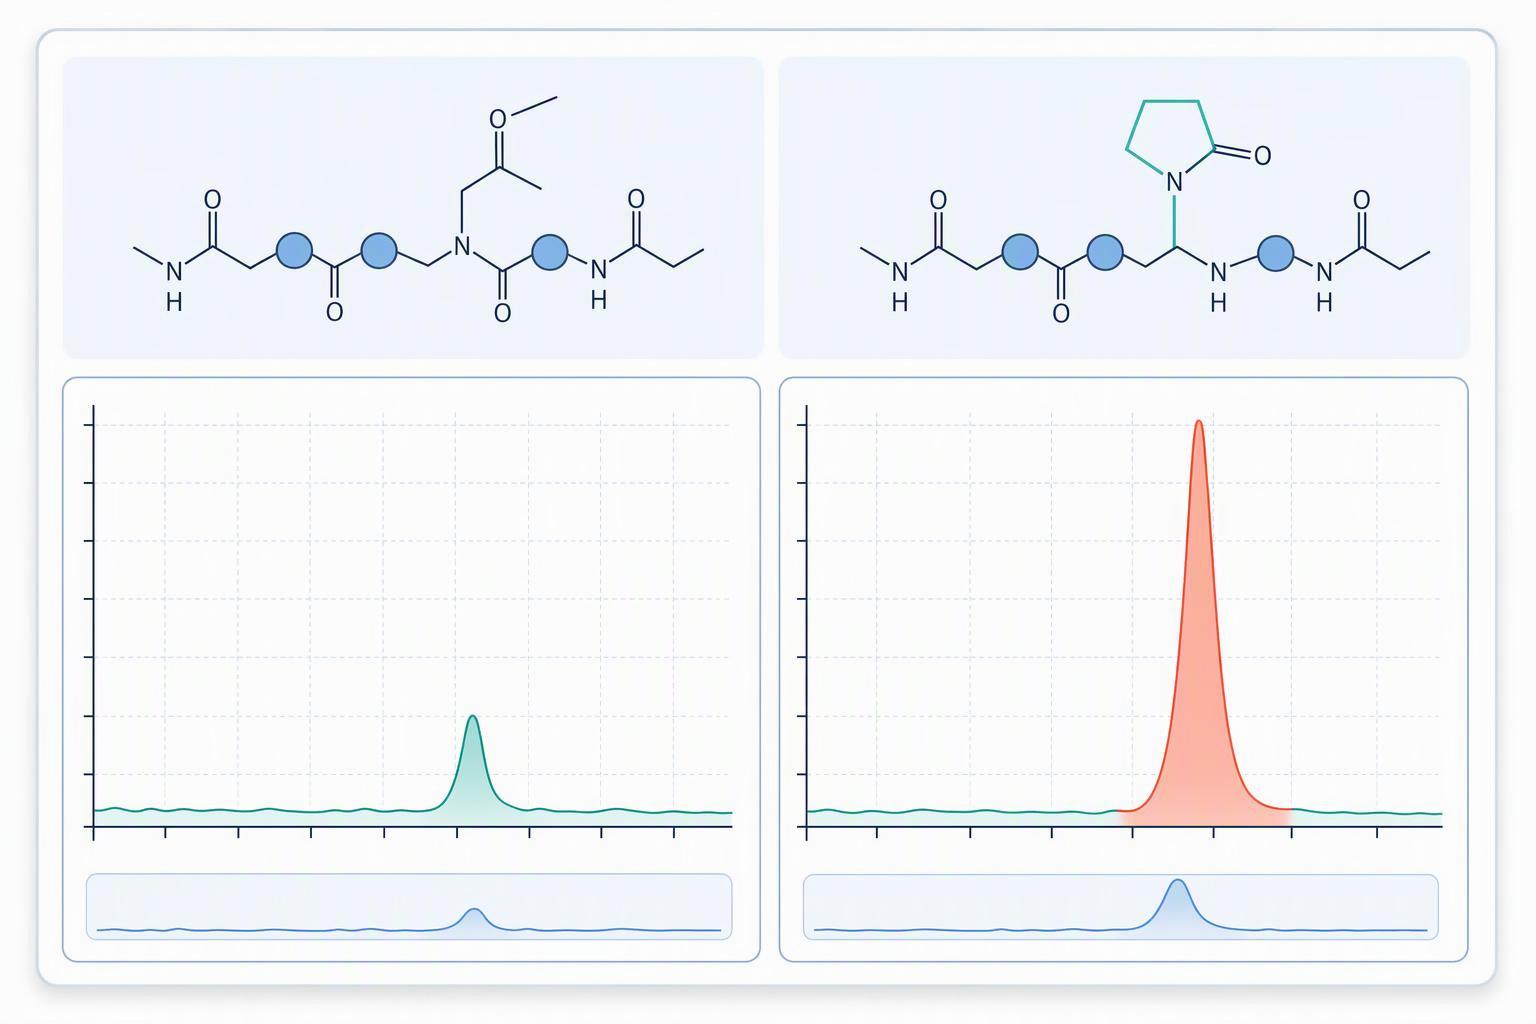
Die Machbarkeit gehört zur Bewertungsfunktion, nicht in der Warteschlange danach. Ein Modell, das allein nach der vorhergesagten Aktivität rangiert, liefert weiterhin die Laborsequenzen, die das Labor nicht erstellen kann, und jede fehlgeschlagene Kopplung kostet einen Zyklus, den die Kampagne nicht zurückbekommen kann. Die Kosten sind messbar. A 2026 Naturchemie Studium von 539 Sequenzen ergaben, dass die Pseudoprolin-Substitution die Rohölreinheit steigerte 23% Zu 69% für ein hGH-Fragment und von 17% Zu 75% für ein GB1-Fragment, mit aggregierenden Sequenzen, die oben durch die Verbreiterung des Entschützungspeaks gekennzeichnet sind 20% relativ zur ersten Kupplung (Tamás et al., Naturchemie, 2026).
Die gleiche Arbeit zeigt, was zu punkten ist. Aggregationsfördernde Rückstandszusammensetzung, nicht die genaue Reihenfolge, trug den größten Teil des Vorhersagesignals: Zu sein(t-Das), Mit, Val und Thr(t-Das) erhöhte die Wahrscheinlichkeit am meisten, Gln(Trt) und Leu leistete einen großen Beitrag, Die Gly-Ser- und Leu-Leu-Motive spielten eine Rolle, und die Aggregation setzt typischerweise ein 5 Zu 15 Rückstände vom Harzanker.
Für Trinkgeld: Fünf Machbarkeitseingaben zur Ergänzung der Ranking-Funktion: Aggregationsanfällige Zusammensetzung, Motivfahnen, Länge im Vergleich zum validierten Bereich des Synthesizers, Komplexität der Modifikation, und Reinigungsrisiko. Eine Sequenz, die bei der Aktivität gut und bei allen fünf schlecht abschneidet, ist ein Warteschlangenelement, kein Kandidat.
Eine Integrationsfrage bleibt offen. Der in der MIT-Arbeit beschriebene ApexGO-Optimierer scheint die Aggregationsneigung nicht zu modellieren, Daher muss für einen Design-to-Synthetic-Workflow immer noch diese Schicht zwischen der Modellausgabe und der Synthesewarteschlange hinzugefügt werden.
Was „validiert“ für ein AI-nominiertes Peptid bedeutet
Validieren Sie jede Methode auf ihr beabsichtigtes Attribut. HPLC-Reinheit und ein MS-Identitätsergebnis beantworten ergänzende Fragen, aber ihre bloße Paarung beweist nicht die orthogonale Bestätigung jedes Strukturmerkmals oder bestätigt die quantitative Wirksamkeit und den Inhalt.
|
Attribut |
Frage, es beantwortet |
Primäre Methode |
Orthogonaler Partner |
Standard |
Häufiges CoA-Auslassen |
|---|---|---|---|---|---|
|
Identität |
Ist das die Reihenfolge? Lieferant von synthetischen Peptiden bestellt? |
LC-MS |
Aminosäureanalyse oder MS/MS-Sequenzierung |
ICH Q6B |
Messe ohne Interpretation wiedergegeben |
|
Reinheit |
Wie viel Zielpeptid ist vorhanden?? |
RP- Reine Peptide HPLC |
HPLC mit einer anderen Chemie |
ICH Q2(R2) |
Nur Flächenprozent, Keine Methodendetails |
|
Potenz |
Funktioniert es im Test?? |
Funktionstest |
Orthogonaler Bioassay |
ICH Q6B Peptidquelle |
Für Forschungslose nicht gemeldet |
|
Inhalt |
Wie viel Peptid ist in der Durchstechflasche?? |
Quantitativer Test |
Massenbilanz |
ICH Q6B |
Nettopeptidgehalt fehlt |
|
Endotoxin |
Ist das Material für das Testsystem sicher?? |
LAL-Test |
Methodeneignungskontrollen |
USP <85> |
Limit nicht angegeben |
Für zellbasierte Tests, Begründen Sie die Endotoxinkontrolle mit der Testempfindlichkeit, Konzentration und Einmischung. Parenterale K/M-Grenzwerte sind keine Standardkriterien für Zelltests. Endotoxin, lebensfähige Mikroorganismen und Partikel sind unterschiedliche Attribute und erfordern gegebenenfalls geeignete Kontrollen.
Was macht Peptidmaterial analysebereit?, und wie man Artefakte ausschließt
Assay-fertiges Peptidmaterial ist Material, dessen Verhalten im Assay von der durch den Assay selbst verursachten Beeinträchtigung getrennt wurde. Der Standard-Aggregations-Gegenschirm existiert, weil Peptide bei niedrigen bis mittleren mikromolaren Konzentrationen aggregieren, Partikel bilden 100 Zu 500 nm darüber binden Proteine im pikomolaren Bereich und sind für das Auge unsichtbar (Auld, Englisch & Dahlin, Assay-Anleitungshandbuch, 2017).
Wählen Sie Aggregation aus, Membranschaden, Adsorptions- und Vehikelkontrollen für den eigentlichen Test. Literaturkonzentrationen oder LDH-Reaktionsbereiche sind keine universellen Akzeptanzgrenzen, und Detergens selbst kann den Mechanismus eines membranaktiven Peptids verändern.
Welche Governance trennt rechnerisches Versprechen von validierter Leistung?
Governance trennt beides, indem es die Ausgabe des Modells und das gemessene Ergebnis getrennt hält, versionierte Datensätze, und indem man sich weigert, den einen für den anderen eintreten zu lassen. Der Teil 11 Die Audit-Trail-Sprache definiert einen elektronischen Datensatz als eine beliebige Textkombination, Grafik, Daten, Audio-, bildliche oder sonstige Informationsdarstellung erstellt, geändert, gepflegt, archiviert, von einem Computersystem abgerufen oder verteilt werden, und unterzieht Computersysteme und deren Dokumentation der FDA-Inspektion (21 CFR Teil 11, eCFR).
Das regelt Aufzeichnungen, keine Modellvalidität. Nichts in der Verordnung besagt, dass ein generatives Modell qualifiziert ist, weil seine Ausgaben protokolliert werden. Die Enzymkampagne zeigt, warum die Unterscheidung wichtig ist: Die eigene Aussage des Berichts, dass die Funktion unbekannt sei, steht neben zehn Wiederholungen, bei denen das Array nie wieder als Entdeckung auftauchte.
|
Beanspruchen |
Status |
Was würde es voranbringen? |
|---|---|---|
|
36 Millionen Verbindungen erzeugt |
Demonstriert, peer-reviewed |
Nichts weiter |
|
6 von 22 In vitro aktive MRSA-Verbindungen Hersteller von Peptidtests |
Demonstriert, peer-reviewed |
Unabhängige Replikation |
|
Wirksamkeit von NG1 in einem Mausmodell |
Nur bei Tieren nachgewiesen |
Kein klinischer Anspruch zulässig |
|
ART-Systemfunktion |
Hypothese, nicht peer-reviewed |
Experimentelle Charakterisierung |
|
Das Modellranking sagt den Syntheseerfolg voraus |
Nicht etabliert |
Prospektive Synthesedaten |
Was für ein Peptidprogramm sollte sich jetzt ändern
Ändern Sie zunächst die Ranking-Funktion, dann das Analysepaket, dann die Aufzeichnungen. Konkret: Fügen Sie vor der Auswahlliste eine Machbarkeitsbewertung hinzu, erfordern eine orthogonale Identitätsmethode für jedes Los, Führen Sie Aggregations-Gegenprüfungen durch, bevor Sie primäre Wirkstoffe glauben, und bewahren Sie die Modellausgabe und die gemessenen Ergebnisse in separaten versionierten Datensätzen mit einem Prüfpfad auf.
Wo Synthese die Einschränkung ist, Das Gespräch mit dem Lieferanten ist wichtiger als das Modell. Unser Team bei MOL Changes führt die Fmoc-Festphasensynthese mit Umkehrphasen-HPLC und Massenspektrometriedaten durch, die jeder individuellen Peptidbestellung beiliegen, deckt den N-Anschluss ab, C-terminale und Seitenkettenmodifikationen einschließlich Zyklisierung, Disulfidbrücken, nichtnatürliche Aminosäuren und den Einbau stabiler Isotope, und skaliert durch Lyophilisierung von Milligramm auf Kilogramm. Die Einrichtungen nutzen eine doppelte Isolierung, HEPA-Filtration und Überdruckraum, mit prozessbegleitender Reinheitsprüfung, Inhalt, Endotoxin, pH-Wert und Sterilität im Rahmen einer Selbstkontrolle.
|
Fenster |
Aktion |
|---|---|
|
30 Tage |
Fügen Sie der Ranking-Funktion die fünf Machbarkeitseingaben hinzu; Überprüfen Sie die letzten drei CoAs auf fehlende Identitäts- oder Inhaltsdaten |
|
60 Tage |
Kombinieren Sie jede Reinheitsmethode mit einer orthogonalen Identitätsmethode; Fügen Sie dem Standard-Assay-Protokoll einen Aggregationsgegenbildschirm hinzu |
|
90 Tage |
Trennen Sie Modellausgabedatensätze von Messergebnisdatensätzen mit Versionierung und Audit-Trail; Schreiben Sie das Anspruchsstatusregister für jedes aktive Programm |
Häufig gestellte Fragen
Tut das 86% Peptid-Trefferquote beweist, dass KI-Peptiddesign Kampagnen mit kleinen Molekülen übertrifft?
NEIN. Der 86 von 100 Entwickelte Peptide waren gegen mindestens eines davon aktiv 11 Krankheitserreger, während die Zelle Papiere 27.3% ist Aktivität unter 22 synthetisierte kleine Moleküle. Verschiedene Nenner, unterschiedlicher chemischer Raum, verschiedene Ausgangspunkte.
Warum scheitern so viele KI-generierte Kandidaten bei der Synthese??
Weil die Erzeugung nicht durch Synthesewege eingeschränkt wird. Der Zelle Autoren berichten nur darüber 2 von 27 Die versuchten Verbindungen in einer Spur waren synthetisierbar, und dieses eine Fragment musste gekürzt werden, da keine seiner fünf wichtigsten Verbindungen innerhalb der üblichen Zeitrahmen und Kosten zugänglich war.
Wird die Enzymentdeckung einem Peer-Review unterzogen??
NEIN. Der technische Bericht wurde keinem Peer-Review unterzogen, bezeichnet das System als Hypothese, und gibt an, dass die Ergebnisse auf eine experimentelle Charakterisierung warten.
Gelten ICH- und USP-Standards für Peptide in Forschungsqualität??
ICH Q2(R2) und Q6B regeln die analytische Validierung und Spezifikationsfestlegung für Arzneimittel. Für forschungsfähiges Material, Verwenden Sie sie als Maßstab für die Methodenqualität: orthogonale Identität, Spezifität nachgewiesen, und die angegebenen Endotoxin-Grenzwerte sagen Ihnen immer noch, ob das CoA etwas bedeutet.
Wie sollte die Priorisierung der Machbarkeit der Peptidsynthese eine Ranking-Funktion ändern??
Bewerten Sie eine zur Aggregation neigende Komposition, Motivfahnen, Länge im Vergleich zum validierten Synthesebereich, Modifikationskomplexität und Reinigungsrisiko neben der vorhergesagten Aktivität, und eine Hochaktivität behandeln, Hochrisikosequenz als Warteschlangenelement und nicht als Kandidat.
Abschluss
Die Antibiotika-Kampagne des MIT und die Enzymsuche zeigen, dass eine Design-to-Data-Schleife riesige Räume durchsuchen und priorisierte Hypothesen zurückgeben kann; Sie zeigen nicht, dass es sich bei einer Verbindung oder einem Peptid um ein Medikament handelt. Der Zelle Die Arbeit hört bei Mausinfektionsmodellen auf, Die Peptidkampagne endet bei In-vitro-MICs, und das Enzymsystem bleibt eine Hypothese, die auf Experimente wartet. Für KI-gestaltete Arbeitsabläufe in der Antibiotika- und Peptidforschung, Die Schwachstellen liegen in der Machbarkeit der Synthese, orthogonale Validierung und Datensatzverwaltung, und jedes davon ist ein technisches Problem, das ein Programm in diesem Quartal beheben kann.
Die Verschiebung, die wir auf dem gesamten Feld erwarten, ist dreifach: Machbarkeitsbewusstes Design, das Kandidaten danach einordnet, ob sie hergestellt werden können, Standardmäßig orthogonale Analysen, bei denen eine einzelne Methode angenommen wird, können irreführend sein, und beanspruchen Sie Etiketten, die mit den Daten übertragen werden, sodass ein Mausmodellergebnis niemals als klinisches Ergebnis interpretiert wird. Programme, die alle drei übernehmen, werden KI-Kandidatenlisten schneller in testfertiges Peptidmaterial umwandeln als Programme, die die Validierung als nachgelagerte Formalität behandeln.
Ein praktischer erster Schritt besteht darin, eine schwierige Sequenz und den beabsichtigten Test in ein technisches Gespräch einzubringen. Fragen Sie, was das Analysepaket enthalten muss, bevor Sie das CoA unterzeichnen, und fordern Sie ein Muster-Analysezertifikat und ein Analysepaket an, damit die Antwort ein Dokument und kein Versprechen ist. Hier handelt es sich nicht um klinische oder behördliche Ratschläge; Entscheidungen über den Aufstieg eines Kandidaten liegen bei Ihren eigenen wissenschaftlichen und medizinischen Gutachtern.
Offenlegung durch den Herausgeber: MOL Changes bietet Peptiddienstleistungen an und hat ein kommerzielles Interesse an diesem Thema. Leistungsumfang und Leistungsbeschreibungen sind Angaben des Lieferanten; Verfügbarkeit und Leistung für ein bestimmtes Konstrukt erfordern projektspezifische Nachweise.