Ce que les codes génétiques étendus pour la conception de peptides personnalisés changent réellement
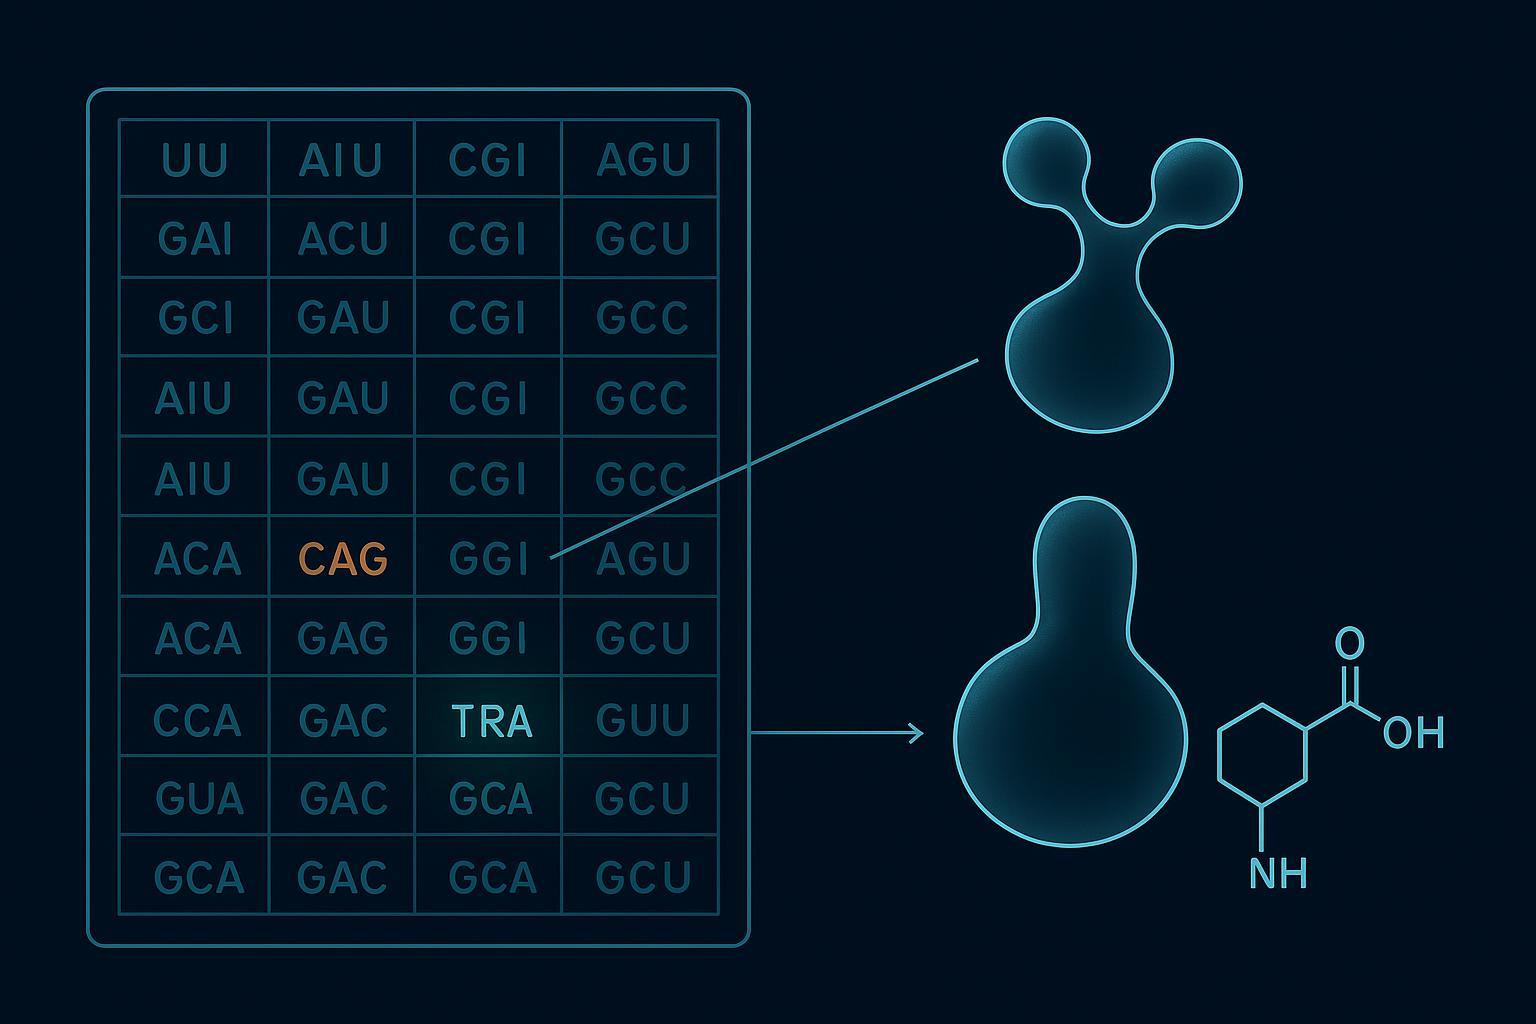
Le code génétique standard attribue 64 codons: 61 détecter les codons et 3 arrêter les codons, et chaque codon sensoriel spécifie l'un des 20 acides aminés canoniques (Collection d'extension de code génétique Addgene, dernière révision 19 Novembre 2025). Un code génétique élargi réécrit cette mission. Un ou plusieurs codons sont redirigés vers un acide aminé non canonique via la réaffectation des codons, installé spécifiquement sur un site par un ARNt orthogonal / Paire d'aminoacyl-ARNt synthétase qui ne charge que son propre ARNt modifié et rien d'autre chez l'hôte.
Cette définition importe moins que le mode de défaillance dans lequel elle se verrouille. Ambre (UAG) la suppression lit à travers un codon d'arrêt, il entre donc directement en concurrence avec le facteur de libération 1. Quand la suppression perd cette course, le résultat est une résiliation prématurée et un produit tronqué, une perte que les hôtes recodés ou RF1-knockout sont spécifiquement conçus pour réduire (Biotechnologie naturelle, 11 Septembre 2024). La réaffectation des codons sens échoue différemment: le codon réattribué est toujours en concurrence avec sa signification originale, le produit arrive donc sous forme d'un mélange contenant des incorporations canoniques plutôt que sous forme d'une chaîne courte.
Clé à retenir: La suppression orange échoue par troncature; la réaffectation des codons sens échoue par mélange. Le rendement et la pureté évoluent donc indépendamment, et le mode de défaillance dont vous héritez est défini par la stratégie de codons que vous choisissez, pas par la compétence du fournisseur.
[DIAGRAMME: table de 64 codons étiquetée avec UAG et un codon sens mis en évidence, chacun étant fléché vers sa paire orthogonale ARNt/synthétase]
Pourquoi la boîte à outils a évolué plus rapidement que les évaluations
Le matériau de référence que la plupart des équipes recherchent est en retard sur la chimie. UN 2025 l'examen met le décompte à plus tard 300 acides aminés non canoniques utilisés avec succès dans l’expansion du code génétique (Communications naturelles, 29 Septembre 2025), tandis que l'avis le plus cité dans les résultats de recherche sur ce sujet date de 2014. Les ressources au niveau plasmidique ont suivi un rythme plus rapide: La collection GCE en expansion d'Addgene répertorie à peu près 150 plasmides synthétases et 26 souches bactériennes, avec le contenu révisé pour la dernière fois le 19 Novembre 2025 (Addgène). Si votre liste restreinte de sélection a été construite à partir d’un examen vieux de dix ans, il décrit une boîte à outils plus petite que celle qui existe.
Comment les codes génétiques étendus remodèlent la sélection des acides aminés non canoniques
Cette même stratégie de codons définit également les conditions de sélection des acides aminés non canoniques., où choix de paire, pas de choix de résidu, est la contrainte contraignante. Quatre facteurs déterminent quelle paire d'ARNt-synthétase vous pouvez utiliser: ajustement du substrat, stratégie de codons, organisme hôte, et si vous devez encoder plusieurs ncAA à la fois. Parcourez-les dans cet ordre et la majeure partie de la liberté apparente dans le catalogue de résidus disparaît.
Deux plateformes dominent. Le Méthanocaldococcus jannaschii La paire TyrRS/ARNt^Tyr accepte les chaînes latérales de type tyrosine et aromatiques. L'échafaudage de la pyrrolysyl-ARNt synthétase et ses variantes évoluées acceptent des résidus volumineux et de type lysine, et tolérer une plus grande variété structurelle. Notez que l'inactivation de RF1 est une stratégie d'hôte qui augmente l'efficacité de la suppression., pas une troisième paire.
|
Services Fonctionnalité |
M. jannaschii TyrRS/ARNt^Tyr |
Variantes PylRS/ARNt^Pyl |
|---|---|---|
|
Portée du substrat |
De type tyrosine, aromatique |
Similaire à la lysine, volumineux, structurellement diversifié |
|
Stratégie de codons |
Ambre (UAG) suppression |
Ambre, ocre, ou réaffectation des codons sens |
|
Compatibilité hôte |
E. coli, levure, cellules de mammifères |
E. coli, cellules de mammifères, systèmes acellulaires |
|
Adéquation au multiplexage |
Limité; tolérance du substrat superposé |
Mieux adapté à l'expansion de paires orthogonales |
Le multiplexage est le domaine où le domaine évolue. UN 2024 stratégie de compression de codons identifiée 12 paires d'ARNt-synthétase mutuellement orthogonales compatibles avec l'ensemble de ressources GCE connu, ce qui est important si votre conception nécessite deux ou plusieurs ncAA distincts dans une seule chaîne.
Il y a ensuite la frontière entre ce qu'un ribosome peut installer et ce que seul le SPPS peut installer.. Les modifications de chaîne latérale sur un squelette d'acide aminé sont compatibles GCE. Acides β-aminés, un,Résidus α-disubstitués, en depsipeptides, et de nombreux résidus N-méthylés ne sont pas; ils sont uniquement SPPS ou in vitro uniquement. Si votre résidu cible figure sur cette liste, aucune sélection de paire ne le sauvera.
Efficacité de la suppression de lecture honnêtement
L'efficacité de la suppression est une plage, et la plage ne signifie quelque chose qu'avec la souche et le reporter attachés. Les systèmes antérieurs fournissaient environ 10 à 20 % pour un seul codon ambre. Les systèmes optimisés et évolués atteignent 50 à 117 % selon le contexte, et 76 à 104 % dans la souche C321 délétée par RF1. Ces figures décrivent différentes constructions, ce n'est donc pas une échelle que vous pouvez gravir en choisissant le nombre le plus élevé.
L'efficacité de l'incorporation n'est pas non plus la même mesure que la lecture presque apparentée. La lecture s'étend sur environ 1% dans le Top10, à propos 3% en BL21, et jusqu'à 17% dans MG1655, atteignant jusqu'à 47.5% sur un site orange donné dans un arrière-plan supprimé par RF1. On mesure la quantité de ncAA que vous installez; l'autre mesure la quantité de mauvais acides aminés que vous installez à côté.
La conséquence pratique: une spécification qui ne nomme qu'un pourcentage, sans nommer la souche et le journaliste, n'est pas une spécification. Demandez les deux avant d’accepter un chiffre d’efficacité.
Conception de bibliothèques de peptides avec des acides aminés non canoniques
Une fois la paire fixée, la plate-forme d'affichage que vous choisissez fixe le plafond sur lequel les acides aminés non canoniques que votre bibliothèque peut contenir. L'affichage de l'ARNm et le RaPID sont les plus élevés en termes de tolérance aux ncAA, car l'ensemble du cycle se déroule in vitro: flexizyme charge directement l'ARNt, le ribosome n'a donc jamais à rivaliser avec une synthétase hôte, et les résidus modifiés par le squelette restent en jeu. L'affichage des ribosomes est élevé mais dépend du système, puisque la tolérance change avec le lysat et la configuration du facteur de libération. L’affichage sur phages reste réalisable, parce que l'affichage par phage peut transporter des résidus non canoniques via un phage auxiliaire codant pour l'ambre, bien que la machinerie hôte limite les résidus qui survivent. L’affichage des levures est le plus contraint des quatre.
La position compte autant que la plateforme. La diversification en termes de position par rapport à la diversification mondiale des ncAA divise l'espace de conception: un ou quelques sites définis conviennent à une sonde mécaniste ou à une poignée de conjugaison et restent faciles à caractériser, tandis que la substitution généralisée convient aux tests de stabilité ou de résistance à la protéase et est beaucoup plus difficile à vérifier résidu par résidu..
Où la conception de la bibliothèque rencontre la sélection des itinéraires
Une bibliothèque construite autour d’un résidu modifié par le squelette ne peut pas du tout être produite par expansion du code génétique., la décision d'affichage et la décision de production doivent donc être prises ensemble plutôt que séquentiellement. Le gain de stabilité est ce qui fait que cette contrainte vaut la peine d'être acceptée. Dans une série d'inhibiteurs, Les résidus β2,3 cycliques ont poussé la demi-vie sérique au-delà 168 heures à 37 °C dans le sérum humain, contre 4.6 heures pour la variante d'alanine correspondante; un deuxième échafaudage dans le même ouvrage atteint 48 heures contre Boutique 4.2 heures. La N-méthylation a étendu la stabilité de la protéinase-K à partir de 6 minutes à environ 110 minutes dans son propre test, et les substitutions d'acides aminés D ont fait passer leur demi-vie de quelques minutes à quelques heures.. Aucune de ces figures ne se généralise aux peptides en tant que classe: chacun appartient à son propre échafaudage et à son propre test. La conséquence pratique est étroite et ferme. Si votre objectif de stabilité nécessite une modification du backbone, l'itinéraire est choisi pour vous, et la bibliothèque doit être conçue à l'intérieur de cette limite dès le départ.
Stratégies de conjugaison spécifiques au site activées par des codes étendus
Cette décision d'itinéraire mène directement à la conjugaison, où un handle ncaa achète un contrôle de position qu'aucun résidu canonique ne peut égaler, et cela change le mode de défaillance plutôt que d'éliminer la défaillance. Une poignée bioorthogonale installée à une position définie offre le contrôle de position le plus élevé et la charge hors cible la plus faible de toute stratégie de conjugaison peptidique spécifique à un site., mais l'échec que vous gérez alors est une incorporation incomplète ou une matière première n'ayant pas réagi, ne pas mal cibler. La cystéine est chimiosélective et bon marché, mais une sur-alkylation, l'oxydation et le brouillage des disulfures sont courants. Le couplage à la lysine donne des mélanges de régioisomères. La chimie N-terminale s'améliore par rapport à la lysine mais reste en séquence- et dépendant du contexte.
|
Chimie |
Sélectivité |
Cinétique |
Cuivre |
Mode de défaillance qu'il produit |
|---|---|---|---|---|
|
SPAAC (azide + cyclooctyne) |
Haut |
Modéré |
Non requis |
Poignée azide n'ayant pas réagi |
|
CuAAC (azide + alcyne) |
Haut |
Rapide |
Requis |
Réactions secondaires médiées par le cuivre |
|
Tétrazine-TCO |
Synthèse peptidique Haut |
Le plus rapide |
Non requis |
Tétrazine hydrolysée |
|
Cyclisation électrophile du ncAA |
Élevé lorsque la géométrie est préorganisée |
Intramoléculaire |
Non requis |
Produit intermoléculaire concurrent |
Le menu est court. SPAAC est sans cuivre et son fonctionnement est simple; CuAAC est le plus robuste, mais la sensibilité au cuivre constitue le problème.; les étiquettes tétrazine-TCO les plus rapides; et la cyclisation électrophile du ncAA est intramoléculaire et propre lorsque la géométrie est préorganisée, comme indiqué pour poignées ncAA doublement bio-orthogonales (Communications naturelles, 2023).
Choisir entre la conjugaison bioorthogonale et la ligature chimique native
La ligature chimique native et la conjugaison ncAA résolvent différents problèmes et ne sont pas des substituts. NCL est la route lorsque la cible nécessite une modification du backbone, un résidu D, ou un segment qu'aucune paire orthogonale ne facturera; its prerequisite is a viable ligation junction and a thioester segment. ncAA conjugation is the route when the target is a standard α-backbone peptide that needs one defined attachment point, and its prerequisite is a pair whose substrate scope accepts the handle plus a host or extract that suppresses the competing canonical readthrough.
La conséquence pratique: make the conjugation decision at the same time as the ncAA decision. A handle the chosen pair will not charge is a redesign, not a substitution.
Des contrôles analytiques qui prouvent la fidélité des séquences
Whatever conjugation route you settle on, the control package is what converts a synthesis claim into a defensible specification, and it has to be designed before the first lot is made, not assembled after a deviation. For any peptide carrying a noncanonical residue, les contrôles analytiques de fidélité de séquence reposent sur cinq éléments: confirmation de la masse exacte du peptide intact plus des ions fragments de localisation de séquence couvrant le résidu modifié par LC-MS/MS; quantification de l'efficacité de l'incorporation, c'est-à-dire la fraction de peptide portant le ncAA par rapport aux malincorporants canoniques ou au produit non étiqueté; un contrôle diastéréomère/épimère par rapport à une référence synthétique ou une méthode chirale orthogonale ou à temps de rétention, car la LC-MS standard ne peut souvent pas distinguer les épimères; validation du système de traduction orthogonale avec contrôles négatifs et aucune lecture hors cible détectable; et, pour les ncAA marqués par des éléments tels que les variantes de sélénium ou de bore, analyse des acides aminés ou ICP-MS (2026 revue sur la bioconjugaison de précision et l'incorporation spécifique à un site, récupéré 2026-02-04).
Définition des critères d'acceptation avant le premier lot
Chaque contrôle ne devient utile que lorsqu'il porte un numéro. Lier la précision de la masse au résidu à confirmer, lier le seuil d'efficacité d'incorporation au pouvoir de résolution du test qui le mesure, et exiger que le contrôle épimère nomme l'étalon de référence auquel il compare. Où le peptide est un candidat parentéral, la limite pharmacopée est dérivée de la dose: USP <85> fixe la limite d'endotoxine = K/M, avec K = 5 UE/kg/heure pour les voies non intrathécales et K = 0.2 UE/kg/heure intrathécale, exprimé par mg ou par mL de la dose humaine maximale. ICH Q2(R2) définit les paramètres de validation, et les principes MHRA ALCOA encadrent les attentes en matière d'intégrité des données qui les entourent..
Un contrôle qui n'est pas inscrit dans le cahier des charges avant le premier lot est un contrôle que vous négocierez après un écart.
Mise à l'échelle: SPSS, CFPS et risque de fidélité lot à lot
Ces contrôles doivent ensuite survivre à une mise à l’échelle, car la filière qui a produit votre lot de recherche n'est pas automatiquement la filière qui produit votre lot clinique, et le profil de risque de fidélité change avec lui. La synthèse peptidique en phase solide fonctionne de quelques milligrammes à grammes par lot, avec des flux de travail préparatifs et industriels atteignant des dizaines à des centaines de grammes, et quelques séquences à l'échelle du kilogramme. Les systèmes sans cellules fournissent généralement des mg par litre: à propos 96 ± 3 mg/L pour une protéine porteuse 40 acides aminés non canoniques identiques, tandis qu'un extrait optimisé déficient en RF1 atteignait environ 1,780 ± 30 mg/L pour sfGFP (Littérature sur l'incorporation de ncAA acellulaires, 2020). Le fossé entre les voies acellulaires et les voies en phase solide est réel, et cela détermine quels risques de fidélité dominent à chaque étape.
Deux risques lot-à-lot découlent de cette répartition. Sous suppression orange, les produits de troncature et de lecture varient selon l'état de l'hôte, de sorte que le profil d'impuretés peut changer entre les cycles de fermentation même lorsque la bande cible semble inchangée. Sous réaffectation des codons sens, le rapport non canonique à canonique peut dériver tandis que le rendement total reste stable, ce qui signifie qu'un test de publication axé uniquement sur le rendement ne le détectera pas.
La conséquence pratique: les contrôles de fidélité de la section précédente appartiennent à la spécification de version pour chaque lot, pas seulement dans le lot de qualification.
Que demander à un partenaire avant de s'engager
Intégrez six questions à la conversation. Quel acide aminé non canonique et quelle paire orthogonale? Quelle stratégie de codons, suppression orange ou réaffectation des codons sens? Quel hôte ou extrait acellulaire, et quelle est sa performance de suppression documentée? Quelle voie de conjugaison, et est-ce qu'il préserve le résidu incorporé? Lequel des cinq contrôles de fidélité s'exécute sur chaque lot ?? Et quels critères d'acceptation définissent un lot de réussite avant que le premier ne soit réalisé?
Un flux de travail structuré de la conception au contrôle qualité prend en charge cela. Les modifications MOL peuvent être utilisées pour aligner la sélection ncAA, voie de synthèse et critères de publication analytiques en un seul transfert, les contrôles convenus au stade de la conception sont donc les contrôles exécutés à grande échelle. Demandez par écrit le panneau de contrôle au niveau du lot, et comparez-le à vos propres spécifications avant de vous engager.
Idées fausses courantes sur les codes génétiques étendus
Quatre erreurs apparaissent assez souvent dans les revues de programmes pour mériter d’être mentionnées directement.
La première est qu’un code génétique élargi signifie un génome réécrit. En pratique, cela signifie généralement un codon réaffecté et une paire orthogonale, ajouté à un hôte qui est par ailleurs inchangé.
La seconde est qu'une efficacité d'incorporation plus élevée signifie une pureté plus élevée.. Les deux peuvent se déplacer dans des directions opposées: la réaffectation des codons sens peut maintenir le rendement tandis que la pureté diminue, parce que le codon réattribué est désormais disponible pour les ARNt presque apparentés ainsi que pour la paire orthogonale.
La troisième est que tout acide aminé non canonique peut être intégré à n’importe quelle voie de production.. La répartition de la modification du squelette est une frontière dure, pas une préférence: les résidus qui altèrent le squelette ne peuvent pas être installés par incorporation ribosomale, et les résidus qui nécessitent le ribosome ne peuvent pas être fabriqués par SPPS.
Le quatrième concerne les tests de version.
⚠️ Attention: Une seule masse intacte ne confirme pas la séquence. Sans fragments d'ions couvrant le résidu modifié, un épimère ou une mauvaise incorporation à une position proche peut satisfaire à la même spécification.
Où va la boîte à outils
Avec ces idées fausses dissipées, la direction du voyage est vers l’utilisation d’une plus grande partie du code à la fois. Où les premiers travaux reposaient sur une seule paire orthogonale, des systèmes récents ont montré que des paires mutuellement orthogonales utilisées ensemble peuvent fonctionner dans la même cellule, c'est ce qui fait de l'incorporation multi-sites de différents acides aminés non canoniques une option de conception plutôt qu'une expérience de réflexion.
Un deuxième changement est architectural. L'intérêt s'est porté vers des systèmes sans cellules et basés sur des extraits qui évitent la modification permanente du génome de l'hôte., ce qui raccourcit le cycle entre la conception d'une construction et son test. A côté de ça, le travail sur les codons à quatre nucléotides étend l'espace de codons disponible au-delà de la norme 64, élargir la marge de réaffectation.
La mise en garde honnête est inchangée: l'efficacité de la suppression reste ncAA- et dépendant du contexte de la séquence, et tous les acides aminés non canoniques ne sont pas compatibles avec toutes les voies. C'est pourquoi le cadre d'évaluation de Peptides synthétiques ce guide, plutôt qu'une paire ou une plateforme particulière, est-ce que la partie vaut la peine d'être gardée: les codes génétiques étendus pour la conception de peptides personnalisés continueront de changer, mais les contrôles qui prouvent ce que vous avez construit ne le seront pas.
Prochaines étapes
Apportez une séquence spécifique et une exigence de fidélité spécifique à la première conversation technique sur les codes génétiques étendus pour la conception de peptides personnalisés, pas une enquête générale. La liste de contrôle d'évaluation ci-dessous transforme le cadre en quatre parties de ce guide en questions auxquelles un partenaire devrait être en mesure de répondre sans se cacher.:
-
Quelle paire orthogonale, and what suppression efficiency has been observed for it in your expression host?
-
Quelle stratégie de codons: amber suppression, sense-codon reassignment, or a quadruplet codon?
-
Which route for this sequence: SPSS, cell-free synthesis, or fermentation, and why that one?
-
Which conjugation chemistry, and does it stay orthogonal to the residues already in the chain?
-
Which of the five sequence fidelity analytical controls are run per lot, and what are the acceptance criteria?
A partner who can answer all five, and say plainly where a given ncAA or route will not work, is worth more than a lower quote. MOL Changes supports this kind of design-to-QC conversation across 300+ groupes fonctionnels, SPPS and microbial fermentation, mg-to-kg scale, and HPLC/MS and sterility QC under Class 100 cleanroom conditions.
Divulgation: MOL Changes is the sponsor of this guide. Le cadre et les critères d'évaluation ci-dessus sont présentés à des fins de recherche et de comparaison.. À propos
Foire aux questions
Qu'est-ce qu'un code génétique élargi?
Un code génétique étendu est un système de traduction dans lequel un ou plusieurs codons ont été réaffectés pour spécifier un acide aminé non canonique au lieu de l'acide aminé standard.. La réaffectation est ciblée plutôt que globale: un ARNt orthogonal et sa paire aminoacyl-ARNt synthétase sont introduits de sorte que la synthétase ne charge que son ARNt apparenté modifié, en laissant intactes les propres machines de traduction de l’hôte. Dans le cadre standard de 64 codons, cela laisse la possibilité d'installer une nouvelle fonction chimique à une position choisie sans réécrire le reste du protéome.
Combien d'acides aminés non canoniques peuvent être génétiquement codés?
UN 2025 L'estimation de la revue place le nombre d'acides aminés non canoniques génétiquement codables à plus de 300, bien que ce chiffre décrit la boîte à outils cumulative du domaine plutôt que ce qu’un système unique peut offrir. Le nombre pratique est bien moindre, car chaque ncAA a besoin d'une paire orthogonale compatible et d'un hôte qui tolère la réaffectation. Traitez le numéro du titre comme une limite supérieure de ce qui a été démontré quelque part, pas comme un menu où vous pouvez commander.
Quelle est la différence entre la suppression de l'ambre et la réaffectation des codons sens?
La suppression orange lit le codon d'arrêt UAG et entre directement en compétition avec le facteur de libération 1, donc son mode de défaillance caractéristique est un produit tronqué. La réaffectation des codons sens remplace un codon qui code normalement un résidu standard, donc son mode de défaillance est une population mixte: le rendement peut rester élevé tandis que la pureté diminue, parce que le résidu de type sauvage est toujours incorporé aux côtés du ncAA. Cette différence détermine les contrôles dont vous avez besoin, puisque la troncature apparaît dans la masse intacte alors qu'une erreur de traduction ne le fait pas.
Quels acides aminés non canoniques peuvent être fabriqués par SPPS plutôt que par expansion du code génétique?
Acides β-aminés, un,Résidus α-disubstitués, les liaisons depsipeptides et de nombreux résidus N-méthylés ne sont généralement accessibles que par synthèse en phase solide ou par chimie in vitro, parce que le ribosome ne les acceptera pas comme substrats. La classe génétiquement codable est plus étroite: modifications de la chaîne latérale construites sur un squelette d'acide aminé. La sélénocystéine est l'exception naturelle, codé via sa propre machinerie dédiée plutôt que via une paire conçue. Production de peptides
Comment confirmez-vous qu'un acide aminé non canonique a été incorporé au site prévu?
La confirmation nécessite une masse exacte ainsi que des ions fragments localisant la séquence qui couvrent le résidu modifié, généralement par LC-MS/MS, ainsi qu'une quantification de l'efficacité de l'incorporation et un contrôle des épimères par rapport à une référence synthétique. La masse intacte seule est insuffisante car elle ne peut pas distinguer le site visé d'un isomère de position ou d'une variante de délétion de masse similaire. Ce sont les ions fragments qui localisent le résidu; la messe te dit seulement que quelque chose a changé.
Les acides aminés non canoniques peuvent-ils être incorporés sur plus d’un site?
Oui, mais l'incorporation sur plusieurs sites multiplie la charge analytique plutôt que de simplement répéter un flux de travail sur un seul site. Chaque poste supplémentaire ajoute son propre événement de suppression ou de réaffectation, et la fraction de produit portant le ncAA sur chaque site prévu diminue à mesure que les positions s'accumulent, la population devient donc une distribution d'espèces partiellement modifiées. Vous devez décider dès le départ si le test résout cette distribution, car une méthode validée pour un site ne fera pas automatiquement rapport sur quatre.
L’expansion du code génétique est-elle évolutive pour la production de peptides au stade clinique?
L'évolutivité dépend de l'itinéraire que vous choisissez, et les deux routes échouent différemment. La synthèse des protéines acellulaires a démontré des rendements dans les plages signalées plus haut dans cet article., mais ces chiffres proviennent de systèmes expérimentaux définis et ne sont pas automatiquement transférés vers un processus GMP. La synthèse en phase solide évolue de manière plus prévisible pour des séquences plus courtes, mais ne peut pas atteindre les résidus uniquement SPPS.. Pour le travail au stade clinique, la question pratique n'est pas de savoir si la chimie évolue, mais si votre logiciel analytique peut prouver la fidélité de la séquence d'un lot à l'autre à cette échelle..
Conclusion
La stratégie de codons que vous choisissez détermine le mode de défaillance dont vous héritez, donc le package de contrôle qui prouve la fidélité de la séquence doit être spécifié avant le premier lot, pas après. C'est le fil conducteur de ce guide: les codes génétiques étendus pour la conception de peptides personnalisés constituent un problème d'évaluation avant d'être un problème de synthèse.
Les quatre décisions qu'un partenaire doit être capable de défendre par écrit sont l'acide aminé non canonique et son comportement de suppression dans votre contexte de séquence., la conception de la bibliothèque et comment elle contraint l'itinéraire, la chimie de la conjugaison et ce qu'elle laisse intact, et les critères d'acceptation analytiques avec leurs méthodes et limites. Chacun rétrécit le suivant.
La direction du déplacement est vers des paires mutuellement orthogonales utilisées ensemble, des systèmes sans cellules et basés sur des extraits qui laissent le génome hôte intact, et des codons à quatre nucléotides qui étendent l'espace de codons disponible au-delà de la norme 64. La mise en garde honnête est que l'efficacité de la suppression reste dépendante du ncAA et de la séquence environnante., et tous les ncAA ne sont pas compatibles avec toutes les routes.
Utilisez la liste de contrôle des prochaines étapes comme base pour votre première conversation technique.
À propos de l'auteur: [Nom de l'auteur], [informations d'identification], écrit sur la conception des peptides et la stratégie de contrôle analytique pour les changements MOL.
Divulgation: MOL Changes fournit la conception de peptides, services de synthèse et d'analyse, y compris les capacités décrites dans ce guide.