Hvad udvidede genetiske koder for tilpasset peptiddesign faktisk ændrer sig
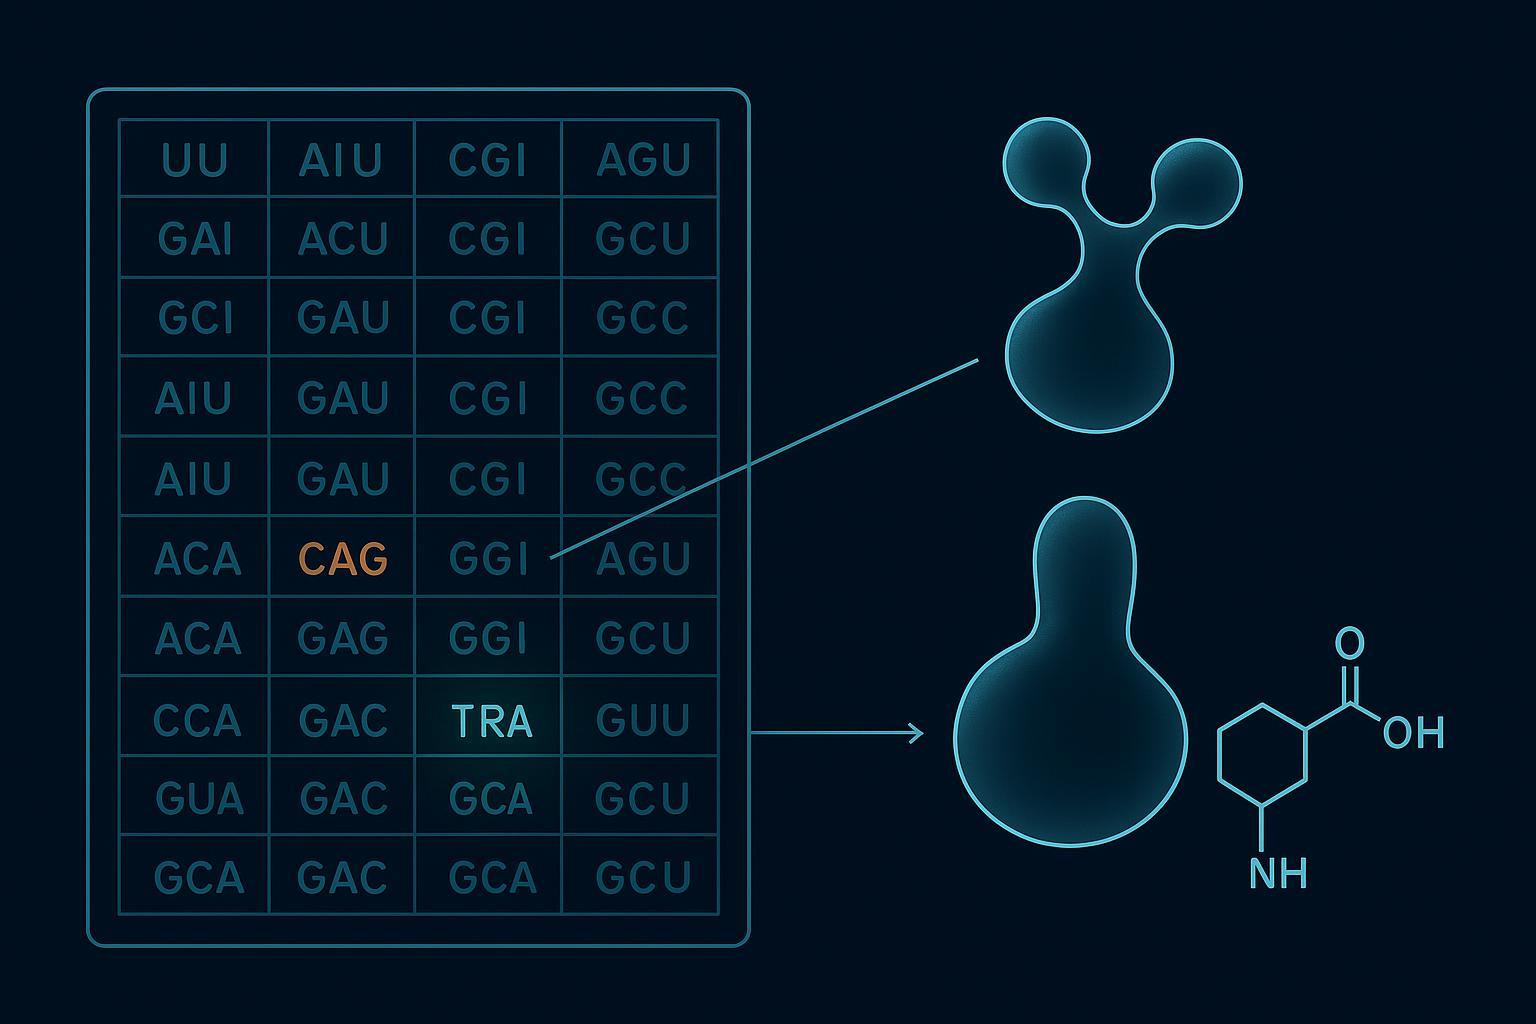
Den genetiske standardkode tildeler 64 kodoner: 61 sanse kodoner og 3 stop kodoner, og hver sense-kodon specificerer en af 20 kanoniske aminosyrer (Addgene Genetic Code Expansion-samling, sidst gennemgået 19 november 2025). En udvidet genetisk kode omskriver denne opgave. Et eller flere kodoner omdirigeres til en ikke-kanonisk aminosyre gennem kodonomfordeling, installeret stedspecifikt af et ortogonalt tRNA / aminoacyl-tRNA syntetasepar, der kun oplader sit eget konstruerede tRNA og intet andet i værten.
Den definition betyder mindre end den fejltilstand, den låser i. Rav (UAG) undertrykkelse læser gennem et stopkodon, så den konkurrerer direkte med frigivelsesfaktor 1. Når undertrykkelse taber den race, resultatet er for tidlig opsigelse og afkortet produkt, et tab, som omkodede eller RF1-knockout-værter er specifikt designet til at reducere (Natur bioteknologi, 11 september 2024). Sense-codon omfordeling mislykkes anderledes: den omtildelte kodon konkurrerer stadig med sin oprindelige betydning, så produktet ankommer som en blanding indeholdende kanoniske fejlinkorporeringer snarere end en kort kæde.
Nøgle takeaway: Ravundertrykkelse mislykkes ved trunkering; sense-codon omfordeling mislykkes ved blanding. Udbytte og renhed bevæger sig derfor uafhængigt, og den fejltilstand, du arver, indstilles af den kodonstrategi, du vælger, ikke efter hvor dygtig leverandøren er.
[DIAGRAM: mærket 64-kodon-tabel med UAG og én sense-kodon fremhævet, hver pilet til sit ortogonale tRNA/syntetase-par]
Hvorfor værktøjskassen flyttede hurtigere end anmeldelserne
Det referencemateriale, de fleste hold når efter, halter med kemien. EN 2025 gennemgang sætter optællingen over 300 ikke-kanoniske aminosyrer med succes brugt i genetisk kodeudvidelse (Naturkommunikation, 29 september 2025), mens den mest citerede anmeldelse i søgeresultaterne om dette emne dateres til 2014. Ressourcer på plasmidniveau er holdt tættere på: Addgenes ekspanderende GCE-samling lister nogenlunde 150 syntetaseplasmider og 26 bakteriestammer, med indhold sidst gennemgået den 19 november 2025 (Addgene). Hvis din valgliste blev bygget ud fra en årtier gammel anmeldelse, det beskriver en mindre værktøjskasse end den der findes.
Hvordan udvidede genetiske koder omformer ikke-kanonisk aminosyreudvælgelse
Den samme kodonstrategi sætter også vilkårene for ikke-kanonisk aminosyreselektion, hvor par valg, ikke restvalg, er den bindende begrænsning. Fire faktorer afgør hvilket tRNA-syntetasepar du kan bruge: underlagspasning, kodon strategi, værtsorganisme, og om du skal indkode mere end én ncAA på én gang. Arbejd gennem dem i den rækkefølge, og det meste af den tilsyneladende frihed i restkataloget forsvinder.
To platforme dominerer. De Methanocaldococcus jannaschii TyrRS/tRNA^Tyr-par accepterer tyrosinlignende og aromatiske sidekæder. Pyrrolysyl-tRNA syntetase stilladset og dets udviklede varianter tager lysin-lignende og omfangsrige rester, og tolerere mere strukturel variation. Bemærk, at RF1 knockout er en værtsstrategi, der øger undertrykkelseseffektiviteten, ikke et tredje par.
|
Tjenester Feature |
M. jannaschii TyrRS/tRNA^Tyr |
PylRS/tRNA^Pyl varianter |
|---|---|---|
|
Underlagsomfang |
Tyrosin-lignende, aromatisk |
Lysin-lignende, omfangsrigt, strukturelt forskelligartet |
|
Codon strategi |
Rav (UAG) undertrykkelse |
Rav, okker, eller sense-codon omfordeling |
|
Værtskompatibilitet |
E. coli, gær, pattedyrsceller |
E. coli, pattedyrsceller, cellefri systemer |
|
Multiplexing egnethed |
Begrænset; overlappende underlagstolerance |
Bedre egnet til ortogonal parudvidelse |
Multiplexing er der, hvor feltet bevæger sig. EN 2024 codon-komprimeringsstrategi identificeret 12 gensidigt ortogonale tRNA-syntetasepar, der er kompatible med det kendte GCE-ressourcesæt, hvilket betyder noget, hvis dit design har brug for to eller flere forskellige ncAA'er i en kæde.
Så er der grænsen mellem, hvad et ribosom kan installere, og hvad kun SPPS kan. Sidekædemodifikationer på en a-aminosyrerygrad er GCE-kompatible. β-aminosyrer, -en,a-disubstituerede rester, i depsipeptider, og mange N-methylerede rester er det ikke; de er kun SPPS eller in vitro-only. Hvis din målrest sidder på den liste, intet parvalg vil redde det.
Læseundertrykkelseseffektivitet ærligt
Undertrykkelseseffektivitet er et område, og rækkevidden betyder kun noget med belastningen og reporteren tilknyttet. Tidligere systemer leverede omkring 10-20% for en enkelt ravkodon. Optimerede og udviklede systemer når 50-117 % afhængigt af kontekst, og 76-104% i den RF1-deleterede C321-stamme. Disse figurer beskriver forskellige konstruktioner, så de er ikke en stige, du kan bestige ved at vælge det højeste tal.
Inkorporeringseffektivitet er heller ikke den samme metrik som næsten beslægtet gennemlæsning. Gennemlæsning kører ca 1% i Top10, om 3% i BL21, og op til 17% i MG1655, når så højt som 47.5% på et givet gult sted i en RF1-slettet baggrund. Man måler, hvor meget ncAA du installerer; den anden måler, hvor meget forkert aminosyre du installerer ved siden af.
Den praktiske konsekvens: en specifikation, der kun nævner en procentdel, uden at nævne stammen og reporteren, er ikke en specifikation. Bed om begge dele, før du accepterer et effektivitetstal.
Design af peptidbiblioteker med ikke-kanoniske aminosyrer
Når parret er fikset, den displayplatform, du vælger, sætter loftet for, hvilke ikke-kanoniske aminosyrer dit bibliotek overhovedet kan indeholde. mRNA-display og RaPID sidder højest på ncAA-tolerance, fordi hele cyklussen kører in vitro: flexizyme oplader tRNA'et direkte, så ribosomet behøver aldrig at konkurrere med en værtssyntetase, og backbone-modificerede rester forbliver i spil. Ribosomdisplay rangerer højt, men systemafhængigt, da tolerancen skifter med lysatet og opsætningen af frigivelsesfaktoren. Phage display forbliver brugbart, fordi fagdisplay kan bære ikke-kanoniske rester via rav-kodende hjælpefag, selvom værtsmaskineriet begrænser, hvilke rester der overlever. Gærvisning er den mest begrænsede af de fire.
Position betyder lige så meget som platform. Positionsmæssigt versus global ncAA-diversifikation splitter designrummet: enkelte eller få definerede steder passer til en mekanistisk sonde eller et konjugationshåndtag og forbliver lette at karakterisere, mens gennemgribende substitution passer til stabilitets- eller protease-resistens-skærme og er langt sværere at verificere rest for rest.
Hvor biblioteksdesign møder rutevalg
Et bibliotek bygget op omkring en backbone-modificeret rest kan slet ikke produceres ved genetisk kodeudvidelse, så visningsbeslutningen og produktionsbeslutningen skal træffes sammen i stedet for i rækkefølge. Stabilitetsgevinsten er det, der gør denne begrænsning værd at acceptere. I en inhibitor serie, cykliske β2,3-rester skubbede serumhalveringstiden forbi 168 timer kl 37 °C i humant serum, mod 4.6 timer for den tilsvarende alaninvariant; et andet stillads i samme værk nået 48 timer kontra Butik 4.2 timer. N-methylering forlængede proteinase-K stabilitet fra 6 minutter til nogenlunde 110 minutter i sin egen analyse, og D-aminosyresubstitutioner flyttede halveringstiden fra minutter til timer i deres. Ingen af disse tal generaliserer til peptider som en klasse: hver tilhører sit eget stillads og analyse. Den praktiske konsekvens er snæver og fast. Hvis dit stabilitetsmål kræver en ændring af rygraden, ruten er valgt for dig, og biblioteket skal designes inden for den grænse fra starten.
Stedspecifikke konjugationsstrategier aktiveret af udvidede koder
Denne rutebeslutning går direkte ind i konjugering, hvor et ncAA-håndtag køber positionskontrol, som ingen kanoniske rester kan matche, og det ændrer fejltilstanden i stedet for at eliminere fejl. Et bioortogonalt håndtag installeret i en defineret position giver den højeste positionskontrol og den laveste off-target byrde af enhver stedspecifik peptidkonjugationsstrategi, men den fiasko, du så klarer, er ufuldstændig inkorporering eller uomsat udgangsmateriale, ikke fejlmålretning. Cystein er kemoselektivt og billigt, dog overalkylering, oxidation og disulfid-forvrængning er rutine. Lysinkobling giver regioisomerblandinger. N-terminal kemi forbedrer lysin, men forbliver sekvens- og kontekstafhængig.
|
Kemi |
Selektivitet |
Kinetik |
Kobber |
Fejltilstand den producerer |
|---|---|---|---|---|
|
SPAAC (azid + cyclooktyn) |
Høj |
Moderat |
Ikke påkrævet |
Ureageret azidhåndtag |
|
CuAAC (azid + alkyn) |
Høj |
Hurtig |
Påkrævet |
Kobbermedierede bivirkninger |
|
Tetrazin-TCO |
Peptidsyntese Høj |
Hurtigste |
Ikke påkrævet |
Hydrolyseret tetrazin |
|
Elektrofil ncAA ringslutning |
Høj, når geometrien er forudorganiseret |
Intramolekylær |
Ikke påkrævet |
Konkurrerende intermolekylært produkt |
Menuen er kort. SPAAC er kobberfri og betjeningsvenlig; CuAAC er den mest robuste, men kobberfølsomhed er ansvaret; tetrazin-TCO etiketter hurtigst; og elektrofil ncAA-cyklisering er intramolekylær og ren, når geometrien er præorganiseret, som indberettet for dobbelt bio-ortogonale ncAA håndtag (Naturkommunikation, 2023).
At vælge mellem bioorthogonal konjugation og naturlig kemisk ligering
Nativ kemisk ligering og ncAA-konjugation løser forskellige problemer og er ikke erstatninger. NCL er ruten, når målet kræver en backbone-modifikation, en D-rest, eller et segment, som intet ortogonalt par vil oplade; dens forudsætning er en levedygtig ligationsforbindelse og et thioestersegment. ncAA-konjugation er ruten, når målet er et standard α-rygradspeptid, der har brug for et defineret tilknytningspunkt, og dets forudsætning er et par, hvis substratomfang accepterer håndtaget plus en vært eller ekstrakt, der undertrykker den konkurrerende kanoniske gennemlæsning.
Den praktiske konsekvens: træffe konjugationsbeslutningen samtidig med ncAA-beslutningen. Et håndtag, som det valgte par ikke vil oplade, er et redesign, ikke en erstatning.
Analytiske kontroller, der beviser sekvenstroskab
Uanset hvilken konjugationsrute du sætter dig på, kontrolpakken er det, der konverterer en syntesepåstand til en forsvarlig specifikation, og det skal designes, før det første parti laves, ikke samlet efter en afvigelse. For ethvert peptid, der bærer en ikke-kanonisk rest, analytiske kontroller for sekvenstroskab hviler på fem elementer: nøjagtig massebekræftelse af det intakte peptid plus sekvenslokaliserende fragmentioner, der spænder over den modificerede rest ved LC-MS/MS; kvantificering af inkorporeringseffektivitet, betyder fraktionen af peptid, der bærer ncAA versus kanoniske fejlinkorporeringer eller umærket produkt; en diastereomer/epimer kontrol mod en syntetisk reference eller en ortogonal chiral eller retentionstid metode, fordi standard LC-MS ofte ikke kan skelne epimerer; ortogonal oversættelsessystemvalidering med negative kontroller og ingen detekterbar off-target readthrough; og, for elementmærkede ncAA'er såsom selen- eller borvarianter, aminosyreanalyse eller ICP-MS (2026 gennemgang af præcisionsbiokonjugation og stedspecifik inkorporering, hentet 2026-02-04).
Indstilling af acceptkriterier før det første parti
Hver kontrol bliver kun nyttig, når den har et nummer. Bind massenøjagtigheden til den rest, der bekræftes, binde inkorporeringseffektivitetstærsklen til opløsningsevnen af den analyse, der måler den, og kræver, at epimerkontrollen navngiver den referencestandard, den sammenligner med. Hvor peptidet er en parenteral kandidat, den farmakopéielle grænse er dosisafledt: USP <85> sætter endotoksingrænse = K/M, med K = 5 EU/kg/time for ikke-intrathekale ruter og K = 0.2 EU/kg/time intrathecal, udtrykt pr. mg eller pr. ml af den maksimale humane dosis. I Q2(R2) indstiller valideringsparametrene, og MHRA ALCOA-principperne danner ramme om forventningerne til dataintegritet omkring dem.
En kontrol, der ikke er skrevet ind i specifikationen før det første parti, er en kontrol, du skal forhandle efter en afvigelse.
Opskalering: SPSS, CFPS og Lot-to-Lot-troskabsrisiko
Disse kontroller skal så overleve opskalering, fordi den rute, der producerede dit forskningsbatch, ikke automatisk er den rute, der producerer dit kliniske batch, og troskabsrisikoprofilen ændres med den. Fastfase peptidsyntese fungerer ved milligram til gram pr. batch, med forberedende og industrielle arbejdsgange, der når ti til hundredvis af gram, og nogle sekvenser i kilogram skala. Cellefri systemer leverer typisk mg pr. liter: om 96 ± 3 mg/L for et proteinbærende 40 identiske ikke-kanoniske aminosyrer, mens et optimeret RF1-mangelfuldt ekstrakt nåede nogenlunde 1,780 ± 30 mg/L for sfGFP (cellefri ncAA-inkorporeringslitteratur, 2020). Skalaforskellen mellem cellefri og fastfase-ruter er reel, og det former, hvilke troskabsrisici, der dominerer på hvert trin.
To lot-to-lot-risici følger af denne opdeling. Under ravundertrykkelse, trunkerings- og gennemlæsningsprodukter varierer med værtsstaten, så urenhedsprofilen kan skifte mellem fermenteringskørsler, selv når målbåndet ser uændret ud. Under sense-codon omfordeling, det ikke-kanoniske-til-kanoniske forhold kan glide, mens det samlede udbytte forbliver fladt, hvilket betyder, at en frigivelsestest med kun udbytte ikke fanger det.
Den praktiske konsekvens: troskabskontrollerne fra det foregående afsnit hører hjemme i udgivelsesspecifikationen for hvert parti, ikke kun i kvalifikationspartiet.
Hvad skal man spørge en partner, før man forpligter sig
Tag seks spørgsmål ind i samtalen. Hvilket ikke-kanonisk aminosyre og ortogonalt par? Hvilken kodonstrategi, ravsuppression eller omplacering af sense-codon? Hvilken vært eller cellefri ekstrakt, og hvad er dens dokumenterede undertrykkelsesydelse? Hvilken konjugationsrute, og bevarer det den inkorporerede rest? Hvilken af de fem troskabskontroller kører på hvert parti? Og hvilke acceptkriterier definerer et bestået parti, før det første er lavet?
En struktureret design-til-QC-arbejdsgang understøtter dette. MOL-ændringer kan bruges til at justere ncAA-valg, synteserute og analytiske frigivelseskriterier i én overdragelse, så de kontroller, der er aftalt på designstadiet, er kontrollerne, der køres i skala. Spørg skriftligt om kontrolpanelet på lotniveau, og sammenlign det med din egen specifikation, før du forpligter dig.
Almindelige misforståelser om udvidede genetiske koder
Fire fejl dukker ofte nok op i programanmeldelser, at de er værd at navngive direkte.
Den første er, at en udvidet genetisk kode betyder et omskrevet genom. I praksis betyder det som regel et omtildelt kodon og et ortogonalt par, tilføjet til en vært, der ellers er uændret.
Den anden er, at højere inkorporeringseffektivitet betyder højere renhed. De to kan bevæge sig i hver sin retning: sense-codon omfordeling kan holde udbytte, mens renheden falder, fordi det omtildelte kodon nu er tilgængeligt for næsten beslægtede tRNA'er såvel som for det ortogonale par.
Den tredje er, at enhver ikke-kanonisk aminosyre kan indsættes i en hvilken som helst produktionsrute. Opdelingen af rygraden er en hård grænse, ikke en præference: rester, der ændrer rygraden, kan ikke installeres ved ribosomal inkorporering, og rester, der kræver ribosomet, kan ikke fremstilles af SPPS.
Den fjerde vedrører udgivelsestest.
⚠️ Advarsel: En enkelt intakt masse bekræfter ikke rækkefølgen. Uden fragmentioner, der spænder over den modificerede rest, en epimer eller en fejlinkorporering i en nærliggende position kan bestå den samme specifikation.
Hvor værktøjskassen er på vej hen
Med disse misforståelser ryddet op, kørselsretningen er mod at bruge mere af koden på én gang. Hvor tidligt arbejde var afhængig af et enkelt ortogonalt par, nyere systemer har vist, at gensidigt ortogonale par brugt sammen kan fungere i den samme celle, hvilket er det, der gør inkorporering af forskellige ikke-kanoniske aminosyrer til en designmulighed snarere end et tankeeksperiment.
Et andet skift er arkitektonisk. Interessen har bevæget sig mod cellefrie og ekstraktbaserede systemer, der undgår permanent modifikation af værtsgenomet, hvilket forkorter cyklussen mellem at designe en konstruktion og teste den. Ved siden af det, fire-nukleotid codon arbejde udvider det tilgængelige codon rum ud over standarden 64, udvide det lokale, der er til rådighed for omplacering.
Den ærlige advarsel er uændret: undertrykkelseseffektiviteten forbliver ncAA- og sekvens-kontekstafhængig, og ikke alle ikke-kanoniske aminosyrer er kompatible med enhver rute. Derfor er evalueringsrammen i Syntetiske peptider denne guide, snarere end et bestemt par eller platform, er den del, der er værd at beholde: udvidede genetiske koder til tilpasset peptiddesign vil blive ved med at ændre sig, men de kontroller, der beviser, hvad du byggede, vil ikke.
Næste trin
Medbring en specifik sekvens og et specifikt troskabskrav til den første tekniske samtale om udvidede genetiske koder til tilpasset peptiddesign, ikke en generel henvendelse. Evalueringstjeklisten nedenfor forvandler den firedelte ramme i denne vejledning til spørgsmål, som en partner bør kunne besvare uden afdækning:
-
Hvilket ortogonalt par, og hvilken undertrykkelseseffektivitet der er blevet observeret for det i din ekspressionsvært?
-
Hvilken kodonstrategi: rav undertrykkelse, sense-codon omfordeling, eller en quadruplet codon?
-
Hvilken rute for denne sekvens: SPSS, cellefri syntese, eller gæring, og hvorfor den?
-
Hvilken konjugationskemi, og forbliver det ortogonalt i forhold til de rester, der allerede er i kæden?
-
Hvilken af de fem analytiske sekvenstroskabskontroller køres pr. lot, og hvad er acceptkriterierne?
En makker, der kan svare alle fem, og sig klart, hvor en given ncAA eller rute ikke vil fungere, er mere værd end et lavere tilbud. MOL Changes understøtter denne form for design-til-QC-samtale på tværs 300+ funktionelle grupper, SPPS og mikrobiel fermentering, mg-til-kg skala, og HPLC/MS og sterilitet QC under klasse 100 renrumsforhold.
Afsløring: MOL Changes er sponsor for denne guide. Ovenstående ramme- og evalueringskriterier præsenteres til forsknings- og sammenligningsformål. Om
Ofte stillede spørgsmål
Hvad er en udvidet genetisk kode?
En udvidet genetisk kode er et oversættelsessystem, hvor et eller flere kodoner er blevet omfordelt til at specificere en ikke-kanonisk aminosyre i stedet for standarden.. Omplaceringen er målrettet snarere end global: et ortogonalt tRNA og dets aminoacyl-tRNA syntetasepar introduceres, så syntetasen oplader kun dets beslægtede manipulerede tRNA, efterlader værtens eget oversættelsesmaskineri urørt. I standard 64-kodon-rammen, der giver plads til at installere en ny kemisk funktion på en valgt position uden at omskrive resten af proteomet.
Hvor mange ikke-kanoniske aminosyrer kan kodes genetisk?
EN 2025 gennemgangsestimat sætter antallet af genetisk kodede ikke-kanoniske aminosyrer på overstået 300, selvom den figur beskriver feltets kumulative værktøjskasse snarere end hvad et enkelt system kan levere. Det praktiske tal er langt mindre, fordi hver ncAA har brug for et kompatibelt ortogonalt par og en vært, der tolererer omfordelingen. Behandl overskriftsnummeret som en øvre grænse for, hvad der er blevet demonstreret et sted, ikke som en menu du kan bestille fra.
Hvad er forskellen mellem ravsuppression og sense-codon reassignment?
Ravsuppression læser gennem UAG-stopkodonet og konkurrerer direkte med frigivelsesfaktoren 1, så dens karakteristiske fejltilstand er afkortet produkt. Sense-codon-omfordeling bytter et kodon, der normalt koder for en standardrest, så dens fiaskotilstand er en blandet befolkning: udbyttet kan forblive højt, mens renheden falder, fordi vildtype-resten stadig er inkorporeret sammen med ncAA. Den forskel bestemmer, hvilke kontroller du har brug for, da trunkering viser sig i intakt masse, mens fejloversættelse ikke gør det.
Hvilke ikke-kanoniske aminosyrer kan fremstilles af SPPS snarere end ved genetisk kodeudvidelse?
β-aminosyrer, -en,a-disubstituerede rester, depsipeptidbindinger og mange N-methylerede rester er normalt kun tilgængelige ved fastfasesyntese eller in vitro-kemi, fordi ribosomet ikke vil acceptere dem som substrater. Den genetisk kodede klasse er smallere: sidekædemodifikationer bygget på en a-aminosyrerygrad. Selenocystein er den naturlige undtagelse, kodet gennem sit eget dedikerede maskineri snarere end gennem et konstrueret par. Peptid produktion
Hvordan bekræfter du, at en ikke-kanonisk aminosyre blev inkorporeret på det tilsigtede sted?
Bekræftelse kræver nøjagtig masse plus sekvenslokaliserende fragmentioner, der spænder over den modificerede rest, typisk af LC-MS/MS, sammen med en kvantificering af inkorporeringseffektivitet og en epimerkontrol mod en syntetisk reference. Intakt masse alene er utilstrækkelig, fordi den ikke kan skelne det tilsigtede sted fra en positionel isomer eller en deletionsvariant af lignende masse. Fragmentionerne er det, der lokaliserer resten; massen fortæller dig kun, at noget er ændret.
Kan ikke-kanoniske aminosyrer inkorporeres på mere end ét sted?
Ja, men multi-site inkorporering multiplicerer den analytiske byrde i stedet for blot at gentage en single-site workflow. Hver yderligere position tilføjer sin egen hændelse for undertrykkelse eller omfordeling, og fraktionen af produkt, der bærer ncAA'en på ethvert tilsigtet sted, falder, efterhånden som positioner akkumuleres, så bestanden bliver en fordeling af delvist modificerede arter. Du skal beslutte på forhånd, om analysen løser denne fordeling, fordi en metode, der er valideret for ét websted, ikke automatisk rapporterer om fire.
Er genetisk kodeudvidelse skalerbar til peptidproduktion i klinisk fase?
Skalerbarhed afhænger af, hvilken rute du vælger, og de to ruter fejler forskelligt. Cellefri proteinsyntese har vist udbytter i de områder, der er rapporteret tidligere i denne artikel, men disse tal kommer fra definerede eksperimentelle systemer og overføres ikke automatisk til en GMP-proces. Fastfasesyntese skalerer mere forudsigeligt for kortere sekvenser, men kan ikke nå de rester, der kun er SPPS. Til arbejde i klinisk fase, det praktiske spørgsmål er ikke, om kemien skalerer, men om din analytiske pakke kan bevise lot-to-lot sekvenstroskab på den skala.
Konklusion
Den kodonstrategi, du vælger, bestemmer den fejltilstand, du arver, så kontrolpakken, der beviser sekvenstroskab, skal specificeres før det første parti, ikke efter det. Det er den tråd, der løber gennem denne guide: expanded genetic codes for custom peptide design are an evaluation problem before they are a synthesis problem.
The four decisions a partner must be able to defend in writing are the noncanonical amino acid and its suppression behavior in your sequence context, the library design and how it constrains the route, the conjugation chemistry and what it leaves intact, and the analytical acceptance criteria with their methods and limits. Each one narrows the next.
The direction of travel is toward mutually orthogonal pairs used together, cell-free and extract-based systems that leave the host genome untouched, and four-nucleotide codons that extend the available codon space past the standard 64. The honest caveat is that suppression efficiency stays dependent on the ncAA and the surrounding sequence, og ikke alle ncAA er kompatible med alle ruter.
Brug tjeklisten i Next Steps som grundlag for din første tekniske samtale.
Om forfatteren: [Forfatterens navn], [akkreditiver], skriver om peptiddesign og analytisk kontrolstrategi for MOL Changes.
Afsløring: MOL Changes giver peptiddesign, syntese og analytiske tjenester, herunder de funktioner, der er beskrevet i denne vejledning.