Was sich durch erweiterte genetische Codes für individuelles Peptiddesign tatsächlich ändert
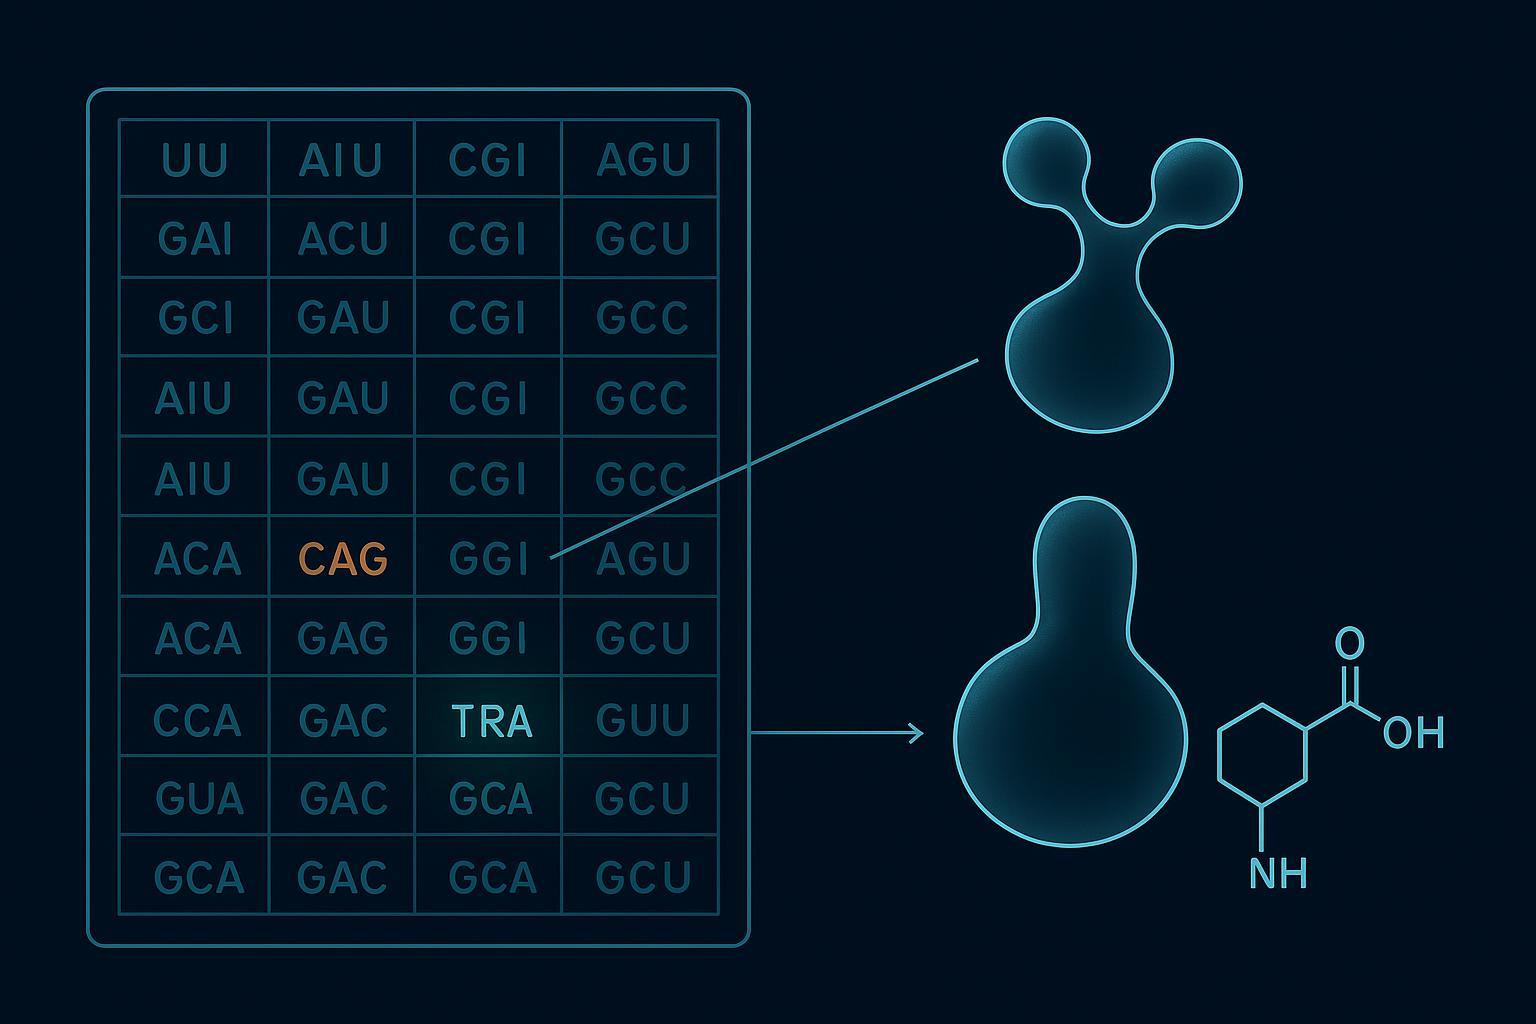
Der standardmäßige genetische Code weist zu 64 Codons: 61 Sense-Codons und 3 Stopp-Codons, und jedes Sense-Codon spezifiziert eines davon 20 kanonische Aminosäuren (Sammlung zur Erweiterung des genetischen Codes von Addgene, zuletzt überprüft 19 November 2025). Ein erweiterter genetischer Code schreibt diese Zuordnung neu. Ein oder mehrere Codons werden durch Codon-Reassignment auf eine nichtkanonische Aminosäure umgeleitet, ortsspezifisch durch eine orthogonale tRNA installiert / Aminoacyl-tRNA-Synthetase-Paar, das nur seine eigene konstruierte tRNA und nichts anderes im Wirt auflädt.
Diese Definition ist weniger wichtig als der Fehlermodus, den sie festlegt. Bernstein (UAG) Die Unterdrückung erfolgt über ein Stoppcodon, Es konkurriert also direkt mit dem Release-Faktor 1. Wenn die Unterdrückung dieses Rennen verliert, Das Ergebnis ist ein vorzeitiger Abbruch und ein verkürztes Produkt, Ein Verlust, den neu kodierte oder RF1-Knockout-Hosts speziell reduzieren sollen (Naturbiotechnologie, 11 September 2024). Die Neuzuordnung von Sense-Codons schlägt anders fehl: Das neu zugewiesene Codon konkurriert immer noch mit seiner ursprünglichen Bedeutung, Daher kommt das Produkt als eine Mischung an, die kanonische Fehlbestandteile enthält, und nicht als eine kurze Kette.
Schlüssel zum Mitnehmen: Die Amber-Unterdrückung schlägt durch Abschneiden fehl; Die Neuzuordnung des Sense-Codons schlägt bei Mischung fehl. Ertrag und Reinheit verlaufen daher unabhängig voneinander, und der Fehlermodus, den Sie erben, wird durch die von Ihnen gewählte Codon-Strategie festgelegt, nicht davon, wie kompetent der Lieferant ist.
[DIAGRAMM: beschriftete 64-Codon-Tabelle mit hervorgehobenem UAG und einem Sense-Codon, Jeder Pfeil zeigt auf sein orthogonales tRNA/Synthetase-Paar]
Warum sich die Toolbox schneller entwickelte als die Rezensionen
Das Referenzmaterial, nach dem die meisten Teams greifen, hinkt der Chemie hinterher. A 2025 Die Rezension geht davon aus, dass die Zählung vorbei ist 300 nichtkanonische Aminosäuren, die erfolgreich bei der Erweiterung des genetischen Codes eingesetzt werden (Naturkommunikation, 29 September 2025), während die meistzitierte Rezension in den Suchergebnissen zu diesem Thema aus dem Jahr stammt 2014. Die Ressourcen auf Plasmidebene haben enger mitgehalten: Die wachsende GCE-Sammlung von Addgene listet ungefähr auf 150 Synthetase-Plasmide und 26 Bakterienstämme, mit Inhalten, die zuletzt überprüft wurden am 19 November 2025 (Addgen). Wenn Ihre Auswahlliste auf einer zehn Jahre alten Rezension basiert, es beschreibt eine kleinere Toolbox als die, die es gibt.
Wie erweiterte genetische Codes die Auswahl nichtkanonischer Aminosäuren verändern
Dieselbe Codon-Strategie legt auch die Bedingungen für die Auswahl nichtkanonischer Aminosäuren fest, wo Paarwahl, keine Rückstandswahl, ist die Bindungsbeschränkung. Vier Faktoren entscheiden darüber, welches tRNA-Synthetase-Paar Sie verwenden können: Untergrund passend, Codon-Strategie, Wirtsorganismus, und ob Sie mehr als eine NCAA gleichzeitig kodieren müssen. Arbeiten Sie sie in dieser Reihenfolge durch, und der größte Teil der scheinbaren Freiheit im Restkatalog verschwindet.
Es dominieren zwei Plattformen. Der Methanocaldococcus jannaschii Das TyrRS/tRNA^Tyr-Paar akzeptiert Tyrosin-ähnliche und aromatische Seitenketten. Das Pyrrolysyl-tRNA-Synthetase-Gerüst und seine entwickelten Varianten nehmen lysinähnliche und sperrige Reste an, und tolerieren mehr strukturelle Vielfalt. Beachten Sie, dass RF1-Knockout eine Host-Strategie ist, die die Unterdrückungseffizienz erhöht, kein drittes Paar.
|
Dienstleistungen Besonderheit |
M. jannaschii TyrRS/tRNA^Tyr |
PylRS/tRNA^Pyl-Varianten |
|---|---|---|
|
Substratumfang |
Tyrosinartig, aromatisch |
Lysinartig, sperrig, strukturell vielfältig |
|
Codon-Strategie |
Bernstein (UAG) Unterdrückung |
Bernstein, Ocker, oder Sense-Codon-Neuzuordnung |
|
Host-Kompatibilität |
E. coli, Hefe, Säugetierzellen |
E. coli, Säugetierzellen, zellfreie Systeme |
|
Multiplex-Eignung |
Beschränkt; überlappende Substrattoleranz |
Besser geeignet für die orthogonale Paarerweiterung |
Beim Multiplexen bewegt sich das Feld. A 2024 Codon-Kompressionsstrategie identifiziert 12 zueinander orthogonale tRNA-Synthetase-Paare, die mit dem bekannten GCE-Ressourcensatz kompatibel sind, Dies ist wichtig, wenn Ihr Design zwei oder mehr unterschiedliche NCAAs in einer Kette benötigt.
Dann gibt es die Grenze zwischen dem, was ein Ribosom installieren kann, und dem, was nur SPPS kann. Seitenkettenmodifikationen an einem α-Aminosäurerückgrat sind GCE-kompatibel. β-Aminosäuren, A,α-disubstituierte Reste, in Depsipeptiden, und viele N-methylierte Reste sind es nicht; Sie sind nur SPPS oder nur In-vitro-Tests. Wenn Ihr Zielrest auf dieser Liste steht, Keine Paarauswahl wird es retten.
Unterdrückungseffizienz mal ehrlich lesen
Die Unterdrückungseffizienz liegt in einem Bereich, und die Reichweite hat nur dann eine Bedeutung, wenn man die Sorte und den Reporter angibt. Frühere Systeme lieferten etwa 10–20 % für ein einzelnes Amber-Codon. Optimierte und weiterentwickelte Systeme erreichen je nach Kontext 50–117 %, und 76–104 % im RF1-deletierten C321-Stamm. Diese Figuren beschreiben unterschiedliche Konstrukte, Es handelt sich also nicht um eine Leiter, die man erklimmen kann, indem man die höchste Zahl wählt.
Die Integrationseffizienz ist auch nicht die gleiche Messgröße wie das nahezu verwandte Readthrough. Das Durchlesen läuft ungefähr 1% in den Top10, um 3% in BL21, und bis zu 17% im MG1655, so hoch reichend wie 47.5% an einem bestimmten Amber-Standort in einem RF1-gelöschten Hintergrund. Man misst, wie viel NCAA Sie installieren; Der andere misst, wie viele falsche Aminosäuren Sie daneben installieren.
Die praktische Konsequenz: eine Angabe, die nur einen Prozentsatz angibt, ohne Nennung der Sorte und des Reporters, ist keine Spezifikation. Fragen Sie nach beidem, bevor Sie eine Effizienzzahl akzeptieren.
Entwerfen von Peptidbibliotheken mit nichtkanonischen Aminosäuren
Sobald das Paar fixiert ist, Die von Ihnen gewählte Anzeigeplattform legt die Obergrenze dafür fest, welche nichtkanonischen Aminosäuren Ihre Bibliothek überhaupt enthalten kann. mRNA-Display und RaPID haben die höchste ncAA-Toleranz, da der gesamte Zyklus in vitro abläuft: Flexizym lädt die tRNA direkt auf, Daher muss das Ribosom niemals mit einer Wirtssynthetase konkurrieren, und rückgratmodifizierte Reste bleiben im Spiel. Die Darstellung von Ribosomen hat einen hohen Stellenwert, ist aber systemabhängig, da sich die Toleranz mit dem Lysat und der Einstellung des Freisetzungsfaktors verschiebt. Das Phagen-Display bleibt praktikabel, weil Phagen-Display nichtkanonische Reste über Amber-kodierende Helferphagen transportieren kann, Die Wirtsmaschinerie bestimmt jedoch, welche Rückstände überleben. Die Hefepräsentation ist die am stärksten eingeschränkte der vier.
Die Position ist genauso wichtig wie die Plattform. Die positionelle Diversifizierung im Vergleich zur globalen NCAA-Diversifizierung teilt den Designraum auf: Einzelne oder wenige definierte Stellen passen zu einer mechanistischen Sonde oder einem Konjugationsgriff und bleiben leicht zu charakterisieren, während die pervasive Substitution für Stabilitäts- oder Proteaseresistenztests geeignet ist und es weitaus schwieriger ist, Rückstand für Rückstand zu überprüfen.
Wo Bibliotheksdesign auf Routenauswahl trifft
Eine Bibliothek, die um einen rückgratmodifizierten Rest herum aufgebaut ist, kann überhaupt nicht durch Erweiterung des genetischen Codes erzeugt werden, Daher müssen die Anzeigeentscheidung und die Produktionsentscheidung gemeinsam und nicht nacheinander getroffen werden. Die Stabilitätsauszahlung ist es, die diese Einschränkung akzeptierenswert macht. In einer Inhibitorserie, zyklische β2,3-Reste verlängerten die Serumhalbwertszeit 168 Stunden um 37 °C im menschlichen Serum, gegen 4.6 Stunden für die entsprechende Alaninvariante; ein zweites Gerüst im gleichen Werk erreicht 48 Stunden vs Geschäft 4.2 Std.. N-Methylierung verlängerte die Proteinase-K-Stabilität von 6 Minuten bis ungefähr 110 Minuten in seinem eigenen Test, und D-Aminosäure-Substitutionen verlängerten bei ihnen die Halbwertszeit von Minuten auf Stunden. Keine dieser Zahlen lässt sich auf Peptide als Klasse verallgemeinern: jedes gehört zu seinem eigenen Gerüst und Assay. Die praktische Konsequenz ist eng und fest. Wenn Ihr Stabilitätsziel eine Backbone-Modifikation erfordert, Die Route wird für Sie ausgewählt, und die Bibliothek muss von Anfang an innerhalb dieser Grenze konzipiert werden.
Standortspezifische Konjugationsstrategien, die durch erweiterte Codes ermöglicht werden
Diese Routenentscheidung wird direkt in die Konjugation übernommen, wobei ein NCAA-Handle eine Positionskontrolle erwirbt, mit der kein kanonischer Rest mithalten kann, und es ändert den Fehlermodus, anstatt Fehler zu beseitigen. Ein bioorthogonaler Griff, der an einer definierten Position installiert ist, bietet die höchste Positionskontrolle und die geringste Off-Target-Belastung aller ortsspezifischen Peptidkonjugationsstrategien, Aber der Fehler, den Sie dann bewältigen, ist ein unvollständiger Einbau oder nicht umgesetztes Ausgangsmaterial, keine Fehlausrichtung. Cystein ist chemoselektiv und billig, noch Überalkylierung, Oxidation und Disulfidbindung sind Routine. Durch Lysinkupplung entstehen Regioisomerengemische. Die N-terminale Chemie verbessert sich gegenüber Lysin, die Sequenz bleibt jedoch erhalten- und kontextabhängig.
|
Chemie |
Selektivität |
Kinetik |
Kupfer |
Fehlermodus, den es erzeugt |
|---|---|---|---|---|
|
SPAAC (Azid + Cyclooctin) |
Hoch |
Mäßig |
Nicht erforderlich |
Nicht umgesetzter Azidgriff |
|
CuAAC (Azid + Alkin) |
Hoch |
Schnell |
Erforderlich |
Kupfervermittelte Nebenreaktionen |
|
Tetrazin-TCO |
Peptidsynthese Hoch |
Am schnellsten |
Nicht erforderlich |
Hydrolysiertes Tetrazin |
|
Elektrophile ncAA-Zyklisierung |
Hoch, wenn die Geometrie vororganisiert ist |
Intramolekular |
Nicht erforderlich |
Konkurrierendes intermolekulares Produkt |
Die Speisekarte ist kurz. SPAAC ist kupferfrei und einfach zu bedienen; CuAAC ist am robustesten, aber die Kupferempfindlichkeit ist die Gefahr; Tetrazin-TCO markiert am schnellsten; und die elektrophile NCAA-Cyclisierung erfolgt intramolekular und sauber, wenn die Geometrie vororganisiert ist, wie berichtet für Doppelt bioorthogonale NCAA-Griffe (Naturkommunikation, 2023).
Wahl zwischen bioorthogonaler Konjugation und nativer chemischer Ligation
Native chemische Ligation und ncAA-Konjugation lösen unterschiedliche Probleme und sind kein Ersatz. NCL ist die Route, wenn das Ziel eine Backbone-Änderung erfordert, ein D-Rest, oder ein Segment, das kein orthogonales Paar auflädt; Seine Voraussetzung ist eine funktionsfähige Ligationsverbindung und ein Thioestersegment. Die ncAA-Konjugation ist der Weg, wenn das Ziel ein Standard-α-Rückgratpeptid ist, das einen definierten Bindungspunkt benötigt, und seine Voraussetzung ist ein Paar, dessen Substratbereich das Handle plus einen Host oder Extrakt akzeptiert, der das konkurrierende kanonische Durchlesen unterdrückt.
Die praktische Konsequenz: Treffen Sie die Konjugationsentscheidung gleichzeitig mit der NCAA-Entscheidung. Ein Griff, den das ausgewählte Paar nicht erfordert, ist eine Neugestaltung, kein Ersatz.
Analytische Kontrollen, die die Sequenztreue beweisen
Für welche Konjugationsroute Sie sich auch entscheiden, Das Kontrollpaket wandelt einen Syntheseanspruch in eine vertretbare Spezifikation um, und es muss entworfen werden, bevor das erste Los hergestellt wird, nach einer Abweichung nicht zusammengebaut. Für jedes Peptid, das einen nichtkanonischen Rest trägt, Die analytischen Kontrollen der Sequenztreue basieren auf fünf Elementen: Genaue Massenbestätigung des intakten Peptids plus sequenzlokalisierender Fragmentionen, die den modifizierten Rest überspannen, durch LC-MS/MS; Quantifizierung der Einbaueffizienz, Gemeint ist der Anteil des Peptids, das die ncAA trägt, im Vergleich zu kanonischen Fehlinkorporationen oder unmarkiertem Produkt; eine Diastereomer/Epimer-Kontrolle gegen eine synthetische Referenz oder eine orthogonale Chiral- oder Retentionszeitmethode, weil Standard-LC-MS Epimere oft nicht unterscheiden kann; Validierung des orthogonalen Translationssystems mit Negativkontrollen und keinem erkennbaren Off-Target-Readthrough; Und, für elementmarkierte ncAAs wie Selen- oder Borvarianten, Aminosäureanalyse oder ICP-MS (2026 Übersicht über Präzisionsbiokonjugation und ortsspezifischen Einbau, abgerufen 2026-02-04).
Festlegung von Abnahmekriterien vor dem ersten Los
Jedes Steuerelement wird nur dann nützlich, wenn es eine Nummer trägt. Binden Sie die Massengenauigkeit an den zu bestätigenden Rückstand, Binden Sie den Schwellenwert für die Einbaueffizienz an das Auflösungsvermögen des Assays, der ihn misst, und erfordern, dass die Epimer-Kontrolle den Referenzstandard benennt, mit dem sie vergleicht. Wobei das Peptid ein parenteraler Kandidat ist, Der Arzneibuch-Grenzwert ist dosisabhängig: USP <85> legt den Endotoxingrenzwert = K/M fest, mit K = 5 EU/kg/Stunde für nicht-intrathekale Wege und K = 0.2 EU/kg/Stunde intrathekal, ausgedrückt pro mg oder pro ml der maximalen menschlichen Dosis. ICH Q2(R2) legt die Validierungsparameter fest, und die MHRA ALCOA-Prinzipien rahmen die Erwartungen an die Datenintegrität ein.
Eine Kontrolle, die nicht vor dem ersten Los in die Spezifikation aufgenommen wird, ist eine Kontrolle, über die Sie nach einer Abweichung verhandeln werden.
Scale-Up: SPSS, CFPS und Lot-to-Lot-Treuerisiko
Diese Kontrollen müssen dann die Skalierung überstehen, denn die Route, die Ihre Forschungscharge produziert hat, ist nicht automatisch die Route, die Ihre klinische Charge produziert, und das Treuerisikoprofil ändert sich damit. Die Festphasenpeptidsynthese erfolgt mit Milligramm bis Gramm pro Charge, mit präparativen und industriellen Arbeitsabläufen, die Dutzende bis Hunderte Gramm erreichen, und einige Sequenzen im Kilogrammmaßstab. Zellfreie Systeme liefern typischerweise mg pro Liter: um 96 ± 3 mg/L für einen Proteinträger 40 identische nichtkanonische Aminosäuren, während ein optimierter RF1-defizienter Extrakt ungefähr erreichte 1,780 ± 30 mg/L für sfGFP (Literatur zum Einbau zellfreier ncAA, 2020). Der Größenunterschied zwischen zellfreien und Festphasenrouten ist real, und es prägt, welche Treuerisiken in jeder Phase dominieren.
Aus dieser Aufteilung ergeben sich zwei Los-zu-Los-Risiken. Unter Bernsteinunterdrückung, Kürzungs- und Durchleseprodukte variieren je nach Hoststaat, Daher kann sich das Verunreinigungsprofil zwischen den Fermentationsläufen verschieben, selbst wenn die Zielbande unverändert aussieht. Unter Sense-Codon-Neuzuordnung, Das nichtkanonische/kanonische Verhältnis kann schwanken, während der Gesamtertrag unverändert bleibt, Das bedeutet, dass ein Release-Test, der nur auf die Ausbeute beschränkt ist, es nicht erkennt.
Die praktische Konsequenz: Die Wiedergabetreuekontrollen aus dem vorherigen Abschnitt gehören in die Freigabespezifikation für jedes Los, nicht nur im Qualifikationsbatch.
Was Sie einen Partner fragen sollten, bevor Sie sich verpflichten
Nehmen Sie sechs Fragen in das Gespräch auf. Welche nichtkanonische Aminosäure und welches orthogonale Paar? Welche Codon-Strategie, Amber-Unterdrückung oder Sense-Codon-Neuzuordnung? Welcher Wirt oder zellfreier Extrakt, und wie hoch ist die dokumentierte Unterdrückungsleistung?? Welcher Konjugationsweg, und bewahrt es die eingearbeiteten Rückstände?? Welche der fünf Wiedergabetreuekontrollen auf jedem Grundstück ausgeführt werden? Und welche Akzeptanzkriterien definieren ein Durchgangslos, bevor das erste hergestellt wird??
Ein strukturierter Design-to-QC-Workflow unterstützt dies. MOL-Änderungen können verwendet werden, um die NCAA-Auswahl anzupassen, Syntheseroute und analytische Freigabekriterien in einer Übergabe, Daher handelt es sich bei den in der Entwurfsphase vereinbarten Kontrollen um die Kontrollen, die maßstabsgetreu ausgeführt werden. Fordern Sie schriftlich das Control Panel auf Losebene an, und vergleichen Sie es mit Ihrer eigenen Spezifikation, bevor Sie es festlegen.
Häufige Missverständnisse über erweiterte genetische Codes
Vier Fehler tauchen in Programmrezensionen so oft auf, dass es sich lohnt, sie direkt zu benennen.
Erstens bedeutet ein erweiterter genetischer Code ein neu geschriebenes Genom. In der Praxis bedeutet es normalerweise ein neu zugewiesenes Codon und ein orthogonales Paar, einem Host hinzugefügt, der ansonsten unverändert bleibt.
Zweitens bedeutet eine höhere Einarbeitungseffizienz eine höhere Reinheit. Die beiden können sich in entgegengesetzte Richtungen bewegen: Die Neuzuordnung von Sense-Codons kann die Ausbeute halten, während die Reinheit sinkt, weil das neu zugewiesene Codon nun sowohl für nahezu verwandte tRNAs als auch für das orthogonale Paar verfügbar ist.
Drittens kann jede nichtkanonische Aminosäure in jeden Produktionsweg integriert werden. Die Rückgrat-Modifikationsaufteilung ist eine harte Grenze, keine Präferenz: Rückstände, die das Rückgrat verändern, können nicht durch ribosomalen Einbau eingebaut werden, und Reste, die das Ribosom erfordern, können nicht durch SPPS hergestellt werden.
Der vierte betrifft Release-Tests.
⚠️ Warnung: Eine einzelne intakte Masse bestätigt die Sequenz nicht. Ohne Fragmentionen, die den modifizierten Rest überspannen, ein Epimer oder ein Fehleinbau an einer nahegelegenen Position kann die gleiche Spezifikation erfüllen.
Wohin die Toolbox geht
Nachdem diese Missverständnisse ausgeräumt sind, Die Richtung geht dahin, mehr Code auf einmal zu verwenden. Frühe Arbeiten stützten sich auf ein einzelnes orthogonales Paar, Neuere Systeme haben gezeigt, dass zueinander orthogonale Paare, die zusammen verwendet werden, in derselben Zelle arbeiten können, Deshalb ist der Einbau verschiedener nichtkanonischer Aminosäuren an mehreren Stellen eher eine Entwurfsoption als ein Gedankenexperiment.
Eine zweite Schicht ist architektonischer Natur. Das Interesse hat sich in Richtung zellfreier und extraktbasierter Systeme verlagert, die eine dauerhafte Veränderung des Wirtsgenoms vermeiden, Dies verkürzt den Zyklus zwischen dem Entwerfen eines Konstrukts und dem Testen. Daneben, Die Vier-Nukleotid-Codon-Arbeit erweitert den verfügbaren Codon-Raum über den Standard hinaus 64, Erweiterung des Raums für Neuzuweisungen.
Der ehrliche Vorbehalt bleibt unverändert: Die Unterdrückungseffizienz bleibt ncAA- und sequenzkontextabhängig, und nicht jede nichtkanonische Aminosäure ist mit jedem Weg kompatibel. Deshalb ist der Bewertungsrahmen in Synthetische Peptide diesen Leitfaden, und nicht auf ein bestimmtes Paar oder eine bestimmte Plattform, ist der Teil, den es wert ist, behalten zu werden?: Erweiterte genetische Codes für individuelles Peptiddesign werden sich ständig ändern, aber die Kontrollen, die beweisen, was Sie gebaut haben, werden es nicht tun.
Nächste Schritte
Bringen Sie eine bestimmte Sequenz und eine bestimmte Genauigkeitsanforderung in das erste technische Gespräch über erweiterte genetische Codes für individuelles Peptiddesign ein, keine allgemeine Anfrage. Die folgende Bewertungscheckliste wandelt den vierteiligen Rahmen dieses Leitfadens in Fragen um, die ein Partner ohne Absicherung beantworten sollte:
-
Welches orthogonale Paar, und welche Unterdrückungseffizienz dafür in Ihrem Expressionshost beobachtet wurde?
-
Welche Codon-Strategie: Bernsteinunterdrückung, Sense-Codon-Neuzuordnung, oder ein Quadruplett-Codon?
-
Welche Route für diese Sequenz: SPSS, zellfreie Synthese, oder Gärung, und warum das??
-
Welche Konjugationschemie, und bleibt es orthogonal zu den Resten, die sich bereits in der Kette befinden??
-
Welche der fünf Sequenztreue-Analysekontrollen werden pro Charge durchgeführt?, und was sind die Akzeptanzkriterien?
Ein Partner, der alle fünf beantworten kann, und sagen Sie deutlich, wo eine bestimmte NCAA oder Route nicht funktionieren wird, ist mehr wert als ein niedrigeres Angebot. MOL Changes unterstützt diese Art der Konversation vom Design bis zur Qualitätskontrolle 300+ Funktionsgruppen, SPPS und mikrobielle Fermentation, mg-zu-kg-Skala, und HPLC/MS und Sterilitäts-QC unter Klasse 100 Reinraumbedingungen.
Offenlegung: MOL Changes ist der Sponsor dieses Leitfadens. Die oben genannten Rahmen- und Bewertungskriterien dienen Forschungs- und Vergleichszwecken. Um
Häufig gestellte Fragen
Was ist ein erweiterter genetischer Code??
Ein erweiterter genetischer Code ist ein Übersetzungssystem, bei dem ein oder mehrere Codons neu zugewiesen wurden, um eine nichtkanonische Aminosäure anstelle der Standardaminosäure zu spezifizieren. Die Neuzuweisung ist eher zielgerichtet als global: Es werden eine orthogonale tRNA und ihr Aminoacyl-tRNA-Synthetase-Paar eingeführt, sodass die Synthetase nur die entsprechende manipulierte tRNA auflädt, Die eigene Übersetzungsmaschinerie des Gastgebers bleibt unberührt. Im Standard-64-Codon-Rahmen, Dadurch bleibt Raum für die Installation einer neuen chemischen Funktion an einer ausgewählten Position, ohne den Rest des Proteoms neu zu schreiben.
Wie viele nichtkanonische Aminosäuren können genetisch kodiert werden??
A 2025 Nach einer Schätzung liegt die Zahl der genetisch kodierbaren nichtkanonischen Aminosäuren bei über 300, Allerdings beschreibt diese Zahl eher die kumulative Toolbox des Bereichs als das, was ein einzelnes System leisten kann. Die praktische Zahl ist weitaus geringer, weil jede ncAA ein kompatibles orthogonales Paar und einen Host benötigt, der die Neuzuweisung toleriert. Behandeln Sie die Schlagzeilenzahl als Obergrenze für das, was irgendwo demonstriert wurde, nicht als Menü, bei dem Sie bestellen können.
Was ist der Unterschied zwischen Amber-Unterdrückung und Sense-Codon-Neuzuweisung??
Die Amber-Unterdrückung liest das UAG-Stoppcodon durch und konkurriert direkt mit dem Freisetzungsfaktor 1, Daher ist sein charakteristischer Fehlermodus das abgeschnittene Produkt. Bei der Sense-Codon-Neuzuweisung wird ein Codon ausgetauscht, das normalerweise einen Standardrest kodiert, sein Ausfallmodus ist also eine gemischte Population: Die Ausbeute kann hoch bleiben, während die Reinheit sinkt, weil der Wildtyp-Rest immer noch neben der ncAA eingebaut ist. Dieser Unterschied bestimmt, welche Steuerelemente Sie benötigen, da die Kürzung in der intakten Masse auftritt, während dies bei einer Fehlübersetzung nicht der Fall ist.
Welche nichtkanonischen Aminosäuren können durch SPPS statt durch Erweiterung des genetischen Codes hergestellt werden??
β-Aminosäuren, A,α-disubstituierte Reste, Depsipeptidbindungen und viele N-methylierte Reste sind normalerweise nur durch Festphasensynthese oder In-vitro-Chemie zugänglich, weil das Ribosom sie nicht als Substrat akzeptiert. Die genetisch kodierbare Klasse ist enger: Seitenkettenmodifikationen, die auf einem α-Aminosäurerückgrat aufgebaut sind. Selenocystein ist die natürliche Ausnahme, Es wird nicht durch ein konstruiertes Paar, sondern durch eine eigene Maschine codiert. Peptidproduktion
Wie bestätigen Sie, dass an der vorgesehenen Stelle eine nichtkanonische Aminosäure eingebaut wurde??
Zur Bestätigung sind eine exakte Masse und sequenzlokalisierende Fragmentionen erforderlich, die den modifizierten Rest überspannen, typischerweise durch LC-MS/MS, zusammen mit einer Quantifizierung der Einbaueffizienz und einer Epimerkontrolle gegenüber einer synthetischen Referenz. Die intakte Masse allein reicht nicht aus, da sie die beabsichtigte Stelle nicht von einem Positionsisomer oder einer Deletionsvariante ähnlicher Masse unterscheiden kann. Die Fragmentionen lokalisieren den Rückstand; Die Masse sagt einem nur, dass sich etwas geändert hat.
Können nichtkanonische Aminosäuren an mehr als einer Stelle eingebaut werden??
Ja, Die Einbindung mehrerer Standorte vervielfacht jedoch den analytischen Aufwand, anstatt einfach nur einen Arbeitsablauf für einen einzelnen Standort zu wiederholen. Jede zusätzliche Position fügt ihr eigenes Unterdrückungs- oder Neuzuweisungsereignis hinzu, und der Anteil des Produkts, das die NCAA an jedem vorgesehenen Standort trägt, sinkt mit der Anhäufung von Positionen, so wird die Population zu einer Verteilung teilweise veränderter Arten. Sie müssen im Voraus entscheiden, ob der Assay diese Verteilung auflöst, weil eine Methode, die für eine Site validiert wurde, nicht automatisch über vier Sites berichtet.
Ist die Erweiterung des genetischen Codes für die Peptidproduktion im klinischen Stadium skalierbar??
Die Skalierbarkeit hängt davon ab, welche Route Sie wählen, und die beiden Routen schlagen unterschiedlich fehl. Die zellfreie Proteinsynthese hat Ausbeuten in den zuvor in diesem Artikel genannten Bereichen gezeigt, Diese Zahlen stammen jedoch aus definierten Versuchssystemen und lassen sich nicht automatisch auf einen GMP-Prozess übertragen. Die Festphasensynthese lässt sich für kürzere Sequenzen vorhersagbarer skalieren, kann jedoch nicht die Reste erreichen, die nur SPPS sind. Für Arbeiten im klinischen Stadium, Die praktische Frage ist nicht, ob sich die Chemie skalieren lässt, sondern ob Ihr Analysepaket in diesem Maßstab die Sequenztreue von Charge zu Charge nachweisen kann.
Abschluss
Die von Ihnen gewählte Codon-Strategie bestimmt den Fehlermodus, den Sie erben, Daher muss das Kontrollpaket, das die Sequenztreue nachweist, vor dem ersten Los angegeben werden, nicht danach. Das ist der rote Faden, der sich durch diesen Leitfaden zieht: expanded genetic codes for custom peptide design are an evaluation problem before they are a synthesis problem.
The four decisions a partner must be able to defend in writing are the noncanonical amino acid and its suppression behavior in your sequence context, the library design and how it constrains the route, the conjugation chemistry and what it leaves intact, and the analytical acceptance criteria with their methods and limits. Each one narrows the next.
The direction of travel is toward mutually orthogonal pairs used together, cell-free and extract-based systems that leave the host genome untouched, and four-nucleotide codons that extend the available codon space past the standard 64. The honest caveat is that suppression efficiency stays dependent on the ncAA and the surrounding sequence, Und nicht jede NCAA ist mit jeder Route kompatibel.
Nutzen Sie die Checkliste in „Nächste Schritte“ als Grundlage für Ihr erstes technisches Gespräch.
Über den Autor: [Name des Autors], [Anmeldeinformationen], schreibt über Peptiddesign und analytische Kontrollstrategie für MOL Changes.
Offenlegung: MOL Changes bietet Peptiddesign, Synthese- und Analysedienstleistungen, einschließlich der in diesem Handbuch besprochenen Funktionen.