Mitä peptiditietojen työnkulku AI-lääkkeiden löytämiseen todella vaatii
Tekoälylääketutkimuksen peptiditietotyönkulut ovat kirjaamista, analyyttinen, ja hallintokäytännöt, jotka tekevät peptiditietojoukosta konekäyttöisen ennustavan mallin avulla. Ne kattavat viisi aluetta: sekvenssi- ja muutostietueet, määrityksen konteksti, epäpuhtaustiedot, erän historia, ja standardoidut analyysitulokset. Se erottaa ne yleisistä datavalmiusneuvoista, että jokainen vaatimus laskeutuu yksittäisen tietuekentän tasolle, ja jokaisen on kestettävä sekä luottamuksellisuustarkistus että dokumentoitu validointiprotokolla.
Ennätystason palkki on se osa, jonka useimmat joukkueet aliarvioivat. Peptidirakenteen merkinnän viitekäsittelyn mukaan koneoppivat putkilinjat toimivat parhaiten häviöttömästä kemiallisesta esityksestä ensisijaisena tietueena., mallikohtaisilla koodauksilla, jotka on johdettu siitä mieluummin kuin tallennettu totuuden lähteeksi (Peptidirakenteiden huomautus SMILES- ja muiden kemiallisten koodien avulla, 2017). Siinä lähestymistavassa, InChIKey toimii identiteetti- ja duplikointiavaimena, kun taas syklisointi ja ristilinkit on kirjoitettava eksplisiittisinä yhteysobjekteina implisiittisten sijaan.
Säätäjät ovat menossa samaan suuntaan. FDA:n tammikuu 2025 luonnos ohjeista tekoälystä sääntelyn päätöksenteossa ottaa käyttöön riskiin perustuvan uskottavuuden arvioinnin, joka on sidottu määriteltyyn käyttökontekstiin (FDA:n ohjeluonnos, sisältö ajankohtainen 2025-01-06). Se on luonnos, ei täytäntöönpanoa varten, mutta se merkitsee, että tekoälyvalmiita peptiditietosarjoja arvioidaan jäljitettävyyden eikä tilavuuden perusteella.
Key Takeaway: Kolme asiaa erottaa nämä työnkulut tavallisesta tietojen puhdistamisesta: kenttätason tietuevaatimukset, luottamuksellisuusmekaniikka, jonka avulla kumppanit voivat jakaa johtoaan paljastamatta, ja toiminnallinen validointiprotokolla ilmaistun periaatteen sijaan.
Suurin osa hämmennystä aiheuttaa kaksi väärinkäsitystä. "Puhdas data" ei tarkoita "kuroitua dataa", siisti laskentataulukko voi silti olla mallin käyttökelvoton. Ja yksi puhtausluku ei kuvaa peptidiä; epäpuhtaus- ja erähistoriatiedot sisältävät tietoja, joista malli voi todella oppia. Tämä osio hyödyntää vertaisarvioitua rakennemerkintäkirjallisuutta ja voimassa olevia sääntelyohjeita, ilman myyjälähteitä.
Miksi tekoälyn huumeiden löytämisen peptiditietojen työnkulut ovat tärkeitä nyt
Tekoälylääketutkimuksen peptiditietojen työnkuluilla on merkitystä, koska rahat liikkuvat nyt ennen dataa. Vuonna 2026 VLS Researchin julkaisema AI-kaupan seuranta, julkistettu etukäteisklusteri on 30–50 miljoonaa dollaria, kun otsikkoarvot ovat yli 1 miljardia dollaria, noin 2–3 % otsikkoarvosta maksetaan käteisenä (VLS tutkimus, AI Drug Discovery Deal Tracker 2026, haettu 2026-07-03). Isomorphic Labs – Eli Lilly näyttää noin 45 miljoonaa dollaria etukäteen, kun yli 1,7 miljardia dollaria virstanpylväissä; Noetik-GSK näyttää 50 miljoonaa dollaria etukäteen viiden vuoden lisenssirakenteesta. Huomaa lähde: yksi analyytikkoseuranta, myyjä on kiinnostunut tekoälykaupan tarinasta.
Kliininen ennätys on vastapaino. Noin 90% Klinikalle saapuvat molekyylit eivät koskaan saa hyväksyntää, ja 50–60 % vaiheen II epäonnistumisista johtuu tehon puutteesta, luvut, jotka ovat hädin tuskin liikkuneet kahteen vuosikymmeneen (Mao Z & Yan L, Farmakologian rajat, haettu 2026-07-03). Sama 2024 järjestelmällinen tarkastelu 20 AI-ohjatut ohjelmat alkaen 2018 to 2023 todettiin, että tekoälyavusteinen liidien optimointi lyhensi ehdokkaiden seulonta-aikaa keskimäärin 30–50 %, kun taas vaiheen I/II poistuminen pysyi verrattavissa alan vertailuarvoihin.
Se aukko on se pointti. Kumppanit voivat nyt allekirjoittaa mallin, mutta malli ei voi oppia tietueista, jotka eivät koskaan saaneet peptidiä.
Tämä vaikuttaa R&D johtaa, analyyttinen kemia, data ja IT, ja allianssin johtajat, jotka perivät huolellisuuskysymykset allekirjoituksen jälkeen.
Tekoälyvalmiiden peptiditietosarjojen viisi tietopilaria
Tekoälyvalmiit peptiditietojoukot on rakennettu viidestä ennätystason pilarista, ja yhdessä ne muodostavat valmiuden tarkistuslistan, jota vastaan joukkue voi arvostella ennen kumppanuussopimuksen allekirjoittamista. Jokainen alla oleva pilari on kirjoitettu samalla tavalla: miksi sillä on väliä, miten se toteutetaan, ja miltä epäonnistuminen näyttää, kun se puuttuu. Määräys on tahallinen. Identiteetti tulee ensin, koska jokainen alavirran kenttä, määrityskontekstista epäpuhtausprofiiliin, perii moniselitteisen rakennetietueen virheet. Väärin määritellylle sekvenssille koulutettu malli ei petä äänekkäästi; se oppii väärän molekyylin ja raportoi siitä luotettavia ennusteita.
Pistele jokainen pilari rehellisesti. Tiimi, joka voi rekonstruoida jokaisen peptidin omista tietueistaan, liitä määritysehdot jokaiseen tulokseen, ja jäljittää jokainen erä analyysitodistukseen, joka on valmis luovuttamaan tiedot kumppanille. Ryhmää, joka ei voi, ei estetä yhteistyöstä, mutta sen pitäisi odottaa, että yhteistyön ensimmäiset kuukaudet käytetään tietojen korjaamiseen mallikoulutuksen sijaan.
Pillerit 1: Yksiselitteiset sekvenssi- ja muutostietueet
Peptidisekvenssi- ja modifiointitietueilla on merkitystä, koska malli ei voi oppia peptidistä, jota se ei voi rekonstruoida, ja identiteettivirheet etenevät äänettömästi jokaisen alavirran ennusteen läpi. Korjaus on häviötön kemiallinen esitys ensisijaisena tietueena, mallikohtaisilla koodauksilla, jotka on johdettu siitä mieluummin kuin tallennettu totuuden lähteeksi.
Toteutus noudattaa pientä käytäntöä. HELM käsittelee polymeeritietoisia rakenteita, mukaan lukien oksat ja ei-luonnolliset monomeerit, kun taas SMILES palvelee atomitason graafimalleja. InChI ja InChIKey toimivat duplikoinnin ja identiteettiavaimina eri järjestelmissä. Syklisointi ja ristisidokset kuuluvat eksplisiittisiin yhteysobjekteihin, ei koskaan implisiittisenä oletuksena, että "syklisoitu" tarkoittaa samaa kaikkialla. Peptidirakenteen merkinnän viitekäsittely kattaa loput: monikirjaiminen koodit ei-proteiinille tai ei-luonnollisille jäämille, Pienet kirjaimet D-aminohapoille, ja jäännöstason muutosmerkintä MAP-muodossa (Journal of Cheminformmatics / PMC).
Vikatila on hiljainen ja kallis. Ohjelma tallentaa laktaomisillan ja disulfidin "syklisoituneiksi" samassa kentässä, joten malli käsittelee kahta kemiallisesti erillistä rakennustelinettä yhtenä. Jokainen tähän sarakkeeseen rakennettu ennuste on saastunut, eikä mikään valmisteilla ole merkkinä siitä.
Mallissa käytettävä tietue modifioidulle makrosykliselle peptidille sisältää alla olevan kentän. MOL Changes tukee tätä rakenne-ensisijaista lähestymistapaa peptiditietotyössään, ja esimerkki on replikoitavissa millä tahansa yhteensopivalla tietuejärjestelmällä.
|
Ala |
Mallikäyttöinen tietue |
Tyypillinen vapaatekstitietue |
|---|---|---|
|
Ensisijainen edustus |
HELM-merkkijono, jossa on eksplisiittisiä yhteysobjekteja |
Jakso liitetty muistiinpanokenttään |
|
Atom-tason koodaus |
SMILES on johdettu HELM-tietueesta |
Poissa |
|
Peptidisynteesi Identiteettiavain |
InChIKey duplikoinnin poistamiseen |
Poissa |
|
Ei-luonnollinen Synteettiset peptidit jäämiä |
Monikirjaimia koodeja, määritelty monomeeritaulukossa |
Yhden kirjaimen likiarvot |
|
Stereokemia |
Pienet kirjaimet D-aminohappomerkinnät |
Ei tallennettu |
|
Muutokset |
Jäännöstason MAP-merkintä |
Vapaatekstinen huomautus, esim. "pyöräilty" |
|
Pyöräilyn tyyppi |
Selkeä siltaobjekti paikoilla |
Epäselvä |
|
Palvelut Ristilinkit |
Eksplisiittinen yhteysobjekti |
Poissa tai epäsuorasti |
Pillerit 2: Analyysikonteksti, joka kulkee tuloksen mukana
Sitoutumisaffiniteetti ilman sen määritysolosuhteita ei ole harjoitusleima, se on numero. Määrityskontekstin täytyy kulkea tuloksen mukana: määritystyyppi, kohderakenne ja laji, lukumuoto, ja onko arvo mitattu vai ennustettu.
Mitattu verrattuna ennustettuun eroon useimmat tietojoukot katkeavat hiljaa. A 2025 epitooppien ennustajien järjestelmällinen tarkastelu havaitsi, että vain 174 / 777 (22%) laskennallisesti ennustettujen HLA:ta sitovien peptidien vahvistettiin yhdessä SARS-CoV-2-tutkimuksessa sitoutuvan vakaasti in vitro (npj Rokotteet, 2025-08-30). Tämä luku koskee yhtä tutkimusta, ei yleinen tarkkuusaste AI:lle immunologiassa, mutta se osoittaa, miksi ennustettu arvo ja mitattu arvo eivät voi jakaa saraketta ilman lippua, joka erottaa ne.
⚠️ Varoitus: SPR:n yhdistäminen, fluoresenssipolarisaatio ja solupohjaiset arvot yhteen affiniteettipylvääseen harjoittavat mallia määrityksessä kemian sijaan. Malli oppii, mikä laboratorio on luonut luvun, ei mikä peptidi sitoutuu.
Pillerit 3: Epäpuhtausprofiilit, Ei yksittäinen puhtausnumero
Peptidiepäpuhtaus- ja erähistoriatiedot kuuluvat tietueeseen profiilina, ei otsikkoprosenttia. Kaksi erää raportoitu klo 98% pure voi käyttäytyä eri tavalla määrityksessä, ja malli tarvitsee epäpuhtausverhon ja vastaionitilan nähdäkseen miksi.
Vastavaikutukset on dokumentoitu hyvin. Vuonna a 2025 arvostelu, M33-peptidi TFA-suolana osoitti 5–30 % suurempaa sytotoksisuutta normaaleja keuhkoputkien epiteelisoluja kohtaan kuin asetaattivastine, ja TFA:n kanssa formuloitu MOG-peptidi liittyi karkeasti enkefalomyeliitin puhkeamiseen 5 päivää aikaisemmin vertailukelpoisella esiintymistiheydellä ja vakavuusasteella (Biomolekyylit, 2025-11-07). Erillisessä katsauksessa havaittiin, että kloridi oli testatuista anioneista vähiten tehokas indusoimaan kierukkarakennetta LL-37:ssä (Farmaseuttiset tuotteet / Molekyylit, 2020-12-03). Nämä ovat formulaatiosta riippuvia havaintoja, ei ole yleinen lausunto siitä, että jokin vastaioni ei ole turvallinen.
Toteutus tarkoittaa epäpuhtauksien retentioaikojen tallentamista, suhteelliset alueet ja vastaioninvaihtotila puhtausluvun rinnalla. Validointitasoja varten, I Q2(R2) asettaa validointialueen peptidin puhtausrajojen sijaan: epäpuhtaustestauksen on katettava raportointikynnys 120% määrittelyrajasta, ja puhtaus pinta-alaprosentteina on validoitu alkaen 80% alemmasta 100% määrittelyn ylärajasta (I Q2(R2), lopullinen ohje 2023-11-30).
Pillerit 4: Erähistoria ja eräkohtaiset analyysitodistukset
Mallin luottamus on jäljitettävyysominaisuus, siksi eränumerot, analyysisertifikaattien linkitys ja uusintatestaushistoria kuuluvat pikemminkin tietoaineistoon kuin vain laadunhallintajärjestelmään. ALCOA+-odotukset, jotka AI/ML-putkien on nyt täytettävä, ovat jo olemassa oleva GMP-standardi, joka on laajennettu uuteen käyttötapaukseen, ei ole uusi malli keksitty sääntö. Datalinja on merkitty kriittiseksi huolenaiheeksi, koska AI/ML integroituu MES:ään ja LIMS:ään, ja digitaalinen säie määritellään katkeamattomaksi tietosuhteiden ketjuksi raaka-ainetestauksesta valmistukseen lopputuotteen julkaisuun. (AI/ML-toteutuksen sääntelynäkökohdat, PMC, 2025-06-16).
Vihjeille: Säilytä uudelleentestaus- ja uudelleenmäärityshistoria korvaamisen sijaan Kauppa se. Aikaleimalla varustettu korvattu arvo on todiste; korvattu arvo on aukko.
Vikatila on kaksinkertainen kampanja. Kolme samalla erällä suoritettua määritystä kirjataan kolmena itsenäisenä havainnona, ja malli käsittelee yhtä erää kolmena, lisää luottamusta tulokseen, jota ei koskaan toistettu.
Pillerit 5: Standardoidut analyysitulokset ja koneellisesti luettavat muodot
Standardoidut peptidi-AI:n analyyttiset tulokset riippuvat muodoista, joita putki voi jäsentää ilman manuaalista puhdistusta. Analyyttiselle kerrokselle on jo olemassa koneellisesti luettavia standardeja: mzML raakamassaspektrometriatiedoille, mzIdentML ja mzTab tunnistamiseen ja kvantifiointiin, PX-XML lähetyksen metadatalle, SDRF-Proteomiikka näyte- ja altistussuhteille, ja USI vakaille spektrin tunnisteille (Proteomics-tietoinfrastruktuuri).
Toistettavuus vaatii myös täyden menetelmälohkon. HPLC-menetelmän parametrit sisältävät kolonnikemian (tyypillisesti C18), hiukkasten ja huokosten koko, sarakkeen mitat, liikkuvat faasit ja modifioijat, gradienttiohjelma, virtausnopeus (noin 1.0 ml/min analyyttinen), kolonnin lämpötila, ilmaisun aallonpituus (tyypillisesti 214–220 nm peptideille) ja injektiomäärä. Identiteetti on vahvistettava koskemattoman massan LC-MS:llä tai MALDI-TOF:lla, jossa on havaittu suhteessa teoreettiseen massaan ja ilmoitettu ppm- tai Da-hyväksymisikkuna, ei pelkästään HPLC:llä (Phenomenex HPLC -tietokeskus, 2026-07-29).
Vikatila on tietue, jossa lukee "tavallinen RP-HPLC-gradientti". Ilman menetelmälohkoa, tulos ei voi toimia validointiankkurina, ja kumppani ei voi toistaa sitä.
Luottamuksellisuus: Peptiditietojen jakaminen ilman johdon vuotamista
Tekoälypeptidikumppanuuksien luottamuksellisuusriski on mitattavissa, ei teoreettista. A 2025 lääketutkimuksen hermoverkkojen tutkimuksessa havaittiin, että musta laatikko -skenaariossa, jossa vain lähtölogit paljastetaan, kuten verkkopalveluna tarjottava malli, Jäsenpäätöshyökkäykset tunnistivat, mitkä kemialliset rakenteet olivat olleet koulutussarjassa, ja useiden hyökkäysten yhdistäminen lisäsi riskiä (Neuraaliverkkojen julkaiseminen lääketutkimuksessa saattaa vaarantaa luottamuksellisuuden, 2025-03-26). Kirjoittajat huomauttavat, että molekyylit vähemmistöluokista, usein arvokkain huumeiden löytämisessä, ovat erityisen haavoittuvia, ja että ainutlaatuiset rakenteet, jotka eroavat vakiintuneista kirjastoyhdisteistä, voivat vastata patentoituja johtoja tai uusia kehitteillä olevia telineitä.
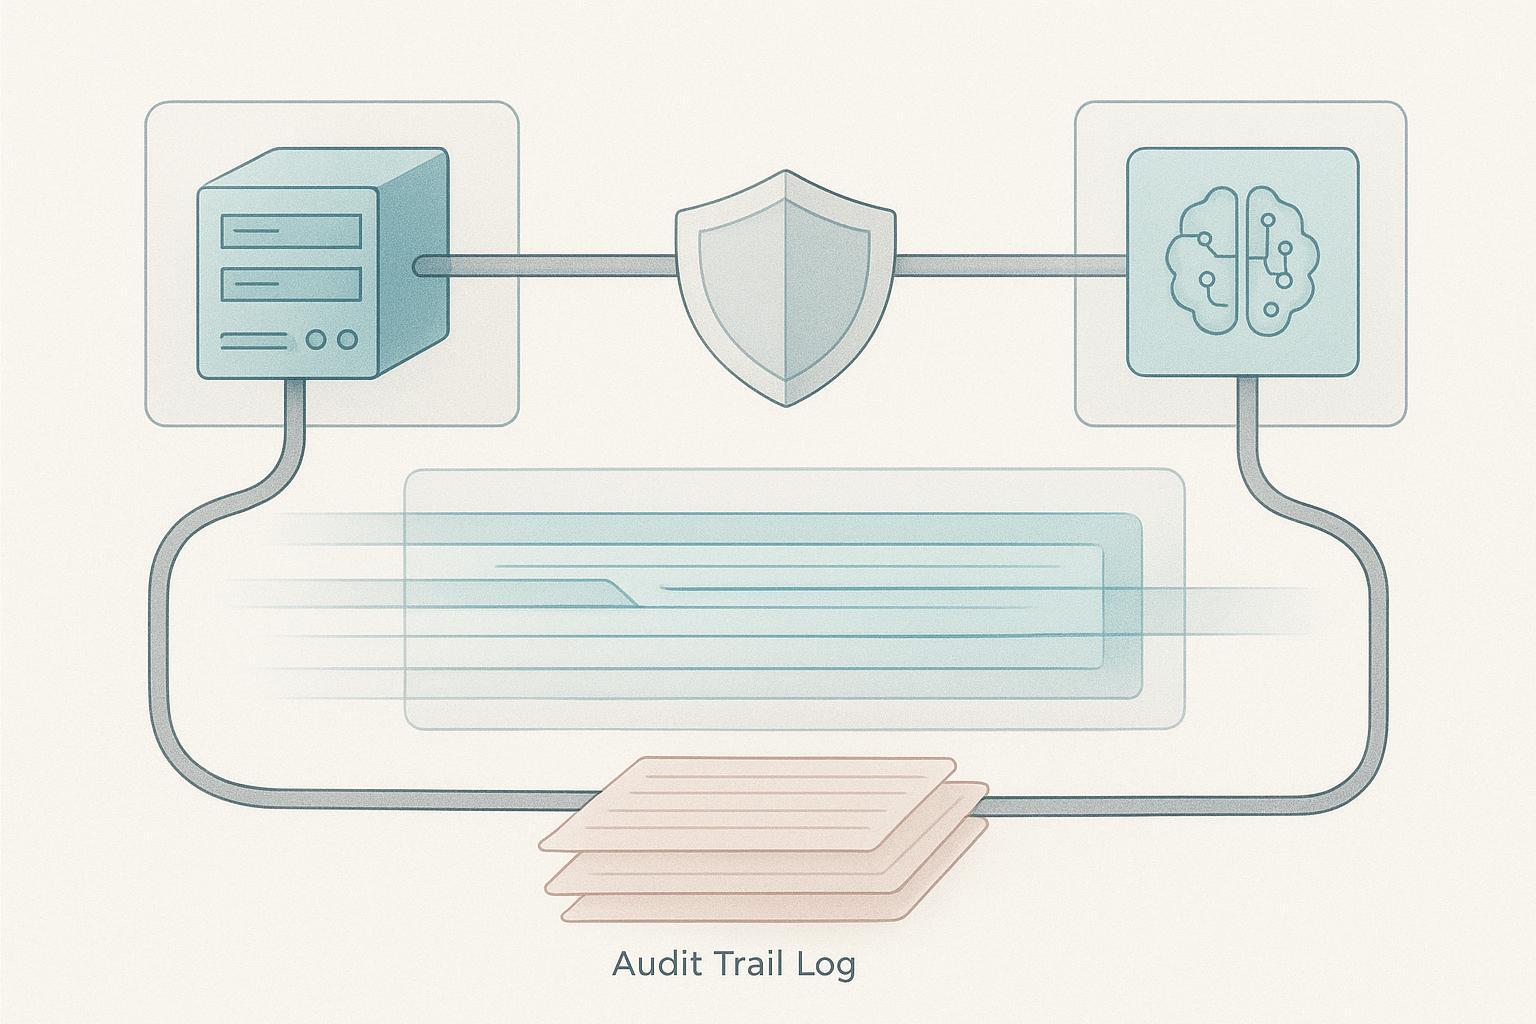
Operatiivinen vastaus on porrastettu pääsymalli eikä yksittäinen tietojen jakamispäätös. Sponsorit pitävät raakakirjanpitoa talon sisällä; kumppani saa tunnistamattomia tai hajautettuja esityksiä, jos mallinnustehtävä sen sallii; vain aggregoidut tuotokset poistuvat yhteistyöstä. Sopimusrajoitukset sille, mitä kumppani voi säilyttää, plus kirjausketju jokaiselle jaetun joukon kyselylle, sulje silmukka.
Key Takeaway: Tunnistamisen poistaminen vähentää vuotoriskiä, mutta ei poista sitä rakenteellisesti erottuvien peptidien osalta, joten tasoituksella ja kyselyn auditoinnilla on painoarvo, jota peittäminen yksinään ei pysty.
Tieteellinen validointi: Toimintapöytäkirja, Ei periaate
Validointi ei ole periaate, josta olet samaa mieltä. Se on suorittamasi sekvenssi: ortogonaalinen vahvistus ensin, sitten riippumaton replikointi, sitten jokaisen malliin kohdistuvan arvon täsmäytys takaisin raakaan analyyttiseen dataan, josta se tuli. Kolmannen vaiheen ohittaminen on yleisin epäonnistuminen, koska täsmäytysluku ja täsmäämätön luku näyttävät identtisiltä harjoitustaulukossa.
Määritä ortogonaalinen pari vaatimustyyppiä kohti ennen kuin luot mitään. Identiteettiä varten, yhdistä ehjä massa sekuntiin, mekaanisesti eri menetelmä kuin toistuva injektio samaan instrumenttiin. Aktiivisuudelle, yhdistä biofysikaalisen sitoutumisen lukema solupohjaiseen toiminnalliseen lukemaan, koska molemmat vastaavat eri kysymyksiin.
Replikoinnin on käytettävä itsenäisesti syntetisoitua erää, ei uusinta samaa materiaalia. Saman määrityksen suorittaminen kahdesti samalla erällä mittaa instrumentin tarkkuuden, ei yleistämistä. A 2025 epitooppien ennustusmenetelmien systemaattinen tarkastelu havaitsi, että monet nykyiset lähestymistavat kärsivät liiallisesta sovituksesta harjoitustietosarjoihinsa, mikä rajoittaa merkittävästi sitä, kuinka hyvin ne siirtyvät uusiin kohteisiin (npj Rokotteet, 2025-08-30). Samassa katsauksessa todetaan, että kaikki sideaineet eivät ole immunogeenisiä: huippuluokan epitooppi voi sitoa vasta-aineita in vitro, mutta ei kuitenkaan saa aikaan aiottua vastetta in vivo, ja tarkkuus benchmarkissa ei siirry lukemaan, solulinja, tai kohdekonteksti on erilainen.
Tämä on epäonnistumistila, jota vastaan suunnitella. Harjoittelusarjan kanssa samasta kampanjasta laadittu validointisarja mittaa muistamista, ei yleistämistä.
Benchmark Gap: Mitä standardointi ei vieläkään voi korjata
Standardointi on välttämätöntä, mutta ei riittävää. Alan mittapuut ovat uusia ja kapeat, eikä mikään tuloskortti voi vielä mitata sitä, mitä se väittää mittaavansa.
PepBenchmark, huhtikuussa julkaistu standardoitu peptidi-ML-benchmark 2026 ja esiteltiin ICLR:ssä 2026, kannet 29 kanoninen peptidi plus 6 ei-kanonisten peptidien tietojoukot 7 ryhmiä, yhtenäisellä esikäsittelyputkella ja tulostaulukolla, joka kattaa neljä menetelmäperhettä: Sormenjälki, GNN, PLM, ja HYMIÄ. Sen kirjoittajat toteavat selvästi, että aiempaa työtä "esti standardoitujen vertailuarvojen puuttuminen" ja että "laatuongelmat ovat yleisiä tilapäisissä putkissa". Se on todellinen edistysaskel, ja se on myös kapea: 35 tietojoukot, yksi benchmark, yksi julkaisu.
Rehellisillä rajoilla on suunnittelussa enemmän merkitystä kuin otsikolla. Mikään kysely ei anna yhtäkään puolustettavaa FAIR-ottoprosenttia biopharma R:lle&D, eikä missään tutkimuksessa lasketa niiden AI-lääkkeiden löytöpapereiden osuutta, joissa on vuotoja tai toistettavuusvirheitä. Mikä tahansa valmiustuloskortti on siksi arviointiapua, ei mittaa.
⚠️ Varoitus: Käsittele valmiuspisteitä jäsennellyn keskustelun aloittajana, ei validoitu mittari. Jos kumppani kysyy, mihin pisteitäsi verrataan, oikea vastaus tänään on "oma kriteerimme,”ei julkaistu standardi.
Ulkoinen kehys saapuu, vaikka. FDA:n tammikuu 2025 luonnos ohjeista tekoälystä sääntelyn päätöksenteossa ehdottaa riskiin perustuvaa uskottavuusarviointia, joka on sidottu ilmoitettuun käyttöympäristöön. Se on luonnos, ei täytäntöönpanoa varten, ja se ohjaa esityksiä eikä löytöjä. Jopa niin, se viittaa kysymykseen, johon pitäisi rakentaa valmiusohjelma vastaamaan: mihin tämä malli on tarkoitettu, ja mitkä todisteet tekevät sen tuotosta uskottavan tähän käyttöön?
Aloitus: 30 päivän peptiditietojen valmiuspassi
Tekoälylääketutkimuksen peptiditietojen työnkulku testataan nopeimmin ottamalla satunnaisesti kaksikymmentä peptiditietuetta ja pisteytämällä jokainen viittä pilaria vastaan. Se on viiden minuutin päätös, ja se yleensä ratkaisee kysymyksen siitä, onko ohjelma valmis kumppanuuteen. Useimmat joukkueet huomaavat, että kourallinen tietueita on puhtaita, suurempi ryhmä on osittain valmis, ja muutamaa ei voida rekonstruoida ollenkaan.
Jokaiselle epäonnistuneelle alalle, päättää, onko aukko sieppausongelma vai kytkentäongelma. Sieppausongelma tarkoittaa, että tietoja ei koskaan tallennettu, joten korjaus on muutos siihen, mitä joukkue kerää penkillä. Linkitysongelma tarkoittaa, että tiedot ovat olemassa jossain, mutta niitä ei ole liitetty paljon, menetelmä, tai analyysin lukema, joten korjaus on tunniste ja liitos, ei uusi kokeilu. Molemmilla on eri omistajat ja eri aikajanat, ja kytkentäongelman käsitteleminen sieppausongelmana tuhlaa kuukausia.
Aja sitten yksi peptidi koko ketjun päästä päähän: henkilöllisyystodistus, Erään liittyvä analyysitodistus, koneellisesti luettava analyyttinen tiedosto. Dokumentoi jokainen kohta, jossa ihmisen oli puututtava käsin. Tämä toimenpideluettelo on valmiusprojektin todellinen laajuus.
Yleinen epäröinti on, että tämä vaatii alustan vaihtamisen. Useimmissa tapauksissa ei. Se vaatii kenttätason kurinalaisuutta ryhmän jo tuottamissa tietueissa.
Seuraava askel: Suorita kahdenkymmenen ennätyksen pisteytys ja tuo toimenpideluettelo teknisten tietojen valmiusarviointiin, jossa raot kartoitetaan betonikorjauksiin.
Usein kysytyt kysymykset
Mikä tekee peptidisekvenssistä ja modifikaatiotietueesta yksiselitteisen?
Yksiselitteinen tietue nimeää tarkan kemiallisen rakenteen, ei lyhenne, jota lukijan on tulkittava. Peptidirakenteen merkinnän viitekäsittely käsittelee häviötöntä kemiallista esitystä ensisijaisena tietueena, jossa HELM käytetään polymeeritietoisissa rakenteissa ja SMILES atomitason graafimalleissa, InChI tai InChIKey duplikointi- ja identiteettiavaimina, syklisointi ja ristilinkit, jotka on kirjoitettu eksplisiittisiksi yhteysobjekteiksi, ja ei-luonnolliset jäännökset, jotka on kirjoitettu monikirjaimilla koodeilla pienillä kirjaimilla D-aminohapoille. Jäännöstason muutosmerkintä, kuten MAP käyttää, pitää laktaamisillan erottuvana disulfidista. Tietue, jossa lukee "muokattu peptidi" ilman tätä yksityiskohtaa, on siistin näköinen, mutta ei tekoälyvalmis.
Onko HELM vai SMILES parempi ensisijainen ennätys?
Kumpikaan ei ole yleisesti parempi; valinta seuraa mallia, joka kuluttaa tietueen. HELM säilyttää polymeeritason topologian ja käsittelee ei-luonnolliset monomeerit ja liitoskohteet siististi, joka sopii sekvenssitietoiseen ja makrosykliseen työhön. SMILES antaa atomitason graafin, jonka useimmat kuvaajahermoverkot ja cheminformatiikan työkalupakkit lukevat suoraan. Ohjelmat, jotka tarvitsevat sekä tallentavat toisen ensisijaiseksi tietueeksi että luovat toisen, InChIKey liitosavaimena, joten samaa molekyyliä ei koskaan lasketa kahdesti.
Kuinka paljon analyysikontekstia riittää?
Riittää, että eri laboratorio voisi toistaa mittauksen ja tulkita numeron. Vähintäänkin: määrityksen tyyppi ja lukema, kohdistaa ja rakentaa, solulinja tai matriisi, pitoisuusalue, inkubaatioolosuhteet, havaitsemismenetelmä, ja yksiköt. A 2025 epitooppien ennustajien systemaattisessa tarkastelussa havaittiin, että huippuluokan epitooppi voi sitoa vasta-aineita in vitro, mutta silti olla huonosti immunogeeninen in vivo, ja tämä tarkkuus ei siirry luettaessa, solulinja tai kohdekonteksti eroaa. Sitovaa arvoa, jolla ei ole kontekstia, ei voida yhdistää mihinkään.
Onko yksittäinen puhtausluku koskaan hyväksyttävä?
Vain otsikkona, ei koskaan ennätyksenä. I Q2(R2)Validointialueen vaatimukset asettavat epäpuhtausraportoinnin kynnysarvosta asti 120% määrittelyrajasta, ja puhtausalueen prosentit alkaen 80% to 100% määrittelyrajoista, ilmaisu- ja kvantitointirajat noin signaali-kohinasuhteen ympärillä 3:1 ja 10:1. Peptidien epäpuhtaudet ja erähistoriatiedot, jotka sisältävät vain "98 % puhdasta", piilottavat mitkä epäpuhtaudet, millä tasolla, millä menetelmällä. Säilytä numero, kiinnitä sitten profiili sen taakse. Peptidin tuotanto Noin
Kuinka jaamme rakenteita kumppanin kanssa paljastamatta johtosarjaa?
Jaa malli tai johdetut ominaisuudet raaka-harjoitussarjan sijaan, ja testaa mitä tulos paljastaa. Jäsenyyspäätelmähyökkäykset, jotka palauttavat harjoitusmolekyylejä tarjotusta mallista, tunnistavat harjoitusmolekyylejä pelkästään lähtölogisteista, ja vähemmistöluokan ja uusien rakennustelineiden molekyylit ovat haavoittuvimpia, yhdistetyt hyökkäykset lisäävät riskiä entisestään. Jos kumppani tarvitsee itse tiedot, Käytä hallittua ympäristöä, jossa on sovittu ominaisuusjoukko ja kirjausketju tiedostonsiirron sijaan.
Voidaanko malli validoida ilman itsenäistä erää??
Ei. Malli, joka on validoitu vain erillä, joka on jo nähnyt raportin ulkoa, ei yleistämistä. Pidä vähintään yksi erä ohjelmaa kohden, mieluiten eri synteesikampanjasta, ja pidä se koskemattomana lopulliseen arviointiin asti. Jos itsenäistä erää ei ole olemassa, rehellinen lausunto on, että malli on sisäisesti johdonmukainen, ei validoitu.
Koskeeko FDA:n ohjeluonnos löytövaiheen työtä??
Ei suoraan, mutta se on selkein saatavilla oleva lause standardista, johon sinut lopulta kiinnitetään. FDA:n tammikuu 2025 luonnos ohjeista tekoälystä sääntelyn päätöksenteossa ehdottaa riskiin perustuvaa uskottavuusarviointia, joka on sidottu ilmoitettuun käyttöympäristöön. Se on päivätty luonnos 6 tammikuu 2025 eikä se ole täytäntöönpanoa varten. Löytöryhmien, jotka dokumentoivat käyttökontekstin nyt, ei tarvitse rekonstruoida sitä myöhemmin.
Key Takeaway: Valmiusvaatimus on puolustettava vain, kun se nimeää tietuekentät, jakamisarkkitehtuuri ja validointiprotokolla, ei silloin, kun se ilmoittaa puhtausluvun.
Johtopäätös
Valmius on tietueen ominaisuus, ei mallista, ja tämä on testipeptiditietojen työnkulku tekoälylääkekehitystä varten jokaisessa kumppanuuskeskustelussa. Viisi pilaria, yksiselitteinen järjestys ja muutosmerkintä, määrityskonteksti, joka kulkee tuloksen mukana, epäpuhtausprofiilit yksittäisen puhtausluvun sijaan, eräin liittyvät analyysitodistukset, ja koneellisesti luettava standardoitu analyyttinen tulos, ovat tarkistuslista. Luottamuksellisuusarkkitehtuuri ja kirjallinen validointiprotokolla mahdollistavat tietueen jakamisen ilman johdon luovuttamista.
Vertailuarvo ja sääntelykehykset ovat edelleen muodostumassa: PepBenchmark 2026 on aikaista, ja FDA:n ohjeluonnos ei ole vielä kirjoitettu täytäntöönpanoa varten. Nyt rakennettu valmiusohjelma vastaa kysymykseen, jota kumppanit esittävät myöhemmin virallisemmin, joten rakentaa se uudelleen pisteytettäväksi sen sijaan, että se sertifioidaan kerran. Tämä opas on arviointiapu, ei mittaa. Ei ole olemassa puolustettavaa kentänlaajuista FAIR-käyttöönottoprosenttia tai vuotovirheiden määrää, joten tuloskortti tässä tukee päätöstä sen ratkaisemisen sijaan.
MOL Changes julkaisee peptiditoimittajana.
Selvitä, missä peptiditietosi epäonnistuvat kumppanisi mallissa. Tekninen tietojen valmiuskatsaus kartoittaa peptiditietosi viiteen pilariin ja luokittelee jokaisen aukon sieppausongelmaksi tai kytkentäongelmaksi. Pyydä tietojen valmiuden tarkistusta analyyttisen tiimimme kanssa.