단계 1: GLP-1R 결합 계산이 실제로 예측하는 것을 정의하십시오.
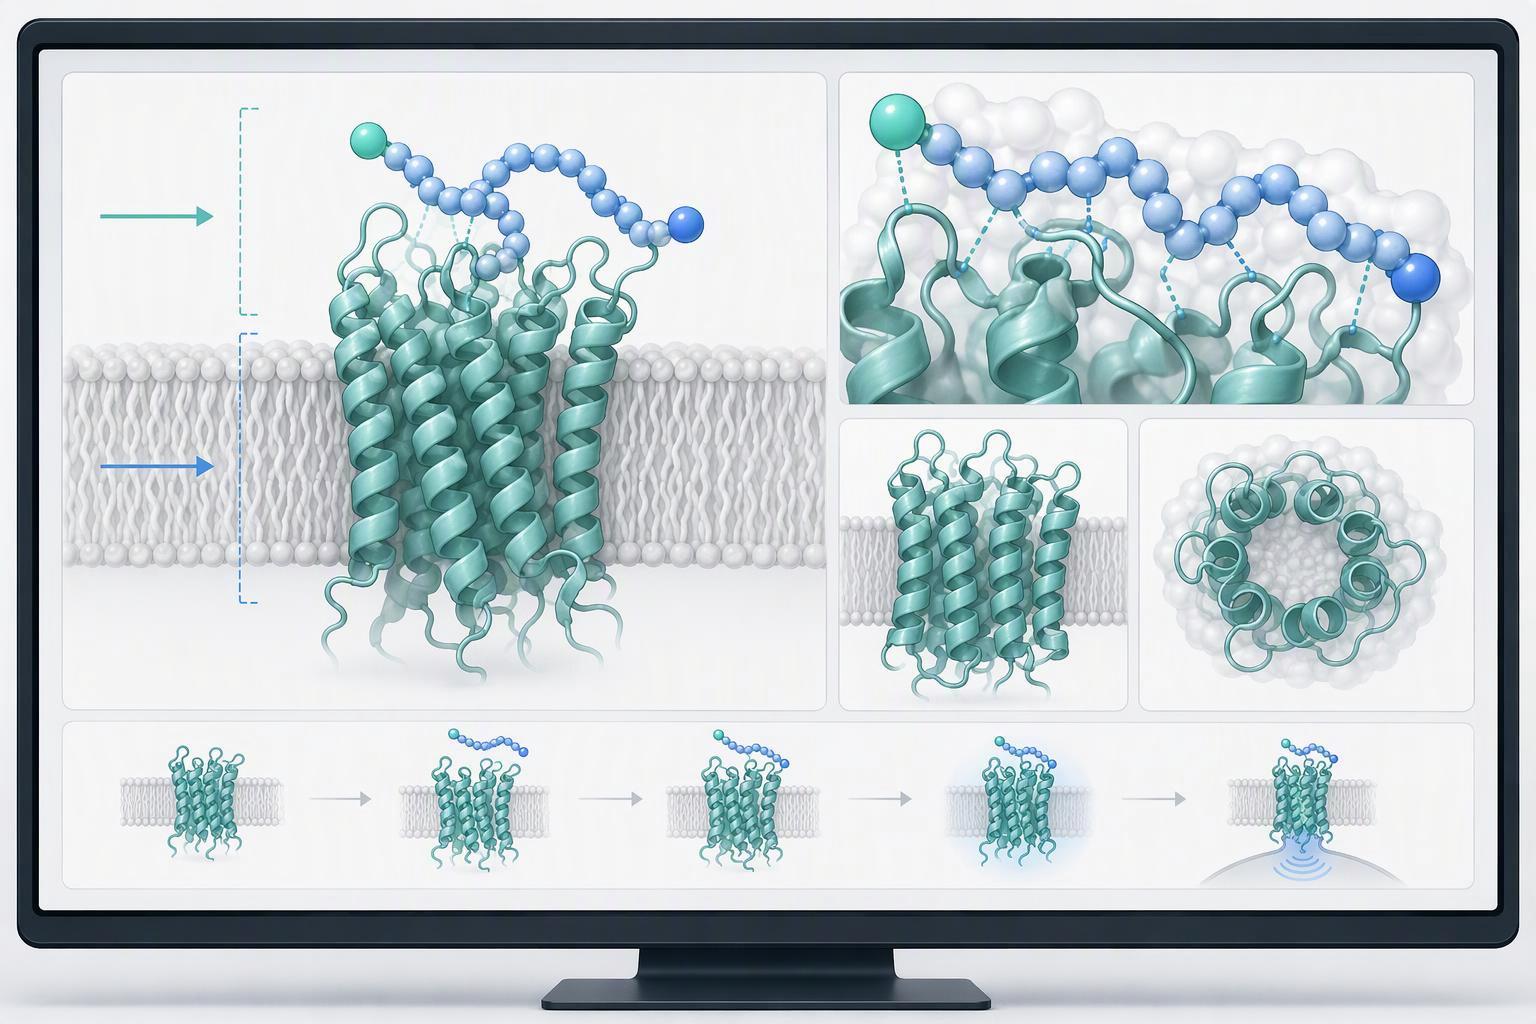
일반적인 모델링 실행에서 세 가지 다른 숫자가 나옵니다., 그리고 그것들은 같은 것을 의미하지 않습니다. 에이 도킹 점수 하나의 수용체 구조에서 펩타이드의 한 위치에 대한 채점 함수 값입니다.; 포즈 순위, 친화력을 측정하지 않습니다. 에이 예측된 Kd 훈련된 회귀를 통해 점수가 해리 상수처럼 보이도록 푸시된 것입니다.. 에이 자유 에너지 추정 (MM-PBSA, MM-GBSA, 연금술 FEP) 프레임 앙상블에 대한 물리 기반 계산입니다., 그리고 숫자의 일부로 읽어야 하는 표준 편차가 있습니다..
이들 중 어느 것도 측정된 결합 상수가 아닙니다..
GLP-1R의 스프레드가 이렇게 넓은 이유는 구조적입니다.. 클래스 B1 GPCR 펩타이드 인식은 2개 도메인 문제입니다.: 펩타이드 C-말단은 세포외 도메인과 결합하는 반면 N-말단은 활성화를 위해 7TM 코어에 도달해야 합니다., 따라서 단일 강성 수용체 자세는 결합 상태를 나타낼 수 없습니다., 도킹은 모델링한 수용체 상태에 민감합니다. (네이처커뮤니케이션즈, 2022).
그 감수성은 학문적이지 않다. 에서 2026 약리학 연구의 개척지, 동일한 18개 잔기 작용제가 득점되었습니다. 55 하나의 수용체 형태에 대한 nM 및 360 다른 것에 비해 nM (SR18; 프로디지(PRODIGY) 0 ns 순응자 대 MD 중앙 순응자). MM-PBSA 이상 1 μs의 MD는 -98.79 ±를 나타냈습니다. 8.77 -167.22 ±에 대한 SR18의 kcal/mol 16.20 GLP-1의 경우 kcal/mol. 세포 기반 분석이 실행되지 않았습니다..
핵심 내용: 점수는 신뢰 구간이 있는 가설입니다., 결과가 아니다. 순위를 매기기 전에, 어떤 수용체 상태를 기록하세요, 어떤 방법, 각 숫자를 생성하는 오류 막대.
단계 2: 순위를 신뢰하기 전에 모델 가정을 감사하십시오.
순위는 그 아래에 있는 가정만큼만 우수합니다., 이러한 가정은 일반적으로 출력 테이블에 표시되지 않습니다.. 예측된 순서에 따라 행동하기 전에, 세 가지 질문을 해보세요: 어떤 역장과 샘플링 체제가 포즈를 만들어냈는가, 시뮬레이션이 실행된 시간, 모델이 실제로 벤치마킹된 내용.
샘플링으로 1위 순위 경신. 클래스 B GPCR MD 실행은 일반적으로 200~500ns 후에만 안정화됩니다., 1.5~2.5μs 동안 계속해서 이완합니다., 많은 활성화 프로세스가 기존 MD 기간보다 더 오래 지속됩니다. (클래스 B GPCR의 구조적 상태 전이 평가, 2019). 에이 100 수렴된 것처럼 보이는 ns 실행은 단순히 관련 상태를 샘플링하지 않았을 수도 있습니다..
포즈 정확도에도 한계가 있습니다. 에서 2025 GPCR-펩타이드 벤치마크, AlphaFold2는 올바른 바인딩 모드를 재현했습니다. 94% 컷오프 후 단지의 (63/67), 상호작용 분류 AUC로 0.86 AF2 대 0.76 차이-1의 경우, ESMFold와 NeuralPLexer는 바인더를 전혀 강화하지 못했습니다. (GPCR-펩타이드 결합 분류기 벤치마크, 2025-04-26). 읽어보세요 94% 단일 소스 벤치마크 결과, 귀하의 목표에 대한 보장은 아닙니다.
|
모델 클래스 |
보고된 성과 |
깨질 가능성이 가장 높은 가정 |
|---|---|---|
|
MD / 자유에너지 |
200~500ns 후에 안정화됩니다. |
샘플링 시간이 충분히 길다 |
|
AF2 / AF3 |
94% 올바른 모드; AUC 0.86 / 0.82 |
벤치마크가 펩타이드로 이전됩니다. |
|
차이-1, 에스엠폴드, NeuralPLexer |
AUC 0.76; 바인더 강화 없음 |
점수는 선호도를 추적합니다. |
실패 모드가 문서화되어 있습니다.: 활성인 것으로 알려진 리간드에 대해 대략 5~5.5Å의 재도킹 RMSD가 보고되었습니다. (GLP-1R 구조 결정 요인, 2016-04-08).
단계 3: 예측을 위조할 수 있는 최소 변형 패널 설계
각 변형이 순위가 잘못되었음을 입증할 때 패널은 비용을 얻습니다.. 모델의 민감도에 맞게 크기 조정, 합성 예산이 아닌: 계산에서 두 변형을 분리해야 한다고 주장하는 경우, 최소한 한 명의 패널 구성원이 해당 경계에 앉아 있어야 합니다..
세 그룹이 대부분의 작업을 수행합니다.. 잔류물에서의 단일 위치 대체는 접촉점으로 모델 플래그를 지정하여 해당 접촉이 예상 중량을 전달하는지 여부를 테스트합니다.. N-말단 절단 또는 대체 계열은 모델이 결정적인 것으로 간주하는 영역을 테스트합니다., 그리고 가장 자주 제외되는 그룹이에요: SR18 저자는 세포 신호 전달 연구가 아직 수행되지 않았다고 언급했습니다., 따라서 그들의 모델링이 암시하는 N-말단 동작은 확정된 입력이 아니라 여전히 공개 질문입니다.. 순서가 아닌 화학을 변경하는 하나의 수정 클래스, 스테이플링, 지질화, 또는 D-아미노산 스캔, 시퀀스 기반 모델이 훈련되지 않은 변경 후에도 예측이 유지되는지 테스트합니다..
맞춤형 펩타이드 합성 결과를 식별 가능한 변형으로 처리, 도서관이 아니다. 모든 구성원은 이를 위조할 수 있는 하나의 가정과 하나의 판독값에 매핑되어야 합니다..
|
변형 클래스 |
테스트된 가정 |
위조된 판독값 |
|---|---|---|
|
접점 대체 |
플래그가 지정된 잔류물은 친화력을 유도합니다. |
측정된 바인딩의 변화 |
|
합성 펩타이드 합성 N단자 시리즈 |
N 말단이 인식을 지배합니다. |
손실 또는 보존 Spps 고체상 펩타이드 합성 바인딩의 |
|
화학 변화 수정 |
시퀀스만으로 행동을 예측합니다. |
예측 순위와의 차이 |
단계 4: 모든 바인딩 판독값을 기능적 판독값과 결합
결합 상수는 펩타이드가 수용체를 얼마나 단단히 점유하는지 알려줍니다.. 점유가 그것을 얼마나 강하게 활성화시키는지는 알려주지 않습니다.. 수용체 점유는 펩타이드가 결합된 GLP-1R 분자의 분율입니다.; cAMP 축적은 활성화를 보고하는 다운스트림 2차 메시지 판독입니다.; 편향된 작용은 다른 것보다 하나의 신호 전달 경로를 선호하는 리간드를 설명합니다., β-arrestin-2 모집에 대한 cAMP와 같은. 별도의 측정이기 때문에, 선호도에만 기반한 순위는 기능을 측정하면 반전될 수 있습니다..
Tirzepatide는 격차를 보여줍니다.. 이는 천연 GLP-1보다 대략 5배 더 약한 친화력으로 GLP-1R과 결합하지만 cAMP 축적에 있어서는 20배 덜 강력합니다., 인간 혈청 알부민의 존재 하에서 효능 변화는 81배에 도달하는 반면 GLP-1은(7-36) 효능은 변함없이 유지됩니다 (JCI 인사이트, 2020). 효능과 친화력은 서로 바꿔서 사용할 수 없습니다., 그리고 분석 매체는 숫자를 변경합니다.
편향된 작용제는 격차를 더욱 확대합니다.. 네이티브 GLP-1의 cAMP EC50은 다음과 같습니다. 3 오후, ~에 맞서 29 리라글루타이드의 경우 pM 및 343 편향된 이중 작용제 CT-859에 대한 pM, 아래에서 생산되는 5% β-arrestin-2 모집 대 99% GLP-1의 경우 (PMC, 2025). cAMP를 플랫하게 유지하는 예측된 친화도 이득은 cAMP를 이동시키는 결과와 다릅니다., 패널은 두 가지를 구별해야 합니다..
결합 친화력, 캠프 효능, 경로 편향과 모델 분류 AUC는 서로 다른 끝점입니다.. 수용체 시스템 보고, 분석 조건 및 각 값의 비교; 일치하는 실험 내에서 수치적 잠재력을 비교합니다.. 다른 펩타이드에 대한 반대이온 독성 관찰은 GLP-1R 특이적 역치를 설정하지 않습니다..
팁의 경우: 비교하려는 동일한 배지에서 기능 분석을 실행하십시오., 위의 알부민 의존성 효능 변화는 분석 조건의 특성이기 때문에, 펩타이드 단독이 아닌.
단계 5: 비교 시 참조 자료 품질을 변수로 취급
귀하의 비교기는 측정입니다, 그리고 그것은 그 자체의 오류를 가지고 있습니다. 참조 표준이 GLP-1R 비교에 들어가기 전, 실제로 무엇인지 확인. 반대 이온 형태는 가장 일반적인 숨겨진 변수입니다.: 사분지형 펩타이드 M33의 TFA 염은 아세테이트 대응물보다 정상 기관지 상피 세포에 대해 5-30% 더 큰 세포 독성을 나타냈습니다., TFA 가속 뇌척수염 발병으로 공식화된 MOG는 대략 다음과 같습니다. 5 비슷한 발생률과 심각도의 일수 (펩타이드 구조에 대한 반대 이온의 효과, 활동, 및 기능성, 생체분자, 2025). 메커니즘은 일상적인 화학이다: Fmoc/tBu SPPS에 이어 RP-HPLC를 수행하면 트리플루오로아세테이트 염이 생성됩니다., 염기성 잔류물에 결합되거나 동결건조물에 흡착된 TFA를 포함함, USP와 EP는 펩타이드 약물의 아세테이트 음이온을 그 수준을 측정해야 하는 불순물로 취급합니다. (펩타이드에서 반대이온의 역할, 개요, 제약, 2020).
|
QC 속성 |
확인해야 할 사항 |
이동할 수 있다고 분석 |
|---|---|---|
|
HPLC에 의한 순도 |
보고된 방법 및 통합 임계값 |
힘, 겉보기 친화력 |
|
반대이온 정체성 |
아세테이트 대. TFA, CoA에 명시된 |
세포 생존력, 기능적 판독 인공의 합성폴리펩타이드 펩타이드 합성 |
|
잔여 TFA |
측정된 수준, 결석으로 간주되지 않음 폴리펩티드 합성 |
세포독성, 증식 분석 |
|
로트 번호 |
단일 합성 배치까지 추적 가능 |
로트 간 비교 가능성 |
단계 6: 불일치 조정 및 다음 패널 설정
측정된 호감도와 예상 순위가 일치하지 않는 경우, 첫 번째 질문은 어떤 모델을 수정해야 하는가가 아닙니다.. 분석이 평형에 도달했는지 여부입니다.. 제대로 작동한 GnRH 수용체 사례는 이것이 얼마나 멀리까지 갈 수 있는지를 보여줍니다.: 에이 2 h 인큐베이션은 겉보기 Kd를 제공했습니다. 200 운동 분석이 제공되는 동안 오후 29 오후, 왜냐하면 방사성 리간드 해리 반감기가 되었기 때문입니다. 4 h 및 완전 평형이 최소한 필요함 20 시간 (평형 상태에서의 리간드 결합 분석: 검증 및 해석, Br J 파마콜, 2010). 비평형 읽기는 Kd를 대략 7배로 과대평가했습니다., 그리고 모델은 문제가 아니었어.
그 단일 사례는 또한 일반적인 지름길을 처리합니다. 널리 반복되는 "2배 이내" 합의 기준은 해당 소스에서 지원되지 않습니다., 따라서 GLP-1R 결합 계산의 합격 표시로 사용해서는 안 됩니다..
모델을 만지기 전에 불일치 위치를 파악하세요.. 간격이 배양 시간으로 추적되는 경우, 버퍼, 아니면 참고로트, 패널이나 프로토콜을 변경해 보세요. 깨끗한 평형 측정을 유지하고 변형 전체에서 반복되는 경우, 모델을 바꾸다.
자주 묻는 질문
도킹 점수가 측정된 결합 상수를 대체할 수 있습니까??
아니요. 도킹 점수는 점수 함수에 의해 생성된 추정치입니다., 해당 추정치의 오류는 그와 함께 보고되지 않습니다.. 측정된 해리 상수 (Kd) 신뢰 구간이 있는 적합 매개변수입니다., 이것이 비교 기준으로 사용할 수 있는 이유입니다..
SR18 사례는 실제로 구별이 중요한 이유를 보여줍니다.. 그 연구에서는, 동일한 펩타이드가 두 개의 수용체 일치체에 대해 다르게 점수를 매겼습니다., 에이 55 하나에 대한 nM 결과 및 360 다른 것에 비해 nM, 그리고 그들 사이를 판단하기 위해 세포 기반 분석이 수행되지 않았습니다.. 시작 구조와 함께 거의 한 자리수만큼 이동하는 점수는 바인딩에 대한 가설입니다., 그것을 측정하는 것이 아니다. 도킹을 사용하여 합성 후보 순위 지정, 그런 다음 분석 결과가 결정하도록 하세요..
GLP-1R 비교를 위해 어떤 분석 형식을 사용해야 합니까??
형식이 실제로 보고하는 내용을 선택하세요.. HTRF 및 Tag-lite 경쟁 분석은 플레이트 형식에서 평형 친화성을 제공하며 더 큰 변형 패널에 적합합니다.. 방사성리간드 경쟁은 다른 검출 원리로 동일하게 수행됩니다., 방사성 동위원소와 함께 제공되는 처리 오버헤드를 수행합니다.. SPR은 동역학을 보고합니다., 결합 및 해리율, 이는 효능 차이가 더 빠른 오프 속도 또는 느린 온 속도에서 발생하는지 여부를 알려줍니다..
이러한 동적 세부 사항은 전체 패널이 아닌 최종 후보 목록에서 SPR 비용을 지불하는 이유입니다.. 공개된 비교 가능성에 대한 한 가지 주의 사항: 경쟁사 애플리케이션 노트에서는 다음의 Kd 값을 보고합니다. 0.816 nM 및 2.347 오류 막대가 없는 두 기기의 nM, 복제 또는 n-숫자, 따라서 자신의 조건에서 재현할 때까지 여러 기기의 숫자를 지표로 취급하십시오..
내 참조 표준의 로트가 연구 도중에 변경되면 어떻게 되나요??
비교에 들어가기 전에 단일 분석 실행으로 이전 로트와 비교하여 새 로트의 적격성을 다시 확인합니다.. 동일한 플레이트에서 두 로트를 나란히 실행, 같은 날, 동일한 프로토콜, 그리고 효능 비율을 기록하세요..
순도 분석 증명서를 확인하세요., 반대이온 및 잔류 TFA, 이들 중 어느 것이든 펩타이드 서열과 관계없이 겉보기 효능을 바꿀 수 있기 때문입니다.. 효능 변화가 로트 변화를 추적하는 경우, 모델 오류가 아닌 비교에 대한 중요한 효과로 처리합니다.. 많은 변화는 통제할 수 있는 변수이다; 채점 기능이 아닙니다..
결론
루프는 방법이다. GLP-1R 결합 계산이 실제로 무엇을 예측하는지 정의하세요., 순위 뒤에 숨겨진 가정을 감사합니다., 위조할 수 있는 변형 패널을 디자인합니다., 모든 바인딩 판독값을 기능적 판독값과 연결합니다., 비교기의 품질을 제어, 다음 패널을 주문하기 전에 불일치를 조정하십시오.. 그 어떤 단계도 선택사항이 아닙니다, 시뮬레이션은 측정된 판독값이 시뮬레이션과 모순될 수 있는 순간에만 유용한 증거가 되기 때문입니다.. 그 전까지는 자신감 넘치는 표를 붙인 가설이다..
이것이 바로 비교기가 모델과 동일한 정밀 조사를 받아야 하는 이유이기도 합니다.. 참조 자료가 많이 다른 경우, 당신이 조정하고 있는 불일치는 예측보다는 표준에 속할 수 있습니다.. 문서화된 참고 자료 및 QC 작업 흐름이 해당 제어를 지원합니다.: 분석 증명서, 순도 및 반대이온 데이터, 분석 결과와 함께 기록된 로트 추적성, 다음 비교는 알려진 기준선에서 시작됩니다.. 루프의 측정된 측면을 계산 측면만큼 감사 가능하게 유지하는 데 사용할 수 있습니다..