Hurtigt svar
En seks-trins loop til at validere GLP-1R bindingsberegninger: revisionsmodelantagelser, designe et forfalskende panel, og kontrollere referencematerialets kvalitet
Trin 1: Definer, hvad dine GLP-1R-bindingsberegninger faktisk forudsiger
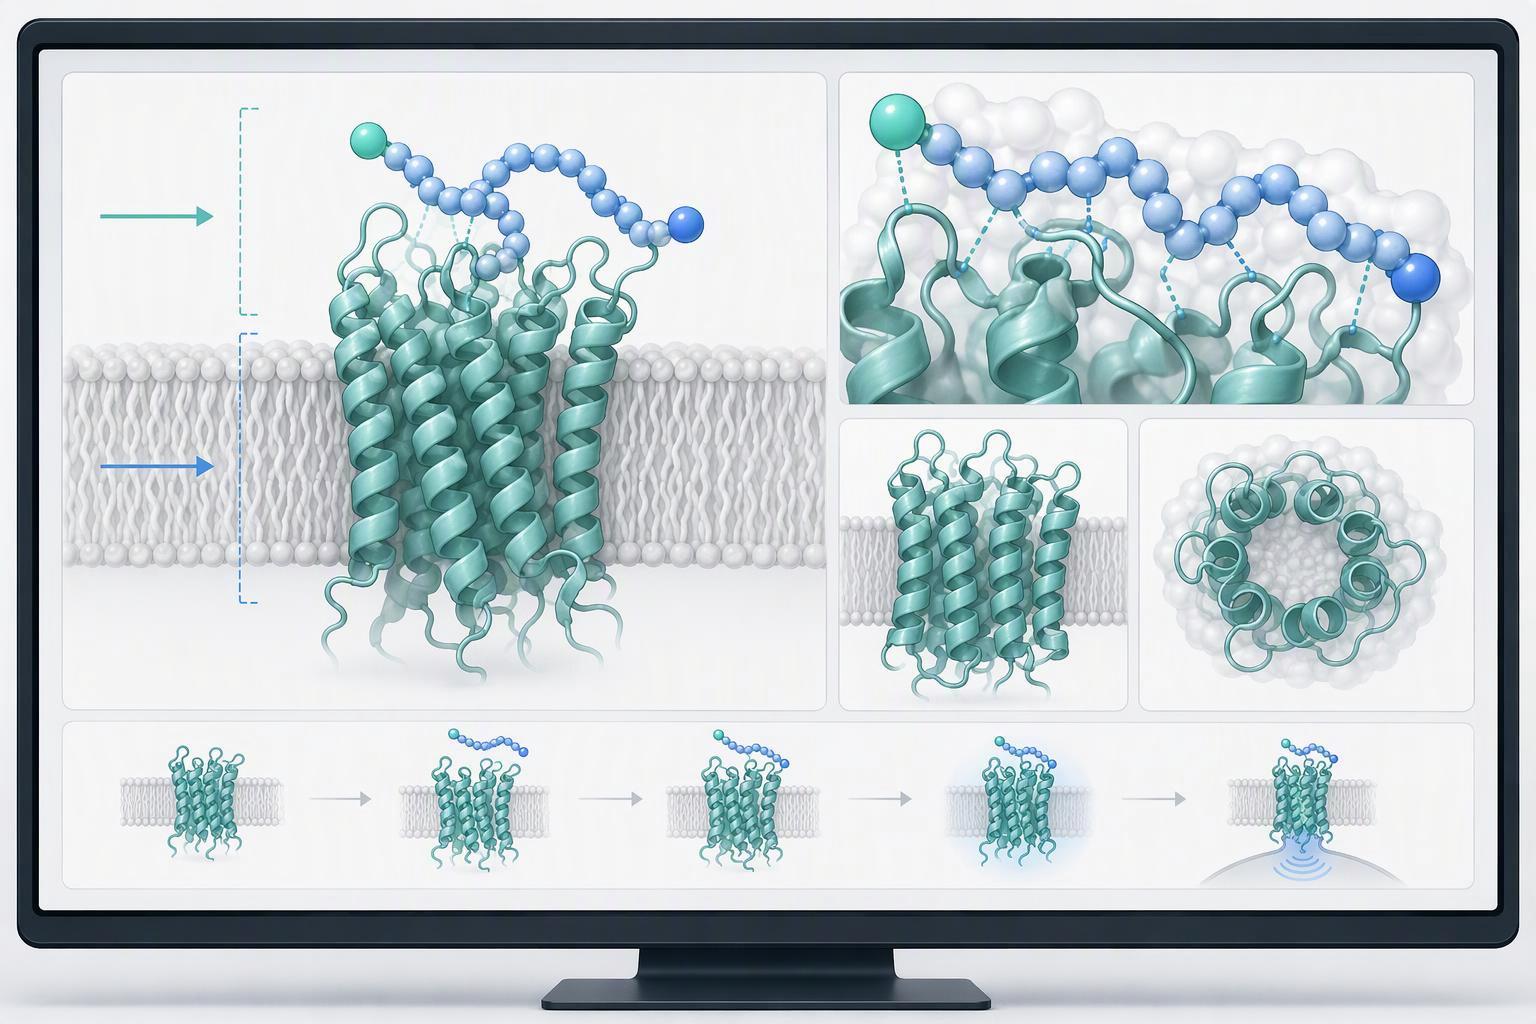
Tre forskellige tal kommer ud af en typisk modellering, og de betyder ikke det samme. EN docking score er en scoringsfunktionsværdi for én positur af peptidet i én receptorstruktur; det rangerer stillinger, den måler ikke affinitet. EN forudsagde Kd er den score skubbet gennem en trænet regression til at ligne en dissociationskonstant. EN fri-energi estimat (MM-PBSA, MM-GBSA, alkymistisk FEP) er en fysik-baseret beregning over et ensemble af rammer, og den har en standardafvigelse, du skal læse som en del af tallet.
Ingen af disse er en målt bindingskonstant.
Grunden til, at spredningen er så stor for GLP-1R, er strukturel. Klasse B1 GPCR-peptidgenkendelse er et problem med to domæner: peptidet C-terminus engagerer det ekstracellulære domæne, mens N-terminus skal nå ind i 7TM-kernen for aktivering, så en enkelt stiv receptorposition kan ikke repræsentere den bundne tilstand, og docking er følsom over for, hvilken receptortilstand du modellerede (Naturkommunikation, 2022).
Den følsomhed er ikke akademisk. I en 2026 Grænser i farmakologi studie, den samme 18-rester agonist scorede 55 nM mod en receptorkonformer og 360 nM mod en anden (SR18; PRODIGY mod 0 ns konformer versus MD central konformer). MM-PBSA overstået 1 μs af MD gav -98,79 ± 8.77 kcal/mol for SR18 mod -167,22 ± 16.20 kcal/mol for GLP-1. Der blev ikke kørt noget cellebaseret assay.
Nøgle takeaway: En score er en hypotese med et konfidensinterval, ikke et resultat. Før du rangerer noget, skriv ned hvilken receptortilstand, hvilken metode, og hvilken fejlbjælke producerede hvert tal.
Trin 2: Revider modelantagelserne, før du stoler på en rangering
En rangordning er kun så god som antagelserne under den, og disse antagelser er normalt usynlige i outputtabellen. Før du handler på en forudsagt ordre, stille tre spørgsmål: hvilket kraftfelt og prøveudtagningsregime producerede stillingen, hvor længe simuleringen kørte, og hvad modellen egentlig var benchmarked imod.
Sampling er førstepladsplaceringens pause. Klasse B GPCR MD-kørsler stabiliseres typisk først efter 200-500 ns, med fortsat afspænding i yderligere 1,5-2,5 μs, og mange aktiveringsprocesser overgår helt konventionelle MD tidsskalaer (Vurdering af konformationelle tilstandsovergange af klasse B GPCR'er, 2019). EN 100 ns-kørsel, der ser konvergeret ud, har muligvis simpelthen ikke samplet den relevante tilstand.
Poseringsnøjagtighed har også et loft. I en 2025 GPCR-peptid benchmark, AlphaFold2 reproducerede korrekte indbindingstilstande i 94% af post-cutoff komplekser (63/67), med interaktionsklassifikation AUC på 0.86 for AF2 versus 0.76 til Chai-1, mens ESMFold og NeuralPLexer slet ikke formåede at berige bindemidler (Benchmark for GPCR-peptidbindingsklassificering, 2025-04-26). Læs det 94% som et benchmarkresultat fra en enkelt kilde, ikke en garanti for dit mål.
|
Model klasse |
Rapporteret præstation |
Antagelsen vil højst sandsynligt bryde |
|---|---|---|
|
MD / fri-energi |
Stabiliserer efter 200-500 ns |
Prøvetagningen er lang nok |
|
AF2 / AF3 |
94% korrekte tilstande; AUC 0.86 / 0.82 |
Benchmark-overførsler til dit peptid |
|
Chai-1, ESMFold, NeuralPLexer |
AUC 0.76; ingen bindemiddelberigelse |
Score spor affinitet |
Fejltilstanden er dokumenteret: re-docking RMSD'er på ca. 5-5,5 Å er blevet rapporteret for ligander, der vides at være aktive (GLP-1R strukturelle determinanter, 2016-04-08).
Trin 3: Design et minimalt variantpanel, der kan forfalske forudsigelsen
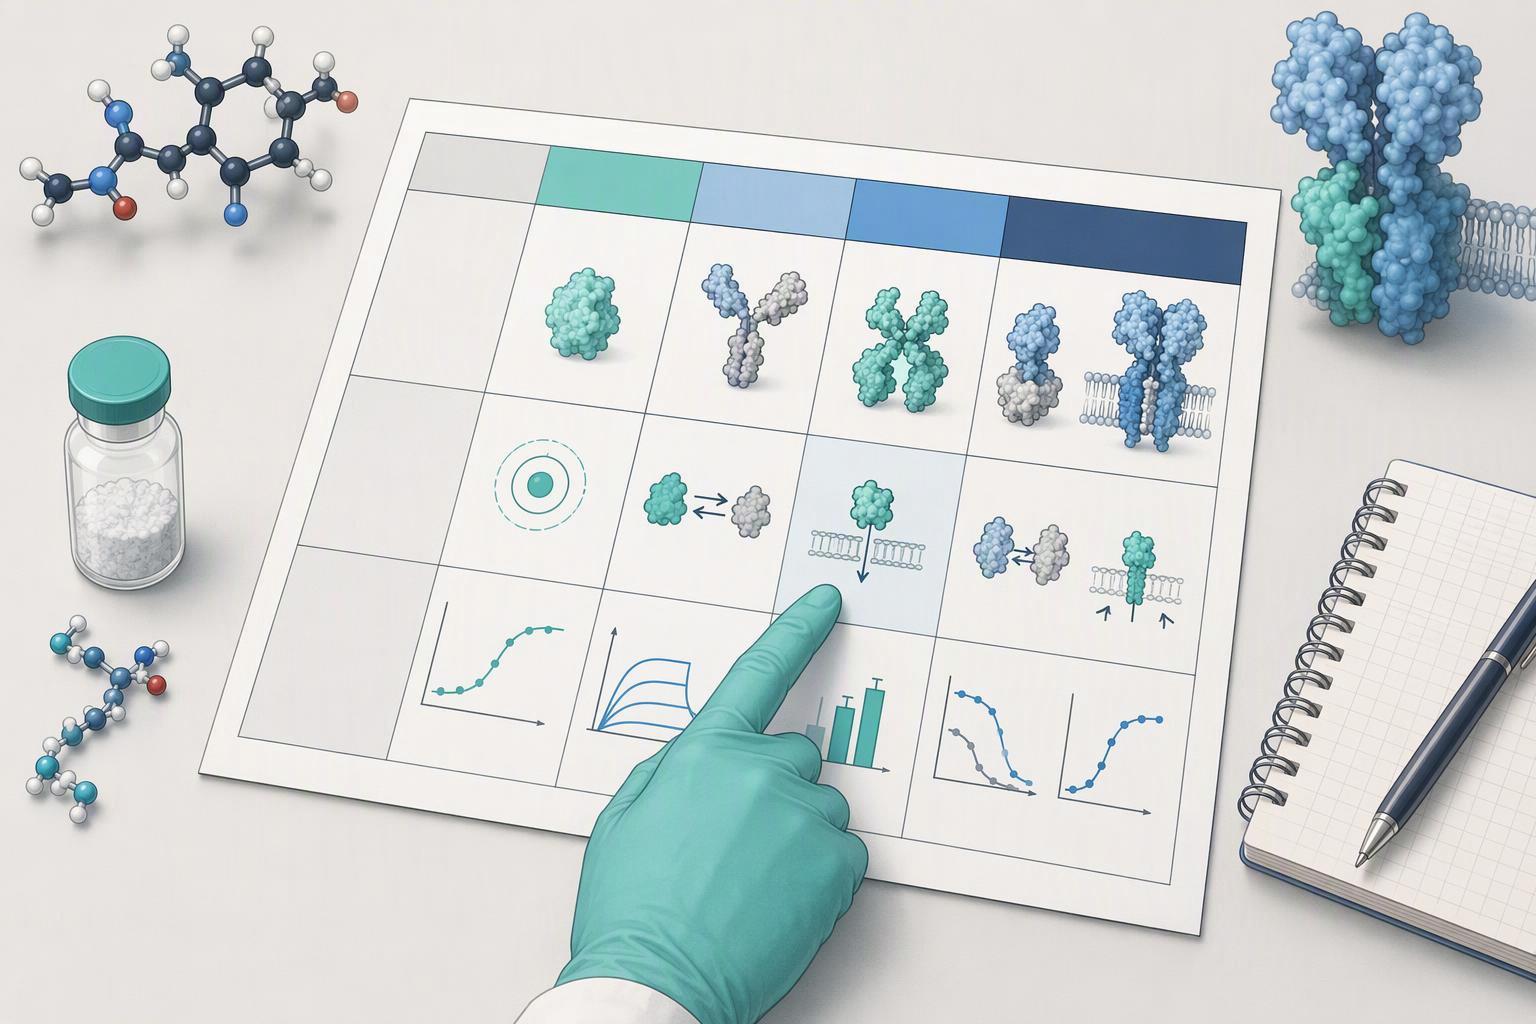
Et panel tjener sine omkostninger, når hver variant kan bevise, at rangeringen er forkert. Tilpas den efter modellens følsomhed, ikke til syntesebudgettet: hvis beregningen hævder at adskille to varianter, mindst ét medlem af panelet skal sidde på denne grænse.
Tre grupper udfører det meste af arbejdet. Enkeltpositionssubstitutioner ved rester, som modellen markerer som kontaktpunkter, tester, om disse kontakter bærer den forudsagte vægt. En N-terminal trunkerings- eller substitutionsserie tester den region, som modellen behandler som afgørende, og det er den gruppe, der oftest er udeladt: SR18-forfatterne bemærkede, at der stadig skulle udføres cellesignalundersøgelser, så den N-terminale adfærd, som deres modellering indebærer, er stadig et åbent spørgsmål snarere end et afgjort input. En modifikationsklasse, der ændrer kemi snarere end sekvens, hæftning, lipidering, eller en D-aminosyrescanning, tester, om forudsigelsen overlever en ændring, som den sekvensbaserede model aldrig blev trænet på.
Brugerdefineret peptidsyntese Behandl resultatet som diskriminerende varianter, ikke et bibliotek. Hvert medlem bør tilknytte én antagelse og én udlæsning, der ville forfalske den.
|
Variant klasse |
Antagelse testet |
Falsificerende udlæsning |
|---|---|---|
|
Kontaktpunktsudskiftning |
Markerede rester driver affinitet |
Skift i afmålt binding |
|
Syntetisk peptidsyntese N-terminal serie |
N-terminal dominerer genkendelse |
Tab eller tilbageholdelse Spps fastfase peptidsyntese af binding |
|
Kemi-ændrende modifikation |
Sekvens alene forudsiger adfærd |
Afvigelse fra forudsagt rang |
Trin 4: Par hver bindende udlæsning med en funktionel
En bindingskonstant fortæller dig, hvor tæt et peptid optager receptoren. Det fortæller dig ikke, hvor stærkt den belægning aktiverer den. Receptorbelægning er fraktionen af GLP-1R-molekyler med et peptid bundet; cAMP-akkumulering er den nedstrøms anden messenger-udlæsning, der rapporterer aktivering; forudindtaget agonisme beskriver ligander, der favoriserer en signalvej frem for en anden, såsom cAMP over β-arrestin-2 rekruttering. Fordi det er separate målinger, en rangordning, der kun er bygget på affinitet, kan inverteres, når du måler funktion.
Tirzepatid illustrerer kløften. Det binder GLP-1R med omtrent 5 gange svagere affinitet end naturligt GLP-1, men er 20 gange mindre potent i cAMP-akkumulering, og i nærvær af humant serumalbumin når dette styrkeskift 81 gange, mens GLP-1(7-36) styrken forbliver uændret (JCI Indsigt, 2020). Styrke og affinitet er ikke udskiftelige, og analysemediet ændrer antallet.
Fordomsfulde agonister udvider kløften yderligere. Native GLP-1 har en cAMP EC50 på 3 pM, mod 29 pM for liraglutid og 343 pM for den partiske dobbeltagonist CT-859, som producerer under 5% β-arrestin-2 rekruttering versus 99% til GLP-1 (PMC, 2025). En forudsagt affinitetsforøgelse, der efterlader cAMP fladt, er et andet resultat end et, der skifter det, og dit panel skal skelne mellem de to.
Bindende affinitet, cAMP styrke, pathway bias og model-klassificering AUC er forskellige endepunkter. Rapporter receptorsystemet, analysebetingelser og komparator med hver værdi; sammenligne numeriske styrker inden for et matchet eksperiment. Observationer af modiontoksicitet for et andet peptid etablerer ikke en GLP-1R-specifik tærskelværdi.
Til tip: Kør det funktionelle assay i det samme medie, som du planlægger at sammenligne på tværs af, da det ovennævnte albuminafhængige styrkeskift er en egenskab ved assaybetingelserne, ikke af peptidet alene.
Trin 5: Behandl referencematerialekvalitet som en variabel i sammenligningen
Din komparator er en måling, og den har sin egen fejl. Før en referencestandard indgår i en GLP-1R sammenligning, bekræfte, hvad det faktisk er. Modform er den mest almindelige skjulte variabel: TFA-saltet af det tetra-forgrenede peptid M33 viste 5-30 % større cytotoksicitet over for normale bronkiale epitelceller end dets acetat-modstykke, og MOG formuleret med TFA-accelereret encephalomyelitis-debut med nogenlunde 5 dage ved sammenlignelig forekomst og sværhedsgrad (Effekterne af modioner på peptidstrukturen, Aktivitet, og funktionalitet, Biomolekyler, 2025). Mekanismen er rutinekemi: Fmoc/tBu SPPS efterfulgt af RP-HPLC giver trifluoracetatsalte, med TFA enten bundet til basiske rester eller adsorberet i lyofilisatet, og USP og EP behandler acetatanionen i peptidlægemidler som en urenhed, hvis niveau skal måles (Mod-ioners rolle i peptider, Et overblik, Lægemidler, 2020).
|
QC attribut |
Hvad skal verificeres |
Analyser det kan skifte |
|---|---|---|
|
Renhed ved HPLC |
Rapporteret metode og integrationstærskel |
Styrke, tilsyneladende affinitet |
|
Counterion identitet |
Acetat vs. TFA, anført på CoA |
Cellelevedygtighed, funktionelle udlæsninger Kunstig Syntetisk polypeptid Peptidsyntese |
|
Resterende TFA |
Målt niveau, antages ikke at være fraværende Syntese af polypeptid |
Cytotoksicitet, proliferationsassays |
|
Partinummer |
Kan spores til en enkelt syntesebatch |
Lot-til-lot sammenlignelighed |
Trin 6: Afstem uenigheden og sæt det næste panel
Når en målt affinitet og en forudsagt placering er uenige, det første spørgsmål er ikke, hvilken model man skal revidere. Det er, om analysen nåede ligevægt. Et bearbejdet GnRH-receptortilfælde viser, hvor langt dette kan gå: -en 2 h inkubation gav en tilsyneladende Kd på 200 pM, mens kinetisk analyse gav 29 pM, fordi radioligand dissociation halvtid var 4 h og fuld ligevægt påkrævet mindst 20 h (Ligandbindingsassays ved ligevægt: validering og fortolkning, Br J Pharmacol, 2010). Den aflæste ikke-ligevægt overestimerede Kd ca. 7 gange, og modellen var aldrig problemet.
Den enkelte sag råder også over en fælles genvej. Det meget gentagne "inden for to-fold" aftalekriteriet understøttes ikke af denne kilde, så det bør ikke bruges som beståelsesmærke for GLP-1R bindingsberegninger.
Lokaliser uenigheden, før du rører ved modellen. Hvis mellemrummet spores til en inkubationstid, en buffer, eller et referenceparti, ændre panelet eller protokollen. Hvis det overlever en ren ligevægtsmåling og gentages på tværs af varianter, ændre modellen.
Ofte stillede spørgsmål
Kan en docking-score erstatte en målt bindingskonstant?
Ingen. En docking-score er et estimat produceret af en scoringsfunktion, og fejlen i dette skøn rapporteres ikke ved siden af det. En målt dissociationskonstant (Kd) er en tilpasset parameter med et konfidensinterval, hvilket er det, der gør det brugbart som en sammenligningsbaseline.
SR18-sagen viser, hvorfor sondringen har betydning i praksis. I det studie, det samme peptid scorede forskelligt mod to receptorkonformere, -en 55 nM resultat mod en og 360 nM mod en anden, og ingen cellebaseret assay blev udført for at bedømme mellem dem. En score, der bevæger sig med næsten en størrelsesorden med startstrukturen, er en hypotese om binding, ikke en måling af det. Brug docking til at rangere kandidater til syntese, lad derefter analysen bestemme.
Hvilket analyseformat skal jeg bruge til en GLP-1R sammenligning?
Vælg, hvad formatet rent faktisk rapporterer. HTRF og Tag-lite konkurrenceanalyser giver ligevægtsaffinitet i et pladeformat og passer til større variantpaneler. Radioligand-konkurrence gør det samme med et andet detektionsprincip, og bærer håndteringsomkostningerne, der følger med radioisotoper. SPR rapporterer kinetik, associations- og dissociationsrater, som fortæller dig, om en styrkeforskel kommer fra hurtigere off-rate eller langsommere on-rate.
Den kinetiske detalje er grunden til at betale for SPR på en shortlist i stedet for et fuldt panel. En advarsel om offentliggjort sammenlignelighed: en konkurrent ansøgningsnotat rapporterer Kd værdier på 0.816 nM og 2.347 nM på to instrumenter uden fejlbjælker, replikater eller n-numre, så behandl numre på tværs af instrumenter som vejledende, indtil du gengiver dem under dine egne forhold.
Hvad hvis min referencestandards parti ændres midt i studiet?
Genkvalificere det nye parti mod det gamle i en enkelt analysekørsel, før det indgår i sammenligningen. Kør begge partier side om side på samme plade, samme dag, samme protokol, og noter styrkeforholdet.
Kontroller analysecertifikatet for renhed, modion og resterende TFA, da enhver af disse kan skifte tilsyneladende styrke uafhængigt af peptidsekvensen. Hvis et styrkeskift følger, ændres partiet, behandle det som en væsentlig effekt på din sammenligning snarere end som en modelfejl. Meget forandring er en variabel, du kan kontrollere; en scoringsfunktion er det ikke.
Konklusion
Løkken er metoden. Definer, hvad dine GLP-1R-bindingsberegninger faktisk forudsiger, revidere forudsætningerne bag rangordningen, designe et variantpanel, der kan forfalske det, par hver bindingsudlæsning med en funktionel, kontrollere komparatorens kvalitet, og afstem uenigheden, før du bestiller det næste panel. Ingen af disse trin er valgfri, fordi en simulering kun bliver nyttig bevis i det øjeblik, en målt udlæsning kan modsige den. Indtil da er det en hypotese med et selvsikkert udseende bord tilknyttet.
Det er også derfor, at komparatoren fortjener samme granskning som modellen. Hvis dit referencemateriale varierer fra parti til parti, den uenighed, du forener, kan tilhøre standarden snarere end forudsigelsen. Et dokumenteret referencemateriale og QC-workflow understøtter denne kontrol: analysecertifikat, renheds- og modiondata, og partisporbarhed registreret sammen med analyseresultatet, så den næste sammenligning starter fra en kendt baseline. Det kan bruges til at holde den målte side af sløjfen lige så auditerbar som den beregningsmæssige side.