步 1: Define What Your GLP-1R Binding Calculations Actually Predict
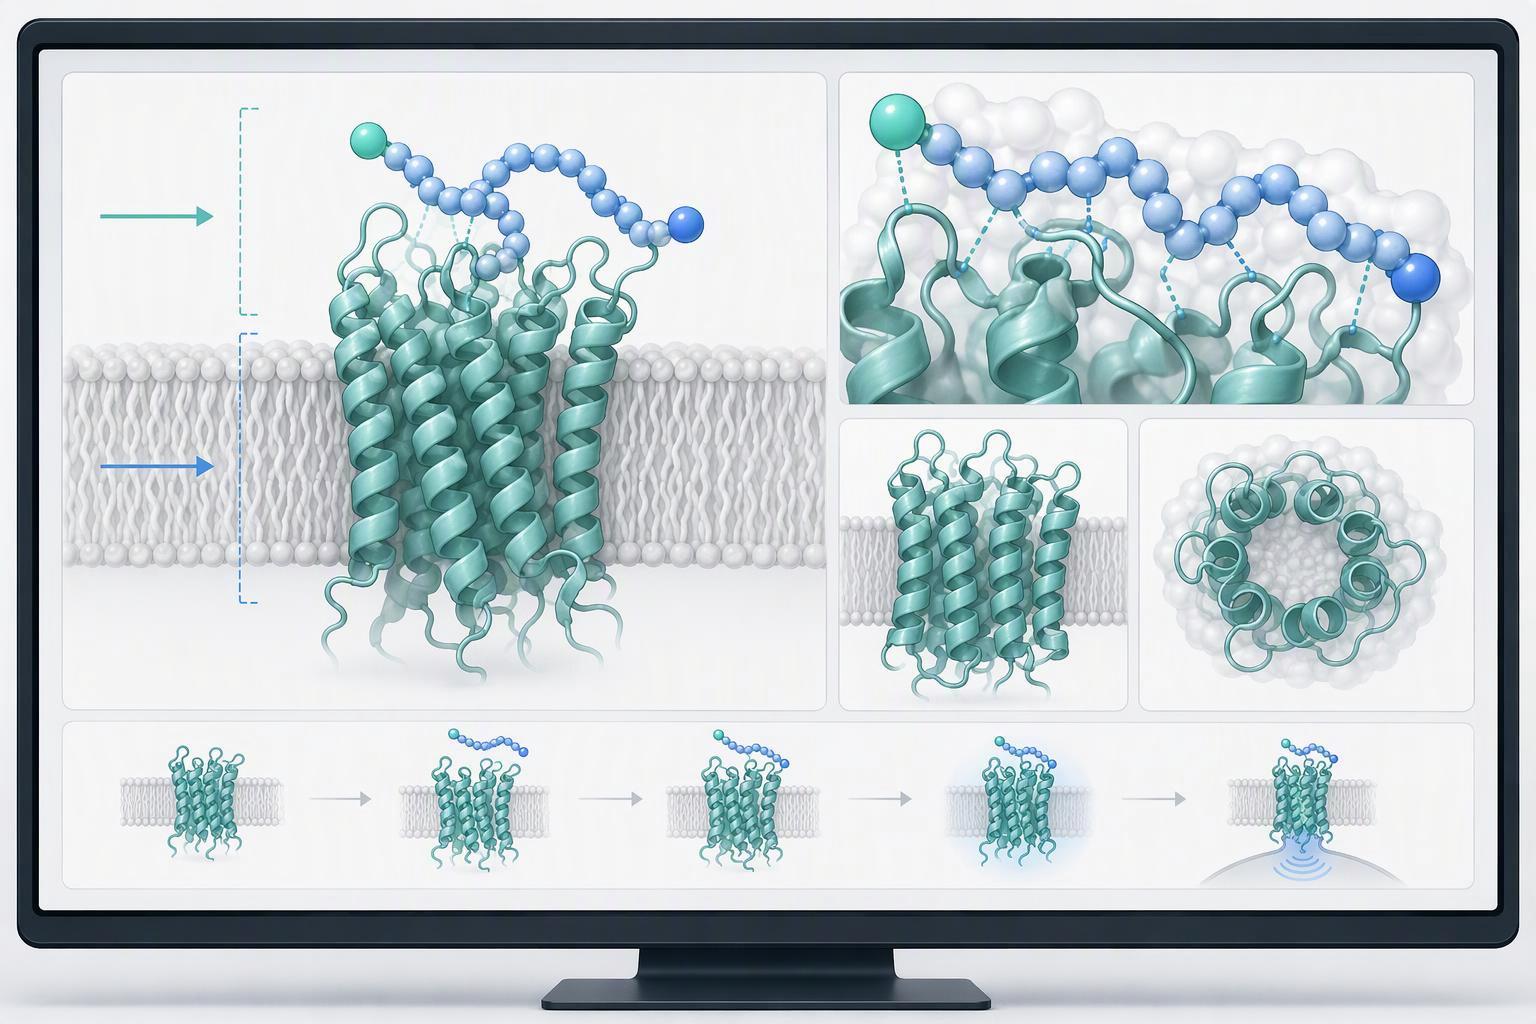
典型的建模运行得出三个不同的数字, 它们的意思并不相同. 一个 对接分数 是一种受体结构中肽的一种姿势的评分函数值; 它对姿势进行排名, 它不衡量亲和力. 一个 预测Kd 该分数是否经过训练回归后看起来像解离常数. 一个 自由能估计 (MM-PBSA, MM-GBSA, 炼金术FEP) 是对帧集合的基于物理的计算, 它带有一个标准差,您应该将其作为数字的一部分来读取.
这些都不是测量的结合常数.
GLP-1R 传播如此广泛的原因是结构性的. B1 类 GPCR 肽识别是一个两域问题: 肽 C 末端与胞外结构域结合,而 N 末端必须进入 7TM 核心才能激活, 因此单个刚性受体姿势不能代表结合状态, 对接对您建模的受体状态敏感 (自然通讯, 2022).
这种敏感性不是学术性的. 在一个 2026 药理学研究前沿, 相同的 18 残基激动剂得分 55 针对一种受体构象异构体的 nM 和 360 nM 对抗另一个 (SR18; PRODIGY 对抗 0 ns 构象异构体与 MD 中心构象异构体). MM-PBSA 过 1 μs MD 给出 -98.79 ± 8.77 kcal/mol SR18 相对于 −167.22 ± 16.20 GLP-1 的千卡/摩尔. 未进行基于细胞的测定.
要点: 分数是具有置信区间的假设, 不是结果. 在对任何内容进行排名之前, 写下哪个受体状态, 哪种方法, 以及哪个误差条产生每个数字.
步 2: Audit the Model Assumptions Before You Trust a Ranking
排名的好坏取决于其背后的假设, 这些假设通常在输出表中不可见. 在您按照预测的订单采取行动之前, 问三个问题: 什么力场和采样方式产生了这个姿势, 模拟运行了多长时间, 以及该模型的实际基准是什么.
抽样是第一名排名突破. B 类 GPCR MD 运行通常仅在 200–500 ns 后稳定, 继续松弛 1.5–2.5 µs, 许多激活过程的持续时间完全超过了传统的 MD 时间尺度 (B 类 GPCR 构象状态转变的评估, 2019). 一个 100 看起来收敛的 ns run 可能根本没有采样相关状态.
姿势准确度也有上限. 在一个 2025 GPCR——肽基准, AlphaFold2 重现了正确的绑定模式 94% 截止后复合体 (63/67), 交互作用分类 AUC 为 0.86 AF2 与 0.76 对于 Chai-1, 而 ESMFold 和 NeuralPLexer 根本无法富集粘合剂 (GPCR——肽结合分类器基准, 2025-04-26). 读一下 94% 作为单一来源基准测试结果, 不能保证你的目标.
|
模型类 |
报告的绩效 |
假设最有可能被打破 |
|---|---|---|
|
医学博士 / 自由能 |
200–500 ns 后稳定 |
采样时间足够长 |
|
AF2 / AF3 |
94% 正确的模式; 曲线下面积 0.86 / 0.82 |
基准转移到您的肽 |
|
柴-1, ESM折叠, 神经分析仪 |
曲线下面积 0.76; 无粘合剂富集 |
分数追踪亲和力 |
故障模式已记录: 据报道,已知活性配体的重新对接 RMSD 约为 5–5.5 Å (GLP-1R 结构决定因素, 2016-04-08).
步 3: Design a Minimal Variant Panel That Can Falsify the Prediction
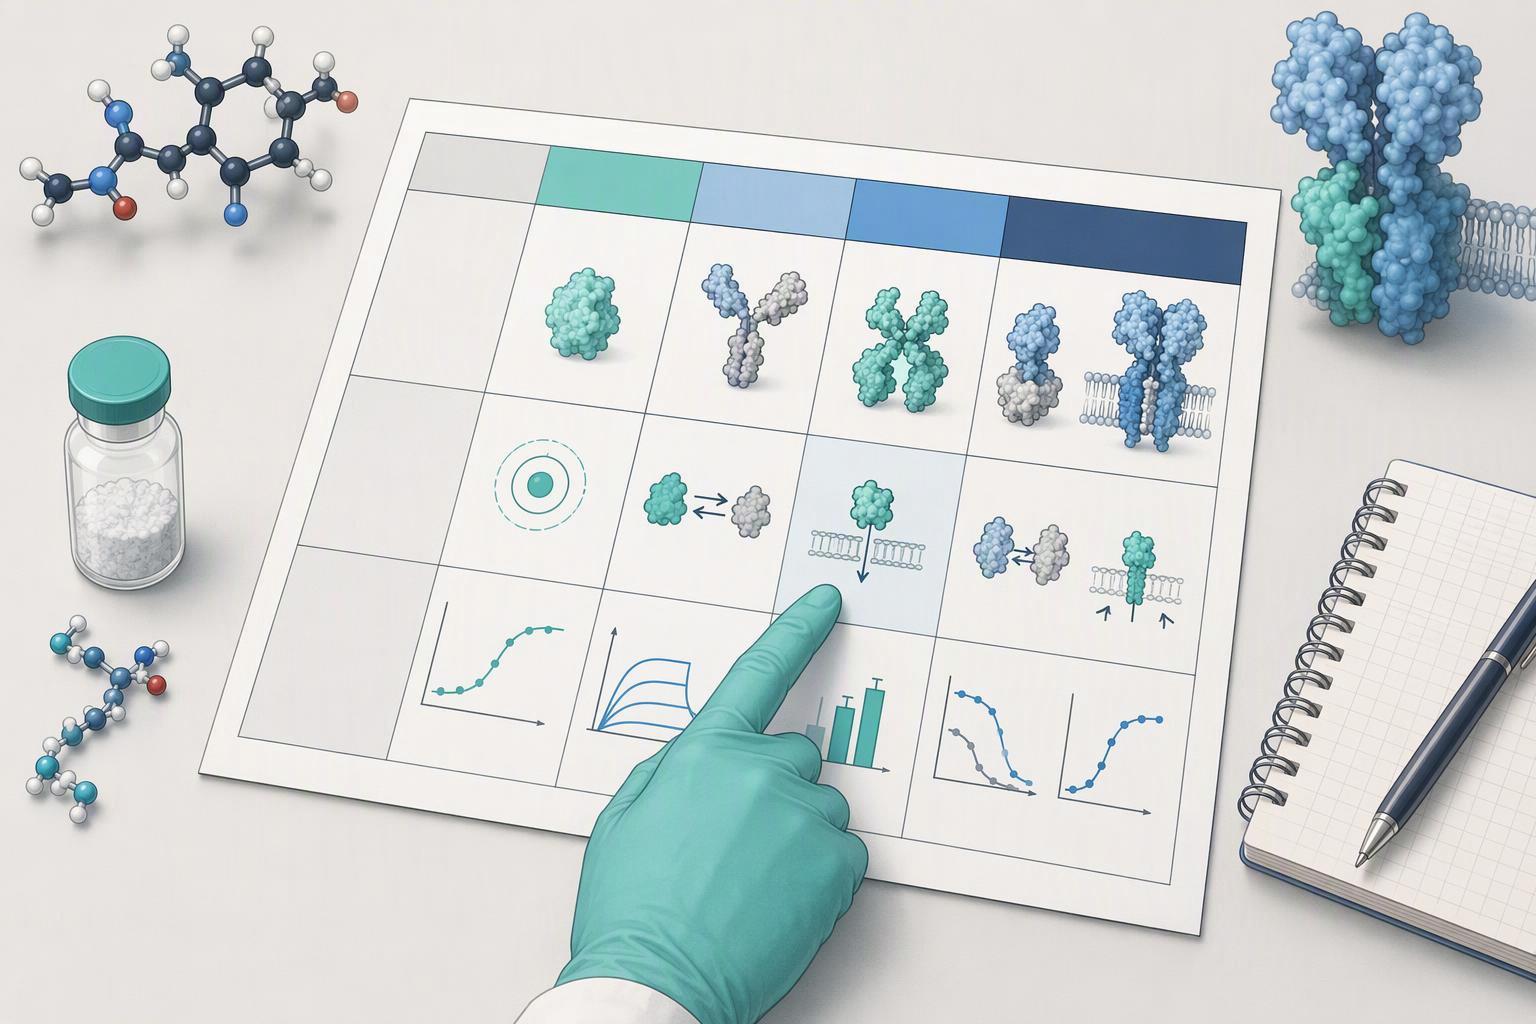
当每个变体都能证明排名错误时,小组就可以获得成本. 根据模型的灵敏度调整其大小, 不属于综合预算: 如果计算声称要分离两个变体, 至少一名小组成员必须坐在该边界上.
三组完成大部分工作. 模型标记为接触点的残基上的单位置替换测试这些接触点是否具有预测的重量. N 端截断或替换系列测试模型视为决定性的区域, 这是最常被忽视的群体: SR18 作者指出细胞信号传导研究仍有待进行, 因此,他们的建模所暗示的 N 端行为仍然是一个悬而未决的问题,而不是一个确定的输入. 一种改变化学而不是序列的修饰类, 装订, 脂化, 或 D-氨基酸扫描, 测试预测是否能经受住基于序列的模型从未接受过训练的变化.
定制肽合成 将结果视为有区别的变体, 不是图书馆. 每个成员都应该映射到一个假设和一个会证伪它的读数.
|
变体类 |
假设经过检验 |
伪造读数 |
|---|---|---|
|
接触点替换 |
标记的残基驱动亲和力 |
测量结合的变化 |
|
合成肽合成 N端系列 |
N 端主导识别 |
丢失或保留 Spps 固相肽合成 绑定的 |
|
化学改变修饰 |
仅序列即可预测行为 |
与预测排名的差异 |
步 4: Pair Every Binding Readout With a Functional One
结合常数告诉您肽占据受体的紧密程度. 它并没有告诉你该占用激活它的强度有多大. 受体占用率是与肽结合的 GLP-1R 分子的分数; cAMP 积累是报告激活的下游第二信使读数; 偏向激动描述了有利于一种信号传导途径而不是另一种信号传导途径的配体, 例如 cAMP 超过 β-arrestin-2 募集. 因为这些是单独的测量, 一旦你衡量功能,仅建立在亲和力基础上的排名可能会发生逆转.
替泽帕肽说明了差距. 它与 GLP-1R 的结合亲和力大约比天然 GLP-1 弱 5 倍,但 cAMP 积累的效力却低 20 倍, 在人血清白蛋白存在的情况下,效力转变达到 81 倍,而 GLP-1(7-36) 效力保持不变 (JCI 洞察, 2020). 效力和亲和力不可互换, 并且测定介质改变了数字.
偏向激动剂进一步拉大差距. 天然 GLP-1 的 cAMP EC50 为 3 下午, 反对 29 利拉鲁肽的下午和 343 偏向双激动剂 CT-859 的 pM, 其产生下 5% β-arrestin-2 募集与 99% 用于GLP-1 (PMC, 2025). 使 cAMP 保持平坦的预测亲和力增益与使 cAMP 发生变化的结果不同, 你的面板必须区分两者.
结合亲和力, 环磷酸腺苷效价, 路径偏差和模型分类 AUC 是不同的终点. 报告受体系统, 测定条件和每个值的比较器; 比较匹配实验中的数值效力. 另一种肽的抗衡离子毒性观察未建立 GLP-1R 特异性阈值.
对于小费: 在您计划比较的相同介质中运行功能测定, 因为上述白蛋白依赖性效力变化是测定条件的一个特性, 不仅仅是肽.
步 5: Treat Reference-Material Quality as a Variable in the Comparison
您的比较器是一种测量, 它有自己的错误. 在参考标准进入 GLP-1R 比较之前, 确认它实际上是什么. 反离子形式是最常见的隐藏变量: 四支链肽 M33 的 TFA 盐对正常支气管上皮细胞的细胞毒性比其醋酸盐高 5-30%, 与 TFA 配制的 MOG 加速脑脊髓炎发作的时间大致相同 5 发生率和严重程度相当的天数 (反离子对肽结构的影响, 活动, 和功能, 生物分子, 2025). 其机理是常规化学: Fmoc/tBu SPPS,然后进行 RP-HPLC,得到三氟乙酸盐, TFA 与碱性残留物结合或吸附在冻干物中, USP和EP将肽类药物中的乙酸根阴离子视为杂质,必须测量其含量 (反离子在肽中的作用, 概述, 药品, 2020).
|
QC属性 |
要验证什么 |
测试它可以改变 |
|---|---|---|
|
HPLC 纯度 |
报告方法和积分阈值 |
效力, 表观亲和力 |
|
抗衡离子身份 |
醋酸纤维 vs. 三氟乙酸, CoA 上注明 |
细胞活力, 功能读数 人造的 合成多肽 多肽合成 |
|
残余三氟乙酸 |
测量液位, 不假定缺席 多肽的合成 |
细胞毒性, 增殖分析 |
|
批号 |
可追溯至单个合成批次 |
批次间可比性 |
步 6: Reconcile the Disagreement and Set the Next Panel
当测量的亲和力与预测的排名不一致时, 第一个问题不是修改哪个模型. 是测定是否达到平衡. 一个有效的 GnRH 受体案例表明这可以走多远: 一个 2 h 孵育后的表观 Kd 为 200 pM,而动力学分析给出 29 下午, 因为放射性配体解离半衰期是 4 h 且至少需要完全平衡 20 小时 (平衡时的配体结合测定: 验证和解释, 药理学杂志, 2010). 非平衡读数高估了 Kd 大约 7 倍, 模型从来都不是问题.
该单个案例还处理了一个常见的快捷方式. 该来源不支持广泛重复的“双重内”一致性标准, 因此它不应该用作 GLP-1R 结合计算的及格分数.
在接触模型之前定位分歧. 如果差距追溯到孵化时间, 一个缓冲区, 或参考批次, 更改面板或协议. 如果它在干净的平衡测量中幸存下来并在变体中重复, 改变模型.
常见问题解答
Can a docking score replace a measured binding constant?
不. 对接分数是由评分函数产生的估计值, 并且该估计的错误不会与其一起报告. 测量的解离常数 (钾) 是具有置信区间的拟合参数, 这就是它可以用作比较基线的原因.
SR18 案例说明了为什么这种区别在实践中很重要. 在那项研究中, 相同的肽针对两种受体构象异构体的得分不同, 一个 55 nM 结果针对 1 和 360 nM 对抗另一个, 并且没有进行基于细胞的测定来裁决它们. 与起始结构移动近一个数量级的分数是关于结合的假设, 不是对其的测量. 使用对接对合成候选进行排名, 然后让分析决定.
Which assay format should I use for a GLP-1R comparison?
选择实际报告的格式. HTRF 和 Tag-lite 竞争测定可在平板形式中提供平衡亲和力,并适合更大的变异组. 放射性配体竞争具有相同的作用,但检测原理不同, 并承担放射性同位素带来的处理开销. SPR 报告动力学, 结合率和解离率, 它告诉您效价差异是来自更快的解离速率还是更慢的结合速率.
这种动态细节是支付 SPR 入围名单而不是完整小组的原因. 关于已发布的可比性的一项警告: 竞争对手的应用说明报告了 Kd 值 0.816 纳摩尔和 2.347 两台仪器上的 nM,没有误差线, 重复或 n 个数字, 因此,将跨仪器数据视为指示性数据,直到您在自己的条件下重现它们为止.
如果我的参考标准在研究过程中发生变化怎么办?
在进入比较之前,在一次检测运行中重新验证新批次与旧批次的质量. 在同一个板上并排运行两个批次, 同一天, 相同的协议, 并记录效价比.
检查纯度分析证书, 抗衡离子和残余 TFA, 因为其中任何一个都可以独立于肽序列改变表观效力. 如果效价变化跟踪批次变化, 将其视为对比较的实质性影响,而不是模型错误. 很多变化是你可以控制的变量; 评分函数不是.
结论
循环就是方法. 定义 GLP-1R 结合计算的实际预测结果, 审核排名背后的假设, 设计一个可以伪造它的变体面板, 将每个结合读数与功能读数配对, 控制比较器的质量, 并在订购下一个面板之前协调分歧. 这些步骤都不是可选的, 因为只有当测量读数与模拟相矛盾时,模拟才会成为有用的证据. 在那之前,这只是一个假设,附有一张看起来自信的表格.
这也是为什么比较器值得与模型同样的审查. 如果您的参考材料因批次而异, 你正在调和的分歧可能属于标准而不是预测. 记录的参考材料和 QC 工作流程支持该控制: 分析证书, 纯度和抗衡离子数据, 并与化验结果一起记录批次可追溯性, 所以下一个比较从已知的基线开始. 它可用于保持循环的测量端与计算端一样可审计.