Schnelle Antwort
Think of precursor selection as a sampling strategy rather than a detector setting. A detector reports what reaches it; the sampling strategy decides what gets…
Was ändert sich tatsächlich durch die erweiterte Vorläuferionenauswahl im Vergleich zur herkömmlichen TopN-DDA??
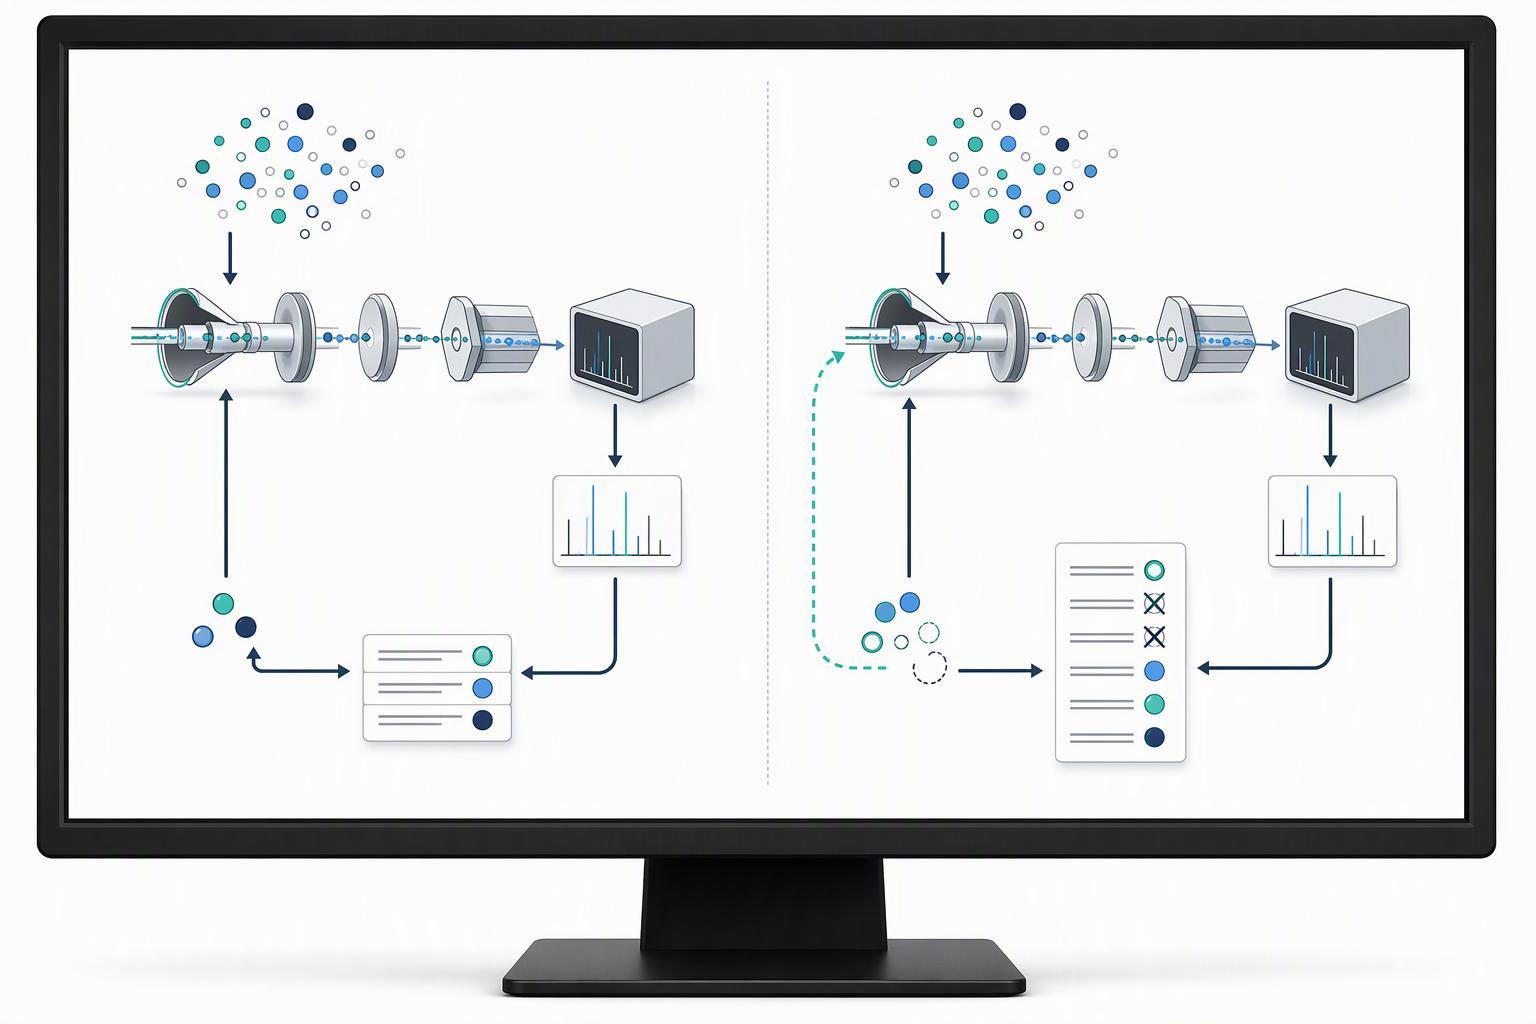
Synthetisches Peptid Peptide Wachstumshormone Es verändert die Sampling-Schleife, nicht der Detektor. Herkömmliche TopN-DDA wählt in jedem MS1-Zyklus die N intensivsten geeigneten Vorläufer aus, und der dynamische Ausschluss verhindert eine sofortige Neuauswahl, Daher bleibt die Auswahl weitgehend intensitätsgesteuert und es werden immer wieder reichlich vorhandene Peptide entnommen (Kreimer et al., J Proteome Res, 2016). Das Instrument funktioniert ordnungsgemäß; Die Strategie kehrt einfach immer wieder in die gleiche Nachbarschaft zurück.
Kreimer et al. verglichen zwei iterative Ausschlussstrategien: Ausschluss aller zuvor fragmentierten Vorläufer und Ausschluss nur identifizierter Peptide. Dabei handelt es sich um unterschiedliche Designs mit unterschiedlichen Ergebnissen. Beschreiben Sie, welche Ausschlussliste verwendet wurde, bevor Sie den Gewinn angeben, und behalten Sie den HeLa-Digest und den LTQ Orbitrap XL-Bereich der Studie bei. Originalstudie.
Eine dritte Variante treibt die Ausgrenzung weiter voran: Die Echtzeit-Datenbanksuche während der Erfassung ermöglicht den Ausschluss anhand der Peptididentität und nicht anhand eines m/z- und Zeitereignisses. Frühe Simulationsarbeiten zur adaptiven Peakauswahl ergaben, dass dies höchstens etwa a zunahm 1% Vorteil gegenüber der standardmäßigen Ausschlusslistenauswahl (arXiv-Vorabdruck 1207.5848, n.d.). Behandeln Sie diese Zahl als Simulationsergebnis, kein Maßstab, und zitieren Sie es nicht als gemessenes Instrumentenergebnis.
Im zitierten 2016 Studie, die herkömmliche TopN-Sättigung nahe 12,500 einzigartige Peptide war eine Extrapolation. Die kombinierten iterativen Ausschlussexperimente wurden übertroffen 16,000 Identifikationen. Der Vergleich veranschaulicht die komplementäre Stichprobe im Rahmen dieses Entwurfs, kein universelles 29% Gewinn gegenüber einer angepassten Single-Run-Steuerung.
Durch die Suche nach co-isolierten Arten kann die Identifizierungstiefe in den zitierten Arten erhöht werden 2025 Studie. Die gemeldeten Prozentsätze verwenden unterschiedliche Vergleiche und müssen ihre eigenen Nenner beibehalten; Sie sollten nicht zu einem Durchschnitt kombiniert werden, der einen angegebenen Bereich überschreitet, oder mit iterativen Ausschlussgewinnen zusammengeführt werden.
Die Auswahl der Vorläufer beeinflusst, welche Fragmentierungsnachweise erfasst werden. In MS1-Daten ist möglicherweise immer noch ein unfragmentiertes Feature vorhanden; Ohne ausreichende Belege kann ihr keine gleichwertige Sequenzkonfidenz zugewiesen werden. Durch eine verbesserte Suche können Informationen wiederhergestellt werden, die bereits in erfassten Spektren vorhanden sind.
Warum kann die Überlappung zwischen technischen Replikaten gering sein, ohne dass die Methode nicht reproduzierbar ist??
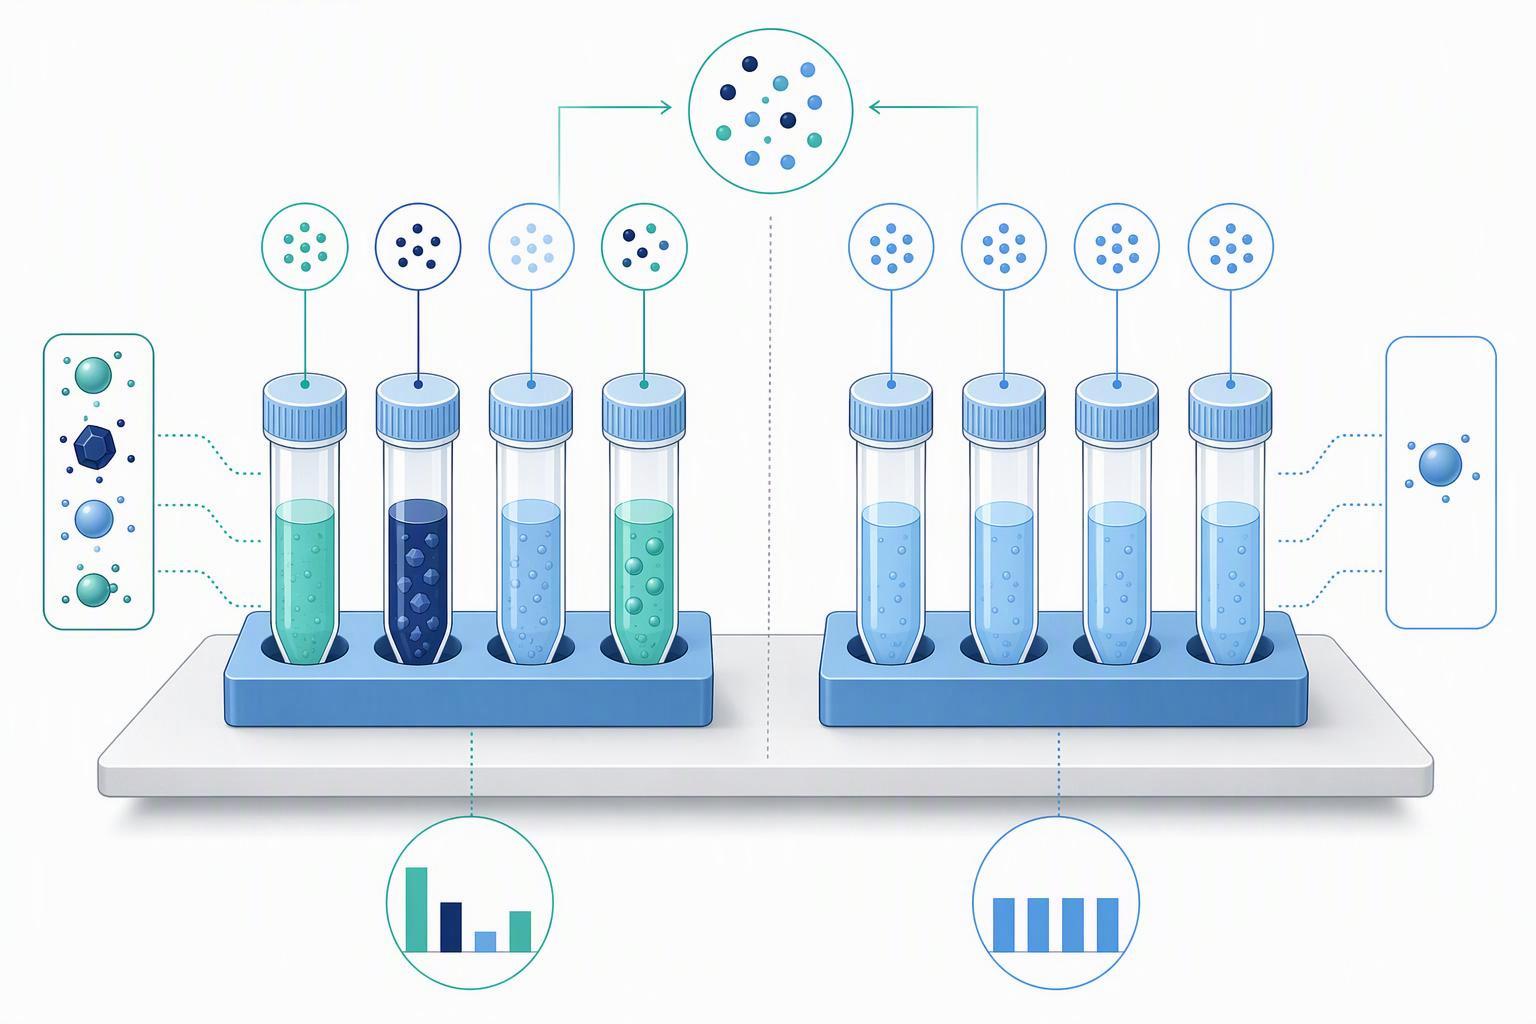
Denn geringe Überlappung und schlechte Reproduzierbarkeit sind unterschiedliche Messungen, und ein entdeckungstiefes Design kann das erste erzeugen, während die Methode perfekt wiederholbar bleibt. Der langjährige Bereich für die Überlappung von Replikatpeptiden bei konventioneller DDA beträgt 35–60 % zwischen Paaren technischer Replikate, eine Figur, die aus a stammt 2010 Neuanalyse auf LTQ und älteren Orbitrap-Instrumenten (Tabb et al., J Proteome Res, 2010). Diese Studie ergab auch, dass die Überlappung unabhängig von der Komplexität der Stichprobe war: Eine 48-Protein-Mischung ergab einen Median 44% überlappen, eine Protein-Standardmischung 46%, und ein Hefeverdau 45% (Tabb et al., J Proteome Res, 2010). Die Wiederholbarkeit korrelierte mit der Vorläuferintensität, Daher waren es die Peptide, die in geringer Menge vorhanden waren und ausfielen.
Das ist der entscheidende Unterschied. Wenn Ihr Replikatdesign die Probe konstant hält und nur die Injektion variiert, Geringe Überlappung bedeutet, dass die Methode stochastisch abtastet, was für DDA erwartet wird. Wenn Ihr Design die Reproduzierbarkeit demonstrieren soll, Sie müssen angeben, was konstant und was unterschiedlich ist, und die Anleitung des MCP-Autors erfordert genau das: die Anzahl der erworbenen Replikate mit einer klaren Unterscheidung zwischen biologischen, Prozess- und technische Nachbildungen, sowie die Methode und Art der Randomisierung, technische Kontrollen, und die Zeitspanne der Probenanalyse (MCP-Anweisungen für Autoren).
Zwei kürzlich durchgeführte unabhängige Experimente zeigen, wie stark das Überlappungsproblem von der Akquise abhängt. Ein direkter DDA-versus-DIA-Vergleich in denselben Proben ergab mehr als 92% von Peptiden, die in den DIA-Daten konsistent über Replikate hinweg identifiziert wurden, im Vergleich zu weniger als 77% in DDA-Daten, mit proteinhaltiger Konsistenz von 99.0/98.2/98.2% für DIA dagegen 95.6/95.4/96.2% für DDA (PMC12801617, 2025). Ein achtfacher Vollständigkeitsvergleich in Tränenflüssigkeit ergab DIA bei 78.5% Peptidvollständigkeit versus 48% für DDA, mit mittleren Lebensläufen von 10.6% Und 22.3% jeweils (J Mass Spectrom Adv Clin Lab, 2025). Zwei verschiedene Metriken, Anwesenheits-/Abwesenheitskonsistenz und Variationskoeffizient, zeigen in die gleiche Richtung.
Die ehrliche Lücke: Keine Quelle in diesem Set misst das erneut 2010 Überlappungsfigur bei aktueller Instrumentierung. Der Bereich von 35–60 % sollte bei jeder Angabe datiert werden, und die DIA-versus-DDA-Beweise beziehen sich nur auf Zelllinien und Tränenflüssigkeit. Keine Quelle hier vergleicht die beiden Modi an einem Phosphoproteom oder einer anderen PTM-angereicherten Probe, Daher wäre jede Behauptung über DIA im Vergleich zu DDA für modifizierte Peptide nicht unterstützt.
Vor der Übernahme, zwischen einem Discovery-Depth-Design und einer Wiederholbarkeitsstudie unterscheiden. Eine geringe Überlappung nach bewusstem Ausschluss kann auf eine komplementäre Stichprobe hinweisen, sondern überprüfen Sie auch die Vertrauenswürdigkeit der Identifizierung, Gesamtabdeckung und Probenqualität; Eine geringe Überlappung allein beweist nicht, dass die Strategie funktioniert.
Wie viel Sequenzabdeckung ist ausreichend?, und wo muss die Deckung liegen??
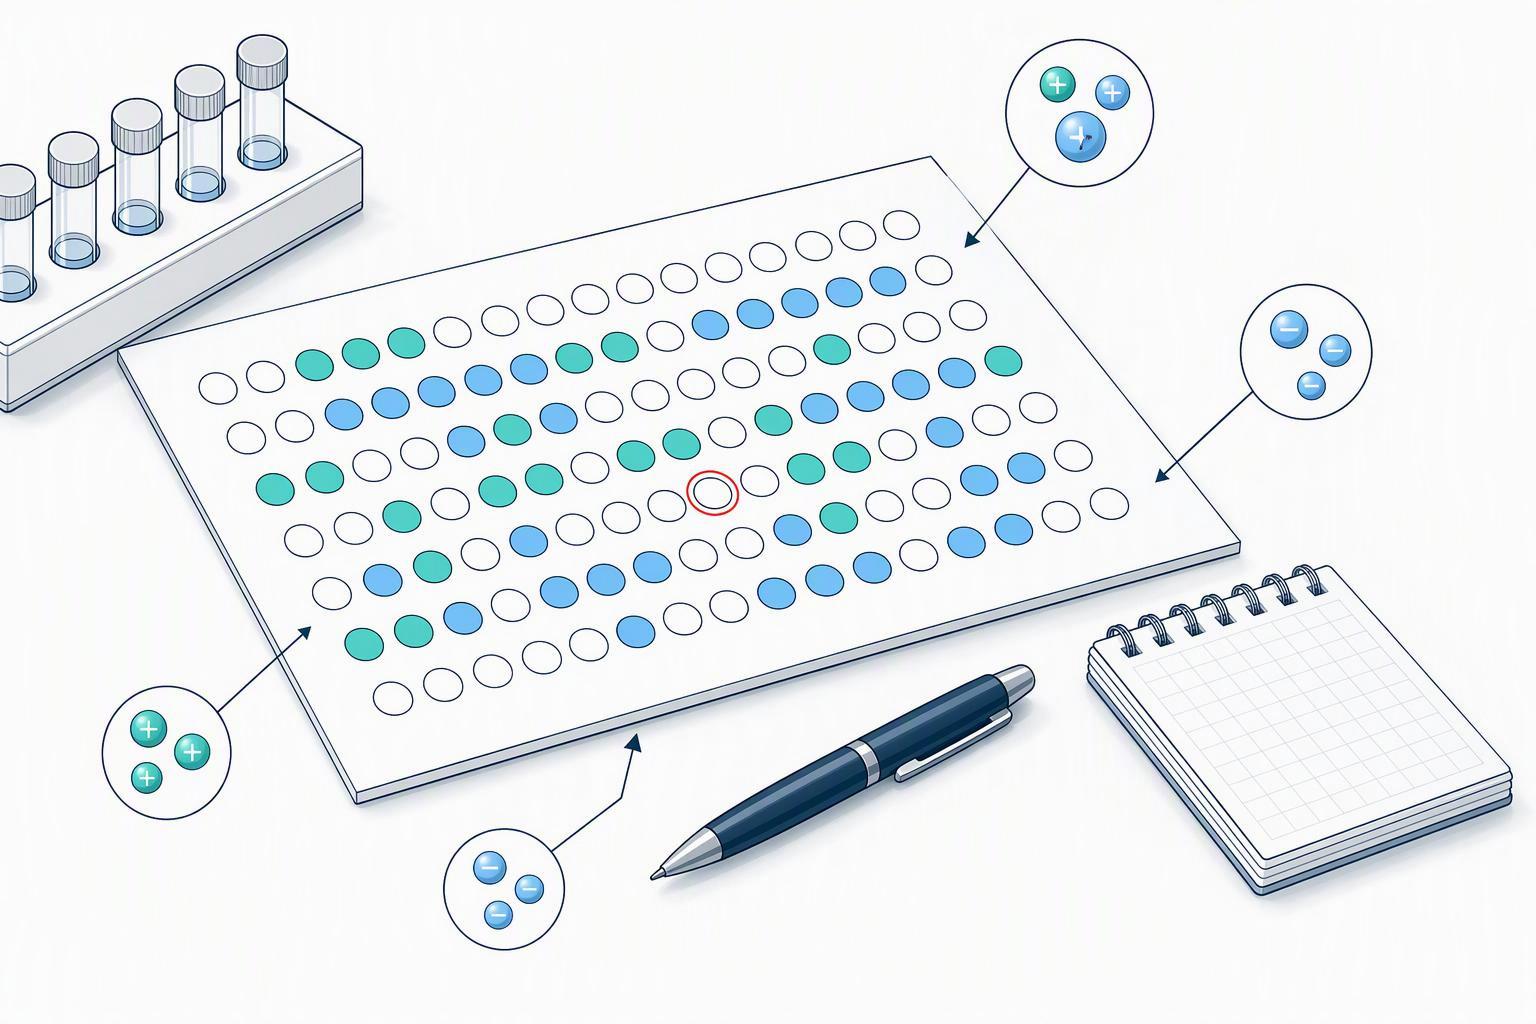
Definieren Sie die Abdeckungsmetrik, bevor Sie ein Kriterium festlegen. Die Proteinsequenzabdeckung zählt Reste, die durch identifizierte Peptide repräsentiert werden; Die Fragment-Ionen-Abdeckung eines synthetischen Peptids ist ein anderes Maß. Keiner der Prozentsätze allein legt die Reihenfolge der Reste fest, Modifikationsposition oder Stereochemie. Legen Sie die erforderlichen Diagnoseionen und orthogonalen Tests für das Konstrukt fest.
Aus dieser Definition ergibt sich die Platzierungsregel. Für ein modifiziertes oder markiertes Peptid, Die Abdeckung muss den Rückstand umfassen, der die Modifikation oder das Etikett trägt. A 95% Abdeckungskarte, die den geänderten Standort unbedeckt lässt 5% unterstützt keinen standortspezifischen Identitätsanspruch, Egal wie hoch der Prozentsatz aussieht.
Das ist Anbieterpraxis, kein regulatorischer Schwellenwert, und es sollte in jeder von Ihnen verfassten Spezifikation als solches gekennzeichnet sein.
Worauf Sie ein Prüfer tatsächlich hinweisen kann, ist der Berichtssatz. Die Zeitschriftenrichtlinien, an die sich ein Leser halten kann, erfordern Massentoleranzen für Vorläuferionen und Fragmentionen, die Suchmaschine und Version, die Datenbank, die FDR-Schätzmethode, und die Software oder Methode, die zur Bewertung der Zuordnung des Änderungsorts verwendet wird, mit kommentierten Spektren für jedes Peptid, bei dem eine Modifikationsstelle angegeben ist (MCP-Tutorial für die Übermittlung von Proteomics-Daten, Leitfaden für MCP-Autoren). Die Checkliste mit den Mindestinformationen fügt den Namen der Software hinzu, Version und Hersteller, Datenbanken mit Versionen und Eintragszahlen abgefragt, und die Parameterdateien (MIAPE-MSI 1.1, 2008-02-05). MIAPE ist das 2008 Checkliste und bleibt bei der Version 1.1; Es handelt sich nicht um eine neue Anforderung.
Die praktische Antwort auf die Frage „Welche Deckungszahl wird ein Gutachter akzeptieren?“ lautet also: Geben Sie den Schwellenwert an, den Sie angewendet haben, Staat, in dem die Deckung relativ zu fällt Semaglutid-Peptid der modifizierte Rückstand, und geben Sie die Parameter an, die es jemandem ermöglichen, die Berechnung zu reproduzieren. Eine Zahl ohne diese drei Dinge ist nicht vertretbar.
Wie kann man eine Änderung oder ein Etikett lokalisieren, anstatt nur die intakte Masse zu bestätigen??
Die Lokalisierung ist eine von der Identifizierung getrennte Messung, mit eigener Partitur, einen eigenen Schwellenwert und eine eigene Fehlerrate. Die kombinatorische Grundlage dafür, warum Masse allein keinen Identitätsanspruch begründen kann, ist alt und sicher: unter Peptiden, die sich in ihrer Zusammensetzung um eins unterscheiden, zwei oder drei Aminosäuren, 10%, 29% Und 53% haben jeweils massenidentische Isomere, und ohne Leucin/Isoleucin-Isomere sind die Zahlen 14% Und 38% (Er et al., J Proteome Res, 2004). Diese isomeren Peptide können nicht anhand der Masse unterschieden werden, und Tandem-Massenspektrometrie oder andere zusätzliche Einschränkungen sind erforderlich.
Lokalisierungsbewertungen funktionieren durch den Vergleich ortsbestimmender Fragmente. Eine aktuelle Implementierung vergleicht die am besten bewertete Peptidoform mit der Modifikation an einer Stelle mit der am besten bewerteten Peptidoform ohne diese, ignoriert gemeinsame Peaks, da sie keine Diskriminierung bieten, und fördert die Lokalisierungssicherheit nur bei unterscheidenden Spitzenwerten (PTMProphet, 2019). Bei dieser Implementierung wurde die Lokalisierung bei iProphet-Wahrscheinlichkeitsschwellenwerten von angewendet 0.9 für zwei Datensätze und 0.8 für ein Drittel, Letzteres entspricht 0.4% geschätzter PSM-Fehler und 97.9% PSM-Empfindlichkeit, und berichtete über die Ergebnisse unter 5% Falschlokalisierungsrate und darunter 1% FLR (PTMProphet, 2019).
Die klassischen Lokalisierungsschwellenwerte sind punktebasiert und sollten nicht als universelle Akzeptanzkriterien betrachtet werden. AScore 19 entspricht ungefähr p 0.01, oder 99% Sicherheit, und später verwendete die Phosphoproteomik-Praxis aus demselben Labor ein liberaleres p < 0.05, AScore > 13; Spectrum Mill erfordert einen Punkteunterschied von mehr als 1.1 zwischen den beiden besten Lokalisierungen für eine sichere Lokalisierung (Lokalisierungsbewertung der Änderungsstelle, 2012). In derselben Rezension wird davor gewarnt, dass wahrscheinlichkeitsbasierte Bewertungen auf der unrealistischen Annahme beruhen, dass alle Massen mit gleicher Wahrscheinlichkeit zufällig beobachtet werden, und empfiehlt, sie als Bewertungen zu behandeln, die einem vom Benutzer festgelegten Schwellenwert unterliegen, und nicht als genaue Maßstäbe für die Sicherheit.
Diese Warnung wird durch die tatsächliche Wahl der Schwellenwerte bestätigt. PTMProphet beschreibt die Auswahl des Lokalisierungswahrscheinlichkeitsschwellenwerts als weitgehend willkürliche Entscheidung des Benutzers, durch die vom Benutzer akzeptierte Fehlerrate festgelegt werden (PTMProphet, 2019). Kein Standard legt eine Zahl fest, Der vertretbare Schritt besteht also darin, den Schwellenwert anzugeben, Geben Sie die entsprechende Fehlerrate an, und geben Sie neben der Identifizierungsrate auch die Lokalisierungsrate an.
Für ein markiertes Peptid, Eine erwartete Verschiebung der intakten Masse stützt eine vorgeschlagene Zusammensetzung, beweist jedoch nicht die Chemie der Markierung oder die Bindungsstelle. Verwenden Sie ortsbestimmende Fragmente und, wo nötig, eine orthogonale Strukturmethode zum Testen der vorgeschlagenen Markierung und Verknüpfung.
Welche orthogonale Technik beantwortet welche Identitätsfrage??
Jede Technik beantwortet eine andere Frage, und die Zuordnung ist wichtiger als die Anzahl. Der 2025 Europäische Richtlinie für synthetische Peptide, in Kraft seit Juni 2026, empfiehlt die Verwendung von mindestens zwei orthogonalen Methoden zur Identifizierung im Rahmen der Spezifikation und Freigabe, und listet Masse auf, relative Retentionszeit, LC-MS, Peptidkartierung, Bioaktivität, Aminosäureanalyse oder NMR, je nach Bedarf, mit der Kombination, die zur eindeutigen Bestätigung der Sequenz erforderlich ist (EMA, Richtlinie zur Entwicklung und Herstellung synthetischer Peptide, 2025-12-04, wirksam 2026-06-01).
Die zugrunde liegende Regulierungslogik ist eher leistungsbasiert als numerisch. ICH Q2(R2) erfordert eine Identifizierung, um die Fähigkeit zu demonstrieren, den Analyten anhand einzigartiger molekularer Strukturaspekte zu unterscheiden, bestätigt durch positive Ergebnisse gegenüber einem Referenzmaterial sowie negative Ergebnisse aus Proben, denen der Analyt fehlt, und wenn ein Verfahren nicht ausreichend diskriminierend ist, Es sollte ein zusätzliches Verfahren angewendet werden (ICH Q2(R2), angenommen 2023-11-01, korrigiert 2023-11-30). Die Spezifitätsanforderung ist eine Fähigkeitsprüfung, keine Zählung der Tests.
Die Praxis der Referenzstandards für die Peptididentität konvergiert in die gleiche Richtung, ohne eine Zahl festzulegen: Zur Überprüfung der chemischen Struktur und chemischen Identität werden typischerweise mehrere orthogonale Techniken verwendet, inklusive HPLC-Retentionszeit, NMR, MS- und Chiralitätstests, und Multilaborstudien verwenden NMR, Peptidkartierung, HPLC und Aminosäureanalyse (Pharmazeutische Forschung, 2023). Die HPLC-Identität beruht in dieser Praxis auf dem Vergleich der Retentionszeit mit einem Referenzstandard, weshalb eine Aufbewahrungszeit ohne Standard kein Identitätsergebnis ist.
Die Zuordnung von Methode zu Frage Großhandelslieferant für Peptide folgt aus diesen Quellen:
|
Identitätsfrage |
Technik, die darauf antwortet |
Worauf es nicht antwortet |
|---|---|---|
|
Ist die intakte Masse korrekt?? |
LC-MS oder MALDI-TOF intakte Masse |
Sequenz, Positions- oder stereochemische Merkmale |
|
Stimmt die Reihenfolge?? |
MS/MS mit Sequenzabdeckung, oder Peptidkartierung |
Labile Modifikationen, teilweise Deckungslücken |
|
Wo ist die Änderung oder das Etikett?? |
Standortbestimmende MS/MS-Fragmente mit einem angegebenen Lokalisierungsschwellenwert |
Ob die Site funktional relevant ist Melittin |
|
Stimmt die Stereochemie?? |
Validierte chirale Analyse; Mit der gewöhnlichen Analyse der Aminosäurezusammensetzung allein lässt sich keine Stereochemie feststellen |
Position einer Änderung |
|
Ist es das gleiche Material wie der Standard?? Kundenspezifischer Peptid-Großhandel |
HPLC-Retentionszeit gegenüber einem Referenzstandard |
Alles, was der Standard selbst nicht festlegt |
Die COA-Überprüfungsgewohnheit, jede Schlussfolgerung mit ihrer Methode beizubehalten, ist die praktische Version dieser Tabelle: Die chromatographische Reinheit beschreibt die chromatographische Homogenität und begründet nicht unabhängig die chemische Identität, Eine intakte Masse allein kann möglicherweise nicht jede Sequenz begründen, Positions- oder stereochemisches Merkmal, Identität und Reinheit sollten separat angegeben und den Methoden zugeordnet werden, die sie unterstützen (Vector E Lab, 2026-09-28).
Was muss vor dem Erwerb niedergeschrieben werden, damit der Identitätsanspruch vertretbar ist??
Der Datensatz muss so vollständig sein, dass jemand anderes dieselbe oder eine ähnliche Suche in derselben oder einer anderen Suchmaschine erneut ausführen kann. Das Austauschformat, das das Suchprotokoll trägt, erfordert, dass das SpectrumIdentificationProtocol einen Suchtyp deklariert, z. B. eine Bewertung auf Peptidebene oder eine Bewertung der Modifikationslokalisierung, erfordert, dass Suchmaschinen in der Softwareliste vertreten sind, und ist genau auf diese Reproduzierbarkeit ausgelegt (mzIdentML 1.3.0, Juni 2024).
Der Datensatz vor der Akquisition, zusammengestellt aus den oben genannten Berichtsstandards:
-
Auswahlstrategie und ihre Parameter. TopN-Wert, Isolationsfenster, dynamische Ausschlussdauer, und ob eine Ausschlussliste zwischen Läufen übertragen wird.
-
Toleranzen. Massentoleranz für Vorläufer und Fragmente, als Zahlen angegeben. Der 2016 Studie verwendet 10 ppm und 0.5 Und (Kreimer et al., J Proteome Res, 2016); Die Genauigkeit auf Instrumentenebene, an die die Methode angepasst werden sollte, ist unten aufgeführt 3 ppm RMS über 24 h mit externer Kalibrierung und darunter 1 ppm RMS mit interner Kalibrierung auf einer aktuellen Orbitrap-Plattform (Datenblatt von Thermo Fisher, Derzeit veröffentlichtes Lieferantenblatt).
-
Suchmaschine und Version, Datenbank und Version mit Eintragsanzahl, und die FDR-Schätzmethode. Die Suche nach Täuschkörpern ist die akzeptierte Methode, um richtige von falschen Identifizierungen zu unterscheiden, und weil die meisten Suchmaschinen auch für unübertroffene Spektren Ergebnisse liefern, Fehlerraten müssen aus der Punkteverteilung geschätzt werden (Elias & Gygi, Naturmethoden, 2007). Die Konfidenz pro Peptid beruht auf einem probabilistischen Modell, das die Wahrscheinlichkeit berechnet, dass jede Zuordnung korrekt ist, Ermöglicht Filterung mit vorhersehbaren Fehlerraten (Keller et al., Anal Chem, 2002).
-
Die Site-Zuweisungsmethode und ihr Schwellenwert, mit kommentierten Spektren für jedes Peptid, bei dem eine Modifikationsstelle angegeben ist.
-
Struktur replizieren. Anzahl der Replikate, und ob sie biologisch sind, Prozess oder technisch.
-
Die Archiv-ID. PXD-Kennungen sind persistent, eindeutig und obligatorisch als Hauptkennung für ursprünglich übermittelte Datensätze, mit Metadaten sowie gemeinsam hinterlegten Roh- und verarbeiteten Dateien, und RPXD-Kennungen für erneut analysierte Datensätze (ProteomeXchange-Konsortium, Nukleinsäureforschung, 2026-01-06).
Die Entscheidungsregel, vor dem Erwerb angewendet werden: wenn Sie die Auswahlstrategie nicht aufschreiben können, die Toleranzen, die Suchparameter, die Lokalisierungsschwelle und die Replikatstruktur im Voraus, der Identitätsanspruch ist danach nicht mehr vertretbar. Jedes dieser Felder ist eine Entscheidung, und es ist billiger, jedes einzelne vor dem Lauf herzustellen, als es danach wieder aufzubauen.
Häufig gestellte Fragen
Bedeutet eine geringe Überlappung zwischen technischen Replikaten, dass meine Methode schlecht ist??
Nicht unbedingt. Herkömmliche DDA wählt in jedem Zyklus nur die intensivsten Vorläufer aus, Eine geringe Überlappung zwischen Replikaten ist daher eher ein erwartetes Probenahmeverhalten als ein Reproduzierbarkeitsfehler (Tabb et al., J Proteome Res, 2010). Es stellt sich die Frage, was das Replikatdesign demonstrieren sollte.
Darf ich das zitieren? 29% Wert als allgemeiner Maßstab?
NEIN. Es kommt von einem 2016 Studie an einem LTQ Orbitrap XL mit einem HeLa-Digest und einem 120 min. Gefälle (Kreimer et al., J Proteome Res, 2016). Zitieren Sie es mit dem beigefügten Umfang, oder geben Sie den Mechanismus qualitativ an.
Welche Sequenzabdeckung sollte ich in eine Spezifikation eintragen??
Es gibt kein aufsichtsrechtlich festgelegtes Minimum. Geben Sie den Schwellenwert an, den Sie angewendet haben, Bestätigen Sie, dass die Abdeckung auch die Rückstände mit der Änderung oder dem Etikett umfasst, und geben Sie die Suchparameter an, die es einem Prüfer ermöglichen, die Berechnung zu reproduzieren.
Reicht die intakte Masse aus, um die Identität zu bestätigen??
NEIN. Unter Peptiden, die sich um eins unterscheiden, zwei oder drei Aminosäuren, 10%, 29% Und 53% haben massenidentische Isomere (Er et al., J Proteome Res, 2004). Masse ist eine orthogonale Methode, kein vollständiger Identitätsanspruch.
Benötige ich genau zwei orthogonale Methoden??
Der 2025 Die europäische Richtlinie empfiehlt mindestens zwei für die Identifizierung synthetischer Peptide (EMA, wirksam 2026-06-01), während ICH Q2(R2) formuliert die Anforderung als spezifitätsbasiert und nicht als feste Anzahl (ICH, 2023). Die Kombination muss die Reihenfolge eindeutig bestätigen; daraus ergibt sich die Zahl.
Abschluss
Der Identitätsanspruch wird vor dem Erwerb aufgebaut, nicht danach. Die Strategie der Vorläuferauswahl entscheidet darüber, welche Peptide untersucht werden, Das Replikatdesign entscheidet darüber, ob die Überlappung informativ oder zufällig ist, Das Coverage Reporting entscheidet darüber, ob sich der veränderte Rückstand tatsächlich im Beweismittel befindet, und die orthogonale Charakterisierung entscheidet darüber, ob die Behauptung einen Rezensenten überlebt, der weiß, dass allein die Masse Isomere ungelöst lässt.
Der nächste Schritt ist eine Voraberfassung: Auswahlstrategie, Toleranzen, Suchparameter, Lokalisierungsschwelle, Replikatstruktur und Archiv-ID, vor der ersten Injektion aufgeschrieben und versioniert. Falls ein Feld fehlt, Beheben Sie das Problem vor der Ausführung und nicht in der Antwort an einen Prüfer.
Für Teams, die Serviceumfänge für benutzerdefinierte vergleichen, modifizierte und markierte Peptide, Fordern Sie ein Angebot an, in dem die oben genannten Analyseparameter und nicht nur die Reinheitszahl aufgeführt sind.
Bei den zitierten Analysestandards und Methodenvergleichen handelt es sich um unabhängige veröffentlichte Quellen.*