Schnelle Antwort
Der TuneLab-Deal von GenScript umfasst Proteine, keine Peptide. Hier erfahren Sie, was die KI-fähige Peptidentdeckung tatsächlich von den Aufzeichnungen Ihres Labors verlangt 2026.
Was geschah und warum es für die KI-fähige Peptidentdeckung wichtig ist
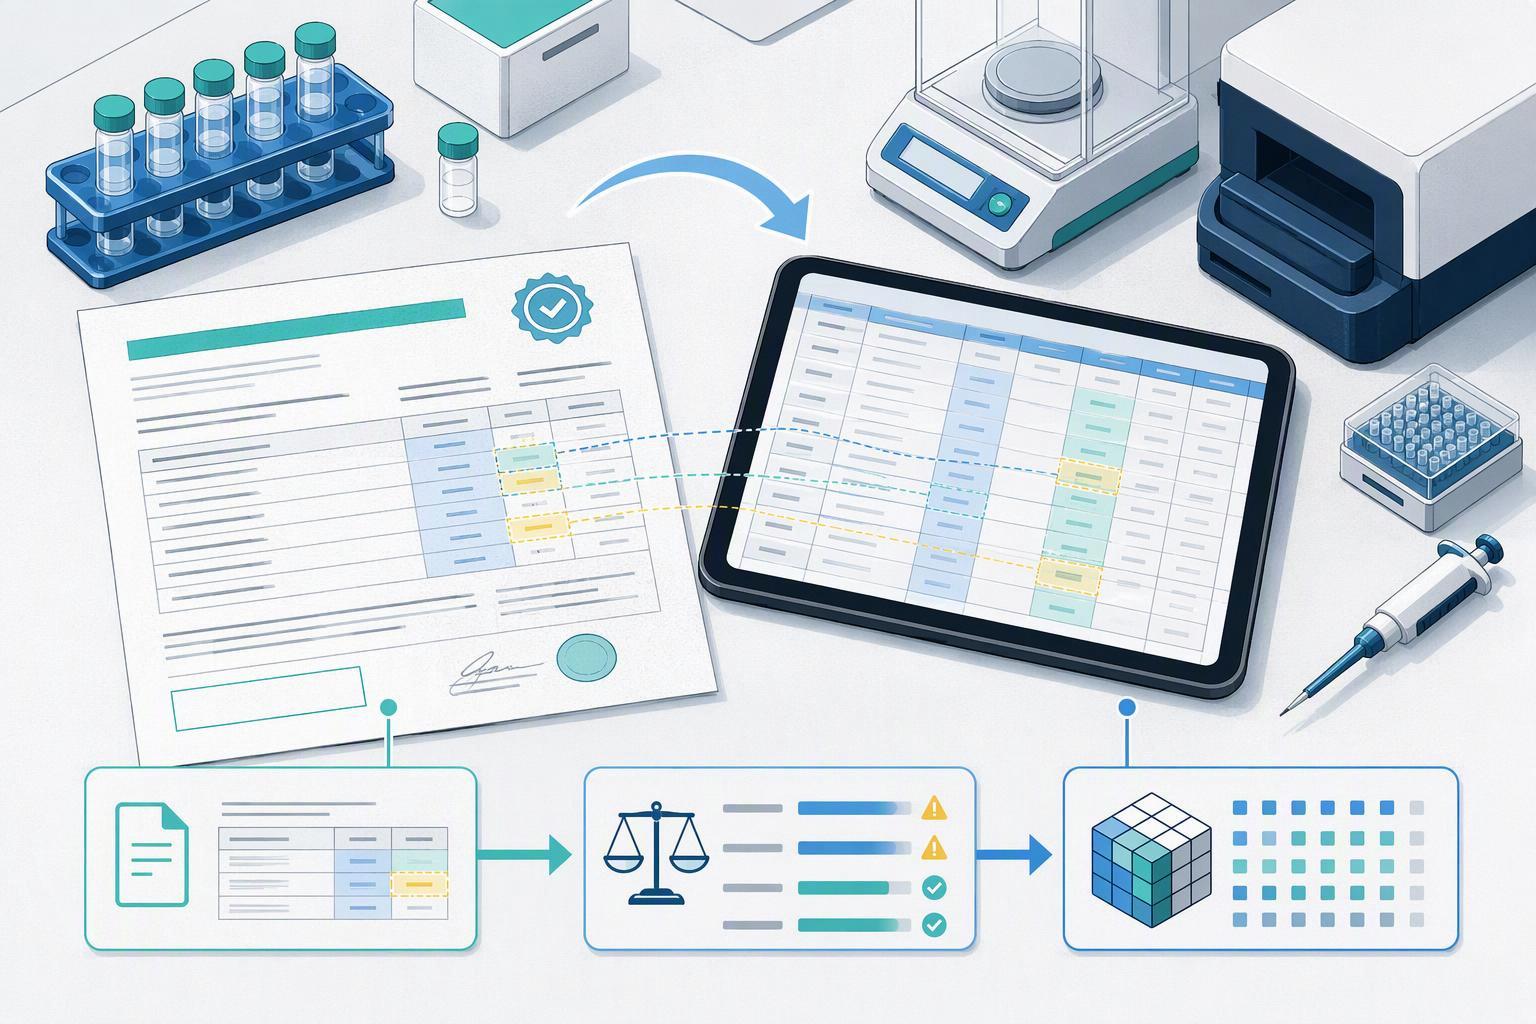
An 2026-09-16, GenScripts eigene Ankündigung der TuneLab-Vereinbarung bestätigte in der Ankündigung, dass das Unternehmen nun Vorzugskonditionen für Nasslabore anbietet: Proteinexpression, Reinigung und Charakterisierung priorisierter Sequenzen, unter standardisierten Bedingungen durchgeführt, vollständig dokumentierte Protokolle. Lesen Sie den Umfang sorgfältig durch. Kein Peptiddatenstandard, Es werden nirgendwo darin ein maschinenlesbares Format und keine peptidspezifischen Ergebnisse genannt.
Diese Lücke ist die Geschichte. Ray Chen, Präsident der GenScript Life Science Group, hat die Begründung in GenScripts erklärter Begründung für die Partnerschaft formuliert: „Die KI-gestützte Arzneimittelforschung wird nur so schnell voranschreiten, wie die Industrie zuverlässige biologische Beweise liefern kann.“
TuneLab selbst ist nicht neu. Lillys Startankündigung für TuneLab datiert es auf 2025-09-09, betrieben von Eli Lilly und nicht von einem unabhängigen Unternehmen, mit einer ersten Veröffentlichung, die die Arzneimitteldisposition abdeckt, Sicherheit und präklinische Modelle. Das Ausmaß dahinter ist der Grund, warum die Lieferanten aufmerksam sind: proprietäre Daten, die zu einem Preis von über $1 Milliarde, aus Hunderttausenden einzigartiger Moleküle gewonnen, je nach Umfang der Daten hinter TuneLab. Der Zugriff erfolgt über das Federated-Learning-Design von TuneLab, Dadurch können Biotech-Unternehmen auf Lillys Modelle zugreifen, ohne ihre eigenen proprietären Daten oder die von Lilly direkt preiszugeben.
Die Plattform wird auch in die Software eingebettet, die Computerteams bereits verwenden, durch die Schrödinger LiveDesign-Integration angekündigt 2026-01-09 und die TuneLab-Integration von CDD Vault angekündigt 2026-05-20.
Betrachten Sie dies also als Signal für die Generierung von Beweisen, keine Spezifikation. In der Ankündigung erfahren Sie nicht, welche Anforderungen die KI-fähige Peptidentdeckung an Ihre Unterlagen stellt. Diese Last liegt beim Labor.
Saubere Daten: Die vier Säulen der KI-fähigen Peptidentdeckung
Durch die KI-fähige Peptidentdeckung können Ihre experimentellen Ergebnisse gelesen werden, von einem Modell zusammengeführt und wiederverwendet werden, ohne dass ein Mensch sie erneut eingeben muss. Maschinenlesbare Daten tragen ihre Einheiten, Probenidentität und Methodenversion in strukturierten Feldern anstelle einer PDF- oder Notizbuchseite. Der Design-Build-Test-Learn-Zyklus ist die Schleife, in der diese Modelle laufen: Designsequenzen, synthetisieren und testen, Geben Sie die Ergebnisse zurück, noch einmal entwerfen.
Vier Säulen halten diese Schleife aufrecht: sauberere experimentelle Daten, reproduzierbare Syntheseaufzeichnungen, analysebereite Formate und analytische Datensätze. Die Messlatte liegt niedriger, als die meisten Teams annehmen. Cradles Leitfaden zur Datenerfassung für das Proteindesign macht das generative ML-Proteindesign für jedes Labor zugänglich, das regelmäßig Tests durchführen kann 96 Proteinsequenzvarianten für jede Eigenschaft, und stellt fest, dass ein paar Dutzend klug ausgewählte Sequenzen zu erheblichen Fortschritten führen können. Veröffentlichung von Best-Practice-Anleitungen zum ML-unterstützten Protein-Engineering berichtet, dass Protein-Engineering-ML-Datensätze oft weniger enthalten als 1,000 Instanzen, Aus diesem Grund wird bei der Validierung üblicherweise eine 10-fache Kreuzvalidierung anstelle einer einzelnen zurückgehaltenen Aufteilung verwendet.
Kleine Datensätze bestrafen schlampige Datensätze. GENs Analyse, warum die Bemühungen zur Entdeckung von KI-Arzneimitteln mangelhaft sind gibt an, dass die Modelle inkonsistent gefüttert wurden, unvollständig, Mehrdeutige oder schlecht formatierte Daten lernen das Rauschen zusammen mit dem Signal, Dies führt zu sicheren, aber weniger zuverlässigen Vorhersagen. Das Fehlermuster ist banal: Die Einheiten werden in einem Lauf in mg/ml und im nächsten in µg/µL aufgezeichnet, Freitext-Beispielnamen, mit denen kein Join-Schlüssel übereinstimmen kann, Fehlende Chargenkennungen, und keine Versionierung der Testmethode oder des Analysecodes. Jede dieser Maßnahmen verhindert, dass ein Datensatz über mehrere Läufe hinweg zusammengeführt wird.
Die vorgelagerte Ursache ist Fragmentierung, keine Nachlässigkeit. LabKeys Überblick über die praktische Assay-Datenverwaltung beschreibt Assay-Daten, die in Silos gespeichert sind, auf geteilten Laufwerken, in Labornotizbüchern, oder in E-Mails eingebettet, mit Instrumentenheterogenität zwischen Anbietern und Dateitypen und keinem einheitlichen Format. Die Peptiddatenqualität für KI-Modelle ist daher ein Datensatzproblem, bevor es sich um ein Modellierungsproblem handelt.
Schlüssel zum Mitnehmen: Eine Kampagne, die herumtestet 96 Varianten pro Eigenschaft liegen bereits im Bereich des generativen Designs. Was den Datensatz disqualifiziert, sind inkonsistente Einheiten, Freitext-Beispielnamen, fehlende Batch-IDs und nicht versionierte Methoden, nicht die Stichprobenanzahl.
Reproduzierbare Syntheseaufzeichnungen und analysebereite Formate
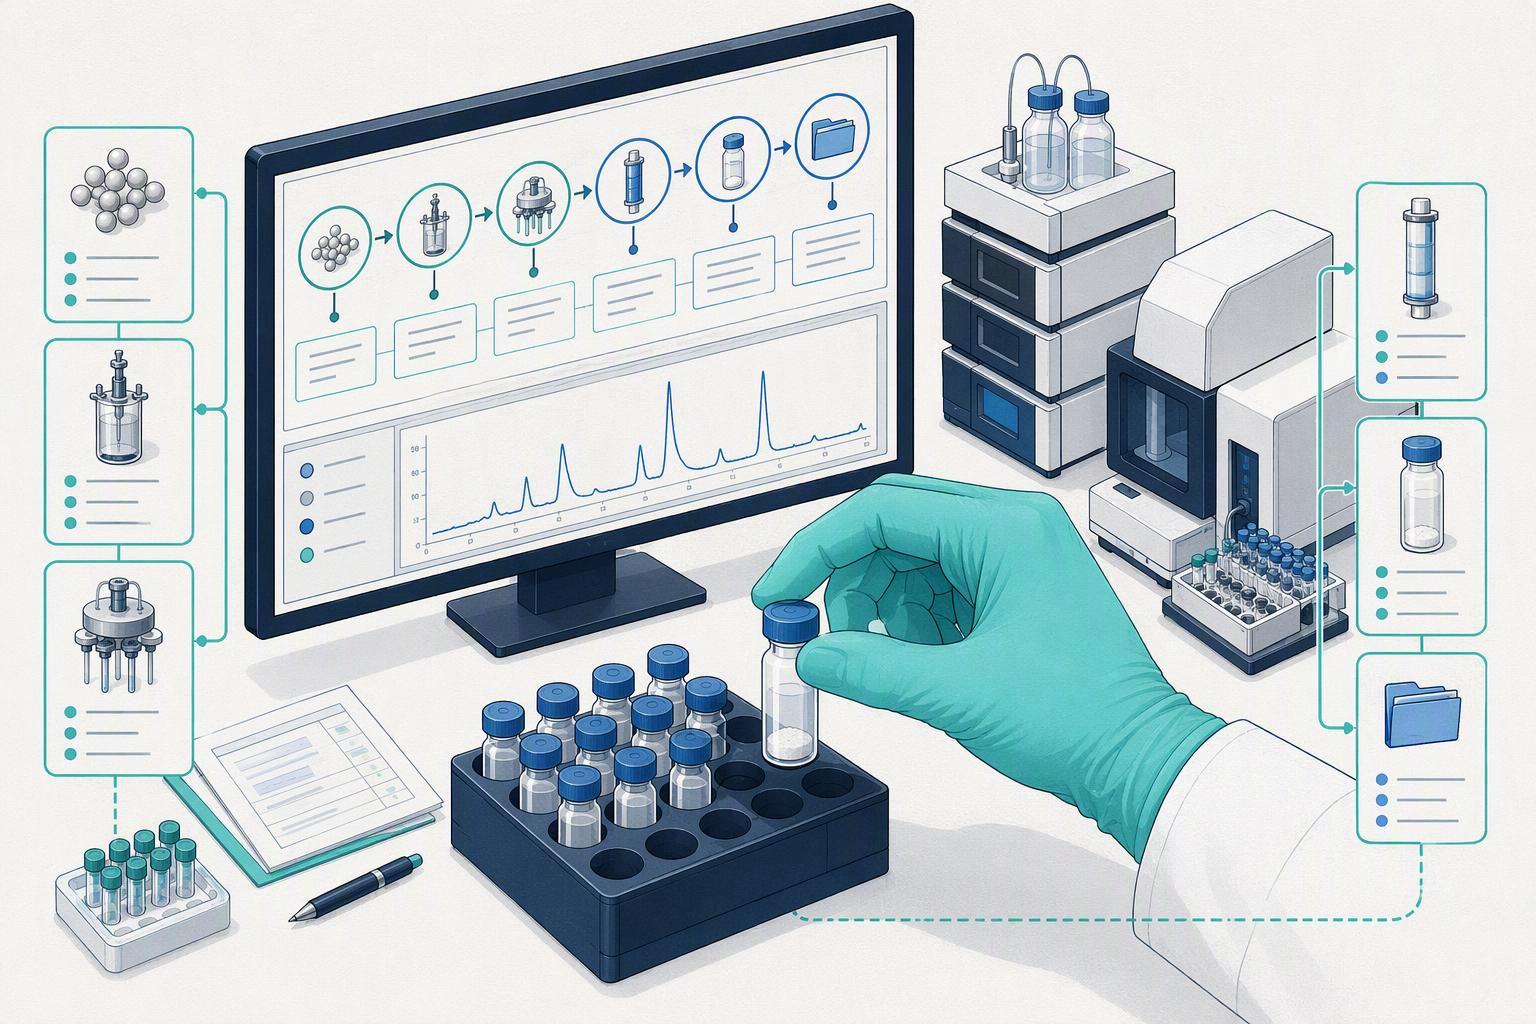
Ein Analysezertifikat ist keine reproduzierbare Aufzeichnung der Peptidsynthese. Die Einheit der Reproduzierbarkeit ist die Chargendatei: Die SPPS-Primer der American Peptide Society beschreibt ein Chargenprotokoll, das so detailliert ist, dass ein Dritter den Lauf neu erstellen kann, Art und Beladung des Abdeckharzes, Entschützung pro Zyklus und Kopplung mit Reagenzien und Äquivalenten, Waschschritte und Ausrüstung. Der darin dokumentierte standardmäßige manuelle Fmoc-Zyklus schreibt vor 20% Piperidin/DMF-Entschützung (5 Minuten, Dann 15 Minuten) Und 3 × 1 ml DMF-Wäsche pro Zyklus. MOL ändert das stufenweise Chain-of-Custody-Framework erweitert das auf neun Stufen, von der Rohstoffbeschaffung und eingehenden Qualifizierung bis hin zu Synthesechargenaufzeichnungen, Rückverfolgbarkeit der Isotopenmarkierung, analytische Freigabe und vollständige Chargendateizusammenstellung, unter Berufung auf ICH Q7 zur Charakterisierung des Ausgangsmaterials und Angabe eines Lieferanten, der die Harzcharge oder Aminosäurequelle nicht nennen kann.
Für analysebereite Peptiddatenformate gelten parallele Anforderungen. Der Überblick von LabKey über die praktische Assay-Datenverwaltung zeigt, was in der gesamten CSV-Datei immer wiederkehrt, JSON, AnIML und SDRF: stabile Identifikatoren für Proben, Dateien und Läufe; kontrollierte Vokabeln oder Ontologien; explizite Einheiten und Datentypen; Verbindungen zwischen Rohdaten, verarbeitete Daten und Metadaten; und offen, langlebige Formate. Die Identitätsbestätigung durch Massenspektrometrie ist keine Reinheitsbestimmung durch HPLC, und keiner klärt Gegenion- oder Inhaltsfragen wie den TFA-Gegenionenaustausch. ICH Q2(R2), veröffentlicht 30 November 2023, erfordert, dass sich ein Analyseverfahren im Rahmen eines vordefinierten Validierungsprotokolls als geeignet für seinen beabsichtigten Zweck erweist, wobei bestätigt wurde, dass der meldepflichtige Bereich obere und untere Spezifikations- oder Berichtsgrenzen umfasst, und erweitert diese Prinzipien auf Massenspektrometrie und andere spektrometrische Daten.
|
Was ein Standard-Lieferantenpaket enthält |
Was ein Computerteam braucht |
|---|---|
|
CoA plus zusammenfassende Analyse |
Chargenbezogene Datensätze mit stabilen Identifikatoren |
|
Endgültige Reinheits- und Identitätswerte |
Synthesedetails und Versionierung pro Zyklus |
|
Peptid 1 Statischer PDF- oder gedruckter Bericht |
Zyklische Peptidsynthese Maschinenlesbare Tabellen mit expliziten Einheiten |
|
Zertifikat als Liefergegenstand |
Herkunft aus Rohmaterial Peptiddienste Material zur Veröffentlichung |
Kein Dokumentationsstandard macht diese Notwendigkeit überflüssig Peptid 2 zur orthogonalen Trefferbestätigung.
Was das für Lieferanten bedeutet, Computerteams und Käufer
Die Ansage landet unterschiedlich, je nachdem, wo Sie sitzen. Für den synthetisierenden Lieferanten, Die Vollständigkeit der Dokumentation wird zu einem Unterscheidungsmerkmal und nicht zu einem nachträglichen Gedanken. AIDD-Serviceseite von GenScript kündigt Sequenz-zu-Daten in kürzester Zeit an 4 Kalendertage, 4000+ Designs pro Tag, 20M+ KI-fähige Datenpunkte werden pro Jahr generiert, unter $10 pro Datenpunkt, Und 3500+ globale Partnerorganisationen. Lesen Sie es genau durch, obwohl, und es nennt überhaupt keine Peptide; seine aufgeführten Modalitäten sind VHHs, Miniproteine, IgG, Bispezifika, Enzyme und De-novo-Proteine. Die Peptidchemie ist noch nicht das nachgewiesene Zentrum dieser Pipeline, Das ist die Chance für Lieferanten, die es vorweisen können. Calcitonin-Synthese
Für das Computerteam, Die Bindungsbeschränkung ist die Größe des Datensatzes und die ausreichende Metadatenanzahl. Veröffentlichte Best-Practice-Leitlinien zum ML-unterstützten Protein-Engineering behandeln die 10-fache Kreuzvalidierung als Norm für Datensätze mit weniger als 1.000 Instanzen, Hier erfahren Sie, wie dünn das Trainingsmaterial normalerweise ist. Hier kommt es auf das föderierte Lerndesign von TuneLab an: Biotech-Unternehmen greifen auf Lillys Modelle zu, ohne proprietäre Daten direkt preiszugeben. Die nicht offensichtliche Folgerung ist, dass die Schrödinger LiveDesign-Integration bedeutet, dass die meisten Teams diese Modelle in Software finden, die sie bereits ausführen. Die Modelle sind nicht die Variable, die Sie kontrollieren. Die Daten, die Sie ihnen geben, sind.
Für den Käufer oder QC-Leiter, „dokumentiert“ hat bereits eine Definition. Die zehn Datenintegritätsprinzipien von ALCOA+ verlangen, dass Datensätze zuordenbar sind, lesbar, gleichzeitig, Original, genau, vollständig, konsistent, langlebig und verfügbar, und der ICH Q2(R2) Gemäß der Richtlinie zur analytischen Validierung muss gezeigt werden, dass ein Analyseverfahren im Rahmen eines vordefinierten Validierungsprotokolls für seinen beabsichtigten Zweck geeignet ist, Mit der Überarbeitung werden diese Prinzipien auf die Massenspektrometrie ausgeweitet. Eine dokumentationsfreie Peptidlieferung, in diesen Begriffen, bedeutet eine Chargendatei, in der die Probenkennung mit der Charge verknüpft ist, Die Testversion und die Einheiten werden mit dem Ergebnis übertragen, und die Kontrollen und Fehlermetriken werden eher angegeben als impliziert. MOL Changes ist ein Anbieter, dessen Analysepaket auf dieser Kette basiert, Es wurde jedoch keine unabhängige Prüfung der KI-spezifischen Datenformate gefunden.
Vier Fragen, die Sie heute zu Ihren eigenen Unterlagen stellen sollten: Kann ein Model diese Tabelle lesen?? Kann ein Dritter diesen Stapel neu erstellen?? Enthält diese Testausgabe Kennungen und Einheiten?? Kann dieser Datensatz mit dem des letzten Quartals zusammengeführt werden?? Peptid 3
Was jetzt zu tun ist und das Gesamtbild
Beginnen Sie mit dem Export, nicht die Plattform. Drei Aktionen, in der Reihenfolge ihrer Dringlichkeit.
-
Diese Woche: Überprüfen Sie den Assay-Export einer aktuellen Kampagne anhand Ihrer maschinenlesbaren Feldliste und notieren Sie, was fehlt. Die meisten Teams finden die Lücken an einem Nachmittag.
-
Diesen Monat: Chargenkennungen hinzufügen, Einheiten, Assay-Version und Analysecode-Version in die Exportvorlage einfügen, und beginnen Sie mit der Versionierung der Testmethode selbst.
-
Dieses Quartal: Fordern Sie die vollständige Losdatei an, einschließlich Harzmenge und Aminosäurequelle, bevor Sie sich zu einer Kampagne verpflichten. Ein Lieferant, der die Harzcharge oder die Aminosäurequelle nicht nennen kann, ist ein Warnsignal.
Zwei Dinge, die man nicht tun sollte. Erstellen Sie eine Datenplattform nicht neu, bevor Sie das Exportformat korrigiert haben, und behandeln Sie ein CoA nicht als trainingsbereiten Datensatz.
Es lohnt sich, den warnenden Kontext im Auge zu behalten. In einer manuellen FAIR-Wiederverwendbarkeitsprüfung archivierter Datensätze, 45.9% der bewerteten offenen Datensätze wurden als wiederverwendbar eingestuft, Bedeutung 54.1% waren nicht. Im Energiebereichs-Datensatz-Audit, 82% der Datensätze enthielten fehlende Daten in mindestens einer Schlüsseldimension und 27% Es fehlte mehr als die Hälfte. Zahlen dieser Art variieren je nach Quelle und Domäne, Sie werden hier als Beispiel für Metadatenverlustraten angeführt, nicht als Peptid-Benchmarks.
Das ist das Gesamtbild für die KI-fähige Peptidentdeckung: Beweisgenerierung, keine Modellfähigkeit, wird zum geschwindigkeitsbegrenzenden Schritt. Dokumentationsstandards werden zum Beschaffungskriterium, und die Labore, die ihre Aufzeichnungen jetzt versionieren, werden diejenigen sein, deren Daten auch in drei Jahren noch verwendbar sind.
Nächster Schritt: Sehen Sie sich das Chain-of-Custody-Dokumentations-Framework an und nutzen Sie die neunstufige Checkliste, um Ihre aktuellen Chargendateien zu bewerten.
Offenlegung: MOL Changes veröffentlicht diesen Blog als Peptidanbieter.
Häufig gestellte Fragen
Deckt die GenScript-TuneLab-Partnerschaft Peptide ab??
NEIN. GenScripts eigene Ankündigung der TuneLab-Vereinbarung weitet den Service auf die Proteinexpression aus, Reinigung und Charakterisierung priorisierter Sequenzen. Die Peptidsynthese wird in diesem Bereich nicht genannt, Daher sollten Peptidteams die Ankündigung als Signal dafür verstehen, wohin sich die KI-gestützte Entdeckung entwickelt, und nicht als eine Dienstleistung, die sie heute kaufen können.
Was bedeuten „KI-fähige“ Daten eigentlich in der Praxis??
Es bedeutet fünf konkrete Eigenschaften: stabile Identifikatoren für jede Entität, kontrollierte Vokabulare anstelle von Freitextfeldern, explizite Einheiten und Datentypen, roh verlinkt, verarbeitete und Metadatendateien, und offene, langlebige Formate statt herstellergebundener Exporte. Der Überblick von LabKey über die praktische Assay-Datenverwaltung legt diese Anforderungen an Assay-Daten dar. Eine Datei, die diese Anforderungen erfüllt, kann von einem Modell analysiert werden, ohne dass ein Mensch zuerst die Spaltenüberschriften neu schreiben muss. Das ist der ganze Test.
Wie groß muss ein Peptidanalysedatensatz sein, damit maschinelles Lernen hilft??
Kleiner als die meisten Teams annehmen, aber nicht trivial klein. Cradles Leitfaden zur Datenerfassung für Proteindesign macht generatives Design von überall aus praktisch 96 Varianten pro Objekt. Typische Protein-Engineering-Datensätze, im Gegensatz dazu, halten weniger als 1,000 Instanzen und werden mit einer 10-fachen Kreuzvalidierung validiert, wie in veröffentlichten Best-Practice-Leitlinien zum ML-unterstützten Protein-Engineering beschrieben. Die Bindungsbeschränkung ist normalerweise die Konsistenz zwischen diesen Instanzen, nicht ihre Zählung.
Was soll ich von einem Lieferanten verlangen??
Fordern Sie die vollständige Losdatei an, nicht nur das CoA. Das stufenweise Chain-of-Custody-System von MOL Changes betrachtet einen Lieferanten, der die Harzcharge oder die Aminosäurequelle nicht nennen kann, als Warnsignal, und verlangt neben dem Zertifikat auch maschinenlesbare Analysedaten. Wenn die von Ihnen erhaltenen analysebereiten Peptiddatenformate nicht ohne manuelle Transkription geladen werden können, Die KI-fähige Peptid-Discovery-Pipeline stoppt in Ihrem Posteingang.
Abschluss
Die GenScript-TuneLab-Partnerschaft ist ein Zeichen dafür, wie Peptidnachweise generiert werden, kein Peptiddatenstandard. Danach wurden keine unabhängigen Testdaten veröffentlicht 2024 Es wurde festgestellt, dass jeder die Ankündigung als festgelegte Spezifikation betrachten könnte, So bleibt die praktische Arbeit dort, wo sie immer war: in der Aufzeichnung, die Ihr Labor bereits produziert.
Dieser Datensatz enthält vier Anforderungen, auf die Sie jetzt reagieren können. Saubere Daten bedeuten Felder, die ein Modell ohne manuelle Reparatur analysieren kann. Reproduzierbare Peptidsyntheseaufzeichnungen ermöglichen eine Rückverfolgbarkeit auf Chargenebene bis hin zu Harz- und Aminosäurequellen. Assay-bereite Peptiddatenformate bedeuten Ergebnisse, die den Transfer zwischen Instrumenten und Mitarbeitern überdauern. Peptidanalytische Datensätze für das Computerdesign sorgen dafür, dass die zugrunde liegenden Messungen mit den von ihnen beschriebenen Sequenzen verknüpft bleiben.
Der nächste logische Schritt ist klein und unscheinbar: Nimm eine abgeschlossene Kampagne, Exportieren Sie es so, wie es heute ist, und prüfen Sie es Feld für Feld anhand einer maschinenlesbaren Spezifikation. Was auch immer bei dieser Prüfung fehlschlägt, ist Ihr KI-fähiger Fahrplan für die Peptidentdeckung, und es wird konkreter sein als jede Ankündigung.