Risposta rapida
L'accordo TuneLab di GenScript riguarda le proteine, non peptidi. Ecco cosa richiede effettivamente la scoperta di peptidi pronti per l'intelligenza artificiale dai registri del tuo laboratorio 2026.
Cosa è successo e perché è importante per la scoperta di peptidi predisposti per l'intelligenza artificiale
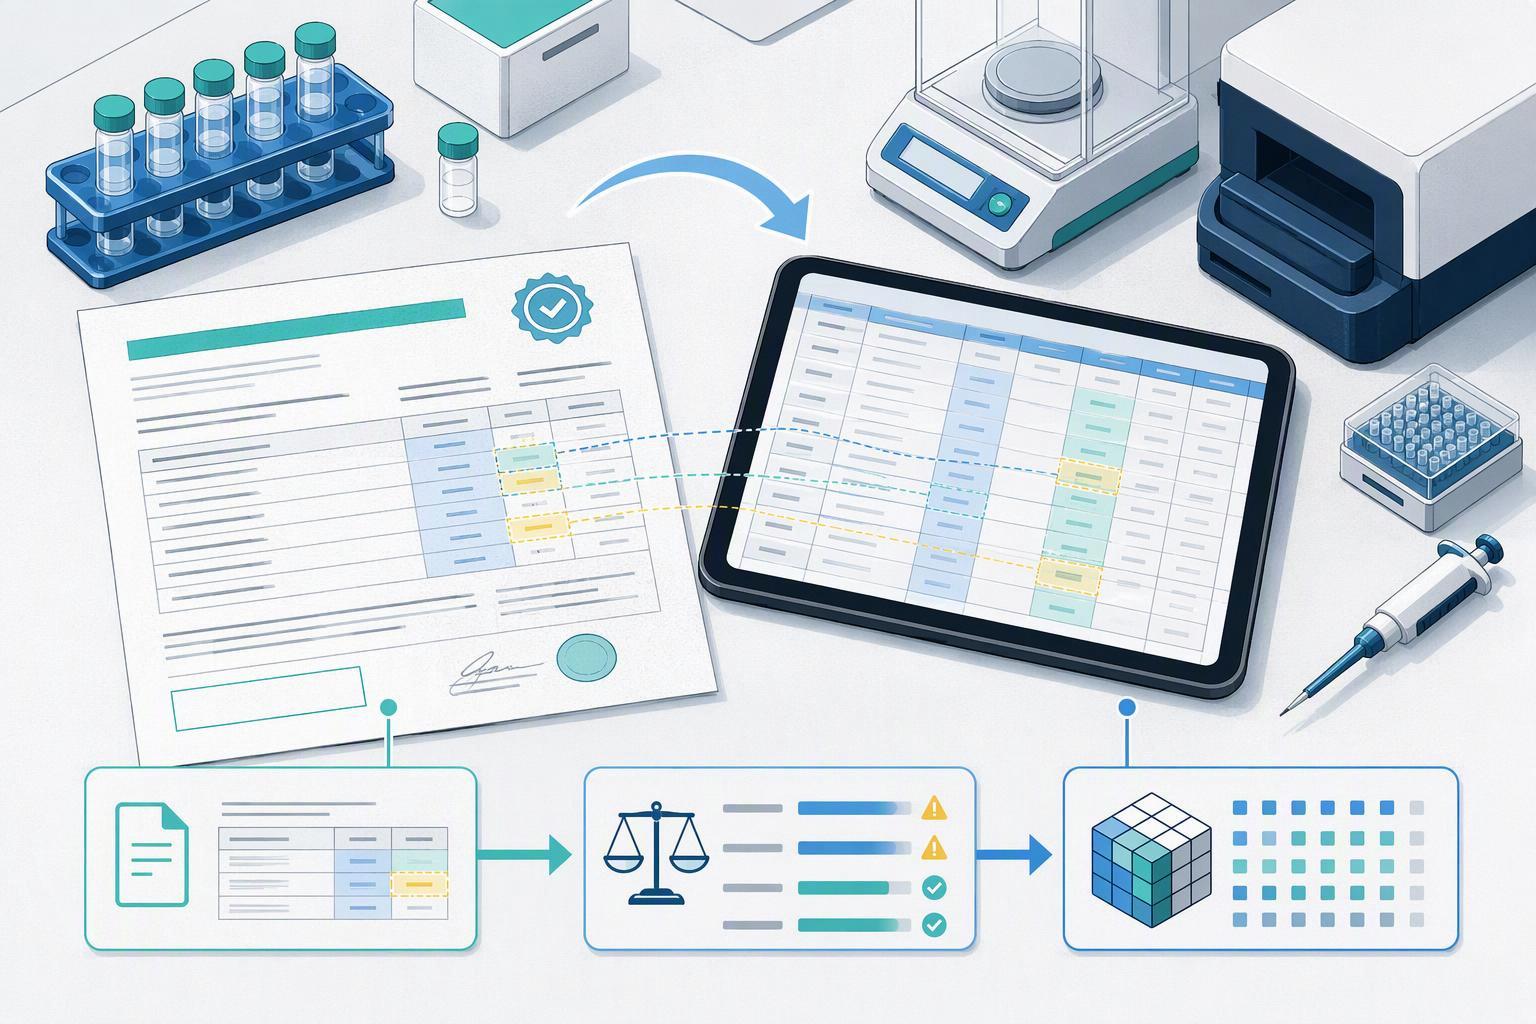
SU 2026-09-16, L'annuncio da parte di GenScript dell'accordo TuneLab ha confermato che nell'annuncio la società offre ora condizioni di laboratorio umido a tariffa preferenziale: espressione proteica, purificazione e caratterizzazione di sequenze prioritarie, eseguito secondo standardizzato, protocolli completamente documentati. Leggere attentamente il campo di applicazione. Nessuno standard di dati sui peptidi, nessun formato leggibile dalla macchina e nessun risultato finale specifico del peptide è nominato da nessuna parte in esso.
Quella lacuna è la storia. Ray Chen, Presidente del gruppo GenScript Life Science, ha inquadrato la logica della partnership dichiarata da GenScript: “La scoperta di farmaci basati sull’intelligenza artificiale avanzerà solo alla velocità con cui l’industria sarà in grado di generare prove biologiche affidabili”.
TuneLab in sé non è nuovo. Annuncio di lancio di Lilly per TuneLab lo data 2025-09-09, gestito da Eli Lilly piuttosto che da una società indipendente, con una prima release riguardante la distribuzione dei farmaci, modelli preclinici e di sicurezza. La portata dietro questo è il motivo per cui i fornitori prestano attenzione: dati proprietari ottenuti ad un costo di oltre $1 miliardi, tratto da centinaia di migliaia di molecole uniche, in base alla scala dei dati dietro TuneLab. L'accesso avviene attraverso il design di apprendimento federato di TuneLab, che consente alle biotecnologie di sfruttare i modelli di Lilly senza esporre direttamente i propri dati proprietari o quelli di Lilly.
La piattaforma verrà inoltre incorporata nel software che i team di calcolo già utilizzano, Attraverso l'integrazione di Schrödinger LiveDesign annunciato 2026-01-09 e annunciata l'integrazione TuneLab di CDD Vault 2026-05-20.
Quindi trattalo come un segnale sulla generazione di prove, non una specifica. Niente nell'annuncio ti dice cosa richiede dai tuoi record la scoperta di peptidi pronti per l'intelligenza artificiale. Questo onere ricade sul laboratorio.
Dati puliti: I quattro pilastri della scoperta dei peptidi predisposti per l’intelligenza artificiale
La scoperta di peptidi pronti per l'intelligenza artificiale significa che i tuoi risultati sperimentali possono essere letti, uniti e riutilizzati da un modello senza che un essere umano lo riscriva. I dati leggibili dalla macchina trasportano le sue unità, identità del campione e versione del metodo in campi strutturati anziché in un PDF o in una pagina di blocco note. Il ciclo progettazione-costruzione-test-apprendimento è il ciclo su cui vengono eseguiti questi modelli: sequenze di progettazione, sintetizzarli e testarli, restituire i risultati, progettare di nuovo.
Quattro pilastri sostengono quel circuito: dati sperimentali più puliti, registrazioni di sintesi riproducibili, formati pronti per il test e set di dati analitici. L’asticella è più bassa di quanto la maggior parte delle squadre pensi. Guida alla raccolta dati di Cradle per la progettazione delle proteine mette la progettazione di proteine generative-ML alla portata di qualsiasi laboratorio in grado di eseguire test in modo coerente 96 varianti della sequenza proteica per ciascuna proprietà, e osserva che alcune dozzine di sequenze scelte saggiamente possono produrre progressi significativi. Pubblicate linee guida sulle migliori pratiche sull'ingegneria proteica assistita da machine learning riporta che i set di dati ML di ingegneria proteica spesso ne contengono meno di 1,000 istanze, ecco perché la convalida utilizza comunemente una convalida incrociata di 10 volte anziché una singola suddivisione mantenuta.
I piccoli set di dati penalizzano i record sciatti. L’analisi di GEN sul motivo per cui gli sforzi di scoperta di farmaci basati sull’intelligenza artificiale hanno risultati inferiori afferma che i modelli alimentati sono incoerenti, incompleto, i dati ambigui o mal formattati apprendono il rumore insieme al segnale, fornendo previsioni attendibili ma meno attendibili. Il modello di fallimento è banale: unità registrate come mg/ml in un'analisi e µg/μl in quella successiva, nomi di esempi di testo libero a cui nessuna chiave di join può corrispondere, identificatori batch mancanti, e nessuna versione del metodo di analisi o del codice di analisi. Ognuno di questi impedisce a un set di dati di unirsi tra le esecuzioni.
La causa a monte è la frammentazione, non disattenzione. Panoramica di LabKey sulla gestione pratica dei dati dei test descrive i dati di analisi che vivono in silos, sui Drive condivisi, nei quaderni di laboratorio, o incorporati nelle e-mail, con eterogeneità degli strumenti tra fornitori e tipi di file e assenza di un formato coerente. La qualità dei dati sui peptidi per i modelli AI è quindi un problema di registrazione prima che un problema di modellizzazione.
Chiave da asporto: Una campagna che mette alla prova tutto 96 le varianti per proprietà rientrano già nel territorio del design generativo. Ciò che squalifica il set di dati sono le unità incoerenti, nomi di campioni con testo libero, ID batch mancanti e metodi senza versione, non il conteggio del campione.
Record di sintesi riproducibili e formati pronti per il test
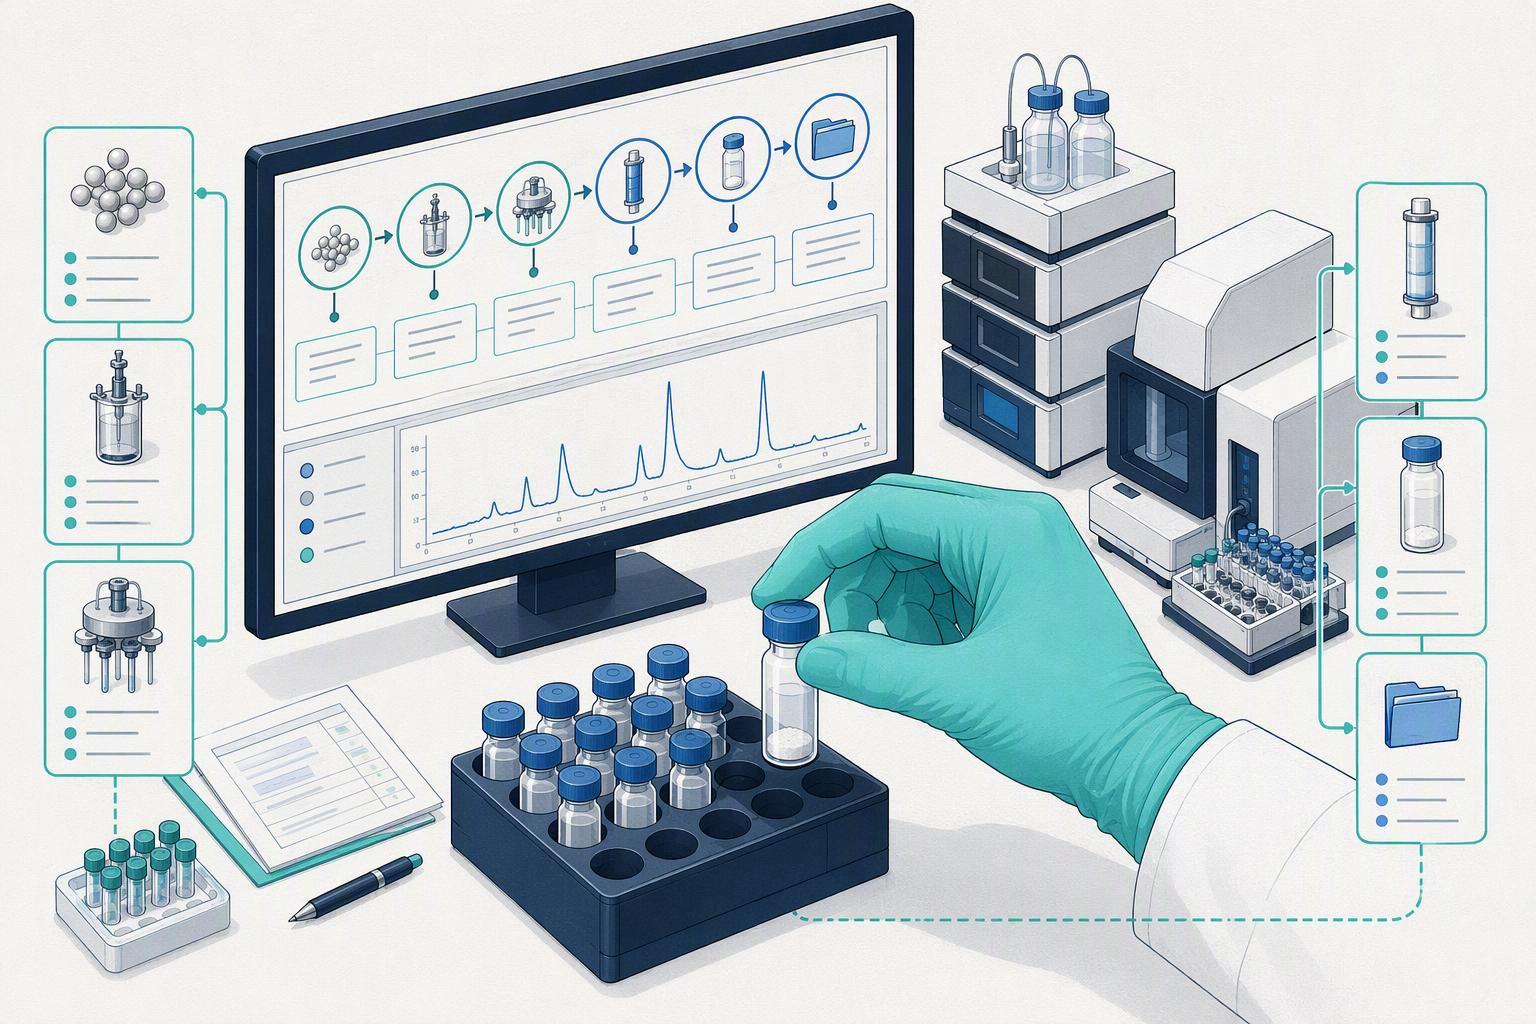
Un certificato di analisi non è un documento riproducibile di sintesi peptidica. L'unità di riproducibilità è il file lotto: IL Primer SPPS dell’American Peptide Society descrive un record batch sufficientemente dettagliato da consentire a terzi di ricreare la corsa, coprendo il tipo di resina e il carico, deprotezione per ciclo e accoppiamento con reagenti ed equivalenti, lavare gradini e attrezzature. Il ciclo Fmoc manuale standard documenta prescrive 20% deprotezione piperidina/DMF (5 minuti, Poi 15 minuti) E 3 × 1 mL di lavaggi DMF per ciclo. Il quadro della catena di custodia fase per fase di MOL Changes lo estende in nove fasi, dall'approvvigionamento delle materie prime e dalla qualificazione in entrata attraverso i registri dei lotti di sintesi, tracciabilità dell'etichettatura isotopica, rilascio analitico e assemblaggio completo del file lotto, citando ICH Q7 per la caratterizzazione del materiale iniziale e segnalando un fornitore che non può nominare il lotto di resina o la fonte di amminoacidi.
I formati di dati peptidici pronti per il test comportano un requisito parallelo. La panoramica di LabKey sulla gestione pratica dei dati dei test identifica ciò che ricorre nel CSV, JSON, AnIML e SDRF: identificatori stabili per i campioni, file ed esegue; vocabolari o ontologie controllate; unità e tipi di dati espliciti; collegamenti tra dati grezzi, dati e metadati trattati; e aperto, formati longevi. La conferma dell'identità mediante spettrometria di massa non è la determinazione della purezza mediante HPLC, e nessuno dei due risolve questioni di controrione o di contenuto come lo scambio di controrioni TFA. Io Q2(R2), pubblicato 30 novembre 2023, richiede che una procedura analitica si dimostri idonea allo scopo previsto nell'ambito di un protocollo di validazione predefinito, with the reportable range confirmed to include upper and lower specification or reporting limits, and extends those principles to mass spectrometry and other spectrometric data.
|
What a standard supplier package contains |
What a computational team needs |
|---|---|
|
CoA plus summary analytics |
Lot-linked records with stable identifiers |
|
Final purity and identity values |
Per-cycle synthesis detail and versioning |
|
Peptide 1 Static PDF or printed report |
Cyclic Peptide Synthesis Machine-readable tables with explicit units |
|
Certificate as the deliverable |
Provenance from raw Peptide Services material to release |
No documentation standard removes the need Peptide 2 for orthogonal confirmation of hits.
Cosa significa per i fornitori, Team computazionali e acquirenti
The announcement lands differently depending on where you sit. For the synthesizing supplier, documentation completeness becomes a differentiator rather than an afterthought. Pagina del servizio AIDD di GenScript pubblicizza la sequenza in dati alla stessa velocità 4 giorni di calendario, 4000+ disegni al giorno, 20M+ Punti dati pronti per l'intelligenza artificiale generati ogni anno, Sotto $10 per punto dati, E 3500+ organizzazioni partner globali. Leggilo attentamente, Anche se, e non nomina alcun peptide; le sue modalità elencate sono VHH, miniproteine, IgG, bispecifici, enzimi e proteine de novo. La chimica dei peptidi non è ancora il centro dimostrato di questo oleodotto, che è l'apertura per i fornitori che possono mostrarlo. Sintesi della calcitonina
Per il team computazionale, il vincolo vincolante è la dimensione del set di dati e la sufficienza dei metadati. Le linee guida pubblicate sulle migliori pratiche sull'ingegneria proteica assistita da machine learning considerano la convalida incrociata 10 volte la norma su set di dati inferiori a 1.000 istanze, che ti dice quanto è sottile solitamente il materiale didattico. La progettazione dell’apprendimento federato di TuneLab è importante qui: le biotecnologie attingono ai modelli di Lilly senza esporre direttamente i dati proprietari. L'implicazione non ovvia è che l'integrazione di Schrödinger LiveDesign significa che la maggior parte dei team incontrerà questi modelli all'interno del software che già utilizzano. I modelli non sono la variabile che controlli. I dati che fornisci loro lo sono.
Per l'acquirente o il responsabile del controllo qualità, “documentato” ha già una definizione. I dieci principi ALCOA+ sull’integrità dei dati richiedono che i record siano attribuibili, leggibile, contemporaneo, originale, accurato, completare, coerente, duraturo e disponibile, e l'ICH Q2(R2) La linea guida per la validazione analitica richiede che una procedura analitica si dimostri idonea allo scopo previsto secondo un protocollo di validazione predefinito, con la revisione che estende tali principi alla spettrometria di massa. Una consegna di peptidi completa di documentazione, in questi termini, indica un file di lotto in cui l'identificatore del campione si ricollega al lotto, la versione del test e le unità viaggiano con il risultato, e i controlli e le misurazioni degli errori sono dichiarati piuttosto che impliciti. MOL Changes è un fornitore il cui pacchetto analitico è costruito attorno a quella catena, sebbene non sia stato trovato alcun controllo indipendente sui formati di dati specifici dell'intelligenza artificiale.
Quattro domande da porre ai propri record oggi: Un modello può leggere questa tabella? Una terza parte può ricreare questo batch? L'output di questo test contiene identificatori e unità? È possibile unire questo set di dati con quello dell'ultimo trimestre? Peptide 3
Cosa fare adesso e il quadro più ampio
Inizia con l'esportazione, non la piattaforma. Tre azioni, in ordine di urgenza.
-
Questa settimana: controlla l'esportazione di un test di una campagna recente rispetto all'elenco di campi leggibili dalla macchina e annota ciò che manca. La maggior parte delle squadre trova le lacune in un pomeriggio.
-
Questo mese: aggiungere identificatori batch, unità, versione del test e versione del codice di analisi nel modello di esportazione, e avviare il controllo delle versioni del metodo di analisi stesso.
-
Questo trimestre: richiedi il file completo del lotto, compreso il lotto di resina e la fonte di aminoacidi, prima di impegnarsi in una campagna. Un fornitore che non sa nominare il lotto di resina o la fonte di aminoacidi è un campanello d'allarme.
Due cose da non fare. Non ricostruire una piattaforma dati prima di correggere il formato di esportazione, e non trattare un certificato di autenticità come un set di dati pronto per l'addestramento.
Vale la pena tenere presente il contesto cautelativo. In un controllo manuale di riusabilità FAIR dei set di dati archiviati, 45.9% dei set di dati aperti valutati sono stati classificati riutilizzabili, Senso 54.1% non lo erano. Nell'audit del set di dati del dominio energetico, 82% dei set di dati presentavano dati mancanti in almeno una dimensione chiave e 27% ne mancava più della metà. I dati di questo tipo variano a seconda della fonte e del dominio, e sono citati qui come esempio dei tassi di perdita di metadati, non come parametri di riferimento dei peptidi.
Questo è il quadro più ampio per la scoperta di peptidi pronti per l’intelligenza artificiale: generazione di prove, non capacità del modello, sta diventando il passo limitante della velocità. Gli standard di documentazione si stanno trasformando in un criterio di appalto, e i laboratori che versioniranno ora i loro dati saranno quelli i cui dati saranno ancora utilizzabili tra tre anni.
Prossimo passo: rivedere il quadro della documentazione della catena di custodia e utilizzare la sua lista di controllo in nove fasi per assegnare un punteggio ai file di lotto attuali.
Divulgazione: MOL Changes pubblica questo blog come fornitore di peptidi.
Domande frequenti
La partnership GenScript-TuneLab copre i peptidi?
NO. L’annuncio dell’accordo TuneLab da parte di GenScript riguarda il servizio relativo all’espressione proteica, purificazione e caratterizzazione di sequenze prioritarie. La sintesi peptidica non è menzionata in questo ambito, quindi i team che si occupano di peptidi dovrebbero leggere l’annuncio come un segnale sulla direzione in cui si sta dirigendo la scoperta assistita dall’intelligenza artificiale piuttosto che come un servizio che possono acquistare oggi.
Cosa significano effettivamente nella pratica i dati “AI-ready”??
Significa cinque proprietà concrete: identificatori stabili per ogni entità, vocabolari controllati anziché campi di testo libero, unità e tipi di dati espliciti, collegato grezzo, file elaborati e di metadati, e formati aperti di lunga durata anziché esportazioni vincolate al fornitore. La panoramica di LabKey sulla gestione pratica dei dati di analisi definisce questi requisiti per i dati di analisi. Un file che li soddisfa può essere analizzato da un modello senza che un essere umano riscriva prima le intestazioni delle colonne. Questo è l'intero test.
Quanto deve essere grande un set di dati analitici sui peptidi affinché l'apprendimento automatico possa essere d'aiuto?
Più piccolo di quanto la maggior parte delle squadre pensi, ma non banalmente piccolo. La guida alla raccolta dati di Cradle per la progettazione delle proteine mette in pratica la progettazione generativa da ogni parte 96 varianti per immobile. Tipici set di dati di ingegneria proteica, per contrasto, tenere meno di 1,000 istanze e sono convalidati con convalida incrociata 10 volte, come descritto dalle linee guida sulle migliori pratiche pubblicate sull'ingegneria proteica assistita da machine learning. Il vincolo vincolante è solitamente la coerenza tra tali istanze, non il loro conteggio.
Cosa devo chiedere a un fornitore?
Richiedi la scheda completa del lotto, non solo il CoA. Il quadro della catena di custodia fase per fase di MOL Changes considera un fornitore che non può nominare il lotto di resina o la fonte di amminoacidi come un segnale di allarme, e richiede dati analitici leggibili dalla macchina insieme al certificato. Se i formati di dati peptidici pronti per il test che ricevi non possono essere caricati senza trascrizione manuale, la pipeline di scoperta dei peptidi pronta per l'intelligenza artificiale si ferma alla tua casella di posta.
Conclusione
La partnership GenScript-TuneLab è un segnale su come vengono generate le prove dei peptidi, non uno standard di dati sui peptidi. Nessun dato di test indipendente pubblicato successivamente 2024 è stato riscontrato che consentirebbe a chiunque di considerare l'annuncio come una specifica definitiva, quindi il lavoro pratico rimane dov'è sempre stato: nella registrazione già prodotta dal tuo laboratorio.
Quel record ha quattro requisiti su cui puoi agire ora. Dati puliti significa campi che un modello può analizzare senza riparazione manuale. Le registrazioni riproducibili della sintesi dei peptidi significano la tracciabilità a livello di lotto fino alle fonti di resina e amminoacidi. I formati di dati peptidici pronti per il test significano risultati che sopravvivono al trasferimento tra strumenti e collaboratori. I set di dati analitici sui peptidi per la progettazione computazionale fanno sì che le misurazioni sottostanti rimangano collegate alle sequenze che descrivono.
Il prossimo passo logico è piccolo e poco affascinante: prendi una campagna completata, esportarlo così com'è oggi, e verificarlo campo per campo rispetto a una specifica leggibile dalla macchina. Qualunque cosa fallisca tale verifica è la tua tabella di marcia per la scoperta dei peptidi pronta per l'intelligenza artificiale, e sarà più specifico di qualsiasi annuncio.