何が起こったのか、そしてそれが AI 対応ペプチド発見にとって重要である理由
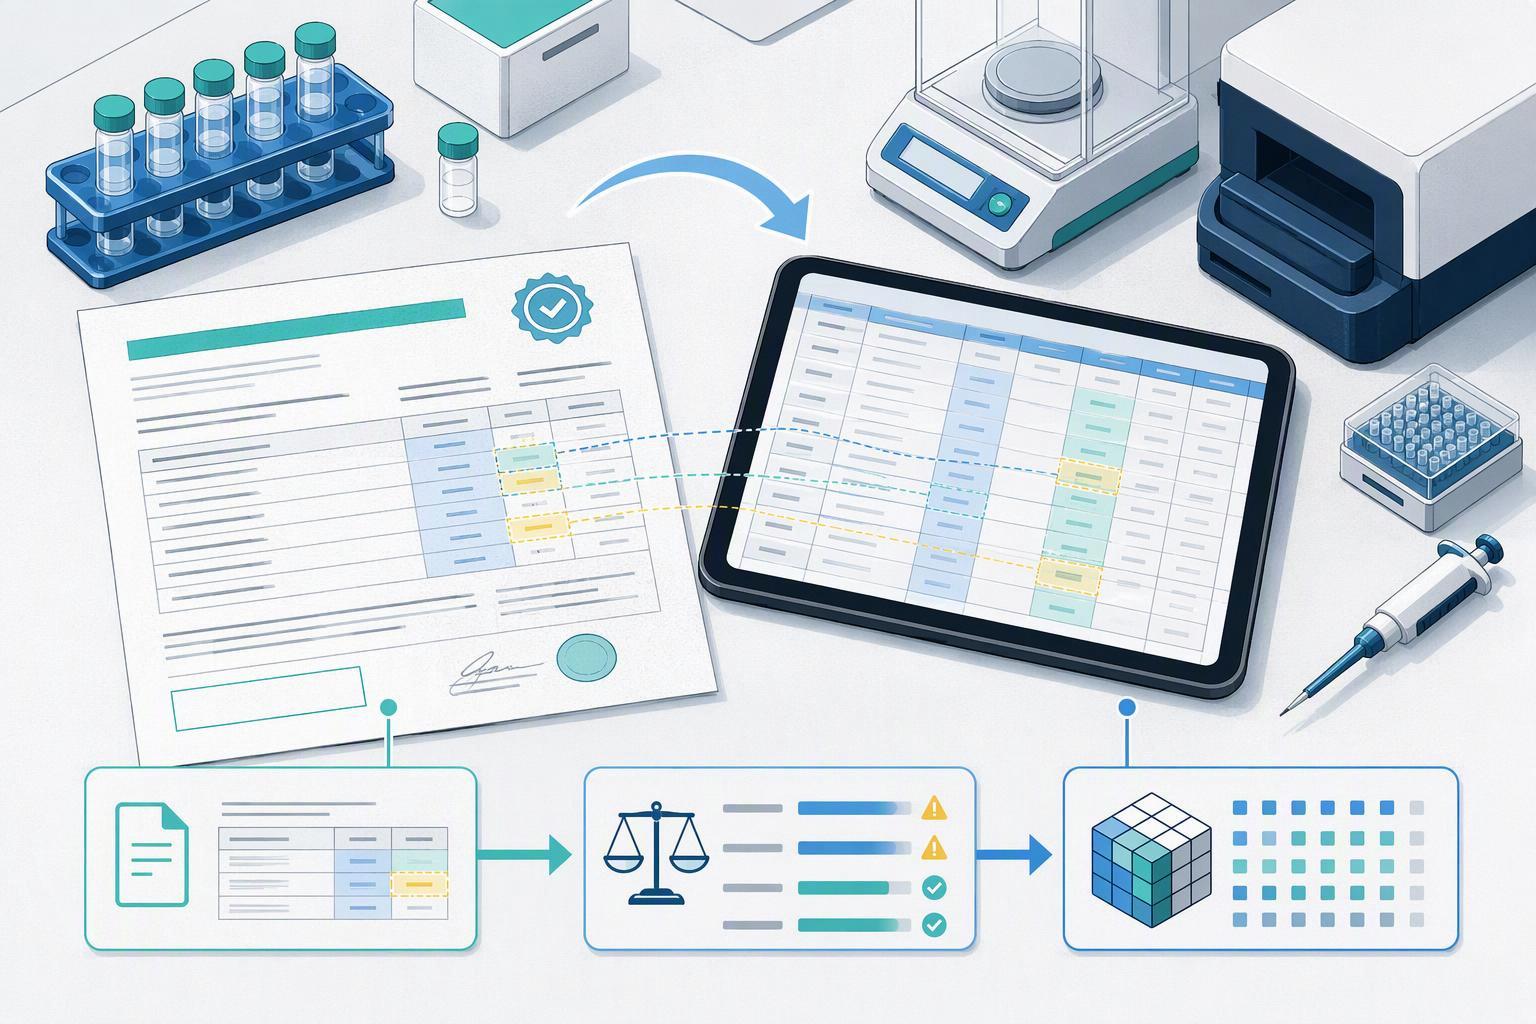
の上 2026-09-16, GenScript 自身による TuneLab 契約の発表 同社が発表の中でウェットラボの優先料金条件を提供していることを確認した: タンパク質発現, 優先順位付けされた配列の精製と特性評価, 標準化された下で実行される, 完全に文書化されたプロトコル. 範囲をよく読んでください. ペプチドデータ標準なし, 機械可読形式がなく、ペプチド固有の成果物の名前がどこにもありません.
そのギャップこそが物語なのです. レイ・チェン, GenScript ライフサイエンスグループ プレジデント, GenScript が表明したパートナーシップの理論的根拠を説明した: 「AI を活用した創薬は、業界が信頼できる生物学的証拠を生成できる速度でのみ進歩します。」
TuneLab自体は新しいものではありません. Lilly による TuneLab の開始のお知らせ 日付は次のとおりです 2025-09-09, 独立した会社ではなくイーライリリーによって運営されています, 薬物動態をカバーする最初のリリース付き, 安全性および前臨床モデル. 背後にあるスケールがサプライヤーが注目する理由: 高額なコストをかけて取得した独自のデータ $1 十億, 数十万のユニークな分子から抽出, TuneLab の背後にあるデータの規模に応じて. アクセスは TuneLab のフェデレーテッド ラーニング設計を通じて実行されます, これにより、バイオテクノロジー企業は、自社の独自データやリリーのデータを直接公開することなく、リリーのモデルを利用できるようになります。.
このプラットフォームは、計算チームがすでに使用しているソフトウェアにも組み込まれています。, を通して Schrödinger LiveDesign の統合 発表された 2026-01-09 と CDD Vault の TuneLab 統合が発表されました 2026-05-20.
したがって、これを証拠生成に関する信号として扱います, 仕様ではありません. この発表には、AI 対応のペプチド発見に必要な記録が何かについては何も記載されていません. その負担は研究室にかかっています.
クリーンデータ: AI 対応ペプチド発見の 4 つの柱
AI 対応のペプチド発見は、実験結果を読み取ることができることを意味します, 人間が再入力することなく、モデルによってマージされ再利用される. 機械可読データにはその単位が含まれる, PDF またはノートブック ページの代わりに構造化フィールド内のサンプル ID とメソッド バージョン. 設計、構築、テスト、学習のサイクルは、モデルが実行されるループです。: デザインシーケンス, それらを合成してテストする, 結果をフィードバックする, もう一度デザインする.
4 本の柱がそのループを支えます: よりクリーンな実験データ, 再現可能な合成記録, アッセイにすぐに使えるフォーマットと分析データセット. ハードルはほとんどのチームが想定しているよりも低い. タンパク質設計のための Cradle のデータ収集ガイダンス 生成 ML タンパク質設計を、一貫してテストできるどの研究室でも手の届くところに置きます。 96 各特性のタンパク質配列バリアント, そして、賢明に選択された数十のシーケンスが大きな進歩をもたらす可能性があると指摘しています. ML 支援タンパク質工学に関するベストプラクティス ガイダンスを公開 タンパク質工学の ML データセットは、多くの場合、保持するデータセットが 1,000 インスタンス, このため、検証では単一の保持された分割ではなく、10 分割の相互検証が一般的に使用されます。.
データセットが小さいと、ずさんなレコードが罰せられる. AI創薬の取り組みがうまくいかない理由についてのGENの分析 モデルのフィードが一貫していないことを述べています, 不完全, あいまいなデータまたは不適切な形式のデータは、信号とともにノイズを学習します, 自信はあるが信頼性が低い予測が得られる. 失敗パターンはありふれたものだ: 単位は 1 回の実行では mg/mL として記録され、次の実行では µg/µL として記録されます。, 結合キーが一致しない自由テキストのサンプル名, バッチ識別子がありません, アッセイ方法や分析コードのバージョン管理はありません. これらのいずれかが発生すると、実行間でのデータセットのマージが停止されます。.
上流の原因は断片化です, 不注意ではない. LabKey の実践的なアッセイデータ管理の概要 サイロに存在するアッセイデータについて説明します, 共有ドライブ上, 研究室のノートに, または電子メールに埋め込まれます, ベンダーやファイルタイプ間で機器が異質であり、一貫したフォーマットがない. したがって、AI モデルのペプチド データの品質は、モデリングの問題である前に記録の問題です。.
重要なポイント: をテストするキャンペーン 96 プロパティごとのバリアントはすでにジェネレーティブ デザインの領域にあります. データセットが不適格となるのは、単位が一貫していない場合です。, 自由記述のサンプル名, 欠落しているバッチ ID とバージョン管理されていないメソッド, サンプル数ではありません.
再現可能な合成記録とアッセイ対応フォーマット
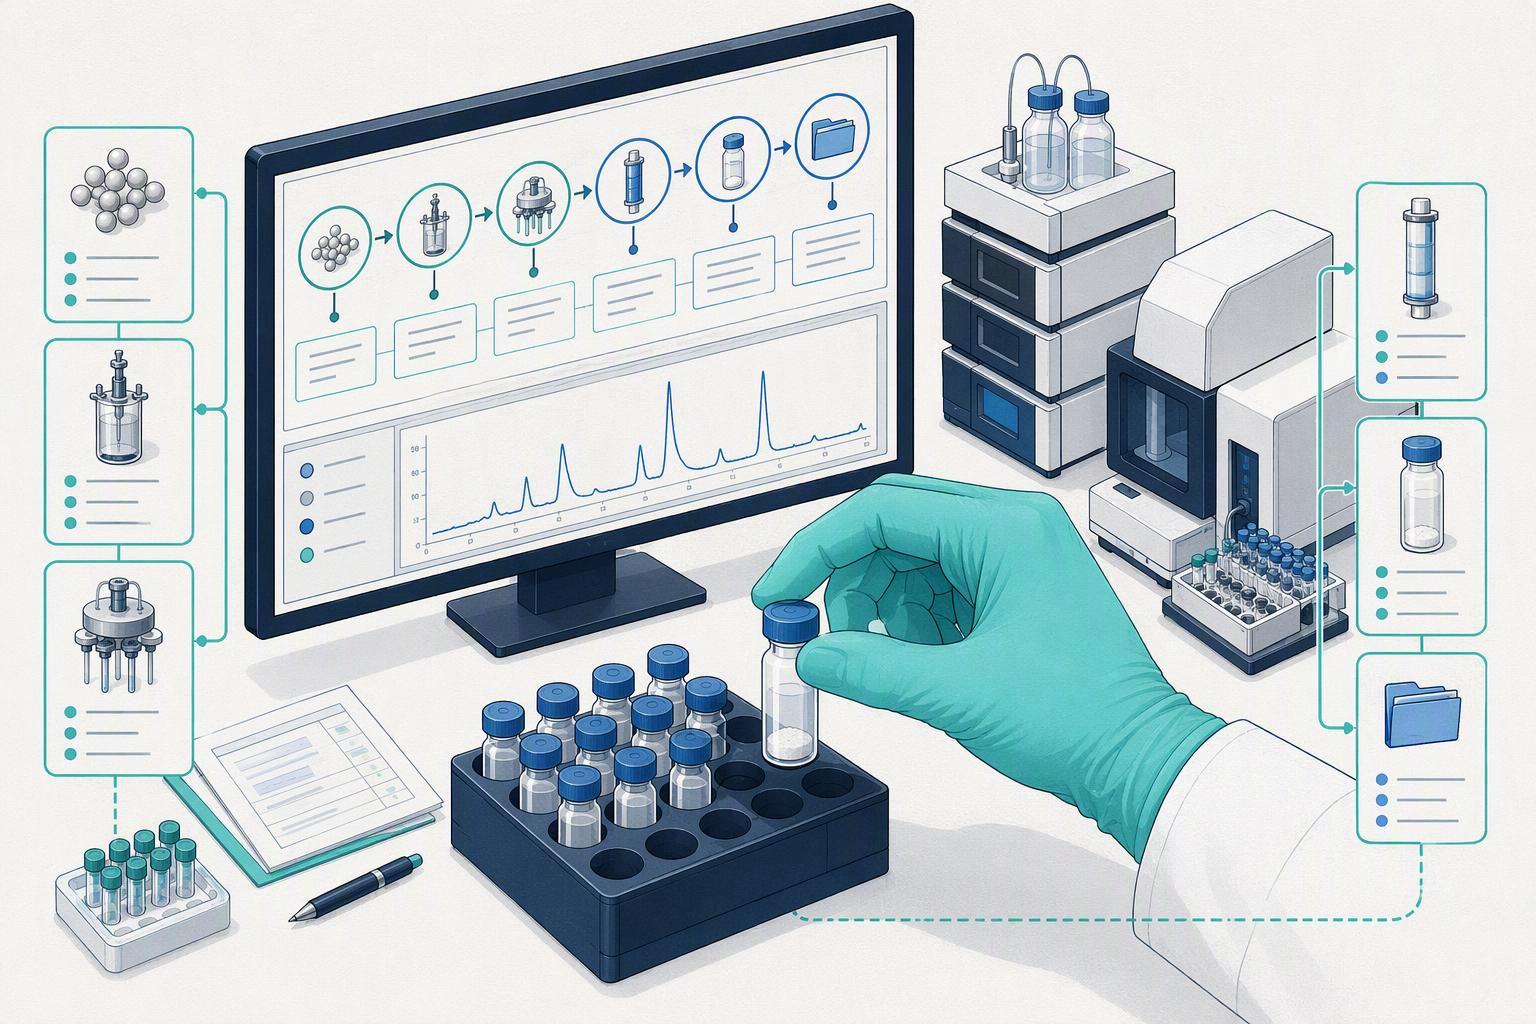
分析証明書は再現可能なペプチド合成記録ではありません. 再現性の単位はロットファイルです: の 米国ペプチド協会の SPPS プライマー サードパーティが実行を再作成できるほど詳細なバッチ レコードを説明します。, 被覆樹脂の種類と積載量, サイクルごとの脱保護と試薬および同等物によるカップリング, 洗浄手順と機器. この文書で規定されている標準的な手動 Fmoc サイクル 20% ピペリジン/DMF 脱保護 (5 分, それから 15 分) そして 3 × 1 サイクルあたりの DMF 洗浄数 mL. MOL Changes の段階別の加工管理フレームワーク それを9つの段階に拡張します, 原材料の調達から、合成ロットの記録を通じた受入適格性評価まで, 同位体標識のトレーサビリティ, 分析リリースと完全なロットファイルアセンブリ, 出発材料の特性評価について ICH Q7 を引用し、樹脂ロットまたはアミノ酸源を指定できないサプライヤーに警告を発する.
アッセイに対応したペプチド データ形式には並行要件が必要です. LabKey の実践的なアッセイデータ管理の概要は、CSV 全体で何が繰り返されるかを特定します, JSON, AnIML と SDRF: サンプルの安定した識別子, ファイルと実行; 管理された語彙またはオントロジー; 明示的な単位とデータ型; 生データ間のリンク, 処理されたデータとメタデータ; そして開く, 長く存続する形式. 質量分析による同一性確認は、HPLC による純度測定ではありません。, 対イオンや TFA 対イオン交換などの内容に関する質問も解決されません. I Q2(R2), 出版された 30 11月 2023, 事前に定義された検証プロトコルの下で、分析手順が意図された目的に適合していることを示す必要がある, 報告可能な範囲には、仕様または報告限界の上限および下限が含まれることが確認されています, そしてそれらの原理を質量分析やその他の分光測定データに拡張します。.
|
標準サプライヤーパッケージの内容 |
計算チームに必要なもの |
|---|---|
|
CoA と概要分析 |
安定した識別子を持つロットリンクされたレコード |
|
最終的な純度と同一性の値 |
サイクルごとの合成の詳細とバージョン管理 |
|
ペプチド 1 静的 PDF または印刷されたレポート |
環状ペプチドの合成 明示的な単位を備えた機械可読テーブル |
|
成果物としての証明書 |
生からの由来 ペプチドサービス リリースする素材 |
文書化標準がないため必要性がなくなる ペプチド 2 ヒットの直交確認用.
これがサプライヤーにとって何を意味するか, 計算チームとバイヤー
座っている場所によってアナウンスの入り方が異なります. 合成サプライヤー様へ, ドキュメントの完全性が後付けではなく差別化要因になる. GenScript の AIDD サービス ページ シーケンスからデータへのアドバタイズを最速で行います 4 暦日, 4000+ 一日あたりのデザイン, 20年間 M 以上の AI 対応データ ポイントが生成される, 下 $10 データポイントごと, そして 3500+ グローバルパートナー組織. よく読んでください, けれど, そしてペプチドの名前はまったくありません; リストされているモダリティは VHH です, ミニプロテイン, IgG, 二重特異性, 酵素とデノボタンパク質. ペプチド化学はまだそのパイプラインの中心として実証されていません, それを示すことができるサプライヤーへの扉です. カルシトニンの合成
計算チーム向け, バインディング制約はデータセットのサイズとメタデータの十分性です. ML 支援タンパク質工学に関する公開されたベスト プラクティス ガイダンスでは、1,000 未満のインスタンス データセットでは 10 倍の相互検証が標準として扱われています, これは、トレーニング素材が通常どれだけ薄いかを示しています. ここでは TuneLab の連合学習設計が重要です: バイオテクノロジー企業は独自のデータを直接公開せずにリリーのモデルを利用する. 明らかではありませんが、Schrödinger LiveDesign の統合により、ほとんどのチームがすでに実行しているソフトウェア内でこれらのモデルに対応できることになります。. モデルはあなたが制御する変数ではありません. あなたが彼らに与えるデータは、.
バイヤーまたは QC リーダー向け, 「文書化された」にはすでに定義があります. ALCOA+ のデータ整合性に関する 10 原則では、記録が帰属可能であることが求められます, 読みやすい, 同時代の, オリジナル, 正確な, 完了, 一貫性のある, 永続的で利用可能な, そしてICH Q2(R2) 分析的検証ガイドラインでは、分析手順が事前に定義された検証プロトコルの下でその意図された目的に適合していることを示すことが求められています, この改訂では、これらの原則が質量分析に拡張されました。. 文書化された完全なペプチドの提供, そういう意味では, サンプル識別子がバッチに関連付けられているロット ファイルを意味します, アッセイのバージョンとユニットは結果とともに送信されます, そして、制御とエラーの指標は暗示されるのではなく明示されます。. MOL Changes は、そのチェーンを中心に分析パッケージが構築されているサプライヤーの 1 つです, ただし、AI 固有のデータ形式に関する独立した監査は見つかりませんでした。.
あなた自身の記録について今日問うべき 4 つの質問: モデルはこのテーブルを読み取ることができますか? サードパーティがこのバッチを再作成できますか? このアッセイ出力には識別子と単位が含まれていますか? このデータセットを前四半期のデータセットとマージできますか? ペプチド 3
今何をすべきか、そして全体像
エクスポートから始める, プラットフォームではありません. 3つのアクション, 緊急性の高い順に.
-
今週: 最近の 1 つのキャンペーンのアッセイ エクスポートを機械可読フィールド リストと照合して監査し、不足しているものを書き留めます. ほとんどのチームは午後にギャップを見つける.
-
今月: バッチ識別子の追加, 単位, エクスポートテンプレートへのアッセイバージョンと分析コードバージョン, そしてアッセイ法自体のバージョン管理を開始します.
-
今四半期: フルロットファイルをリクエストする, 樹脂ロットとアミノ酸源を含む, キャンペーンに参加する前に. 樹脂のロットやアミノ酸源を明らかにできないサプライヤーは危険信号です.
やってはいけない2つのこと. エクスポート形式を修正する前にデータ プラットフォームを再構築しないでください。, CoA をトレーニングの準備ができたデータセットとして扱わないでください。.
警戒すべき文脈を念頭に置く価値がある. アーカイブされたデータセットの手動 FAIR 再利用性監査, 45.9% 評価されたオープン データセットのうち、再利用可能と評価されたデータセット, 意味 54.1% そうではなかった. エネルギー領域のデータセット監査において, 82% のデータセットには少なくとも 1 つのキー ディメンションでデータが欠落しており、 27% 半分以上が欠けていた. このタイプの数値はソースとドメインによって異なります, ここではメタデータ損失率の例として引用されています。, ペプチドベンチマークとしてではない.
これが AI 対応ペプチド発見の全体像です: 証拠の生成, モデルの能力ではない, 律速段階になりつつある. 文書化基準が調達基準に変わりつつある, そして、現在記録をバージョン管理している研究所は、そのデータが 3 年後もまだ使用できる研究所となるでしょう。.
次のステップ: 保管管理文書フレームワークを確認し、その 9 段階のチェックリストを使用して現在のロット ファイルをスコア付けします。.
開示: MOL Changes はペプチドベンダーとしてこのブログを公開しています.
よくある質問
GenScript と TuneLab のパートナーシップはペプチドを対象としていますか??
いいえ. GenScript 自身による TuneLab 契約の発表では、サービスの範囲がタンパク質発現に限定されています, 優先順位付けされた配列の精製と特性評価. ペプチド合成はその範囲内では名前が付けられていません, したがって、ペプチドチームはこの発表を、今日購入できるサービスとしてではなく、AI支援による発見がどこに向かっているのかについてのシグナルとして読むべきである。.
「AI 対応」データが実際に何を意味するのか?
5つの具体的な性質を意味します: すべてのエンティティの安定した識別子, 自由記述フィールドの代わりに統制された語彙, 明示的な単位とデータ型, リンクされた生の, 処理されたメタデータ ファイル, ベンダーロックされたエクスポートではなく、長期間有効なフォーマットをオープンします. LabKey の実践的なアッセイ データ管理の概要では、アッセイ データに対する次の要件が定められています。. それらを満たすファイルは、人間が最初に列ヘッダーを書き換えることなく、モデルによって解析できます。. それがテスト全体です.
機械学習が役立つ前に、ペプチド分析データセットはどのくらいの大きさにする必要がありますか?
ほとんどのチームが想定しているよりも小さい, しかし、決して小さいわけではない. Cradle のタンパク質設計のためのデータ収集ガイダンスにより、ジェネレーティブ デザインが周囲から実用化されます。 96 プロパティごとのバリエーション. 典型的なタンパク質工学データセット, 対照的に, より少ない値を保持する 1,000 インスタンスは 10 分割相互検証で検証されます, ML 支援タンパク質工学に関する公開されたベストプラクティス ガイダンスで説明されているとおり. 通常、バインディング制約はそれらのインスタンス間で一貫性があります。, 彼らの数ではありません.
サプライヤーに何を依頼すればよいですか?
フルロットファイルを要求する, CoA だけではありません. MOL Changes の段階ごとの加工過程管理フレームワークでは、樹脂ロットまたはアミノ酸源を指定できないサプライヤーは危険信号として扱われます。, 証明書とともに機械可読な分析データを要求します. 受け取ったアッセイ対応のペプチド データ形式を手動で転記しないとロードできない場合, AI 対応のペプチド検出パイプラインが受信トレイで停止します.
結論
GenScript と TuneLab のパートナーシップは、ペプチドの証拠がどのように生成されるかを示すシグナルです, ペプチドデータ標準ではありません. その後、独立したテストデータは公開されていません 2024 誰もが発表を確定した仕様として扱うことができることが判明しました, したがって、実際の作業は以前と同じままになります: あなたの研究室がすでに作成した記録に.
この記録には、今すぐ行動できる 4 つの要件があります. クリーンなデータとは、モデルが手動修復せずに解析できるフィールドを意味します. 再現可能なペプチド合成記録により、樹脂およびアミノ酸の供給源にまで遡るロットレベルのトレーサビリティが可能になります。. アッセイに対応したペプチド データ形式は、機器や共同研究者間の転送に耐える結果を意味します。. 計算設計用のペプチド分析データセットは、基礎となる測定値が記述された配列に関連付けられたままであることを意味します.
次の論理的なステップは小さくて地味なものです: 完了したキャンペーンを 1 つ取得する, 現状のまま輸出する, 機械可読仕様と照らし合わせてフィールドごとにチェックします. 監査で不合格になったものはすべて、AI 対応のペプチド発見ロードマップになります。, そしてそれはどんな発表よりも具体的になるでしょう.