Hvad skete der, og hvorfor det betyder noget for AI-Ready Peptide Discovery
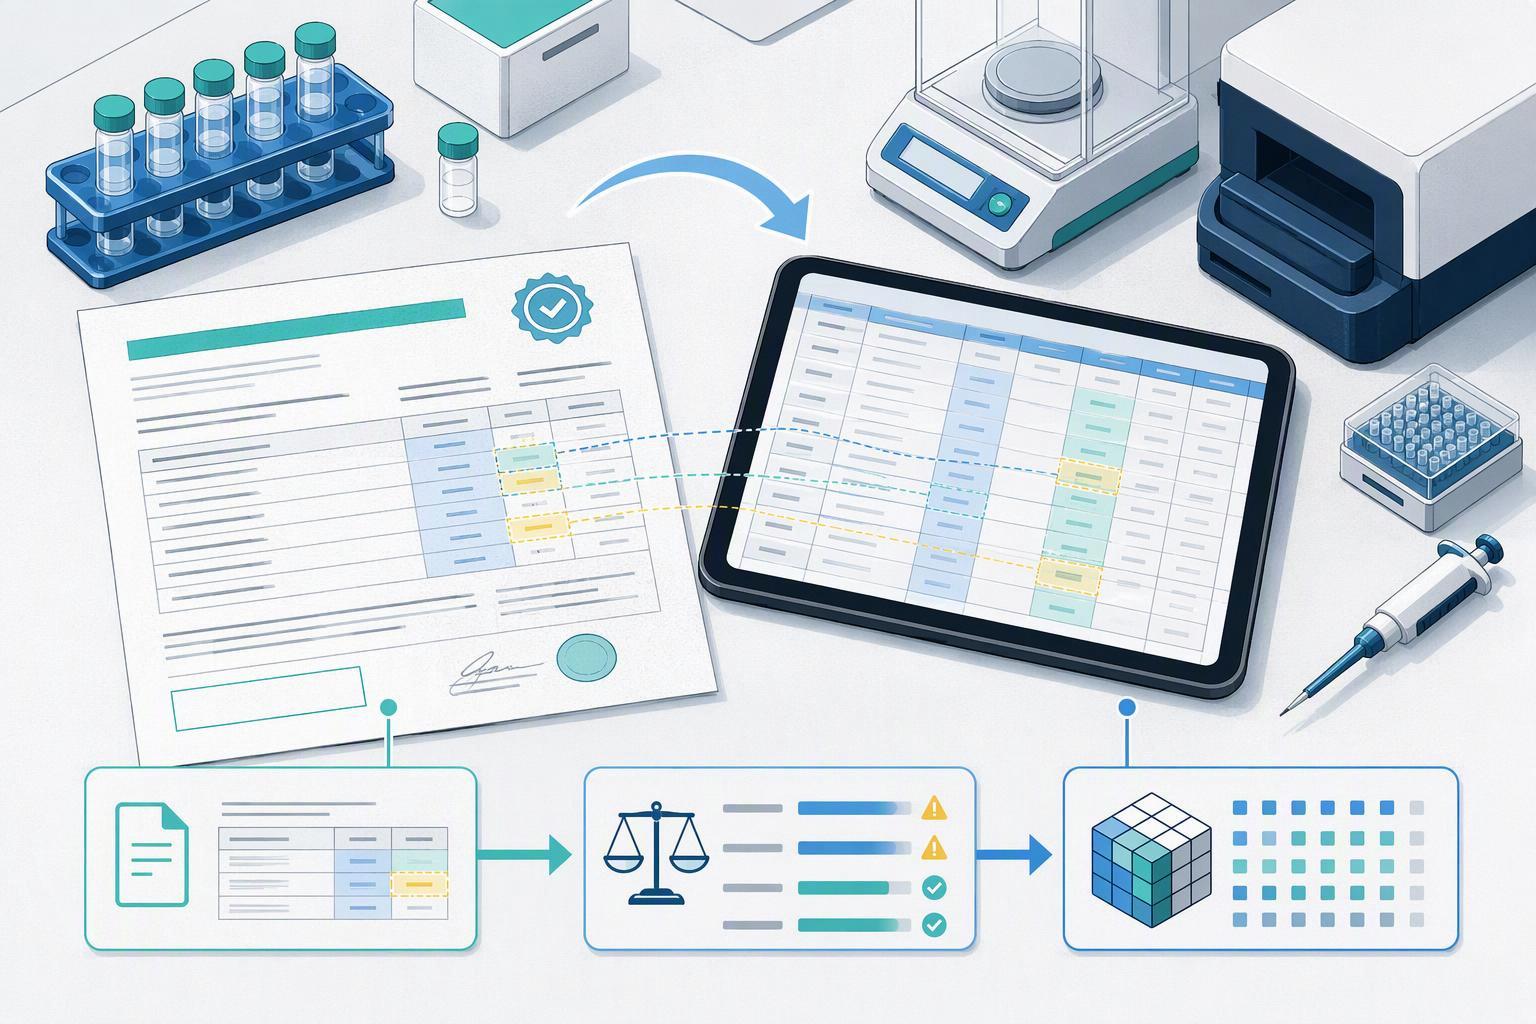
På 2026-09-16, GenScripts egen meddelelse om TuneLab-aftalen bekræftede, at virksomheden nu tilbyder foretrukne vilkår for våde laboratorier i meddelelsen: proteinekspression, oprensning og karakterisering af prioriterede sekvenser, udføres under standardiseret, fuldt dokumenterede protokoller. Læs omfanget omhyggeligt. Ingen peptiddatastandard, intet maskinlæsbart format og ingen peptidspecifikke leverancer er navngivet nogen steder i det.
Det hul er historien. Ray Chen, Formand for GenScript Life Science Group, indrammede begrundelsen i GenScripts erklærede begrundelse for partnerskabet: "AI-aktiveret lægemiddelopdagelse vil kun udvikle sig så hurtigt, som industrien kan generere pålidelige biologiske beviser."
TuneLab i sig selv er ikke ny. Lillys lanceringsmeddelelse for TuneLab daterer det til 2025-09-09, drives af Eli Lilly frem for et uafhængigt selskab, med en første frigivelse, der dækker lægemiddeldisposition, sikkerhed og prækliniske modeller. Skalaen bag det er grunden til, at leverandører er opmærksomme: proprietære data opnået til en pris på over $1 milliard, trukket fra hundredtusindvis af unikke molekyler, efter skalaen af dataene bag TuneLab. Adgang kører gennem TuneLabs forbundne læringsdesign, som lader bioteknører tage fat på Lillys modeller uden direkte at afsløre deres egne proprietære data eller Lillys.
Platformen er også ved at blive integreret i de softwareberegningsteams, der allerede bruger, ved Schrödinger LiveDesign integrationen annonceret 2026-01-09 og CDD Vaults TuneLab-integration annonceret 2026-05-20.
Så behandl dette som et signal om bevisgenerering, ikke en specifikation. Intet i meddelelsen fortæller dig, hvad AI-klar peptidopdagelse kræver af dine optegnelser. Den byrde falder på laboratoriet.
Rens data: De fire søjler i AI-Ready Peptide Discovery
AI-klar peptidopdagelse betyder, at dit eksperimentelle output kan læses, slået sammen og genbrugt af en model, uden at et menneske genindtastede den. Maskinlæsbare data bærer sine enheder, eksempel på identitet og metodeversion i strukturerede felter i stedet for en PDF- eller en notesbogside. Design-build-test-learn-cyklussen er den løkke, som disse modeller kører på: designsekvenser, syntetisere og teste dem, feed resultaterne tilbage, design igen.
Fire søjler holder løkken oppe: renere eksperimentelle data, reproducerbare synteseposter, analyseklare formater og analytiske datasæt. Baren er lavere end de fleste hold antager. Cradles dataindsamlingsvejledning til proteindesign sætter generativt ML-proteindesign inden for rækkevidde af ethvert laboratorium, der konsekvent kan teste rundt 96 proteinsekvensvarianter for hver egenskab, og bemærker, at et par dusin klogt udvalgte sekvenser kan give betydelige fremskridt. Udgivet vejledning om bedste praksis om ML-assisteret proteinteknologi rapporterer, at protein-engineering ML-datasæt ofte indeholder færre end 1,000 tilfælde, hvilket er grunden til, at validering almindeligvis bruger 10-dobbelt krydsvalidering i stedet for en enkelt udholdt split.
Små datasæt straffer sjuskede optegnelser. GENs analyse af, hvorfor AI-lægemiddelopdagelsesindsatsen underpræsterer anfører, at modeller fodres inkonsekvente, ufuldstændig, tvetydige eller dårligt formaterede data lærer støjen sammen med signalet, giver sikre, men mindre pålidelige forudsigelser. Fejlmønsteret er banalt: enheder registreret som mg/ml i én kørsel og µg/µL i den næste, friteksteksempelnavne, som ingen joinnøgle kan matche, manglende batch-id'er, og ingen versionering af analysemetoden eller analysekoden. Enhver af disse forhindrer et datasæt i at flette på tværs af kørsler.
Opstrømsårsagen er fragmentering, ikke skødesløshed. LabKeys oversigt over praktisk analysedatahåndtering beskriver analysedata, der lever i siloer, på fællesdrev, i laboratorie-notesbøger, eller indlejret i e-mails, med instrument heterogenitet på tværs af leverandører og filtyper og intet konsekvent format. Peptiddatakvalitet for AI-modeller er derfor et registreringsproblem, før det er et modelleringsproblem.
Nøgle takeaway: En kampagne, der tester rundt 96 varianter pr. ejendom er allerede i generativt designområde. Det, der diskvalificerer datasættet, er inkonsistente enheder, friteksteksempler på navne, manglende batch-id'er og uversionerede metoder, ikke stikprøveantallet.
Reproducerbare synteseposter og analyseklare formater
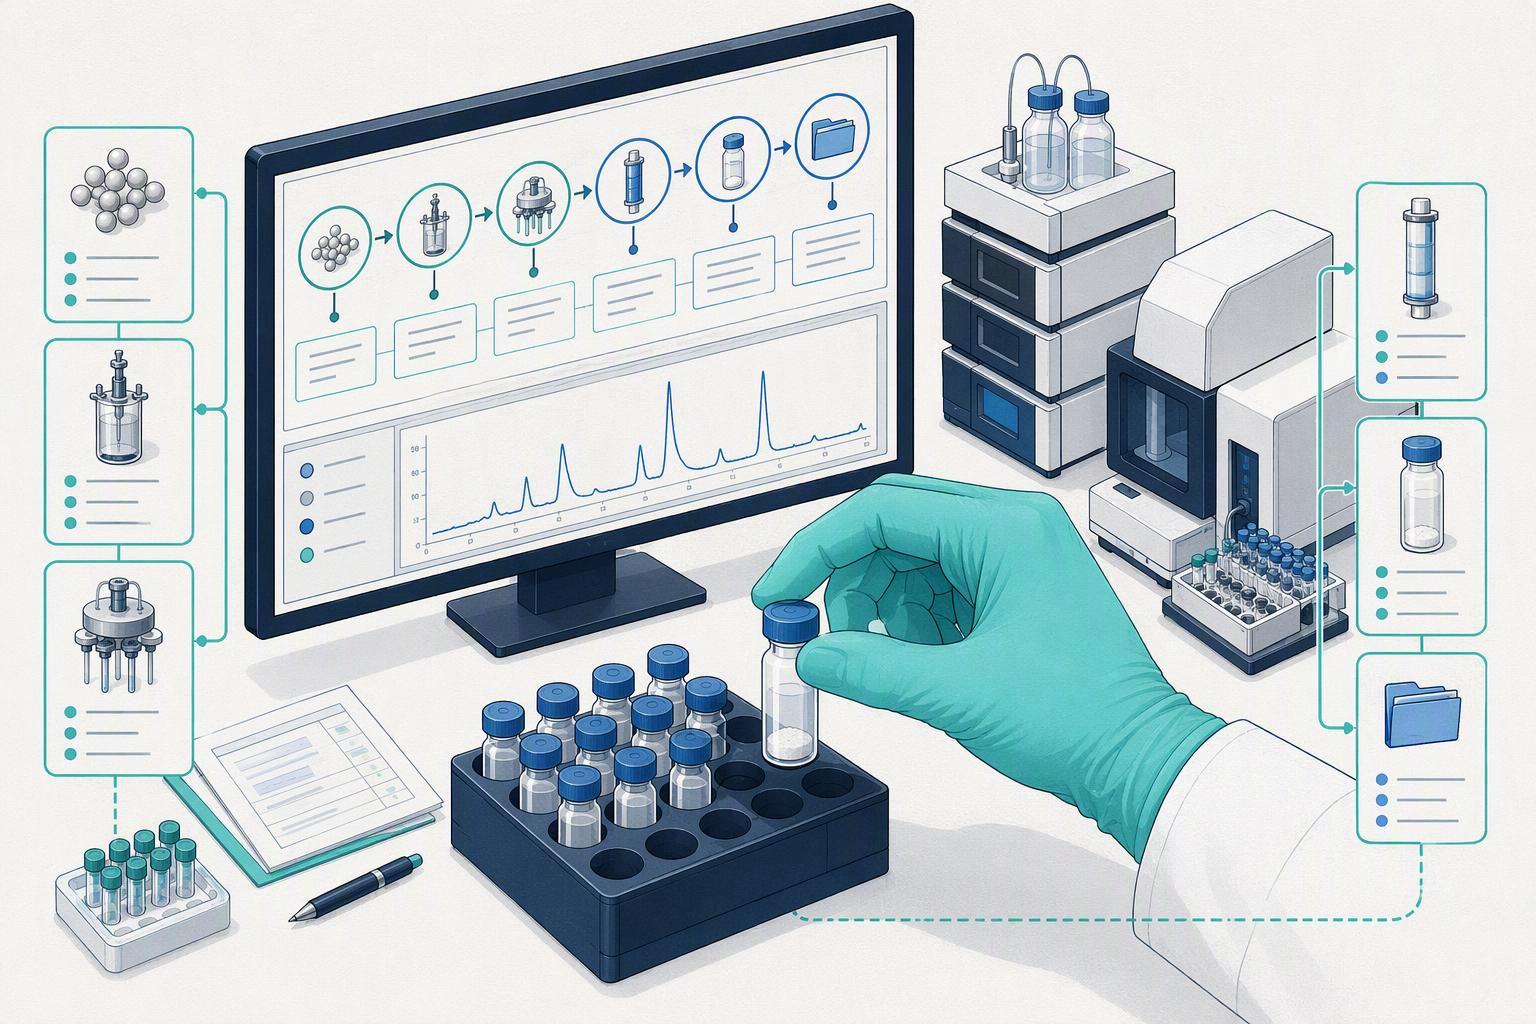
Et analysecertifikat er ikke en reproducerbar peptidsyntesepost. Enheden for reproducerbarhed er partifilen: de American Peptide Society's SPPS primer beskriver en batch-record, der er detaljeret nok til, at en tredjepart kan genskabe kørslen, dækkende harpikstype og belastning, per-cyklus afbeskyttelse og kobling med reagenser og ækvivalenter, vasketrin og udstyr. Den standardmanuelle Fmoc-cyklus, den dokumenterer, foreskriver 20% piperidin/DMF afbeskyttelse (5 minutter, så 15 minutter) og 3 × 1 ml DMF-vaske pr. cyklus. MOL Changes' fase-for-trin chain-of-custody-ramme udvider det i ni faser, fra råmateriale sourcing og indgående kvalifikation gennem syntese lot records, sporbarhed af isotopmærkning, analytisk frigivelse og komplet samling af lot-fil, citerer ICH Q7 til karakterisering af udgangsmateriale og markerer en leverandør, der ikke kan navngive harpikspartiet eller aminosyrekilden.
Analyseklare peptiddataformater har et parallelt krav. LabKeys oversigt over praktisk analysedatahåndtering identificerer, hvad der gentager sig på tværs af CSV, JSON, AnIML og SDRF: stabile identifikatorer for prøver, filer og kørsler; kontrollerede ordforråd eller ontologier; eksplicitte enheder og datatyper; links mellem rådata, behandlede data og metadata; og åben, langlivede formater. Identitetsbekræftelse ved massespektrometri er ikke renhedsbestemmelse ved HPLC, og hverken løser kontraion- eller indholdsspørgsmål såsom TFA-modionudveksling. I Q2(R2), offentliggjort 30 november 2023, kræver, at en analytisk procedure vises egnet til dets tilsigtede formål under en foruddefineret valideringsprotokol, med det rapporterbare interval bekræftet til at omfatte øvre og nedre specifikation eller rapporteringsgrænser, og udvider disse principper til massespektrometri og andre spektrometriske data.
|
Hvad en standard leverandørpakke indeholder |
Hvad et computerhold har brug for |
|---|---|
|
CoA plus sammenfattende analyser |
Lot-linked records med stabile identifikatorer |
|
Endelige renheds- og identitetsværdier |
Syntesedetaljer og versionering pr. cyklus |
|
Peptid 1 Statisk PDF eller udskrevet rapport |
Cyklisk peptidsyntese Maskinlæsbare tabeller med eksplicitte enheder |
|
Certifikat som leverance |
Herkomst fra rå Peptidtjenester materiale at frigive |
Ingen dokumentationsstandard fjerner behovet Peptid 2 til ortogonal bekræftelse af hits.
Hvad dette betyder for leverandører, Beregningsteams og indkøbere
Meddelelsen lander forskelligt alt efter, hvor du sidder. For syntetiseringsleverandøren, dokumentationsfuldstændighed bliver en differentiator snarere end en eftertanke. GenScripts AIDD-serviceside annoncerer sekvens-til-data så hurtigt som 4 kalenderdage, 4000+ designs om dagen, 20M+ AI-klare datapunkter genereret pr. år, under $10 pr. datapunkt, og 3500+ globale partnerorganisationer. Læs den nøje, selvom, og det navngiver ingen peptider overhovedet; dens anførte modaliteter er VHH'er, miniproteiner, IgG, bispecifikke, enzymer og de novo proteiner. Peptidkemi er endnu ikke det demonstrerede centrum af denne pipeline, som er åbningen for leverandører, der kan vise det. Calcitonin syntese
For beregningsteamet, den bindende begrænsning er datasætstørrelse og metadatatilstrækkelighed. Udgivet vejledning om bedste praksis om ML-assisteret proteinteknologi behandler 10 gange krydsvalidering som normen på datasæt under 1.000 instanser, som fortæller dig, hvor tyndt træningsmaterialet normalt er. TuneLabs forbundslærende design betyder noget her: bioteknikere benytter sig af Lillys modeller uden direkte at afsløre proprietære data. Den ikke-oplagte implikation er, at Schrödinger LiveDesign-integrationen betyder, at de fleste teams vil møde disse modeller i software, de allerede kører. Modellerne er ikke den variabel, du kontrollerer. De data du fodrer dem er.
For køberen eller QC lead, "dokumenteret" har allerede en definition. De ti ALCOA+ dataintegritetsprincipper kræver, at registreringer kan henføres, læselig, samtidige, original, nøjagtig, komplet, konsekvent, udholdende og tilgængelig, og ICH Q2(R2) analytisk valideringsvejledning kræver, at en analytisk procedure vises egnet til dets tilsigtede formål under en foruddefineret valideringsprotokol, med revisionen, der udvider disse principper til at omfatte massespektrometri. En dokumentationsfuldstændig peptidlevering, i de termer, betyder en partifil, hvor prøveidentifikationen knytter sig tilbage til batchen, analyseversionen og enhederne rejser med resultatet, og kontrollerne og fejlmålingerne er angivet snarere end underforstået. MOL Changes er en leverandør, hvis analysepakke er bygget op omkring den kæde, selvom der ikke blev fundet nogen uafhængig revision af dets AI-specifikke dataformater.
Fire spørgsmål at stille til dine egne poster i dag: Kan en model læse denne tabel? Kan en tredjepart genskabe denne batch? Bærer denne analyseudgang identifikatorer og enheder? Kan dette datasæt lægges sammen med sidste kvartals? Peptid 3
Hvad du skal gøre nu og det større billede
Start med eksporten, ikke platformen. Tre handlinger, i hastende rækkefølge.
-
Denne uge: overvåg en nylig kampagnes assayeksport mod din maskinlæsbare feltliste og skriv ned, hvad der mangler. De fleste hold finder hullerne på en eftermiddag.
-
Denne måned: tilføje batch-id'er, enheder, analyseversion og analysekodeversion til eksportskabelonen, og start versionering af selve analysemetoden.
-
Dette kvartal: anmode om den fulde partifil, inklusive harpiksparti og aminosyrekilde, før du forpligter dig til en kampagne. En leverandør, der ikke kan navngive harpikspartiet eller aminosyrekilden, er et rødt flag.
To ting man ikke skal gøre. Genopbyg ikke en dataplatform, før du har rettet eksportformatet, og behandle ikke en CoA som et træningsklar datasæt.
Den advarende kontekst er værd at holde øje med. I en manuel FAIR-genanvendelighedsrevision af arkiverede datasæt, 45.9% af vurderede åbne datasæt blev vurderet som genbrugelige, mening 54.1% var ikke. I energidomænets datasætrevision, 82% af datasæt havde manglende data i mindst én nøgledimension og 27% manglede mere end halvdelen. Tal af denne type varierer efter kilde og domæne, og de er citeret her som en illustration af tab af metadata, ikke som peptid benchmarks.
Det er det større billede for opdagelse af AI-klare peptider: bevisgenerering, ikke modelkapacitet, er ved at blive det satsbegrænsende trin. Dokumentationsstandarder bliver til et indkøbskriterium, og de laboratorier, der versionerer deres registreringer nu, vil være dem, hvis data stadig er brugbare om tre år.
Næste skridt: gennemgå chain-of-custody dokumentationsrammen og brug dens ni-trins tjekliste til at score dine nuværende lot filer.
Afsløring: MOL Changes udgiver denne blog som en peptidleverandør.
Ofte stillede spørgsmål
Dækker GenScript-TuneLab-partnerskabet peptider?
Ingen. GenScripts egen meddelelse af TuneLab-aftalen omfatter tjenesten til proteinekspression, oprensning og karakterisering af prioriterede sekvenser. Peptidsyntese er ikke nævnt i dette omfang, så peptidhold bør læse meddelelsen som et signal om, hvor AI-assisteret opdagelse er på vej hen, snarere end som en service, de kan købe i dag.
Hvad betyder "AI-klar" data egentlig i praksis?
Det betyder fem konkrete egenskaber: stabile identifikatorer for hver enhed, kontrollerede ordforråd i stedet for fritekstfelter, eksplicitte enheder og datatyper, kædet rå, behandlede filer og metadatafiler, og åbne langlivede formater i stedet for leverandørlåst eksport. LabKeys oversigt over praktisk styring af assaydata angiver disse krav til assaydata. En fil, der opfylder dem, kan parses af en model uden en menneskelig omskrivning af kolonneoverskrifter først. Det er hele testen.
Hvor stort skal et peptidanalytisk datasæt være, før maskinlæring hjælper?
Mindre end de fleste hold antager, men ikke trivielt lille. Cradles dataindsamlingsvejledning til proteindesign sætter generativt design til praktisk fra omkring 96 varianter pr. ejendom. Typiske protein-tekniske datasæt, derimod, holde færre end 1,000 instanser og valideres med 10 gange krydsvalidering, som offentliggjort vejledning om bedste praksis om ML-assisteret proteinteknologi beskriver. Den bindende begrænsning er normalt konsistens på tværs af disse tilfælde, ikke deres tæller.
Hvad skal jeg bede en leverandør om?
Spørg efter den fulde partifil, ikke CoA alene. MOL Changes' trinvise chain-of-custody-ramme behandler en leverandør, der ikke kan navngive harpikspartiet eller aminosyrekilden som et rødt flag, og beder om maskinlæsbare analytiske data ved siden af certifikatet. Hvis de analyseklare peptiddataformater, du modtager, ikke kan indlæses uden manuel transkription, den AI-klare peptidopdagelsespipeline stopper ved din indbakke.
Konklusion
GenScript-TuneLab-partnerskabet er et signal om, hvordan peptidbevis bliver genereret, ikke en peptiddatastandard. Ingen uafhængige testdata offentliggjort efter 2024 blev fundet, der ville lade enhver behandle meddelelsen som en fastlagt specifikation, så det praktiske arbejde bliver, hvor det altid har været: i den registrering, dit laboratorium allerede producerer.
Den rekord har fire krav, du kan handle på nu. Rene data betyder felter, som en model kan parse uden manuel reparation. Reproducerbare peptidsynteseregistreringer betyder sporbarhed på partiniveau tilbage til harpiks- og aminosyrekilder. Analyseklare peptiddataformater betyder resultater, der overlever overførsel mellem instrumenter og samarbejdspartnere. Peptidanalytiske datasæt til beregningsdesign betyder, at de underliggende målinger forbliver knyttet til de sekvenser, de beskriver.
Det næste logiske skridt er lille og uglamorøst: tage en gennemført kampagne, eksportere det, som det står i dag, og kontroller det felt for felt mod en maskinlæsbar specifikation. Uanset hvad der fejler denne revision, er din køreplan for opdagelse af AI-klare peptider, og det vil være mere specifikt end nogen meddelelse.