AI 지원 펩타이드 발견에 무슨 일이 일어났고 왜 중요한가요?
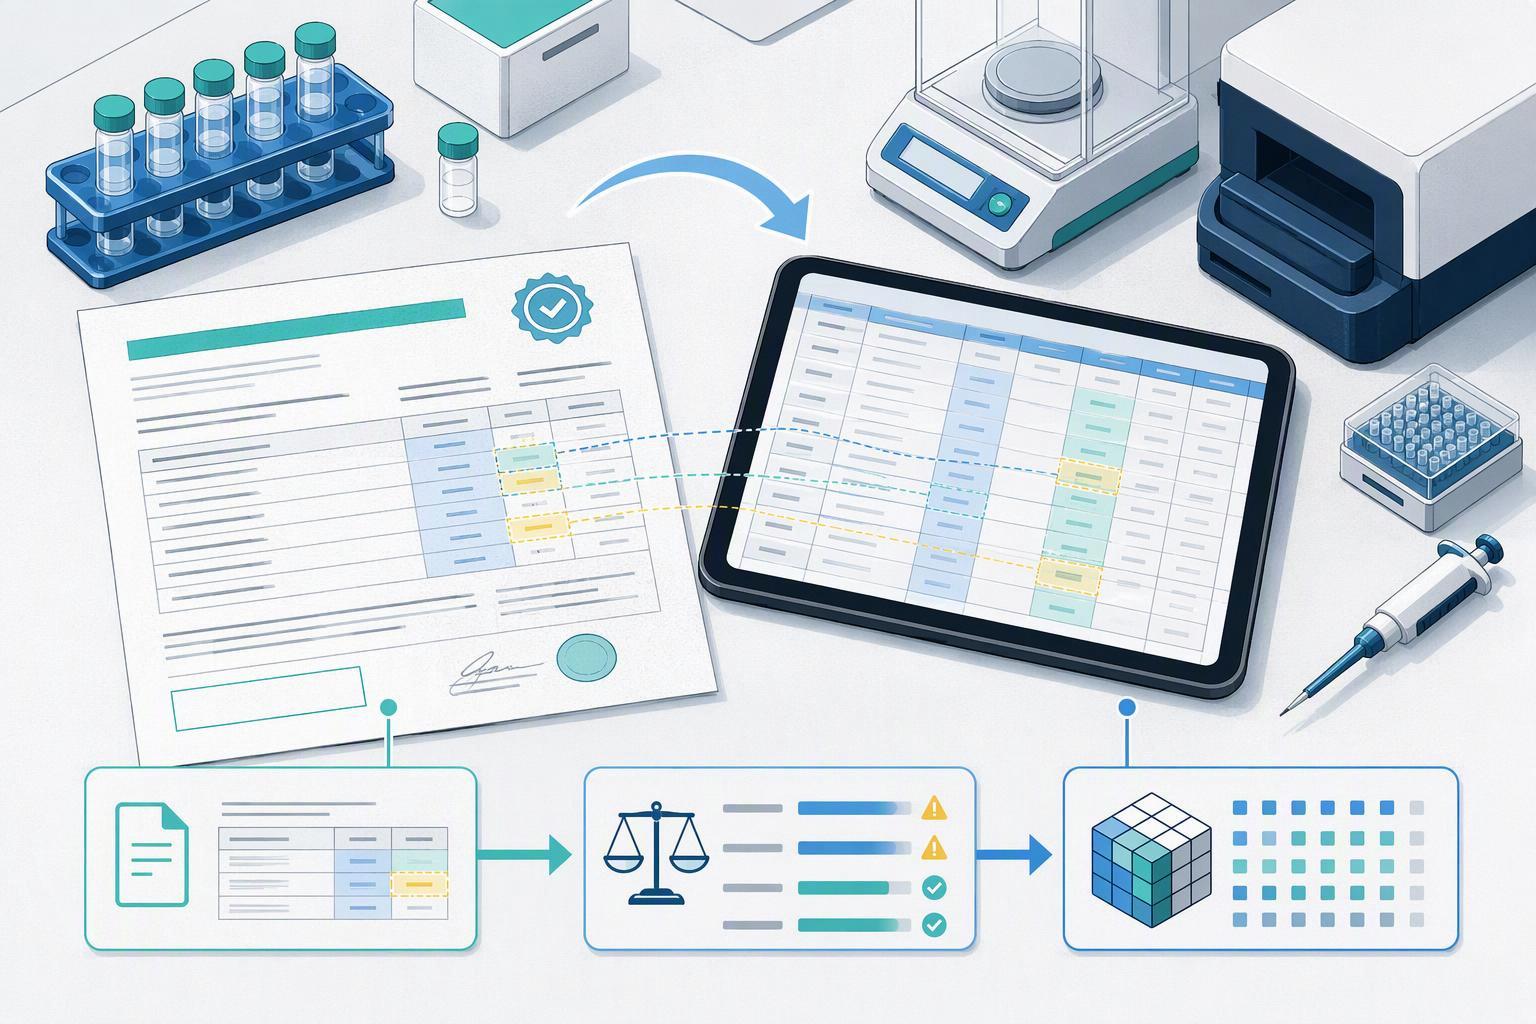
~에 2026-09-16, GenScript의 TuneLab 계약 발표 회사는 이제 발표에서 우대율의 습식 실험실 조건을 제공한다고 확인했습니다.: 단백질 발현, 우선순위가 지정된 시퀀스의 정제 및 특성화, 표준화된 방식으로 수행됨, 완전히 문서화된 프로토콜. 범위를 주의 깊게 읽으십시오. 펩타이드 데이터 표준 없음, 기계가 읽을 수 있는 형식이 없고 펩타이드별 결과물의 이름이 어디에도 없습니다..
그 격차가 이야기다. 레이 첸, GenScript 생명과학 그룹 회장, 파트너십에 대해 GenScript가 명시한 근거를 근거로 삼았습니다.: “AI 기반 신약 발견은 업계가 신뢰할 수 있는 생물학적 증거를 생성할 수 있는 만큼만 빠르게 발전할 것입니다.”
TuneLab 자체는 새로운 것이 아닙니다.. Lilly의 TuneLab 출시 발표 날짜를 기입하다 2025-09-09, 독립 회사가 아닌 Eli Lilly가 운영함, 약물 배치를 다루는 첫 번째 릴리스, 안전성 및 전임상 모델. 그 뒤에 있는 규모는 공급업체가 주목하는 이유입니다.: 이상의 비용으로 얻은 독점 데이터 $1 10억, 수십만 개의 독특한 분자에서 추출, TuneLab의 데이터 규모에 따라. 액세스는 TuneLab의 연합 학습 설계를 통해 실행됩니다., 이를 통해 생명공학 기업은 자체 독점 데이터나 Lilly의 데이터를 직접 노출하지 않고도 Lilly의 모델을 활용할 수 있습니다..
플랫폼은 또한 이미 사용하고 있는 소프트웨어 계산 팀에도 내장되고 있습니다., ~을 통해 Schrödinger LiveDesign 통합 발표 2026-01-09 CDD Vault의 TuneLab 통합 발표 2026-05-20.
따라서 이것을 증거 생성에 대한 신호로 취급하십시오., 사양이 아닌. 발표 내용에는 AI 지원 펩타이드 발견에 필요한 기록이 무엇인지 알려주는 내용이 없습니다.. 그 부담은 연구실에 있다.
데이터 정리: AI 지원 펩타이드 발견의 4가지 핵심
AI 지원 펩티드 발견은 실험 결과를 읽을 수 있음을 의미합니다., 사람이 다시 입력하지 않고도 모델에 의해 병합 및 재사용됨. 기계가 읽을 수 있는 데이터에는 단위가 포함됩니다., PDF 또는 노트북 페이지 대신 구조화된 필드의 샘플 ID 및 메소드 버전. 디자인-빌드-테스트-학습 주기는 해당 모델이 실행되는 루프입니다.: 디자인 순서, 합성해서 테스트해봐, 결과를 다시 피드, 다시 디자인하다.
네 개의 기둥이 그 고리를 지탱하고 있어요: 더 깨끗한 실험 데이터, 재현 가능한 합성 기록, 분석용 형식 및 분석 데이터 세트. 기준은 대부분의 팀이 가정하는 것보다 낮습니다.. 단백질 디자인을 위한 Cradle의 데이터 수집 지침 지속적으로 테스트할 수 있는 모든 실험실에서 생성적 ML 단백질 설계를 제공합니다. 96 각 속성에 대한 단백질 서열 변형, 그리고 현명하게 선택된 수십 개의 시퀀스가 상당한 진전을 가져올 수 있다는 점에 주목합니다.. ML 지원 단백질 공학에 대한 모범 사례 지침 게시 단백질 공학 ML 데이터 세트는 종종 1,000 인스턴스, 이것이 바로 검증이 일반적으로 단일 유지 분할 대신 10겹 교차 검증을 사용하는 이유입니다..
작은 데이터 세트는 엉성한 기록을 처벌합니다.. AI 약물 발견 노력이 성과가 저조한 이유에 대한 GEN의 분석 모델이 일관성 없이 공급되었다고 말합니다., 불완전한, 모호하거나 형식이 잘못된 데이터는 신호와 함께 노이즈를 학습합니다., 확신이 있지만 신뢰도가 떨어지는 예측을 내림. 실패 패턴은 평범하다: 단위는 한 실행에서 mg/mL로 기록되고 다음 실행에서는 µg/μL로 기록됩니다., 조인 키와 일치할 수 없는 자유 텍스트 샘플 이름, 누락된 배치 식별자, 분석 방법이나 분석 코드의 버전 관리가 없습니다.. 이들 중 하나는 데이터 세트가 실행 전반에 걸쳐 병합되는 것을 중지합니다..
업스트림 원인은 조각화입니다., 부주의가 아닌. LabKey의 실제 분석 데이터 관리 개요 사일로에 있는 분석 데이터를 설명합니다., 공유 드라이브에, 실험실 노트에, 또는 이메일에 포함됨, 공급업체와 파일 유형에 걸쳐 계측기가 이질적이며 일관된 형식이 없음. 따라서 AI 모델의 펩타이드 데이터 품질은 모델링 문제 이전에 기록 문제입니다..
핵심 내용: 주변을 테스트하는 캠페인 96 속성별 변형은 이미 제너레이티브 디자인 영역에 있습니다.. 데이터 세트를 부적격하게 만드는 것은 일관성 없는 단위입니다., 자유 텍스트 샘플 이름, 누락된 배치 ID 및 버전이 지정되지 않은 메소드, 샘플 개수가 아니라.
재현 가능한 합성 기록 및 분석 준비 형식
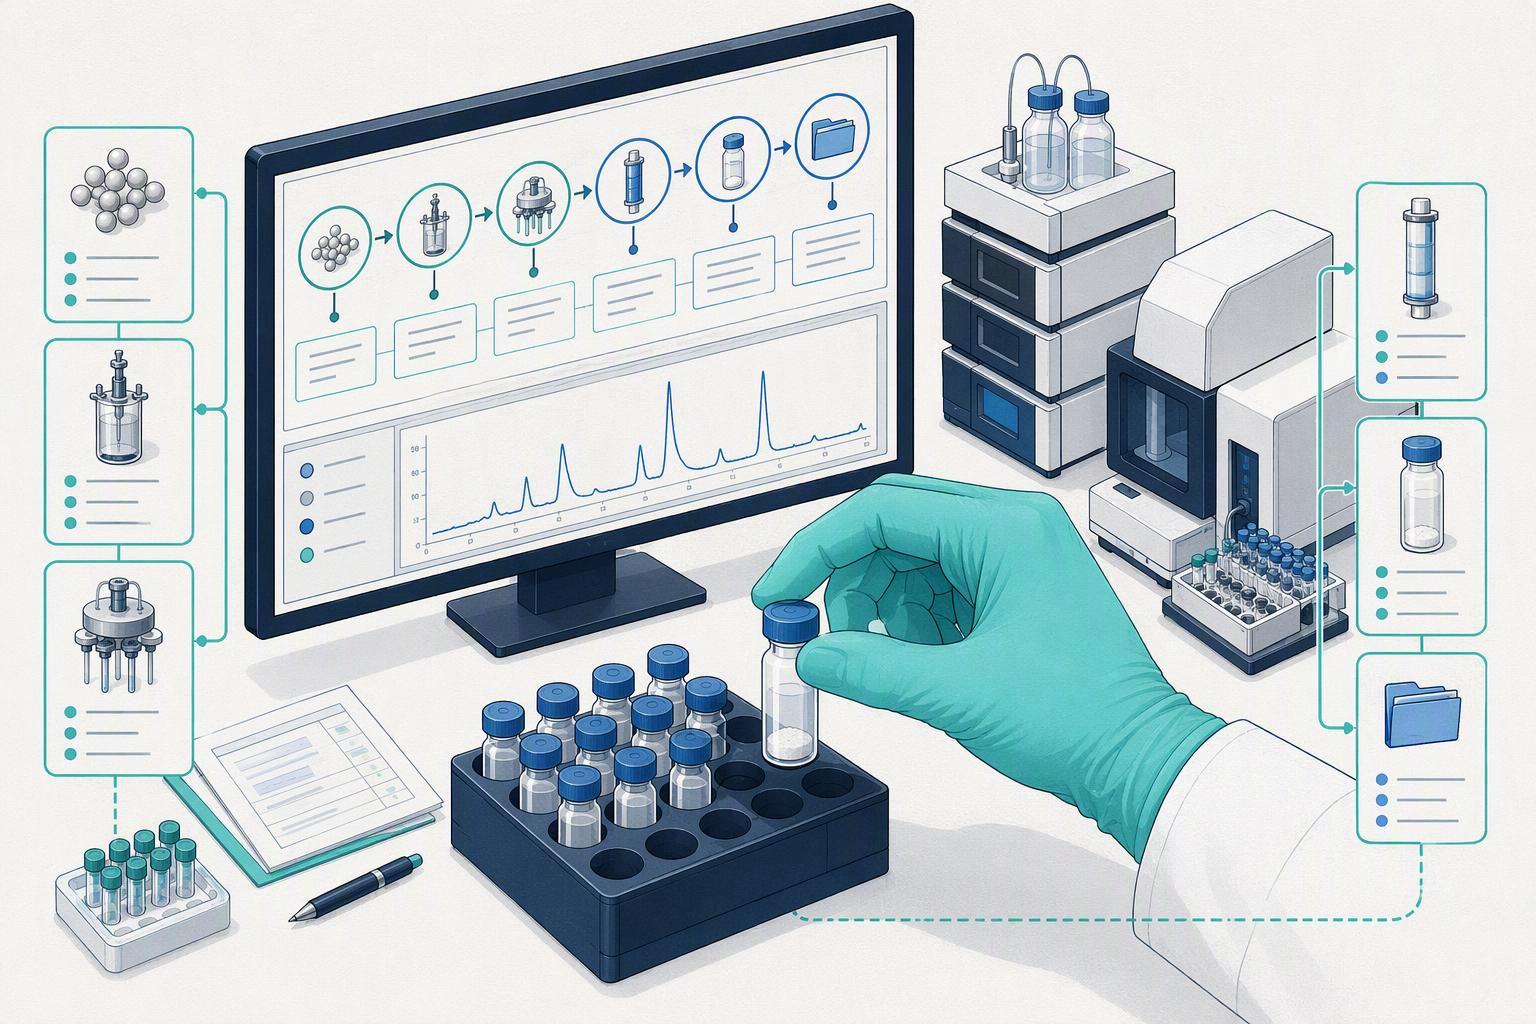
분석 인증서는 재현 가능한 펩타이드 합성 기록이 아닙니다.. 재현성의 단위는 로트 파일입니다.: 그만큼 American Peptide Society의 SPPS 입문서 제3자가 실행을 다시 생성할 수 있을 만큼 상세한 배치 기록을 설명합니다., 커버링 수지 종류 및 로딩, 주기별 탈보호 및 시약 및 등가물과의 결합, 세척 단계 및 장비. 문서에 규정된 표준 수동 Fmoc 사이클 20% 피페리딘/DMF 탈보호 (5 분, 그 다음에 15 분) 그리고 3 × 1 주기당 mL DMF 세척. MOL Changes의 단계별 관리 연속성 프레임워크 9단계로 확장, 원자재 소싱 및 입고 적격성 평가부터 합성 로트 기록까지, 동위원소 라벨링 추적성, 분석 릴리스 및 완전한 로트 파일 조립, 출발 물질 특성화를 위해 ICH Q7을 인용하고 수지 로트나 아미노산 공급원을 명명할 수 없는 공급자를 표시합니다..
분석 준비가 된 펩타이드 데이터 형식에는 병렬 요구 사항이 있습니다.. LabKey의 실제 분석 데이터 관리 개요는 CSV에서 반복되는 내용을 식별합니다., JSON, AnIML 및 SDRF: 샘플의 안정적인 식별자, 파일 및 실행; 통제된 어휘 또는 온톨로지; 명시적 단위 및 데이터 유형; 원시 데이터 간의 링크, 처리된 데이터 및 메타데이터; 그리고 열어, 수명이 긴 형식. 질량분석법에 의한 동일성 확인은 HPLC에 의한 순도 측정이 아닙니다., TFA 반대 이온 교환과 같은 반대 이온이나 콘텐츠 문제를 해결하지 않습니다.. 나는 Q2(R2), 출판됨 30 십일월 2023, 사전 정의된 검증 프로토콜에 따라 분석 절차가 의도된 목적에 적합한 것으로 입증되어야 합니다., 보고 가능 범위에 사양 상한 및 하한 또는 보고 한계가 포함된 것으로 확인됨, 이러한 원리를 질량 분석 및 기타 분광 데이터로 확장합니다..
|
표준 공급업체 패키지에 포함된 내용 |
전산팀에 필요한 것 |
|---|---|
|
CoA 및 요약 분석 |
안정적인 식별자가 있는 로트 연결 레코드 |
|
최종 순도 및 동일성 값 |
주기별 합성 세부 사항 및 버전 관리 |
|
펩타이드 1 정적 PDF 또는 인쇄된 보고서 |
고리형 펩타이드 합성 명시적 단위가 있는 기계 판독 가능 테이블 |
|
결과물로서의 인증서 |
원시의 출처 펩타이드 서비스 공개할 자료 |
어떤 문서 표준도 필요하지 않습니다. 펩타이드 2 히트의 직교 확인을 위해.
이것이 공급업체에 미치는 영향, 전산팀 및 구매자
당신이 어디에 앉느냐에 따라 안내방송이 다르게 전달됩니다.. 합성 공급업체의 경우, 문서의 완전성은 나중에 고려하는 것이 아니라 차별화 요소가 됩니다.. GenScript의 AIDD 서비스 페이지 다음과 같은 속도로 시퀀스-데이터를 광고합니다. 4 역일, 4000+ 하루에 디자인, 20연간 M+ AI 지원 데이터 포인트 생성, 아래에 $10 데이터 포인트당, 그리고 3500+ 글로벌 파트너 조직. 자세히 읽어보세요, 그렇지만, 그리고 전혀 펩타이드 이름이 없습니다; 나열된 양식은 VHH입니다., 미니단백질, IgG, 이중특이성, 효소와 새로운 단백질. 펩타이드 화학은 아직 파이프라인의 입증된 중심이 아닙니다., 이를 보여줄 수 있는 공급업체를 위한 기회입니다.. 칼시토닌 합성
전산팀의 경우, 바인딩 제약 조건은 데이터세트 크기와 메타데이터 충분성입니다.. ML 지원 단백질 엔지니어링에 대해 게시된 모범 사례 지침은 1,000개 이하의 인스턴스 데이터 세트에 대한 표준으로 10겹 교차 검증을 처리합니다., 이는 훈련 자료가 일반적으로 얼마나 얇은지를 알려줍니다.. 여기서 TuneLab의 연합 학습 설계가 중요합니다.: 생명공학 기업은 독점 데이터를 직접 노출하지 않고 Lilly의 모델을 활용합니다.. 명백하지 않은 의미는 Schrödinger LiveDesign 통합으로 인해 대부분의 팀이 이미 실행 중인 소프트웨어 내에서 이러한 모델을 충족하게 된다는 것입니다.. 모델은 사용자가 제어하는 변수가 아닙니다.. 당신이 그들에게 제공하는 데이터는.
구매자 또는 QC 리드의 경우, "문서화됨"에는 이미 정의가 있습니다.. 10가지 ALCOA+ 데이터 무결성 원칙은 기록의 귀속을 요구합니다., 읽기 쉬운, 동시대의, 원래의, 정확한, 완벽한, 일관된, 지속적이고 사용 가능, 그리고 ICH Q2(R2) 분석 밸리데이션 지침에서는 사전 정의된 밸리데이션 프로토콜에 따라 분석 절차가 의도된 목적에 적합함을 보여야 합니다., 개정을 통해 이러한 원리를 질량 분석법으로 확장. 문서화된 완전한 펩타이드 전달, 그런 의미에서, 샘플 식별자가 배치에 다시 연결되는 로트 파일을 의미합니다., 분석 버전과 단위는 결과와 함께 이동합니다., 통제 및 오류 측정항목은 묵시적인 것이 아니라 명시되어 있습니다.. MOL Changes는 해당 체인을 중심으로 분석 패키지가 구축된 공급업체입니다., AI 관련 데이터 형식에 대한 독립적인 감사는 발견되지 않았지만.
오늘 자신의 기록에 대해 물어볼 네 가지 질문: 모델이 이 테이블을 읽을 수 있나요?? 제3자가 이 배치를 다시 생성할 수 있나요?? 이 분석 결과에 식별자와 단위가 포함되어 있습니까?? 이 데이터세트를 지난 분기의 데이터세트와 병합할 수 있나요?? 펩타이드 3
지금 해야 할 일과 더 큰 그림
내보내기부터 시작하세요, 플랫폼이 아닌. 세 가지 행동, 긴급한 순서대로.
-
이번주: 기계가 읽을 수 있는 필드 목록과 비교하여 최근 캠페인의 분석 내보내기를 감사하고 누락된 내용을 기록합니다.. 대부분의 팀은 오후에 공백을 찾습니다..
-
이번 달: 배치 식별자 추가, 단위, assay version and analysis-code version to the export template, and start versioning the assay method itself.
-
This quarter: request the full lot file, including resin lot and amino-acid source, before committing to a campaign. A supplier who cannot name the resin lot or the amino-acid source is a red flag.
Two things not to do. Do not rebuild a data platform before fixing the export format, and do not treat a CoA as a training-ready dataset.
The cautionary context is worth keeping in view. In a manual FAIR reusability audit of archived datasets, 45.9% of assessed open datasets were rated reusable, meaning 54.1% were not. In the energy-domain dataset audit, 82% of datasets had missing data in at least one key dimension and 27% were missing more than half. Figures of this type vary by source and domain, and they are cited here as an illustration of metadata loss rates, not as peptide benchmarks.
That is the bigger picture for AI-ready peptide discovery: evidence generation, not model capability, is becoming the rate-limiting step. Documentation standards are turning into a procurement criterion, and the labs that version their records now will be the ones whose data is still usable in three years.
다음 단계: review the chain-of-custody documentation framework and use its nine-stage checklist to score your current lot files.
폭로: MOL Changes publishes this blog as a peptide vendor.
자주 묻는 질문
GenScript-TuneLab 파트너십이 펩타이드를 다루고 있습니까??
아니요. GenScript’s own announcement of the TuneLab agreement scopes the service to protein expression, 우선순위가 지정된 시퀀스의 정제 및 특성화. Peptide synthesis is not named in that scope, so peptide teams should read the announcement as a signal about where AI-assisted discovery is heading rather than as a service they can buy today.
What does “AI-ready” data actually mean in practice?
It means five concrete properties: stable identifiers for every entity, controlled vocabularies instead of free-text fields, 명시적 단위 및 데이터 유형, linked raw, processed and metadata files, and open long-lived formats rather than vendor-locked exports. LabKey’s overview of practical assay data management sets out these requirements for assay data. A file that satisfies them can be parsed by a model without a human rewriting column headers first. That is the whole test.
기계 학습이 도움이 되기 전에 펩타이드 분석 데이터 세트의 크기는 얼마나 커야 합니까??
Smaller than most teams assume, but not trivially small. Cradle’s data-collection guidance for protein design puts generative design at practical from around 96 variants per property. Typical protein-engineering datasets, 대조적으로, hold fewer than 1,000 instances and are validated with 10-fold cross-validation, as published best-practice guidance on ML-assisted protein engineering describes. The binding constraint is usually consistency across those instances, not their count.
공급업체에 무엇을 요청해야 합니까??
Ask for the full lot file, not the CoA alone. MOL Changes’ stage-by-stage chain-of-custody framework treats a supplier who cannot name the resin lot or the amino-acid source as a red flag, and asks for machine-readable analytical data alongside the certificate. If the assay-ready peptide data formats you receive cannot be loaded without manual transcription, the AI-ready peptide discovery pipeline stops at your inbox.
결론
The GenScript-TuneLab partnership is a signal about how peptide evidence gets generated, not a peptide data standard. No independent test data published after 2024 was found that would let anyone treat the announcement as a settled specification, so the practical work stays where it always was: in the record your lab already produces.
That record has four requirements you can act on now. Clean data means fields a model can parse without manual repair. Reproducible peptide synthesis records mean lot-level traceability back to resin and amino acid sources. Assay-ready peptide data formats mean results that survive transfer between instruments and collaborators. Peptide analytical datasets for computational design mean the underlying measurements stay attached to the sequences they describe.
The next logical step is small and unglamorous: take one completed campaign, export it as it stands today, and check it field by field against a machine-readable specification. Whatever fails that audit is your AI-ready peptide discovery roadmap, and it will be more specific than any announcement.