Qué sucedió y por qué es importante para el descubrimiento de péptidos listos para la IA
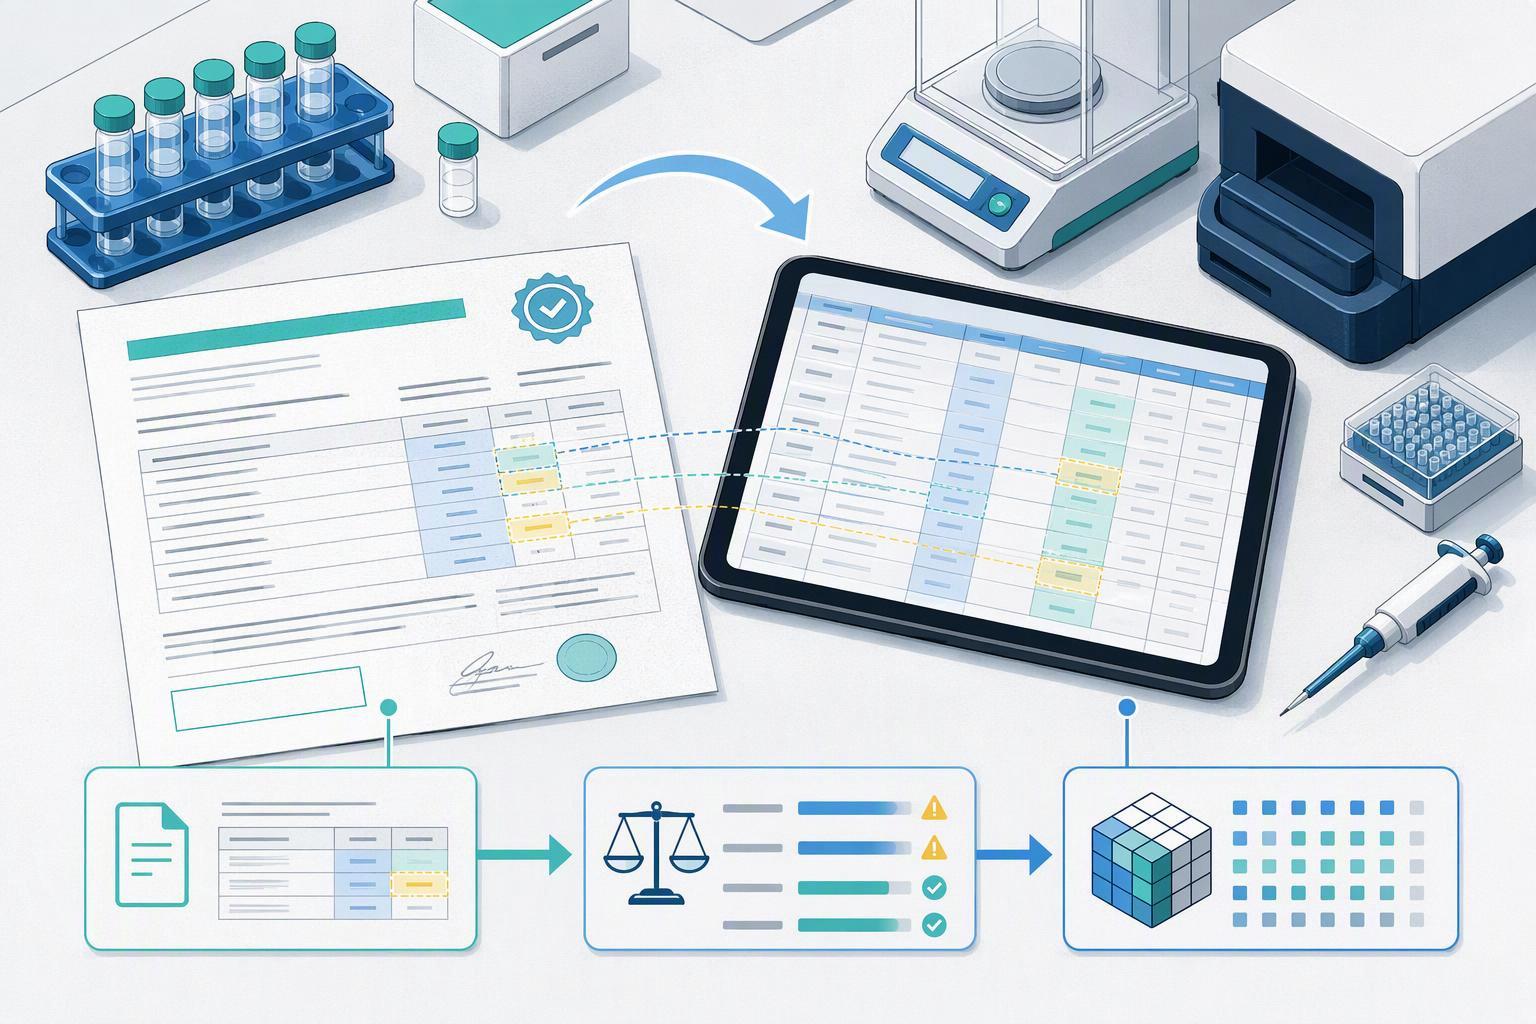
En 2026-09-16, El propio anuncio de GenScript sobre el acuerdo TuneLab confirmó que la compañía ahora ofrece condiciones de laboratorio húmedo con tarifa preferencial en el anuncio: expresión de proteínas, purificación y caracterización de secuencias priorizadas., realizado bajo estandarización, protocolos completamente documentados. Lea atentamente el alcance. Sin estándar de datos de péptidos, no se menciona ningún formato legible por máquina ni entregables específicos de péptidos en ninguna parte.
Esa brecha es la historia.. Ray Chen, Presidente del grupo de ciencias biológicas GenScript, enmarcó el fundamento en el fundamento declarado de GenScript para la asociación: "El descubrimiento de fármacos mediante IA avanzará tan rápido como la industria pueda generar evidencia biológica confiable".
TuneLab en sí no es nuevo. Anuncio de lanzamiento de Lilly para TuneLab lo fecha en 2025-09-09, operado por Eli Lilly en lugar de una empresa independiente, con una primera versión que cubre la eliminación de medicamentos, modelos preclínicos y de seguridad. La escala detrás de esto es la razón por la que los proveedores están prestando atención.: datos de propiedad obtenidos a un costo de más de $1 mil millones, extraído de cientos de miles de moléculas únicas, según la escala de los datos detrás de TuneLab. El acceso se realiza a través del diseño de aprendizaje federado de TuneLab., que permite a las biotecnologías aprovechar los modelos de Lilly sin exponer directamente sus propios datos de propiedad o los de Lilly..
La plataforma también se está integrando en el software que los equipos computacionales ya utilizan., a través de la integración de Schrödinger LiveDesign anunciado 2026-01-09 y se anuncia la integración TuneLab de CDD Vault 2026-05-20.
Así que trate esto como una señal sobre la generación de evidencia., no es una especificación. Nada en el anuncio le dice qué requiere de sus registros el descubrimiento de péptidos listos para IA.. Esa carga recae en el laboratorio..
Datos limpios: Los cuatro pilares del descubrimiento de péptidos preparados para la IA
El descubrimiento de péptidos preparado por IA significa que se puede leer el resultado experimental, fusionado y reutilizado por un modelo sin que un humano lo vuelva a escribir. Los datos legibles por máquina llevan sus unidades., identidad de muestra y versión del método en campos estructurados en lugar de un PDF o una página de cuaderno. El ciclo de diseño-construcción-prueba-aprendizaje es el ciclo en el que se ejecutan esos modelos.: secuencias de diseño, sintetizarlos y probarlos, retroalimentar los resultados, diseñar de nuevo.
Cuatro pilares sostienen ese bucle: datos experimentales más limpios, registros de síntesis reproducibles, formatos listos para ensayos y conjuntos de datos analíticos. El listón es más bajo de lo que la mayoría de los equipos suponen. Guía de recopilación de datos de Cradle para el diseño de proteínas pone el diseño de proteínas de aprendizaje automático generativo al alcance de cualquier laboratorio que pueda realizar pruebas consistentes 96 variantes de secuencia de proteínas para cada propiedad, y señala que unas pocas docenas de secuencias sabiamente elegidas pueden generar avances significativos. Guía de mejores prácticas publicada sobre ingeniería de proteínas asistida por ML informa que los conjuntos de datos de ML de ingeniería de proteínas a menudo contienen menos de 1,000 instancias, Es por eso que la validación comúnmente utiliza una validación cruzada de 10 veces en lugar de una única división retenida..
Los conjuntos de datos pequeños castigan los registros descuidados. El análisis de GEN sobre por qué los esfuerzos de descubrimiento de fármacos con IA tienen un rendimiento inferior afirma que los modelos alimentados son inconsistentes, incompleto, Los datos ambiguos o mal formateados aprenden el ruido junto con la señal., produciendo predicciones seguras pero menos confiables. El patrón de fracaso es mundano.: unidades registradas como mg/mL en una ejecución y µg/µL en la siguiente, nombres de muestra de texto libre que ninguna clave de unión puede igualar, identificadores de lote faltantes, y sin versiones del método de ensayo o del código de análisis. Cualquiera de estos impide que un conjunto de datos se fusione entre ejecuciones.
La causa aguas arriba es la fragmentación., no descuido. Descripción general de LabKey sobre la gestión práctica de datos de ensayos describe datos de ensayo que viven en silos, en unidades compartidas, en cuadernos de laboratorio, o incrustado en correos electrónicos, con heterogeneidad de instrumentos entre proveedores y tipos de archivos y sin formato consistente. Por lo tanto, la calidad de los datos de péptidos para los modelos de IA es un problema de registros antes de ser un problema de modelado..
Conclusión clave: Una campaña que prueba 96 variantes por propiedad ya está en territorio de diseño generativo. Lo que descalifica el conjunto de datos son las unidades inconsistentes, nombres de muestra de texto libre, ID de lote faltantes y métodos no versionados, no el recuento de la muestra.
Registros de síntesis reproducibles y formatos listos para ensayos
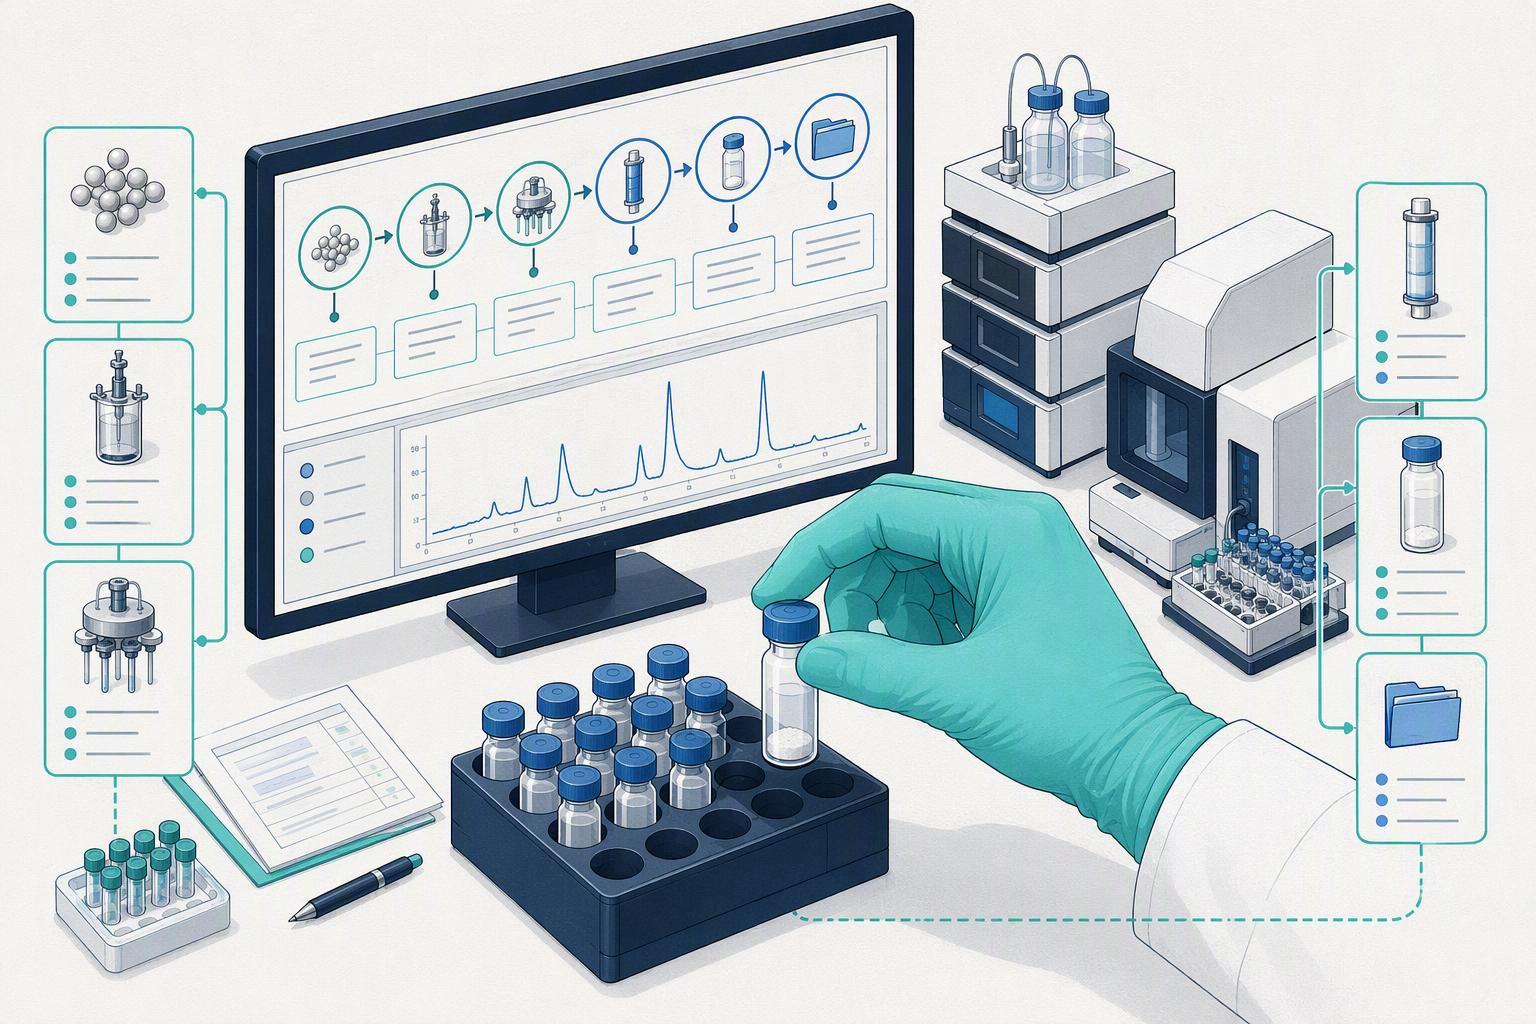
Un certificado de análisis no es un registro de síntesis de péptidos reproducible.. La unidad de reproducibilidad es el archivo de lote.: el Imprimación SPPS de la American Peptide Society describe un registro de lote lo suficientemente detallado como para que un tercero pueda recrear la ejecución, cubriendo el tipo de resina y la carga, desprotección por ciclo y acoplamiento con reactivos y equivalentes, pasos de lavado y equipo. El ciclo Fmoc manual estándar que documenta prescribe 20% desprotección piperidina/DMF (5 minutos, entonces 15 minutos) y 3 × 1 ml de lavados de DMF por ciclo. Marco de cadena de custodia paso a paso de MOL Changes extiende eso en nueve etapas, desde el abastecimiento de materia prima y la calificación entrante hasta los registros de lotes de síntesis, trazabilidad del etiquetado de isótopos, liberación analítica y ensamblaje completo del archivo de lotes, citar ICH Q7 para la caracterización del material de partida y señalar a un proveedor que no puede nombrar el lote de resina o la fuente de aminoácidos.
Los formatos de datos de péptidos listos para el ensayo conllevan un requisito paralelo. La descripción general de LabKey sobre la gestión práctica de datos de ensayos identifica lo que se repite en CSV, JSON, AnIML y SDRF: identificadores estables para muestras, archivos y ejecuciones; vocabularios controlados u ontologías; unidades y tipos de datos explícitos; vínculos entre datos sin procesar, datos procesados y metadatos; y abierto, formatos de larga duración. La confirmación de identidad mediante espectrometría de masas no es una determinación de pureza mediante HPLC, y tampoco resuelve cuestiones de contraión o de contenido, como el intercambio de contraión de TFA. Yo Q2(R2), publicado 30 Noviembre 2023, Requiere que un procedimiento analítico sea apto para el propósito previsto según un protocolo de validación predefinido., con el rango reportable confirmado para incluir las especificaciones o límites de reporte superior e inferior, y extiende esos principios a la espectrometría de masas y otros datos espectrométricos..
|
Qué contiene un paquete de proveedor estándar |
Lo que necesita un equipo computacional |
|---|---|
|
CoA más análisis resumidos |
Registros vinculados a lotes con identificadores estables |
|
Valores finales de pureza e identidad |
Detalle de síntesis por ciclo y control de versiones. |
|
péptido 1 PDF estático o informe impreso |
Síntesis de péptidos cíclicos Tablas legibles por máquina con unidades explícitas |
|
Certificado como entregable |
Procedencia de crudo Servicios de péptidos material para liberar |
Ningún estándar de documentación elimina la necesidad péptido 2 para confirmación ortogonal de aciertos.
Qué significa esto para los proveedores, Equipos computacionales y compradores
El anuncio llega de forma diferente dependiendo de dónde te sientes.. Para el proveedor de sintetizadores, La integridad de la documentación se convierte en un diferenciador en lugar de una idea de último momento.. Página de servicio AIDD de GenScript anuncia secuencia a datos tan rápido como 4 días calendario, 4000+ diseños por día, 20M+ puntos de datos listos para IA generados por año, bajo $10 por punto de datos, y 3500+ organizaciones asociadas globales. Léelo atentamente, aunque, y no nombra ningún péptido; sus modalidades listadas son VHH, miniproteínas, IgG, biespecíficos, enzimas y proteínas de novo. La química de péptidos aún no es el centro demostrado de ese proceso., cual es la apertura para proveedores que puedan mostrarlo. Síntesis de calcitonina
Para el equipo computacional, la restricción vinculante es el tamaño del conjunto de datos y la suficiencia de los metadatos. La guía de mejores prácticas publicada sobre ingeniería de proteínas asistida por ML trata la validación cruzada 10 veces como la norma en conjuntos de datos de menos de 1000 instancias., que indica qué tan delgado suele ser el material de entrenamiento. El diseño de aprendizaje federado de TuneLab es importante aquí: La biotecnología aprovecha los modelos de Lilly sin exponer directamente datos de propiedad exclusiva.. La implicación no obvia es que la integración de Schrödinger LiveDesign significa que la mayoría de los equipos cumplirán con estos modelos dentro del software que ya ejecutan.. Los modelos no son la variable que controlas. Los datos que les proporcionas son.
Para el comprador o líder de control de calidad, “documentado” ya tiene una definición. Los diez principios de integridad de datos de ALCOA+ exigen que los registros sean atribuibles, legible, contemporáneo, original, preciso, completo, coherente, duradero y disponible, y el ICH Q2(R2) La guía de validación analítica requiere que un procedimiento analítico sea apto para el propósito previsto bajo un protocolo de validación predefinido., con la revisión extendiendo esos principios a la espectrometría de masas. Una entrega de péptidos con documentación completa, en esos términos, significa un archivo de lote donde el identificador de la muestra se vincula con el lote, La versión del ensayo y las unidades viajan con el resultado., y los controles y métricas de error son declarados en lugar de implícitos.. MOL Changes es un proveedor cuyo paquete analítico se basa en esa cadena., aunque no se encontró ninguna auditoría independiente de sus formatos de datos específicos de IA.
Cuatro preguntas que debes hacer hoy sobre tus propios registros: ¿Puede un modelo leer esta tabla?? ¿Puede un tercero recrear este lote?? ¿La salida de este ensayo lleva identificadores y unidades?? ¿Se puede fusionar este conjunto de datos con los del último trimestre?? péptido 3
Qué hacer ahora y el panorama más amplio
Comience con la exportación, no la plataforma. Tres acciones, en orden de urgencia.
-
Esta semana: Audite la exportación de ensayos de una campaña reciente comparándola con su lista de campos legibles por máquina y anote lo que falta.. La mayoría de los equipos encuentran los huecos en una tarde.
-
este mes: agregar identificadores de lote, unidades, versión del ensayo y versión del código de análisis a la plantilla de exportación, y comenzar a versionar el método de ensayo en sí..
-
este trimestre: solicitar el archivo del lote completo, incluyendo lote de resina y fuente de aminoácidos, antes de comprometerse con una campaña. Un proveedor que no puede nombrar el lote de resina o la fuente de aminoácidos es una señal de alerta..
Dos cosas que no debes hacer. No reconstruya una plataforma de datos antes de corregir el formato de exportación, y no trate un CoA como un conjunto de datos listo para entrenar.
Vale la pena tener en cuenta el contexto de precaución. En una auditoría manual de reutilización FAIR de conjuntos de datos archivados, 45.9% de los conjuntos de datos abiertos evaluados fueron clasificados como reutilizables, significado 54.1% no fueron. En la auditoría del conjunto de datos del dominio energético, 82% de los conjuntos de datos tenían datos faltantes en al menos una dimensión clave y 27% faltaban más de la mitad. Las cifras de este tipo varían según la fuente y el dominio., y se citan aquí como una ilustración de las tasas de pérdida de metadatos., no como puntos de referencia de péptidos.
Ese es el panorama general para el descubrimiento de péptidos listos para la IA: generación de evidencia, no capacidad de modelo, se está convirtiendo en el paso limitante de la tasa. Los estándares de documentación se están convirtiendo en un criterio de contratación., y los laboratorios que versionen sus registros ahora serán aquellos cuyos datos aún sean utilizables dentro de tres años..
Siguiente paso: revise el marco de documentación de la cadena de custodia y utilice su lista de verificación de nueve etapas para calificar sus archivos de lote actuales.
Divulgación: MOL Changes publica este blog como proveedor de péptidos.
Preguntas frecuentes
¿La asociación GenScript-TuneLab cubre los péptidos??
No. El propio anuncio de GenScript sobre el acuerdo TuneLab abarca el servicio a la expresión de proteínas, purificación y caracterización de secuencias priorizadas.. La síntesis de péptidos no se menciona en ese ámbito., por lo tanto, los equipos de péptidos deberían leer el anuncio como una señal sobre hacia dónde se dirige el descubrimiento asistido por IA en lugar de como un servicio que pueden comprar hoy..
¿Qué significan realmente en la práctica los datos “preparados para la IA”??
Significa cinco propiedades concretas.: identificadores estables para cada entidad, vocabularios controlados en lugar de campos de texto libre, unidades y tipos de datos explícitos, vinculado crudo, archivos procesados y de metadatos, y abrir formatos de larga duración en lugar de exportaciones bloqueadas por proveedores. La descripción general de LabKey sobre la gestión práctica de datos de ensayos establece estos requisitos para los datos de ensayos. Un archivo que los satisfaga puede ser analizado por un modelo sin que un ser humano reescriba primero los encabezados de las columnas.. esa es toda la prueba.
¿Qué tamaño debe tener un conjunto de datos analíticos de péptidos antes de que el aprendizaje automático ayude??
Más pequeño de lo que la mayoría de los equipos suponen, pero no trivialmente pequeño. La guía de recopilación de datos de Cradle para el diseño de proteínas pone el diseño generativo en práctica en todas partes 96 variantes por propiedad. Conjuntos de datos típicos de ingeniería de proteínas, por el contrario, contener menos de 1,000 instancias y se validan con validación cruzada 10 veces, como se describe en la guía de mejores prácticas publicada sobre ingeniería de proteínas asistida por ML. La restricción vinculante suele ser la coherencia entre esas instancias., no su cuenta.
¿Qué debo pedirle a un proveedor??
Solicite el archivo del lote completo, no solo el CoA. El marco de cadena de custodia paso a paso de MOL Changes trata a un proveedor que no puede nombrar el lote de resina o la fuente de aminoácidos como una señal de alerta., y solicita datos analíticos legibles por máquina junto con el certificado. Si los formatos de datos de péptidos listos para el ensayo que recibe no se pueden cargar sin una transcripción manual, El proceso de descubrimiento de péptidos listo para la IA se detiene en su bandeja de entrada.
Conclusión
La asociación GenScript-TuneLab es una señal sobre cómo se genera la evidencia de péptidos, no es un estándar de datos de péptidos. No se publicaron datos de pruebas independientes después 2024 Se encontró que permitiría a cualquiera tratar el anuncio como una especificación establecida., para que el trabajo práctico permanezca donde siempre estuvo: en el registro que su laboratorio ya produce.
Ese registro tiene cuatro requisitos que puedes cumplir ahora. Datos limpios significa campos que un modelo puede analizar sin reparación manual. Los registros de síntesis de péptidos reproducibles significan trazabilidad a nivel de lote hasta fuentes de resina y aminoácidos.. Los formatos de datos de péptidos listos para el ensayo significan resultados que sobreviven a la transferencia entre instrumentos y colaboradores.. Los conjuntos de datos analíticos de péptidos para el diseño computacional significan que las mediciones subyacentes permanecen adjuntas a las secuencias que describen.
El siguiente paso lógico es pequeño y poco glamoroso.: tomar una campaña completa, exportarlo tal como está hoy, y compruébelo campo por campo con una especificación legible por máquina. Lo que sea que falle en esa auditoría es su hoja de ruta de descubrimiento de péptidos listos para IA, y será más específico que cualquier anuncio..