发生了什么以及为什么它对 AI 就绪肽发现很重要
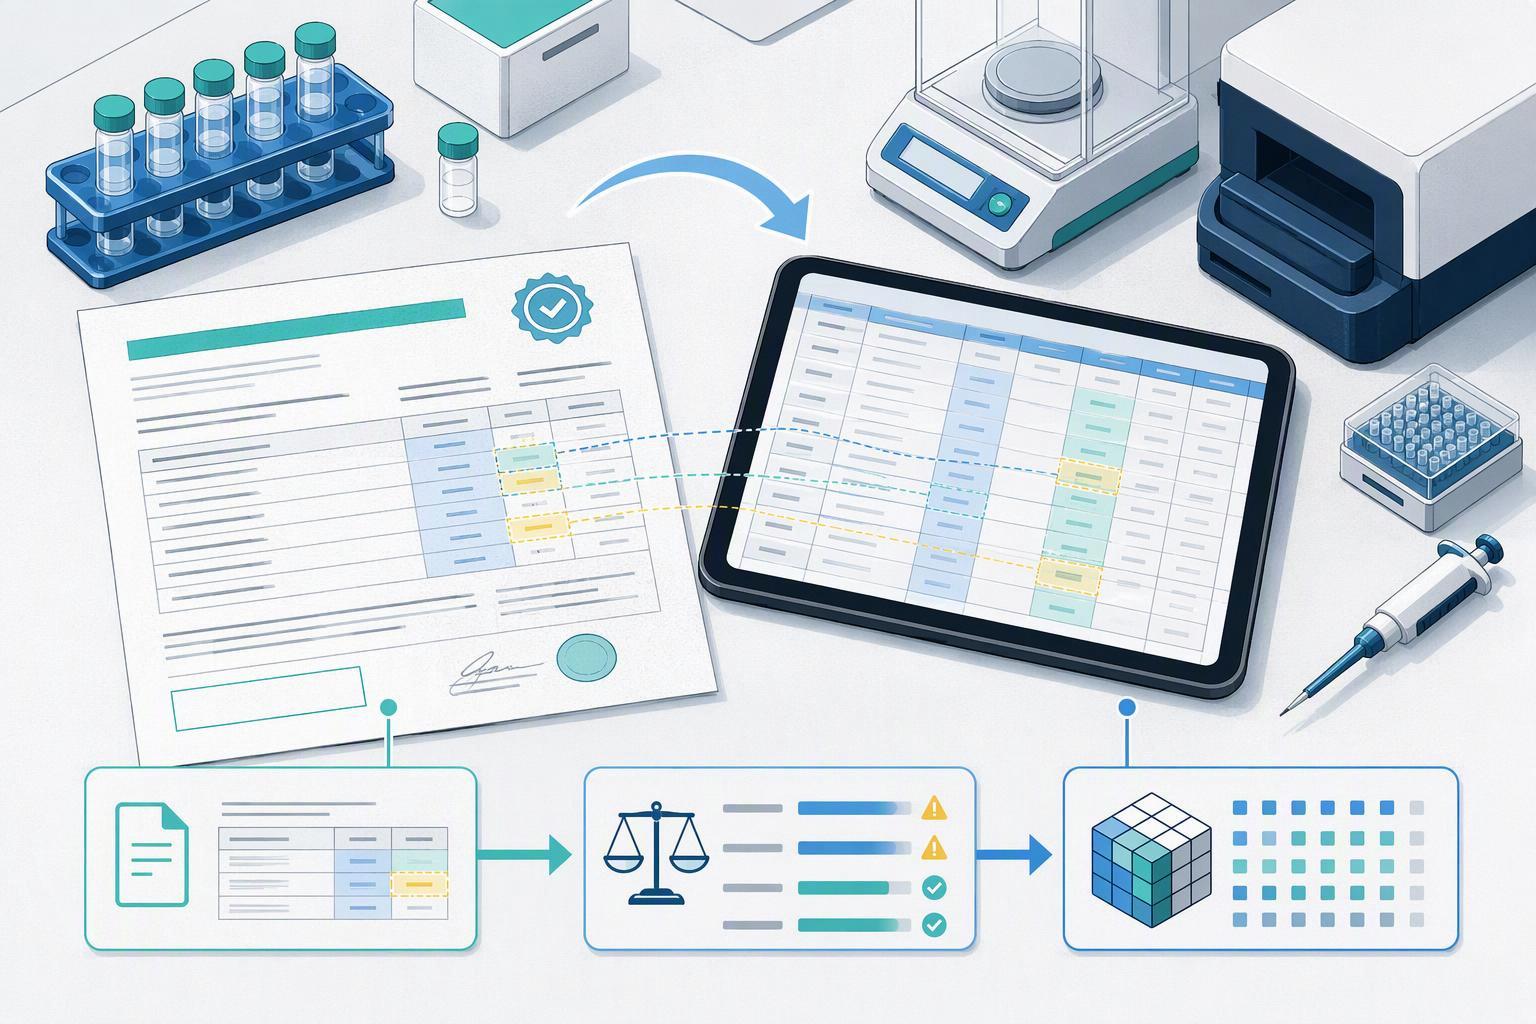
在 2026-09-16, 金斯瑞自行宣布 TuneLab 协议 确认该公司现在在公告中提供优惠湿实验室条款: 蛋白质表达, 优先序列的纯化和表征, 在标准化下进行, 完整记录的协议. 仔细阅读范围. 无肽数据标准, 没有机器可读的格式,也没有在其中的任何地方指定肽特定的可交付成果.
那个差距就是故事. 陈雷, 金斯瑞生命科学集团总裁, 在金斯瑞声明的合作理由中阐述了理由: “人工智能药物发现的进展速度取决于行业能否产生可靠的生物学证据。”
TuneLab 本身并不新鲜. 礼来 (Lilly) 发布 TuneLab 的发布公告 日期为 2025-09-09, 由礼来公司而非独立公司运营, 首次发布涵盖药物处置, 安全性和临床前模型. 其背后的规模是供应商关注的原因: 以超过成本获得的专有数据 $1 十亿, 从数十万个独特的分子中提取, 根据 TuneLab 背后的数据规模. 访问贯穿 TuneLab 的联合学习设计, 这使得生物技术公司可以利用礼来公司的模型,而无需直接暴露自己的专有数据或礼来公司的数据.
该平台也被嵌入到计算团队已经使用的软件中, 通过 薛定谔 LiveDesign 集成 宣布 2026-01-09 宣布与 CDD Vault 的 TuneLab 集成 2026-05-20.
因此,将此视为有关证据生成的信号, 不是规格. 公告中没有任何内容告诉您人工智能就绪的肽发现对您的记录有何要求. 这个负担落在了实验室身上.
清洁数据: AI 就绪肽发现的四大支柱
人工智能就绪的肽发现意味着您的实验输出可以被读取, 由模型合并和重用,无需人工重新输入. 机器可读数据带有其单位, 结构化字段中的示例标识和方法版本,而不是 PDF 或笔记本页面. 设计-构建-测试-学习循环是模型运行的循环: 设计序列, 综合并测试它们, 反馈结果, 再次设计.
四根柱子支撑着这个环: 更干净的实验数据, 可重复的合成记录, 分析就绪格式和分析数据集. 这个标准比大多数团队想象的要低. Cradle 的蛋白质设计数据收集指南 让任何能够持续测试的实验室都可以进行生成机器学习蛋白质设计 96 每个属性的蛋白质序列变体, 并指出,几十个明智选择的序列可以产生重大进展. 发布了机器学习辅助蛋白质工程的最佳实践指南 报告称蛋白质工程 ML 数据集通常少于 1,000 实例, 这就是为什么验证通常使用 10 倍交叉验证而不是单个保留分割的原因.
小数据集惩罚马虎记录. GEN 对人工智能药物发现工作表现不佳的原因的分析 指出模型的喂养不一致, 不完整的, 不明确或格式不良的数据会随着信号一起学习噪声, 产生自信但不太可靠的预测. 失败模式很平常: 一次运行中的单位记录为 mg/mL,下一次运行中的单位记录为 µg/µL, 没有连接键可以匹配的自由文本示例名称, 缺少批次标识符, 并且没有测定方法或分析代码的版本控制. 其中任何一项都会阻止数据集跨运行合并.
上游原因是碎片, 不粗心. LabKey 实用检测数据管理概述 描述了存在于孤岛中的分析数据, 在共享云端硬盘上, 在实验室笔记本中, 或嵌入电子邮件中, 不同供应商和文件类型的仪器存在异质性,并且没有一致的格式. 因此,人工智能模型的肽数据质量首先是记录问题,然后才是建模问题.
要点: 围绕测试的活动 96 每个属性的变体已经属于生成设计领域. 数据集不合格的原因是单位不一致, 自由文本样本名称, 缺少批次 ID 和未版本控制的方法, 不是样本数.
可重复的合成记录和分析就绪格式
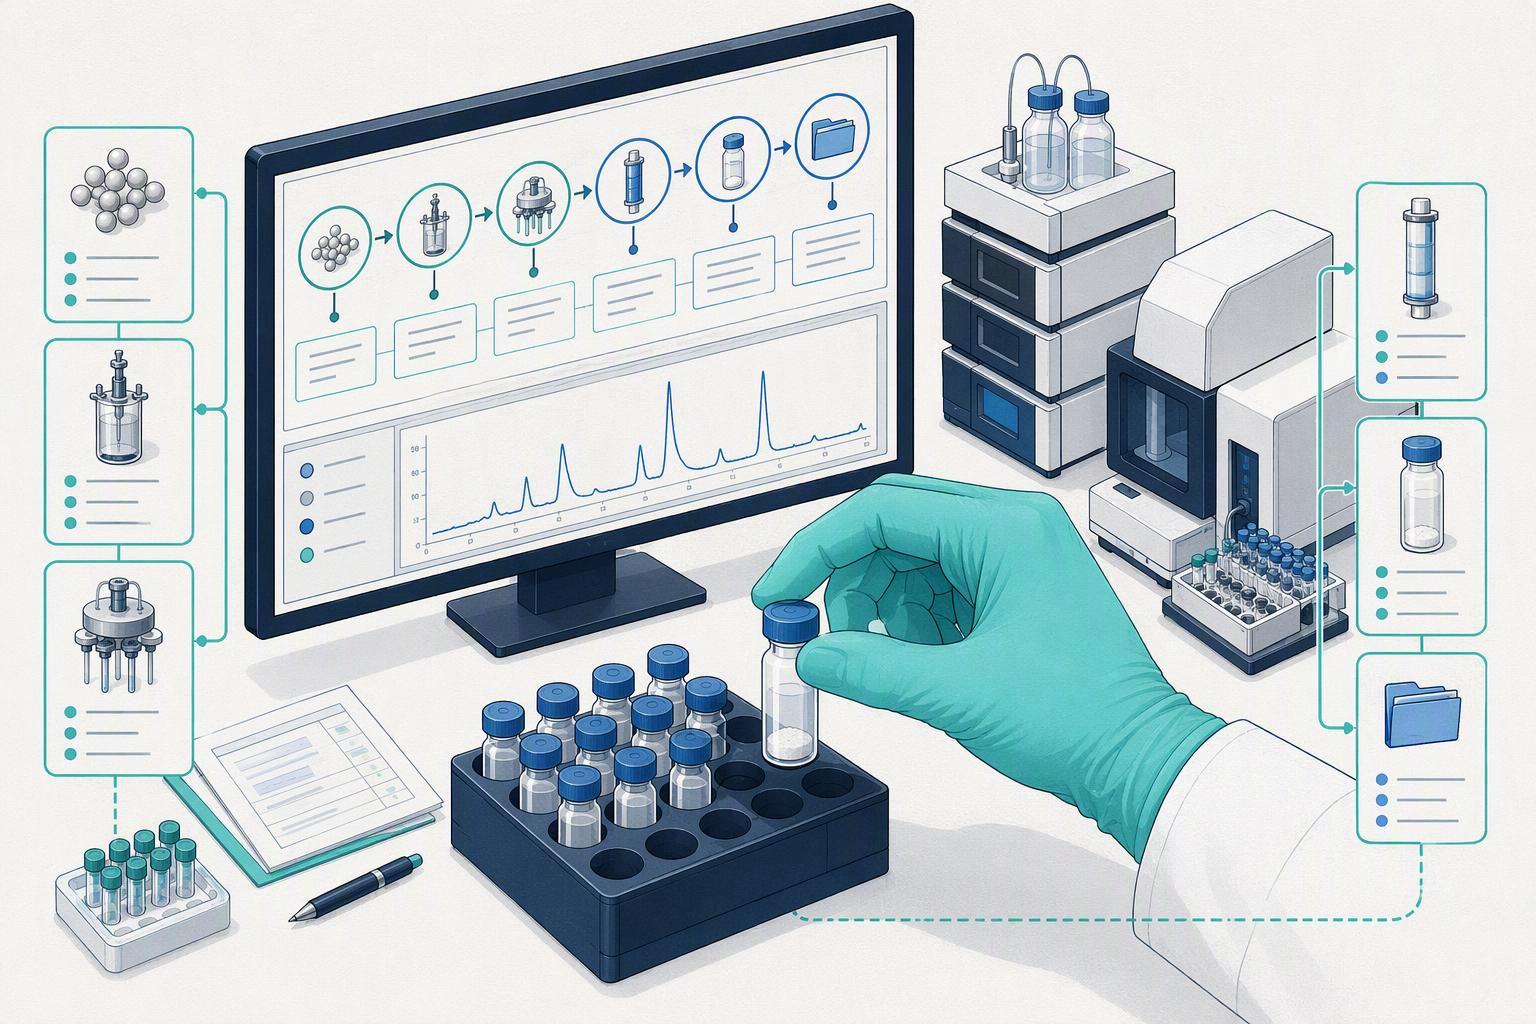
分析证书不是可重复的肽合成记录. 重现性的单位是批次文件: 这 美国肽协会的 SPPS 引物 描述了足够详细的批次记录,可供第三方重新创建运行, 涵盖树脂类型和装载量, 每循环脱保护并与试剂和等效物偶联, 清洗步骤及设备. 它记录的标准手册 Fmoc 循环规定 20% 哌啶/DMF脱保护 (5 分钟, 然后 15 分钟) 和 3 × 1 每个周期洗涤 mL DMF. MOL 逐步改变监管链框架 将其扩展为九个阶段, 从原材料采购和进料鉴定到合成批次记录, 同位素标记可追溯性, 分析发布和完整的批次文件组装, 引用 ICH Q7 进行原材料表征,并标记无法命名树脂批次或氨基酸来源的供应商.
检测就绪的肽数据格式具有并行要求. LabKey 对实际检测数据管理的概述确定了 CSV 中重复出现的内容, JSON, AnIML 和 SDRF: 样品的稳定标识符, 文件和运行; 受控词汇或本体; 显式单位和数据类型; 原始数据之间的联系, 处理后的数据和元数据; 并打开, 长期存在的格式. 通过质谱进行身份确认不是通过 HPLC 确定纯度, 也不能解决反离子或含量问题,例如 TFA 反离子交换. 我Q2(R2), 发表 30 十一月 2023, 需要在预定义的验证协议下证明分析程序适合其预期目的, with the reportable range confirmed to include upper and lower specification or reporting limits, and extends those principles to mass spectrometry and other spectrometric data.
|
What a standard supplier package contains |
What a computational team needs |
|---|---|
|
CoA plus summary analytics |
Lot-linked records with stable identifiers |
|
Final purity and identity values |
Per-cycle synthesis detail and versioning |
|
肽 1 Static PDF or printed report |
Cyclic Peptide Synthesis Machine-readable tables with explicit units |
|
Certificate as the deliverable |
Provenance from raw Peptide Services material to release |
No documentation standard removes the need 肽 2 for orthogonal confirmation of hits.
这对供应商意味着什么, 计算团队和买家
The announcement lands differently depending on where you sit. For the synthesizing supplier, documentation completeness becomes a differentiator rather than an afterthought. 金斯瑞AIDD服务页面 广告序列到数据的速度最快 4 日历日, 4000+ 每天的设计, 20每年生成 M+ AI 就绪数据点, 在下面 $10 每个数据点, 和 3500+ 全球合作伙伴组织. 仔细阅读, 尽管, 它根本没有命名任何肽; 其列出的方式是 VHH, 微蛋白, 免疫球蛋白G, 双特异性, 酶和从头蛋白质. 肽化学尚未成为该管道的示范中心, 这是为能够展示它的供应商提供的机会. 降钙素合成
对于计算团队, 绑定约束是数据集大小和元数据充足性. 已发布的关于机器学习辅助蛋白质工程的最佳实践指南将 10 倍交叉验证视为 1,000 个实例以下数据集的标准, 它告诉您培训材料通常有多薄. TuneLab 的联合学习设计在这里很重要: biotechs tap into Lilly’s models without directly exposing proprietary data. The non-obvious implication is that the Schrödinger LiveDesign integration means most teams will meet these models inside software they already run. The models are not the variable you control. The data you feed them is.
For the buyer or QC lead, “documented” already has a definition. The ten ALCOA+ data-integrity principles require records to be attributable, 清晰易读, 同时期的, 原来的, 准确的, 完全的, 持续的, 持久且可用, and the ICH Q2(R2) analytical validation guideline requires an analytical procedure to be shown fit for its intended purpose under a predefined validation protocol, with the revision extending those principles to mass spectrometry. A documentation-complete peptide delivery, in those terms, means a lot file where the sample identifier ties back to the batch, 化验版本和单位随结果一起传送, 并且控制和误差指标是明示的而不是暗示的. MOL Changes 是一家围绕该供应链构建分析包的供应商, 尽管没有发现对其人工智能特定数据格式的独立审计.
今天要问您自己的记录的四个问题: 模型能读懂这个表吗? 第三方可以重新创建该批次吗? 该检测输出是否带有标识符和单位? 该数据集可以与上季度的数据集合并吗? 肽 3
现在该做什么以及更大的前景
从导出开始, 不是平台. 三个动作, 按紧急程度排序.
-
本星期: 根据机器可读的字段列表审核最近一项活动的检测导出,并记下缺少的内容. 大多数球队在一个下午就找到了差距.
-
本月: 添加批次标识符, 单位, 导出模板的测定版本和分析代码版本, 并开始对测定方法本身进行版本控制.
-
本季度: 索取完整批次文件, 包括树脂批次和氨基酸源, 在致力于一项活动之前. 无法说出树脂批次或氨基酸来源名称的供应商是一个危险信号.
两件事不要做. 在修复导出格式之前不要重建数据平台, 并且不要将 CoA 视为训练就绪数据集.
值得警惕的背景. 在归档数据集的手动 FAIR 可重用性审核中, 45.9% 的评估开放数据集被评为可重用, 意义 54.1% 不是. 在能源领域数据集审计中, 82% 的数据集至少在一个关键维度上缺少数据,并且 27% 一半以上失踪了. 此类数字因来源和领域而异, 此处引用它们作为元数据丢失率的说明, 不作为肽基准.
这是人工智能肽发现的更大前景: 证据生成, 不是模型能力, 正在成为限速步骤. 文件标准正在转变为采购标准, 现在对记录进行版本控制的实验室的数据在三年内仍然可用.
下一步: 查看监管链文档框架并使用其九阶段清单对当前批次文件进行评分.
披露: MOL Changes 作为肽供应商发布此博客.
常见问题解答
GenScript-TuneLab 合作伙伴关系是否涵盖肽?
不. GenScript 自己宣布的 TuneLab 协议将服务范围扩大到蛋白质表达, 优先序列的纯化和表征. 肽合成未在此范围内命名, 因此,肽团队应该将这一公告视为人工智能辅助发现的发展方向的信号,而不是他们今天可以购买的服务.
“AI 就绪”数据在实践中实际上意味着什么?
这意味着五个具体属性: 每个实体的稳定标识符, 受控词汇表而不是自由文本字段, 显式单位和数据类型, 链接原始, 处理后的文件和元数据文件, 并开放长期格式而不是供应商锁定的导出. LabKey 对实际检测数据管理的概述列出了检测数据的这些要求. 满足这些条件的文件可以由模型进行解析,而无需人工重写列标题. 这就是整个测试.
机器学习提供帮助之前,肽分析数据集需要有多大?
比大多数团队想象的要小, 但并不小. Cradle 的蛋白质设计数据收集指南使生成设计变得实用 96 每个属性的变体. 典型的蛋白质工程数据集, 相比之下, 持有少于 1,000 实例并通过 10 倍交叉验证进行验证, 正如已发布的机器学习辅助蛋白质工程最佳实践指南所述. 绑定约束通常是这些实例之间的一致性, 不是他们的计数.
我应该向供应商询问什么?
索取完整批次文件, 不仅仅是 CoA. MOL Changes 的分阶段监管链框架将无法说出树脂批次或氨基酸来源名称的供应商视为危险信号, 并要求提供机器可读的分析数据以及证书. 如果您收到的可用于检测的肽数据格式无法在没有手动转录的情况下加载, 人工智能就绪的肽发现管道就停在您的收件箱中.
结论
GenScript-TuneLab 合作伙伴关系是一个关于如何生成肽证据的信号, 不是肽数据标准. 之后没有发布独立测试数据 2024 被发现可以让任何人将公告视为已确定的规范, 所以实际工作保持在原来的位置: 在您的实验室已经产生的记录中.
该记录有四个要求,您现在可以采取行动. 干净的数据意味着模型无需手动修复即可解析的字段. 可重复的肽合成记录意味着批次级可追溯至树脂和氨基酸来源. 检测就绪的肽数据格式意味着结果可以在仪器和合作者之间传输. 用于计算设计的肽分析数据集意味着基础测量与它们描述的序列保持关联.
下一个合乎逻辑的步骤是小而乏味的: 进行一项已完成的活动, 按现在的样子导出, 并根据机器可读的规范逐字段检查. 无论审核失败是什么,都是您的 AI 就绪肽发现路线图, 它将比任何公告都更加具体.