Điều gì đã xảy ra và tại sao nó lại quan trọng đối với việc khám phá peptide sẵn sàng cho AI
TRÊN 2026-09-16, Thông báo riêng của GenScript về thỏa thuận TuneLab xác nhận công ty hiện cung cấp các điều khoản phòng thí nghiệm ướt có tỷ lệ ưu tiên trong thông báo: biểu hiện protein, thanh lọc và mô tả đặc tính của các trình tự ưu tiên, được thực hiện theo tiêu chuẩn, các giao thức được ghi chép đầy đủ. Đọc kỹ phạm vi. Không có tiêu chuẩn dữ liệu peptide, không có định dạng có thể đọc được bằng máy và không có sản phẩm phân phối dành riêng cho peptide nào được đặt tên ở bất kỳ đâu trong đó.
Khoảng cách đó chính là câu chuyện. Ray Chen, Chủ tịch Nhóm Khoa học Đời sống GenScript, đóng khung cơ sở lý luận trong cơ sở lý luận đã nêu của GenScript cho mối quan hệ đối tác: “Việc khám phá thuốc hỗ trợ AI sẽ chỉ tiến triển nhanh khi ngành công nghiệp có thể tạo ra bằng chứng sinh học đáng tin cậy.”
Bản thân TuneLab không phải là mới. Thông báo ra mắt TuneLab của Lilly hẹn hò với nó 2025-09-09, được điều hành bởi Eli Lilly chứ không phải là một công ty độc lập, với bản phát hành đầu tiên bao gồm việc xử lý thuốc, mô hình an toàn và tiền lâm sàng. Quy mô đằng sau nó là lý do khiến các nhà cung cấp chú ý: dữ liệu độc quyền thu được với chi phí hơn $1 tỷ, được rút ra từ hàng trăm ngàn phân tử độc đáo, theo quy mô của dữ liệu đằng sau TuneLab. Quyền truy cập chạy qua thiết kế học tập liên kết của TuneLab, cho phép các công nghệ sinh học khai thác các mô hình của Lilly mà không làm lộ trực tiếp dữ liệu độc quyền của họ hoặc dữ liệu của Lilly.
Nền tảng này cũng đang được nhúng vào các nhóm tính toán phần mềm đã sử dụng, bởi vì sự tích hợp Schrödinger LiveDesign công bố 2026-01-09 và công bố tích hợp TuneLab của CDD Vault 2026-05-20.
Vì vậy hãy coi đây như một tín hiệu về việc tạo ra bằng chứng, không phải là một đặc điểm kỹ thuật. Không có gì trong thông báo cho bạn biết việc khám phá peptide sẵn sàng cho AI yêu cầu hồ sơ của bạn là gì. Gánh nặng đó đổ lên vai phòng thí nghiệm.
Làm sạch dữ liệu: Bốn trụ cột của việc khám phá peptide sẵn sàng cho AI
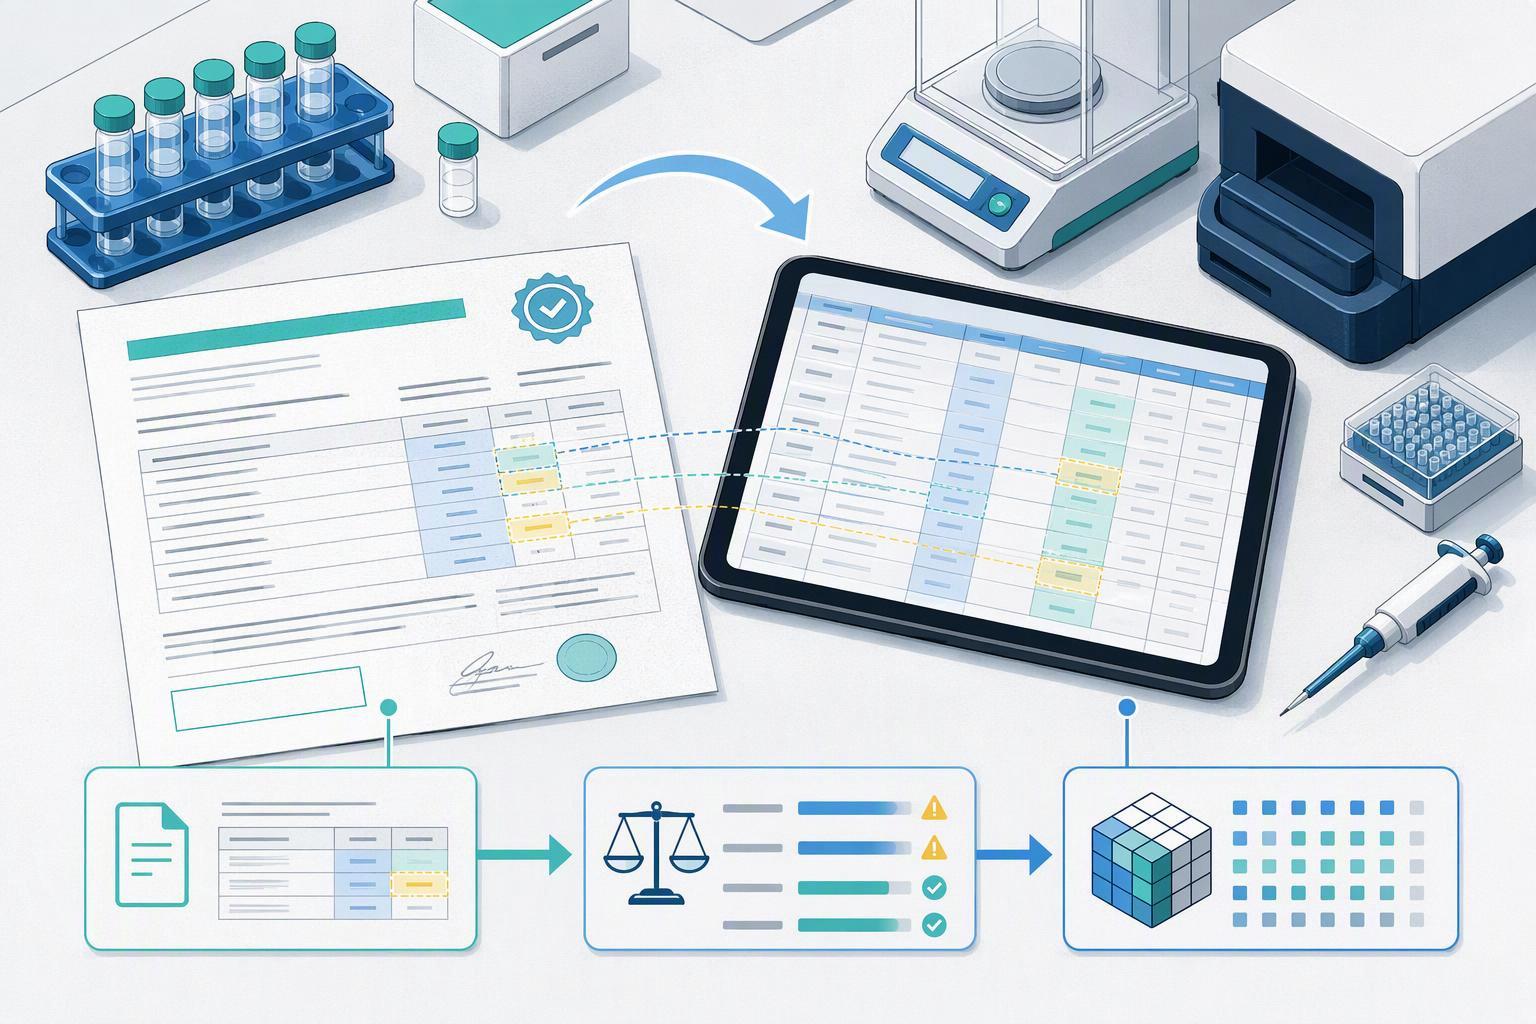
Khám phá peptide sẵn sàng cho AI có nghĩa là kết quả thử nghiệm của bạn có thể được đọc, được hợp nhất và sử dụng lại bởi một mô hình mà không cần con người gõ lại. Dữ liệu máy đọc được mang đơn vị của nó, phiên bản phương thức và nhận dạng mẫu trong các trường có cấu trúc thay vì trang PDF hoặc sổ ghi chép. Chu trình thiết kế-xây dựng-kiểm tra-học hỏi là vòng lặp mà các mô hình chạy trên đó: trình tự thiết kế, tổng hợp và kiểm tra chúng, phản hồi lại kết quả, thiết kế lại.
Bốn cây cột giữ vòng lặp đó lên: dữ liệu thử nghiệm sạch hơn, hồ sơ tổng hợp tái sản xuất, các định dạng sẵn sàng cho xét nghiệm và bộ dữ liệu phân tích. Tiêu chuẩn thấp hơn hầu hết các đội nghĩ. Hướng dẫn thu thập dữ liệu của Cradle để thiết kế protein đặt thiết kế protein ML tổng quát trong tầm tay của bất kỳ phòng thí nghiệm nào có thể kiểm tra nhất quán xung quanh 96 các biến thể trình tự protein cho từng đặc tính, và lưu ý rằng vài chục trình tự được lựa chọn khôn ngoan có thể mang lại tiến bộ đáng kể. Đã xuất bản hướng dẫn thực hành tốt nhất về kỹ thuật protein được hỗ trợ ML báo cáo rằng các bộ dữ liệu ML kỹ thuật protein thường chứa ít hơn 1,000 trường hợp, đó là lý do tại sao quá trình xác thực thường sử dụng xác thực chéo 10 lần thay vì phân tách một lần duy nhất.
Bộ dữ liệu nhỏ trừng phạt hồ sơ cẩu thả. Phân tích của GEN về lý do tại sao các nỗ lực khám phá thuốc AI lại kém hiệu quả tuyên bố rằng các mô hình được cung cấp không nhất quán, không đầy đủ, dữ liệu không rõ ràng hoặc được định dạng kém tìm hiểu nhiễu cùng với tín hiệu, mang lại những dự đoán tự tin nhưng kém tin cậy hơn. Mô hình thất bại là trần tục: đơn vị được ghi là mg/mL trong một lần chạy và µg/µL trong lần tiếp theo, tên mẫu văn bản tự do mà không có khóa tham gia nào có thể khớp, số nhận dạng lô bị thiếu, và không có phiên bản của phương pháp xét nghiệm hoặc mã phân tích. Bất kỳ một trong những điều này đều ngăn tập dữ liệu hợp nhất trong các lần chạy.
Nguyên nhân ngược dòng là sự phân mảnh, không bất cẩn. Tổng quan về quản lý dữ liệu xét nghiệm thực tế của LabKey mô tả dữ liệu xét nghiệm tồn tại trong silo, trên bộ nhớ dùng chung, trong sổ tay phòng thí nghiệm, hoặc được nhúng vào email, với sự không đồng nhất về công cụ giữa các nhà cung cấp và loại tệp và không có định dạng nhất quán. Do đó, chất lượng dữ liệu peptide cho các mô hình AI là một vấn đề về hồ sơ trước khi nó trở thành một vấn đề về mô hình hóa.
Chìa khóa mang đi: Một chiến dịch thử nghiệm xung quanh 96 các biến thể cho mỗi thuộc tính đã có trong lãnh thổ thiết kế tổng quát. Điều khiến tập dữ liệu không đủ tiêu chuẩn là các đơn vị không nhất quán, tên mẫu văn bản tự do, thiếu ID lô và phương pháp không phiên bản, không phải số lượng mẫu.
Bản ghi tổng hợp có thể tái tạo và các định dạng sẵn sàng cho xét nghiệm
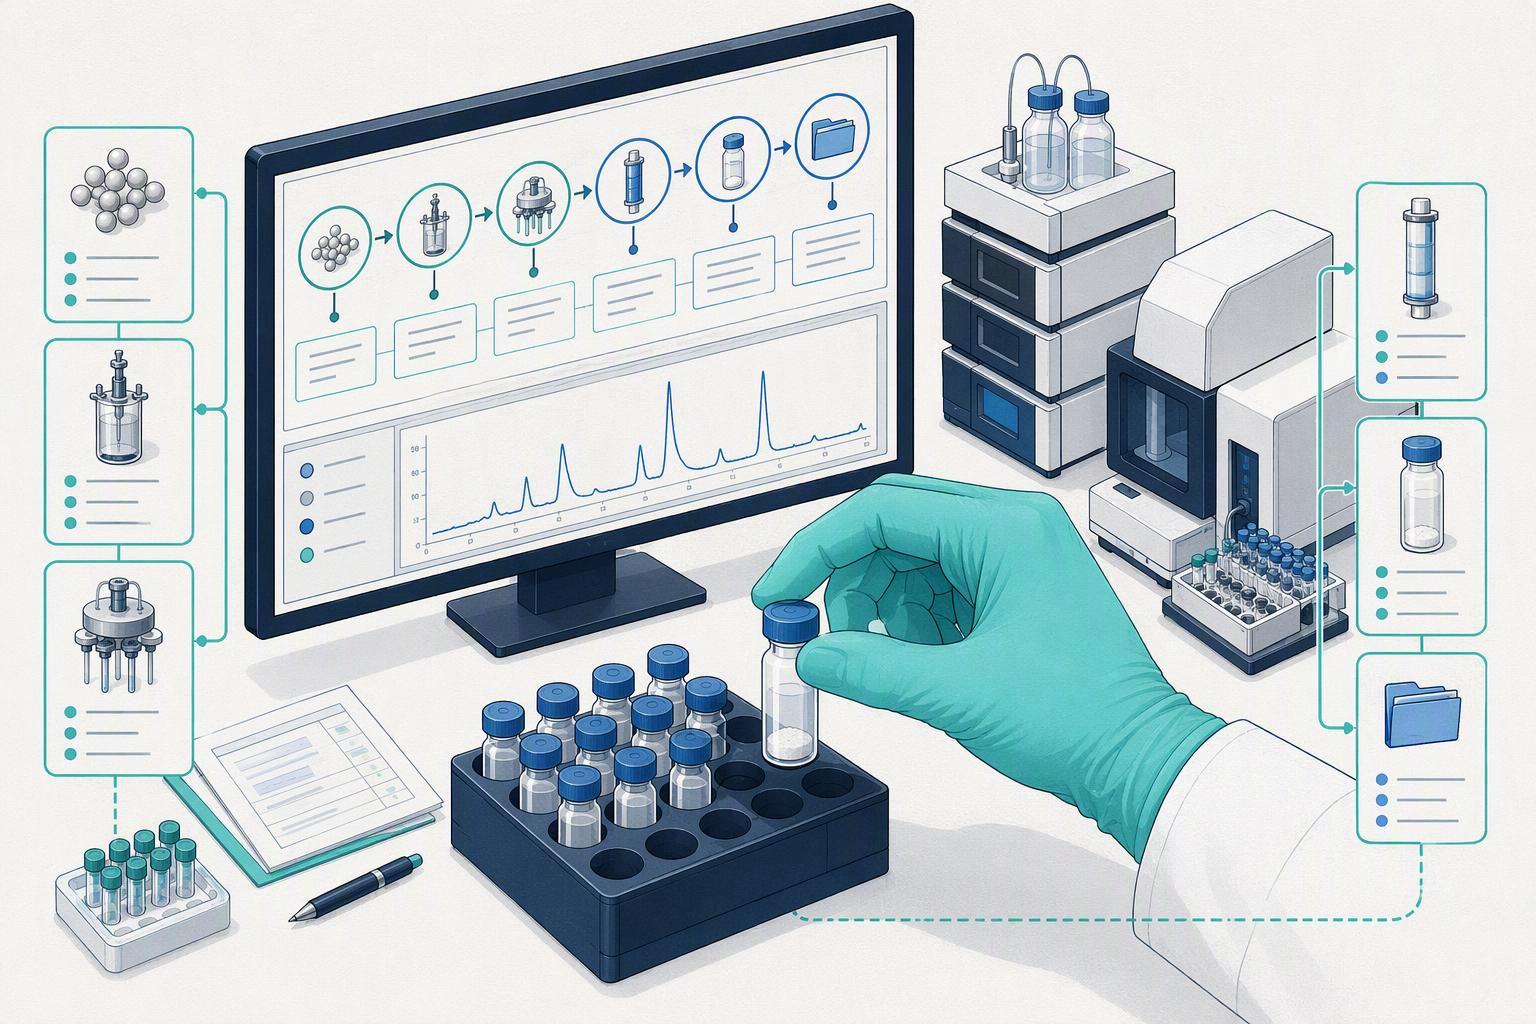
Giấy chứng nhận phân tích không phải là bản ghi tổng hợp peptide có thể tái tạo. Đơn vị của độ tái lập là tệp lô: cái Sơn lót SPPS của Hiệp hội Peptide Hoa Kỳ mô tả một bản ghi lô đủ chi tiết để bên thứ ba tạo lại lần chạy, bao gồm loại nhựa và tải, hủy bảo vệ mỗi chu kỳ và ghép nối với thuốc thử và chất tương đương, bước rửa và thiết bị. Chu trình Fmoc thủ công tiêu chuẩn mà nó quy định 20% mất bảo vệ piperidine/DMF (5 phút, sau đó 15 phút) Và 3 × 1 mL DMF rửa mỗi chu kỳ. Khung quản lý chuỗi hành trình theo từng giai đoạn của MOL Changes mở rộng điều đó thành chín giai đoạn, từ tìm nguồn cung ứng nguyên liệu thô và đánh giá chất lượng đầu vào thông qua hồ sơ lô tổng hợp, truy xuất nguồn gốc ghi nhãn đồng vị, xuất bản phân tích và tập hợp hồ sơ lô hoàn chỉnh, trích dẫn ICH Q7 để mô tả đặc tính nguyên liệu ban đầu và gắn cờ nhà cung cấp không thể nêu tên lô nhựa hoặc nguồn axit amin.
Các định dạng dữ liệu peptide sẵn sàng cho xét nghiệm có yêu cầu song song. Tổng quan của LabKey về quản lý dữ liệu xét nghiệm thực tế xác định những gì tái diễn trên CSV, JSON, AnIML và SDRF: định danh ổn định cho mẫu, tập tin và chạy; từ vựng hoặc ontology được kiểm soát; đơn vị và kiểu dữ liệu rõ ràng; liên kết giữa dữ liệu thô, dữ liệu đã xử lý và siêu dữ liệu; và mở, định dạng tồn tại lâu dài. Xác nhận danh tính bằng phép đo phổ khối không phải là xác định độ tinh khiết bằng HPLC, và không giải quyết các câu hỏi phản đối hoặc nội dung như trao đổi phản đối TFA. Tôi quý 2(R2), được xuất bản 30 Tháng mười một 2023, yêu cầu một quy trình phân tích phải được chứng minh là phù hợp với mục đích dự định của nó theo một quy trình xác nhận được xác định trước, với phạm vi báo cáo được xác nhận bao gồm thông số kỹ thuật trên và dưới hoặc giới hạn báo cáo, và mở rộng những nguyên tắc đó sang phép đo khối phổ và các dữ liệu đo phổ khác.
|
Gói nhà cung cấp tiêu chuẩn chứa những gì |
Những gì một nhóm tính toán cần |
|---|---|
|
CoA cộng với phân tích tóm tắt |
Các bản ghi liên kết lô với số nhận dạng ổn định |
|
Giá trị nhận dạng và độ tinh khiết cuối cùng |
Chi tiết tổng hợp mỗi chu kỳ và phiên bản |
|
peptit 1 Báo cáo PDF tĩnh hoặc in |
Tổng hợp peptide tuần hoàn Các bảng có thể đọc được bằng máy với các đơn vị rõ ràng |
|
Giấy chứng nhận là sản phẩm có thể giao được |
Xuất xứ từ nguyên liệu Dịch vụ peptide vật liệu để phát hành |
Không có tiêu chuẩn tài liệu nào loại bỏ được nhu cầu peptit 2 để xác nhận trực giao các lượt truy cập.
Điều này có ý nghĩa gì đối với các nhà cung cấp, Nhóm tính toán và người mua
Thông báo sẽ xuất hiện khác nhau tùy thuộc vào vị trí bạn ngồi. Đối với nhà cung cấp tổng hợp, tính đầy đủ của tài liệu trở thành một yếu tố khác biệt hơn là một suy nghĩ lại. Trang dịch vụ AIDD của GenScript quảng cáo chuỗi dữ liệu nhanh như 4 ngày dương lịch, 4000+ thiết kế mỗi ngày, 20Điểm dữ liệu sẵn sàng cho M+ AI được tạo mỗi năm, dưới $10 mỗi điểm dữ liệu, Và 3500+ tổ chức đối tác toàn cầu. Đọc kỹ nhé, mặc dù, và nó không hề đặt tên cho peptide nào cả; các phương thức được liệt kê của nó là VHH, protein nhỏ, IgG, đặc hiệu kép, enzyme và protein de novo. Hóa học peptide vẫn chưa phải là trung tâm được chứng minh của đường ống đó, đó là cơ hội cho các nhà cung cấp có thể thể hiện điều đó. Tổng hợp canxitonin
Đối với nhóm tính toán, ràng buộc ràng buộc là kích thước tập dữ liệu và tính đầy đủ của siêu dữ liệu. Hướng dẫn thực hành tốt nhất đã xuất bản về kỹ thuật protein được ML hỗ trợ coi việc xác thực chéo 10 lần là tiêu chuẩn trên các bộ dữ liệu dưới 1.000 phiên bản, nó cho bạn biết tài liệu đào tạo thường mỏng đến mức nào. Vấn đề ở đây là thiết kế học tập liên kết của TuneLab: công nghệ sinh học khai thác các mô hình của Lilly mà không trực tiếp làm lộ dữ liệu độc quyền. Hàm ý không rõ ràng là việc tích hợp Schrödinger LiveDesign có nghĩa là hầu hết các nhóm sẽ gặp những mô hình này trong phần mềm mà họ đã chạy. Các mô hình không phải là biến số bạn kiểm soát. Dữ liệu bạn cung cấp cho họ là.
Dành cho người mua hoặc khách hàng tiềm năng QC, “được ghi lại” đã có định nghĩa. Mười nguyên tắc toàn vẹn dữ liệu ALCOA+ yêu cầu hồ sơ phải được quy kết, dễ đọc, đương thời, nguyên bản, chính xác, hoàn thành, nhất quán, bền bỉ và sẵn có, và ICH Q2(R2) Hướng dẫn xác nhận phân tích yêu cầu một quy trình phân tích phải được chứng minh là phù hợp với mục đích dự định của nó theo một quy trình xác nhận được xác định trước, với việc sửa đổi mở rộng những nguyên tắc đó sang phép đo phổ khối. Việc phân phối peptide đầy đủ tài liệu, trong những điều khoản đó, có nghĩa là một tệp rất nhiều trong đó mã định danh mẫu liên kết trở lại lô, phiên bản xét nghiệm và các đơn vị đi cùng với kết quả, và các biện pháp kiểm soát cũng như số liệu lỗi được nêu rõ thay vì ngụ ý. MOL Changes là một nhà cung cấp có gói phân tích được xây dựng xung quanh chuỗi đó, mặc dù không có cuộc kiểm tra độc lập nào về các định dạng dữ liệu dành riêng cho AI của nó được tìm thấy.
Bốn câu hỏi để hỏi hồ sơ của chính bạn ngày hôm nay: Người mẫu có thể đọc được bảng này không? Bên thứ ba có thể tạo lại lô này không? Kết quả xét nghiệm này có mang số nhận dạng và đơn vị không? Tập dữ liệu này có thể được hợp nhất với tập dữ liệu của quý trước không? peptit 3
Phải làm gì bây giờ và bức tranh lớn hơn
Bắt đầu với việc xuất khẩu, không phải nền tảng. Ba hành động, theo thứ tự khẩn cấp.
-
Tuần này: kiểm tra quá trình xuất thử nghiệm của một chiến dịch gần đây dựa trên danh sách trường có thể đọc được bằng máy của bạn và ghi lại những gì còn thiếu. Hầu hết các đội tìm thấy khoảng trống trong một buổi chiều.
-
Tháng này: thêm số nhận dạng lô, đơn vị, phiên bản xét nghiệm và phiên bản mã phân tích sang mẫu xuất, và bắt đầu phiên bản chính phương pháp xét nghiệm đó.
-
Quý này: yêu cầu hồ sơ lô đầy đủ, bao gồm lô nhựa và nguồn axit amin, trước khi tham gia một chiến dịch. Nhà cung cấp không thể nêu tên lô nhựa hoặc nguồn axit amin là cờ đỏ.
Hai điều không nên làm. Không xây dựng lại nền tảng dữ liệu trước khi sửa định dạng xuất, và không coi CoA là tập dữ liệu sẵn sàng cho việc đào tạo.
Bối cảnh cảnh báo đáng được lưu ý. Trong quá trình kiểm tra khả năng sử dụng lại FAIR thủ công của các bộ dữ liệu được lưu trữ, 45.9% trong số các tập dữ liệu mở được đánh giá đã được xếp hạng có thể tái sử dụng, nghĩa 54.1% đã không. Trong kiểm tra dữ liệu miền năng lượng, 82% các bộ dữ liệu bị thiếu dữ liệu ở ít nhất một chiều chính và 27% đã mất tích hơn một nửa. Số liệu loại này thay đổi tùy theo nguồn và miền, và chúng được trích dẫn ở đây như một minh họa về tỷ lệ mất siêu dữ liệu, không phải là điểm chuẩn peptide.
Đó là bức tranh lớn hơn về việc khám phá peptide sẵn sàng cho AI: tạo bằng chứng, không phải khả năng của mô hình, đang trở thành bước giới hạn tỷ lệ. Tiêu chuẩn tài liệu đang trở thành một tiêu chí mua sắm, và các phòng thí nghiệm phiên bản hồ sơ của họ bây giờ sẽ là những phòng thí nghiệm có dữ liệu vẫn có thể sử dụng được sau ba năm.
Bước tiếp theo: xem lại khung tài liệu chuỗi hành trình sản phẩm và sử dụng danh sách kiểm tra chín giai đoạn của nó để chấm điểm các hồ sơ lô hiện tại của bạn.
Tiết lộ: MOL Changes xuất bản blog này với tư cách là nhà cung cấp peptide.
Câu hỏi thường gặp
Quan hệ đối tác GenScript-TuneLab có bao gồm các peptide không?
KHÔNG. Thông báo riêng của GenScript về thỏa thuận TuneLab mở rộng phạm vi dịch vụ biểu hiện protein, thanh lọc và mô tả đặc tính của các trình tự ưu tiên. Tổng hợp peptide không được đặt tên trong phạm vi đó, vì vậy các nhóm peptide nên đọc thông báo này như một tín hiệu về nơi mà hoạt động khám phá được hỗ trợ bởi AI đang hướng tới thay vì như một dịch vụ mà họ có thể mua ngày nay.
Dữ liệu “sẵn sàng cho AI” thực sự có ý nghĩa gì trong thực tế?
Nó có nghĩa là năm thuộc tính cụ thể: định danh ổn định cho mọi thực thể, từ vựng được kiểm soát thay vì các trường văn bản tự do, đơn vị và kiểu dữ liệu rõ ràng, liên kết thô, tập tin được xử lý và siêu dữ liệu, và mở các định dạng tồn tại lâu dài thay vì xuất do nhà cung cấp khóa. Tổng quan về quản lý dữ liệu xét nghiệm thực tế của LabKey đặt ra các yêu cầu này đối với dữ liệu xét nghiệm. Một tệp thỏa mãn chúng có thể được phân tích cú pháp bằng một mô hình mà không cần con người viết lại tiêu đề cột trước. Đó là toàn bộ bài kiểm tra.
Bộ dữ liệu phân tích peptide cần lớn đến mức nào trước khi học máy hỗ trợ?
Nhỏ hơn hầu hết các đội giả định, nhưng không hề nhỏ chút nào. Hướng dẫn thu thập dữ liệu của Cradle cho thiết kế protein giúp thiết kế sáng tạo trở nên thực tế từ khắp nơi 96 các biến thể cho mỗi thuộc tính. Bộ dữ liệu kỹ thuật protein điển hình, ngược lại, giữ ít hơn 1,000 các phiên bản và được xác thực bằng xác thực chéo 10 lần, như hướng dẫn thực hành tốt nhất đã xuất bản về kỹ thuật protein được hỗ trợ ML mô tả. Ràng buộc ràng buộc thường là tính nhất quán giữa các trường hợp đó, không phải số của họ.
Tôi nên hỏi nhà cung cấp những gì?
Yêu cầu file lô đầy đủ, không phải riêng CoA. Khuôn khổ chuỗi hành trình sản phẩm theo từng giai đoạn của MOL Changes coi nhà cung cấp không thể nêu tên lô nhựa hoặc nguồn axit amin là cờ đỏ, và yêu cầu dữ liệu phân tích có thể đọc được bằng máy cùng với chứng chỉ. Nếu không thể tải các định dạng dữ liệu peptide sẵn sàng cho xét nghiệm mà bạn nhận được nếu không chép lại thủ công, quy trình khám phá peptide sẵn sàng cho AI dừng ở hộp thư đến của bạn.
Phần kết luận
Sự hợp tác GenScript-TuneLab là một tín hiệu về cách tạo ra bằng chứng peptide, không phải là một tiêu chuẩn dữ liệu peptide. Không có dữ liệu thử nghiệm độc lập nào được công bố sau 2024 đã được phát hiện ra rằng sẽ cho phép mọi người coi thông báo đó như một thông số kỹ thuật đã được giải quyết, nên công việc thực tế vẫn ở nguyên chỗ cũ: trong hồ sơ mà phòng thí nghiệm của bạn đã tạo ra.
Bản ghi đó có bốn yêu cầu bạn có thể thực hiện ngay bây giờ. Dữ liệu sạch có nghĩa là các trường mà mô hình có thể phân tích cú pháp mà không cần sửa chữa thủ công. Các bản ghi tổng hợp peptide có thể tái tạo có nghĩa là khả năng truy xuất nguồn gốc ở cấp độ lô trở lại nguồn nhựa và axit amin. Các định dạng dữ liệu peptide sẵn sàng cho xét nghiệm có nghĩa là kết quả vẫn được chuyển giao giữa các công cụ và cộng tác viên. Bộ dữ liệu phân tích peptide cho thiết kế tính toán có nghĩa là các phép đo cơ bản luôn gắn liền với trình tự mà chúng mô tả.
Bước hợp lý tiếp theo là nhỏ nhặt và không hấp dẫn: thực hiện một chiến dịch đã hoàn thành, xuất khẩu nó như hiện nay, và kiểm tra từng trường theo thông số kỹ thuật mà máy có thể đọc được. Bất cứ điều gì thất bại trong quá trình kiểm tra đó là lộ trình khám phá peptide sẵn sàng cho AI của bạn, và nó sẽ cụ thể hơn bất kỳ thông báo nào.