Schnelle Antwort
Vom KI-Training zur Arzneimittelentwicklung bis hin zu marktreifen Peptiden: Die Übersetzungslücke schließen
Was die Übersetzungslücke ist und was „Bench-Ready“ bedeutet
Kundenspezifischer Peptidlieferant Peptidberechnung Die Übersetzungslücke ist der Abstand zwischen einem rechnerisch eingestuften Kandidaten und einem Peptid, das reproduzierbar hergestellt werden kann, charakterisiert und getestet. „Bereit“ ist der überprüfbare Zustand auf der anderen Seite dieser Distanz: eine definierte Reihenfolge und ein definiertes Format, demonstrierte die Machbarkeit der Synthese, ein analytisches Datenpaket, das jede Behauptung stützt, angegebenen Handhabungsbedingungen, und ein Test, für den das Material tatsächlich geeignet ist.
Die klinische Ebene zeigt, warum die Lücke kommerziell wichtig ist. Die Branchenbasislinie 2011–2020 war a 7.9% Wahrscheinlichkeit einer Genehmigung ab Phase I 12,728 Phasenübergänge (BIO / Informa Pharma Intelligence / QLS-Berater, 2021). Die erste Analyse von KI-nativen Pipelines ergab einen Phase-I-Erfolg von 80–90 %, aber nur etwa 40% in Phase II, eine Zahl, die nach Angaben der Autoren auf einer begrenzten Stichprobengröße beruht (Jayatunga et al., Arzneimittelentdeckung heute, 2024). A 2025 Ein direkt auf diesen Zahlen basierender Kommentar besagt, dass die Sicherheit und Verträglichkeit besser ist als bei herkömmlich entwickelten Molekülen, 90% versus unter 65%, während der Erfolg des Phase-II-Proof-of-Concept noch aussteht 40%, im Einklang mit historischen Branchendurchschnitten, und fügt hinzu, dass es noch nicht genügend Fälle gibt, um statistische Analysen zu ermöglichen (Jacobson, npj Drug Discovery, 2025).
Zwei Grenzwerte für die Evidenz gehören in denselben Absatz wie die Zahlen. Keine von Experten überprüfte Quelle quantifiziert den Anteil der von KI entwickelten Peptide, bei denen die Synthese fehlschlägt, und keine Quelle definiert „KI-entdeckt“ operativ, ob das bedeutet, dass KI zur Zielidentifizierung verwendet wird, Moleküldesign, oder beides. Das Schließen der Übersetzungslücke im KI-Peptiddesign kann daher nicht anhand einer veröffentlichten Fehlerquote gemessen werden. Es muss als Abfolge technischer Entscheidungen verwaltet werden, Genau das wird in den übrigen Abschnitten dargelegt.
Wie Peptid-KI-Modelle trainiert werden und welche Daten sie benötigen
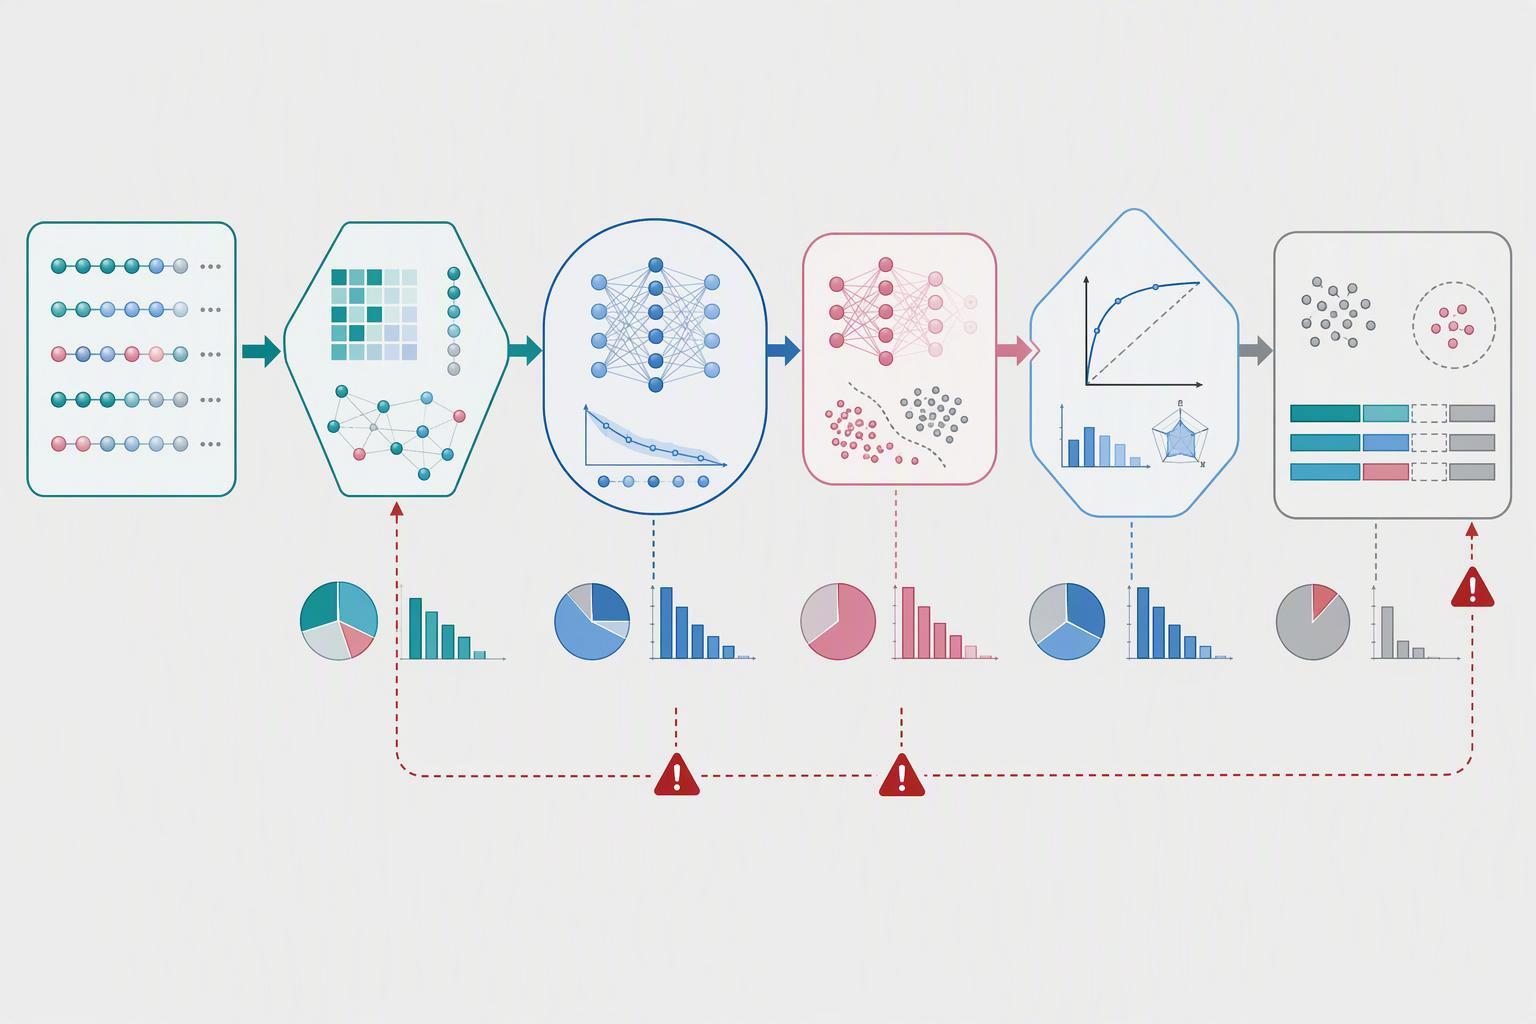
Peptidmodelle lernen aus einer Sequenzdarstellung, ein Korpus vor dem Training, ein Feinabstimmungsset mit beschrifteten Positiv- und Negativteilen, und eine Bewertungsaufteilung, und die Qualität der letzten beiden bestimmt, ob die gemeldete Leistung etwas bedeutet. Das Trainingsset von AMPGen ist ein nützlicher konkreter Fall: 10,249 einzigartige antimikrobielle Peptidsequenzen, zusammengestellt aus sechs öffentlichen Datenbanken, davon 9,854 tragen antibakterielle Ziele, reduziert auf 9,964 positiv nach Filterung auf 5–65 Aminosäuren, gepaart mit 11,989 Nicht-AMP-Sequenzen, die aus UniProt als Negative gezogen wurden (AMPGen, Kommunikationsbiologie, 2025). Der Generator selbst wurde auf die OpenFold-Datenabdeckung vorab trainiert 401,381 mehrere Sequenzausrichtungen für grob 132,000 einzigartige PDB-Sequenzen.
Dieser negative Satz ist der Teil, in den die meisten Projekte zu wenig investieren. UniProt wird nach Sequenzen mit 5–65 Resten gefiltert und dabei ausgeschlossen 17 Schlüsselwörter wie antimikrobiell, Antibiotikum, Antibakteriell und Toxin erzeugen laut Annotation Negative, die nicht AMP sind, keine Negative, die gemessen und als inaktiv befunden wurden. Für den Anteil inaktiver Datensätze in Peptidaktivitätsdatenbanken gibt es keine stabile öffentliche Figur, Deshalb ist die Zusammensetzung eines bestimmten Sets, Keine allgemeine Aussage zum Datenbankgleichgewicht, ist die ehrliche Art, dies zu beschreiben.
Die Bewertung ist der zweite Schwachpunkt. Eine Prüfung von 51 Benchmark-Konfigurationen über Polaris hinweg, OT, MoleculeNet und DTI fanden in der überwiegenden Mehrheit der Datensätze eine Cross-Split-Kontamination, mit mittlerer ECFP-Tanimoto-Ähnlichkeit des nächsten Nachbarn zwischen Test- und Trainingsverbindungen von 0.494, 0.559, 0.589 Und 0.779 jeweils (Benchmark-Audit, PMC, 2026). Unter injizierten Label-Konflikten, die mittlere ROC-AUC sank um 0.317. Ein Peptidmodell, das anhand eines Splits evaluiert wurde, der nahezu doppelte Sequenzen mit dem Training teilt, meldet eine Zahl, die die Synthese nicht überlebt.
Warum rechnerisch vielversprechende Peptide bei der Synthese und im Test versagen
Peptide versagen am Labortisch aus chemischen Gründen, die ein Aktivitätsmodell auf Sequenzebene nicht erkennt. Schwierige Sequenzen, definiert als diejenigen, die starke inter bilden- oder intramolekulare nichtkovalente Wechselwirkungen, die unlösliche Aggregate erzeugen und die vollständige Entschützung und Kopplung blockieren, oberhalb von 50–60 Aminosäuren bleiben auch bei automatisierter Synthese eine Herausforderung, und Sequenzen länger als 50 Reste erfordern häufig eine Fragmentkondensation oder eine native chemische Ligation (Grenzen in der Chemie, 2020).
Die zitierte Zwei-Peptid-Studie veränderte die Prozessbedingungen mit zunehmendem Maßstab. Seine Erträge beschreiben diese Routen und Experimente, kein Planungsbereich für jede Sequenz. Vergleichen Sie eine vorgeschlagene Skalierung anhand abgestimmter Prozess- und Analysedaten.
Das zitierte AMPGen-Papier berichtet über Synthese und antibakterielle Tests ausgewählter Kandidaten sowie rechnerisches Screening. Halten Sie gemessene Ergebnisse von Vorhersagen fern und behalten Sie den relevanten Organismus bei, Assay und Kandidatenauswahlnenner; Die Ergebnisse belegen weder die klinische Wirksamkeit noch eine Erfolgsquote für alle generierten Sequenzen.
So filtern Sie KI-Kandidaten anhand realer Synthesebeschränkungen
Filtern Sie Kandidaten nach Synthesebeschränkungen, bevor Sie sie nach Aktivität einstufen, nicht nach einer gescheiterten Kampagne. Der praktische Ablauf läuft: zulässige Reste und Schutzgruppenkompatibilität, dann Hydrophobic-Run- und Aggregationsrisiko-Scoring, dann Multi-Disulfid- und Cyclisierungsmöglichkeit, dann Kompatibilität von Terminal- und Seitenkettenmodifikationen, dann die Länge Decke. Jedes Tor ist ein Ja oder Nein in einer bestimmten Sequenz, und ein Kandidat, der ein Tor nicht besteht, sollte neu entworfen werden, anstatt mit einer Notiz weiterzumachen.
Die Strukturvorhersage unterstützt die mittleren Tore, anstatt sie zu ersetzen. AlphaFold 3 sagt die gemeinsame Struktur von Komplexen einschließlich Proteinen voraus, Nukleinsäuren, kleine Moleküle, Ionen und modifizierte Reste aus Polymersequenzen, Restmodifikationen und Ligand SMILES, und berichtet über eine wesentlich höhere Genauigkeit für Protein-Ligand-Wechselwirkungen als Docking-Tools wie Vina (P = 2.27 × 10⁻¹³) und für Antikörper-Antigen-Komplexe als AlphaFold-Multimer v2.3 (P = 6.5 × 10⁻⁵) (Abramson et al., Natur, 2024). Das sind Signifikanzwerte, keine prozentuale Schlagzeilenverbesserung, und sie sagen nichts darüber aus, ob das Peptid auf Harz zusammengesetzt werden kann.
Die Sequenzlänge ist ein Risikofaktor, keine universelle Synthesedecke. Hydrophobe Läufe, Änderungen und Topologie sollten eine Machbarkeitsbewertung auslösen; Vier aufeinanderfolgende hydrophobe Reste erfordern nicht automatisch eine Neugestaltung oder Fragmentligation. Wählen Sie eine Route mithilfe konstruktspezifischer Experimente.
|
Tor |
Was es anzeigt |
Fehlerreaktion |
|---|---|---|
|
Rückstand und Schutzgruppe Verstärkte Peptide Kompatibilität |
Ob erforderliche Rückstände und Chemie nebeneinander existieren |
Reste ersetzen oder Strategie ändern |
|
Hydrophobie und Aggregationsgefahr |
Aufeinanderfolgende hydrophobe Strecken, β-Faltblatt-Neigung |
Fragmentverdichtung neu konzipieren oder planen |
|
Machbarkeit von Disulfid und Zyklisierung |
Multi-Disulfid-Regiochemie, Hersteller von Peptidinformationen Kopf-an-Schwanz- oder Lactam-Verschluss |
Passen Sie die Cyclisierungschemie an oder lassen Sie sie fallen Wachstumshormonpeptide |
|
Modifikationskompatibilität |
Terminal, Seitenkette, Etikett, Linker- und Lipidzusätze |
Ordnen Sie die Änderungsstelle neu zu |
|
Länge Decke |
Praktische Grenze für komplexe modifizierte Sequenzen |
In Fragmente aufspalten oder ligieren |
Welches analytische Datenpaket macht ein Peptid vor Gericht vertretbar?
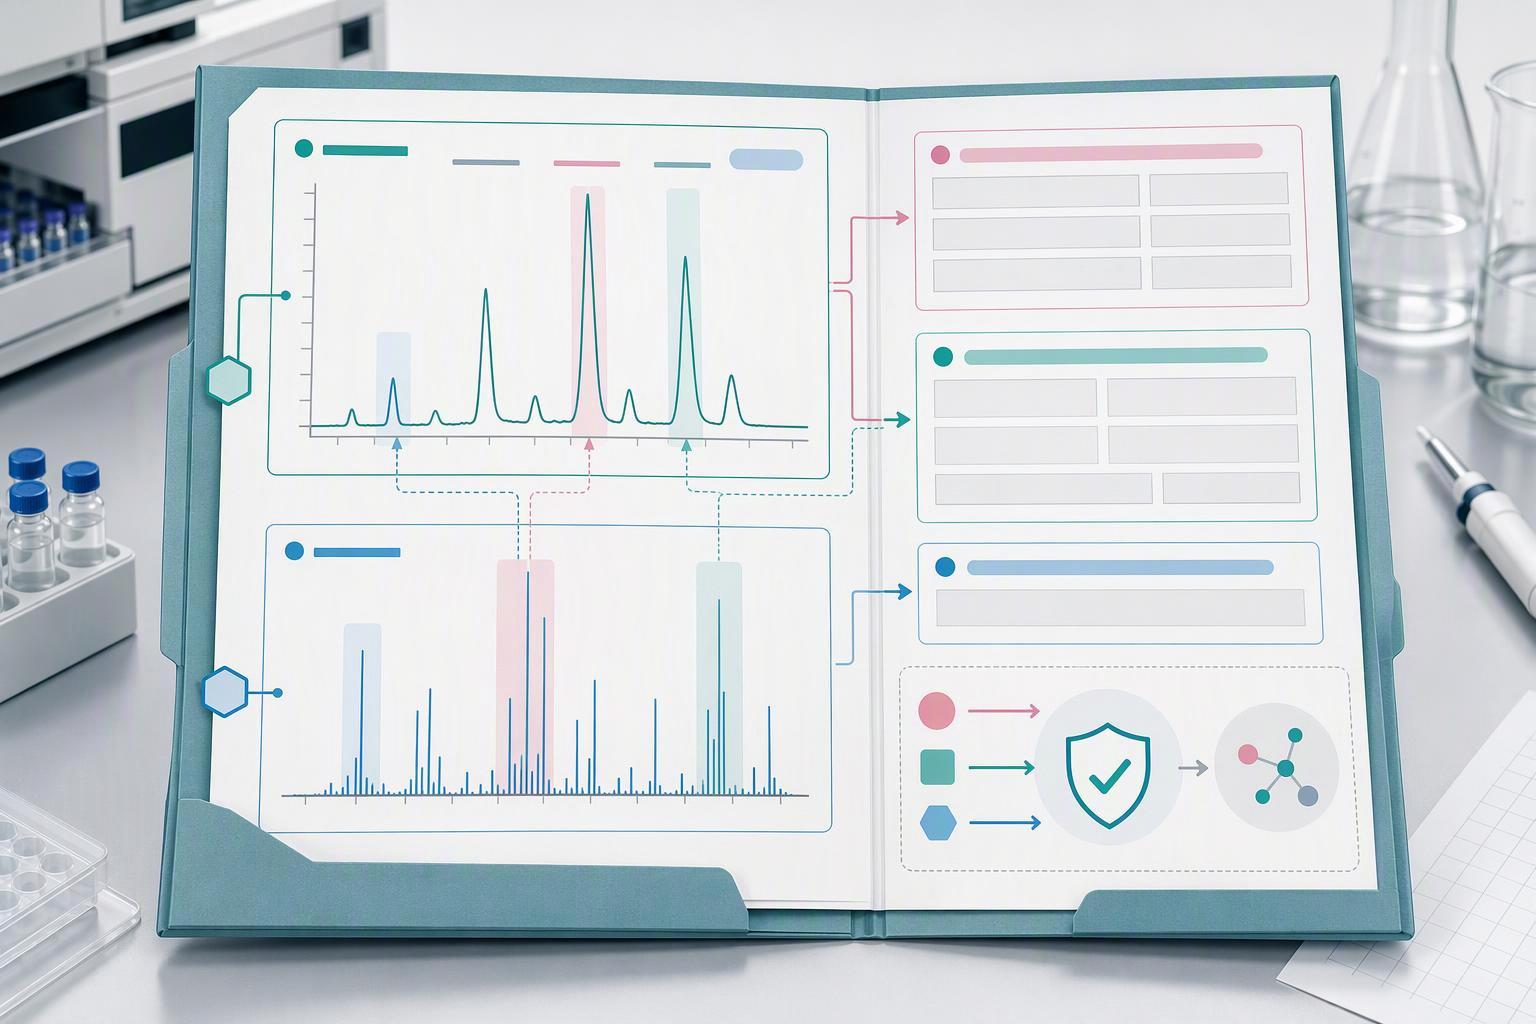
Eine vertretbare Verpackung trennt Reinheit, Identität, Inhalt, Stabilität und Assay-Eignung in unterschiedliche Ansprüche, jedes mit seiner eigenen Methode und seinen eigenen Beweisen. Die EMA-Richtlinie zur Entwicklung und Herstellung synthetischer Peptide, angenommen 4 Dezember 2025 und effektiv 1 Juni 2026, betrachtet Reinheit als eines der wichtigsten kritischen Qualitätsmerkmale für synthetische Peptide, erfordert die Angabe und Begründung von Akzeptanzkriterien für einzelne Fraktionen und den Hauptpool, und fordert eine größenbasierte orthogonale Reinheitscharakterisierung, ladungsbasierte und hydrophobe Trennung (EMA, 2025).
Identität ist nicht Reinheit, und die Richtlinien sagen dies an verschiedenen Stellen. ICH Q6B vertritt die Auffassung, dass absolute und relative Reinheit schwer zu bestimmen und stark methodenabhängig sind, Daher wird die Reinheit durch eine Kombination analytischer Verfahren beurteilt, während Identitätstests sehr spezifisch für das Molekül sein sollten und möglicherweise mehr als eine physikalische Chemikalie erfordern, biologischer oder immunochemischer Test (ICH Q6B, 1999). Die EMA-Richtlinie empfiehlt mindestens zwei orthogonale Identifizierungsmethoden bei Spezifikation und Freigabe, aus der Masse gezogen, relative Retentionszeit, LC-MS, Peptidkartierung, Bioaktivität, Aminosäureanalyse oder NMR, und unterteilt Verunreinigungen in peptidbezogene und nicht-peptidische Kategorien (EMA, 2025).
Verwenden Sie den endgültigen ICH Q2(R2) Rahmen für die anwendbare analytische Validierung erstellen und das Studiendesign für die beabsichtigte Entscheidung begründen. Lagerbedingungen, Chargenanzahl und -dauer müssen für die Produkt- und Entwicklungsphase ausgewählt werden und dürfen nicht als universelle Screening-Materialanforderung vererbt werden.
So skalieren Sie vom mg-Screening auf die kg-Produktion, ohne die Chargenkonsistenz zu verlieren
Scale-up verändert den Prozess, Daher entsprechen die Reinheit und Ausbeute, die Sie im Screening-Maßstab validiert haben, nicht den Zahlen, die Sie im Produktionsmaßstab versprechen sollten. Die Guzmán-Daten zeigen das Ausmaß dieser Verschiebung: das gleiche Peptid bewegte sich von 8.0% Ertrag und 23.9% Rohreinheit bei 10–20 mg to 53.5% Ertrag und 64.4% Rohreinheit bei 3–4 g, und das zweite Peptid aus 36% Und 62.1% Zu 78.5% Und 98.7% (Guzmán et al., Elektronisches Journal für Biotechnologie, 2023). Weil sich das Protokoll und die Bedingungen in dieser Studie mit dem Umfang veränderten, Die ehrliche Lesart ist, dass eine Skalierung eine erneute Optimierung erfordert, nicht, dass eine feste Strafe gilt.
Die Chargenkonsistenz wird durch die Spezifikation gesteuert, nicht über die Ertragszahl. Die EMA-Richtlinie sieht vor, dass Prozessparameter für Isolationsvorgänge beschrieben werden, erfordert Maßnahmen zur Verhinderung einer Kreuzkontamination, wenn verschiedene Peptide auf derselben Säule gereinigt werden, und erfordert eine Fate-and-Purge-Bewertung der Verunreinigungen des Ausgangsmaterials, die bis zum endgültigen Peptid gelangen können (EMA, 2025). Löschung und abgeschnittene Sequenzen, durch unvollständige Kopplung oder Entschützung gebildet und durch Acetylierung verschlossen, sind die Verunreinigungsklasse, die die Prozesskontrolle am direktesten widerspiegelt, und die Richtlinie geht davon aus, dass ihre Entstehung durch wiederholte Kopplung und systematisches Verschließen verhindert und nicht stromabwärts korrigiert wird.
Stabilitätsstudien sollten die tatsächliche Lagerung unterstützen, Bearbeitungszeitraum, Verwendungszweck und Entwicklungsstadium. ICH-Registrierungsempfehlungen für Primärchargen und Einreichungsdauer stellen keine allgemeingültige Wartezeit von zwölf Monaten für Forschungspeptide dar. Definieren Sie ein phasengerechtes Protokoll und Akzeptanzkriterien.
Wie der geschlossene Kreislauf funktioniert, wenn Assay-Ergebnisse und -Fehler in das Modell zurückfließen
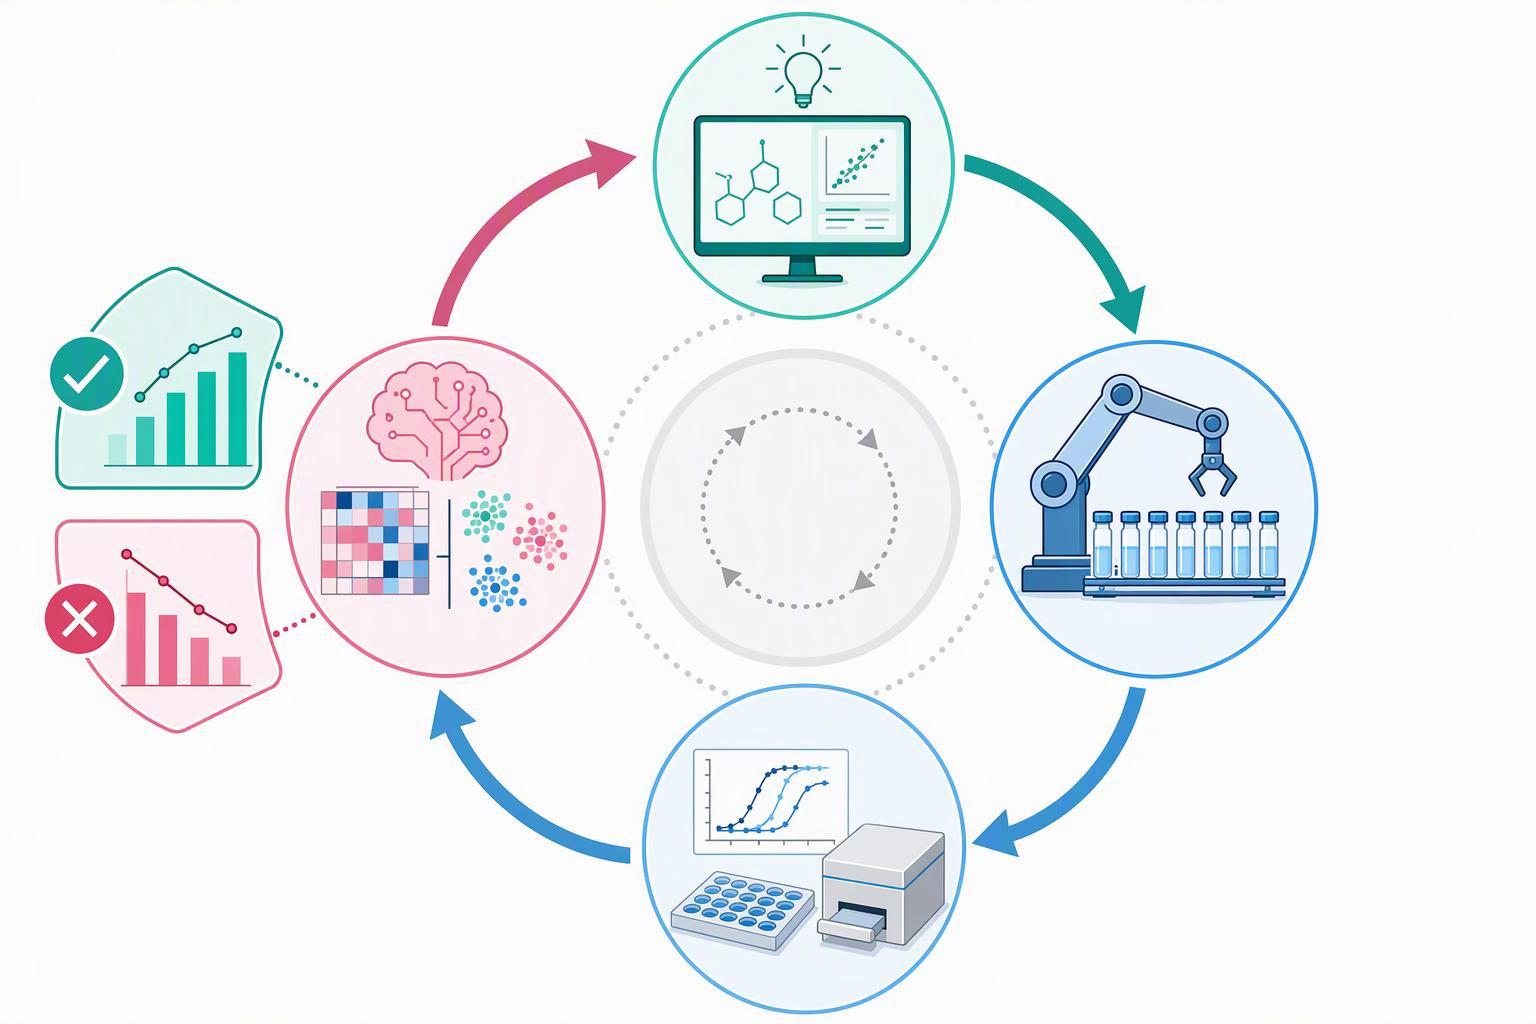
Der geschlossene Kreislauf funktioniert nur, wenn Ausfälle und Negative als unterschiedliche Bezeichnungen erfasst werden und nicht in einem inaktiven Bereich zusammengefasst werden. Der dokumentierte Zyklus besteht aus Design und Vorfilterung gegen harte Einschränkungen, einschließlich der Durchführbarkeit der Synthese, Aggregation, Toxizität, Löslichkeit und Materialverträglichkeit; machen und testen; Kuratieren Sie Ergebnisse, indem Sie jedes Ergebnis der genauen Reihenfolge zuordnen, Konstrukt, Charge, Testprotokoll, Konzentration, replizieren, Kontrollen, QC-Status und Modellversion; Modelle aktualisieren; Führen Sie dann eine neue Rangfolge durch und wählen Sie den nächsten vorhergesagten Batch-Balancing-Dienstprogramm aus, Unsicherheit, Diversität, Neuheit und praktische Umsetzbarkeit (Überprüfung des multimodalen Fundamentmodells, PMC, 2026). Kundenspezifische Peptidfabrik
Die vier Label-Kategorien machen den Unterschied. Quantitative Messungen haben einen Wert und eine Methode. Bestätigte negative Ergebnisse belegen, dass das Peptid hergestellt und getestet wurde und nicht funktioniert hat. Zensierte Ergebnisse enthalten einen Messwert, der außerhalb des Testbereichs liegt. Technische Fehler führen dazu, dass eine Synthese oder ein Assay keine interpretierbaren Daten liefert. Das Zusammenführen dieser Werte zu „inaktiv“ lehrt das Modell, dass eine fehlgeschlagene Kopplung und ein echtes Negativ dasselbe sind, Das ist das Gegenteil von dem, was die nächste Designrunde braucht.
Der Durchsatz ist die praktische Einschränkung dafür, wie schnell sich die Schleife dreht. Eine parallelisierte Kampagne mit 192 Reaktionen, abgeschlossen in vier Tagen, eine Vervierfachung gegenüber einem typischen sequenziellen Ansatz, mit aktivem Lernen in Achtergruppen, ist der konkrete Maßstab für die Iteration im Kampagnenmaßstab (Selbstfahrendes Laborkonto, PMC, 2022). In diesem Bericht wird auch darauf hingewiesen, dass das System nicht vollständig autonom ist und dass einige Schritte immer noch menschliches Eingreifen erfordern, beispielsweise das Laden neuer Fläschchen oder Chemikalien, Das ist derselbe Vorbehalt, dass der Mensch in der Schleife ist 2025 Es gibt Kommentare, in denen es heißt, KI sei ein Werkzeug zur Verbesserung, nicht ersetzen, wissenschaftliche Intuition (Jacobson, npj Drug Discovery, 2025).
Wo Regulierung und Beweise stehen, und Was bleibt unbewiesen
Die Regulierung von KI in der Arzneimittelentwicklung basiert auf Prinzipien und ist noch im Entstehen begriffen, während die Erwartungen an die Peptidchemie bereits konkret sind. EMA und FDA haben gemeinsam zehn Grundsätze für eine gute KI-Praxis im Arzneimittellebenszyklus veröffentlicht 14 Januar 2026, Es deckt die Beweiserstellung und -überwachung von der frühen Forschung bis hin zur Herstellung und Sicherheitsüberwachung ab, richtet sich an Entwickler sowie Antragsteller und Inhaber einer Marktzulassung, und soll künftige gebietsspezifische Leitlinien untermauern (EMA, 2026). Die Entwicklung der EU-Richtlinien basiert auf dem KI-Reflexionspapier der EMA, das in veröffentlicht wurde 2024. Der Januar der FDA 2025 Der Leitlinienentwurf zu KI für regulatorische Entscheidungen ist unverbindlich und nach dem Nutzungskontext organisiert, definiert als die Art und Weise, wie ein Modell verwendet wird, um eine bestimmte Frage zu beantworten, mit Sponsoren, die vorbildliche Glaubwürdigkeit für diesen Kontext schaffen (FDA, 2025).
Gemeinsam lesen, Die Peptidrichtlinie ist die operative Vorlage und die KI-Prinzipien basieren darauf. Die EMA-Leitlinie für synthetische Peptide schreibt bereits eine Rechtfertigung für das Ausgangsmaterial vor, Berichterstattung über Verunreinigungen, Identifikations- und Qualifikationsschwellen, und orthogonale Identifikation, und erfordert, dass analytische Verfahren so detailliert beschrieben werden, dass sie von einem offiziellen Arzneimittelkontrolllabor wiederholt werden können (EMA, 2025). Keine Quelle bringt die EMA-FDA-KI-Prinzipien mit einem peptidspezifischen KI-Design in Verbindung, und keine Quelle gibt einen regulatorischen Weg oder Zeitplan für die Zulassung von KI-entwickelten Peptiden an.
Die Krankenakte ist gemischt und sollte als solche gelesen werden. DSP-1181, das erste von KI entwickelte Medikament, das in den Menschen gelangt, wurde eingestellt in 2022 vor Phase II; REC-994 wurde im Jahr eingestellt 2025 nachdem längerfristige Daten frühere Wirksamkeitstrends nicht aufrechterhalten konnten; Rentosertib erreichte Phase IIa zur Behandlung von idiopathischer Lungenfibrose 2024, mit 18 Monate von der Entdeckung des Zielmoleküls bis zur Nominierung des präklinischen Kandidaten (KI in der Arzneimittelforschung: Klinische Fehler, Regulatorische Realität, PMC, 2026). Der 2025 In Kommentaren heißt es eindeutig, dass die KI-Bemühungen bisher nicht zu wirksameren Medikamenten geführt haben, während die 2024 Die Analyse stellt ihre Ergebnisse als frühe Anzeichen für klinisches Potenzial dar. Was noch unbewiesen ist, ist die Wirksamkeit, nicht Geschwindigkeit.
Häufig gestellte Fragen
Sind von KI entwickelte Peptide schwieriger zu synthetisieren als natürliche??
Keine Quelle belegt das. Die Schwierigkeit verfolgt die Sequenz selbst, nicht sein Ursprung: Aggregationsgefährdete Abschnitte, sperrige oder behinderte Rückstände, und Länge oben ungefähr 50 Zu 60 Aminosäuren verursachen die gleichen Kopplungs- und Entschützungsprobleme, unabhängig davon, ob ein Modell oder eine Evolution die Kette geschrieben hat (Grenzen in der Chemie, 2020). Was sich mit KI ändert, ist der Durchsatz. Models schlagen Kandidaten schneller vor, als eine Bank sie selektieren kann, Daher kommen harte Sequenzen in größeren Mengen an und die Fehlerquote sieht schlimmer aus, als sie ist.
Welche Reinheit benötigt ein Peptid für einen Zelltest im Vergleich zu einer In-vivo-Studie??
Es gibt keine einzelne Zahl. Die EMA-Richtlinie zu synthetischen Peptiden, wirksam 1 Juni 2026, fordert statt eines festen Schwellenwerts Akzeptanzkriterien, die für den konkreten Verwendungszweck gerechtfertigt sind (EMA, 2025). Legen Sie den Grenzwert fest, den der Test toleriert: Gegenionen und verkürzte Spezies, die eine In-vitro-Anzeige verschieben, können in vivo irrelevant sein, und das Umgekehrte gilt auch.
Reicht ein Analysezertifikat aus, um eine Menge freizugeben??
NEIN. Ein CoA berichtet, was der Lieferant gemessen hat; es allein bestätigt nicht die Identität. Bei der Spezifikation und Freigabe werden mindestens zwei orthogonale Identifikationsmethoden empfohlen, Daher sollten Massenspektrometrie und eine chromatographische oder Sequenzierungsmethode übereinstimmen, bevor die Charge akzeptiert wird (EMA, 2025).
Was soll mit einer fehlgeschlagenen Synthese im Trainingssatz passieren??
Bezeichnen Sie es als technischen Fehler, kein Inaktiver. Quantitative Ergebnisse, bestätigte Negative, zensierte Werte und fehlgeschlagene Läufe haben unterschiedliche Bedeutungen, und ihre Zusammenführung zerstört das Signal, das ein geschlossener KI-Peptiddesign-Workflow benötigt (Überprüfung des multimodalen Fundamentmodells, 2026). Hängen Sie jedes Etikett an die Sequenz an, Konstrukt, Charge, Protokoll, Konzentration, replizieren, Kontrollen, QC-Status und Modellversion.
Hat KI tatsächlich die klinische Wirksamkeit verbessert??
Die Beweise sind umstritten, und die spätere Lesart ist negativ. Frühe Berichte über eine beschleunigte Entdeckung gingen nicht mit nachgewiesenen Fortschritten bei den klinischen Endpunkten einher, Betrachten Sie die Rechengeschwindigkeit also als Prozessverbesserung und nicht als Beweis für bessere Ergebnisse (Überprüfung des multimodalen Fundamentmodells, 2026).
Abschluss
Vergleichen Sie vergleichbare Endpunkte: Der Abschluss von Phase I ist nicht dasselbe wie eine eventuelle Genehmigung nach Eintritt in Phase I. Die genannten KI-Programmbeispiele und historischen Branchenkohorten unterscheiden sich in der Auswahl, Größe, Termine und Nachbereitung. Sie begründen keinen KI-Vorteil, indem sie 80–90 % mit a vergleichen 7.9% Zustimmungswahrscheinlichkeit.
Was die Lücke schließt, ist ein Workflow, kein Modell. Filtern Sie Kandidaten anhand von Synthesebeschränkungen, bevor Sie sie in eine Rangfolge bringen, Bauen Sie das Analysepaket so auf, dass es rein ist, Identität, Inhalt, Stabilität und Assay-Eignung beruhen jeweils auf ihren eigenen Beweisen, Planen Sie ein Scale-up mit neu optimierten Prozessparametern und drei Primärchargen, und erfassen Sie Fehler als eigene Etiketten, damit die nächste Designrunde daraus lernt. Die Constraint-Checkliste im Abschnitt „Synthese-Machbarkeit“ ist der praktische Ausgangspunkt, und die Checkliste für analytische Datenpakete ist der Begleiter für die Laborphase. Es lohnt sich, beide vor der nächsten Kampagne zu übernehmen, nicht danach.