Qué es la brecha de traducción y qué significa Bench-Ready
Proveedor de péptidos personalizado Calc de péptidos La brecha de traducción es la distancia entre un candidato clasificado computacionalmente y un péptido que se puede producir de manera reproducible., caracterizado y probado. Listo para el banco es el estado comprobable al otro lado de esa distancia.: una secuencia y formato definidos, viabilidad de síntesis demostrada, un paquete de datos analíticos que respalda cada afirmación, condiciones de manipulación indicadas, y un ensayo para el que el material es realmente apto.
La capa clínica muestra por qué la brecha es importante comercialmente. La línea de base de la industria para el período 2011-2020 fue una 7.9% probabilidad de aprobación de la Fase I en todo 12,728 transiciones de fase (BIO / Inteligencia farmacéutica informática / Asesores QLS, 2021). El primer análisis de canales nativos de IA encontró entre un 80% y un 90% de éxito en la Fase I, pero solo aproximadamente 40% en la Fase II, una cifra que los autores describen como basada en un tamaño de muestra limitado (Jayatunga et al., Descubrimiento de fármacos hoy, 2024). A 2025 El comentario basado directamente en esos números afirma que la seguridad y la tolerabilidad tienden a ser mejores que las moléculas desarrolladas tradicionalmente., 90% versus menos 65%, mientras que el éxito de la prueba de concepto de la Fase II se sitúa en 40%, en línea con los promedios históricos de la industria, y añade que todavía no hay suficientes casos para impulsar los análisis estadísticos (jacobson, Descubrimiento de fármacos npj, 2025).
Dos límites a la evidencia pertenecen al mismo párrafo que los números.. Ninguna fuente revisada por pares cuantifica la proporción de péptidos diseñados por IA que fallan en la síntesis, y ninguna fuente define operativamente "IA-descubierta", si eso significa que se utiliza IA para la identificación de objetivos, diseño de moléculas, o ambos. Por lo tanto, cerrar la brecha de traducción en el diseño de péptidos de IA no se puede medir en comparación con una tasa de fracaso publicada.. Tiene que gestionarse como una secuencia de decisiones de ingeniería., que es lo que establecen los apartados restantes.
Cómo se entrenan los modelos de IA peptídica y qué datos necesitan
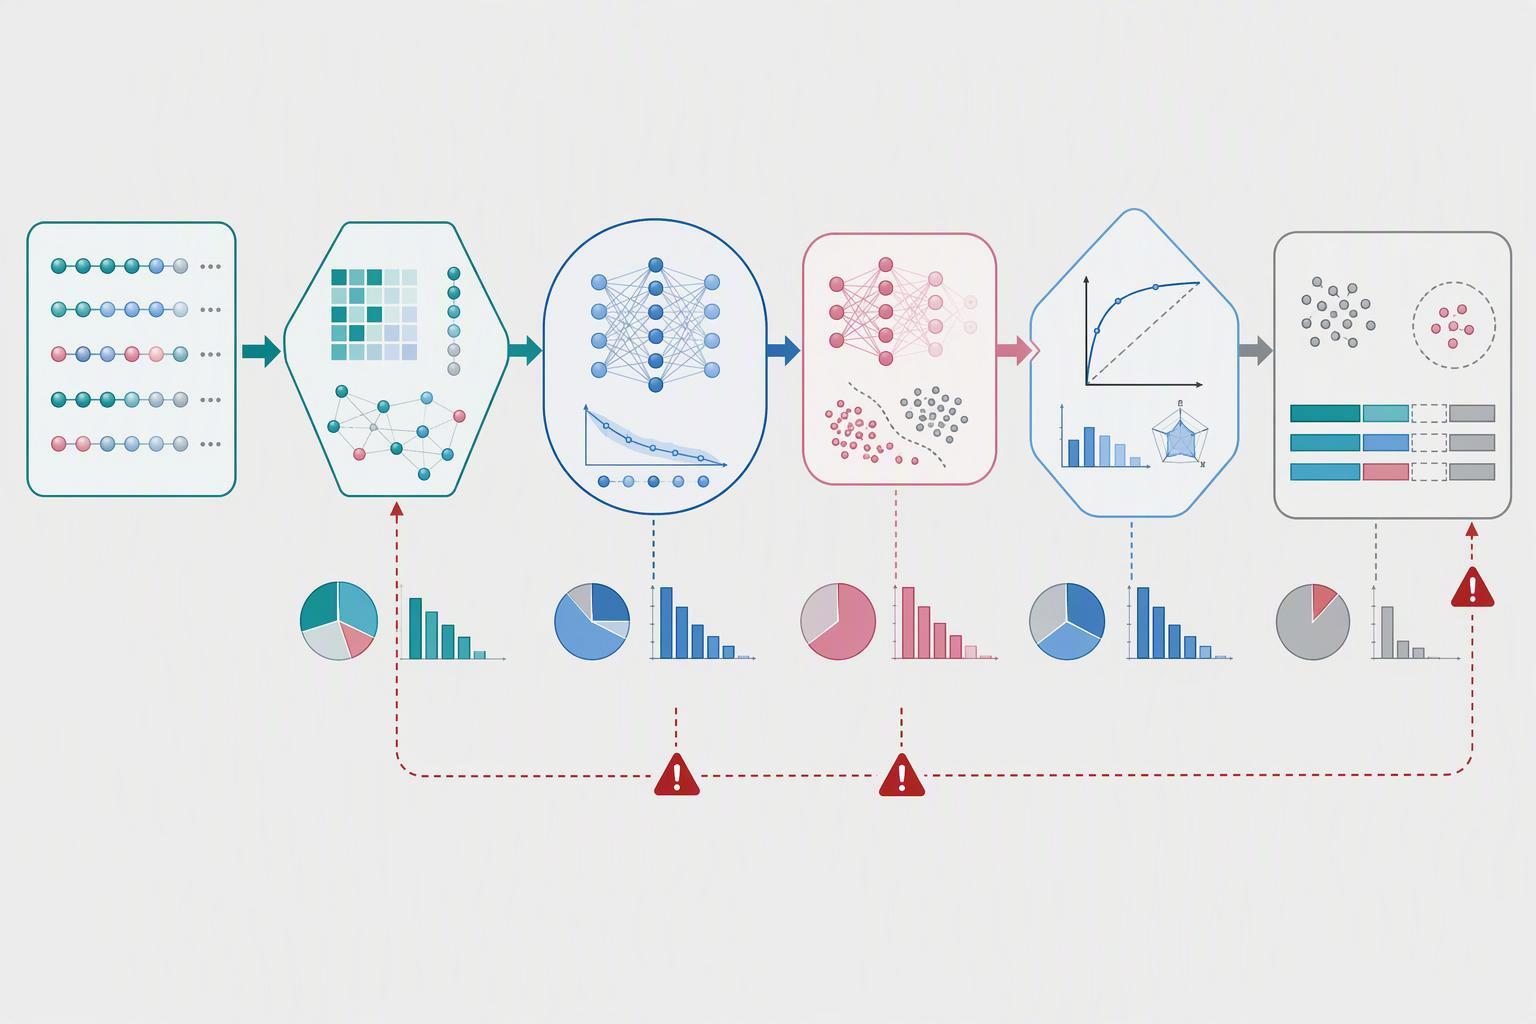
Los modelos de péptidos aprenden de una representación de secuencia., un corpus previo al entrenamiento, un conjunto de ajustes con etiquetas positivas y negativas, y una división de evaluación, y la calidad de los dos últimos determina si el desempeño reportado significa algo. El conjunto de formación de AMPGen es un caso concreto útil: 10,249 secuencias de péptidos antimicrobianos únicas compiladas a partir de seis bases de datos públicas, de los cuales 9,854 llevar objetivos antibacterianos, reducido a 9,964 positivos después de filtrar a 5-65 aminoácidos, emparejado con 11,989 secuencias que no son AMP extraídas de UniProt como negativas (AMPGen, Biología de las Comunicaciones, 2025). El generador en sí fue entrenado previamente con datos OpenFold que cubren 401,381 múltiples alineamientos de secuencias para aproximadamente 132,000 secuencias PDB únicas.
Ese conjunto negativo es la parte en la que la mayoría de los proyectos invierten poco.. Filtrar UniProt para secuencias de 5 a 65 residuos y excluir 17 palabras clave como antimicrobiano, antibiótico, antibacteriano y toxina produce negativos que no son AMP por anotación, no negativos que fueron medidos y encontrados inactivos. No existe una cifra pública estable para la proporción de registros inactivos en las bases de datos de actividad de péptidos., es por eso que la composición de un conjunto específico, no es un reclamo general sobre el equilibrio de la base de datos, es la manera honesta de describir esto.
La evaluación es el segundo punto débil. una auditoría de 51 configuraciones de referencia que abarcan Polaris, CDC, MoleculeNet y DTI encontraron contaminación cruzada en la gran mayoría de conjuntos de datos, con similitud media de ECFP Tanimoto del vecino más cercano entre los compuestos de prueba y entrenamiento de 0.494, 0.559, 0.589 y 0.779 respectivamente (auditoría de referencia, PMC, 2026). Conflictos bajo etiquetas inyectadas, el AUC medio de la República de China cayó 0.317. Un modelo de péptido evaluado en una división que comparte secuencias casi duplicadas con el entrenamiento informa un número que no sobrevivirá a la síntesis.
Por qué los péptidos computacionalmente prometedores fallan en la síntesis y en el ensayo
Los péptidos fallan en el banco por razones químicas que un modelo de actividad a nivel de secuencia no ve. Secuencias difíciles, definidos como aquellos que forman fuertes inter- o interacciones intramoleculares no covalentes que producen agregados insolubles y bloquean la desprotección y el acoplamiento completos., Sigue siendo un desafío por encima de 50 a 60 aminoácidos incluso con síntesis automatizada., y secuencias más largas que 50 Los residuos a menudo necesitan condensación de fragmentos o ligación química nativa. (Fronteras de la química, 2020).
El estudio de dos péptidos citado cambió las condiciones del proceso a medida que aumentaba la escala.. Sus rendimientos describen esas rutas y experimentos., no hay un rango de planificación para cada secuencia. Comparar una propuesta de ampliación a través de procesos combinados y datos analíticos.
El artículo de AMPGen citado informa sobre pruebas de síntesis y antibacterianas de candidatos seleccionados, así como sobre detección computacional.. Mantenga los resultados medidos distintos de las predicciones y conserve el organismo relevante., ensayo y denominador de selección de candidatos; Los resultados no establecen eficacia clínica ni una tasa de éxito para todas las secuencias generadas..
Cómo filtrar candidatos de IA según restricciones de síntesis reales
Filtre los candidatos según las restricciones de síntesis antes de clasificarlos según su actividad., no después de una campaña fallida. La secuencia práctica transcurre: residuos permitidos y compatibilidad con grupos protectores, luego puntuación de riesgo de agregación y ejecución hidrofóbica, luego viabilidad de multidisulfuro y ciclación, luego compatibilidad de modificación de terminal y cadena lateral, entonces el techo de longitud. Cada puerta es un sí o un no en una secuencia específica., y un candidato que no pasa cualquiera de los criterios debe ser rediseñado en lugar de seguir adelante con una nota..
La predicción de estructuras respalda las puertas intermedias en lugar de reemplazarlas. AlfaFold 3 predice la estructura conjunta de complejos que incluyen proteínas, ácidos nucleicos, moléculas pequeñas, Iones y residuos modificados de secuencias de polímeros., modificaciones de residuos y ligando SMILES, e informa una precisión sustancialmente mayor para las interacciones proteína-ligando que las herramientas de acoplamiento como Vina (pag = 2.27 × 10⁻¹³) y para complejos anticuerpo-antígeno que AlphaFold-Multimer v2.3 (pag = 6.5 × 10⁻⁵) (Abramson y cols., Naturaleza, 2024). Esos son valores de significación., no es una mejora porcentual general, y no dicen nada sobre si el péptido se puede ensamblar en resina.
La longitud de la secuencia es un factor de riesgo., no es un techo de síntesis universal. Carreras hidrofóbicas, Las modificaciones y la topología deberían desencadenar una evaluación de viabilidad.; cuatro residuos hidrofóbicos consecutivos no requieren automáticamente rediseño o ligadura de fragmentos. Elija una ruta utilizando experimentos específicos de construcción.
|
Puerta |
lo que proyecta |
Respuesta de falla |
|---|---|---|
|
Residuo y grupo protector Péptidos amplificados compatibilidad |
Si coexisten los residuos necesarios y la química. |
Sustituir residuo o cambiar de estrategia |
|
Riesgo de agregación y funcionamiento hidrofóbico |
Estiramientos hidrofóbicos consecutivos, propensión a la hoja β |
Rediseñar o planificar la condensación de fragmentos. |
|
Viabilidad de disulfuro y ciclación. |
Regioquímica de multidisulfuros, Fabricante de información de péptidos cierre cabeza-cola o lactama |
Ajuste la química de ciclación o suelte Péptidos de la hormona del crecimiento |
|
Compatibilidad de modificaciones |
Terminal, cadena lateral, etiqueta, enlazadores y adiciones de lípidos |
Vuelva a secuenciar el sitio de modificación |
|
Techo de longitud |
Límite práctico para secuencias modificadas complejas. |
Dividir en fragmentos o ligar |
¿Qué paquete de datos analíticos hace que un péptido sea defendible en el banco?
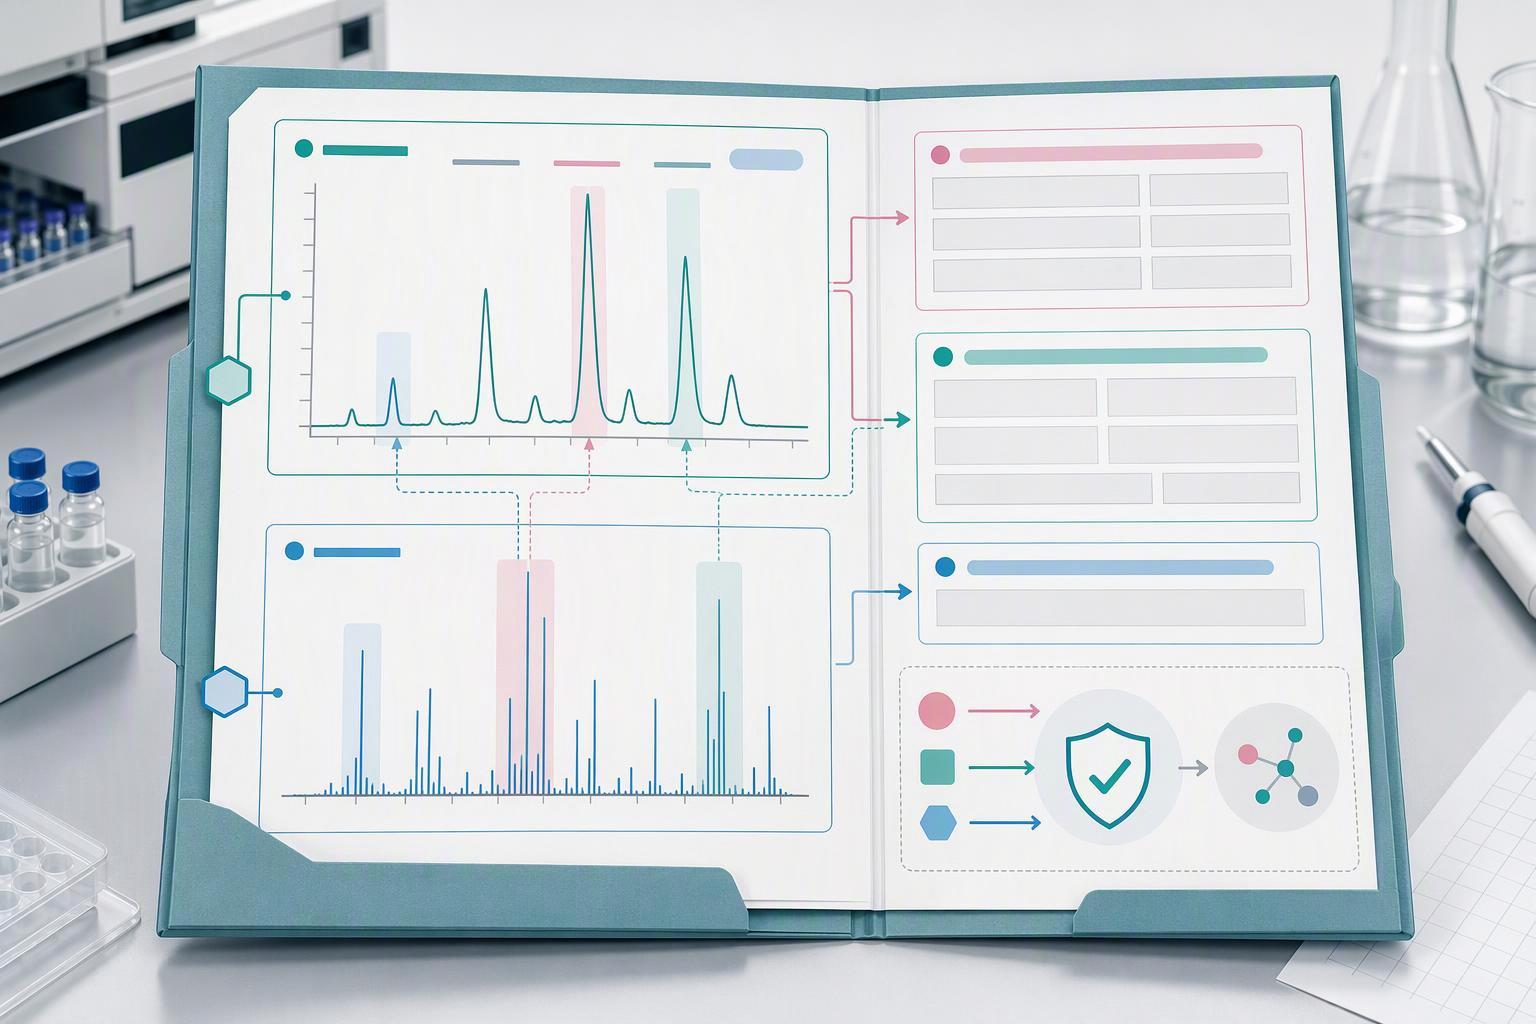
Un paquete defendible separa la pureza, identidad, contenido, estabilidad e idoneidad del ensayo en distintas afirmaciones, cada uno con su propio método y su propia evidencia. La directriz de la EMA sobre el desarrollo y fabricación de péptidos sintéticos, adoptado 4 Diciembre 2025 y eficaz 1 Junio 2026, trata la pureza como uno de los atributos de calidad críticos más importantes para los péptidos sintéticos, requiere que se establezcan y justifiquen los criterios de aceptación para las fracciones individuales y el conjunto principal, y exige una caracterización de la pureza ortogonal en función del tamaño., separación basada en carga y basada en hidrofobicidad (EMA, 2025).
La identidad no es pureza., y las pautas lo dicen en diferentes lugares. ICH Q6B sostiene que la pureza absoluta y relativa es difícil de determinar y depende en gran medida del método., por lo que la pureza se evalúa mediante una combinación de procedimientos analíticos, mientras que las pruebas de identidad deben ser muy específicas de la molécula y pueden requerir más de una prueba fisicoquímica., prueba biológica o inmunoquímica (Yo Q6B, 1999). La directriz de la EMA recomienda al menos dos métodos de identificación ortogonales en la especificación y la liberación., extraído de la masa, tiempo de retención relativo, LC-MS, mapeo de péptidos, bioactividad, análisis de aminoácidos o RMN, y divide las impurezas en categorías relacionadas con péptidos y no peptídicas (EMA, 2025).
Utilice el ICH Q2 final(R2) marco para la validación analítica aplicable y justificar el diseño del estudio para la decisión prevista. Condiciones de almacenamiento, El número y la duración del lote deben seleccionarse para el producto y la etapa de desarrollo en lugar de heredarse como un requisito universal del material de detección..
Cómo pasar de la selección de mg a la producción en kg sin perder la coherencia entre lotes
La ampliación cambia el proceso, por lo tanto, la pureza y el rendimiento que usted validó a escala de selección no son los números que debe prometer a escala de producción.. Los datos de Guzmán muestran la magnitud de ese cambio: el mismo péptido se movió desde 8.0% rendimiento y 23.9% pureza bruta de 10 a 20 mg a 53.5% rendimiento y 64.4% pureza bruta de 3 a 4 g, y el segundo péptido de 36% y 62.1% a 78.5% y 98.7% (Guzmán et al., Revista Electrónica de Biotecnología, 2023). Porque el protocolo y las condiciones cambiaron con la escala en ese estudio., La lectura honesta es que la ampliación requiere una nueva optimización., no es que se aplique una pena fija.
La consistencia entre lotes se controla mediante la especificación., no a través de la cifra de rendimiento. La directriz de la EMA espera que se describan los parámetros del proceso para las operaciones de aislamiento., Requiere medidas para evitar la contaminación cruzada cuando se purifican diferentes péptidos en la misma columna., y requiere una evaluación de destino y purga de las impurezas del material de partida que pueden llegar al péptido final. (EMA, 2025). Eliminación y secuencias truncadas., formado por acoplamiento incompleto o desprotección y cubierto por acetilación, Son la clase de impureza que refleja más directamente el control del proceso., y la directriz espera que su formación se prevenga mediante un acoplamiento repetido y una limitación sistemática en lugar de corregirse aguas abajo.
Los estudios de estabilidad deben respaldar el almacenamiento real., período de manipulación, uso previsto y etapa de desarrollo. Las recomendaciones de registro de ICH para lotes primarios y la duración de la presentación no son un período de espera universal de doce meses para los péptidos de investigación.. Definir un protocolo y criterios de aceptación apropiados para cada fase..
Cómo funciona el circuito cerrado cuando los resultados y las fallas del ensayo regresan al modelo
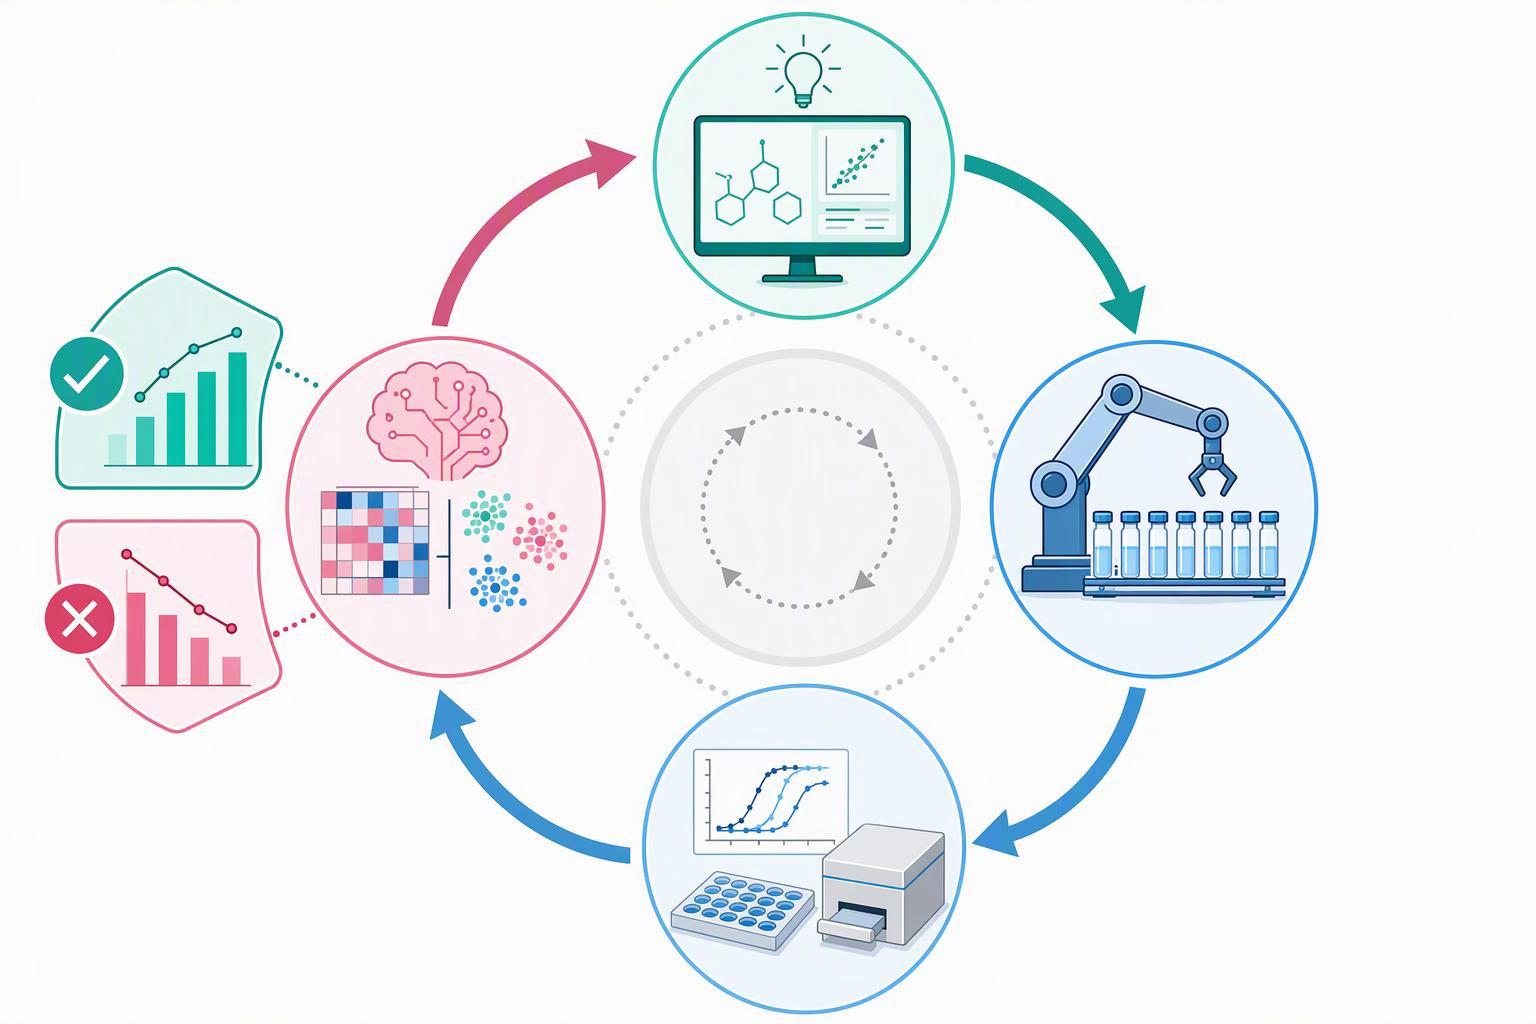
El circuito cerrado solo funciona si las fallas y los negativos se registran como etiquetas distintas en lugar de agruparse en un solo grupo inactivo.. El ciclo documentado es el diseño y el prefiltro contra restricciones estrictas, incluida la viabilidad de la síntesis., agregación, toxicidad, solubilidad y compatibilidad de materiales; hacer y ensayar; seleccionar resultados adjuntando cada resultado a la secuencia exacta, construir, lote, protocolo de ensayo, concentración, reproducir exactamente, controles, Estado de control de calidad y versión del modelo.; actualizar modelos; luego vuelva a clasificar y seleccione la siguiente utilidad prevista de equilibrio de lotes, incertidumbre, diversidad, novedad y viabilidad práctica (revisión del modelo de cimentación multimodal, PMC, 2026). Fábrica de péptidos personalizada
Las cuatro categorías de etiquetas son las que marcan la diferencia. Las mediciones cuantitativas conllevan un valor y un método.. Los negativos confirmados contienen evidencia de que el péptido fue elaborado y probado y no funcionó.. Los resultados censurados contienen una medición que quedó fuera del rango del ensayo.. Las fallas técnicas conllevan una síntesis o ensayo que no produjo datos interpretables.. Fusionarlos en "inactivos" le enseña al modelo que un acoplamiento fallido y un negativo genuino son la misma cosa., que es lo contrario de lo que necesita la próxima ronda de diseño.
El rendimiento es la restricción práctica sobre la rapidez con la que gira el bucle.. Una campaña paralela de 192 reacciones completada en cuatro días, un aumento de cuatro veces con respecto a un enfoque secuencial típico, con aprendizaje activo en lotes de ocho, es el punto de referencia concreto para la iteración a escala de campaña (cuenta de laboratorio autónomo, PMC, 2022). Esa cuenta también afirma que el sistema no es completamente autónomo y que algunos pasos aún requieren intervención humana, como cargar nuevos viales o productos químicos., que es la misma advertencia del ser humano en el circuito 2025 comentario hace cuando dice que la IA es una herramienta para mejorar, no reemplazar, intuición científica (jacobson, Descubrimiento de fármacos npj, 2025).
Dónde están la regulación y la evidencia, y lo que aún no se ha demostrado
La regulación de la IA en el desarrollo de fármacos se basa en principios y aún está en formación, mientras que las expectativas sobre la química de los péptidos ya son concretas. La EMA y la FDA publicaron conjuntamente diez principios para buenas prácticas de IA en el ciclo de vida de los medicamentos en 14 Enero 2026, Cubriendo la generación de evidencia y el seguimiento desde las primeras investigaciones hasta la fabricación y el seguimiento de la seguridad., dirigido a desarrolladores y solicitantes y titulares de autorizaciones de comercialización, y destinado a respaldar futuras orientaciones específicas para jurisdicciones (EMA, 2026). El desarrollo de directrices de la UE se basa en el documento de reflexión sobre IA de la EMA publicado en 2024. El informe de enero de la FDA 2025 El proyecto de orientación sobre IA para la toma de decisiones regulatorias no es vinculante y está organizado en función del contexto de uso., definido como cómo se utiliza un modelo para abordar una pregunta particular, con patrocinadores estableciendo un modelo de credibilidad para ese contexto (FDA, 2025).
Leer juntos, la directriz de péptidos es la plantilla operativa y los principios de la IA se encuentran encima de ella.. La directriz de péptidos sintéticos de la EMA ya impone una justificación del material de partida, informes de impurezas, umbrales de identificación y calificación, e identificación ortogonal, y exige que los procedimientos analíticos se describan con suficiente detalle para ser repetidos por un Laboratorio Oficial de Control de Medicamentos (EMA, 2025). Ninguna fuente conecta los principios de IA de la EMA y la FDA con el diseño de IA específico de péptidos, y ninguna fuente proporciona una vía regulatoria o un cronograma para que los péptidos diseñados por IA alcancen la aprobación.
La historia clínica es mixta y debe leerse como tal.. DSP-1181, el primer fármaco diseñado por IA que llega a los humanos, fue descontinuado en 2022 antes de la Fase II; REC-994 fue descontinuado en 2025 después de que los datos a más largo plazo no lograron sostener las tendencias de eficacia anteriores; rentosertib alcanzó la Fase IIa para la fibrosis pulmonar idiopática en 2024, con 18 meses desde el descubrimiento del objetivo hasta la nominación del candidato preclínico (IA en el descubrimiento de fármacos: Fracasos clínicos, Realidad regulatoria, PMC, 2026). El 2025 El comentario afirma claramente que los esfuerzos de IA hasta ahora no han dado como resultado medicamentos más eficaces., mientras que el 2024 El análisis enmarca sus hallazgos como signos tempranos de potencial clínico.. Lo que aún no se ha demostrado es la eficacia., no velocidad.
Preguntas frecuentes
¿Son los péptidos diseñados por IA más difíciles de sintetizar que los naturales??
Ninguna fuente establece que. La dificultad sigue la secuencia en sí., no su origen: tramos propensos a la agregación, residuos voluminosos o estorbados, y longitud arriba aproximadamente 50 a 60 Los aminoácidos crean los mismos problemas de acoplamiento y desprotección ya sea que un modelo o una evolución escribieran la cadena. (Fronteras de la química, 2020). Lo que cambia con la IA es el rendimiento. Los modelos proponen candidatos más rápido de lo que un banco puede clasificarlos, Por lo tanto, las secuencias difíciles llegan en lotes más grandes y la tasa de fallas parece peor de lo que es..
¿Qué pureza necesita un péptido para un ensayo celular frente a un estudio in vivo??
No hay un solo numero. La directriz de la EMA sobre péptidos sintéticos, eficaz 1 Junio 2026, Solicita criterios de aceptación justificados para el uso específico previsto en lugar de un umbral fijo. (EMA, 2025). Establecer el límite de lo que tolera el ensayo.: El contraión y las especies truncadas que cambian una lectura in vitro pueden ser irrelevantes in vivo., y lo contrario también vale.
¿Es suficiente un certificado de análisis para liberar mucho??
No. Un CoA informa lo que midió el proveedor.; por sí solo no confirma la identidad. Se recomiendan al menos dos métodos de identificación ortogonales en la especificación y publicación., por lo tanto, la espectrometría de masas y un método cromatográfico o de secuenciación deben coincidir antes de que se acepte el lote. (EMA, 2025).
¿Qué debería pasar con una síntesis fallida en el conjunto de entrenamiento??
Etiquételo como falla técnica, no un inactivo. Resultados cuantitativos, negativos confirmados, Los valores censurados y las ejecuciones fallidas tienen significados diferentes., y fusionarlos destruye la señal que necesita un flujo de trabajo de diseño de péptidos de IA de circuito cerrado (revisión del modelo de cimentación multimodal, 2026). Adjunte cada etiqueta a la secuencia, construir, lote, protocolo, concentración, reproducir exactamente, controles, Estado de control de calidad y versión del modelo..
¿La IA realmente ha mejorado la eficacia clínica??
La evidencia es impugnada, y la lectura posterior es negativa. Los primeros informes sobre descubrimiento acelerado no han ido acompañados de avances demostrados en los criterios de valoración clínicos., Por lo tanto, trate la velocidad computacional como una mejora del proceso en lugar de una prueba de mejores resultados. (revisión del modelo de cimentación multimodal, 2026).
Conclusión
Comparar puntos finales similares: La finalización de la Fase I no es lo mismo que la aprobación final después de ingresar a la Fase I. Las muestras de programas de IA citadas y las cohortes históricas de la industria difieren en la selección, tamaño, fechas y seguimiento. No establecen una ventaja de IA al comparar el 80-90% con una 7.9% probabilidad de aprobación.
Lo que cierra la brecha es un flujo de trabajo, no es un modelo. Filtrar candidatos según restricciones de síntesis antes de clasificarlos, construir el paquete analítico para que la pureza, identidad, contenido, La estabilidad y la idoneidad del ensayo se basan cada una en su propia evidencia., planificar la ampliación en torno a parámetros de proceso reoptimizados y tres lotes principales, y registrar los fracasos como sus propios sellos para que la próxima ronda de diseño aprenda de ellos. La lista de verificación de restricciones en la sección de viabilidad de síntesis es el punto de partida práctico., y la lista de verificación del paquete de datos analíticos es el complemento para la etapa de banco. Vale la pena adoptar ambos antes de la próxima campaña., no después de eso.