Cos'è il divario di traduzione e cosa significa Bench-Ready
Fornitore di peptidi personalizzati Calcolo dei peptidi Il gap di traduzione è la distanza tra un candidato classificato computazionalmente e un peptide che può essere prodotto in modo riproducibile, caratterizzato e testato. Pronto per il banco è lo stato controllabile dall'altra parte di quella distanza: una sequenza e un formato definiti, dimostrata fattibilità della sintesi, un pacchetto di dati analitici che supporta ogni affermazione, condizioni di movimentazione dichiarate, e un test per il quale il materiale è effettivamente idoneo.
Il livello clinico mostra perché il divario è importante a livello commerciale. Lo scenario di riferimento del settore per il periodo 2011-2020 era: 7.9% probabilità di approvazione a partire dalla Fase I 12,728 transizioni di fase (BIO / Informa Pharma Intelligence / Consulenti QLS, 2021). La prima analisi delle pipeline native dell’intelligenza artificiale ha rilevato un successo della Fase I dell’80-90%, ma solo circa 40% nella Fase II, una cifra che gli autori descrivono come basata su una dimensione del campione limitata (Jayatunga et al., La scoperta della droga oggi, 2024). UN 2025 i commenti basati direttamente su questi numeri affermano che la sicurezza e la tollerabilità tendono a migliorare rispetto alle molecole sviluppate tradizionalmente, 90% contro sotto 65%, mentre il successo della prova di concetto della Fase II si trova 40%, in linea con le medie storiche del settore, e aggiunge che non ci sono ancora abbastanza casi per alimentare analisi statistiche (Jacobson, npj Scoperta di farmaci, 2025).
Due limiti all'evidenza appartengono allo stesso paragrafo dei numeri. Nessuna fonte sottoposta a revisione paritaria quantifica la quota di peptidi progettati dall’intelligenza artificiale che non riescono a sintetizzarsi, e nessuna fonte definisce operativamente “scoperta dall’intelligenza artificiale”., se ciò significa che l'IA viene utilizzata per l'identificazione del bersaglio, progettazione della molecola, o entrambi. Pertanto, la chiusura del divario traslazionale nella progettazione dei peptidi AI non può essere misurata rispetto a un tasso di fallimento pubblicato. Deve essere gestito come una sequenza di decisioni ingegneristiche, che è quanto stabilito nelle restanti sezioni.
Come vengono addestrati i modelli di intelligenza artificiale dei peptidi e di quali dati hanno bisogno
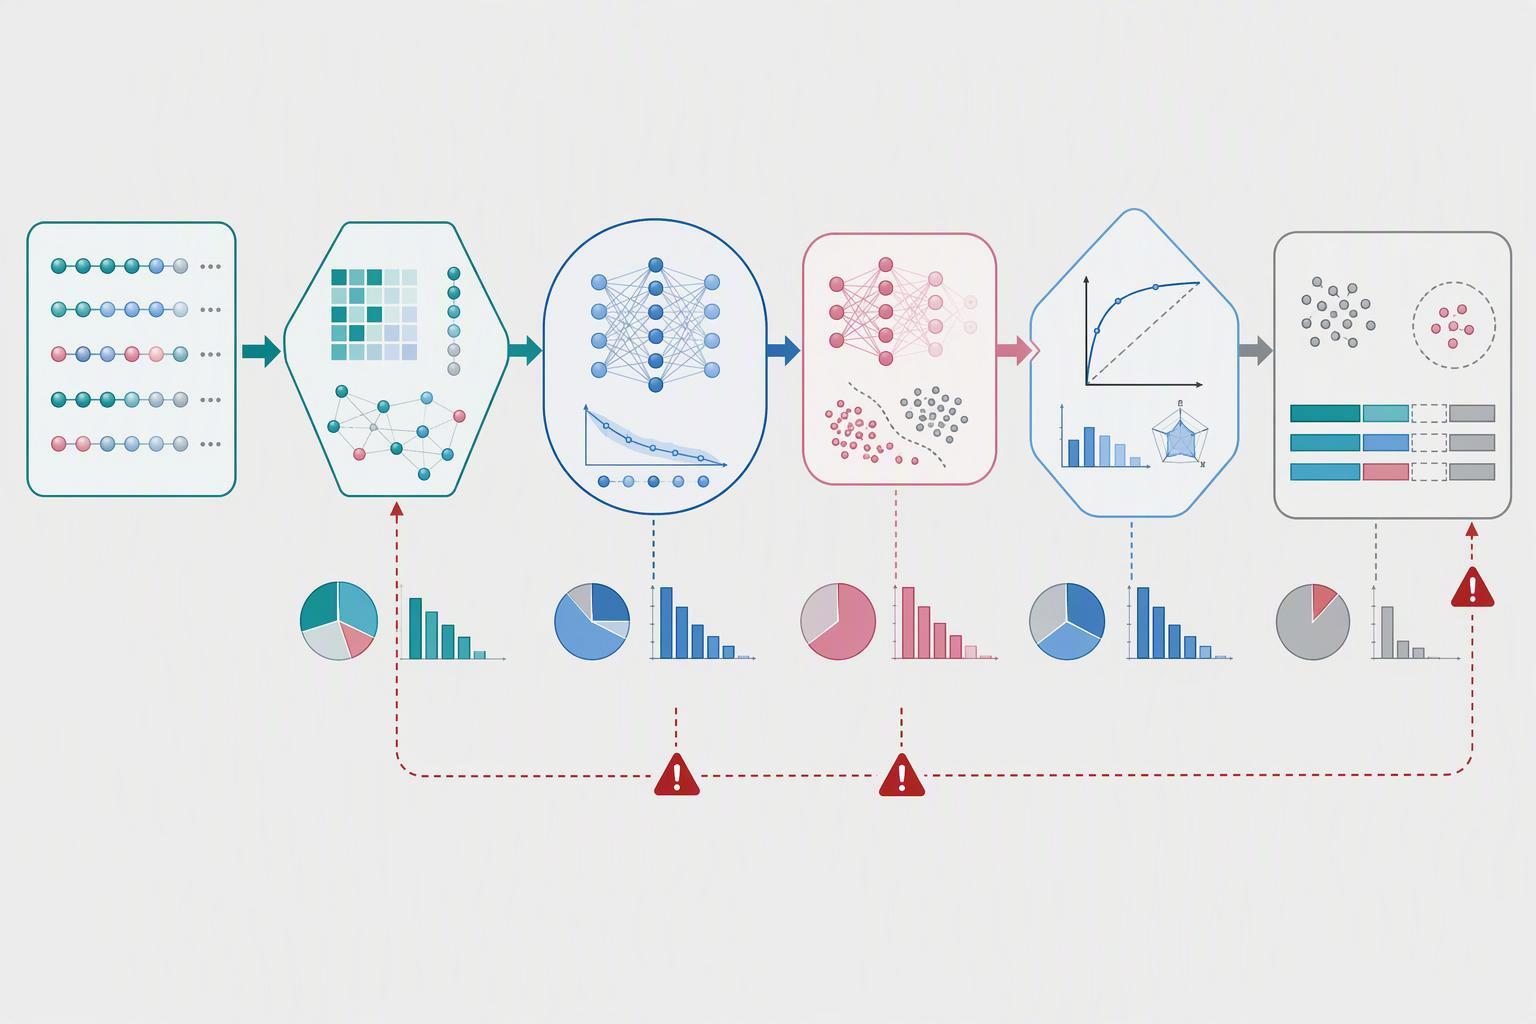
I modelli peptidici apprendono da una rappresentazione di sequenza, un corpus di pre-formazione, un set di messa a punto con positivi e negativi etichettati, e una suddivisione della valutazione, e la qualità degli ultimi due determina se la performance riportata significa qualcosa. Il set di formazione di AMPGen è un utile caso concreto: 10,249 sequenze peptidiche antimicrobiche uniche compilate da sei database pubblici, di cui 9,854 trasportano bersagli antibatterici, ridotto a 9,964 positivi dopo il filtraggio a 5-65 aminoacidi, accoppiato con 11,989 sequenze non AMP estratte da UniProt come negative (AMPGen, Biologia delle comunicazioni, 2025). Il generatore stesso è stato pre-addestrato sulla copertura dei dati OpenFold 401,381 allineamenti di sequenze multiple per circa 132,000 sequenze PDB uniche.
Questo insieme negativo è la parte in cui la maggior parte dei progetti investe poco. Filtraggio UniProt per sequenze di 5–65 residui escludendo 17 parole chiave come antimicrobico, antibiotico, antibatterico e tossico produce negativi che non sono AMP mediante annotazione, non negativi che sono stati misurati e trovati inattivi. Non esiste alcun dato pubblico stabile per la quota di record inattivi nei database sull'attività dei peptidi, ecco perché la composizione di un insieme specifico, non un'affermazione generale sul bilanciamento del database, è il modo onesto per descriverlo.
La valutazione è il secondo punto debole. Un controllo di 51 configurazioni di benchmark che abbracciano Polaris, PMS, MoleculeNet e DTI hanno riscontrato una contaminazione incrociata nella stragrande maggioranza dei set di dati, con somiglianza media ECFP Tanimoto del vicino più vicino tra i composti di prova e quelli di formazione 0.494, 0.559, 0.589 E 0.779 rispettivamente (verifica dei parametri di riferimento, PMC, 2026). Conflitti di etichette sotto iniettate, l'AUC media della ROC è diminuita 0.317. Un modello peptidico valutato su una divisione che condivide sequenze quasi duplicate con l'addestramento riporta un numero che non sopravviverà alla sintesi.
Perché i peptidi computazionalmente promettenti falliscono nella sintesi e nel dosaggio
I peptidi falliscono in laboratorio per ragioni chimiche che un modello di attività a livello di sequenza non vede. Sequenze difficili, definiti come quelli che formano un'inter forte- o interazioni intramolecolari non covalenti che producono aggregati insolubili e bloccano la deprotezione e l'accoppiamento completi, rimangono una sfida sopra i 50-60 aminoacidi anche con la sintesi automatizzata, e sequenze più lunghe di 50 i residui spesso necessitano di condensazione dei frammenti o di legatura chimica nativa (Frontiere della chimica, 2020).
Il citato studio sui due peptidi ha modificato le condizioni del processo con l'aumento della scala. I suoi rendimenti descrivono quei percorsi ed esperimenti, non un intervallo di pianificazione per ogni sequenza. Confrontare una proposta di scale-up attraverso processi abbinati e dati analitici.
Il citato documento AMPGen riporta la sintesi e i test antibatterici dei candidati selezionati, nonché lo screening computazionale. Mantenere i risultati misurati distinti dalle previsioni e mantenere l'organismo rilevante, dosaggio e denominatore di selezione del candidato; i risultati non stabiliscono l'efficacia clinica o un tasso di successo per tutte le sequenze generate.
Come filtrare i candidati AI rispetto ai reali vincoli di sintesi
Filtra i candidati in base ai vincoli di sintesi prima di classificarli per attività, non dopo una campagna fallita. Viene eseguita la sequenza pratica: residui ammissibili e compatibilità con il gruppo protettore, quindi punteggio relativo alla corsa idrofobica e al rischio di aggregazione, quindi fattibilità multi-disolfuro e ciclizzazione, quindi compatibilità con la modifica del terminale e della catena laterale, poi la lunghezza del soffitto. Ogni cancello è un sì o un no su una sequenza specifica, e un candidato che fallisce qualsiasi cancello dovrebbe essere riprogettato piuttosto che riportato avanti con una nota.
La previsione della struttura supporta le porte intermedie anziché sostituirle. AlphaFold 3 predice la struttura congiunta di complessi comprese le proteine, acidi nucleici, piccole molecole, ioni e residui modificati da sequenze polimeriche, modifiche dei residui e SORRISI del ligando, e riporta una precisione sostanzialmente più elevata per le interazioni proteina-ligando rispetto a strumenti di docking come Vina (P = 2.27 × 10⁻¹³) e per i complessi anticorpo-antigene rispetto ad AlphaFold-Multimer v2.3 (P = 6.5 × 10⁻⁵) (Abramson et al., Natura, 2024). Questi sono valori significativi, non un miglioramento percentuale del titolo, e non dicono nulla sulla possibilità che il peptide possa essere assemblato sulla resina.
La lunghezza della sequenza è un fattore di rischio, non un tetto di sintesi universale. Percorsi idrofobici, le modifiche e la topologia dovrebbero innescare una valutazione di fattibilità; quattro residui idrofobici consecutivi non richiedono automaticamente la riprogettazione o la legatura dei frammenti. Scegli un percorso utilizzando esperimenti specifici del costrutto.
|
Cancello |
Cosa scherma |
Risposta al fallimento |
|---|---|---|
|
Residuo e gruppo protettore Peptidi amplificati compatibilità |
Se i residui necessari e la chimica coesistono |
Sostituisci il residuo o cambia strategia |
|
Rischio di corsa idrofobica e di aggregazione |
Tratti idrofobici consecutivi, Propensione al foglio β |
Riprogettare o pianificare la condensazione dei frammenti |
|
Fattibilità del disolfuro e della ciclizzazione |
Regiochimica multi-disolfuro, Produttore di informazioni sui peptidi chiusura testa-coda o lattamica |
Regola la chimica o la caduta della ciclizzazione Peptidi dell'ormone della crescita |
|
Compatibilità delle modifiche |
terminale, catena laterale, etichetta, linker e aggiunte di lipidi |
Risequenziare il sito di modifica |
|
Soffitto di lunghezza |
Limite pratico per sequenze modificate complesse |
Diviso in frammenti o legato |
Quale pacchetto di dati analitici rende un peptide difendibile in panchina
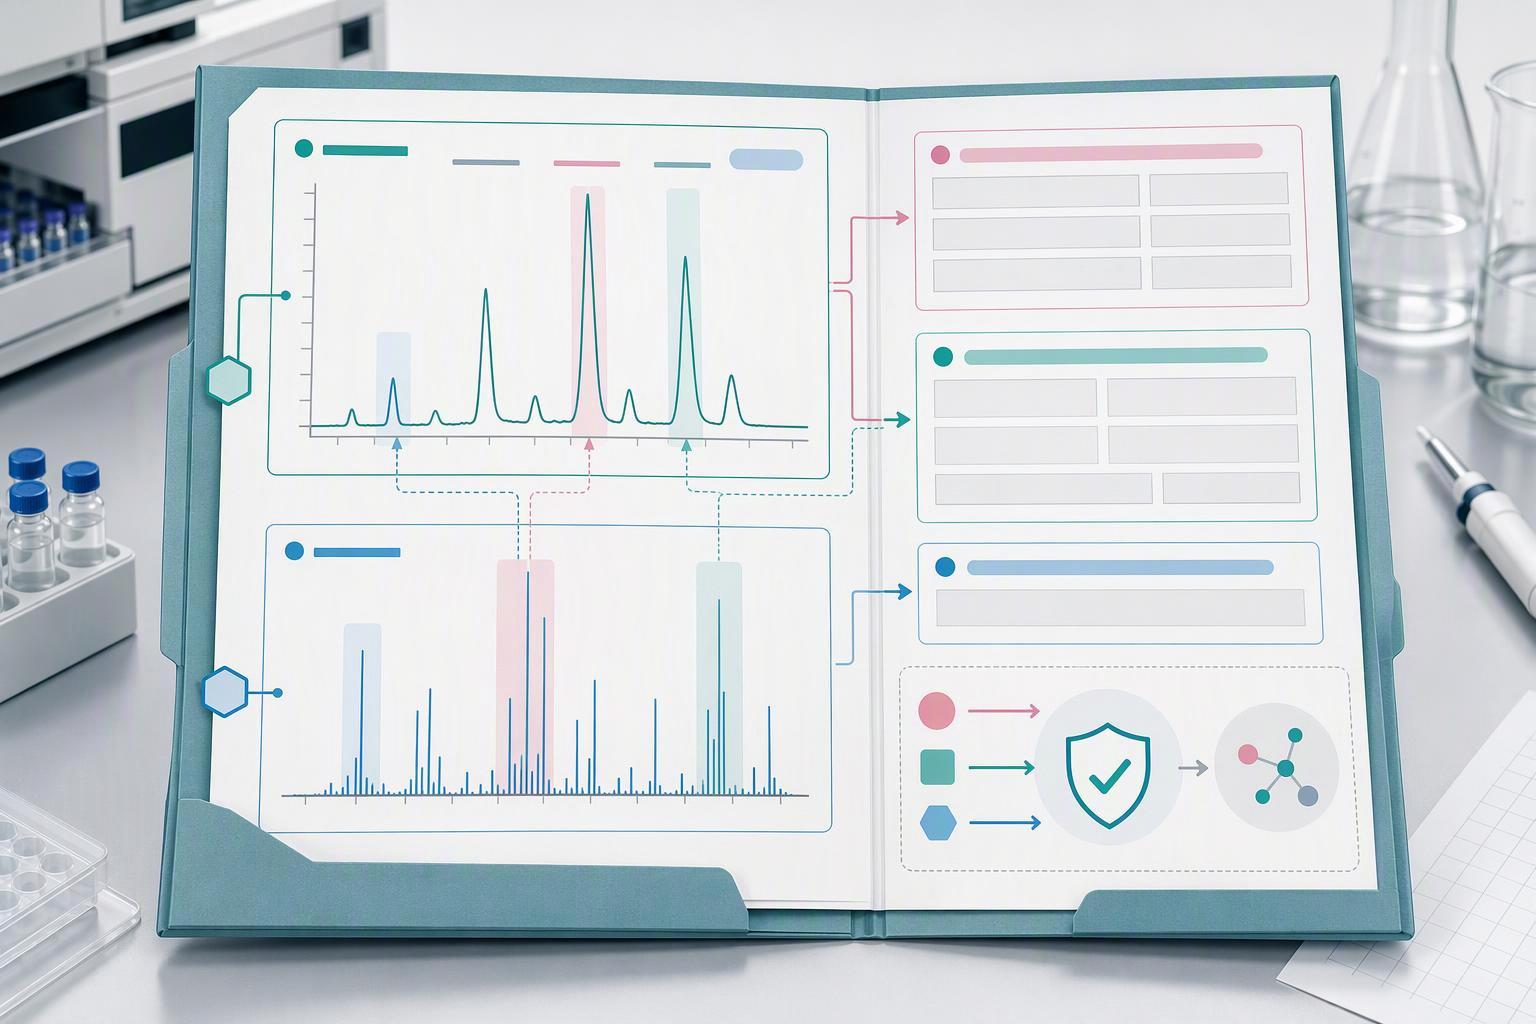
Un pacchetto difendibile separa la purezza, identità, contenuto, stabilità e idoneità al test in affermazioni distinte, ognuno con il proprio metodo e le proprie prove. Le linee guida EMA sullo sviluppo e la produzione di peptidi sintetici, adottato 4 Dicembre 2025 ed efficace 1 Giugno 2026, considera la purezza come uno degli attributi di qualità critici più importanti per i peptidi sintetici, richiede che i criteri di accettazione per le singole frazioni e per il pool principale siano dichiarati e giustificati, e richiede una caratterizzazione ortogonale della purezza in base alle dimensioni, separazione basata sulla carica e sull'idrofobicità (EMA, 2025).
L'identità non è purezza, e le linee guida lo dicono in diversi luoghi. ICH Q6B sostiene che la purezza assoluta e relativa sono difficili da determinare e fortemente dipendenti dal metodo, quindi la purezza viene valutata mediante una combinazione di procedure analitiche, mentre i test di identità dovrebbero essere altamente specifici per la molecola e potrebbero richiedere più di un test fisico-chimico, test biologico o immunochimico (Io Q6B, 1999). Le linee guida EMA raccomandano almeno due metodi di identificazione ortogonali al momento della specifica e del rilascio, tratto dalla massa, relativo tempo di ritenzione, LC-MS, mappatura peptidica, bioattività, analisi degli amminoacidi o NMR, e divide le impurità in categorie correlate ai peptidi e non peptidiche (EMA, 2025).
Utilizzare l'ICH finale Q2(R2) quadro per la validazione analitica applicabile e giustificare il disegno dello studio per la decisione prevista. Condizioni di conservazione, il conteggio dei lotti e la durata devono essere selezionati per il prodotto e la fase di sviluppo piuttosto che ereditati come requisito universale del materiale di screening.
Come passare dallo screening in mg alla produzione in kg senza perdere la coerenza tra lotti
Lo scale-up cambia il processo, quindi la purezza e la resa convalidate su scala di screening non sono i numeri che dovresti promettere su scala di produzione. I dati di Guzmán mostrano l’entità di questo cambiamento: da cui si è mosso lo stesso peptide 8.0% resa e 23.9% purezza grezza a 10-20 mg a 53.5% resa e 64.4% purezza grezza a 3–4 g, e il secondo peptide da 36% E 62.1% A 78.5% E 98.7% (Guzman et al., Giornale elettronico di biotecnologia, 2023). Perché il protocollo e le condizioni sono cambiati con la scala in quello studio, la lettura onesta è che lo scale-up richiede una riottimizzazione, non che si applichi una sanzione fissa.
La coerenza tra lotti è controllata attraverso le specifiche, non attraverso la cifra del rendimento. La linea guida EMA prevede che vengano descritti i parametri di processo per le operazioni di isolamento, richiede misure per prevenire la contaminazione incrociata quando diversi peptidi vengono purificati sulla stessa colonna, e richiede una valutazione del destino e dell'eliminazione delle impurità del materiale di partenza che potrebbero passare al peptide finale (EMA, 2025). Cancellazioni e sequenze troncate, formato da accoppiamento incompleto o deprotezione e limitato da acetilazione, sono la classe di impurità che riflette più direttamente il controllo del processo, e la linea guida prevede che la loro formazione venga prevenuta mediante ripetuti accoppiamenti e capping sistematici piuttosto che corretti a valle.
Gli studi di stabilità dovrebbero supportare l'effettivo stoccaggio, periodo di gestione, destinazione d'uso e fase di sviluppo. Le raccomandazioni di registrazione ICH per i lotti primari e la durata della presentazione non rappresentano un periodo di attesa universale di dodici mesi per i peptidi di ricerca. Definire un protocollo e criteri di accettazione adeguati alla fase.
Come funziona il circuito chiuso quando i risultati e gli errori del test rientrano nel modello
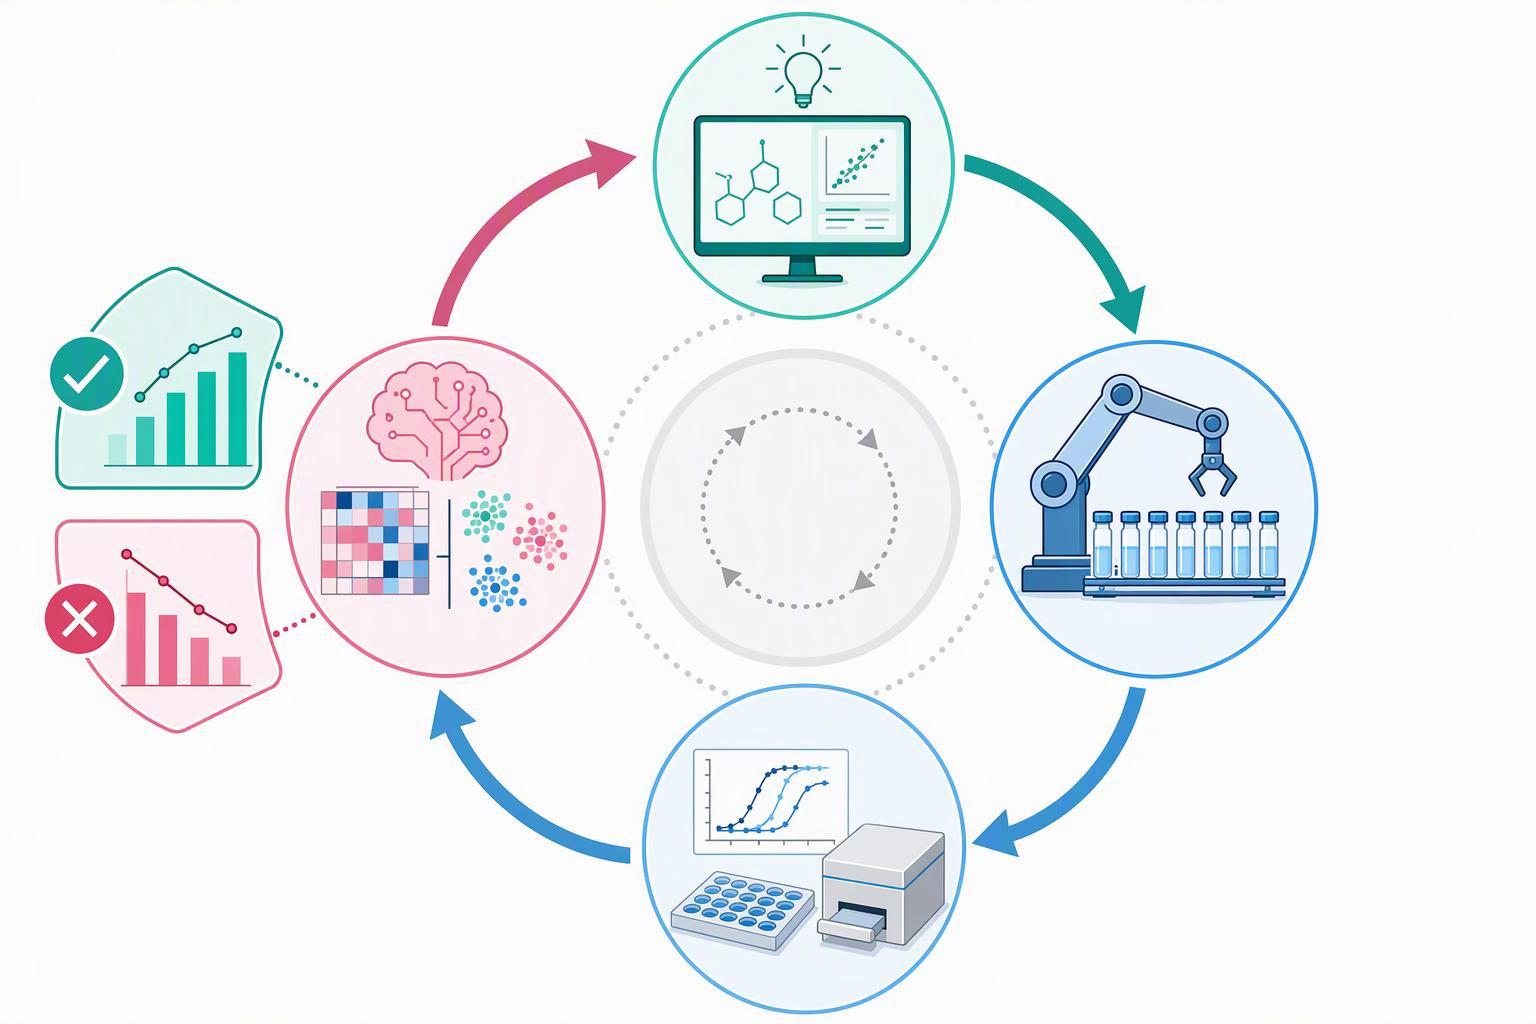
Il ciclo chiuso funziona solo se i guasti e gli aspetti negativi vengono registrati come etichette distinte anziché compressi in un unico contenitore inattivo. Il ciclo documentato è la progettazione e il prefiltro rispetto a vincoli rigidi, inclusa la fattibilità della sintesi, aggregazione, tossicità, solubilità e compatibilità dei materiali; fare e testare; selezionare i risultati allegando ciascun risultato alla sequenza esatta, costruire, lotto, protocollo di analisi, concentrazione, replicare, controlli, Stato QC e versione del modello; aggiornare i modelli; quindi riclassificare e selezionare l'utilità prevista per il bilanciamento batch successivo, incertezza, diversità, Novità e fattibilità pratica (revisione del modello di fondazione multimodale, PMC, 2026). Fabbrica di peptidi personalizzati
Le quattro categorie di etichette sono ciò che fa la differenza. Le misurazioni quantitative portano con sé un valore e un metodo. I negativi confermati portano la prova che il peptide è stato prodotto e testato e non ha funzionato. I risultati censurati contengono una misurazione che non rientra nell’intervallo del test. I guasti tecnici comportano una sintesi o un'analisi che non ha prodotto dati interpretabili. Unirli in “inattivi” insegna al modello che un accoppiamento fallito e un vero negativo sono la stessa cosa, che è l'opposto di ciò di cui ha bisogno il prossimo ciclo di progettazione.
Il throughput è il vincolo pratico sulla velocità con cui gira il circuito. Una campagna parallelizzata di 192 reazioni completata in quattro giorni, un aumento di quattro volte rispetto a un tipico approccio sequenziale, con apprendimento attivo in gruppi di otto, è il punto di riferimento concreto per l'iterazione su scala di campagna (account del laboratorio di guida autonoma, PMC, 2022). Tale resoconto afferma inoltre che il sistema non è completamente autonomo e che alcuni passaggi richiedono ancora l’intervento umano, come il caricamento di nuove fiale o sostanze chimiche, che è lo stesso avvertimento dell'uomo nel ciclo 2025 commento fa quando afferma che l’intelligenza artificiale è uno strumento per migliorare, non sostituire, intuizione scientifica (Jacobson, npj Scoperta di farmaci, 2025).
Dove stanno la regolamentazione e le prove, e ciò che rimane non dimostrato
La regolamentazione dell’intelligenza artificiale nello sviluppo farmaceutico è basata su principi ed è ancora in fase di formazione, mentre le aspettative sulla chimica dei peptidi sono già concrete. L’EMA e la FDA hanno pubblicato congiuntamente dieci principi per una buona pratica dell’IA nel ciclo di vita dei medicinali 14 Gennaio 2026, coprendo la produzione di prove e il monitoraggio dalla ricerca iniziale fino alla produzione e al monitoraggio della sicurezza, rivolto agli sviluppatori e ai richiedenti e titolari dell’autorizzazione all’immissione in commercio, e destinato a sostenere le future linee guida specifiche per giurisdizione (EMA, 2026). Lo sviluppo delle linee guida dell’UE si basa sul documento di riflessione sull’intelligenza artificiale dell’EMA pubblicato nel 2024. Gennaio della FDA 2025 la bozza di linee guida sull'IA per il processo decisionale normativo non è vincolante ed è organizzata in base al contesto d'uso, definito come il modo in cui un modello viene utilizzato per affrontare una particolare domanda, con gli sponsor che stabiliscono un modello di credibilità per quel contesto (FDA, 2025).
Leggere insieme, la linea guida sui peptidi è il modello operativo e i principi dell’intelligenza artificiale sono al di sopra di esso. La linea guida EMA sui peptidi sintetici impone già la giustificazione del materiale di partenza, segnalazione di impurità, soglie di identificazione e qualificazione, e identificazione ortogonale, e richiede che le procedure analitiche siano descritte in modo sufficientemente dettagliato da poter essere ripetute da un laboratorio ufficiale di controllo dei medicinali (EMA, 2025). Nessuna fonte collega i principi dell’IA EMA-FDA alla progettazione dell’IA specifica per il peptide, e nessuna fonte fornisce un percorso normativo o una tempistica affinché i peptidi progettati dall’intelligenza artificiale raggiungano l’approvazione.
La cartella clinica è mista e come tale va letta. DSP-1181, il primo farmaco progettato dall’intelligenza artificiale a entrare negli esseri umani, è stato interrotto nel 2022 prima della Fase II; REC-994 è stato interrotto nel 2025 dopo che i dati a lungo termine non sono riusciti a sostenere le precedenti tendenze di efficacia; rentosertib ha raggiunto la Fase IIa per la fibrosi polmonare idiopatica in 2024, con 18 mesi dalla scoperta del target alla nomina del candidato preclinico (L’intelligenza artificiale nella scoperta dei farmaci: Fallimenti clinici, Realtà normativa, PMC, 2026). IL 2025 I commenti affermano chiaramente che gli sforzi compiuti finora nel campo dell’intelligenza artificiale non hanno prodotto farmaci più efficaci, mentre il 2024 l’analisi inquadra i suoi risultati come primi segni di potenziale clinico. Ciò che rimane non dimostrato è l’efficacia, non velocità.
Domande frequenti
I peptidi progettati dall'intelligenza artificiale sono più difficili da sintetizzare rispetto a quelli naturali??
Nessuna fonte lo stabilisce. La difficoltà segue la sequenza stessa, non la sua origine: tratti soggetti ad aggregazione, residui voluminosi od ostacolati, e la lunghezza sopra approssimativamente 50 A 60 gli amminoacidi creano gli stessi problemi di accoppiamento e deprotezione indipendentemente dal fatto che la catena sia stata scritta da un modello o da un'evoluzione (Frontiere della chimica, 2020). Ciò che cambia con l’intelligenza artificiale è il throughput. I modelli propongono i candidati più velocemente di quanto un banco possa valutarli, quindi le sequenze difficili arrivano in lotti più grandi e il tasso di fallimento sembra peggiore di quello che è.
Di quale purezza ha bisogno un peptide per un test cellulare rispetto a uno studio in vivo?
Non esiste un numero unico. La linea guida EMA sui peptidi sintetici, efficace 1 Giugno 2026, chiede criteri di accettazione giustificati per l'uso specifico previsto piuttosto che una soglia fissa (EMA, 2025). Impostare il limite rispetto a ciò che il test tollera: controioni e specie troncate che spostano una lettura in vitro possono essere irrilevanti in vivo, e vale anche il contrario.
È sufficiente un certificato di analisi per rilasciare molto?
NO. Un CoA riporta ciò che ha misurato il fornitore; di per sé non conferma l'identità. Al momento della specifica e del rilascio si raccomandano almeno due metodi di identificazione ortogonali, pertanto la spettrometria di massa e un metodo cromatografico o di sequenziamento dovrebbero concordare prima che il lotto venga accettato (EMA, 2025).
Cosa dovrebbe succedere ad una sintesi fallita nel training set?
Etichettalo come un guasto tecnico, non un inattivo. Risultati quantitativi, negativi confermati, i valori censurati e le esecuzioni fallite hanno significati diversi, e la loro unione distrugge il segnale di cui ha bisogno un flusso di lavoro di progettazione di peptidi AI a circuito chiuso (revisione del modello di fondazione multimodale, 2026). Attacca ciascuna etichetta alla sequenza, costruire, lotto, protocollo, concentrazione, replicare, controlli, Stato QC e versione del modello.
L’intelligenza artificiale ha effettivamente migliorato l’efficacia clinica?
Le prove sono contestate, e la lettura successiva è negativa. I primi resoconti di scoperte accelerate non sono stati accompagnati da miglioramenti dimostrati negli endpoint clinici, quindi tratta la velocità di calcolo come un miglioramento del processo piuttosto che come una prova di risultati migliori (revisione del modello di fondazione multimodale, 2026).
Conclusione
Confronta endpoint simili: Il completamento della Fase I non equivale all'eventuale approvazione dopo l'ingresso nella Fase I. I campioni di programmi di intelligenza artificiale citati e le coorti storiche del settore differiscono nella selezione, misurare, date e seguito. Non stabiliscono un vantaggio dell’IA confrontando l’80-90% con a 7.9% probabilità di approvazione.
Ciò che colma il divario è un flusso di lavoro, non un modello. Filtra i candidati in base ai vincoli di sintesi prima di classificarli, costruire il pacchetto analitico in modo tale da purezza, identità, contenuto, la stabilità e l'idoneità al test si basano ciascuna su prove proprie, pianificare lo scale-up attorno a parametri di processo riottimizzati e tre lotti primari, e registrare i fallimenti come etichette proprie in modo che il prossimo ciclo di progettazione impari da loro. La lista di controllo dei vincoli nella sezione sintesi-fattibilità è il punto di partenza pratico, e la lista di controllo del pacchetto di dati analitici è il compagno della fase di banco. Vale la pena adottarli entrambi prima della prossima campagna, non dopo.