Qu'est-ce que l'écart en matière de traduction et ce que signifie être prêt à être testé
Fournisseur de peptides personnalisés Calcul des peptides L'écart de traduction est la distance entre un candidat classé informatiquement et un peptide qui peut être produit de manière reproductible., caractérisé et testé. Prêt pour le banc est l'état vérifiable de l'autre côté de cette distance: une séquence et un format définis, faisabilité de la synthèse démontrée, un ensemble de données analytiques qui soutiennent chaque affirmation, conditions de manipulation indiquées, et un test pour lequel le matériau est réellement adapté.
La couche clinique montre pourquoi l’écart est important sur le plan commercial. La référence de l’industrie pour 2011-2020 était une 7.9% probabilité d'approbation de la phase I à travers 12,728 transitions de phases (BIO / Informa Pharma Intelligence / Conseillers QLS, 2021). La première analyse des pipelines d'IA natifs a révélé un succès de 80 à 90 % pour la phase I, mais seulement environ 40% en Phase II, un chiffre que les auteurs décrivent comme reposant sur une taille d’échantillon limitée (Jayatunga et coll., La découverte de médicaments aujourd'hui, 2024). UN 2025 un commentaire basé directement sur ces chiffres indique que la sécurité et la tolérabilité sont meilleures que celles des molécules développées traditionnellement., 90% contre sous 65%, tandis que le succès de la validation de principe de la phase II se situe à 40%, en ligne avec les moyennes historiques du secteur, et ajoute qu'il n'y a pas encore suffisamment de cas pour alimenter les analyses statistiques (Jacobson, Découverte de médicaments npj, 2025).
Deux limites sur la preuve appartiennent au même paragraphe que les chiffres. Aucune source évaluée par des pairs ne quantifie la part des peptides conçus par l’IA qui échouent à la synthèse, et aucune source ne définit « AI-découvert » de manière opérationnelle, si cela signifie que l'IA est utilisée pour l'identification des cibles, conception de molécules, ou les deux. Combler l’écart de traduction dans la conception de peptides d’IA ne peut donc pas être mesuré par rapport à un taux d’échec publié. Il doit être géré comme une séquence de décisions techniques, c'est ce que présentent les sections restantes.
Comment les modèles d’IA peptidique sont formés et de quelles données ils ont besoin
Les modèles peptidiques apprennent à partir d’une représentation séquentielle, un corpus de pré-formation, un ensemble de réglage fin avec des positifs et des négatifs étiquetés, et une répartition d'évaluation, et la qualité des deux derniers détermine si les performances rapportées signifient quelque chose. L’ensemble de formation d’AMPGen est un cas concret utile: 10,249 séquences peptidiques antimicrobiennes uniques compilées à partir de six bases de données publiques, dont 9,854 porter des cibles antibactériennes, réduit à 9,964 positifs après filtration sur 5 à 65 acides aminés, jumelé avec 11,989 séquences non-AMP tirées d'UniProt comme négatifs (AMPGen, Biologie des communications, 2025). Le générateur lui-même a été pré-entraîné sur les données OpenFold couvrant 401,381 plusieurs alignements de séquences pendant environ 132,000 séquences PDB uniques.
Cet ensemble négatif est la partie dans laquelle la plupart des projets sous-investissent. Filtrage d'UniProt pour les séquences de 5 à 65 résidus tout en excluant 17 des mots-clés tels que antimicrobien, antibiotique, l'antibactérien et la toxine produisent des négatifs qui ne sont pas AMP par annotation, pas de négatifs qui ont été mesurés et trouvés inactifs. Il n'existe aucun chiffre public stable concernant la part des enregistrements inactifs dans les bases de données sur l'activité peptidique., c'est pourquoi la composition d'un ensemble spécifique, pas une affirmation générale sur l'équilibre de la base de données, est la façon honnête de décrire cela.
L'évaluation est le deuxième point faible. Une vérification de 51 configurations de référence couvrant Polaris, PMH, MoleculeNet et DTI ont découvert une contamination croisée dans la grande majorité des ensembles de données, avec une similitude moyenne ECFP Tanimoto du voisin le plus proche entre les composés de test et d'entraînement de 0.494, 0.559, 0.589 et 0.779 respectivement (audit de référence, PMC, 2026). Conflits d'étiquettes sous injectés, l'ASC ROC moyenne a chuté 0.317. Un modèle peptidique évalué sur une division qui partage des séquences quasi-dupliquées avec l'entraînement rapporte un nombre qui ne survivra pas à la synthèse.
Pourquoi les peptides prometteurs sur le plan informatique échouent lors de la synthèse et du test
Les peptides échouent au banc pour des raisons chimiques qu'un modèle d'activité au niveau séquence ne voit pas. Des séquences difficiles, définis comme ceux qui forment des relations fortes- ou des interactions intramoléculaires non covalentes qui produisent des agrégats insolubles et bloquent la déprotection et le couplage complets, restent un défi au-dessus de 50 à 60 acides aminés, même avec une synthèse automatisée, et des séquences plus longues que 50 les résidus nécessitent souvent une condensation de fragments ou une ligature chimique native (Frontières de la chimie, 2020).
L'étude citée sur deux peptides a modifié les conditions du procédé à mesure que l'échelle augmentait. Ses rendements décrivent ces itinéraires et expériences, pas de plage de planification pour chaque séquence. Comparez une proposition de mise à l’échelle grâce à des processus et des données analytiques correspondants.
L'article AMPGen cité rend compte de la synthèse et des tests antibactériens des candidats sélectionnés ainsi que du criblage informatique.. Gardez les résultats mesurés distincts des prédictions et conservez l’organisme concerné, dénominateur de test et de sélection de candidats; les résultats n'établissent pas d'efficacité clinique ni de taux de réussite pour toutes les séquences générées.
Comment filtrer les candidats IA par rapport aux contraintes de synthèse réelles
Filtrer les candidats par rapport aux contraintes de synthèse avant de les classer par activité, pas après une campagne ratée. La séquence pratique se déroule: résidus admissibles et compatibilité des groupes protecteurs, puis notation hydrophobe et risque d'agrégation, puis faisabilité du multi-disulfure et de la cyclisation, puis compatibilité des modifications de terminal et de side-chain, puis la longueur plafond. Chaque porte est un oui ou un non sur une séquence spécifique, et un candidat qui échoue à une porte doit être repensé plutôt que reporté avec une note.
La prédiction de structure prend en charge les portes du milieu plutôt que de les remplacer. AlphaFold 3 prédit la structure conjointe de complexes comprenant des protéines, acides nucléiques, petites molécules, ions et résidus modifiés de séquences polymères, modifications de résidus et ligand SMILES, et rapporte une précision beaucoup plus élevée pour les interactions protéine-ligand que les outils d'accueil tels que Vina (P = 2.27 × 10⁻¹³) et pour les complexes anticorps-antigène que AlphaFold-Multimer v2.3 (P = 6.5 × 10⁻⁵) (Abramson et al., Nature, 2024). Ce sont des valeurs significatives, pas une amélioration globale en pourcentage, et ils ne disent rien sur la possibilité d'assembler le peptide sur de la résine.
La longueur de la séquence est un facteur de risque, pas un plafond de synthèse universel. Courses hydrophobes, les modifications et la topologie devraient déclencher une évaluation de faisabilité; quatre résidus hydrophobes consécutifs ne nécessitent pas automatiquement une nouvelle conception ou une ligature des fragments. Choisissez un itinéraire à l'aide d'expériences spécifiques à une construction.
|
Grille |
Ce qu'il filtre |
Réponse à l'échec |
|---|---|---|
|
Résidu et groupe protecteur Peptides amplifiés compatibilité |
Si les résidus requis et la chimie coexistent |
Remplacer le résidu ou changer de stratégie |
|
Risque de ruissellement hydrophobe et d’agrégation |
Étirements hydrophobes consécutifs, Propension à la feuille β |
Refonte ou plan de condensation de fragments |
|
Faisabilité du disulfure et de la cyclisation |
Régiochimie multi-disulfure, Fabricant d'informations sur les peptides fermeture tête-bêche ou lactame |
Ajuster la chimie de cyclisation ou supprimer Peptides d'hormone de croissance |
|
Compatibilité des modifications |
Terminal, chaîne latérale, étiquette, ajouts de lieurs et de lipides |
Re-séquencer le site de modification |
|
Longueur plafond |
Limite pratique pour les séquences modifiées complexes |
Diviser en fragments ou ligaturer |
Quel ensemble de données analytiques rend un peptide défendable sur le banc
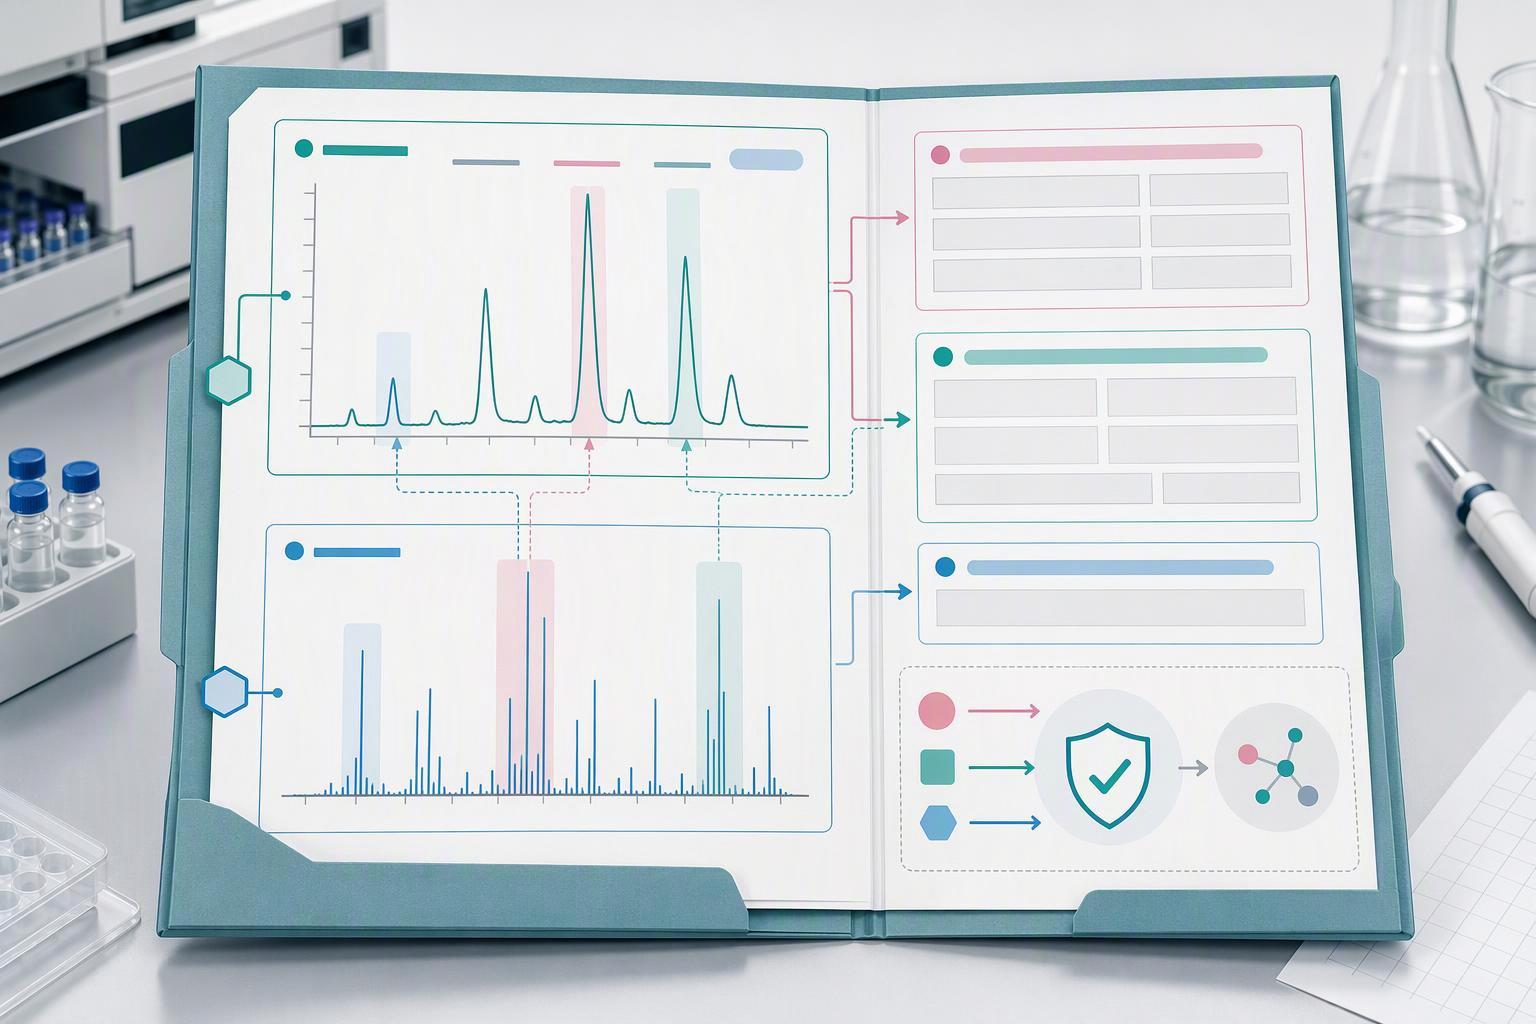
Un emballage défendable sépare la pureté, identité, contenu, la stabilité et la pertinence du test dans des allégations distinctes, chacun avec sa propre méthode et ses propres preuves. La ligne directrice de l'EMA sur le développement et la fabrication de peptides synthétiques, adopté 4 Décembre 2025 et efficace 1 Juin 2026, considère la pureté comme l’un des attributs de qualité critiques les plus importants pour les peptides synthétiques, exige que les critères d'acceptation des fractions individuelles et du pool principal soient énoncés et justifiés, et appelle à une caractérisation orthogonale de la pureté en fonction de la taille, séparation basée sur la charge et basée sur l'hydrophobie (EMA, 2025).
L'identité n'est pas la pureté, et les directives le disent à différents endroits. L'ICH Q6B considère que la pureté absolue et relative est difficile à déterminer et dépend fortement de la méthode utilisée., la pureté est donc évaluée par une combinaison de procédures analytiques, tandis que les tests d'identité doivent être très spécifiques à la molécule et peuvent nécessiter plusieurs tests physico-chimiques., test biologique ou immunochimique (Je Q6B, 1999). La directive de l'EMA recommande au moins deux méthodes d'identification orthogonales lors de la spécification et de la sortie., tiré de la masse, temps de rétention relatif, LC-MS, cartographie peptidique, bioactivité, analyse des acides aminés ou RMN, et divise les impuretés en catégories liées aux peptides et non peptidiques (EMA, 2025).
Utiliser la version finale de l'ICH Q2(R2) cadre pour la validation analytique applicable et justifier la conception de l’étude pour la décision envisagée. Conditions de stockage, le nombre et la durée des lots doivent être sélectionnés en fonction du produit et de l'étape de développement plutôt que hérités en tant qu'exigence universelle en matière de matériel de dépistage.
Comment passer du criblage en mg à la production en kg sans perdre la cohérence d'un lot à l'autre
La mise à l’échelle change le processus, donc la pureté et le rendement que vous avez validés à l'échelle du criblage ne sont pas les chiffres que vous devriez promettre à l'échelle de la production. Les données de Guzmán montrent l’ampleur de ce changement: le même peptide est passé de 8.0% rendement et 23.9% pureté brute à 10-20 mg pour 53.5% rendement et 64.4% pureté brute à 3–4 g, et le deuxième peptide de 36% et 62.1% à 78.5% et 98.7% (Guzman et al., Journal électronique de biotechnologie, 2023). Parce que le protocole et les conditions ont changé avec l'échelle de cette étude, la lecture honnête est que la mise à l'échelle nécessite une ré-optimisation, non pas qu'une pénalité forfaitaire s'applique.
La cohérence d'un lot à l'autre est contrôlée par la spécification, pas à travers le chiffre de rendement. La directive de l'EMA prévoit que les paramètres de processus pour les opérations d'isolement soient décrits, nécessite des mesures pour éviter la contamination croisée lorsque différents peptides sont purifiés sur la même colonne, et nécessite une évaluation du devenir et de la purge des impuretés du matériau de départ qui peuvent se retrouver jusqu'au peptide final (EMA, 2025). Suppression et séquences tronquées, formé par couplage incomplet ou déprotection et coiffé par acétylation, sont la classe d'impuretés qui reflète le plus directement le contrôle du processus, et la ligne directrice s'attend à ce que leur formation soit empêchée par des couplages répétés et un bouchage systématique plutôt que corrigée en aval..
Les études de stabilité devraient étayer le stockage réel, période de traitement, utilisation prévue et stade de développement. Les recommandations d'enregistrement de l'ICH pour les lots primaires et la durée de soumission ne constituent pas une période d'attente universelle de douze mois pour les peptides de recherche. Définir un protocole et des critères d'acceptation adaptés à la phase.
Comment fonctionne la boucle fermée lorsque les résultats et les échecs des tests sont réintégrés dans le modèle
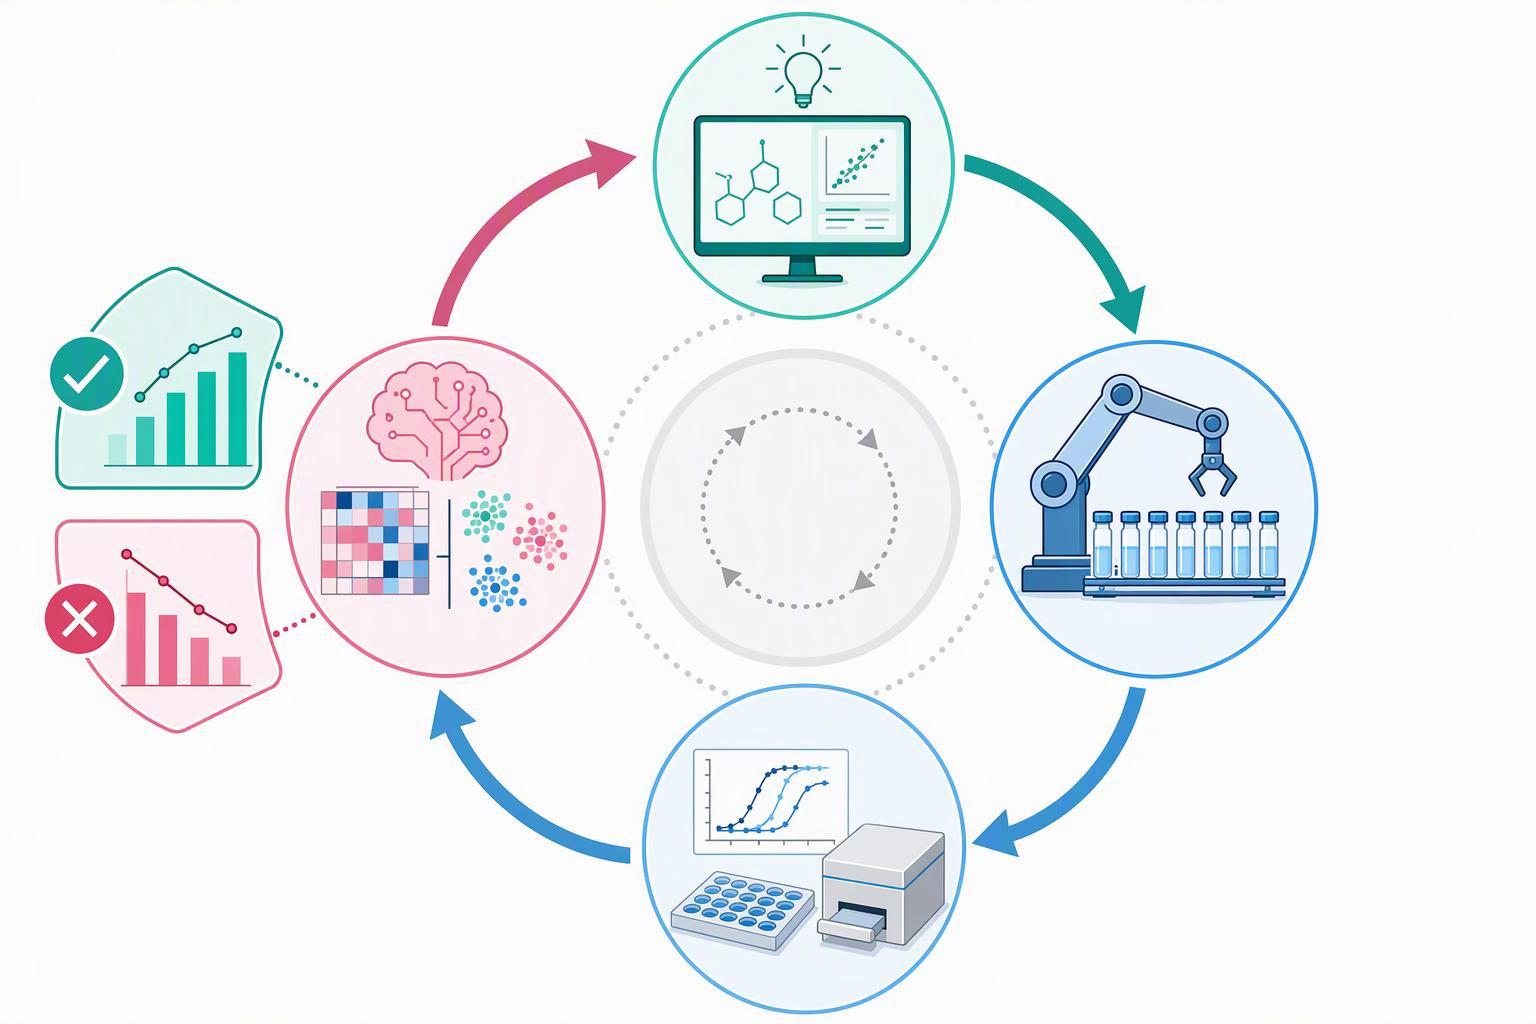
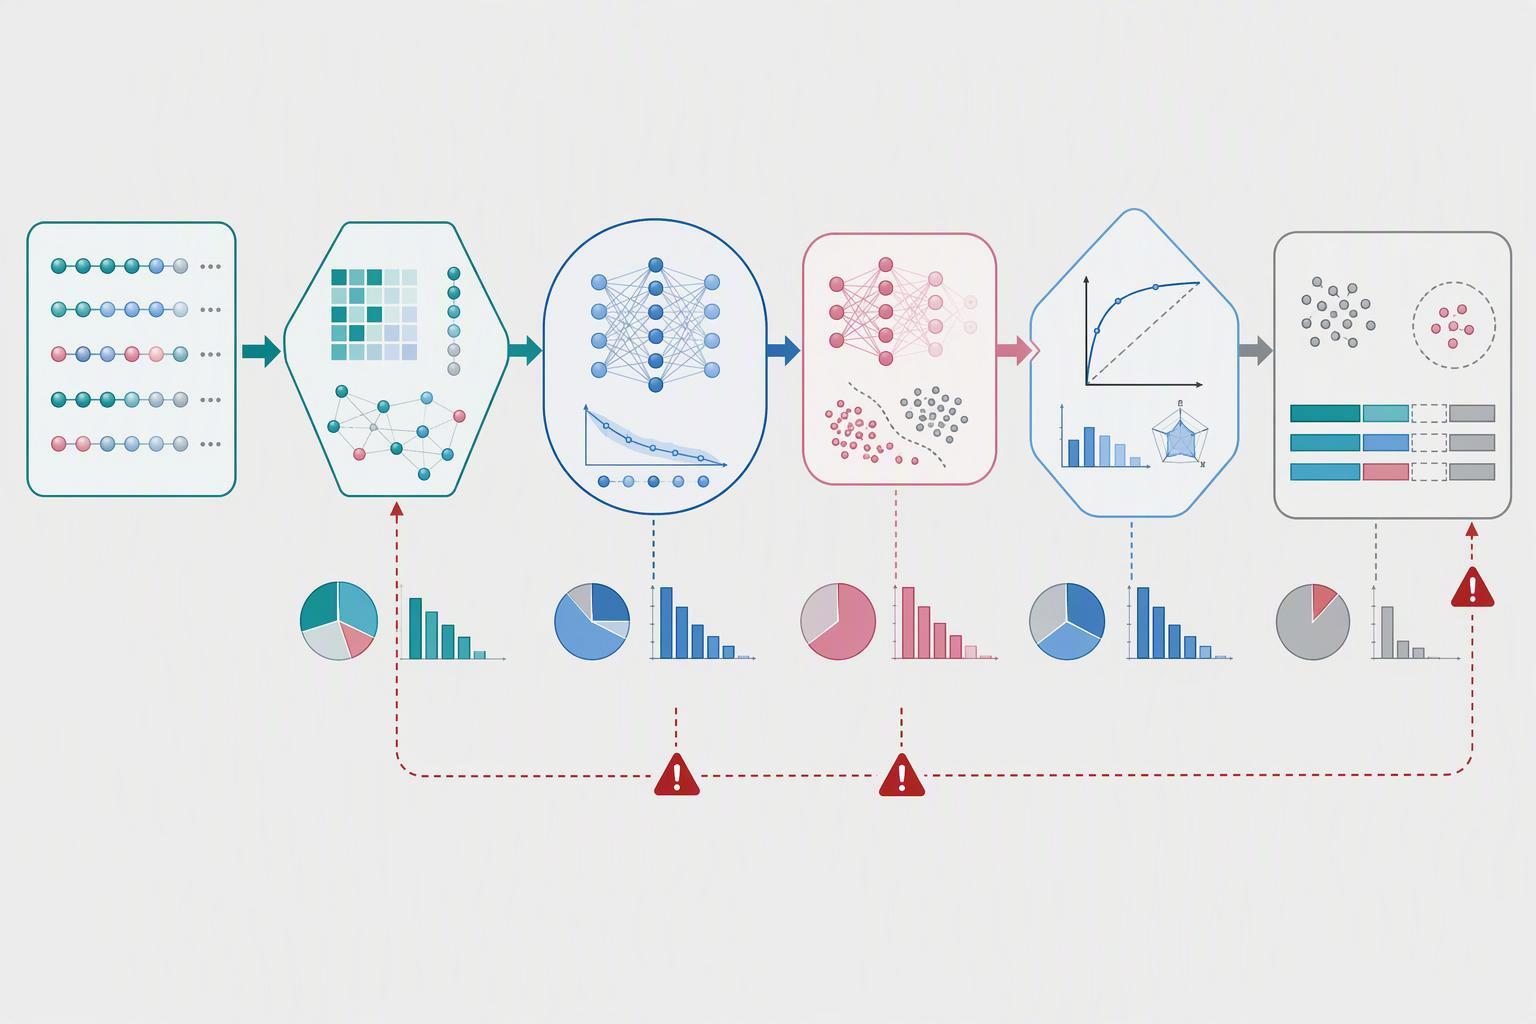
La boucle fermée ne fonctionne que si les échecs et les négatifs sont enregistrés sous des étiquettes distinctes plutôt que regroupés dans un seul compartiment inactif.. Le cycle documenté est la conception et le préfiltrage contre des contraintes strictes, y compris la faisabilité de la synthèse., agrégation, toxicité, solubilité et compatibilité des matériaux; faire et tester; organiser les résultats en attachant chaque résultat à la séquence exacte, construction, lot, protocole de test, concentration, reproduire, contrôles, Statut QC et version du modèle; mettre à jour les modèles; puis reclassez et sélectionnez le prochain utilitaire prévu d'équilibrage de lots, incertitude, diversité, nouveauté et faisabilité pratique (examen du modèle de fondation multimodale, PMC, 2026). Usine de peptides personnalisés
Les quatre catégories de labels font la différence. Les mesures quantitatives portent une valeur et une méthode. Les résultats négatifs confirmés portent la preuve que le peptide a été fabriqué et testé et n'a pas fonctionné.. Les résultats censurés comportent une mesure qui se situe en dehors de la plage du test. Les échecs techniques entraînent une synthèse ou un test qui n'a pas produit de données interprétables. Les fusionner en « inactifs » enseigne au modèle qu’un couplage raté et un véritable négatif sont la même chose., ce qui est le contraire de ce dont le prochain cycle de conception a besoin.
Le débit est la contrainte pratique sur la vitesse à laquelle la boucle tourne. Une campagne parallélisée de 192 réactions réalisée en quatre jours, une multiplication par quatre par rapport à une approche séquentielle typique, avec apprentissage actif par lots de huit, est la référence concrète pour l'itération à l'échelle d'une campagne (compte de laboratoire autonome, PMC, 2022). Ce compte indique également que le système n'est pas totalement autonome et que certaines étapes nécessitent encore une intervention humaine, comme le chargement de nouveaux flacons ou produits chimiques., qui est la même mise en garde humaine dans la boucle 2025 commentaire fait lorsqu'il dit que l'IA est un outil pour améliorer, ne pas remplacer, intuition scientifique (Jacobson, Découverte de médicaments npj, 2025).
Où en sont la réglementation et les preuves, et ce qui reste à prouver
La réglementation de l’IA dans le développement de médicaments est fondée sur des principes et est toujours en cours d’élaboration, alors que les attentes en matière de chimie peptidique sont déjà concrètes. L'EMA et la FDA ont publié conjointement dix principes de bonnes pratiques en matière d'IA dans le cycle de vie des médicaments. 14 Janvier 2026, couvrant la génération et la surveillance des preuves depuis les premières recherches jusqu'à la fabrication et la surveillance de la sécurité, adressée aux développeurs et aux demandeurs et titulaires d’autorisations de mise sur le marché, et destiné à étayer les futures orientations spécifiques aux juridictions (EMA, 2026). L’élaboration des lignes directrices de l’UE s’appuie sur le document de réflexion de l’EMA sur l’IA publié dans 2024. Le mois de janvier de la FDA 2025 le projet de lignes directrices sur l’IA pour la prise de décision réglementaire est non contraignant et organisé en fonction du contexte d’utilisation, défini comme la manière dont un modèle est utilisé pour répondre à une question particulière, avec des sponsors établissant la crédibilité du modèle pour ce contexte (FDA, 2025).
Lire ensemble, la directive sur les peptides est le modèle opérationnel et les principes de l'IA se trouvent au-dessus. La directive EMA sur les peptides synthétiques impose déjà une justification du matériau de départ, rapport d'impuretés, seuils d’identification et de qualification, et identification orthogonale, et exige que les procédures analytiques soient décrites de manière suffisamment détaillée pour être répétées par un laboratoire officiel de contrôle des médicaments. (EMA, 2025). Aucune source ne relie les principes de l'IA de l'EMA et de la FDA à la conception de l'IA spécifique aux peptides, et aucune source ne donne de voie réglementaire ni de calendrier pour que les peptides conçus par l'IA soient approuvés..
Le dossier clinique est mitigé et doit être lu comme tel. DSP-1181, le premier médicament conçu par l'IA à pénétrer chez l'homme, a été interrompu en 2022 avant la phase II; REC-994 a été interrompu en 2025 après que les données à plus long terme n'ont pas réussi à maintenir les tendances d'efficacité antérieures; le rentosertib a atteint la phase IIa dans la fibrose pulmonaire idiopathique 2024, avec 18 mois entre la découverte de la cible et la nomination du candidat préclinique (L'IA dans la découverte de médicaments: Échecs cliniques, Réalité réglementaire, PMC, 2026). Le 2025 le commentaire indique clairement que les efforts déployés jusqu’à présent en matière d’IA n’ont pas abouti à des médicaments plus efficaces., tandis que le 2024 l’analyse considère ses résultats comme les premiers signes d’un potentiel clinique. Ce qui reste à prouver, c'est l'efficacité, pas de vitesse.
Foire aux questions
Les peptides conçus par l’IA sont-ils plus difficiles à synthétiser que les peptides naturels?
Aucune source n'établit que. La difficulté suit la séquence elle-même, pas son origine: tronçons sujets à l'agrégation, résidus volumineux ou encombrés, et longueur au dessus à peu près 50 à 60 les acides aminés créent les mêmes problèmes de couplage et de déprotection qu'un modèle ou une évolution ait écrit la chaîne (Frontières de la chimie, 2020). Ce qui change avec l'IA, c'est le débit. Les modèles proposent des candidats plus rapidement qu'un banc ne peut les trier, donc les séquences difficiles arrivent en lots plus importants et le taux d'échec semble pire qu'il ne l'est.
De quelle pureté un peptide a-t-il besoin pour un test cellulaire par rapport à une étude in vivo?
Il n'y a pas de numéro unique. La directive de l'EMA sur les peptides synthétiques, efficace 1 Juin 2026, demande des critères d'acceptation justifiés pour l'utilisation spécifique prévue plutôt qu'un seuil fixe (EMA, 2025). Définir la limite de ce que le test tolère: Les contre-ions et les espèces tronquées qui modifient une lecture in vitro peuvent ne pas être pertinents in vivo, et l'inverse est également vrai.
Un certificat d'analyse est-il suffisant pour libérer beaucoup?
Non. Un CoA rapporte ce que le fournisseur a mesuré; il ne confirme pas en soi l'identité. Au moins deux méthodes d'identification orthogonales sont recommandées lors de la spécification et de la sortie., la spectrométrie de masse et une méthode chromatographique ou de séquençage doivent donc convenir avant que le lot ne soit accepté (EMA, 2025).
Que devrait-il arriver en cas d'échec d'une synthèse dans l'ensemble de formation ??
Étiquetez-le comme une défaillance technique, pas un inactif. Résultats quantitatifs, négatifs confirmés, les valeurs censurées et les échecs d'exécution ont des significations différentes, et leur fusion détruit le signal dont un flux de travail de conception de peptides d'IA en boucle fermée a besoin (examen du modèle de fondation multimodale, 2026). Attachez chaque étiquette à la séquence, construction, lot, protocole, concentration, reproduire, contrôles, Statut QC et version du modèle.
L’IA a-t-elle réellement amélioré l’efficacité clinique?
La preuve est contestée, et la lecture ultérieure est négative. Les premiers rapports faisant état d'une découverte accélérée n'ont pas été accompagnés de gains démontrés en termes de paramètres cliniques., traitez donc la vitesse de calcul comme une amélioration du processus plutôt que comme une preuve de meilleurs résultats (examen du modèle de fondation multimodale, 2026).
Conclusion
Comparez les points de terminaison comparables: L'achèvement de la phase I n'est pas la même chose que l'approbation éventuelle après le début de la phase I.. Les échantillons de programmes d’IA cités et les cohortes industrielles historiques diffèrent dans leur sélection, taille, dates et suivi. Ils n’établissent pas un avantage de l’IA en comparant 80 à 90 % avec un 7.9% probabilité d'approbation.
Ce qui comble l'écart, c'est un flux de travail, pas un modèle. Filtrer les candidats par rapport aux contraintes de synthèse avant de les classer, construire le package analytique de manière à garantir la pureté, identité, contenu, la stabilité et l'adéquation du test reposent chacune sur leurs propres preuves, planifier la mise à l'échelle autour de paramètres de processus réoptimisés et de trois lots principaux, et enregistrer les échecs sous leur propre label afin que le prochain cycle de conception en tire des leçons. La liste de contrôle des contraintes dans la section synthèse-faisabilité est le point de départ pratique, et la liste de contrôle du paquet de données analytiques est le compagnon de l'étape de référence. Les deux méritent d’être adoptés avant la prochaine campagne, pas après.