トランスレーションギャップとは何か、そしてベンチレディが何を意味するか
カスタムペプチドサプライヤー ペプチド計算 翻訳ギャップは、計算によってランク付けされた候補と、再現可能に作成できるペプチドとの間の距離です。, 特徴付けられ、テストされた. ベンチレディとは、その距離の向こう側でチェック可能な状態です: 定義されたシーケンスとフォーマット, 合成の実現可能性を実証した, 各主張を裏付ける分析データパッケージ, 記載された取り扱い条件, そしてその材料が実際に適したアッセイ.
臨床層は、ギャップが商業的に重要である理由を示しています. 2011 年から 2020 年の業界ベースラインは 7.9% 第I相からの承認の可能性 12,728 相転移 (バイオ / インフォマ ファーマ インテリジェンス / QLSアドバイザー, 2021). AI ネイティブ パイプラインの最初の分析では、フェーズ I の成功率は 80 ~ 90% でしたが、成功したのは約 20% でした。 40% フェーズII中, 著者らが説明する、限られたサンプルサイズに基づいた数字 (ジャヤトゥンガら。, 今日の創薬, 2024). あ 2025 これらの数値に直接基づいて構築された解説では、安全性と忍容性が伝統的に開発された分子よりも優れている傾向にあると述べられています。, 90% 対以下 65%, 一方、フェーズ II の概念実証の成功は次の段階にあります。 40%, 過去の業界平均と一致, そして、統計分析を強化するのに十分な症例がまだないと付け加えた (ジェイコブソン, npj創薬, 2025).
証拠に対する 2 つの制限が数値と同じ段落に属します. 合成に失敗した AI 設計ペプチドの割合を定量化する査読済みの情報源はない, 「AI が発見した」を運用上定義する情報源はない, それはターゲット識別にAIが使用されていることを意味するかどうか, 分子設計, または両方. したがって、AI ペプチド設計における翻訳ギャップを埋めることは、公表されている失敗率に基づいて測定することはできません。. 一連のエンジニアリング上の決定として管理する必要がある, これは残りのセクションで説明することです.
ペプチド AI モデルのトレーニング方法と必要なデータ
ペプチドモデルは配列表現から学習します, トレーニング前コーパス, プラスとマイナスのラベルが付いた微調整セット, そして評価分割, そして最後の 2 つの品質によって、報告されたパフォーマンスに意味があるかどうかが決まります。. AMPGen のトレーニング セットは有用な具体例です: 10,249 6 つの公的データベースから編集された独自の抗菌ペプチド配列, うち 9,854 抗菌ターゲットを運ぶ, に縮小される 9,964 5 ~ 65 個のアミノ酸にフィルタリングした後の陽性, とペアになった 11,989 UniProt からネガティブとして抽出された非 AMP シーケンス (AMPGen, コミュニケーション生物学, 2025). ジェネレーター自体は、OpenFold データを対象として事前にトレーニングされています。 401,381 おおよその複数の配列アラインメント 132,000 ユニークな PDB シーケンス.
このマイナスセットは、ほとんどのプロジェクトで投資が不足している部分です. 5 ~ 65 残基の配列を除外しながら UniProt をフィルタリングする 17 抗菌などのキーワード, 抗生物質, 抗菌性と毒素により、アノテーションにより非 AMP となるネガが生成されます。, 測定されて不活性であることが判明した陰性物質ではない. ペプチド活性データベースにおける非アクティブな記録のシェアについて安定した公的数値は存在しない, そのため、特定のセットの構成は, データベースのバランスに関する一般的な主張ではありません, これを正直に説明する方法は.
評価が第二の弱点. の監査 51 Polaris にわたるベンチマーク構成, TDC, MoleculeNet と DTI は、大部分のデータセットでクロススプリット汚染を発見しました, のテスト化合物とトレーニング化合物の間の平均最近傍 ECFP 谷本類似度を使用 0.494, 0.559, 0.589 そして 0.779 それぞれ (ベンチマーク監査, PMC, 2026). 挿入されたラベルの競合の下で, ROC AUC の平均値が低下しました 0.317. トレーニングとほぼ重複した配列を共有する分割で評価されたペプチド モデルが、合成では生き残れない数値を報告しています.
なぜ計算上有望なペプチドが合成やアッセイで失敗するのか
配列レベルの活性モデルでは認識できない化学的な理由により、ペプチドはベンチで失敗する. 難しいシーケンス, 強力な相互作用を形成するものとして定義される- または不溶性凝集体を生成し、完全な脱保護とカップリングをブロックする分子内非共有結合相互作用, 自動合成を使用しても、50 ~ 60 アミノ酸を超えると依然として課題が残る, より長いシーケンス 50 多くの場合、残基はフラグメントの縮合またはネイティブの化学ライゲーションを必要とします。 (化学のフロンティア, 2020).
引用された 2 つのペプチドの研究では、規模が拡大するにつれてプロセス条件が変化しました. その収量はそれらのルートと実験を説明します, すべてのシーケンスの計画範囲ではない. 一致したプロセスと分析データを通じて提案されたスケールアップを比較する.
引用された AMPGen の論文では、選択された候補の合成と抗菌テスト、およびコンピューターによるスクリーニングが報告されています。. 測定結果を予測と区別し、関連する微生物を保持します, アッセイと候補者選択の分母; この結果は、生成されたすべての配列の臨床有効性または成功率を確立するものではありません。.
実際の合成制約に対して AI 候補をフィルタリングする方法
アクティビティに関して候補をランク付けする前に、合成制約に対して候補をフィルタリングします, 失敗したキャンペーンの後ではない. 実際のシーケンスが実行されます: 許容残基と保護基の適合性, その後、疎水性ランと凝集リスクのスコアリング, 次にマルチジスルフィドと環化の実現可能性, 次に、ターミナルとサイドチェーンの変更の互換性, 次に天井の長さ. 各ゲートは特定のシーケンスに対する「はい」または「いいえ」です。, そして、いずれかのゲートに不合格となった候補者は、メモを付けて進められるのではなく、再設計されるべきです。.
構造予測は中間ゲートを置き換えるのではなく、中間ゲートをサポートします。. アルファフォールド 3 タンパク質を含む複合体の結合構造を予測します, 核酸, 小さな分子, ポリマー配列からのイオンと修飾残基, 残基修飾とリガンド SMILES, また、Vina などのドッキング ツールよりもタンパク質とリガンドの相互作用の精度が大幅に高いことが報告されています。 (P = 2.27 × 10⁻¹³) 抗体抗原複合体については AlphaFold-Multimer v2.3 よりも優れています (P = 6.5 × 10⁻⁵) (アブラムソンら。, 自然, 2024). これらは重要な値です, 見出しの割合の改善ではない, そしてペプチドが樹脂上で組み立てられるかどうかについては何も述べていない.
配列の長さは危険因子です, ユニバーサル合成の上限ではない. 疎水性ラン, 変更とトポロジーは実現可能性評価のきっかけとなるはずです; 4 つの連続する疎水性残基は、自動的に再設計やフラグメントのライゲーションを必要としません。. 構造固有の実験を使用してルートを選択する.
|
ゲート |
何を映すのか |
障害対応 |
|---|---|---|
|
残基と保護基 増幅されたペプチド 互換性 |
必要な残基と化学的性質が共存するかどうか |
残基を置換するか戦略を変更する |
|
疎水性ランと凝集のリスク |
連続した疎水性ストレッチ, βシート傾向 |
フラグメントの凝縮を再設計または計画する |
|
ジスルフィドおよび環化の実現可能性 |
マルチジスルフィドの位置化学, ペプチド情報メーカー 頭から尾までの閉鎖またはラクタム閉鎖 |
環化反応の調整またはドロップ 成長ホルモンペプチド |
|
改造互換性 |
ターミナル, サイドチェーン, ラベル, リンカーと脂質の追加 |
変更部位を再配列する |
|
天井の長さ |
複雑な修飾シーケンスの実際的な制限 |
断片に分割するか連結する |
ペプチドをベンチで防御できるようにする分析データパッケージとは
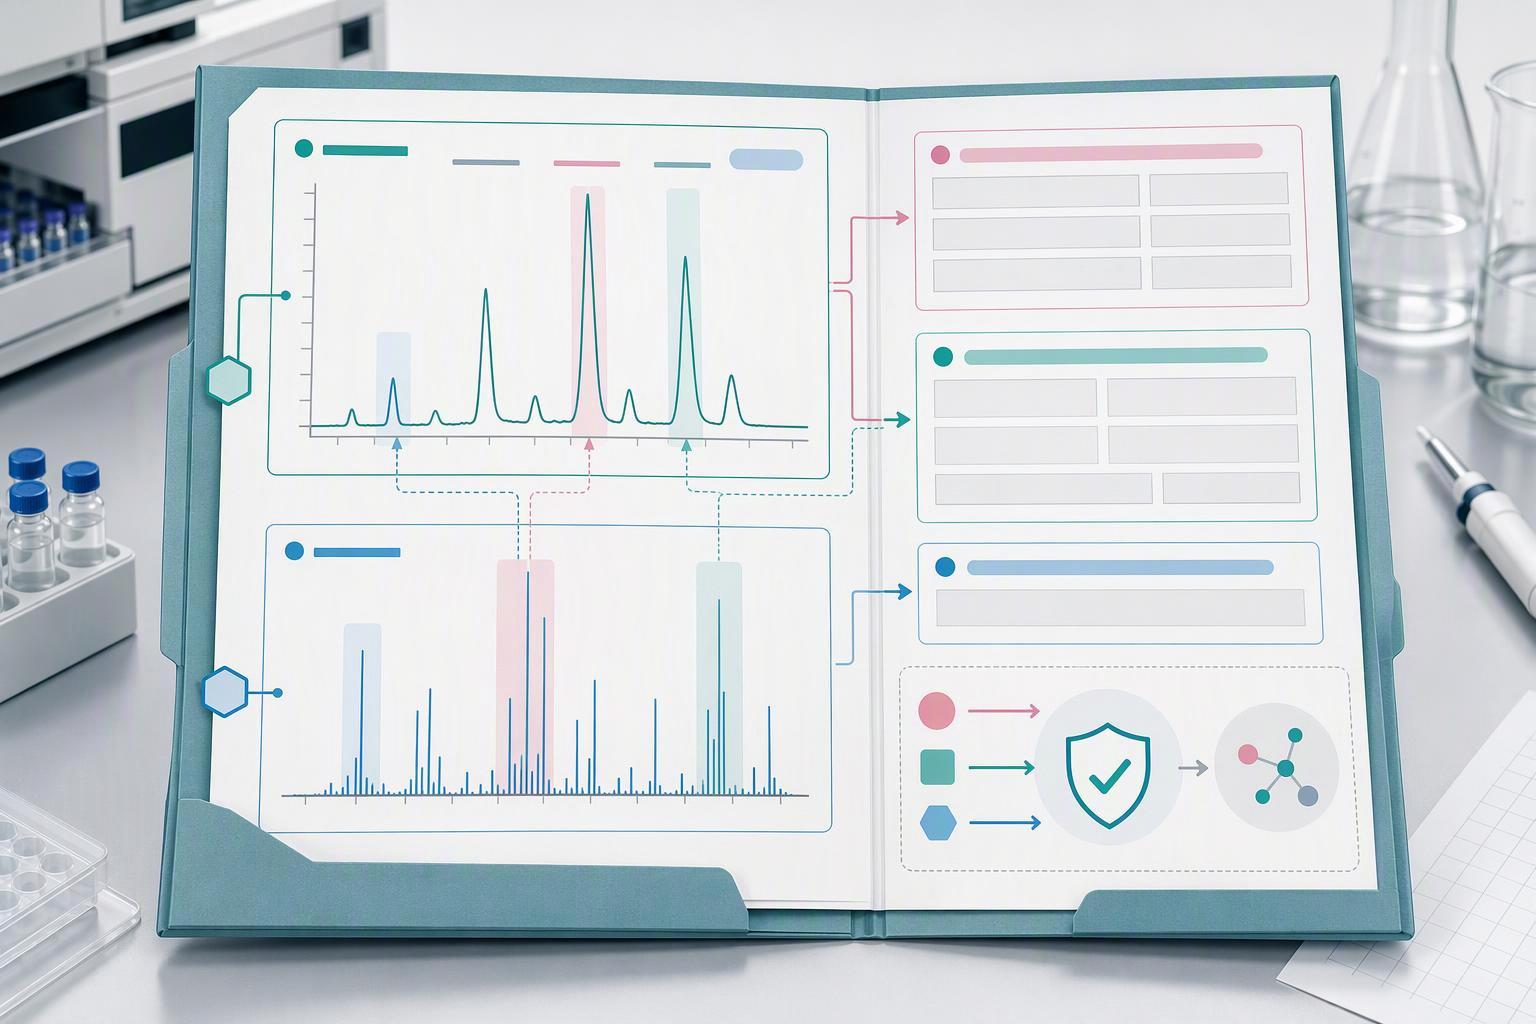
防御可能なパッケージが純度を分ける, 身元, コンテンツ, 安定性とアッセイ適合性を個別のクレームに組み込む, それぞれが独自の方法と独自の証拠を持っています. 合成ペプチドの開発および製造に関するEMAガイドライン, 採用された 4 12月 2025 そして効果的な 1 6月 2026, 合成ペプチドの最も重要な重要な品質特性の 1 つとして純度を扱います, 個々の部分とメインプールの受け入れ基準を明示し、正当化する必要がある, サイズベースにわたる直交純度特性評価が必要です, 電荷ベースと疎水性に基づいた分離 (EMA, 2025).
アイデンティティは純粋さではない, ガイドラインにはさまざまな場所でそのように記載されています. ICH Q6B では、絶対純度と相対純度を決定するのは難しく、方法に大きく依存するとしています。, したがって、純度は分析手順の組み合わせによって評価されます。, 一方、同一性検査は分子に非常に特異的である必要があり、複数の物理化学的検査が必要になる場合があります。, 生物学的または免疫化学的検査 (I Q6B, 1999). EMA ガイドラインでは、仕様およびリリース時に少なくとも 2 つの直交識別方法を推奨しています。, 塊から引き出された, 相対保持時間, LC-MS, ペプチドマッピング, 生物活性, アミノ酸分析またはNMR, 不純物をペプチド関連と非ペプチドのカテゴリーに分類します (EMA, 2025).
最終的な ICH Q2 を使用する(R2) 適用可能な分析的検証のためのフレームワークを作成し、意図した決定に向けた研究デザインを正当化する. 保管条件, バッチ数と期間は、普遍的なスクリーニング材料要件として継承されるのではなく、製品と開発段階に応じて選択される必要があります。.
ロット間の一貫性を失わずに mg スクリーニングから kg 生産までスケールする方法
スケールアップはプロセスを変える, したがって、スクリーニング規模で検証した純度と収率は、生産規模で約束すべき数値ではありません. グスマンのデータはその変化の大きさを示している: 同じペプチドがから移動しました 8.0% 収量と 23.9% 粗純度 10 ~ 20 mg 53.5% 収量と 64.4% 粗純度 3 ~ 4 g, そして2番目のペプチドは 36% そして 62.1% に 78.5% そして 98.7% (グスマンら。, バイオテクノロジー電子ジャーナル, 2023). その研究では規模に応じてプロトコールと条件が変化したため、, 正直なところ、スケールアップには再最適化が必要であるということです。, 固定ペナルティが適用されるわけではない.
ロット間の一貫性は仕様によって制御されます, 収量の数字ではなく. EMA ガイドラインでは、隔離操作のプロセス パラメーターが記述されることを期待しています。, 異なるペプチドを同じカラムで精製する場合、相互汚染を防ぐための対策が必要, 最終的なペプチドにまで引き継がれる可能性のある出発原料の不純物の運命と除去の評価が必要です (EMA, 2025). 欠失および切り詰められた配列, 不完全なカップリングまたは脱保護によって形成され、アセチル化によってキャップされる, プロセス制御を最も直接的に反映する不純物クラスです。, そしてガイドラインは、下流で修正するのではなく、繰り返しのカップリングと体系的なキャッピングによってその形成が防止されることを期待しています。.
安定性の研究では実際のストレージをサポートする必要があります, 取扱期間, 使用目的と開発段階. 一次バッチおよび提出期間に対する ICH 登録推奨事項は、研究用ペプチドの普遍的な 12 か月の待機期間ではありません。. フェーズに適したプロトコルと受け入れ基準を定義する.
アッセイ結果と失敗がモデルに戻される場合の閉ループの仕組み
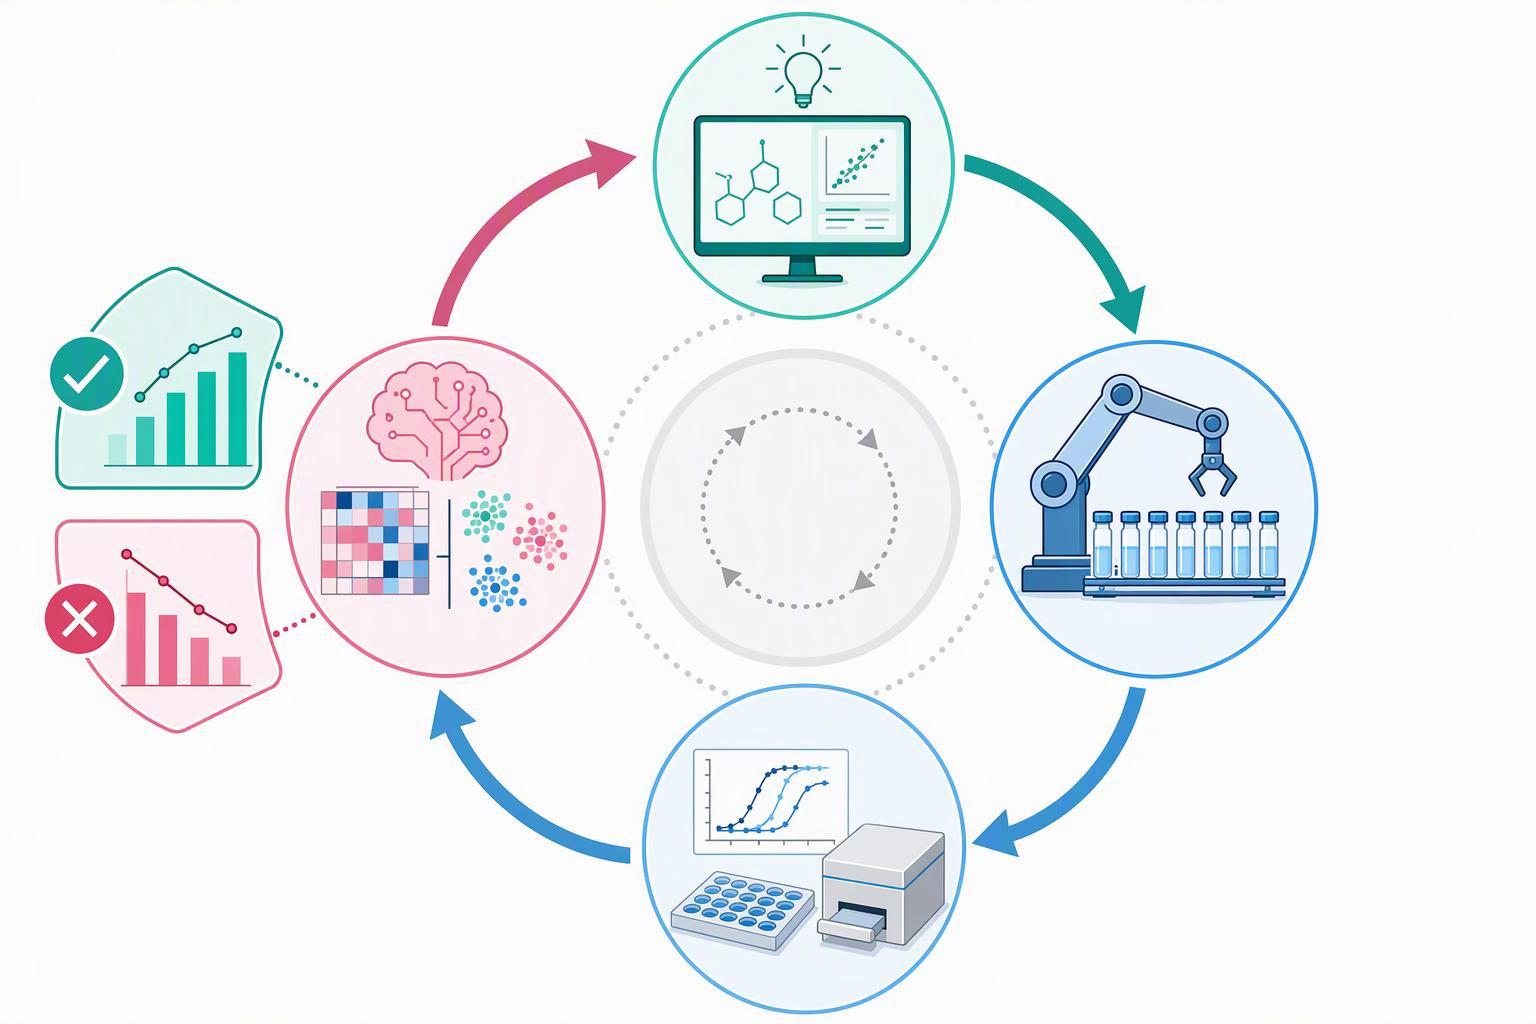
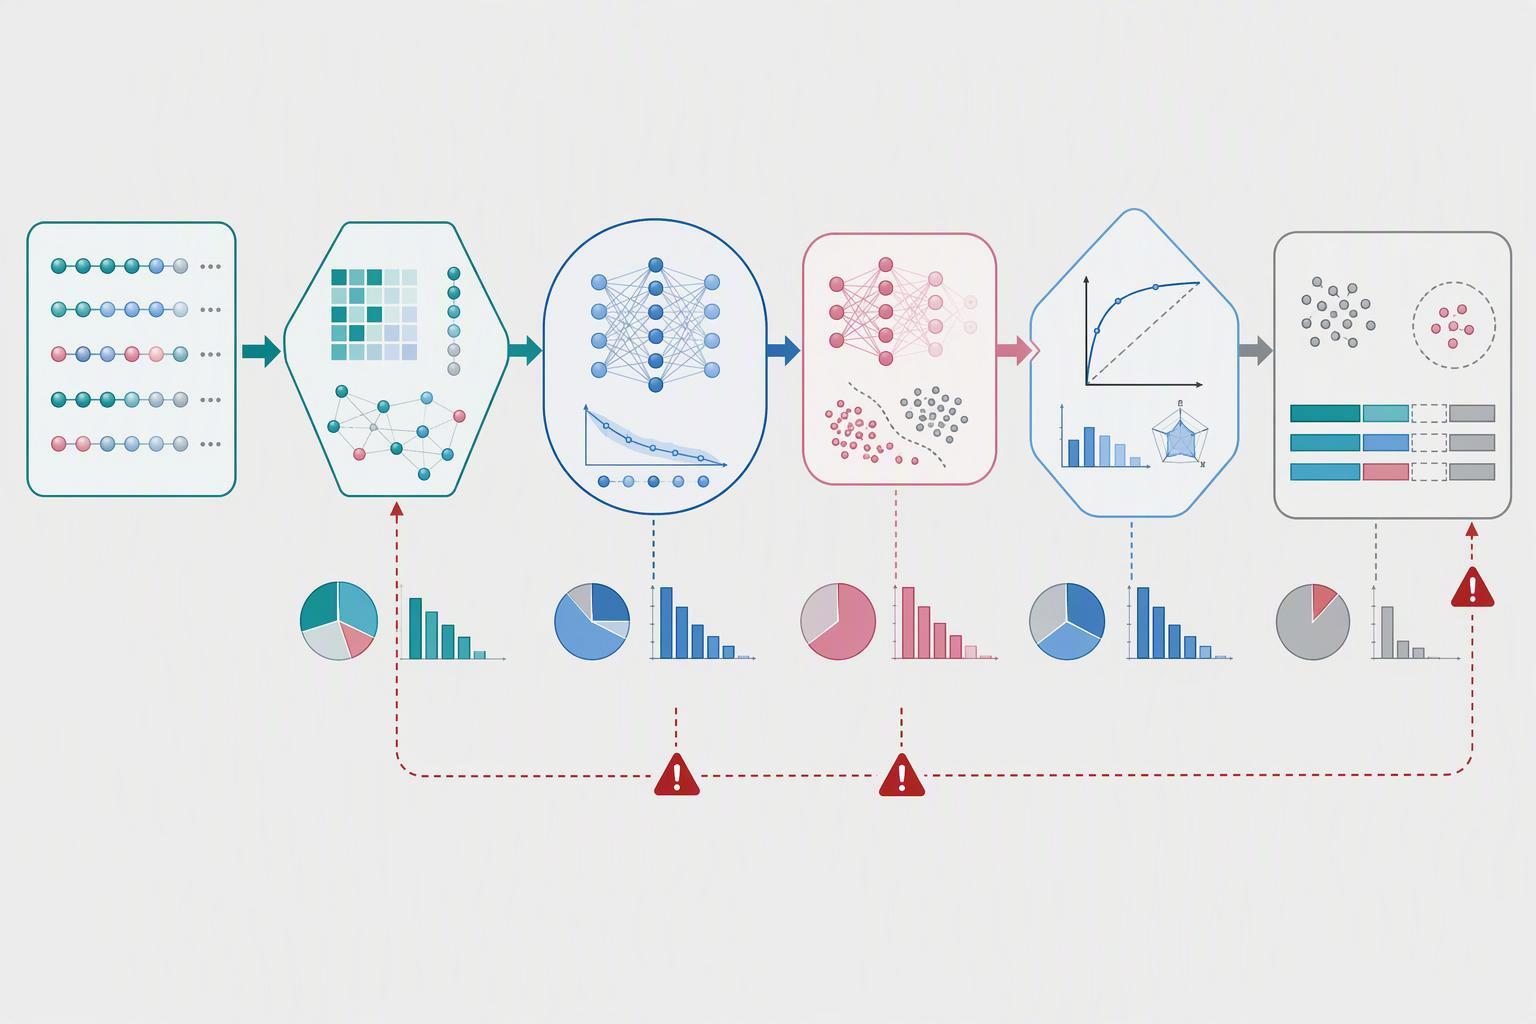
閉じたループは、失敗とマイナスが 1 つの非アクティブなバケットにまとめられるのではなく、個別のラベルとして記録される場合にのみ機能します。. 文書化されたサイクルは、合成の実現可能性を含む厳しい制約に対する設計とプレフィルターです。, 集計, 毒性, 溶解性と材料の適合性; 作って分析する; 各結果を正確なシーケンスに関連付けることによって結果を厳選する, 構築する, バッチ, アッセイプロトコル, 集中, 複製する, コントロール, QCステータスとモデルバージョン; モデルを更新する; 次に、次のバッチ バランシング予測ユーティリティを再ランク付けして選択します。, 不確実性, 多様性, 新規性と実用的な実現可能性 (マルチモーダル基礎モデルのレビュー, PMC, 2026). カスタムペプチドファクトリー
4 つのラベル カテゴリが違いを生む. 定量的測定には値と方法が含まれます. 陰性が確認された場合は、ペプチドが作成およびテストされたが機能しなかったという証拠が含まれます。. 検閲された結果には、アッセイの範囲外の測定値が含まれています. 技術的欠陥により、解釈可能なデータが得られなかった合成またはアッセイが行われる. これらを「非アクティブ」にマージすると、モデルは失敗したカップリングと本物のネガティブが同じものであることを教えます。, これは次の設計ラウンドで必要なものとは逆です.
スループットは、ループの回転速度に対する実際的な制約です。. 並列化された 192 のリアクション キャンペーンが 4 日間で完了, 一般的な逐次アプローチに比べて 4 倍の増加, 8 つのバッチでアクティブ ラーニングを使用, キャンペーン規模の反復の具体的なベンチマークです (自動運転ラボのアカウント, PMC, 2022). この説明では、システムが完全に自律的ではなく、新しいバイアルや化学物質を装填するなど、一部のステップではまだ人間の介入が必要であるとも述べています。, これは、人間関係者の注意事項と同じです。 2025 AI は機能を強化するツールであるとコメントが述べています。, 交換しない, 科学的直観 (ジェイコブソン, npj創薬, 2025).
規制と証拠が存在する場所, そしてまだ証明されていないこと
医薬品開発における AI の規制は原則に基づいており、現在も形成され続けています, 一方、ペプチド化学の期待はすでに具体的になっています. EMA と FDA は、医薬品ライフサイクルにおける AI の適切な実践のための 10 原則を共同で発表しました。 14 1月 2026, 初期の研究から製造、安全性の監視に至るまでの証拠の生成と監視をカバーします。, 開発者および販売承認申請者および保有者宛て, 将来の管轄区域固有のガイダンスを支えることを目的としています (EMA, 2026). EU ガイドラインの開発は、 2024. FDAの1月 2025 規制上の意思決定のための AI に関するガイダンス草案は拘束力がなく、使用のコンテキストに基づいて構成されています, 特定の質問に対処するためにモデルを使用する方法として定義される, スポンサーとともにその文脈におけるモデルの信頼性を確立する (FDA, 2025).
一緒に読む, ペプチドガイドラインは運用テンプレートであり、AI 原則はその上にあります. EMA 合成ペプチドガイドラインはすでに出発原料の正当性を課しています, 不純物の報告, 識別および認定のしきい値, と直交識別, 分析手順は、公的医薬品管理研究所が反復できるほど詳細に説明する必要があります。 (EMA, 2025). EMA-FDA の AI 原則とペプチド固有の AI 設計を結び付ける情報源はない, AI設計ペプチドが承認に達するまでの規制経路やタイムラインを示す情報源はない.
臨床記録は混在しているため、そのように読む必要があります. DSP-1181, AIが設計して人間に投与される最初の薬, で中止されました 2022 フェーズ II 前; REC-994は年に生産中止となりました。 2025 長期データが以前の有効性傾向を維持できなかったことを受けて; レントセルチブは、特発性肺線維症の第IIa相に達した。 2024, と 18 標的の発見から前臨床候補の指名まで数か月 (創薬における AI: 臨床的失敗, 規制の現実, PMC, 2026). の 2025 解説では、これまでの AI の取り組みはより効果的な薬をもたらしていないことを明白に述べている, 一方 2024 分析は、その結果を臨床的可能性の初期の兆候として枠組み化します. まだ証明されていないのは有効性です, スピードではない.
よくある質問
AIが設計したペプチドは天然のものよりも合成が難しいですか?
それを証明する情報源はありません. シーケンス自体を追跡するのが難しい, その起源ではありません: 凝集しやすいストレッチ, かさばるまたは邪魔な残留物, 上記の長さはおおよそ 50 に 60 アミノ酸は、モデルまたは進化が鎖を書いたかどうかに関係なく、同じカップリングと脱保護の問題を引き起こします。 (化学のフロンティア, 2020). AIで変わるのはスループット. モデルは、ベンチが候補者をトリアージするよりも早く候補者を提案します, そのため、ハードシーケンスはより大きなバッチで到着し、失敗率は実際よりも悪化しているように見えます.
細胞アッセイと in vivo 研究ではペプチドにどの程度の純度が必要ですか?
単一の番号はありません. 合成ペプチドに関するEMAガイドライン, 効果的 1 6月 2026, 固定されたしきい値ではなく、特定の使用目的に適した許容基準を求めます (EMA, 2025). アッセイが許容する限界を設定します: in vitro の読み取り値をシフトさせる対イオンおよび切断された種は、in vivo では無関係である可能性があります, そしてその逆も成り立ちます.
大量にリリースできるほどの分析証明書はありますか?
いいえ. CoA はサプライヤーが測定した内容を報告します; それ自体は身元を確認するものではありません. 仕様およびリリース時には、少なくとも 2 つの直交識別方法が推奨されます, したがって、ロットが受け入れられる前に、質量分析法とクロマトグラフィーまたは配列決定法が一致している必要があります (EMA, 2025).
トレーニング セットで合成が失敗するとどうなるか?
技術的な失敗というラベルを付ける, 非アクティブではない. 定量的な結果, 陰性が確認された, 打ち切られた値と失敗した実行には異なる意味があります, それらをマージすると、閉ループ AI ペプチド設計ワークフローに必要なシグナルが破壊されます。 (マルチモーダル基礎モデルのレビュー, 2026). 各ラベルをシーケンスに添付します, 構築する, バッチ, プロトコル, 集中, 複製する, コントロール, QCステータスとモデルバージョン.
AIは実際に臨床効果を向上させたのか?
証拠が争われている, そしてその後の読みはマイナスです. 発見の加速に関する初期の報告は、臨床エンドポイントの実証された利益と一致していない, したがって、計算速度を、より良い結果の証拠としてではなく、プロセスの改善として扱います。 (マルチモーダル基礎モデルのレビュー, 2026).
結論
同等のエンドポイントを比較する: フェーズ I の完了は、フェーズ I に入った後の最終的な承認と同じではありません. 引用された AI プログラムのサンプルと過去の業界コホートは選択が異なります, サイズ, 日付とフォローアップ. 80 ~ 90% を AI と比較して AI の優位性を確立することはできません。 7.9% 承認確率.
ギャップを埋めるのはワークフローです, モデルではありません. 候補をランク付けする前に、合成制約に対して候補をフィルタリングします, 分析パッケージを構築するための純度, 身元, コンテンツ, 安定性とアッセイ適合性はそれぞれ独自の証拠に基づいています, 再最適化されたプロセスパラメータと 3 つの主要バッチを中心にスケールアップを計画する, 失敗を独自のラベルとして記録し、次の設計ラウンドでそこから学習できるようにします。. 合成実現可能性セクションの制約チェックリストが実際の出発点です, 分析データパッケージのチェックリストはベンチステージの付属品です. どちらも次のキャンペーンまでに採用する価値があります, それ以降ではない.