翻译差距是什么以及基准准备意味着什么
定制多肽供应商 肽计算 翻译差距是计算排名的候选者和可重复制造的肽之间的距离, 表征和测试. 工作台就绪是该距离另一侧的可检查状态: 定义的顺序和格式, 证明合成可行性, 支持每项主张的分析数据包, 规定的处理条件, 以及材料实际适合的检测.
临床层面显示了为什么这种差距在商业上很重要. 2011-2020 年行业基准是 7.9% 第一阶段获得批准的可能性 12,728 相变 (生物 / 英富曼制药情报 / QLS 顾问, 2021). 对 AI 原生管道的首次分析发现,第一阶段成功率达到 80-90%,但仅约为 40% 第二阶段, 作者将这个数字描述为基于有限的样本量 (贾亚通加等人。, 当今的药物发现, 2024). 一个 2025 直接基于这些数字的评论指出,安全性和耐受性趋势比传统开发的分子更好, 90% 与低于 65%, 而第二阶段概念验证的成功在于 40%, 符合历史行业平均水平, 并补充说,目前还没有足够的案例来支持统计分析 (雅各布森, npj 药物发现, 2025).
证据的两个限制与数字属于同一段落. 没有经过同行评审的来源量化人工智能设计的合成失败的肽的比例, 并且没有任何来源在操作上定义“人工智能发现”, 这是否意味着人工智能用于目标识别, 分子设计, 或两者兼而有之. 因此,缩小人工智能肽设计中的翻译差距无法根据已发布的失败率来衡量. 它必须作为一系列工程决策进行管理, 这就是其余部分的内容.
肽人工智能模型如何训练以及它们需要什么数据
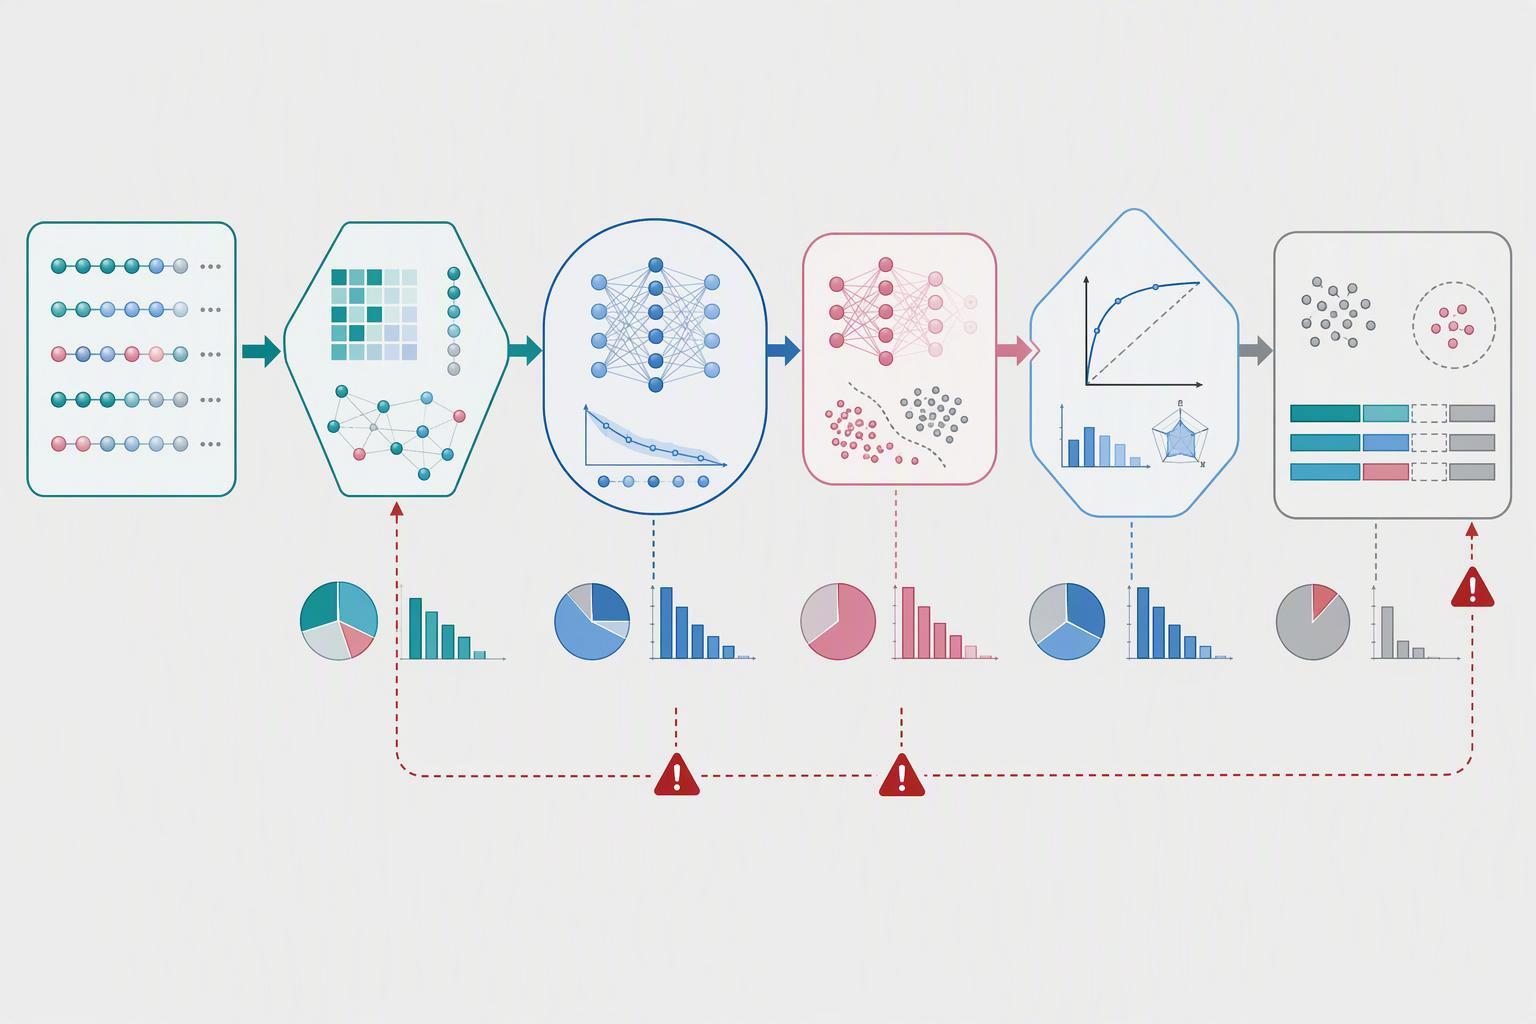
肽模型从序列表示中学习, 预训练语料库, 带有标记的正值和负值的微调集, 和评估分割, 最后两项的质量决定了报告的绩效是否有意义. AMPGen 的训练集是一个有用的具体案例: 10,249 由六个公共数据库编制的独特抗菌肽序列, 其中 9,854 携带抗菌靶点, 减少到 9,964 过滤至 5-65 个氨基酸后呈阳性, 与 11,989 从 UniProt 中提取的非 AMP 序列作为阴性 (AMP基因, 通讯生物学, 2025). 生成器本身已针对 OpenFold 数据进行了预训练,涵盖 401,381 多序列比对大致 132,000 独特的PDB序列.
负集是大多数项目投资不足的部分. 过滤 UniProt 中 5-65 个残基的序列,同时排除 17 抗菌等关键词, 抗生素, 根据注释,抗菌剂和毒素会产生非 AMP 阴性结果, 不是被测量并发现不活跃的阴性. 对于肽活性数据库中不活跃记录的比例,不存在稳定的公众人物, 这就是为什么特定集合的组成, 不是关于数据库平衡的一般声明, 是描述这一点的诚实方式.
评价是第二个弱点. 审计 51 跨越 Polaris 的基准配置, 贸易发展局, MoleculeNet 和 DTI 在绝大多数数据集中发现了交叉分割污染, 测试化合物和训练化合物之间的平均最近邻 ECFP Tanimoto 相似性 0.494, 0.559, 0.589 和 0.779 分别 (基准审核, PMC, 2026). 注入标签冲突, ROC AUC 平均值下降了 0.317. 对与训练共享近乎重复序列的分割进行评估的肽模型报告了无法在合成中幸存的数字.
为什么有计算前景的肽在合成和测定中失败
由于序列级活性模型看不到的化学原因,肽在实验台上失败. 困难的序列, 定义为那些形成强大的内部- 或分子内非共价相互作用,产生不溶性聚集体并阻止完全脱保护和偶联, 即使采用自动化合成,超过 50-60 个氨基酸仍然是一个挑战, 和序列长于 50 残基通常需要片段缩合或天然化学连接 (化学前沿, 2020).
所引用的二肽研究随着规模的增加而改变了工艺条件. 它的产量描述了那些路线和实验, 不是每个序列的计划范围. 通过匹配的工艺和分析数据比较拟议的放大.
引用的 AMPGen 论文报告了所选候选药物的合成和抗菌测试以及计算筛选. 保持测量结果与预测不同并保留相关有机体, 测定和候选选择分母; 结果并未确定所有生成序列的临床疗效或成功率.
如何根据真实综合约束筛选人工智能候选者
在对候选者进行活动排名之前,根据综合限制筛选候选者, 不是在竞选失败之后. 实际序列运行: 允许残留物和保护基相容性, 然后疏水运行和聚集风险评分, 那么多二硫键和环化的可行性, 然后是终端和侧链修改兼容性, 然后是长度上限. 每个门都是特定序列上的“是”或“否”, 未能通过任何门的候选人应该重新设计,而不是带着注释继续前进.
结构预测支持中间门而不是取代它们. 阿尔法折叠 3 预测包括蛋白质在内的复合物的联合结构, 核酸, 小分子, 聚合物序列中的离子和修饰残基, 残基修饰和配体 SMILES, 并报告了比 Vina 等对接工具更高的蛋白质-配体相互作用的准确性 (P= 2.27 × 10⁻13) 对于抗体-抗原复合物,则比 AlphaFold-Multimer v2.3 (P= 6.5 × 10⁻⁵) (艾布拉姆森等人。, 自然, 2024). 这些是重要性值, 不是总体百分比改善, 他们没有提到肽是否可以在树脂上组装.
序列长度是一个风险因素, 不是通用的综合上限. 疏水运行, 修改和拓扑应触发可行性评估; 四个连续的疏水残基不会自动需要重新设计或片段连接. 使用特定结构实验选择路线.
|
门 |
它筛选什么 |
失败响应 |
|---|---|---|
|
残基和保护基团 扩增肽 兼容性 |
所需残留物和化学物质是否共存 |
替代残渣或改变策略 |
|
疏水运行和聚集风险 |
连续疏水拉伸, β-折叠倾向 |
重新设计或计划碎片凝聚 |
|
二硫键和环化的可行性 |
多二硫键区域化学, 多肽信息生产商 头尾相连或内酰胺闭合 |
调整环化化学或下降 生长激素肽 |
|
改装兼容性 |
终端, 侧链, 标签, 连接体和脂质添加 |
对修饰位点重新测序 |
|
长度上限 |
复杂修饰序列的实际限制 |
分裂成片段或连接 |
什么分析数据包使肽在实验室中具有防御能力
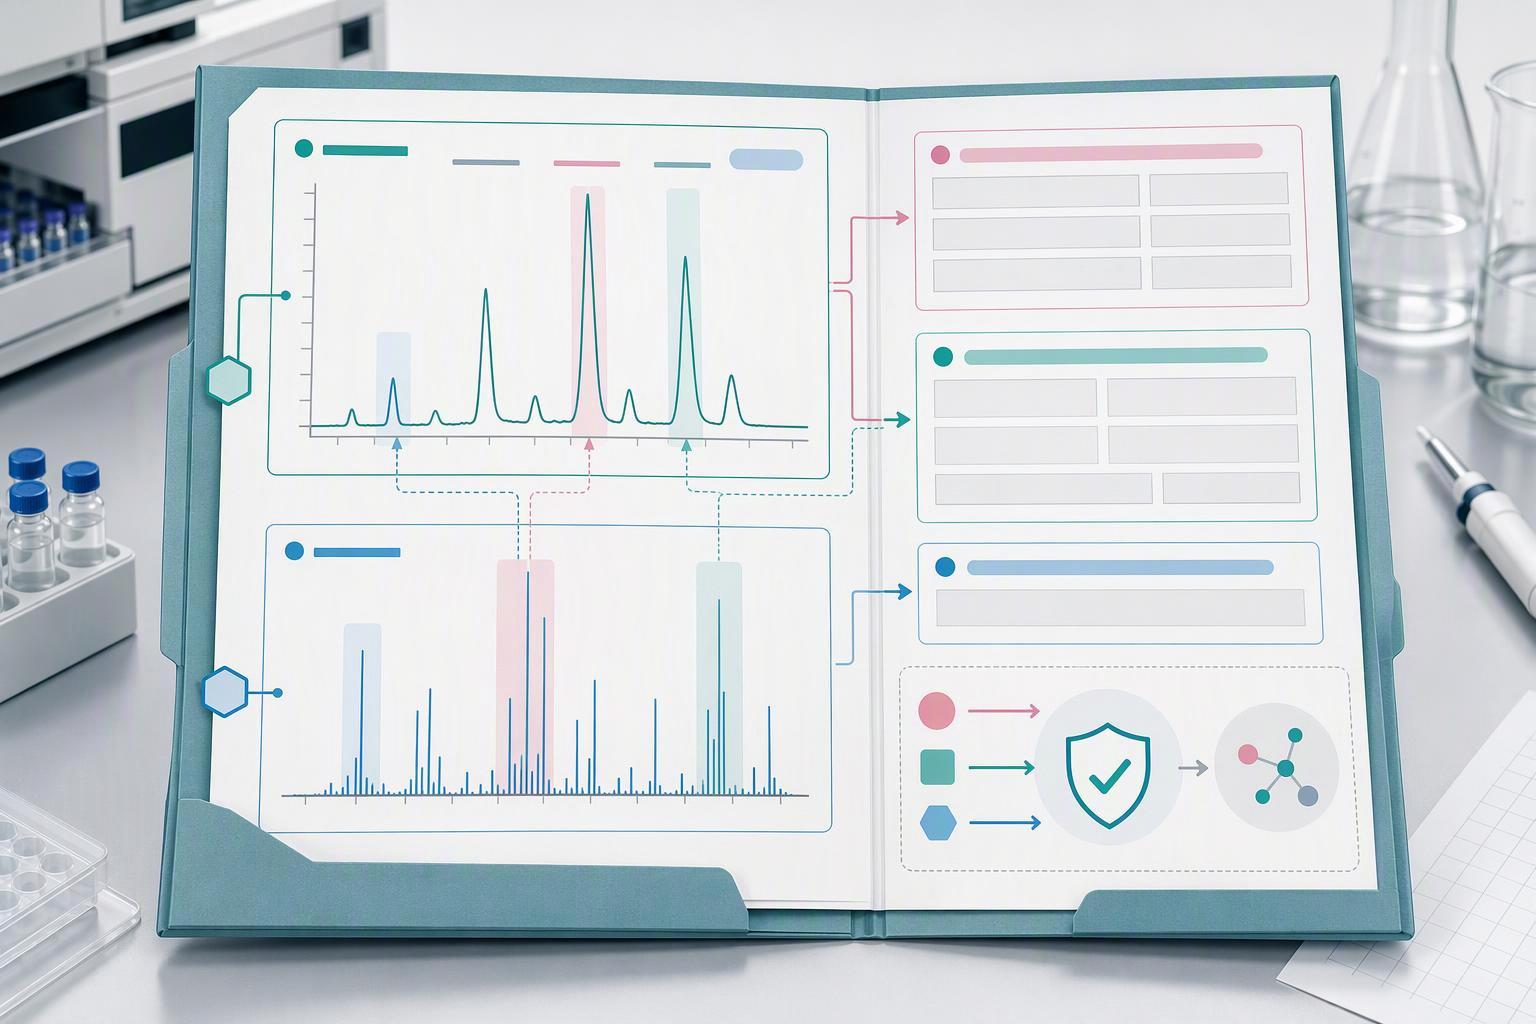
防御性的包装分离纯度, 身份, 内容, 不同声明中的稳定性和测定适用性, 每个都有自己的方法和自己的证据. EMA 合成肽开发和生产指南, 通过 4 十二月 2025 和有效的 1 六月 2026, 将纯度视为合成肽最重要的关键质量属性之一, 要求说明并证明各个部分和主池的接受标准, 并呼吁基于尺寸的正交纯度表征, 基于电荷和疏水性的分离 (EMA, 2025).
身份不是纯粹, 不同地方的指导方针都是这么说的. ICH Q6B 认为绝对纯度和相对纯度难以确定并且高度依赖于方法, 因此纯度是通过分析程序的组合来评估的, 而身份测试应该对分子具有高度特异性,并且可能需要不止一种物理化学, 生物或免疫化学测试 (我Q6B, 1999). EMA 指南建议在规范和发布时至少采用两种正交识别方法, 从质量中提取, 相对保留时间, 液质联用, 肽图谱, 生物活性, 氨基酸分析或核磁共振, 并将杂质分为肽相关和非肽类别 (EMA, 2025).
使用最终的 ICH Q2(R2) 适用的分析验证框架并证明研究设计对预期决策的合理性. 储存条件, 必须针对产品和开发阶段选择批次计数和持续时间,而不是继承作为通用筛选材料要求.
如何在不损失批次一致性的情况下从毫克筛选扩展到公斤生产
扩大规模改变了流程, 因此,您在筛选规模上验证的纯度和产量并不是您在生产规模上应承诺的数字. 古兹曼的数据显示了这种转变的规模: 相同的肽从 8.0% 产量和 23.9% 粗品纯度为 10–20 mg 53.5% 产量和 64.4% 粗品纯度为 3–4 g, 第二个肽来自 36% 和 62.1% 到 78.5% 和 98.7% (古兹曼等人。, 生物技术电子杂志, 2023). 因为该研究中的方案和条件随着规模的变化而变化, 诚实的解读是,扩大规模需要重新优化, 不适用定额罚款.
通过规范控制批次间的一致性, 不通过产量数字. EMA 指南期望描述隔离操作的工艺参数, 当不同的肽在同一柱上纯化时需要采取措施防止交叉污染, 并需要对可能影响最终肽的起始材料杂质进行归宿和清除评估 (EMA, 2025). 删除和截断序列, 由不完全偶联或脱保护形成并通过乙酰化封端, 是最直接反映过程控制的杂质类别, 该指南期望通过重复耦合和系统封盖来防止它们的形成,而不是在下游进行纠正.
稳定性研究应支持实际存储, 处理期限, 预期用途和开发阶段. ICH 对初级批次的注册建议和提交期限并非研究肽通用的 12 个月等待期. 定义适合阶段的协议和验收标准.
当检测结果和失败返回模型时闭环如何工作
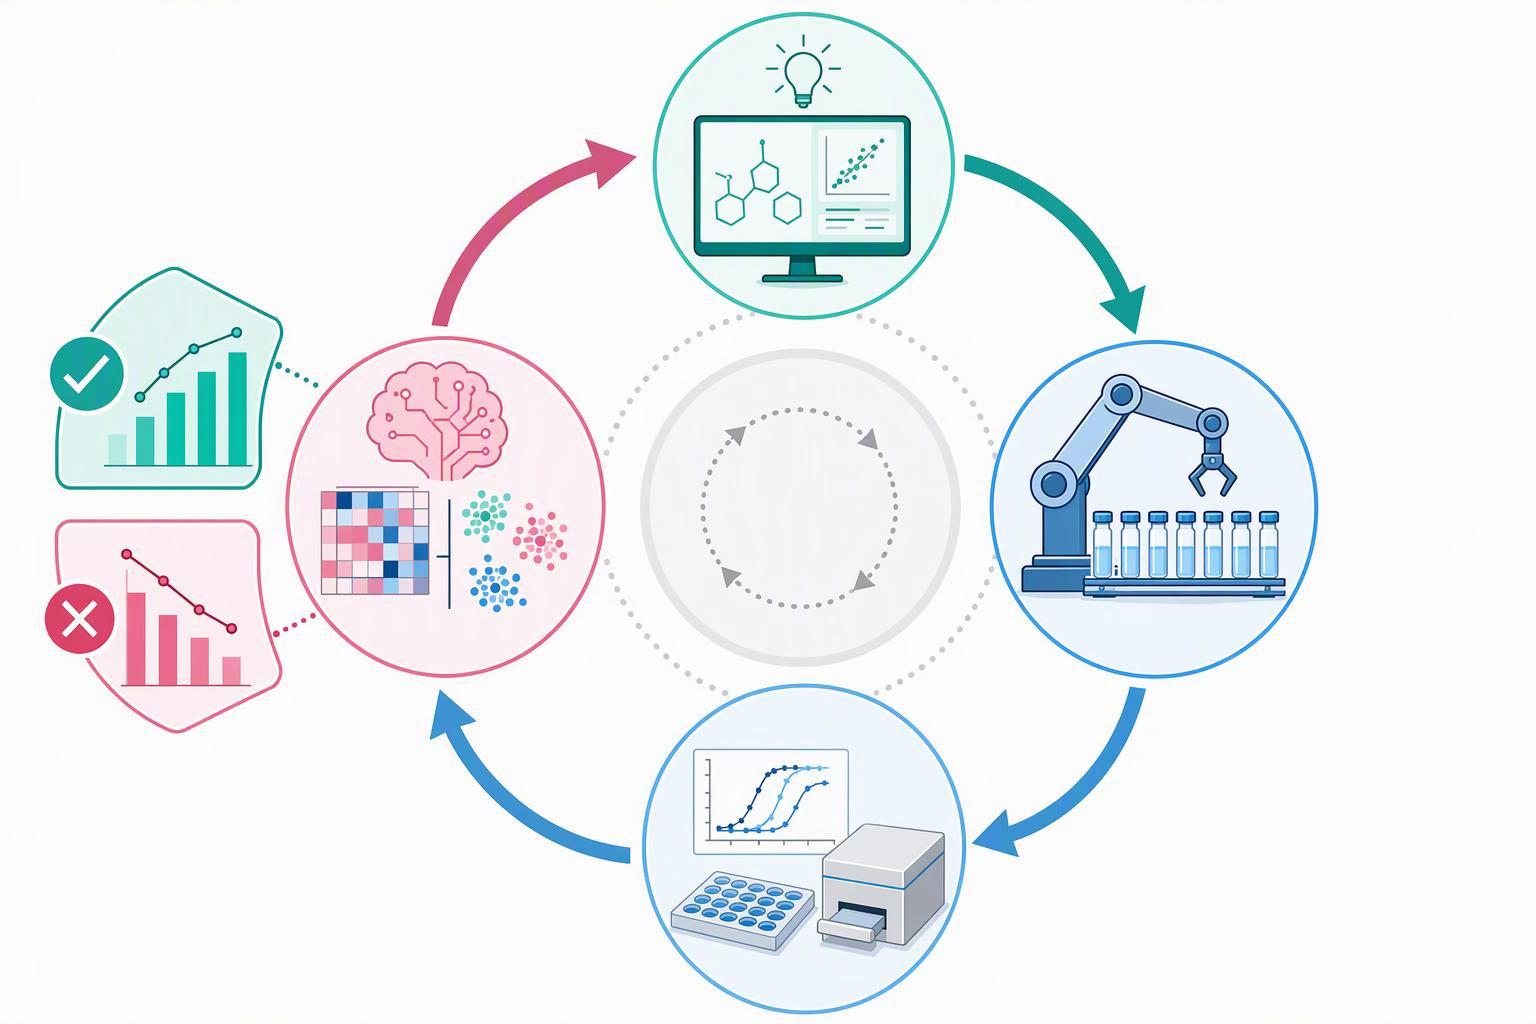
仅当失败和负数被记录为不同的标签而不是折叠到一个不活动的存储桶中时,闭环才起作用. 记录的周期是针对硬约束(包括合成可行性)的设计和预过滤, 聚合, 毒性, 溶解度和材料相容性; 制作和测定; 通过将每个结果附加到确切的序列来管理结果, 构造, 批, 检测方案, 专注, 复制, 控制, QC状态和型号版本; 更新模型; 然后重新排序并选择下一批平衡预测效用, 不确定, 多样性, 新颖性和实际可行性 (多模式基础模型审查, PMC, 2026). 定制肽工厂
四个标签类别是有区别的. 定量测量具有价值和方法. 确认的阴性结果有证据表明该肽是制造和测试的但不起作用. 审查结果的测量结果超出了测定范围. 技术故障导致合成或分析无法产生可解释的数据. 将这些合并到“不活动”中可以告诉模型,失败的耦合和真正的负面是同一件事, 这与下一轮设计的需求相反.
吞吐量是循环速度的实际限制. 四天内完成了 192 个并行反应活动, 比典型的顺序方法增加四倍, 分八个批次进行主动学习, 是活动规模迭代的具体基准 (自动驾驶实验室帐户, PMC, 2022). 该说法还指出,该系统并不是完全自主的,某些步骤仍然需要人工干预,例如装载新的小瓶或化学品, 这是相同的人机循环警告 2025 当评论说人工智能是增强能力的工具时, 不替换, 科学直觉 (雅各布森, npj 药物发现, 2025).
监管和证据的依据, 以及尚未证实的内容
药物开发中人工智能的监管是基于原则的且仍在形成中, 而肽化学的期望已经具体化. EMA 和 FDA 联合发布了药物生命周期中人工智能良好实践的十项原则 14 一月 2026, 涵盖从早期研究到制造和安全监控的证据生成和监控, 致开发商和营销授权申请人和持有者, 并旨在支持未来特定司法管辖区的指导 (EMA, 2026). 欧盟指南的制定建立在 EMA AI 反思论文的基础上 2024. FDA 一月份 2025 用于监管决策的人工智能指南草案不具有约束力,并围绕使用背景进行组织, 定义为如何使用模型来解决特定问题, 与赞助商一起建立该背景下的可信度模型 (美国食品药品监督管理局, 2025).
一起阅读, 肽指南是操作模板,人工智能原理位于其之上. EMA 合成肽指南已经规定了起始材料的合理性, 杂质报告, 身份和资格门槛, 和正交识别, 并要求对分析程序进行足够详细的描述,以便由官方药品控制实验室重复 (EMA, 2025). 没有来源将 EMA-FDA 人工智能原则与肽特异性人工智能设计联系起来, 并且没有任何消息来源给出人工智能设计的肽获得批准的监管途径或时间表.
临床记录是混杂的,应该这样解读. DSP-1181, 第一种人工智能设计的进入人体的药物, 已停产于 2022 第二阶段之前; REC-994 已停产 2025 在长期数据未能维持早期疗效趋势之后; rentosertib 治疗特发性肺纤维化达到 IIa 期 2024, 和 18 从目标发现到临床前候选人提名仅数月时间 (药物发现中的人工智能: 临床失败, 监管现实, PMC, 2026). 这 2025 评论明确指出,迄今为止人工智能的努力尚未产生更有效的药物, 而 2024 分析将其发现视为临床潜力的早期迹象. 尚未证实的是功效, 不是速度.
常见问题解答
人工智能设计的肽比天然肽更难合成吗?
没有消息来源证实这一点. 难以跟踪序列本身, 不是它的起源: 容易聚集的延伸, 大体积或受阻残留物, 和上面的长度大致 50 到 60 无论是模型还是进化编写了这条链,氨基酸都会产生相同的偶联和脱保护问题 (化学前沿, 2020). AI 改变的是吞吐量. 模型推荐候选人的速度比工作人员对他们进行分类的速度要快, 因此硬序列会以更大的批次到达,并且失败率看起来比实际情况更糟糕.
细胞测定与体内研究所需的肽纯度是多少?
没有单一的号码. EMA 合成肽指南, 有效的 1 六月 2026, 要求针对特定预期用途合理的验收标准,而不是固定的阈值 (EMA, 2025). 设置检测耐受的限度: 改变体外读数的反离子和截短物种可能与体内无关, 反过来也成立.
一份分析证书是否足以释放大量?
不. CoA 报告供应商测量的内容; 它本身并不确认身份. 规范和发布时推荐至少两种正交识别方法, 因此,在接受批次之前,质谱分析法和色谱分析或测序方法应达成一致 (EMA, 2025).
训练集中合成失败会发生什么?
将其标记为技术故障, 不是不活跃的. 定量结果, 确认阴性, 审查值和失败的运行具有不同的含义, 合并它们会破坏闭环人工智能肽设计工作流程所需的信号 (多模式基础模型审查, 2026). 将每个标签附加到序列上, 构造, 批, 协议, 专注, 复制, 控制, QC状态和型号版本.
AI真的改善了临床疗效吗?
证据有争议, 后来的读数是负数. 加速发现的早期报告并未与临床终点的实际进展相匹配, 因此,将计算速度视为流程改进,而不是更好结果的证明 (多模式基础模型审查, 2026).
结论
比较同类端点: 第一阶段完成并不等同于进入第一阶段后最终获得批准. 引用的人工智能程序样本和历史行业群体在选择上有所不同, 尺寸, 日期和后续行动. 他们并没有通过将 80-90% 的人与其他人进行比较来确立人工智能的优势。 7.9% 批准概率.
缩小差距的是工作流程, 不是模型. 在对候选者进行排名之前,根据综合约束条件筛选候选者, 构建分析包以保证纯度, 身份, 内容, 稳定性和检测适用性都有自己的证据, 围绕重新优化的工艺参数和三个主要批次计划扩大规模, 并将失败记录为自己的标签,以便下一轮设计从中学习. 综合可行性部分中的约束清单是实际的起点, 分析数据包清单是工作台阶段的配套文件. 两者都值得在下一次竞选之前采用, 不在它之后.