Hvad oversættelseskløften er, og hvad bænk-klar betyder
Tilpasset peptidleverandør Peptid beregnet Oversættelsesgabet er afstanden mellem en beregningsmæssigt rangeret kandidat og et peptid, der kan fremstilles reproducerbart, karakteriseret og testet. Bench-ready er den kontrollerbare tilstand på den anden side af den afstand: en defineret rækkefølge og format, demonstreret syntesegennemførlighed, en analytisk datapakke, der understøtter hver enkelt påstand, angivne håndteringsforhold, og en analyse, materialet faktisk er egnet til.
Det kliniske lag viser, hvorfor kløften kommercielt har betydning. 2011-2020-industriens basislinje var en 7.9% sandsynlighed for godkendelse fra fase I på tværs 12,728 faseovergange (BIO / Informa Pharma Intelligence / QLS rådgivere, 2021). Den første analyse af AI-native pipelines fandt 80-90 % fase I succes, men kun ca 40% i fase II, en figur, forfatterne beskriver som hvilende på en begrænset stikprøvestørrelse (Jayatunga et al., Drug Discovery Today, 2024). EN 2025 kommentar bygget direkte på disse tal siger, at sikkerhed og tolerabilitet udvikler sig bedre end traditionelt udviklede molekyler, 90% kontra under 65%, mens Fase II proof-of-concept succes sidder på 40%, på linje med historiske branchegennemsnit, og tilføjer, at der endnu ikke er sager nok til at drive statistiske analyser (Jacobson, npj Drug Discovery, 2025).
To grænser for beviserne hører hjemme i samme afsnit som tallene. Ingen peer-reviewed kilde kvantificerer andelen af AI-designede peptider, der fejler syntese, og ingen kilde definerer "AI-opdaget" operationelt, om det betyder AI brugt til målidentifikation, molekyle design, eller begge dele. Lukning af translationsgabet i AI-peptiddesign kan derfor ikke måles mod en offentliggjort fejlrate. Det skal styres som en sekvens af tekniske beslutninger, hvilket er, hvad de resterende afsnit angiver.
Hvordan Peptide AI-modeller trænes, og hvilke data de har brug for
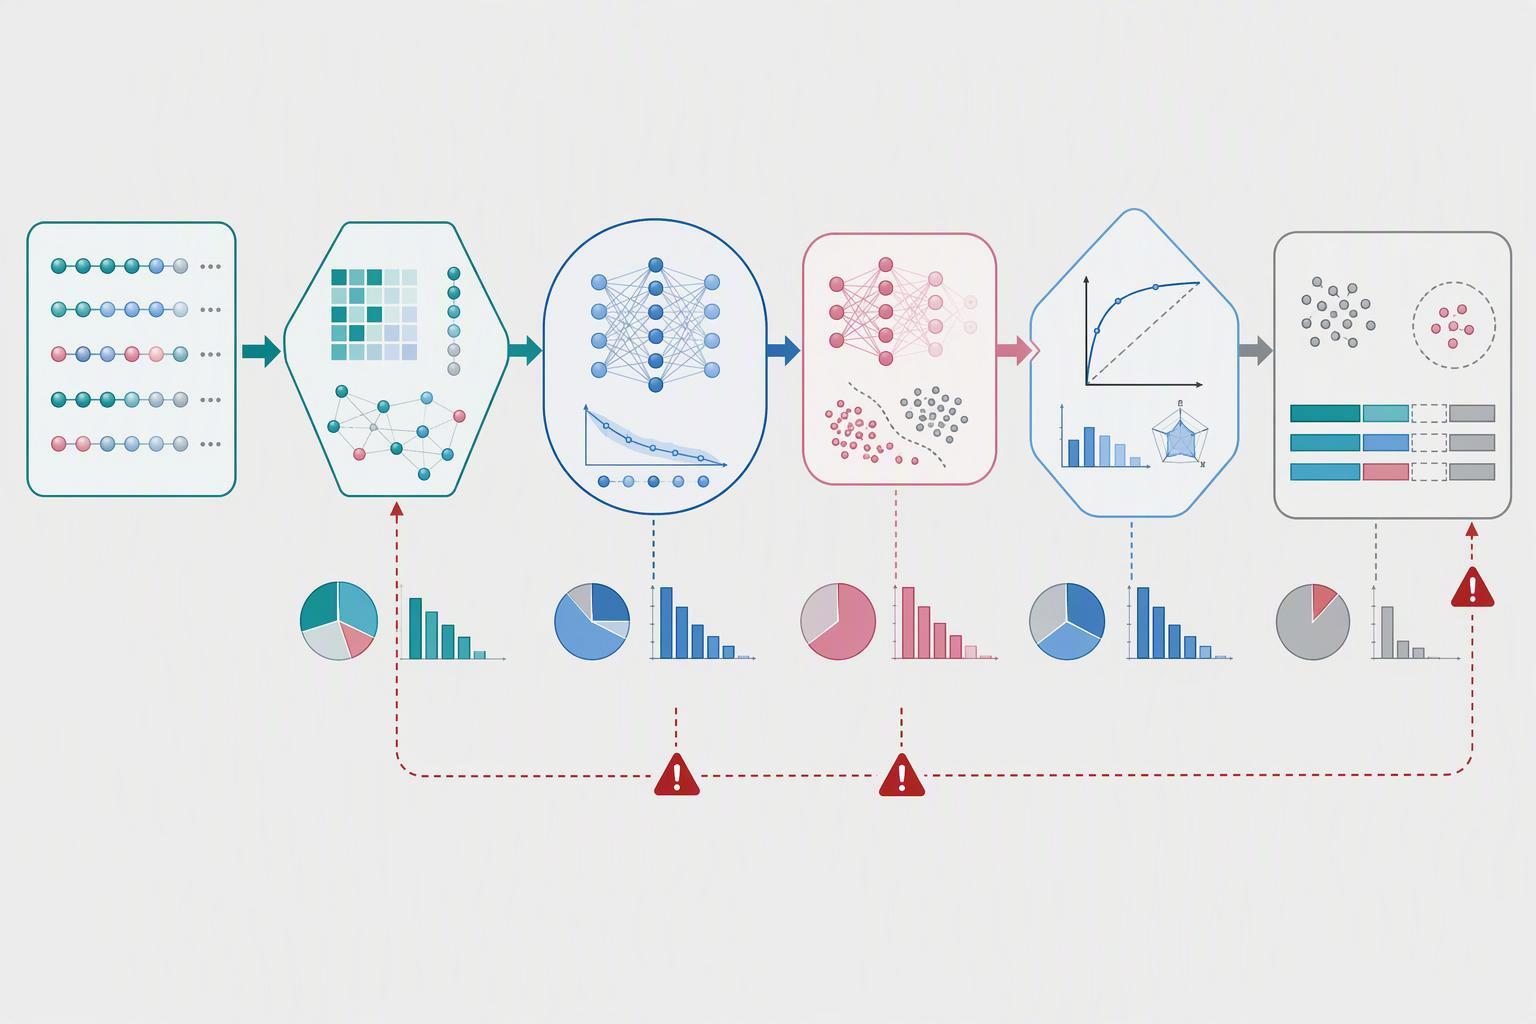
Peptidmodeller lærer af en sekvensrepræsentation, et fortræningskorpus, et finjusteringssæt med mærkede positive og negative, og en evalueringsopdeling, og kvaliteten af de to sidste afgør, om rapporteret præstation betyder noget. AMPGens træningssæt er en nyttig konkret case: 10,249 unikke antimikrobielle peptidsekvenser kompileret fra seks offentlige databaser, heraf 9,854 bære antibakterielle mål, reduceret til 9,964 positive efter filtrering til 5-65 aminosyrer, parret med 11,989 ikke-AMP-sekvenser trukket fra UniProt som negative (AMPGen, Kommunikationsbiologi, 2025). Selve generatoren var fortrænet i OpenFold-datadækning 401,381 flere sekvensjusteringer for nogenlunde 132,000 unikke PDB-sekvenser.
Det negative sæt er den del, de fleste projekter underinvesterer i. Filtrering af UniProt for sekvenser på 5-65 rester med ekskludering 17 nøgleord såsom antimikrobiel, antibiotikum, antibakteriel og toksin producerer negativer, der er ikke-AMP ved annotering, ikke negative, der blev målt og fundet inaktive. Der eksisterer ingen stabil offentlig person for andelen af inaktive poster i peptidaktivitetsdatabaser, hvorfor sammensætningen af et bestemt sæt, ikke en generel påstand om databasebalance, er den ærlige måde at beskrive dette på.
Evaluering er det andet svage punkt. En revision af 51 benchmark-konfigurationer, der spænder over Polaris, TDC, MoleculeNet og DTI fandt krydssplittet kontaminering i langt de fleste datasæt, med gennemsnitlig nærmeste nabo ECFP Tanimoto lighed mellem test- og træningsforbindelser af 0.494, 0.559, 0.589 og 0.779 henholdsvis (benchmark revision, PMC, 2026). Under indsprøjtet etiket konflikter, den gennemsnitlige ROC AUC faldt med 0.317. En peptidmodel evalueret på en split, der deler næsten duplikerede sekvenser med træning, rapporterer et tal, der ikke vil overleve syntese.
Hvorfor beregningsmæssigt lovende peptider fejler ved syntese og i analysen
Peptider fejler ved bænken af kemiske årsager, som en aktivitetsmodel på sekvensniveau ikke kan se. Svære sekvenser, defineret som dem, der danner stærke inter- eller intramolekylære ikke-kovalente interaktioner, der producerer uopløselige aggregater og blokerer fuldstændig afbeskyttelse og kobling, forbliver en udfordring over 50-60 aminosyrer selv med automatiseret syntese, og sekvenser længere end 50 rester har ofte behov for fragmentkondensering eller naturlig kemisk ligering (Grænser i kemi, 2020).
Den citerede undersøgelse med to peptider ændrede procesbetingelserne, efterhånden som skalaen steg. Dens udbytter beskriver disse ruter og eksperimenter, ikke et planlægningsområde for hver sekvens. Sammenlign en foreslået opskalering gennem matchede proces- og analytiske data.
Det citerede AMPGen-papir rapporterer syntese og antibakteriel testning af udvalgte kandidater samt computerscreening. Hold målte resultater adskilt fra forudsigelser og behold den relevante organisme, assay og kandidatudvælgelsesnævner; resultaterne fastslår ikke klinisk effekt eller en succesrate for alle genererede sekvenser.
Sådan filtreres AI-kandidater mod reelle syntesebegrænsninger
Filtrer kandidater mod syntesebegrænsninger, før du rangordner dem for aktivitet, ikke efter en mislykket kampagne. Den praktiske sekvens kører: tilladte rester og beskyttelsesgruppekompatibilitet, derefter hydrofobisk-run og aggregeringsrisiko-scoring, derefter multi-disulfid og cyklisering gennemførlighed, derefter terminal- og sidekædemodifikationskompatibilitet, derefter længdeloftet. Hver gate er et ja-eller-nej på en bestemt sekvens, og en kandidat, der fejler en gate, bør re-designes i stedet for at blive båret videre med en seddel.
Strukturforudsigelse understøtter de midterste porte i stedet for at erstatte dem. AlphaFold 3 forudsiger den fælles struktur af komplekser, herunder proteiner, nukleinsyrer, små molekyler, ioner og modificerede rester fra polymersekvenser, restmodifikationer og ligand SMILES, og rapporterer væsentligt højere nøjagtighed for protein-ligand-interaktioner end dockingværktøjer såsom Vina (P = 2.27 × 10⁻¹³) og for antistof-antigen komplekser end AlphaFold-Multimer v2.3 (P = 6.5 × 10⁻⁵) (Abramson et al., Natur, 2024). Det er betydningsværdier, ikke en overskriftsprocentforbedring, og de siger intet om, hvorvidt peptidet kan samles på harpiks.
Sekvenslængde er en risikofaktor, ikke et universelt synteseloft. Hydrofobe løb, ændringer og topologi bør udløse gennemførlighedsvurdering; fire på hinanden følgende hydrofobe rester kræver ikke automatisk redesign eller fragmentligering. Vælg en rute ved hjælp af konstruktionsspecifikke eksperimenter.
|
Port |
Hvad den skærmer |
Svar på fejl |
|---|---|---|
|
Rest- og beskyttelsesgruppe Amplificerede peptider kompatibilitet |
Hvorvidt nødvendige rester og kemi eksisterer side om side |
Erstat rest eller skift strategi |
|
Hydrofobisk løb og aggregeringsrisiko |
På hinanden følgende hydrofobe strækninger, β-ark tilbøjelighed |
Redesign eller planlæg fragmentkondensering |
|
Mulighed for disulfid og ringslutning |
Multi-disulfid regiokemi, Peptidinformationsproducent hoved-til-hale eller lactam lukning |
Juster cykliseringskemi eller drop Væksthormonpeptider |
|
Ændringskompatibilitet |
Terminal, sidekæde, mærke, linker og lipidtilsætninger |
Sekvensér ændringsstedet igen |
|
Længde loft |
Praktisk grænse for komplekse modificerede sekvenser |
Del i fragmenter eller ligere |
Hvilken analytisk datapakke gør et peptid forsvarligt ved bænken
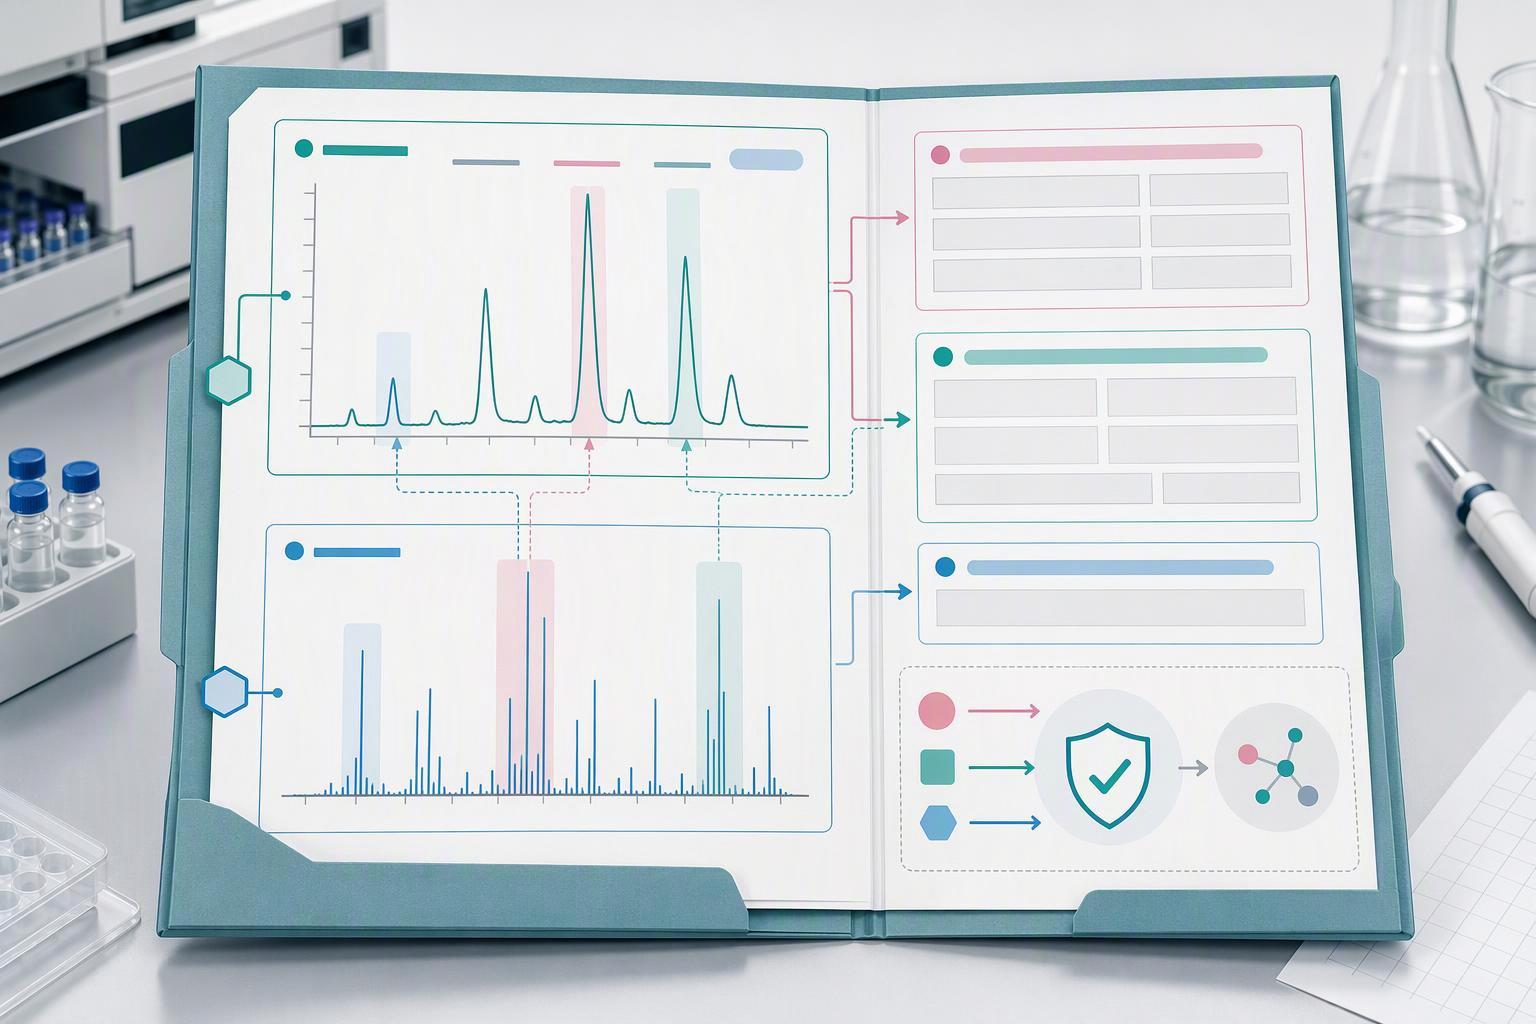
En forsvarlig pakke adskiller renhed, identitet, tilfreds, stabilitet og assay-egnethed til forskellige krav, hver med sin egen metode og sine egne beviser. EMAs retningslinjer for udvikling og fremstilling af syntetiske peptider, vedtaget 4 december 2025 og effektiv 1 juni 2026, behandler renhed som en af de vigtigste kritiske kvalitetsegenskaber for syntetiske peptider, kræver, at acceptkriterier for de enkelte fraktioner og hovedpuljen angives og begrundes, og opfordrer til ortogonal renhedskarakterisering på tværs af størrelsesbaseret, ladningsbaseret og hydrofobicitetsbaseret adskillelse (EMA, 2025).
Identitet er ikke renhed, og retningslinjerne siger det forskellige steder. ICH Q6B hævder, at absolut og relativ renhed er svære at bestemme og meget metodeafhængige, så renheden vurderes ved en kombination af analytiske procedurer, mens identitetstests bør være meget specifikke for molekylet og kan kræve mere end én fysisk-kemisk, biologisk eller immunkemisk test (I Q6B, 1999). EMA-retningslinjen anbefaler mindst to ortogonale identifikationsmetoder ved specifikation og frigivelse, trukket fra masse, relativ opbevaringstid, LC-MS, peptidkortlægning, bioaktivitet, aminosyreanalyse eller NMR, og opdeler urenheder i peptidrelaterede og ikke-peptidkategorier (EMA, 2025).
Brug den endelige ICH Q2(R2) rammer for relevant analytisk validering og begrunde undersøgelsesdesignet for den påtænkte beslutning. Opbevaringsforhold, batchantal og varighed skal vælges til produkt- og udviklingsstadiet i stedet for at nedarves som et universelt krav til screeningsmateriale.
Sådan skaleres fra mg screening til kg produktion uden at miste parti-til-lot-konsistens
Opskalering ændrer processen, så den renhed og udbytte, du validerede i screeningsskala, er ikke de tal, du skal love i produktionsskala. Guzmán-dataene viser størrelsen af dette skift: det samme peptid flyttet fra 8.0% udbytte og 23.9% rå renhed ved 10-20 mg til 53.5% udbytte og 64.4% rå renhed ved 3-4 g, og det andet peptid fra 36% og 62.1% til 78.5% og 98.7% (Guzmán et al., Electronic Journal of Biotechnology, 2023). Fordi protokol og betingelser ændrede sig med skalaen i den undersøgelse, den ærlige læsning er, at opskalering kræver re-optimering, ikke at der gælder en fast straf.
Lot-til-lot-konsistens styres gennem specifikationen, ikke gennem udbyttetallet. EMA-retningslinjen forventer, at procesparametre for isolationsoperationer beskrives, kræver foranstaltninger for at forhindre krydskontaminering, når forskellige peptider oprenses på samme søjle, og kræver en skæbne-og-udrensning vurdering af udgangsmateriale urenheder, der kan føre igennem til det endelige peptid (EMA, 2025). Sletning og trunkerede sekvenser, dannet ved ufuldstændig kobling eller afbeskyttelse og lukket af acetylering, er den urenhedsklasse, der mest direkte afspejler processtyring, og retningslinjen forventer, at deres dannelse forhindres ved gentagen kobling og systematisk dækning i stedet for at korrigeres nedstrøms.
Stabilitetsundersøgelser bør understøtte den faktiske opbevaring, håndteringsperiode, påtænkt brug og udviklingsstadium. ICH-registreringsanbefalinger for primære batcher og indsendelsesvarighed er ikke en universel 12-måneders venteperiode for forskningspeptider. Definer en fase-passende protokol og acceptkriterier.
Sådan fungerer den lukkede sløjfe, når analyseresultater og -fejl går tilbage i modellen
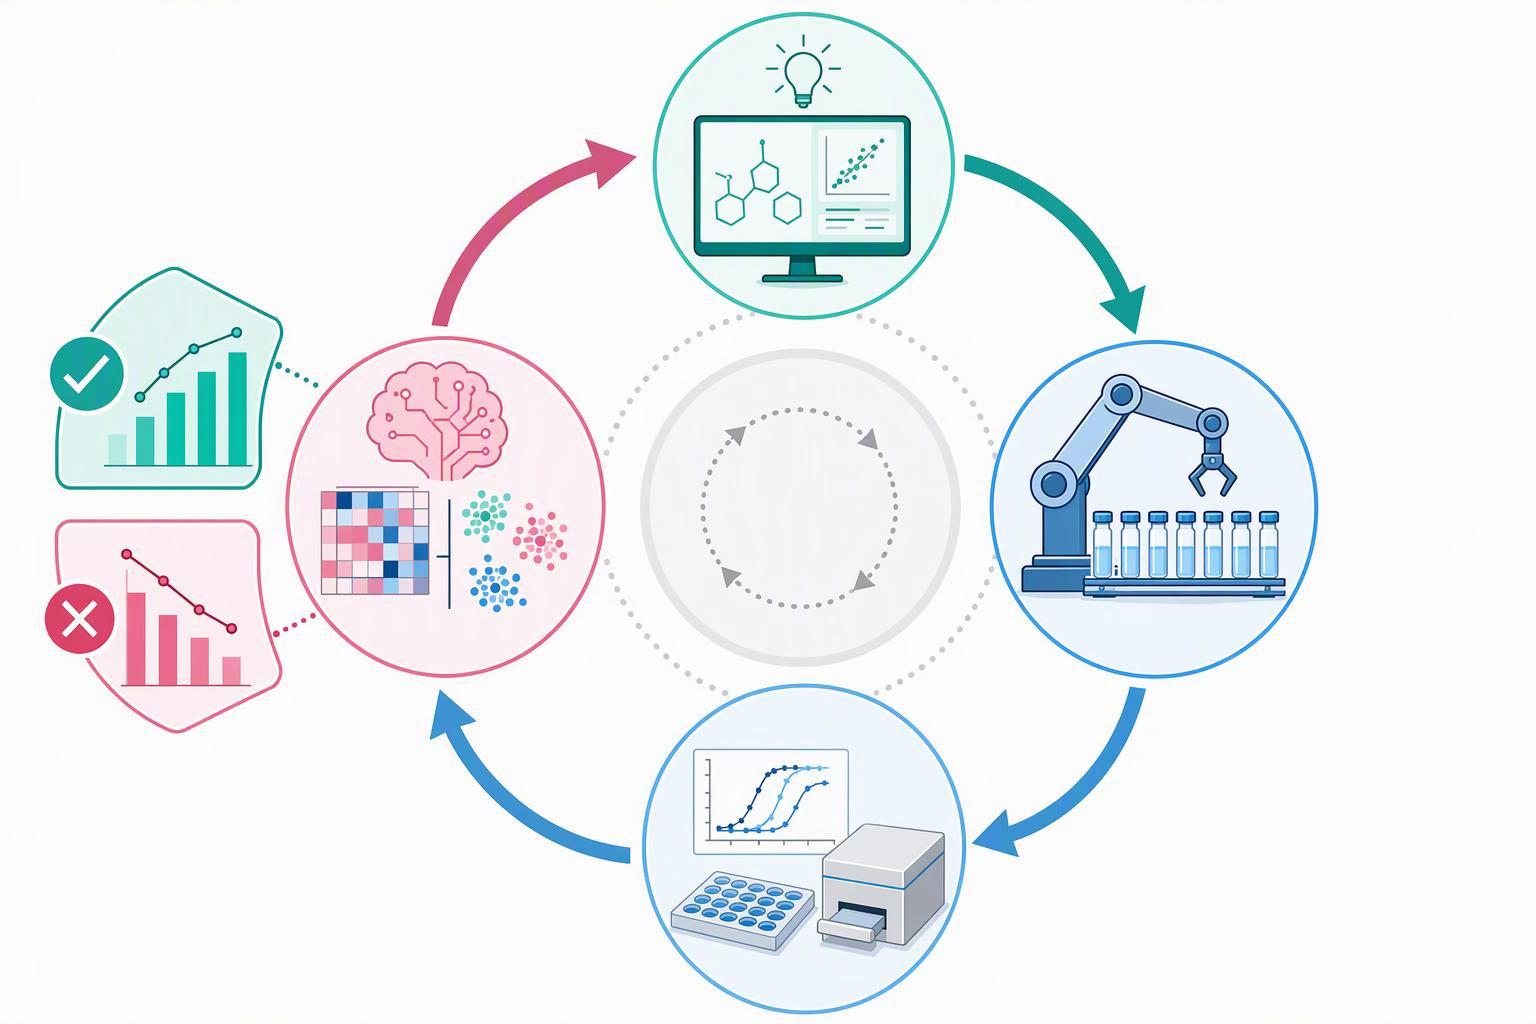
Den lukkede sløjfe fungerer kun, hvis fejl og negativer registreres som særskilte etiketter i stedet for at blive foldet sammen i en inaktiv bøtte. Den dokumenterede cyklus er design og forfilter mod hårde begrænsninger, herunder syntesegennemførlighed, sammenlægning, toksicitet, opløselighed og materialekompatibilitet; lave og analysere; kurér resultater ved at knytte hvert resultat til den nøjagtige rækkefølge, konstruere, batch, analyseprotokol, koncentration, replikere, kontroller, QC-status og modelversion; opdatere modeller; derefter omranger og vælg det næste batchbalanceringsforventede hjælpeprogram, usikkerhed, mangfoldighed, nyhed og praktisk gennemførlighed (gennemgang af multimodal fundamentmodel, PMC, 2026). Custom Peptide Factory
Det er de fire etiketkategorier, der gør forskellen. Kvantitative målinger bærer en værdi og en metode. Bekræftede negativer bærer bevis for, at peptidet blev fremstillet og testet og ikke virkede. Censurerede resultater bærer en måling, der faldt uden for analysens område. Tekniske fejl har en syntese eller analyse, der ikke producerede fortolkelige data. Sammenlægning af disse til "inaktive" lærer modellen, at en mislykket kobling og en ægte negativ er det samme, hvilket er det modsatte af, hvad næste designrunde har brug for.
Gennemløb er den praktiske begrænsning for, hvor hurtigt løkken drejer. En paralleliseret kampagne med 192 reaktioner afsluttet på fire dage, en firedobling i forhold til en typisk sekventiel tilgang, med aktiv læring i hold af otte, er det konkrete benchmark for iteration i kampagneskala (selvkørende laboratoriekonto, PMC, 2022). Denne beretning angiver også, at systemet ikke er fuldt autonomt, og at nogle trin stadig kræver menneskelig indgriben, såsom at fylde nye hætteglas eller kemikalier, som er det samme menneske-i-løkken forbehold 2025 kommenterer når det siger AI er et værktøj til at forbedre, ikke erstatte, videnskabelig intuition (Jacobson, npj Drug Discovery, 2025).
Hvor regulering og beviser står, og hvad der forbliver ubevist
Regulering af kunstig intelligens i lægemiddeludvikling er principbaseret og er stadig under udvikling, mens forventningerne til peptidkemi allerede er konkrete. EMA og FDA offentliggjorde i fællesskab ti principper for god kunstig intelligens i lægemidlers livscyklus 14 januar 2026, dækker evidensgenerering og overvågning fra tidlig forskning gennem fremstilling og sikkerhedsovervågning, rettet til udviklere og ansøgere og indehavere af markedsføringstilladelser, og har til formål at understøtte fremtidig jurisdiktionsspecifik vejledning (EMA, 2026). Udvikling af EU-retningslinjer bygger på EMA AI-refleksionspapiret udgivet i 2024. FDA's januar 2025 udkast til vejledning om kunstig intelligens til lovgivningsmæssig beslutningstagning er ikke-bindende og organiseret omkring brugskonteksten, defineret som hvordan en model bruges til at løse et bestemt spørgsmål, med sponsorer, der etablerer modeltroværdighed i den sammenhæng (FDA, 2025).
Læs sammen, peptidretningslinjen er den operationelle skabelon, og AI-principperne ligger ovenpå. EMA-retningslinjen for syntetiske peptider pålægger allerede en begrundelse for udgangsmateriale, urenhedsrapportering, identifikations- og kvalifikationstærskler, og ortogonal identifikation, og kræver, at analytiske procedurer beskrives tilstrækkeligt detaljeret til at blive gentaget af et officielt lægemiddelkontrollaboratorium (EMA, 2025). Ingen kilde forbinder EMA–FDA AI-principperne med peptidspecifikt AI-design, og ingen kilde giver en regulatorisk vej eller tidslinje for AI-designede peptider, der når godkendelse.
Den kliniske journal er blandet og bør læses som sådan. DSP-1181, det første AI-designede lægemiddel, der kommer ind i mennesker, blev afbrudt i 2022 før fase II; REC-994 blev udgået i 2025 efter at langsigtede data ikke kunne opretholde tidligere effektivitetstendenser; rentosertib nåede fase IIa for idiopatisk lungefibrose i 2024, med 18 måneder fra målopdagelse til præklinisk kandidatnominering (AI i Drug Discovery: Kliniske fejl, Regulatorisk virkelighed, PMC, 2026). De 2025 kommentaren siger klart, at AI-indsatsen indtil videre ikke har resulteret i mere effektive lægemidler, mens 2024 analyse rammer sine resultater som tidlige tegn på klinisk potentiale. Det, der forbliver ubevist, er effektiviteten, ikke hastighed.
Ofte stillede spørgsmål
Er AI-designede peptider sværere at syntetisere end naturlige?
Ingen kilde fastslår det. Svært ved at spore selve sekvensen, ikke dens oprindelse: aggregeringstilbøjelige strækninger, voluminøse eller hindrede rester, og længde over ca 50 til 60 aminosyrer skaber de samme koblings- og afbeskyttelsesproblemer, uanset om en model eller en evolution skrev kæden (Grænser i kemi, 2020). Det, der ændrer sig med AI, er gennemstrømning. Modeller foreslår kandidater hurtigere, end en bænk kan triage dem, så hårde sekvenser ankommer i større partier, og fejlraten ser værre ud, end den er.
Hvilken renhed har et peptid brug for til et celleassay versus et in vivo-studie?
Der er ikke et enkelt nummer. EMA guideline om syntetiske peptider, effektiv 1 juni 2026, anmoder om acceptkriterier, der er begrundede for den specifikke påtænkte anvendelse frem for en fast tærskel (EMA, 2025). Indstil grænsen fra, hvad analysen tolererer: modion og trunkerede arter, der skifter en in vitro-aflæsning, kan være irrelevante in vivo, og det omvendte gælder også.
Er et analysecertifikat nok til at frigive en masse?
Ingen. En CoA rapporterer, hvad leverandøren målte; det bekræfter ikke i sig selv identitet. Mindst to ortogonale identifikationsmetoder anbefales ved specifikation og frigivelse, så massespektrometri og en kromatografisk eller sekventeringsmetode bør stemme overens, før partiet accepteres (EMA, 2025).
Hvad skal der ske med en mislykket syntese i træningssættet?
Mærk det som en teknisk fejl, ikke en inaktiv. Kvantitative resultater, bekræftede negativer, censurerede værdier og mislykkede kørsler har forskellige betydninger, og sammensmeltning af dem ødelægger det signal, som en workflow for AI-peptiddesign med lukket sløjfe har brug for (gennemgang af multimodal fundamentmodel, 2026). Fastgør hver etiket til sekvensen, konstruere, batch, protokol, koncentration, replikere, kontroller, QC-status og modelversion.
Har AI faktisk forbedret den kliniske effektivitet?
Beviset er bestridt, og den senere læsning er negativ. Tidlige rapporter om accelereret opdagelse er ikke blevet modsvaret af påviste gevinster i kliniske endepunkter, så behandl beregningshastighed som en procesforbedring frem for et bevis på bedre resultater (gennemgang af multimodal fundamentmodel, 2026).
Konklusion
Sammenlign like-for-like-endepunkter: Fase I færdiggørelse er ikke det samme som eventuel godkendelse efter indtræden i fase I. De citerede prøver af AI-program og historiske industrikohorter er forskellige i udvælgelse, størrelse, datoer og opfølgning. De etablerer ikke en AI-fordel ved at sammenligne 80–90 % med en 7.9% godkendelsessandsynlighed.
Det, der lukker hullet, er en arbejdsgang, ikke en model. Filtrer kandidater mod syntesebegrænsninger, før de rangeres, bygge den analytiske pakke så renhed, identitet, tilfreds, stabilitet og assay-egnethed står hver for sig, planlægge opskalering omkring re-optimerede procesparametre og tre primære batches, og registrere fejl som deres egne labels, så den næste designrunde lærer af dem. Begrænsningstjeklisten i afsnittet om syntese-gennemførlighed er det praktiske udgangspunkt, og den analytiske datapakke-tjekliste er ledsageren til bænkstadiet. Begge dele er værd at adoptere inden næste kampagne, ikke efter det.