Khoảng cách dịch thuật là gì và sẵn sàng cho băng ghế dự bị có nghĩa là gì
Nhà cung cấp peptide tùy chỉnh Canxi peptit Khoảng cách dịch thuật là khoảng cách giữa một ứng cử viên được xếp hạng tính toán và một peptide có thể được tạo ra, đặc trưng và thử nghiệm. Sẵn sàng cho băng ghế dự bị là trạng thái có thể kiểm tra được ở phía bên kia của khoảng cách đó: một trình tự và định dạng xác định, đã chứng minh tính khả thi tổng hợp, gói dữ liệu phân tích hỗ trợ từng tuyên bố, điều kiện xử lý đã nêu, và một cuộc khảo nghiệm mà vật liệu thực sự phù hợp cho.
Lớp lâm sàng cho thấy tại sao khoảng cách lại quan trọng về mặt thương mại. Đường cơ sở của ngành giai đoạn 2011–2020 là 7.9% khả năng được phê duyệt từ Giai đoạn I qua 12,728 chuyển pha (SINH HỌC / Thông tin dược phẩm Informa / Cố vấn QLS, 2021). Phân tích đầu tiên về các quy trình gốc AI cho thấy Giai đoạn I thành công 80–90% nhưng chỉ đạt khoảng 40% trong giai đoạn II, một con số mà các tác giả mô tả là dựa trên một cỡ mẫu giới hạn (Jayatunga và cộng sự., Khám phá thuốc ngày nay, 2024). MỘT 2025 bình luận được xây dựng trực tiếp trên những con số đó nói rằng xu hướng an toàn và dung nạp tốt hơn so với các phân tử được phát triển truyền thống, 90% so với dưới 65%, trong khi thành công của bằng chứng khái niệm Giai đoạn II nằm ở 40%, phù hợp với mức trung bình lịch sử của ngành, và nói thêm rằng vẫn chưa có đủ trường hợp để phân tích thống kê (Jacobson, khám phá thuốc npj, 2025).
Hai giới hạn về bằng chứng thuộc cùng một đoạn với các con số. Không có nguồn được đánh giá ngang hàng nào định lượng được tỷ lệ các peptide do AI thiết kế không tổng hợp được, và không có nguồn nào định nghĩa hoạt động “được AI phát hiện”, liệu điều đó có nghĩa là AI được sử dụng để nhận dạng mục tiêu, thiết kế phân tử, hoặc cả hai. Do đó, việc thu hẹp khoảng cách dịch thuật trong thiết kế peptide AI không thể đo lường được so với tỷ lệ thất bại đã công bố. Nó phải được quản lý như một chuỗi các quyết định kỹ thuật, đó là những gì các phần còn lại đặt ra.
Các mô hình AI peptide được đào tạo như thế nào và chúng cần dữ liệu gì
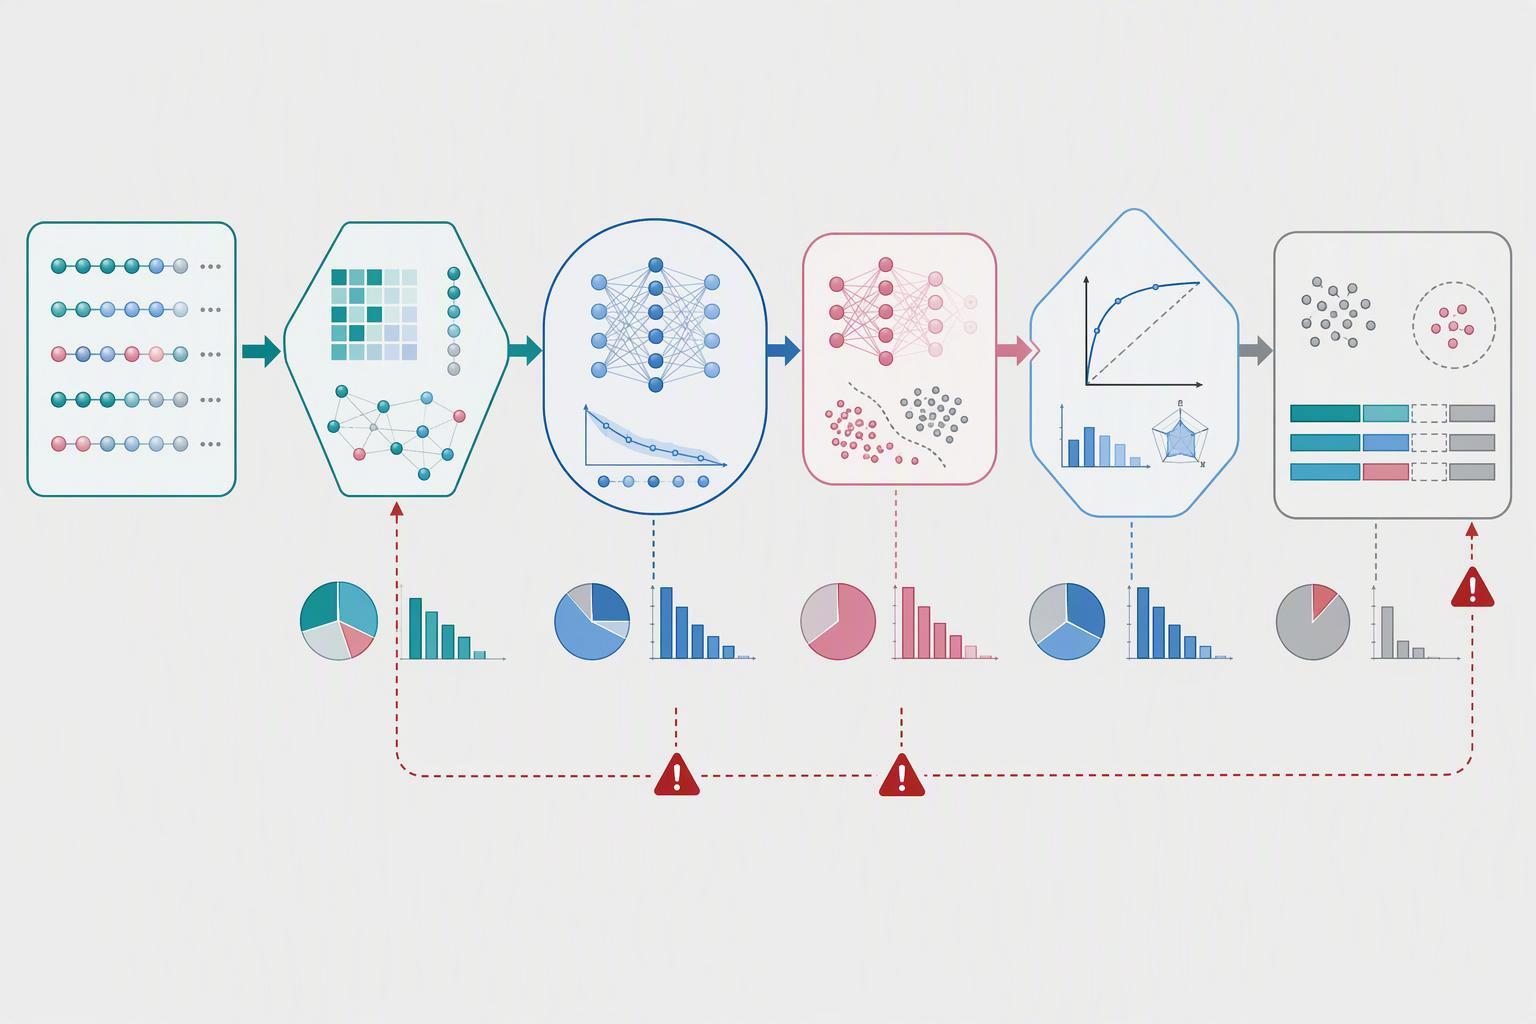
Các mô hình peptide học từ cách biểu diễn trình tự, một kho ngữ liệu được huấn luyện trước, một bộ tinh chỉnh có gắn nhãn dương và âm, và phân chia đánh giá, và chất lượng của hai yếu tố cuối quyết định liệu hiệu suất được báo cáo có ý nghĩa gì không. Tập huấn luyện của AMPGen là một trường hợp cụ thể hữu ích: 10,249 trình tự peptide kháng khuẩn độc đáo được tổng hợp từ sáu cơ sở dữ liệu công cộng, trong số đó 9,854 mang mục tiêu kháng khuẩn, giảm xuống còn 9,964 dương tính sau khi lọc tới 5–65 axit amin, ghép nối với 11,989 Các chuỗi không phải AMP được lấy từ UniProt dưới dạng âm (AMPGen, Sinh học Truyền thông, 2025). Bản thân trình tạo đã được đào tạo trước về bao gồm dữ liệu OpenFold 401,381 nhiều sự sắp xếp trình tự cho khoảng 132,000 trình tự PDB duy nhất.
Tập số âm đó là phần mà hầu hết các dự án đều không đầu tư vào.. Lọc UniProt để tìm chuỗi 5–65 dư lượng trong khi loại trừ 17 từ khóa như kháng sinh, kháng sinh, kháng khuẩn và độc tố tạo ra âm tính không phải AMP bằng chú thích, không phải âm bản đã được đo lường và phát hiện không hoạt động. Không có nhân vật công cộng ổn định nào tồn tại để chia sẻ các bản ghi không hoạt động trong cơ sở dữ liệu hoạt động peptide, đó là lý do tại sao thành phần của một bộ cụ thể, không phải là một tuyên bố chung về cân bằng cơ sở dữ liệu, là cách trung thực để mô tả điều này.
Đánh giá là điểm yếu thứ hai. Một cuộc kiểm toán 51 cấu hình điểm chuẩn trải rộng trên Polaris, TDC, MoleculeNet và DTI phát hiện thấy sự lây nhiễm chéo trong phần lớn các tập dữ liệu, với độ tương tự ECFP Tanimoto lân cận gần nhất trung bình giữa các hợp chất thử nghiệm và huấn luyện của 0.494, 0.559, 0.589 Và 0.779 tương ứng (kiểm toán chuẩn, PMC, 2026). Xung đột nhãn được chèn, ROC AUC trung bình đã giảm 0.317. Một mô hình peptide được đánh giá trên một phần tách chia sẻ các trình tự gần như trùng lặp với quá trình huấn luyện đang báo cáo một số lượng sẽ không thể tồn tại trong quá trình tổng hợp.
Tại sao các peptide có hứa hẹn về mặt tính toán lại thất bại trong quá trình tổng hợp và thử nghiệm
Các peptide thất bại vì lý do hóa học mà mô hình hoạt động ở cấp độ chuỗi không nhìn thấy được. Trình tự khó khăn, được định nghĩa là những hình thành liên kết mạnh mẽ- hoặc các tương tác không cộng hóa trị nội phân tử tạo ra các tập hợp không hòa tan và ngăn chặn sự khử và ghép nối hoàn toàn, vẫn là một thách thức trên 50–60 axit amin ngay cả với quá trình tổng hợp tự động, và trình tự dài hơn 50 dư lượng thường cần ngưng tụ mảnh hoặc thắt hóa học tự nhiên (Biên giới trong hóa học, 2020).
Nghiên cứu hai peptide được trích dẫn đã thay đổi điều kiện quy trình khi quy mô tăng lên. Sản lượng của nó mô tả các tuyến đường và thử nghiệm đó, không phải là phạm vi lập kế hoạch cho mọi trình tự. So sánh việc mở rộng quy mô được đề xuất thông qua quy trình phù hợp và dữ liệu phân tích.
Bài báo AMPGen được trích dẫn báo cáo tổng hợp và thử nghiệm kháng khuẩn của các ứng cử viên được chọn cũng như sàng lọc tính toán. Giữ kết quả đo được khác biệt với dự đoán và giữ lại sinh vật có liên quan, mẫu số xét nghiệm và lựa chọn ứng viên; kết quả không chứng minh được hiệu quả lâm sàng hoặc tỷ lệ thành công cho tất cả các chuỗi được tạo ra.
Cách lọc ứng viên AI chống lại các ràng buộc tổng hợp thực sự
Lọc các ứng viên theo các ràng buộc tổng hợp trước khi xếp hạng chúng theo hoạt động, không phải sau một chiến dịch thất bại. Trình tự thực tế chạy: dư lượng cho phép và khả năng tương thích của nhóm bảo vệ, sau đó tính điểm rủi ro tổng hợp và chạy kỵ nước, sau đó là tính khả thi của đa disulfide và chu trình hóa, sau đó khả năng tương thích sửa đổi thiết bị đầu cuối và chuỗi bên, thì chiều dài trần nhà. Mỗi cổng là có hoặc không theo một trình tự cụ thể, và một ứng cử viên không đạt bất kỳ cổng nào nên được thiết kế lại thay vì chuyển tiếp kèm theo một ghi chú.
Dự đoán cấu trúc hỗ trợ các cổng giữa thay vì thay thế chúng. AlphaFold 3 dự đoán cấu trúc chung của các phức hợp bao gồm protein, axit nucleic, phân tử nhỏ, các ion và dư lượng biến đổi từ chuỗi polymer, sửa đổi dư lượng và phối tử SMILES, và báo cáo độ chính xác cao hơn đáng kể về tương tác protein-phối tử so với các công cụ lắp ghép như Vina (P = 2.27 × 10⁻¹³) và đối với phức hợp kháng nguyên-kháng thể hơn AlphaFold-Multimer v2.3 (P = 6.5 × 10⁻⁵) (Abramson và cộng sự., Thiên nhiên, 2024). Đó là những giá trị ý nghĩa, không phải là cải thiện tỷ lệ phần trăm tiêu đề, và họ không nói gì về việc peptide có thể được lắp ráp trên nhựa hay không.
Độ dài trình tự là một yếu tố rủi ro, không phải là trần tổng hợp phổ quát. Chạy kỵ nước, sửa đổi và cấu trúc liên kết sẽ kích hoạt đánh giá tính khả thi; bốn dư lượng kỵ nước liên tiếp không tự động yêu cầu thiết kế lại hoặc thắt mảnh. Chọn tuyến đường bằng cách sử dụng các thử nghiệm dành riêng cho từng công trình.
|
Cổng |
Nó chiếu những gì |
Phản hồi thất bại |
|---|---|---|
|
Nhóm dư lượng và bảo vệ Peptide khuếch đại khả năng tương thích |
Liệu dư lượng cần thiết và hóa chất có cùng tồn tại hay không |
Dư lượng thay thế hoặc thay đổi chiến lược |
|
Rủi ro kỵ nước và tổng hợp |
Kéo dài kỵ nước liên tiếp, xu hướng tờ β |
Thiết kế lại hoặc lập kế hoạch ngưng tụ mảnh |
|
Tính khả thi của disulfide và chu kỳ |
Hóa trị đa disulfide, Nhà sản xuất thông tin peptide đóng cửa từ đầu đến đuôi hoặc đóng lactam |
Điều chỉnh hóa học chu kỳ hoặc thả Peptide hormone tăng trưởng |
|
Khả năng tương thích sửa đổi |
Phần cuối, chuỗi bên, nhãn, bổ sung chất liên kết và lipid |
Sắp xếp lại trình tự trang web sửa đổi |
|
Chiều dài trần |
Giới hạn thực tế cho các chuỗi sửa đổi phức tạp |
Chia thành các đoạn hoặc dây chằng |
Gói dữ liệu phân tích nào giúp peptide có thể bảo vệ được trên băng ghế dự bị
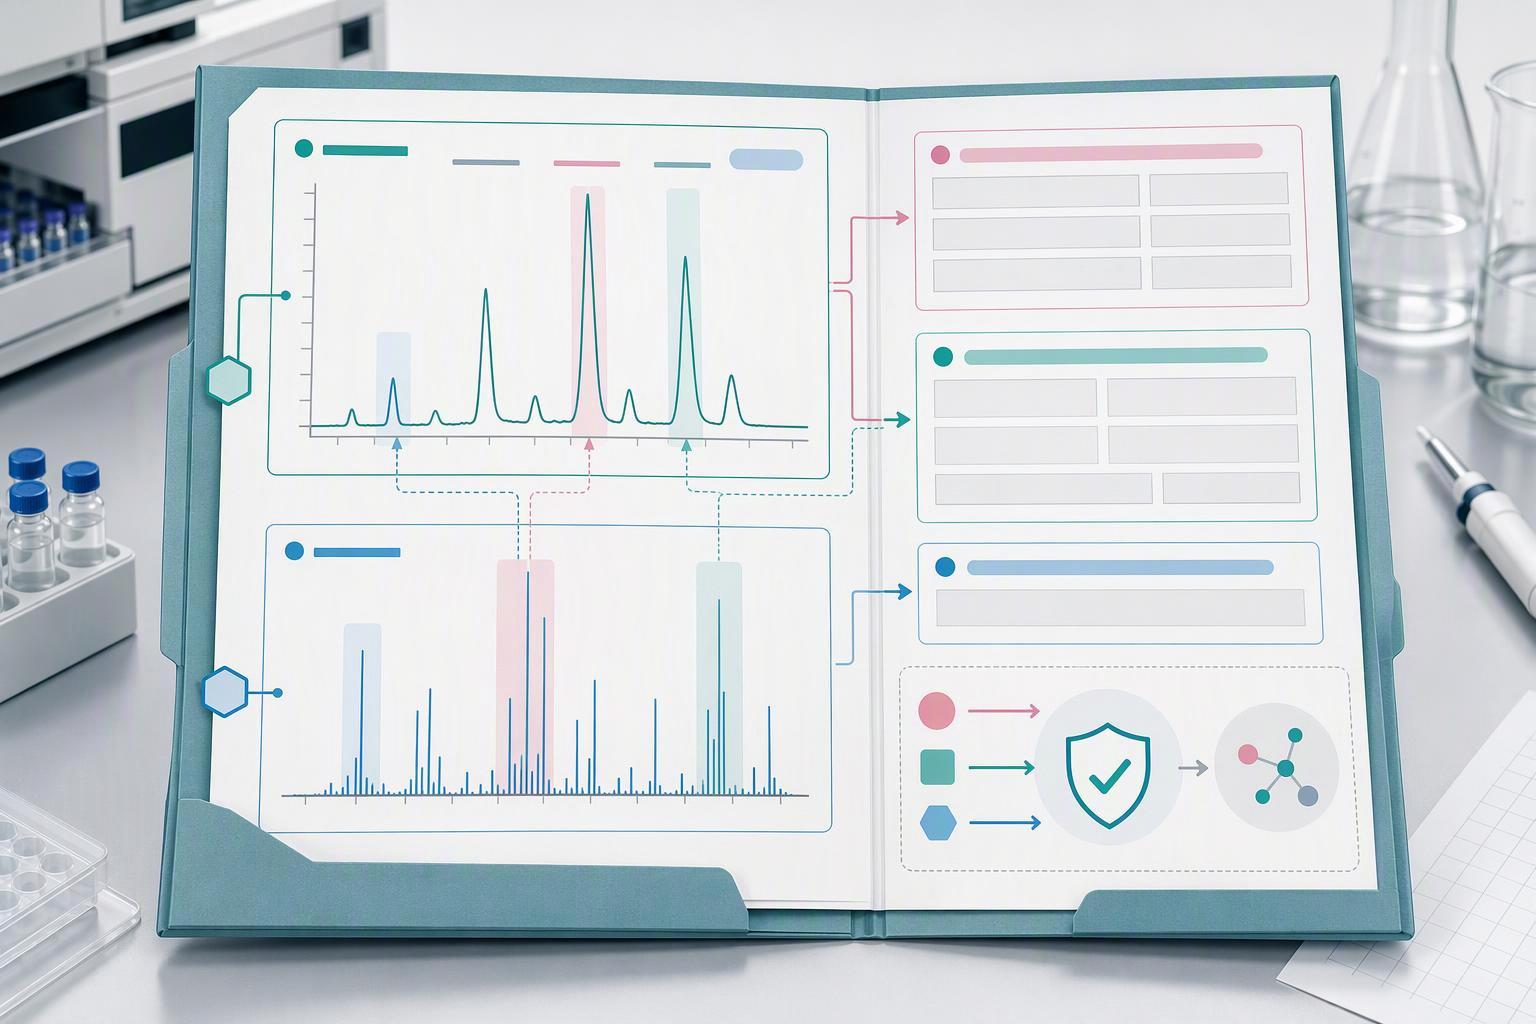
Một gói phòng thủ ngăn cách sự tinh khiết, danh tính, nội dung, tính ổn định và thử nghiệm sự phù hợp thành các yêu cầu riêng biệt, mỗi người có phương pháp riêng và bằng chứng riêng. Hướng dẫn của EMA về phát triển và sản xuất peptide tổng hợp, được thông qua 4 Tháng 12 2025 và hiệu quả 1 Tháng sáu 2026, coi độ tinh khiết là một trong những thuộc tính chất lượng quan trọng nhất đối với peptide tổng hợp, yêu cầu các tiêu chí chấp nhận cho các phân số riêng lẻ và nhóm chính phải được nêu rõ và chứng minh, và yêu cầu mô tả đặc tính độ tinh khiết trực giao trên cơ sở kích thước, phân tách dựa trên điện tích và kỵ nước (EMA, 2025).
Bản sắc không phải là sự trong sạch, và các hướng dẫn nói như vậy ở những nơi khác nhau. ICH Q6B cho rằng độ tinh khiết tuyệt đối và tương đối rất khó xác định và phụ thuộc nhiều vào phương pháp, vì vậy độ tinh khiết được đánh giá bằng sự kết hợp của các quy trình phân tích, trong khi các xét nghiệm nhận dạng phải có tính đặc hiệu cao đối với phân tử và có thể yêu cầu nhiều hơn một xét nghiệm hóa lý, xét nghiệm sinh học hoặc miễn dịch hóa học (Tôi Q6B, 1999). Hướng dẫn của EMA khuyến nghị ít nhất hai phương pháp nhận dạng trực giao ở thông số kỹ thuật và phát hành, rút ra từ khối lượng, thời gian lưu tương đối, LC-MS, lập bản đồ peptit, hoạt tính sinh học, phân tích axit amin hoặc NMR, và phân tách tạp chất thành các loại liên quan đến peptide và không liên quan đến peptide (EMA, 2025).
Sử dụng ICH Q2 cuối cùng(R2) khuôn khổ để xác nhận phân tích có thể áp dụng và chứng minh thiết kế nghiên cứu cho quyết định dự định. Điều kiện bảo quản, Số lượng và thời lượng lô phải được chọn cho sản phẩm và giai đoạn phát triển thay vì kế thừa như một yêu cầu chung về vật liệu sàng lọc.
Cách mở rộng quy mô từ sàng lọc mg đến sản xuất kg mà không làm mất tính nhất quán giữa các lô
Mở rộng quy mô thay đổi quá trình, vì vậy độ tinh khiết và năng suất mà bạn xác nhận ở quy mô sàng lọc không phải là con số bạn nên hứa hẹn ở quy mô sản xuất. Dữ liệu Guzmán cho thấy quy mô của sự thay đổi đó: cùng một peptide được chuyển từ 8.0% năng suất và 23.9% độ tinh khiết thô ở mức 10–20 mg đến 53.5% năng suất và 64.4% độ tinh khiết thô ở mức 3–4 g, và peptide thứ hai từ 36% Và 62.1% ĐẾN 78.5% Và 98.7% (Guzmán và cộng sự., Tạp chí điện tử Công nghệ sinh học, 2023). Bởi vì giao thức và điều kiện thay đổi theo quy mô trong nghiên cứu đó, đọc một cách trung thực thì việc mở rộng quy mô đòi hỏi phải tối ưu hóa lại, không phải là một hình phạt cố định được áp dụng.
Tính nhất quán giữa các lô được kiểm soát thông qua thông số kỹ thuật, không thông qua con số lợi nhuận. Hướng dẫn của EMA yêu cầu các thông số quy trình cho hoạt động cách ly được mô tả, yêu cầu các biện pháp ngăn ngừa ô nhiễm chéo khi các peptide khác nhau được tinh chế trên cùng một cột, và yêu cầu đánh giá về số phận và thanh lọc các tạp chất nguyên liệu ban đầu có thể mang đến peptide cuối cùng (EMA, 2025). Xóa và cắt ngắn trình tự, được hình thành bằng cách ghép hoặc khử bảo vệ không hoàn toàn và bị giới hạn bởi quá trình acetyl hóa, là loại tạp chất phản ánh trực tiếp nhất việc kiểm soát quá trình, và hướng dẫn hy vọng sự hình thành của chúng sẽ được ngăn chặn bằng cách ghép nối lặp lại và giới hạn có hệ thống thay vì điều chỉnh ở hạ lưu.
Các nghiên cứu về độ ổn định sẽ hỗ trợ việc bảo quản thực tế, thời gian xử lý, mục đích sử dụng và giai đoạn phát triển. Khuyến nghị đăng ký ICH cho các đợt chính và thời gian gửi không phải là khoảng thời gian chờ đợi chung là 12 tháng đối với các peptide nghiên cứu. Xác định một giao thức phù hợp với từng giai đoạn và tiêu chí chấp nhận.
Vòng khép kín hoạt động như thế nào khi kết quả xét nghiệm và lỗi thất bại quay trở lại mô hình
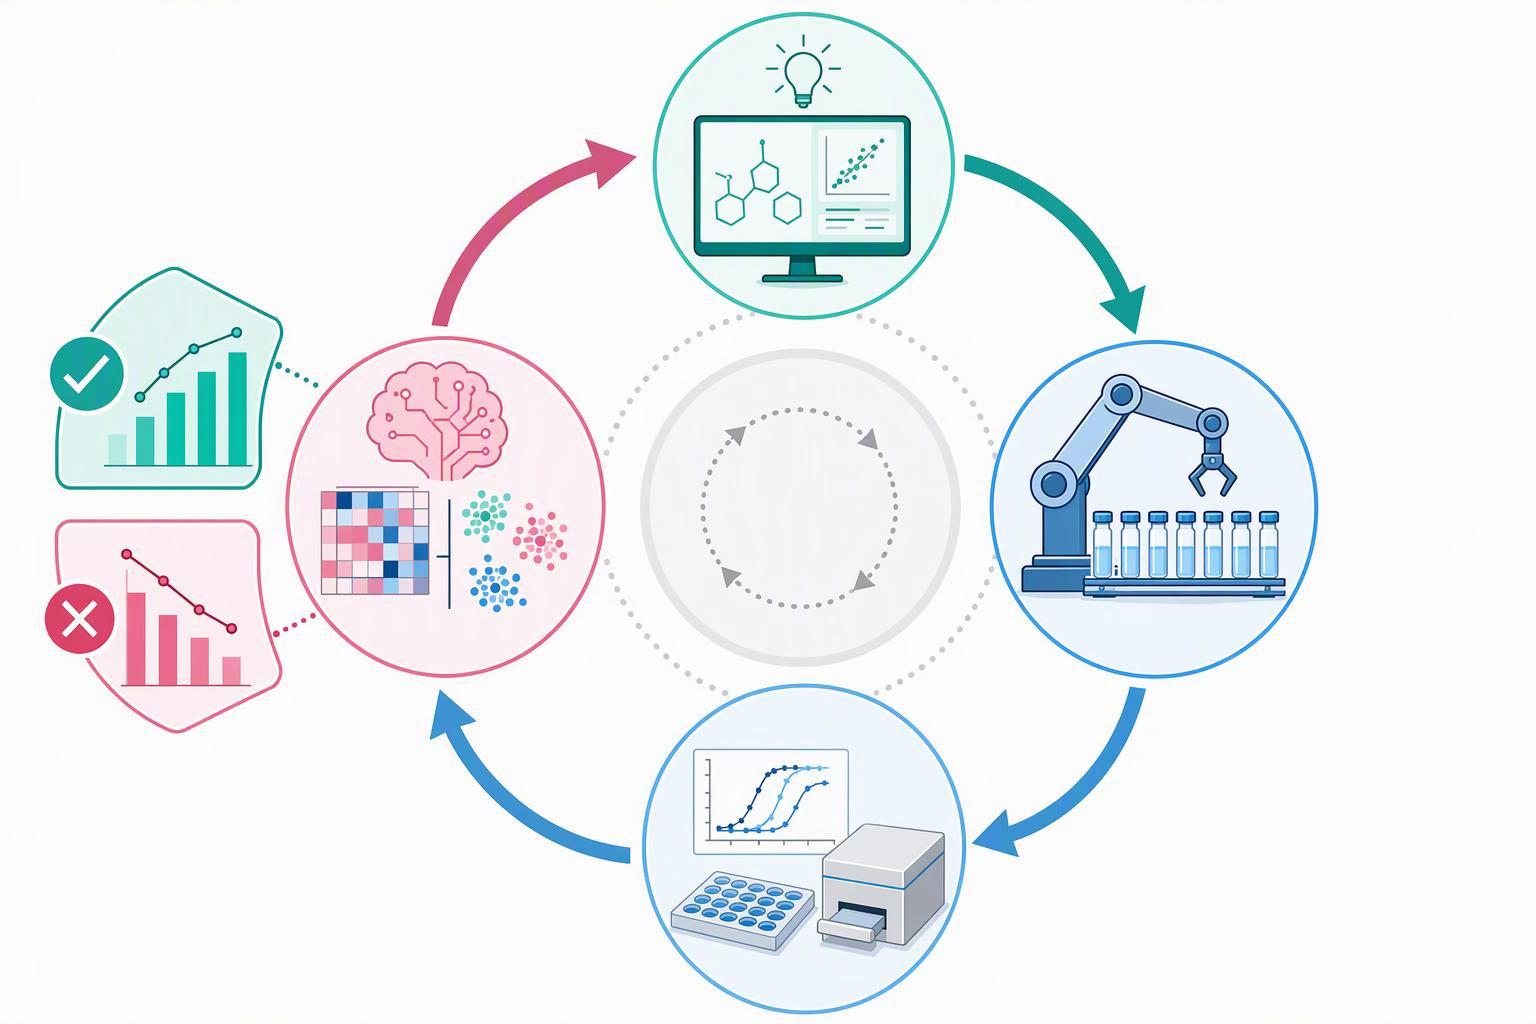
Vòng lặp khép kín chỉ hoạt động nếu các lỗi và kết quả âm tính được ghi lại dưới dạng các nhãn riêng biệt thay vì được thu gọn vào một nhóm không hoạt động. Chu trình được ghi lại là thiết kế và lọc trước các ràng buộc cứng bao gồm tính khả thi tổng hợp, sự tổng hợp, độc tính, độ hòa tan và khả năng tương thích vật liệu; thực hiện và khảo nghiệm; quản lý kết quả bằng cách đính kèm từng kết quả vào trình tự chính xác, xây dựng, lô, giao thức xét nghiệm, sự tập trung, nhân rộng, điều khiển, Trạng thái QC và phiên bản mẫu; cập nhật mô hình; sau đó xếp hạng lại và chọn tiện ích dự đoán cân bằng đợt tiếp theo, sự không chắc chắn, đa dạng, tính mới và khả thi trong thực tiễn (đánh giá mô hình nền tảng đa phương thức, PMC, 2026). Nhà máy peptide tùy chỉnh
Bốn loại nhãn là điều tạo nên sự khác biệt. Các phép đo định lượng mang một giá trị và một phương pháp. Các kết quả âm tính được xác nhận mang theo bằng chứng cho thấy peptide đã được tạo ra và thử nghiệm và không hoạt động. Các kết quả bị kiểm duyệt có kết quả đo nằm ngoài phạm vi của xét nghiệm. Lỗi kỹ thuật dẫn đến quá trình tổng hợp hoặc xét nghiệm không tạo ra dữ liệu có thể giải thích được. Việc hợp nhất những thứ đó thành “không hoạt động” sẽ dạy cho mô hình rằng khớp nối không thành công và âm bản thực sự là giống nhau, điều này trái ngược với những gì vòng thiết kế tiếp theo cần.
Thông lượng là hạn chế thực tế về tốc độ vòng lặp quay. Một chiến dịch phản ứng song song 192 đã hoàn thành trong bốn ngày, tăng gấp bốn lần so với cách tiếp cận tuần tự điển hình, với việc học tập tích cực theo đợt tám, là điểm chuẩn cụ thể cho việc lặp lại quy mô chiến dịch (tài khoản phòng thí nghiệm tự lái, PMC, 2022). Tài khoản đó cũng cho biết hệ thống không hoàn toàn tự chủ và một số bước vẫn cần sự can thiệp của con người như nạp lọ hoặc hóa chất mới, đó là cùng một con người trong vòng lặp hãy báo trước 2025 bình luận đưa ra khi nói AI là một công cụ để nâng cao, không thay thế, trực giác khoa học (Jacobson, khám phá thuốc npj, 2025).
Trường hợp có quy định và bằng chứng, và những gì vẫn chưa được chứng minh
Quy định về AI trong phát triển thuốc dựa trên nguyên tắc và vẫn đang hình thành, trong khi những kỳ vọng về hóa học peptit đã cụ thể. EMA và FDA đã cùng nhau công bố 10 nguyên tắc thực hành tốt AI trong vòng đời của thuốc trên 14 Tháng Một 2026, bao gồm việc tạo và giám sát bằng chứng từ nghiên cứu ban đầu thông qua giám sát sản xuất và an toàn, gửi đến các nhà phát triển và người nộp đơn và chủ sở hữu ủy quyền tiếp thị, và nhằm mục đích củng cố hướng dẫn cụ thể về khu vực pháp lý trong tương lai (EMA, 2026). Việc phát triển hướng dẫn của EU được xây dựng dựa trên tài liệu phản ánh AI của EMA được xuất bản trên 2024. Tháng 1 của FDA 2025 dự thảo hướng dẫn về AI để ra quyết định theo quy định là không ràng buộc và được tổ chức xung quanh bối cảnh sử dụng, được định nghĩa là cách một mô hình được sử dụng để giải quyết một câu hỏi cụ thể, với các nhà tài trợ thiết lập độ tin cậy của mô hình cho bối cảnh đó (FDA, 2025).
Đọc cùng nhau, hướng dẫn peptide là khuôn mẫu hoạt động và các nguyên tắc AI nằm trên đó. Hướng dẫn về peptide tổng hợp của EMA đã áp đặt biện minh cho nguyên liệu ban đầu, báo cáo tạp chất, ngưỡng nhận dạng và trình độ chuyên môn, và nhận dạng trực giao, và yêu cầu các quy trình phân tích phải được mô tả đủ chi tiết để Phòng thí nghiệm kiểm soát thuốc chính thức lặp lại (EMA, 2025). Không có nguồn nào kết nối các nguyên tắc AI của EMA-FDA với thiết kế AI dành riêng cho peptide, và không có nguồn nào đưa ra lộ trình quản lý hoặc mốc thời gian để các peptide do AI thiết kế được phê duyệt.
Hồ sơ bệnh án được trộn lẫn và nên được đọc như vậy. DSP-1181, loại thuốc do AI thiết kế đầu tiên được đưa vào cơ thể người, đã bị ngừng sản xuất ở 2022 trước Giai đoạn II; REC-994 đã bị ngừng sản xuất vào năm 2025 sau khi dữ liệu dài hạn không duy trì được xu hướng hiệu quả trước đó; Rentosertib đã đạt đến Giai đoạn IIa đối với bệnh xơ phổi vô căn ở 2024, với 18 tháng từ khi phát hiện mục tiêu đến đề cử ứng viên tiền lâm sàng (AI trong khám phá ma túy: Thất bại lâm sàng, Thực tế quy định, PMC, 2026). các 2025 bài bình luận nêu rõ rằng những nỗ lực về AI cho đến nay vẫn chưa tạo ra được loại thuốc hiệu quả hơn, trong khi 2024 phân tích coi những phát hiện của nó là những dấu hiệu ban đầu về tiềm năng lâm sàng. Điều vẫn chưa được chứng minh là hiệu quả, không phải tốc độ.
Câu hỏi thường gặp
Các peptide do AI thiết kế có khó tổng hợp hơn các peptide tự nhiên không??
Không có nguồn nào chứng minh điều đó. Độ khó theo dõi chính trình tự đó, không phải nguồn gốc của nó: kéo dài dễ bị tổng hợp, dư lượng cồng kềnh hoặc bị cản trở, và chiều dài trên khoảng 50 ĐẾN 60 các axit amin tạo ra các vấn đề liên kết và khử bảo vệ giống nhau cho dù một mô hình hay một quá trình tiến hóa đã viết ra chuỗi (Biên giới trong hóa học, 2020). Những thay đổi với AI là thông lượng. Người mẫu đề xuất ứng viên nhanh hơn băng ghế dự bị có thể phân loại họ, vì vậy các chuỗi cứng được gửi đến với số lượng lớn hơn và tỷ lệ thất bại có vẻ tệ hơn thực tế.
Peptide cần độ tinh khiết như thế nào cho xét nghiệm tế bào so với nghiên cứu in-vivo?
Không có số duy nhất. Hướng dẫn của EMA về peptide tổng hợp, hiệu quả 1 Tháng sáu 2026, yêu cầu các tiêu chí chấp nhận phù hợp với mục đích sử dụng cụ thể thay vì một ngưỡng cố định (EMA, 2025). Đặt giới hạn từ những gì xét nghiệm cho phép: các loài đối kháng và bị cắt cụt làm thay đổi kết quả đọc trong ống nghiệm có thể không liên quan trong cơ thể, và điều ngược lại cũng đúng.
Giấy chứng nhận phân tích có đủ để phát hành nhiều không?
KHÔNG. CoA báo cáo những gì nhà cung cấp đo được; bản thân nó không xác nhận danh tính. Ít nhất hai phương pháp nhận dạng trực giao được khuyến nghị ở phần đặc tả và phát hành, vì vậy phép đo khối phổ và phương pháp sắc ký hoặc giải trình tự phải được thống nhất trước khi lô hàng được chấp nhận (EMA, 2025).
Điều gì sẽ xảy ra với sự tổng hợp thất bại trong tập huấn luyện?
Dán nhãn cho nó là lỗi kỹ thuật, không phải là không hoạt động. Kết quả định lượng, xác nhận tiêu cực, các giá trị bị kiểm duyệt và các lần chạy không thành công mang những ý nghĩa khác nhau, và việc hợp nhất chúng sẽ phá hủy tín hiệu mà quy trình thiết kế peptide AI vòng kín cần có (đánh giá mô hình nền tảng đa phương thức, 2026). Đính kèm từng nhãn vào trình tự, xây dựng, lô, giao thức, sự tập trung, nhân rộng, điều khiển, Trạng thái QC và phiên bản mẫu.
AI có thực sự cải thiện hiệu quả lâm sàng?
Bằng chứng đang được tranh cãi, và lần đọc sau là âm tính. Các báo cáo ban đầu về việc phát hiện nhanh chóng chưa phù hợp với những lợi ích đã được chứng minh ở các điểm cuối lâm sàng, vì vậy hãy coi tốc độ tính toán như một sự cải tiến của quy trình thay vì bằng chứng về kết quả tốt hơn (đánh giá mô hình nền tảng đa phương thức, 2026).
Phần kết luận
So sánh các điểm cuối tương tự: Việc hoàn thành Giai đoạn I không giống như việc phê duyệt cuối cùng sau khi bước vào Giai đoạn I. Các mẫu chương trình AI được trích dẫn và nhóm thuần tập lịch sử của ngành khác nhau về cách lựa chọn, kích cỡ, ngày và theo dõi. Họ không thiết lập lợi thế AI bằng cách so sánh 80–90% với 7.9% xác suất phê duyệt.
Điều thu hẹp khoảng cách là một quy trình làm việc, không phải là người mẫu. Lọc các ứng viên theo các ràng buộc tổng hợp trước khi xếp hạng chúng, xây dựng gói phân tích sao cho độ tinh khiết, danh tính, nội dung, tính ổn định và tính phù hợp của xét nghiệm, mỗi bên đều có bằng chứng riêng, lập kế hoạch mở rộng quy mô xung quanh các thông số quy trình được tối ưu hóa lại và ba lô chính, và ghi lại những thất bại dưới dạng nhãn riêng của họ để vòng thiết kế tiếp theo học hỏi từ chúng. Danh sách kiểm tra ràng buộc trong phần tổng hợp-khả thi là điểm khởi đầu thực tế, và danh sách kiểm tra gói dữ liệu phân tích là người bạn đồng hành cho giai đoạn chuẩn bị. Cả hai đều đáng được áp dụng trước chiến dịch tiếp theo, không theo sau nó.